Note de l’auteur : cet article compare les trois types de canaux GPT-Image (officiel, -all et -vip) sur la facturation, les tailles d’image et l’édition locale. Il revient sur les incidents survenus entre avril et octobre 2026 et propose une solution de repli combinant « nouvelles tentatives limitées + disjoncteur + canal de secours ».
Quand on intègre GPT-Image, on tombe vite sur un détail déroutant : un seul modèle d’image, mais plusieurs noms sur la plateforme. Les canaux officiel (« 官转 », par exemple gpt-image-2.5-flare), -all et -vip n’ont ni la même facturation, ni les mêmes paramètres, ni les mêmes causes de panne. Cet article compare ces trois types de canaux GPT-Image sous plusieurs angles et propose une méthode de choix et un plan de repli directement applicables.
Ce n’est pas une analyse « chacun a ses avantages » qui ménage la chèvre et le chou. Nos conclusions s’appuient sur la page de comparaison des canaux du centre de documentation APIYI, sur le registre des modèles et sur les bulletins d’état en temps réel d’avril à octobre 2026. Nous distinguons ce qui relève d’une annonce de la plateforme, ce qui vient de tests réalisés par la plateforme et ce qui n’est qu’un historique d’incidents.
L’essentiel : après cette lecture, vous saurez quel canal GPT-Image utiliser comme canal principal pour votre activité, lequel garder en secours, et comment votre programme doit réagir face à une erreur 429, 408 ou 5xx.
GPT-Image : que sont les canaux « officiel relayé », « officiel inversé » et le groupe entreprise ?
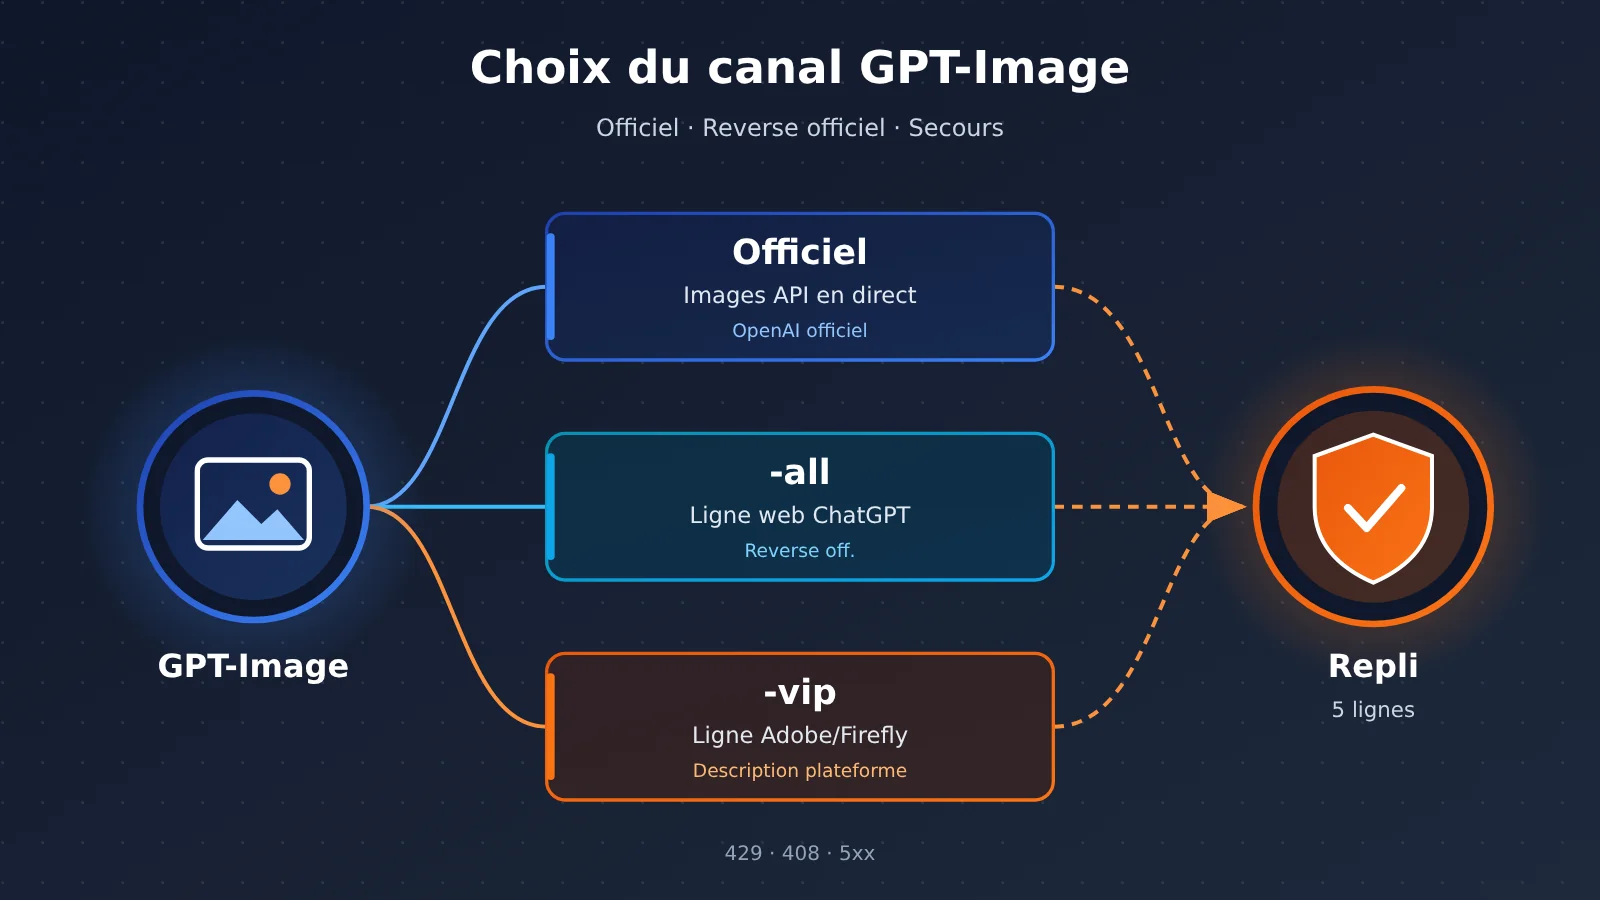
Les termes « 官转 » (officiel relayé) et « 官逆 » (officiel inversé) sont une classification propre à la plateforme APIYI pour ses canaux, et non une terminologie officielle d’OpenAI. Le canal « 官转 » désigne une ligne qui relaie directement les requêtes vers l’API Images officielle d’OpenAI. Le canal « 官逆 » désigne des ressources accessibles par rétro-ingénierie, c’est-à-dire de façon non officielle ; cela ne signifie pas qu’OpenAI fournit ces API inversées.
| Type de canal | Définition dans la documentation de la plateforme | Modèles représentatifs | Principale dépendance en amont |
|---|---|---|---|
| 官转 (officiel relayé) | Relais direct vers l’API Images officielle d’OpenAI | gpt-image-2.5-flare, gpt-image-2.5-sunburst | Puissance de calcul et quotas de l’API OpenAI |
| -all (官逆, officiel inversé) | Accès par rétro-ingénierie à la ligne web de ChatGPT | gpt-image-2-all, gpt-image-2.5-all | Disponibilité de la version web de ChatGPT |
| -vip (官逆, officiel inversé) | Décrit dans la documentation de la plateforme comme une ressource inversée de la ligne Adobe / Firefly | gpt-image-2-vip, gpt-image-2.5-flare-vip, gpt-image-2.5-sunburst-vip | Concurrence du pool de comptes de la plateforme et contrôles de risque en amont |
Le rôle du groupe entreprise image2Enterprise pour GPT-Image
On prend souvent image2Enterprise pour un modèle à part entière, alors que c’est en réalité un groupe de jetons. Il a été ajouté le 2026-04-25, avec un multiplicateur de 1,2x dans le catalogue, contre 1,0x pour les groupes Default, image2_OSS et SVIP. Les 2026-04-27 et 2026-09-21, les ressources du groupe par défaut étaient tendues alors que le groupe entreprise restait stable : il a donc longtemps servi de voie de secours pour le canal officiel relayé.
Le groupe entreprise a toutefois ses limites. Le 2026-05-07, le canal officiel relayé du groupe entreprise a lui aussi été touché par une panne côté OpenAI : il peut soulager l’engorgement du groupe par défaut, mais pas éviter tous les problèmes en amont. Par ailleurs, qu’un groupe figure dans le registre des modèles ne veut pas dire que tous les comptes peuvent l’utiliser ; pour les conditions d’activation, reportez-vous à la console.
GPT-Image 2.6 et la frontière avec les anciens canaux
Au 2026-11-11, le registre des modèles d’APIYI contient deux modèles facturés au token, gpt-image-2.6-flare et gpt-image-2.6-sunburst, mais aucune variante -all ou -vip pour la 2.6. On ne peut donc pas transposer directement à la 2.6 les capacités de taille et de qualité de la 2.5 VIP. Autre point : la page de comparaison indique que la connexion officielle directe de l’ancien gpt-image-2 a été fermée le 2026-09-30, mais le registre conserve toujours cet ID. Pour un nouveau projet, nous vous conseillons d’utiliser directement 2.5 Flare ou Sunburst dans vos exemples de canal officiel relayé. D’après les notes de lancement de la plateforme, flare génère les images plus vite, tandis que sunburst offre de meilleures capacités d’édition.
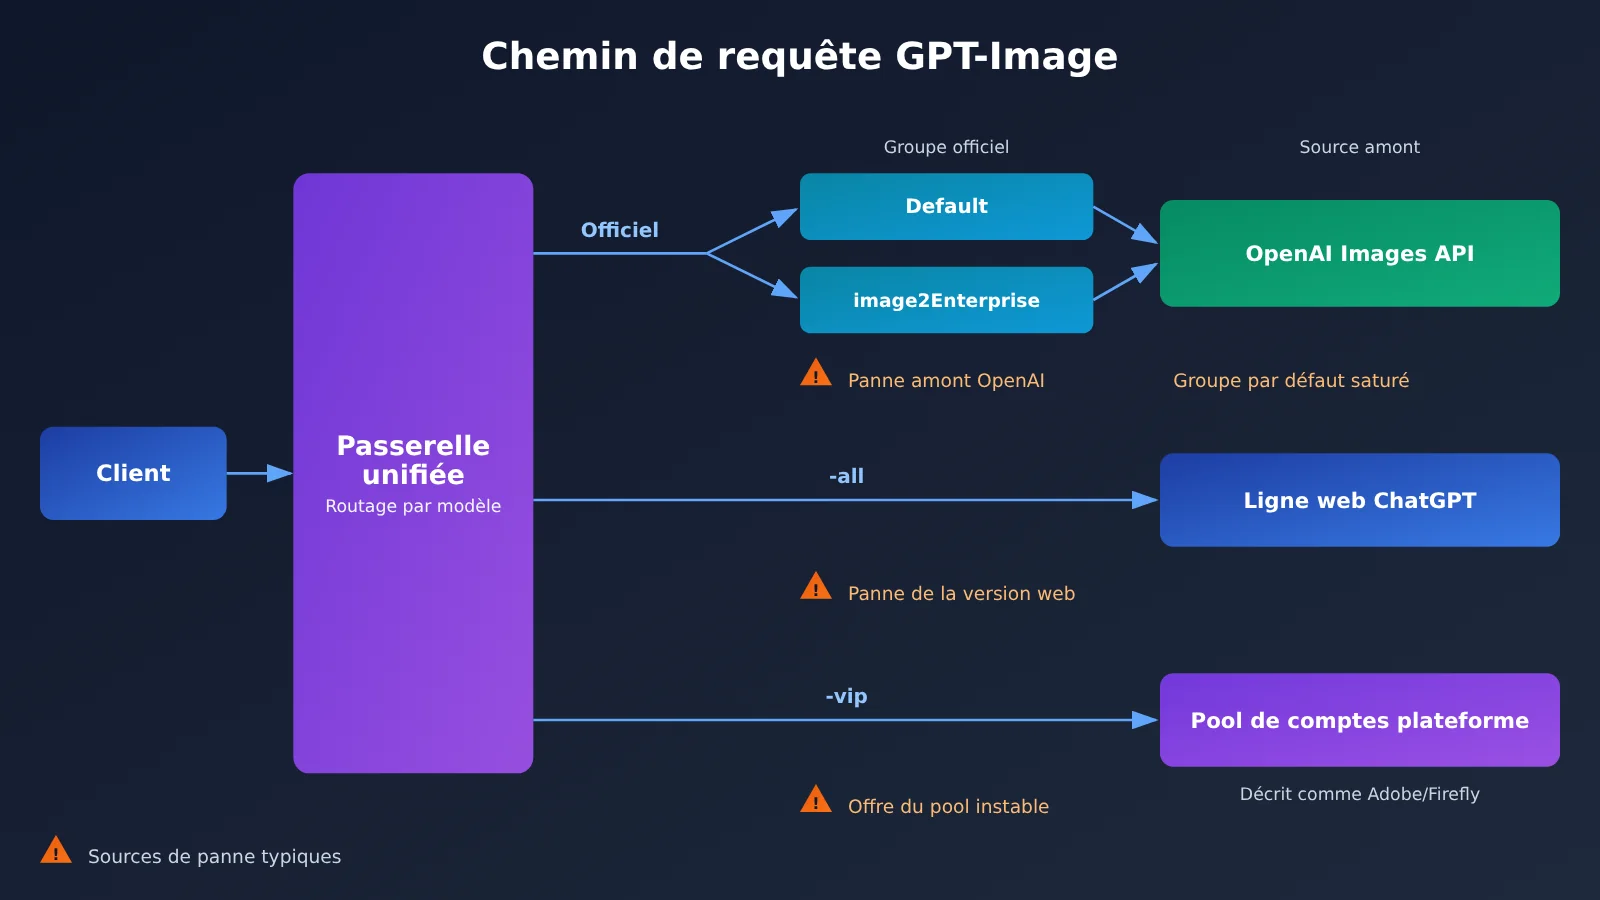
Différences clés entre GPT-Image officiel, -all et -vip
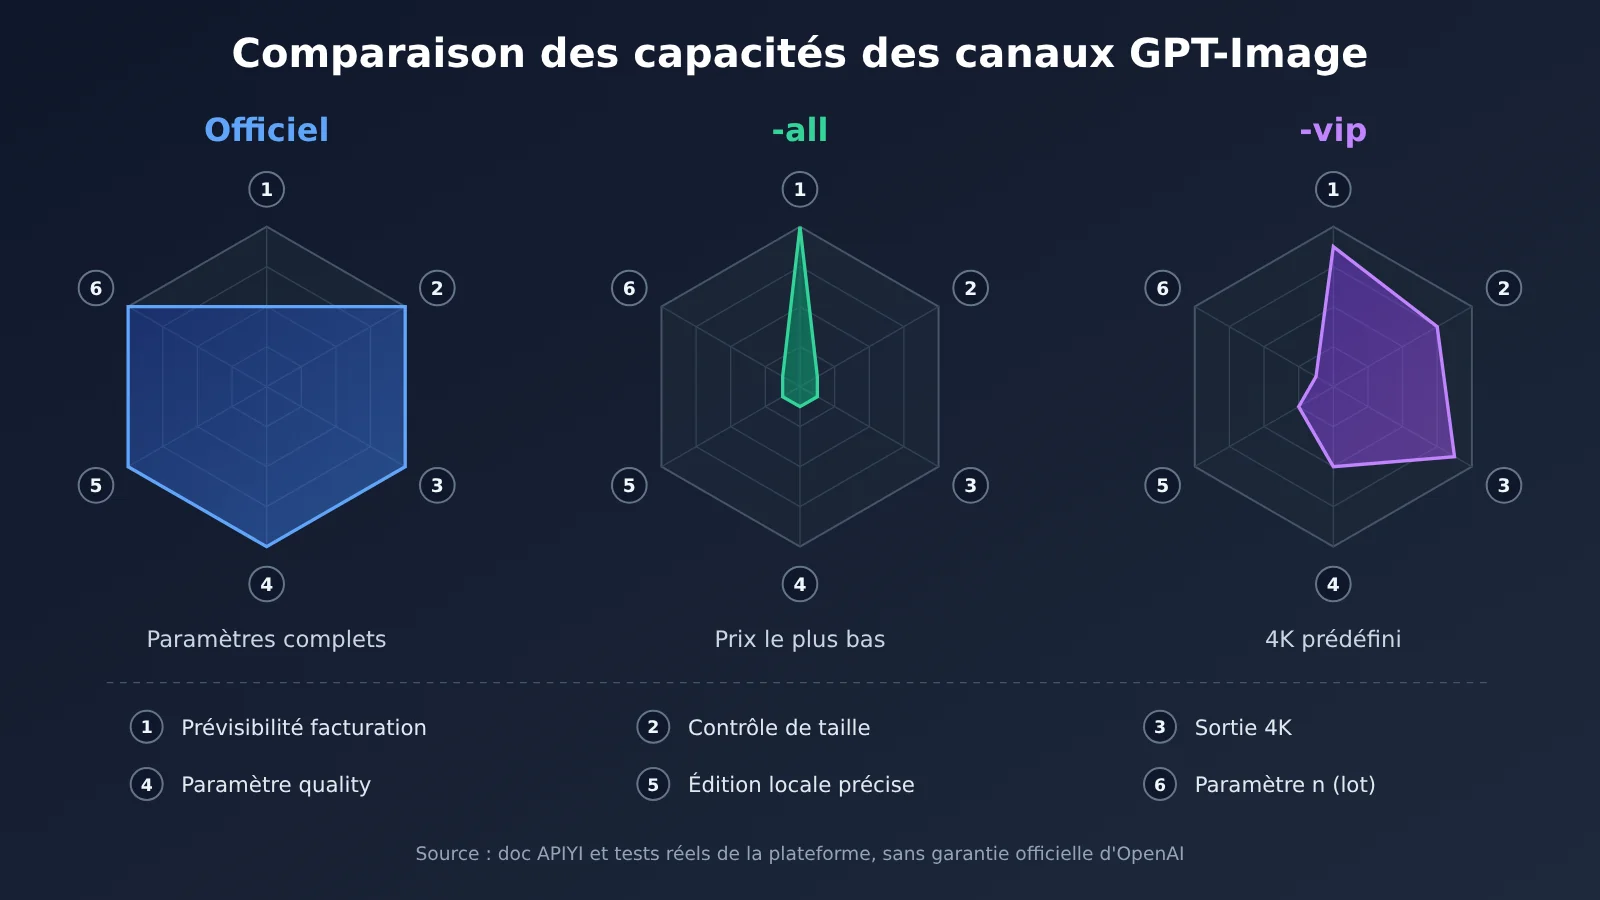
| Critère de comparaison | Canal officiel (2.5 flare / sunburst) | -all | -vip | Meilleur choix |
|---|---|---|---|---|
| Facturation | Au Token, varie selon la taille et la qualité | 0,025 $/image (à partir du 10 octobre 2026) | 0,03 $/image | Coût prévisible : -all |
| Paramètre size | Toute taille valide | Non pris en charge | 30 tailles courantes | Officiel |
| Sortie 4K | Prise en charge | Non prise en charge | Préréglage 4K pris en charge | Officiel / -vip |
| Paramètre quality | Paramètre officiel pris en charge | Non pris en charge | Comportement propre au canal, variable selon le modèle | Officiel |
| Génération de plusieurs images (n) | Prise en charge | Non prise en charge | Non prise en charge | Officiel |
| Retouche locale précise avec mask | Prise en charge | Non prise en charge | Non garantie, régénération de l’image entière uniquement | Officiel |
| Usage typique | Contrôle des paramètres, retouche précise | Génération par lots à prix fixe | Prix fixe, tailles prédéfinies et 4K | — |
Lecture comparative des canaux GPT-Image
Le canal officiel : il est en tête sur l’étendue des paramètres. size, quality, n et mask fonctionnent exactement comme dans l’API Images officielle, ce qui convient bien aux environnements de production qui demandent un contrôle fin. En revanche, il est facturé au Token : le coût par image grimpe avec les grandes tailles et la haute qualité, et on ne peut donc pas le comparer directement à un prix à l’unité. Les tests réels de la plateforme montrent aussi que la limite d’invite du canal officiel est d’environ 8192 tokens. Au-delà, aucune erreur n’est renvoyée, mais l’image générée devient confuse. Il faut donc tronquer les invites longues côté client. Par ailleurs, la fonction de fond transparent de gpt-image-2 a été désactivée par OpenAI. Si vous avez besoin d’un fond transparent, la plateforme recommande le canal officiel 2.5.
-all : son atout est un prix fixe et le plus bas des trois, idéal pour les gros volumes d’images quand la composition n’a pas besoin d’être très précise. Il ne prend pas en charge size, quality, n ni mask, donc mieux vaut ne transmettre que le prompt dans vos appels. -all dépend de la version web de ChatGPT : dès qu’elle tombe en panne, -all en subit directement les effets.
-vip : il se situe entre les deux. Facturé à l’unité, il propose des tailles prédéfinies et la 4K, ce qui convient quand on veut un coût fixe tout en obtenant une haute résolution. Le comportement de ses paramètres relève du canal et non d’une garantie officielle. Les niveaux de qualité xhigh et max de 2.5 VIP sont ouverts d’après les tests réels de la plateforme : on ne peut pas les considérer comme acquis pour tous les modèles obtenus par rétro-ingénierie.
À savoir : les prix du tableau ci-dessus correspondent au catalogue de la plateforme APIYI (avant bonus de recharge et remises de groupe). Ce ne sont pas les tarifs officiels d’OpenAI à l’image. Le prix final est celui affiché dans la console d’apiyi.com.
Retour sur les pannes historiques des canaux GPT-Image : pourquoi ne pas miser sur une seule voie
Se limiter au tableau des fonctionnalités fait passer à côté d’un facteur clé : les trois types de canaux n’ont ni les mêmes sources de panne, ni le même rythme de rétablissement. Voici des événements représentatifs tirés des bulletins d’état de la plateforme, d’avril à octobre 2026. Il s’agit uniquement d’historique, qui ne reflète pas l’état actuel.
| Date (2026) | Canal | Symptôme | Explication / recommandation de la plateforme |
|---|---|---|---|
| 23–27 avril | Relais officiel, groupe par défaut | Concurrence saturée, limites temporaires, erreurs 429 / 408 | Basculer vers image2Enterprise et porter le timeout à 360–600 secondes |
| 7 mai | Relais officiel, groupe entreprise | Erreurs | Cause racine côté OpenAI (en amont) |
| 9 mai | Relais officiel, groupe par défaut | Nouvelle saturation | Basculer le jeton vers le groupe entreprise |
| 16–23 juin | -vip | Le paramètre size ne fonctionne plus, la résolution est tombée un temps à 1,5K, puis 1K | Ajustement des règles en amont, avec un bref retour à la normale entre-temps |
| 7–13 juillet | -all | Panne en amont, timeouts | Redirigé temporairement vers le canal vip ; crédits réattribués après coup pour les appels en timeout |
| 24–25 août | -vip | Limitation de débit par le contrôle des risques en amont, saturation | Les 429 peuvent être retentées, les erreurs de sécurité du contenu n’ont pas besoin de l’être |
| 10–15 septembre | 2.5 -vip | Touché par des 429, ressources insuffisantes | Relais officiel et -all fonctionnaient normalement sur la même période |
| 15 octobre | -all / -vip | -all affecté par une panne de la version web de ChatGPT, -vip en surcharge | Utiliser d’abord le relais officiel en secours quand le canal officiel inversé est indisponible |
| 19 octobre | 2.5 -vip | Concurrence saturée | Ressources en cours de renfort |
Synthèse des modes de panne des canaux GPT-Image
En mettant ces enregistrements côte à côte, on distingue quatre schémas typiques :
- Ressources insuffisantes sur le groupe par défaut du relais officiel : on voit des 429 et des 408. Le groupe entreprise en atténue une partie, mais ne protège pas des pannes d’OpenAI en amont ;
- -all qui suit les pannes de la version web : dès que la version web de ChatGPT a un problème, -all renvoie des erreurs ou ralentit en même temps. Les temps de réponse relevés par la plateforme ont oscillé entre environ 40 et 80 secondes ;
- -vip : saturation du pool de ressources et dérive des paramètres : en plus des 429, size et quality ont déjà cessé de fonctionner brusquement avant de revenir. La disponibilité des paramètres n’est donc pas stable non plus ;
- Plusieurs canaux fonctionnent normalement en même temps : les 10 et 15 septembre, quand -vip était indisponible, le relais officiel et -all tournaient normalement. C’est précisément là que l’accès à deux canaux prend tout son sens.
Un mot sur les limites temporelles : dans les archives au 2026-11-11, le dernier bulletin qui concerne clairement l’état de santé des canaux GPT-Image date du 19 octobre. Les enregistrements des 5 et 9 novembre portent sur la mise en ligne de la 2.6 et sur des mises à jour de documentation, pas sur des annonces d’état. Cet article ne propose donc pas de classement de stabilité à jour, et les données historiques de temps de réponse ne doivent pas être prises pour un SLA.
Recommandations de canaux GPT-Image selon les cas d’usage
Quand choisir le canal « officiel » (官转)
- Visuels principaux e-commerce, images publicitaires : vous avez besoin d’une taille précise ou de la 4K, et vous voulez piloter la qualité d’image avec
quality; - Retouche locale, changement d’arrière-plan : tout repose sur un
maskpour une édition précise. Le canal -vip ne sait que régénérer l’image entière, et -all ne prend pas en charge lemask; - Code OpenAI SDK existant : c’est le canal le plus compatible côté paramètres, et donc le moins coûteux à migrer.
Quand choisir -all
- Visuels en lot, croquis d’inspiration : aucune contrainte stricte de taille, et c’est le prix fixe bas qui compte le plus ;
- Production de contenu avec budget serré : le tarif fixe de 0,025 $/image facilite le calcul des coûts.
Quand choisir -vip
- Besoin de la 4K, mais avec une facturation à l’unité : il suffit d’utiliser les tailles prédéfinies proposées par la plateforme ;
- Génération d’images entières, sans besoin d’édition locale précise : vous acceptez les variations de paramètres liées au comportement du canal.
| Cas d’usage | Canal principal recommandé | Canal de secours recommandé | Points d’attention en cas de bascule |
|---|---|---|---|
| Édition locale précise | Officiel sunburst | Groupe entreprise officiel (si vous êtes éligible) | Ne basculez pas vers -all / -vip : le mask ne sera plus pris en compte |
| Images commerciales à taille imposée | Officiel flare | -vip avec tailles prédéfinies | La taille de secours doit correspondre à l’un des 30 formats prédéfinis |
| 4K haute définition à coût fixe | -vip | Officiel | Après la bascule, la facturation se fait au token |
| Génération massive en lot | -all | -vip (également facturé à l’unité) | Le coût par image passe de 0,025 $ à 0,03 $ |
| Besoin de n variantes | Officiel | Appels multiples en boucle sur -all | Le canal reverse ne prend pas en charge le paramètre n |
Stratégie de repli pour les canaux GPT-Image : relances, coupe-circuit et dégradation
Un repli fiable ne consiste pas à renvoyer la requête dès qu’une erreur survient. Il faut d’abord identifier le type d’erreur, puis choisir l’action adaptée.
| Type d’erreur | Causes fréquentes | Relance ? | Traitement recommandé |
|---|---|---|---|
| 429 | Limite de concurrence ou de débit, pool de ressources saturé | Oui, avec temporisation obligatoire | Backoff exponentiel avec gigue aléatoire ; après plusieurs échecs consécutifs, coupe-circuit et bascule vers un autre canal |
| 408 / timeout côté client | Génération lente en amont, valeur de timeout trop faible | Relance limitée | Pour le canal officiel, monter le timeout à 360–600 secondes et relancer 2 fois maximum |
| 5xx (erreur système) | Panne de la plateforme ou du service en amont | Relance limitée | 2 tentatives maximum avec backoff exponentiel ; si l’échec persiste, bascule vers un canal de secours |
| Erreur de sécurité du contenu | L’invite ou l’image d’entrée a déclenché la modération | Non | Modifier le contenu avant de renvoyer la requête ; relancer à l’identique ne fait que gaspiller du quota |
| Panne durable | Incident massif en amont | Non | Couper le canal concerné et basculer vers un canal de secours dont l’état de santé a été vérifié |
Deux pièges sont à éviter. Premièrement, la plateforme a indiqué que les erreurs 500 renvoyées par -all correspondent généralement à une violation de contenu (non facturée). Depuis mai, pour -all et -vip, les erreurs 500 liées à la sécurité sont renvoyées directement avec leur motif, sans relance interne. Le client doit donc lire le message d’erreur plutôt que de renvoyer systématiquement la requête à chaque 5xx. Deuxièmement, -vip a déjà renvoyé des « Unknown error ». D’après l’expérience de la plateforme, il suffit de compresser chaque image d’entrée à moins de 1,5 Mo.
Exemple minimaliste
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
    timeout=600,  # La génération d'images via le canal officiel est lente ; la plateforme a déjà recommandé 360 à 600 secondes
)

resp = client.images.generate(
    model="gpt-image-2.5-flare",
    prompt="一只在咖啡馆窗边看书的橘猫,柔和晨光,写实摄影风格",
    size="1536x1024",
)
item = resp.data[0]
print(item.b64_json[:60] if item.b64_json else item.url)
Voir le code complet : multi-canaux avec nouvelle tentative, coupe-circuit et repli
import time
import random
import logging
import openai
from openai import OpenAI

logging.basicConfig(level=logging.INFO)
BASE_URL = "https://api.apiyi.com/v1"

# Les canaux sont classés par priorité ; chaque groupe utilise un jeton différent
CHANNELS = [
    {"name": "official", "model": "gpt-image-2.5-flare",
     "key": "KEY_DEFAULT", "params": {"size": "1536x1024", "quality": "high"}},
    # À activer uniquement si le compte est éligible au groupe image2Enterprise
    {"name": "official-enterprise", "model": "gpt-image-2.5-flare",
     "key": "KEY_ENTERPRISE", "params": {"size": "1536x1024", "quality": "high"}},
    # Pour -vip, remplacez size par l'un des 30 préréglages indiqués dans la documentation
    {"name": "vip", "model": "gpt-image-2.5-flare-vip",
     "key": "KEY_DEFAULT", "params": {"size": "1536x1024"}},
    # -all ne prend pas en charge size / quality / n, on ne passe que le prompt
    {"name": "all", "model": "gpt-image-2.5-all",
     "key": "KEY_DEFAULT", "params": {}},
]

FAIL_THRESHOLD = 3     # Nombre d'échecs consécutifs avant l'ouverture du disjoncteur (valeur d'exemple)
COOLDOWN = 120         # Durée de refroidissement du disjoncteur en secondes (valeur d'exemple)
MAX_RETRY = 2          # 5xx / timeout : 2 nouvelles tentatives au maximum
breaker = {c["name"]: {"fails": 0, "open_until": 0} for c in CHANNELS}


def classify(err: Exception) -> str:
    msg = str(err).lower()
    if any(k in msg for k in ("safety", "content_policy", "moderation", "violat")):
        return "content"
    if isinstance(err, openai.RateLimitError):
        return "rate_limit"
    if isinstance(err, openai.APITimeoutError):
        return "timeout"
    if isinstance(err, openai.APIStatusError):
        if err.status_code == 408:
            return "timeout"
        if err.status_code >= 500:
            return "server"
        return "fatal"
    if isinstance(err, openai.APIConnectionError):
        return "network"
    return "fatal"


def generate(prompt: str, need_mask: bool = False):
    for ch in CHANNELS:
        if need_mask and ch["name"] in ("vip", "all"):
            continue  # Pas de repli vers les canaux inversés pour l'édition précise
        state = breaker[ch["name"]]
        if time.time() < state["open_until"]:
            continue  # Disjoncteur ouvert sur ce canal
        client = OpenAI(api_key=ch["key"], base_url=BASE_URL, timeout=600)
        for attempt in range(MAX_RETRY + 1):
            try:
                resp = client.images.generate(
                    model=ch["model"], prompt=prompt, **ch["params"])
                state["fails"] = 0
                logging.info("ok channel=%s model=%s", ch["name"], ch["model"])
                return ch["name"], resp.data[0]
            except Exception as e:
                kind = classify(e)
                logging.warning("fail channel=%s model=%s kind=%s req_id=%s",
                                ch["name"], ch["model"], kind,
                                getattr(e, "request_id", None))
                if kind in ("content", "fatal"):
                    raise  # Problème de contenu ou de paramètres : modifier la requête, ne pas réessayer
                if attempt < MAX_RETRY:
                    time.sleep(2 ** (attempt + 1) + random.uniform(0, 1))
        state["fails"] += 1
        if state["fails"] >= FAIL_THRESHOLD:
            state["open_until"] = time.time() + COOLDOWN
    raise RuntimeError("所有 GPT-Image 通道均不可用")
🚀 Démarrage rapide : commencez par utiliser le crédit de test gratuit offert aux nouveaux utilisateurs sur APIYI apiyi.com pour faire un test A/B entre les canaux officiel, -vip et -all : même invite, même taille, et notez pour chacun le temps de réponse, le taux de réussite et les différences visuelles. Vous pourrez ensuite définir l’ordre entre canal principal et canaux de secours.
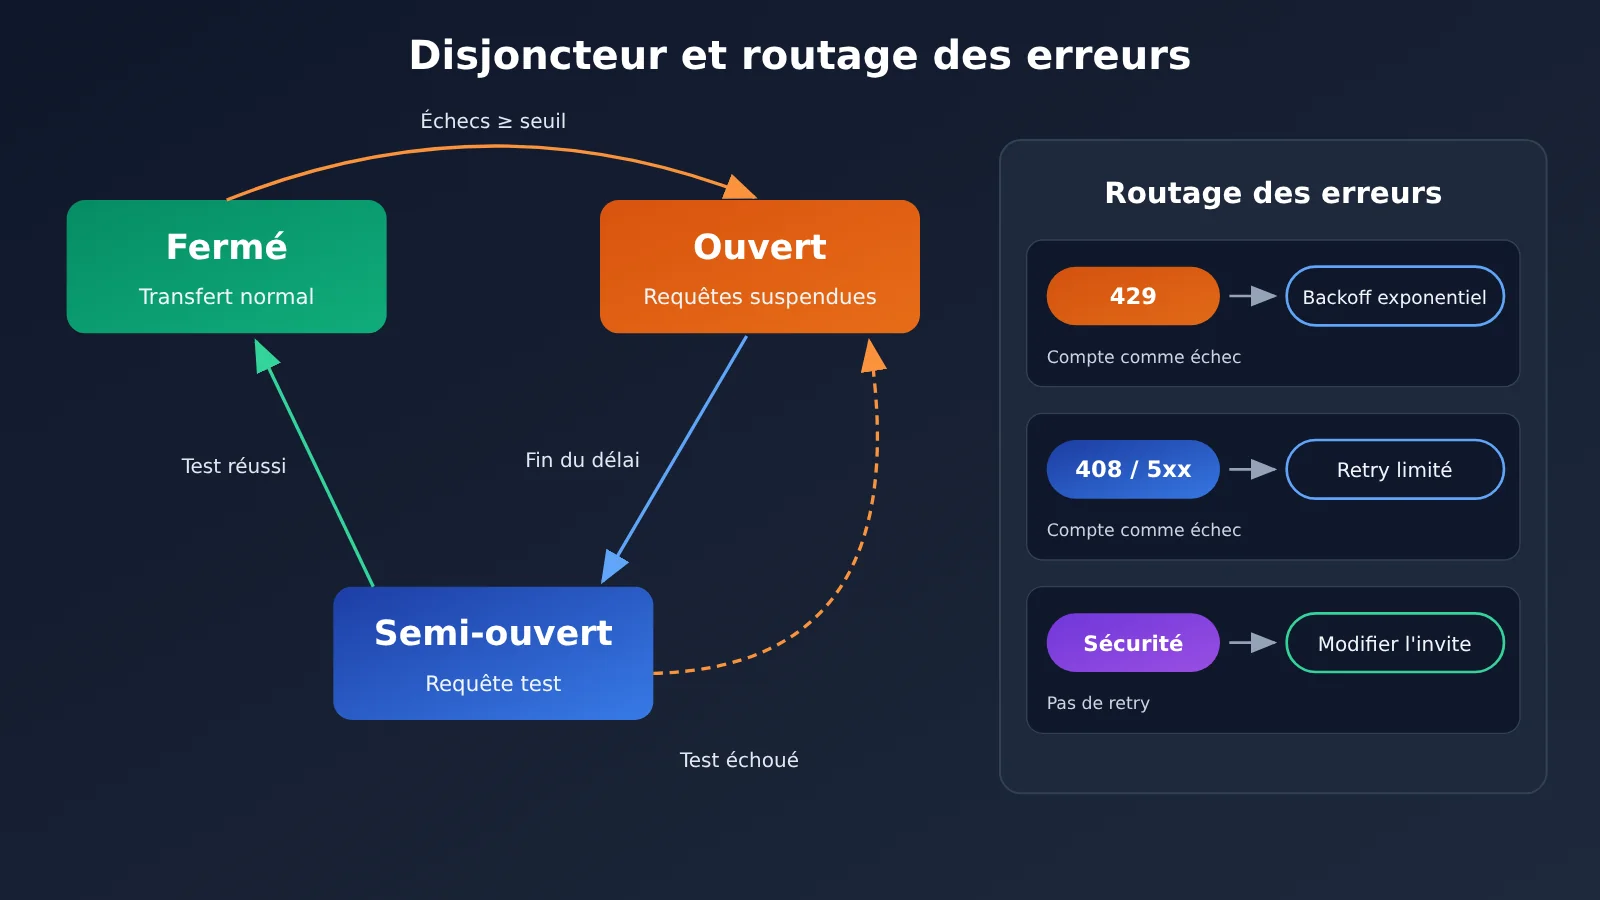
Recommandations de choix de canal pour GPT-Image
Si vous ne deviez retenir qu’un seul principe : choisissez le canal principal en fonction des contraintes strictes de votre métier, et le canal de secours en fonction de l’origine des pannes. Si votre cas d’usage exige une édition précise par masque (mask), la redondance ne peut se faire qu’à l’intérieur du canal officiel, par exemple en combinant le groupe par défaut et un groupe entreprise. Si vous avez seulement besoin de générer des images entières, vous pouvez combiner « canal officiel + -vip » ou « -all + -vip » : deux lignes dont les pannes ont des origines différentes se servent alors mutuellement de filet de sécurité. Pensez aussi à consigner, pour chaque requête, le modèle réellement utilisé, le canal et le request_id. Cela facilite le rapprochement des factures et le dépannage après coup.
💡 Conseil : les performances d’un canal évoluent avec les ressources en amont, et une stabilité passée ne garantit pas une stabilité future. Nous vous recommandons de brancher au moins deux canaux via l’interface unifiée d’APIYI (apiyi.com), puis de lancer régulièrement des vérifications de santé avec un petit volume de trafic, plutôt que de figer votre choix sur la base d’un seul test.
FAQ : questions fréquentes
Q1 : Qu’est-ce que « 官转 » (relais officiel) et « 官逆 » (relais inversé) pour GPT-Image ?
Le « 官转 » désigne la ligne qui transmet directement les requêtes vers l’API Images officielle d’OpenAI. Le « 官逆 » est la catégorie que la plateforme utilise pour les ressources d’accès par rétro-ingénierie : elle regroupe le suffixe -all, basé sur la ligne web de ChatGPT, et le suffixe -vip, que la documentation de la plateforme décrit comme une ligne Adobe/Firefly. Le « 官逆 » n’est pas une API fournie officiellement par OpenAI.
Q2 : Quelle est la différence entre GPT-Image -all et -vip ?
Les deux sont facturés à l’unité. -all coûte 0,025 $/image et ne prend en charge ni size, ni quality, ni la 4K. -vip coûte 0,03 $/image et propose 30 tailles prédéfinies ainsi qu’une 4K prédéfinie. Mais le comportement des paramètres dépend du canal : par le passé, size a cessé de fonctionner avant de revenir.
Q3 : GPT-Image 2.6 existe-t-il aussi en versions -all et -vip ?
Dans le registre des modèles au 2026-11-11, seuls deux modèles facturés au token figurent : gpt-image-2.6-flare et gpt-image-2.6-sunburst. Il n’y a pas de version -all ou -vip pour la 2.6. N’appliquez donc pas à la 2.6 les capacités de la 2.5 VIP.
Q4 : Le groupe entreprise image2Enterprise garantit-il l’absence de pannes ?
Non. Il a tenu bon à plusieurs reprises quand le groupe par défaut était saturé, mais il a aussi été touché par une panne en amont chez OpenAI le 2026-05-07. Son multiplicateur est de 1,2x, et l’éligibilité à son activation dépend de ce qu’affiche la console. Il sert de redondance au sein du relais officiel, pas d’assurance tous risques.
Q5 : Comment tester rapidement plusieurs canaux GPT-Image via l’API ?
1. Créez un compte sur APIYI (apiyi.com) pour obtenir une clé API et un crédit de test gratuit ;
2. Définissez base_url sur `https://api.apiyi.com/v1`, puis changez le paramètre model en suivant le code de cet article ;
3. Appelez chaque canal avec la même invite et notez le temps de réponse, le taux de réussite et la qualité d’image.
Avec une interface unifiée, changer de canal revient à changer le nom du modèle : inutile de maintenir un SDK distinct pour chaque fournisseur en amont.
Q6 : Faut-il réessayer en boucle face à une erreur 5xx ?
Non. La documentation de la plateforme recommande de limiter les nouvelles tentatives à 2, avec un backoff exponentiel, pour les erreurs 5xx et les délais d’attente dépassés. Sur -all, une erreur 500 est généralement liée à une violation de contenu : réessayer ne servira à rien. Une fois le nombre de tentatives dépassé, coupez le canal courant (circuit breaker) et basculez sur un canal de secours.
Q7 : Quelles sont les limites connues des canaux GPT-Image ?
– Avec le relais officiel, une invite de plus de 8192 tokens environ ne déclenche pas d’erreur, mais l’image générée devient brouillonne ;
– Le fond transparent de gpt-image-2 a été désactivé officiellement : pour un fond transparent, utilisez le relais officiel de la 2.5 ;
– Les canaux inversés ne prennent pas en charge le paramètre n ni les masques précis ;
– Pour -vip, mieux vaut compresser l’image d’entrée sous 1,5 Mo.
Points clés pour choisir un canal GPT-Image
- Trois types de canaux : le canal « officiel » (官转) passe par l’API Images officielle, le canal -all dépend de la version web de ChatGPT, et le canal -vip repose sur le pool de comptes de la plateforme ;
- Différences de paramètres : seul le canal officiel prend en charge pleinement n’importe quelle valeur de size, le paramètre n et l’édition avec masque précis ;
- Différences de facturation : le canal officiel facture au jeton, le canal -all à 0,025 $ l’image, le canal -vip à 0,03 $ l’image ;
- Groupe entreprise : image2Enterprise est un groupe de jetons avec un multiplicateur de 1,2x, pas un modèle à part ;
- Profil des pannes : chaque canal a sa propre source de pannes, et l’on a souvent vu par le passé un canal en panne alors qu’un autre fonctionnait normalement ;
- Règles de relance : en cas d’erreur 429, relancez avec un délai croissant ; pour les erreurs 5xx et les timeouts, 2 tentatives maximum ; pas de relance pour les erreurs de sécurité du contenu ;
- Pour démarrer : branchez les deux canaux via l’interface unifiée d’APIYI, puis départagez le canal principal et le canal de secours par un test A/B.
Conclusion
Voici l’essentiel à retenir pour choisir un canal GPT-Image :
- Choisissez le canal principal selon vos contraintes dures : si vous avez besoin d’une édition précise et de tailles libres, optez pour le canal officiel ; si vous cherchez un prix fixe et bas, prenez -all ; si vous voulez de la 4K facturée à l’image, choisissez -vip ;
- Choisissez le canal de secours selon l’origine des pannes : les dépendances amont du canal principal et du canal de secours ne doivent pas se recouper, car un canal unique finira tôt ou tard par subir une saturation des ressources ou une panne en amont ;
- Prévoyez un filet de sécurité selon le type d’erreur : relances limitées, backoff exponentiel, coupe-circuit avec temps de refroidissement et journalisation — il faut mettre en place ces quatre éléments.
L’historique des incidents le montre : aucun canal GPT-Image ne peut garantir zéro panne sur la durée. La fiabilité vient de l’architecture, pas du pari sur une route en particulier. Nous vous recommandons de vous connecter à plusieurs canaux avec la même clé via APIYI (apiyi.com), de lancer d’abord un test comparatif sur un petit volume de trafic, puis de fixer votre configuration principal/secours.
📚 Références
- Archives des actualités en temps réel d’APIYI : historique des états de chaque canal GPT-Image, changements de prix et mises à jour de la documentation
- Lien :
docs.apiyi.com/live/archive -
Remarque : c’est la source de la chronologie du post-mortem de cet article. Pour connaître l’état actuel, référez-vous toujours aux derniers bulletins.
-
Registre des modèles d’APIYI : identifiants de modèles, types de facturation, groupes visibles et multiplicateurs de groupe
- Lien :
docs.apiyi.com/model-registry.json -
Remarque : les données citées dans cet article ont été générées le 2026-11-11, et les prix sont ceux du catalogue avant remise.
-
Page d’état d’OpenAI : état officiel des services d’OpenAI
- Lien :
status.openai.com - Remarque : la plateforme a déjà recommandé de surveiller cette page pour savoir si une panne du canal officiel vient bien de l’amont.
Auteur : l’équipe technique d’APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI. Vous trouverez d’autres ressources sur l’intégration de GPT-Image dans le centre de documentation docs.apiyi.com.