Nota del autor: comparo los tres tipos de canal de GPT-Image (oficial/官转, -all y -vip) en facturación, tamaños y edición local, repaso las incidencias históricas de abril a octubre de 2026 y propongo un plan de contingencia basado en «reintentos limitados + circuit breaker + canal de respaldo».
Quien integra GPT-Image se topa pronto con un problema: el mismo modelo de imagen aparece en la plataforma con varios nombres distintos. El canal oficial (官转, por ejemplo gpt-image-2.5-flare), el -all y el -vip se facturan de forma distinta, tienen capacidades de parámetros diferentes y fallan por motivos distintos. En este artículo comparo los tres canales de GPT-Image en esas dimensiones y te doy una propuesta de selección y de contingencia que puedes aplicar directamente.
Esto no es un análisis de «cada uno tiene sus ventajas». Los juicios que verás aquí se basan en la página de comparación de canales del centro de documentación de APIYI, en el registro de modelos y en los avisos de estado en tiempo real de abril a octubre de 2026. Distinguiremos entre lo que son anuncios de la plataforma, lo que son pruebas hechas por la plataforma y lo que es solo registro histórico.
Valor clave: al terminar de leer sabrás qué canal de GPT-Image usar como principal y cuál como respaldo según tu negocio, y qué debe hacer tu programa ante un 429, un 408 o un 5xx.
Qué son los canales de GPT-Image: 官转, 官逆 y el grupo empresarial
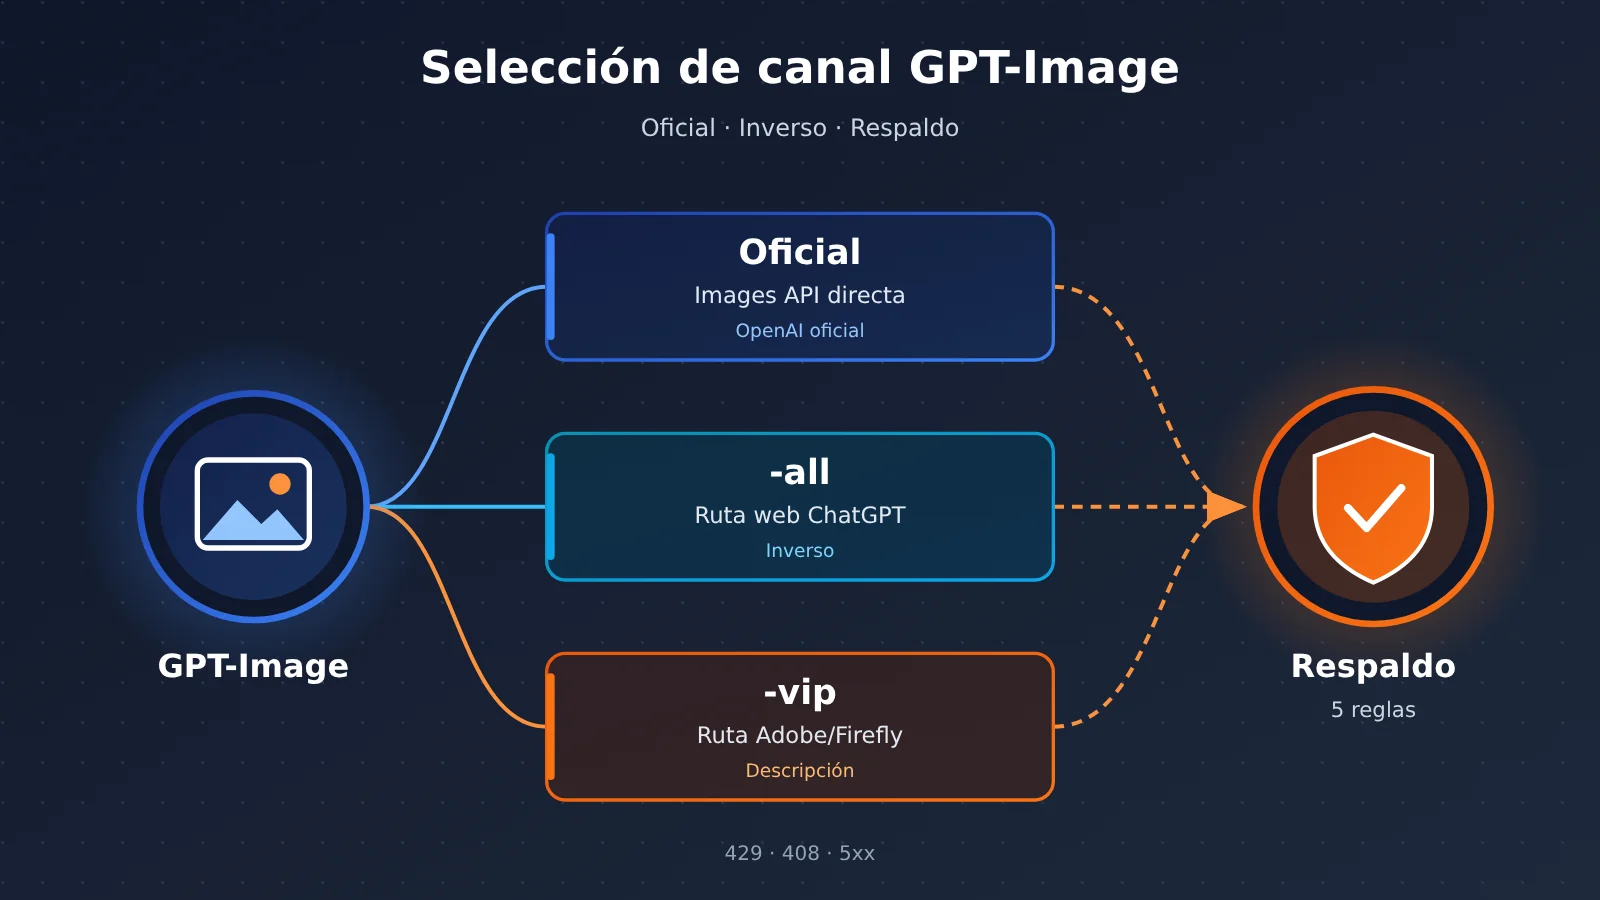
«官转» (guānzhuǎn) y «官逆» (guānnì) son categorías que usa la plataforma APIYI para clasificar sus canales; no son términos oficiales de OpenAI. 官转 se refiere a las rutas que reenvían las solicitudes directamente a la API oficial de Imágenes de OpenAI. 官逆 se refiere a recursos conectados mediante ingeniería inversa, es decir, de forma no oficial, y no significa que OpenAI ofrezca esas API inversas.
| Tipo de canal | Definición en la documentación de la plataforma | Modelos representativos | Dependencia principal aguas arriba |
|---|---|---|---|
| 官转 | Reenvío directo a la API oficial de Imágenes de OpenAI | gpt-image-2.5-flare, gpt-image-2.5-sunburst | Capacidad de cómputo y cuota de la API de OpenAI |
| -all (官逆) | Acceso por ingeniería inversa a la ruta web de ChatGPT | gpt-image-2-all, gpt-image-2.5-all | Disponibilidad de la versión web de ChatGPT |
| -vip (官逆) | La documentación de la plataforma lo describe como recursos inversos de la ruta Adobe / Firefly | gpt-image-2-vip, gpt-image-2.5-flare-vip, gpt-image-2.5-sunburst-vip | Concurrencia del pool de cuentas de la plataforma y control de riesgos aguas arriba |
El papel del grupo empresarial image2Enterprise en GPT-Image
Mucha gente confunde image2Enterprise con un modelo independiente, pero en realidad es un grupo de tokens. Se añadió el 2026-04-25, con un multiplicador de catálogo de 1.2x, mientras que los grupos Default, image2_OSS y SVIP tienen un multiplicador de 1.0x. Tanto el 2026-04-27 como el 2026-09-21 hubo situaciones en las que los recursos del grupo por defecto estaban saturados y el grupo empresarial seguía estable, así que en su momento funcionó como ruta de respaldo para 官转.
El grupo empresarial también tiene sus límites. El 2026-05-07, el 官转 del grupo empresarial se vio igualmente afectado por una caída aguas arriba de OpenAI, lo que demuestra que puede aliviar la congestión del grupo por defecto, pero no evita todos los problemas del proveedor original. Además, que el registro de modelos liste un grupo no significa que todas las cuentas puedan usarlo; las condiciones de activación concretas dependen de lo que indique la consola.
GPT-Image 2.6 y su frontera con los canales anteriores
A fecha de 2026-11-11, el registro de modelos de APIYI ya incluye gpt-image-2.6-flare y gpt-image-2.6-sunburst, dos modelos facturados por Token, pero no lista variantes -all ni -vip para la 2.6. Por tanto, las capacidades de tamaño y calidad de 2.5 VIP no se pueden extrapolar directamente a la 2.6. Otro detalle: la página comparativa indica que la conexión directa oficial del antiguo gpt-image-2 se cerró el 2026-09-30, aunque el registro todavía conserva ese ID. Para proyectos nuevos, lo recomendable es usar directamente 2.5 Flare o Sunburst en los ejemplos de 官转. Según las notas de lanzamiento de la plataforma, flare genera imágenes más rápido y sunburst tiene mejores capacidades de edición.
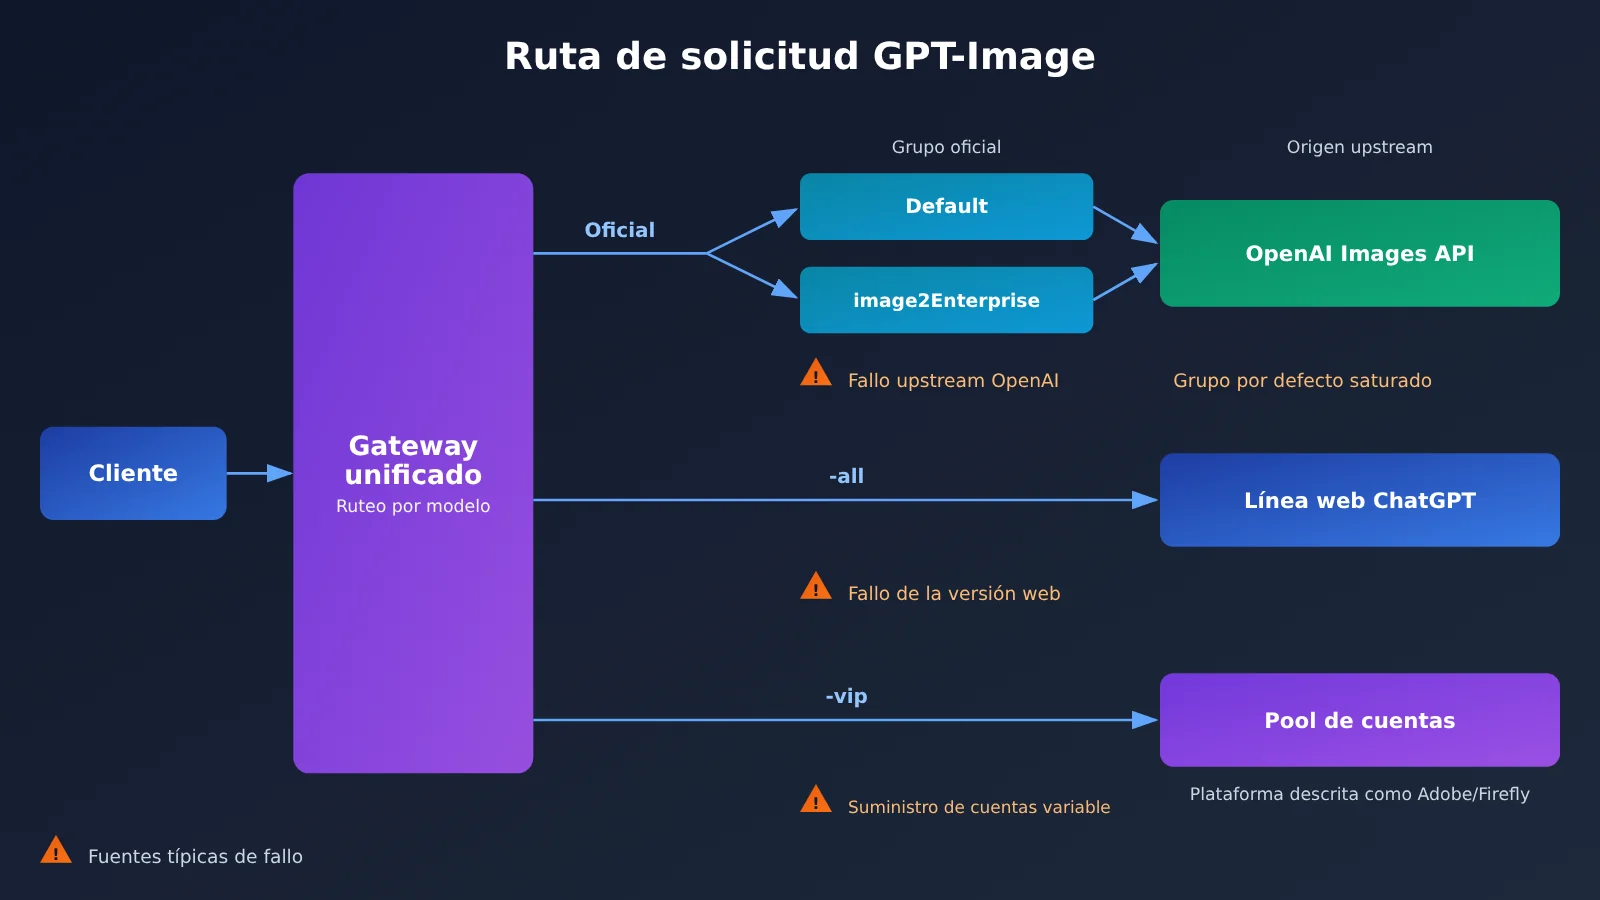
GPT-Image: canal oficial (官转) vs -all vs -vip, diferencias clave
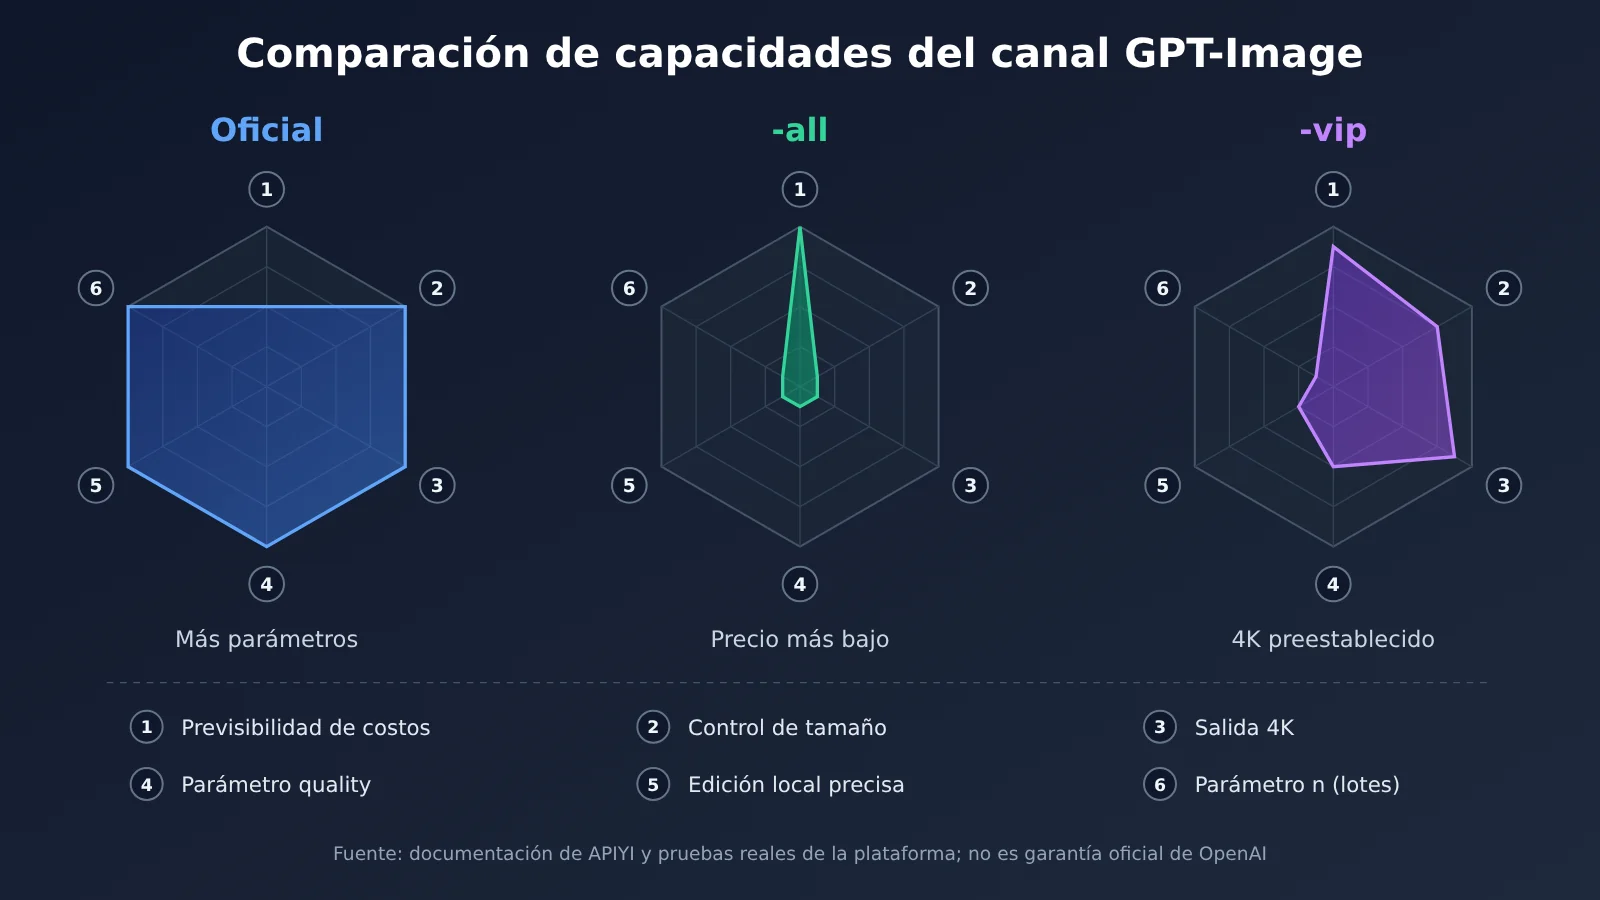
| Dimensión | Canal oficial (2.5 flare / sunburst) | -all | -vip | Ganador |
|---|---|---|---|---|
| Facturación | Por token, varía según tamaño y calidad | $0.025/imagen (desde el 2026-10-10) | $0.03/imagen | Costo predecible: -all |
| Parámetro size | Cualquier tamaño válido | No soportado | 30 tamaños habituales | Canal oficial |
| Salida 4K | Soportada | No soportada | Soporta 4K predefinido | Canal oficial / -vip |
| Parámetro quality | Soportado con el parámetro oficial | No soportado | Comportamiento propio del canal; el rango varía según el modelo | Canal oficial |
| Generar varias imágenes (n) | Soportado | No soportado | No soportado | Canal oficial |
| Repintado local preciso con mask | Soportado | No soportado | No garantizado, solo se puede repintar la imagen completa | Canal oficial |
| Uso típico | Control de parámetros, edición precisa | Generación masiva a precio fijo | Precio fijo, tamaños predefinidos y 4K | — |
Cómo interpretar la comparación entre canales de GPT-Image
Canal oficial: es el más completo en parámetros. size, quality, n y mask funcionan igual que en la Images API oficial, así que encaja bien en producción cuando necesitas un control fino. Eso sí, se factura por token, de modo que el costo por imagen sube con tamaños grandes y alta calidad, y no se puede comparar directamente con un precio por llamada. En las pruebas de la plataforma también vimos que el límite de la indicación en el canal oficial ronda los 8192 tokens: si te pasas no da error, pero la imagen sale desordenada, así que conviene recortar las indicaciones largas en el cliente. Además, OpenAI ha desactivado oficialmente el fondo transparente en gpt-image-2; si lo necesitas, la plataforma recomienda usar el canal oficial 2.5.
-all: su ventaja es el precio fijo y el más bajo, ideal para generar muchas imágenes cuando la composición no es crítica. No soporta size, quality, n ni mask, así que lo mejor es enviar solo el prompt. Depende de la versión web de ChatGPT, por lo que si la web falla, -all se ve afectado al mismo tiempo.
-vip: queda a medio camino. Cobra por llamada y ofrece tamaños predefinidos y 4K, lo que lo hace adecuado cuando quieres un costo fijo y alta resolución. El comportamiento de sus parámetros depende del canal, no es una garantía oficial. Los niveles de calidad xhigh y max de 2.5 VIP se habilitaron según las pruebas de la plataforma, y no debes asumir que todos los modelos de ingeniería inversa tienen esa capacidad.
Nota sobre la comparación: los precios de la tabla corresponden al catálogo de la plataforma APIYI (antes de bonos por recarga y descuentos por grupo), no a las tarifas por imagen de OpenAI. El precio final es el que aparece en la consola de apiyi.com.
Análisis retrospectivo de fallos históricos en los canales de GPT-Image: por qué no conviene apostar todo a una sola ruta
Si solo miras la tabla de funciones, te pierdes un factor clave: los tres tipos de canal fallan por motivos distintos y se recuperan a ritmos distintos. A continuación recopilo eventos representativos de los avisos de estado de la plataforma entre abril y octubre de 2026. Son registros históricos y no reflejan el estado actual.
| Fecha (2026) | Canal | Síntoma | Explicación / recomendación de la plataforma |
|---|---|---|---|
| 23–27 de abril | Grupo predeterminado de官转 (conversión oficial) | Alerta de concurrencia, límites temporales, errores 429 / 408 | Se recomienda cambiar a image2Enterprise y subir el timeout a 360–600 segundos |
| 7 de mayo | Grupo empresarial de官转 | Errores | La causa raíz estaba en el upstream de OpenAI |
| 9 de mayo | Grupo predeterminado de官转 | Saturación otra vez | Se recomienda cambiar el token al grupo empresarial |
| 16–23 de junio | -vip | El parámetro size dejó de funcionar; la resolución llegó a bajar a 1.5K y 1K | Se atribuyó a un ajuste de reglas del upstream; hubo una breve recuperación en ese periodo |
| 7–13 de julio | -all | Fallos del upstream, timeouts | Se redirigió temporalmente al canal vip y después se repuso saldo por las llamadas con timeout |
| 24–25 de agosto | -vip | Limitación de velocidad por control de riesgos del upstream, saturación | Los 429 se pueden reintentar; los errores de seguridad de contenido no hace falta reintentarlos |
| 10–15 de septiembre | 2.5 -vip | Afectado por 429, recursos insuficientes | 官转 y -all funcionaron con normalidad en el mismo periodo |
| 15 de octubre | -all / -vip | -all afectado por una caída de la versión web de ChatGPT; -vip con carga demasiado alta | Si 官逆 (ingeniería inversa oficial) no está disponible, se recomienda usar primero 官转 como respaldo |
| 19 de octubre | 2.5 -vip | Saturación de concurrencia | Se están ampliando los recursos |
Patrones de fallo en los canales de GPT-Image
Si juntamos todos estos registros, se distinguen cuatro patrones típicos:
- Recursos insuficientes en el grupo predeterminado de 官转: se manifiesta con 429 y 408. El grupo empresarial alivia una parte, pero no evita las caídas del propio upstream de OpenAI.
- -all sigue las caídas de la versión web: en cuanto la versión web de ChatGPT tiene un problema, -all da errores o se ralentiza a la vez. Los tiempos registrados por la plataforma han ido desde unos 40 segundos hasta unos 80.
- -vip: saturación del pool de recursos y deriva de parámetros: además de los 429, hubo casos en que size y quality dejaron de funcionar de repente y luego volvieron. La propia disponibilidad de los parámetros no es estable.
- Varios canales funcionando a la vez: el 10 y el 15 de septiembre, cuando -vip no estaba disponible, 官转 y -all seguían funcionando con normalidad. Ahí es donde se ve el valor de conectarse a dos canales.
Conviene aclarar el límite temporal: en el archivo hasta el 11 de noviembre de 2026, el último aviso que trata claramente el estado de salud de los canales de GPT-Image es el del 19 de octubre. Los registros del 5 y el 9 de noviembre corresponden al lanzamiento de 2.6 y a actualizaciones de documentación, no son avisos de estado. Por eso este artículo no ofrece un ranking de estabilidad del día, y los datos históricos de tiempos de respuesta tampoco deben tomarse como un SLA.
Recomendaciones de canal para GPT-Image
Cuándo elegir el canal oficial (官转)
- Imágenes principales de e-commerce y anuncios: necesitas indicar un tamaño exacto o 4K, y además controlar la calidad con
quality. - Repintado local y cambio de fondo: dependen de editar con precisión mediante
mask. El canal -vip solo puede repintar la imagen completa y -all no admitemask. - Ya tienes código con el SDK de OpenAI: es el que mejor compatibilidad de parámetros ofrece y el que menos cuesta migrar.
Cuándo elegir -all
- Material en lote y bocetos para inspirarte: no tienes requisitos estrictos de tamaño y lo que más te importa es un precio fijo y bajo.
- Producción de contenido con presupuesto ajustado: el precio fijo de $0.025 por imagen facilita mucho el cálculo de costes.
Cuándo elegir -vip
- Necesitas 4K pero prefieres pagar por uso: basta con usar los tamaños preestablecidos que ofrece la plataforma.
- Generas sobre todo imágenes completas y no necesitas edición local precisa: puedes aceptar cierta variación en los parámetros debido al comportamiento del canal.
| Escenario de negocio | Canal principal recomendado | Respaldo recomendado | Qué tener en cuenta al degradar |
|---|---|---|---|
| Edición local precisa | Oficial sunburst | Grupo empresarial oficial (si cumples los requisitos) | No bajes a -all / -vip: el mask dejaría de funcionar |
| Imágenes comerciales con tamaño definido | Oficial flare | Tamaños preestablecidos de -vip | Los tamaños de respaldo deben ajustarse a los 30 tamaños preestablecidos |
| 4K en alta definición con coste fijo | -vip | Oficial | Al cambiar, la facturación pasa a ser por Token |
| Generación masiva de imágenes | -all | -vip (también se factura por uso) | El coste por imagen pasa de $0.025 a $0.03 |
| Necesitas n variantes | Oficial | Varias llamadas en bucle a -all | Los canales inversos no admiten el parámetro n |
Estrategia de respaldo para canales GPT-Image: reintentos, circuit breaker y degradación
Un buen respaldo no consiste en «reenviar la petición cada vez que falla». Primero hay que identificar el tipo de error y después elegir qué hacer.
| Tipo de error | Causas habituales | ¿Reintentar? | Tratamiento recomendado |
|---|---|---|---|
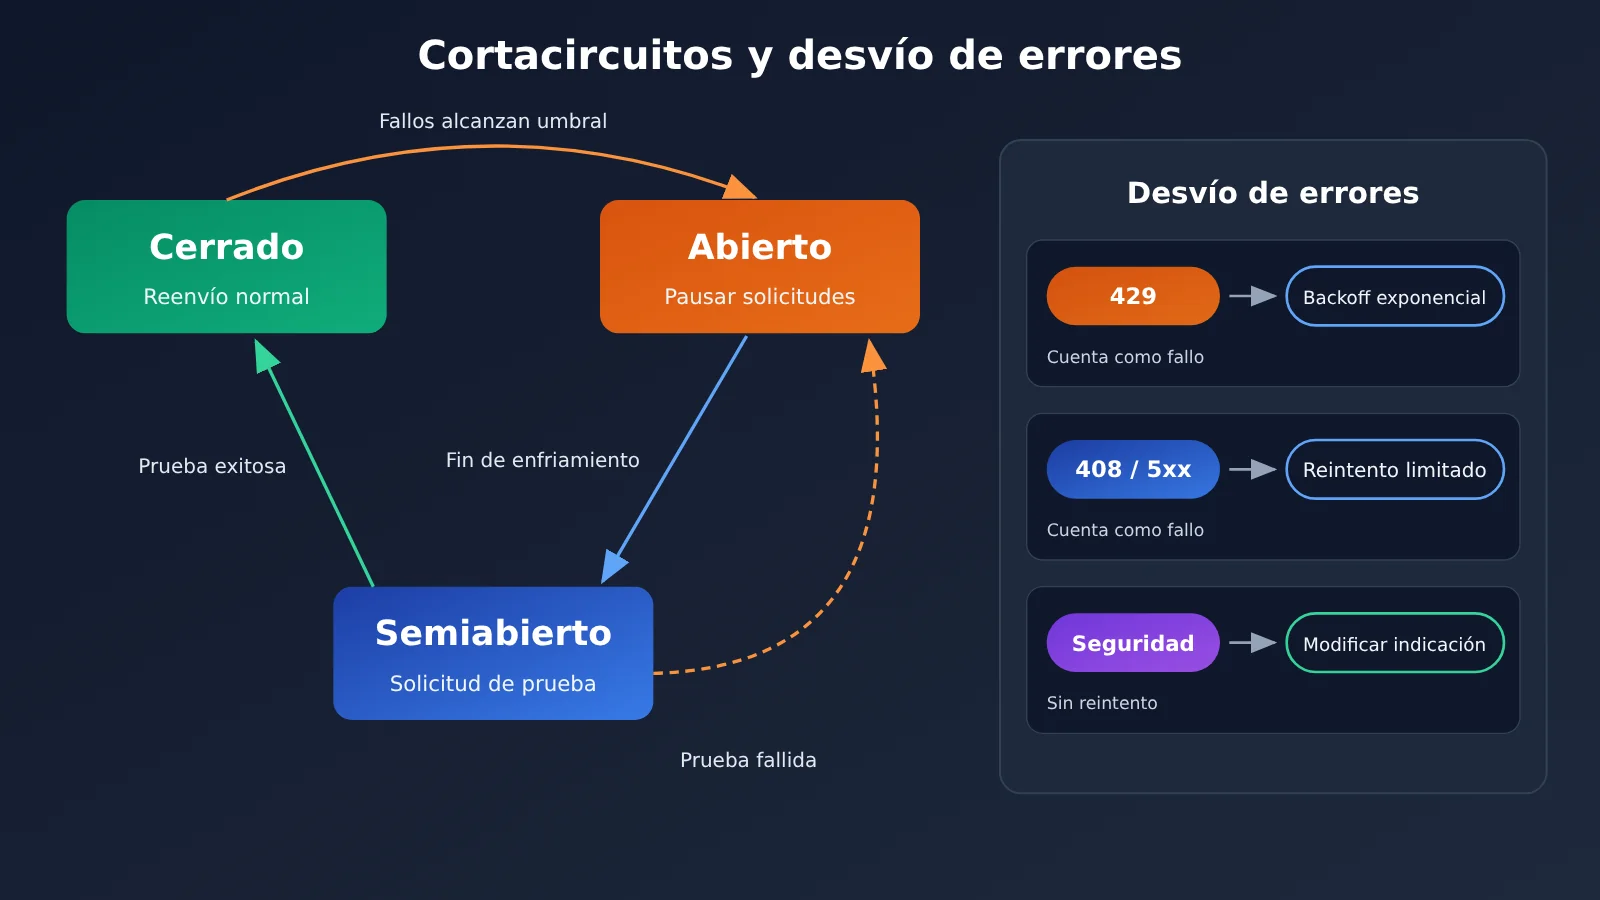
| 429 | Límite de concurrencia o de velocidad, pool de recursos saturado | Sí, con espera obligatoria | Backoff exponencial con jitter aleatorio; tras fallos consecutivos, abrir el circuit breaker y cambiar de canal |
| 408 / timeout del cliente | El servicio upstream tarda en generar la imagen, o el timeout configurado es demasiado corto | Reintentos limitados | Subir el timeout del canal oficial a 360–600 segundos y reintentar como máximo 2 veces |
| 5xx (error del sistema) | Fallo de la plataforma o del upstream | Reintentos limitados | Máximo 2 reintentos con backoff exponencial; si sigue fallando, cambiar al canal de respaldo |
| Error de seguridad de contenido | La indicación o la imagen de entrada activan la moderación | No | Modificar el contenido antes de volver a enviar; repetir la misma petición solo gasta cuota |
| Sin recuperación prolongada | Caída generalizada del upstream | No | Abrir el circuit breaker del canal actual y pasar a un canal de respaldo que haya superado el health check |
Hay dos trampas en las que es fácil caer. La primera: la plataforma ha explicado que el 500 devuelto por -all suele indicar una infracción de contenido (no se cobra). Además, desde mayo, los 500 de seguridad de -all/-vip se informan directamente y ya no se reintentan internamente. Por eso el cliente debe leer el mensaje de error y no reenviar la petición cada vez que vea un 5xx. La segunda: -vip ha llegado a devolver «Unknown error», y la experiencia de la plataforma indica que conviene comprimir cada imagen de entrada a menos de 1,5 MB.
Ejemplo mínimo
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
    timeout=600,  # La generación por el canal oficial es lenta; la plataforma ha recomendado entre 360 y 600 segundos
)

resp = client.images.generate(
    model="gpt-image-2.5-flare",
    prompt="一只在咖啡馆窗边看书的橘猫,柔和晨光,写实摄影风格",
    size="1536x1024",
)
item = resp.data[0]
print(item.b64_json[:60] if item.b64_json else item.url)
Ver el código completo: múltiples canales con reintentos + cortacircuitos + degradación
import time
import random
import logging
import openai
from openai import OpenAI

logging.basicConfig(level=logging.INFO)
BASE_URL = "https://api.apiyi.com/v1"

# Los canales están ordenados por prioridad; cada grupo usa un token distinto
CHANNELS = [
    {"name": "official", "model": "gpt-image-2.5-flare",
     "key": "KEY_DEFAULT", "params": {"size": "1536x1024", "quality": "high"}},
    # Solo se activa si la cuenta cumple los requisitos del grupo image2Enterprise
    {"name": "official-enterprise", "model": "gpt-image-2.5-flare",
     "key": "KEY_ENTERPRISE", "params": {"size": "1536x1024", "quality": "high"}},
    # El size de -vip debe sustituirse por uno de los 30 presets de la documentación
    {"name": "vip", "model": "gpt-image-2.5-flare-vip",
     "key": "KEY_DEFAULT", "params": {"size": "1536x1024"}},
    # -all no admite size / quality / n, solo se envía prompt
    {"name": "all", "model": "gpt-image-2.5-all",
     "key": "KEY_DEFAULT", "params": {}},
]

FAIL_THRESHOLD = 3     # Número de fallos consecutivos antes de abrir el cortacircuitos (valor de ejemplo)
COOLDOWN = 120         # Segundos de enfriamiento del cortacircuitos (valor de ejemplo)
MAX_RETRY = 2          # Máximo 2 reintentos ante errores 5xx / timeout
breaker = {c["name"]: {"fails": 0, "open_until": 0} for c in CHANNELS}


def classify(err: Exception) -> str:
    msg = str(err).lower()
    if any(k in msg for k in ("safety", "content_policy", "moderation", "violat")):
        return "content"
    if isinstance(err, openai.RateLimitError):
        return "rate_limit"
    if isinstance(err, openai.APITimeoutError):
        return "timeout"
    if isinstance(err, openai.APIStatusError):
        if err.status_code == 408:
            return "timeout"
        if err.status_code >= 500:
            return "server"
        return "fatal"
    if isinstance(err, openai.APIConnectionError):
        return "network"
    return "fatal"


def generate(prompt: str, need_mask: bool = False):
    for ch in CHANNELS:
        if need_mask and ch["name"] in ("vip", "all"):
            continue  # La edición precisa no se degrada a canales de ingeniería inversa
        state = breaker[ch["name"]]
        if time.time() < state["open_until"]:
            continue  # Canal con el cortacircuitos abierto
        client = OpenAI(api_key=ch["key"], base_url=BASE_URL, timeout=600)
        for attempt in range(MAX_RETRY + 1):
            try:
                resp = client.images.generate(
                    model=ch["model"], prompt=prompt, **ch["params"])
                state["fails"] = 0
                logging.info("ok channel=%s model=%s", ch["name"], ch["model"])
                return ch["name"], resp.data[0]
            except Exception as e:
                kind = classify(e)
                logging.warning("fail channel=%s model=%s kind=%s req_id=%s",
                                ch["name"], ch["model"], kind,
                                getattr(e, "request_id", None))
                if kind in ("content", "fatal"):
                    raise  # Problema de contenido o de parámetros: hay que cambiar la petición, no reintentar
                if attempt < MAX_RETRY:
                    time.sleep(2 ** (attempt + 1) + random.uniform(0, 1))
        state["fails"] += 1
        if state["fails"] >= FAIL_THRESHOLD:
            state["open_until"] = time.time() + COOLDOWN
    raise RuntimeError("所有 GPT-Image 通道均不可用")
🚀 Inicio rápido: te recomendamos empezar en APIYI (apiyi.com) con el crédito de prueba gratuito para usuarios nuevos y hacer una ronda de validación A/B entre los canales oficial (官转), -vip y -all: misma indicación, mismo tamaño, y anota por separado el tiempo de respuesta, la tasa de éxito y las diferencias en la imagen. Con esos datos, decide cuál será el canal principal y cuál el de respaldo.
Recomendaciones para elegir canal en GPT-Image
Si solo pudieras quedarte con un principio, sería este: elige el canal principal según las restricciones duras de tu negocio y el canal de respaldo según el origen de los fallos. Si tu caso necesita edición precisa con mask, solo podrás crear redundancia dentro del canal oficial (官转), por ejemplo combinando el grupo predeterminado con un grupo empresarial. Si solo necesitas generar la imagen completa, puedes combinar «oficial + -vip» o «-all + -vip», de modo que dos rutas con orígenes de fallo distintos se respalden entre sí. Además, en cada solicitud conviene registrar el modelo, el canal y el request_id que se usaron realmente, para facilitar la conciliación y el diagnóstico posterior.
💡 Recomendación: el rendimiento de los canales cambia según los recursos del proveedor upstream, y que hayan sido estables en el pasado no garantiza que lo sigan siendo. Te sugerimos integrar al menos dos canales a través de la interfaz unificada de APIYI (apiyi.com) y hacer comprobaciones de salud periódicas con un volumen pequeño de tráfico, en lugar de fijar una elección a largo plazo basándote en una sola prueba.
Preguntas frecuentes (FAQ)
Q1: ¿Qué son «官转» y «官逆» en GPT-Image?
«官转» (o ruta oficial) es la línea que reenvía las peticiones directamente a la API oficial de imágenes (Images API) de OpenAI. «官逆» (o ruta inversa) es la categoría que usa la plataforma para los recursos de acceso por ingeniería inversa. Incluye -all, basada en la línea web de ChatGPT, y -vip, que según la documentación de la plataforma es una línea de Adobe/Firefly. Las rutas «官逆» no son una API proporcionada oficialmente por OpenAI.
Q2: ¿Qué diferencia hay entre GPT-Image -all y -vip?
Ambas se cobran por solicitud. -all cuesta $0.025 por imagen y no admite size, quality ni 4K. -vip cuesta $0.03 por imagen y admite 30 tamaños predefinidos y 4K predefinido, pero el comportamiento de los parámetros depende del canal: en el pasado hubo casos en los que size dejó de funcionar y luego se restableció.
Q3: ¿GPT-Image 2.6 también tiene -all y -vip?
En el registro de modelos a fecha de 2026-11-11 solo aparecen dos modelos con cobro por token, gpt-image-2.6-flare y gpt-image-2.6-sunburst. No existen versiones -all ni -vip de 2.6. No des por hecho que las capacidades de 2.5 VIP se aplican a 2.6.
Q4: ¿El grupo empresarial image2Enterprise garantiza que no habrá fallos?
No. Funcionó de forma estable en varias ocasiones en que el grupo predeterminado estaba saturado, pero el 2026-05-07 también se vio afectado por una caída del upstream de OpenAI. Su multiplicador es 1.2x y la elegibilidad para activarlo se confirma en la consola. Sirve como redundancia dentro de la ruta oficial, pero no como seguro universal.
Q5: ¿Cómo pruebo rápidamente varios canales de GPT-Image mediante la API?
1. Regístrate en APIYI (apiyi.com) para obtener tu clave API y saldo de prueba gratuito.
2. Configura base_url como `https://api.apiyi.com/v1` y cambia el parámetro model según el código de este artículo.
3. Llama a cada canal con la misma indicación y registra el tiempo de respuesta, la tasa de éxito y la calidad de imagen.
Con una interfaz unificada, cambiar de canal solo requiere cambiar el nombre del modelo; no tienes que mantener un SDK distinto para cada upstream.
Q6: ¿Debo reintentar sin parar cuando aparece un 5xx?
No. La documentación de la plataforma recomienda hacer como máximo 2 reintentos con retroceso exponencial ante errores 5xx y timeouts. Un 500 en -all suele deberse a una infracción de contenido, así que reintentar no servirá. Superado el número de reintentos, conviene abrir el circuito del canal actual y pasar a uno de respaldo.
Q7: ¿Qué limitaciones conocidas tienen los canales de GPT-Image?
– Si la indicación en la ruta oficial supera aproximadamente 8192 tokens, no da error, pero la imagen sale desordenada.
– OpenAI ha desactivado el fondo transparente en gpt-image-2; si necesitas fondo transparente, usa 2.5 por la ruta oficial.
– Los canales inversos no admiten el parámetro n ni máscaras (mask) precisas.
– En -vip se recomienda comprimir la imagen de entrada a menos de 1.5 MB.
Puntos clave para elegir canal en GPT-Image (Key Takeaways)
- Tres tipos de canal: el canal oficial (官转) usa la Images API oficial, el canal -all depende de la versión web de ChatGPT y el canal -vip depende del pool de cuentas de la plataforma;
- Diferencias de parámetros: solo el canal oficial admite por completo cualquier
size,ny edición precisa con máscara (mask); - Diferencias de facturación: el canal oficial cobra por Token, el canal -all cuesta $0.025 por imagen y el canal -vip $0.03 por imagen;
- Grupo enterprise: image2Enterprise es un grupo de tokens con multiplicador 1.2x, no un modelo independiente;
- Patrón de fallos: cada canal falla por motivos distintos, y históricamente es habitual que uno caiga mientras el otro funciona con normalidad;
- Reglas de reintento: ante un 429, reintento con backoff; ante errores 5xx y timeouts, máximo 2 reintentos; los errores de seguridad de contenido no se reintentan;
- Cómo empezar: integra los dos canales bajo la interfaz unificada de APIYI y decide cuál va como principal y cuál como respaldo con pruebas A/B.
Resumen
Lo esencial para elegir canal en GPT-Image:
- Elige el canal principal según las restricciones duras: si necesitas edición precisa y tamaños arbitrarios, el canal oficial; si buscas un precio fijo y bajo, -all; si necesitas 4K con facturación por llamada, -vip;
- Elige el canal de respaldo según el origen de los fallos: las dependencias upstream del canal principal y del de respaldo no deben solaparse, porque tarde o temprano un canal único se topará con saturación de recursos o con una caída upstream;
- Cubre los errores según su tipo: reintentos limitados, backoff exponencial, circuit breaker con enfriamiento y registro de logs. Hay que hacer las cuatro cosas.
El historial de avisos demuestra que ningún canal de GPT-Image garantiza cero fallos a largo plazo. La fiabilidad viene del diseño de la arquitectura, no de apostar por una sola línea. Te recomendamos conectar varios canales con la misma clave a través de APIYI (apiyi.com), hacer primero una ronda de comparación con poco tráfico y, después, definir tu esquema de canal principal y de respaldo.
📚 Referencias
- Archivo de novedades en tiempo real de APIYI: historial de estados, cambios de precio y actualizaciones de documentación de cada canal de GPT-Image
- Enlace:
docs.apiyi.com/live/archive -
Descripción: es la fuente de la línea de tiempo del análisis de incidentes de este artículo; para consultar el estado actual, guíate por el aviso más reciente
-
Registro de modelos de APIYI: ID de modelo, tipo de facturación, grupos visibles y multiplicadores de grupo
- Enlace:
docs.apiyi.com/model-registry.json -
Descripción: los datos citados en este artículo se generaron el 2026-11-11 y los precios son los de catálogo, antes de descuentos
-
Página de estado de OpenAI: estado oficial de los servicios de OpenAI
- Enlace:
status.openai.com - Descripción: la plataforma recomendó en su momento seguir esta página para determinar si una caída del canal oficial proviene de OpenAI
Autor: equipo técnico de APIYI
Intercambio técnico: puedes contactarnos desde la página principal de APIYI; encontrarás más material sobre la integración de GPT-Image en el centro de documentación docs.apiyi.com