Nota do autor: este artigo compara os três tipos de canal do GPT-Image (oficial, -all e -vip) em cobrança, tamanhos e edição localizada. Também faz um balanço das falhas históricas de abril a outubro de 2026 e propõe um plano de contingência com “retentativas limitadas + circuit breaker + canal reserva”.
Quem começa a integrar o GPT-Image logo esbarra num problema: o mesmo modelo de imagem aparece na plataforma com vários nomes. O canal oficial (como gpt-image-2.5-flare), o -all e o -vip diferem na forma de cobrança e nos parâmetros suportados, e também nos motivos pelos quais falham. Aqui comparamos os três tipos de canal nesses pontos e apresentamos um plano de escolha e de contingência que você pode aplicar direto.
Esta não é uma daquelas análises do tipo “cada um tem seu mérito”. Os julgamentos abaixo se baseiam na página de comparação de canais da central de documentação da APIYI, no registro de modelos e nos boletins de status em tempo real de abril a outubro de 2026. Vamos separar o que é comunicado oficial da plataforma, o que é resultado de testes da plataforma e o que é apenas registro histórico.
Valor central: ao terminar a leitura, você vai saber qual canal do GPT-Image usar como principal e qual como reserva no seu negócio, e como o seu programa deve reagir diante de erros 429, 408 e 5xx.
O que são os canais GPT-Image: 官转, 官逆 e o grupo empresarial
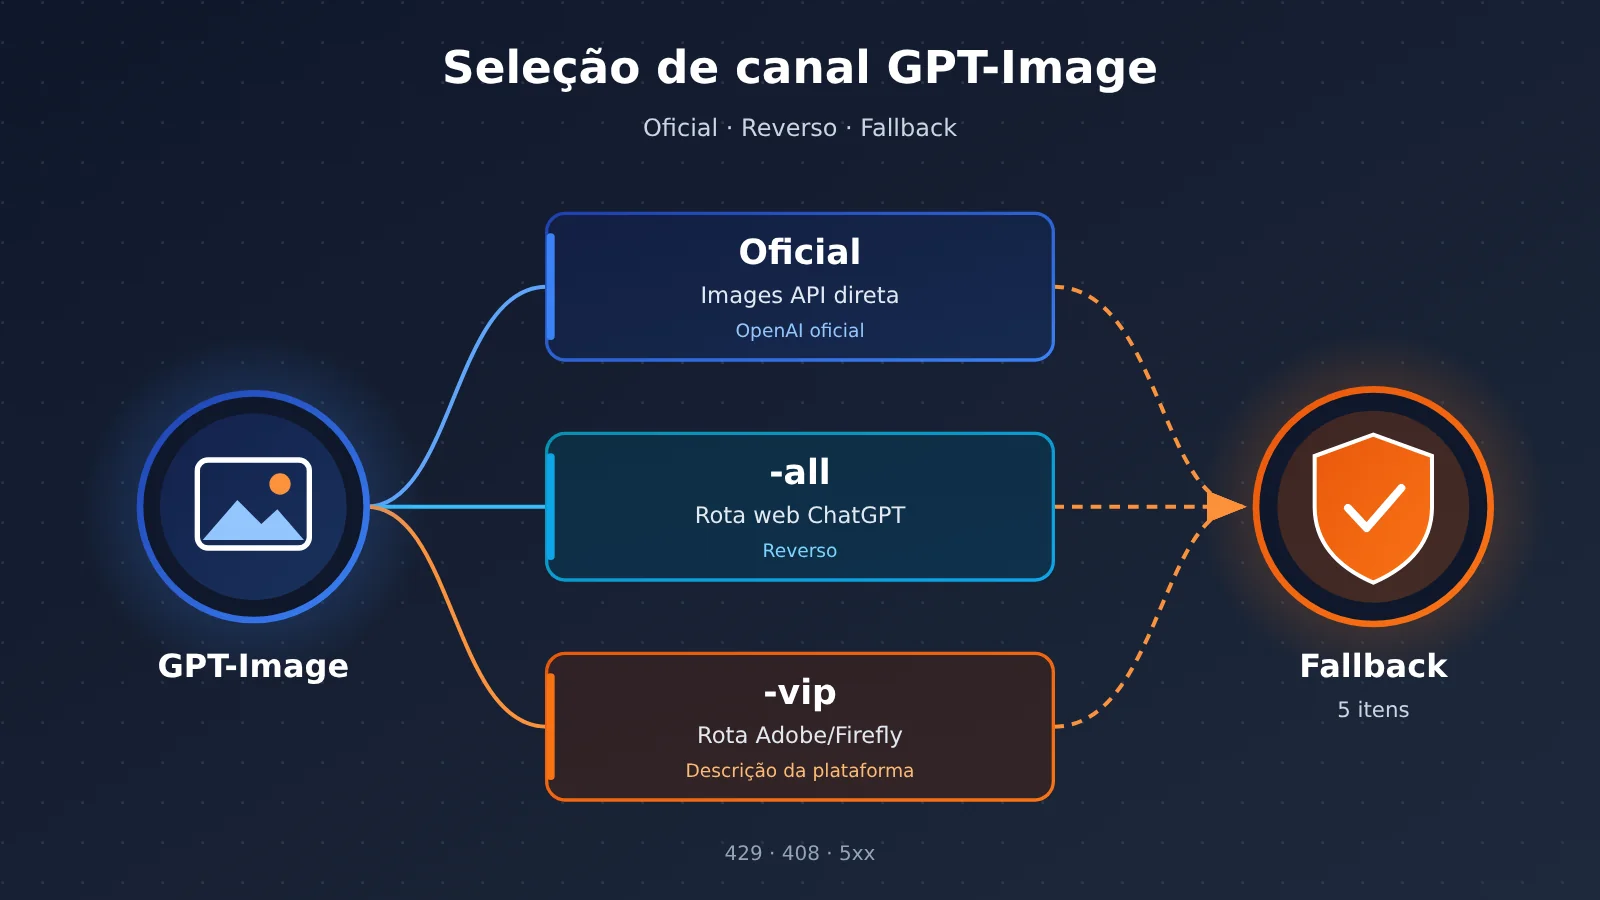
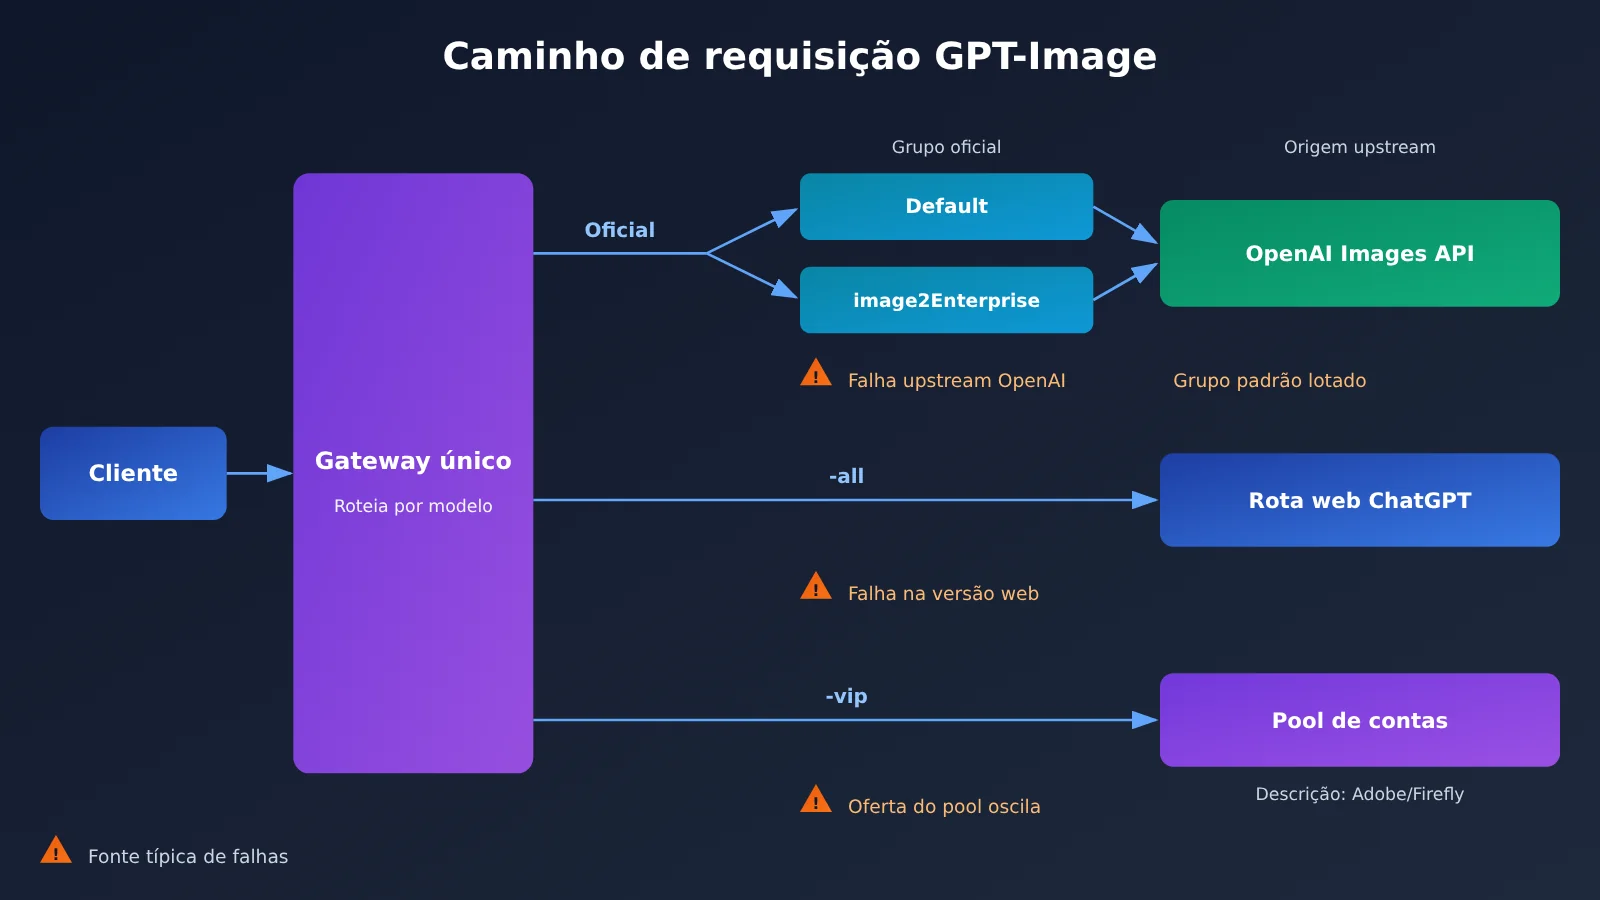
“官转” (guānzhuǎn) e “官逆” (guānnì) são a forma como a plataforma APIYI classifica os canais, e não termos oficiais da OpenAI. O 官转 é a rota que encaminha as requisições diretamente pela API oficial de imagens (Images API) da OpenAI. O 官逆 são recursos acessados por engenharia reversa, de forma não oficial, e isso não significa que a OpenAI forneça essas APIs reversas.
| Tipo de canal | Definição na documentação da plataforma | Modelos representativos | Principal dependência de upstream |
|---|---|---|---|
| 官转 | Encaminhamento direto pela Images API oficial da OpenAI | gpt-image-2.5-flare, gpt-image-2.5-sunburst | Poder de processamento e cota da API da OpenAI |
| -all (官逆) | Acesso reverso à rota web do ChatGPT | gpt-image-2-all, gpt-image-2.5-all | Disponibilidade da versão web do ChatGPT |
| -vip (官逆) | A documentação da plataforma descreve como recurso reverso da rota Adobe / Firefly | gpt-image-2-vip, gpt-image-2.5-flare-vip, gpt-image-2.5-sunburst-vip | Concorrência do pool de contas da plataforma e controle de risco do upstream |
Qual é o papel do grupo empresarial image2Enterprise
Muita gente confunde o image2Enterprise com um modelo independente, mas na verdade ele é um grupo de tokens. Foi adicionado em 25/04/2026, com multiplicador de 1,2x no catálogo, enquanto os grupos Default, image2_OSS e SVIP têm multiplicador de 1,0x. Em 27/04/2026 e em 21/09/2026, houve situações em que os recursos do grupo padrão ficaram apertados e o grupo empresarial continuou estável, então ele já serviu como rota de contingência para o 官转.
O grupo empresarial também tem seus limites. Em 07/05/2026, o 官转 do grupo empresarial foi afetado da mesma forma por uma falha no upstream da OpenAI. Ou seja, ele alivia o congestionamento do grupo padrão, mas não escapa de todos os problemas do upstream. Além disso, um grupo listado no registro de modelos não significa que toda conta tenha direito de usá-lo: as condições de ativação dependem do que aparece no console.
Os limites entre o GPT-Image 2.6 e os canais antigos
Até 11/11/2026, o registro de modelos da APIYI já traz dois modelos cobrados por Token, o gpt-image-2.6-flare e o gpt-image-2.6-sunburst, mas não lista versões -all ou -vip correspondentes ao 2.6. Por isso, as capacidades de tamanho e qualidade do 2.5 VIP não podem ser transpostas diretamente para o 2.6. Outro ponto: a página de comparação diz que a conexão direta oficial do gpt-image-2 antigo foi encerrada em 30/09/2026, mas o registro ainda mantém esse ID. Em projetos novos, nos exemplos de 官转, recomendo usar direto o 2.5 Flare ou o Sunburst. Segundo as notas de lançamento da plataforma, o flare gera imagens mais rápido, e o sunburst tem capacidade de edição mais forte.
GPT-Image oficial vs -all vs -vip: as principais diferenças
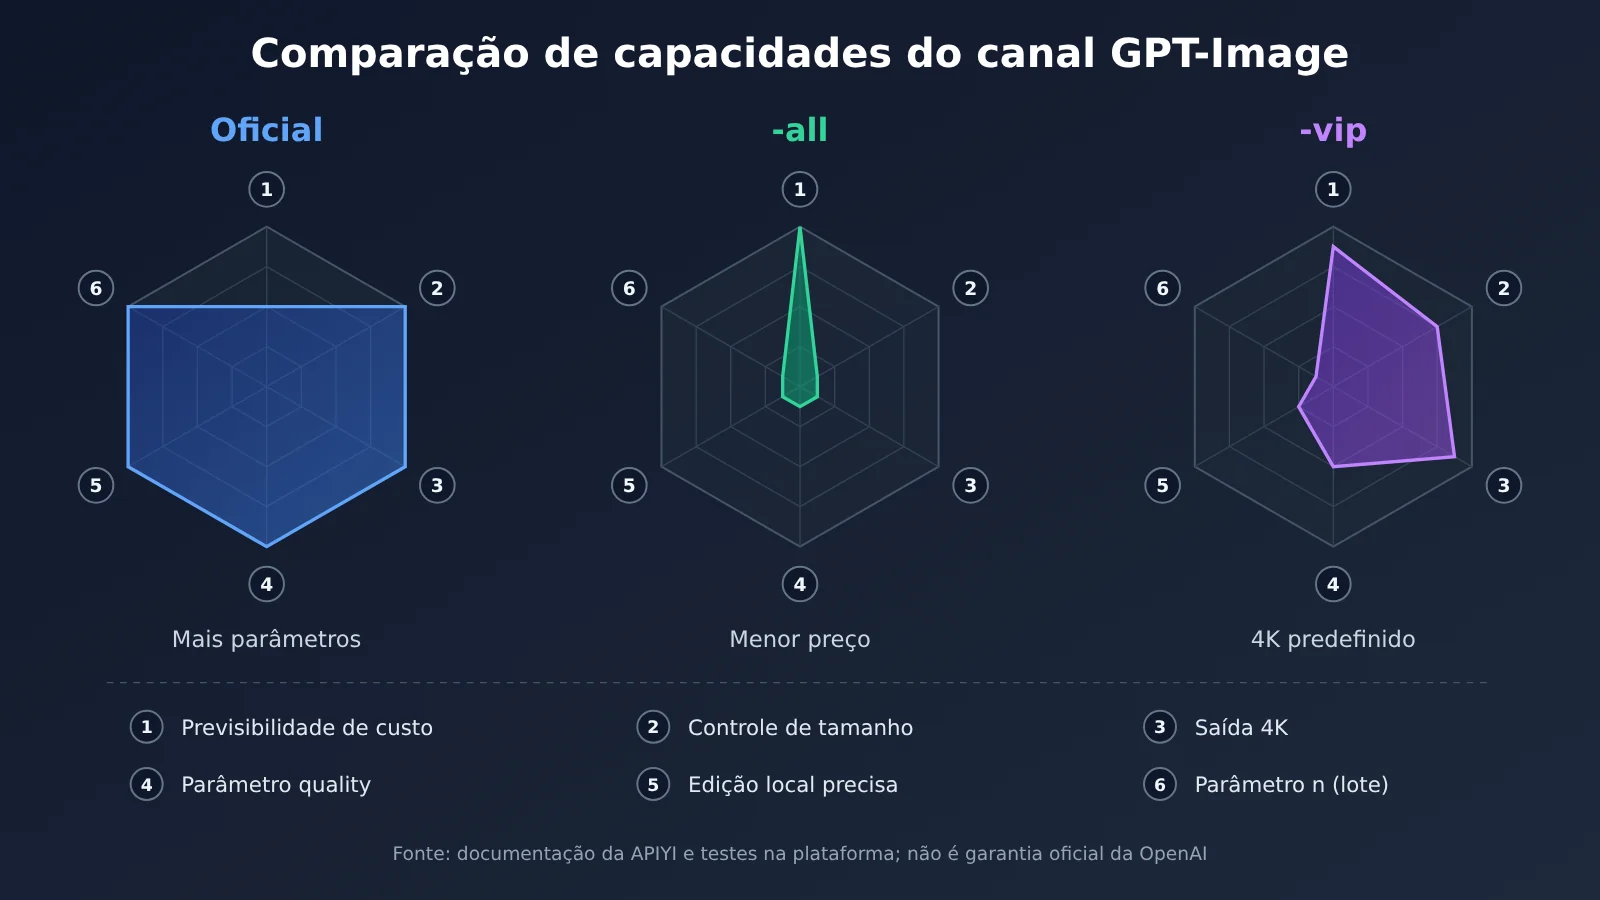
| Dimensão | Oficial (2.5 flare / sunburst) | -all | -vip | Vencedor |
|---|---|---|---|---|
| Cobrança | Por Token, varia com tamanho e qualidade | US$ 0,025/imagem (a partir de 2026-10-10) | US$ 0,03/imagem | Custo previsível: -all |
| Parâmetro size | Qualquer tamanho válido | Não suporta | 30 tamanhos comuns | Oficial |
| Saída 4K | Suporta | Não suporta | Suporta 4K predefinido | Oficial / -vip |
| Parâmetro quality | Suporte ao parâmetro oficial | Não suporta | Comportamento do canal, o alcance varia conforme o modelo | Oficial |
| n (várias imagens) | Suporta | Não suporta | Não suporta | Oficial |
| Repintura local precisa com mask | Suporta | Não suporta | Sem garantia, só redesenha a imagem inteira | Oficial |
| Uso típico | Controle de parâmetros, edição precisa | Geração em lote a preço fixo | Preço fixo, tamanhos predefinidos e 4K | — |
Entendendo cada canal do GPT-Image
Canal oficial: é o que tem o conjunto de parâmetros mais completo. size, quality, n e mask funcionam do mesmo jeito que na Images API oficial, o que combina bem com ambientes de produção que exigem controle fino. Só que a cobrança é por Token, então o custo por imagem sobe com tamanhos grandes e qualidade alta, e você não pode compará-lo diretamente com preços por chamada. Os testes reais na plataforma também mostraram que o limite de comando no canal oficial é de cerca de 8192 tokens. Passou disso, não dá erro, mas a imagem sai bagunçada, então comandos longos precisam ser cortados no cliente. Além disso, o recurso de fundo transparente do gpt-image-2 foi desativado pela própria OpenAI. Se você precisa de fundo transparente, a plataforma recomenda usar o canal oficial 2.5.
-all: a vantagem é o preço fixo e o mais baixo de todos, ideal para tarefas em grande volume em que a composição não precisa ser tão rigorosa. Ele não suporta size, quality, n nem mask, então o melhor é enviar apenas o prompt na chamada. Como o -all depende do ChatGPT versão web, qualquer falha na versão web afeta o canal ao mesmo tempo.
-vip: fica no meio do caminho. A cobrança é por chamada e ele oferece tamanhos predefinidos e 4K, o que serve bem para quem quer custo fixo e alta resolução. O comportamento dos parâmetros é do canal, não uma garantia oficial. Os níveis de qualidade xhigh e max do 2.5 VIP foram liberados a partir de testes reais da plataforma, e você não deve assumir que todo modelo de engenharia reversa tenha essa capacidade.
Nota sobre a comparação: os preços da tabela seguem o catálogo da plataforma APIYI (antes de bônus de recarga e descontos de grupo). Não são os preços por imagem da OpenAI oficial. O valor final é o que aparece no console do apiyi.com.
Retrospectiva de falhas históricas dos canais GPT-Image: por que não dá para apostar em uma rota só
Olhar apenas a tabela de funcionalidades faz você perder um fator decisivo: os três tipos de canal têm origens de falha e ritmos de recuperação diferentes. Abaixo estão eventos representativos extraídos dos comunicados de status da plataforma entre abril e outubro de 2026. São registros históricos e não refletem o estado atual.
| Data (2026) | Canal | Sintoma | Explicação / recomendação da plataforma |
|---|---|---|---|
| 23–27 de abril | Grupo padrão do repasse oficial | Alerta de concorrência, limite temporário, erros 429 / 408 | Recomendado migrar para image2Enterprise e aumentar o timeout para 360–600 segundos |
| 7 de maio | Grupo empresarial do repasse oficial | Erros | Causa raiz no upstream da OpenAI |
| 9 de maio | Grupo padrão do repasse oficial | Saturação novamente | Recomendado trocar o token para o grupo empresarial |
| 16–23 de junho | -vip | Parâmetro size deixou de funcionar; resolução chegou a cair para 1.5K e 1K | Avaliado como ajuste de regras do upstream, com breve recuperação no período |
| 7–13 de julho | -all | Falha no upstream, timeouts | Foi temporariamente apontado para o canal vip; depois, créditos foram reembolsados nas chamadas com timeout |
| 24–25 de agosto | -vip | Limitação de taxa por controle de risco no upstream, saturação | 429 pode ser repetido; erros de segurança de conteúdo não precisam de nova tentativa |
| 10–15 de setembro | 2.5 -vip | Afetado por 429, recursos insuficientes | Repasse oficial e -all funcionaram normalmente no mesmo período |
| 15 de outubro | -all / -vip | -all afetado por falha na versão web do ChatGPT; -vip com carga muito alta | Recomendado usar o repasse oficial como contingência quando o canal de engenharia reversa estiver indisponível |
| 19 de outubro | 2.5 -vip | Saturação de concorrência | Recursos adicionais sendo providenciados |
Padrões de falha dos canais GPT-Image
Juntando esses registros, dá para enxergar quatro padrões típicos:
- Grupo padrão do repasse oficial com poucos recursos: aparece como 429 e 408. O grupo empresarial alivia parte do problema, mas não escapa de falhas do próprio upstream da OpenAI;
- -all acompanhando as falhas da versão web: quando o ChatGPT web tem problema, o -all dá erro ou fica lento junto. Os tempos registrados pela plataforma variaram de cerca de 40 a cerca de 80 segundos;
- -vip com pool saturado e parâmetros instáveis: além do 429, houve casos em que size e quality deixaram de funcionar de repente e depois voltaram. Ou seja, a própria disponibilidade dos parâmetros não é estável;
- Vários canais normais ao mesmo tempo: em 10 e 15 de setembro, quando o -vip estava fora, o repasse oficial e o -all continuaram funcionando. É aí que a integração com dois canais mostra seu valor.
Vale deixar claro o limite de tempo: no arquivo até 11/11/2026, o último comunicado que trata claramente da saúde dos canais GPT-Image é o de 19 de outubro. Os registros de 5 e 9 de novembro são sobre o lançamento do 2.6 e atualizações de documentação, não avisos de status. Por isso, este artigo não traz um ranking de estabilidade do dia, e os dados históricos de tempo de resposta não devem ser tratados como SLA.
Recomendações de canais GPT-Image por cenário
Quando escolher o canal oficial (官转)
- Imagens principais de e-commerce e peças publicitárias: você precisa definir um tamanho exato ou usar 4K, além de controlar a qualidade da imagem com o parâmetro quality;
- Repintura local e troca de fundo: dependem de edição precisa com mask. O -vip só consegue repintar a imagem inteira, e o -all não suporta mask;
- Quem já tem código com o SDK da OpenAI: é o canal com a melhor compatibilidade de parâmetros e o menor custo de migração.
Quando escolher o -all
- Materiais em lote e esboços de inspiração: não há exigência rígida de tamanho e o mais importante é o preço fixo e baixo;
- Produção de conteúdo com orçamento apertado: o preço fixo de $0,025 por imagem facilita o cálculo de custos.
Quando escolher o -vip
- Precisa de 4K, mas prefere cobrança por requisição: basta usar os tamanhos predefinidos oferecidos pela plataforma;
- Foco em geração de imagem inteira, sem necessidade de edição local precisa: dá para conviver com a variação de parâmetros causada pelo comportamento do canal.
| Cenário de negócio | Canal principal recomendado | Canal reserva recomendado | Atenção ao fazer fallback |
|---|---|---|---|
| Edição local precisa | Oficial sunburst | Grupo empresarial do canal oficial (quando você tiver elegibilidade) | Não faça fallback para -all / -vip, porque a mask deixa de funcionar |
| Imagens comerciais com tamanho definido | Oficial flare | -vip com tamanhos predefinidos | O tamanho do canal reserva precisa ser mapeado para um dos 30 tamanhos predefinidos |
| 4K em alta definição com custo fixo | -vip | Oficial | Após a troca, a cobrança passa a ser por Token |
| Geração em massa | -all | -vip (também cobrado por requisição) | O custo por imagem passa de $0,025 para $0,03 |
| Precisa de n variações | Oficial | Chamar o -all várias vezes em loop | O canal reverso não suporta o parâmetro n |
Estratégia de contingência do canal GPT-Image: retentativa, circuit breaker e fallback
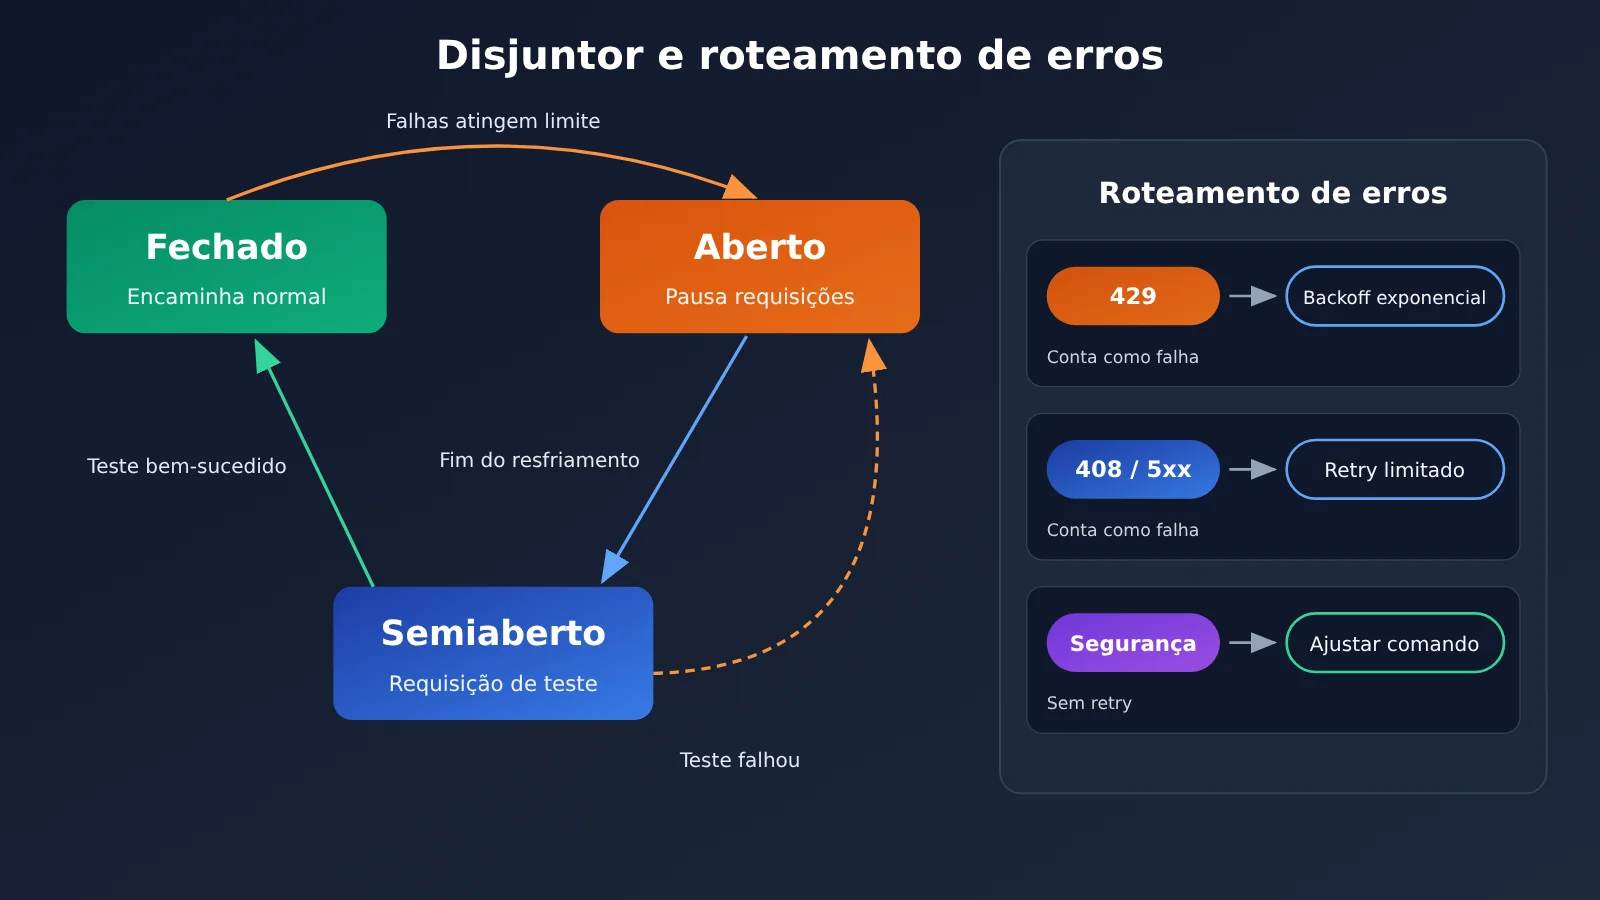
Uma contingência confiável não é simplesmente “deu erro, manda de novo”. Primeiro você identifica o tipo de erro e só então escolhe a ação.
| Tipo de erro | Causas comuns | Tentar de novo? | Tratamento recomendado |
|---|---|---|---|
| 429 | Limite de concorrência ou de taxa, pool de recursos saturado | Sim, com backoff obrigatório | Backoff exponencial com jitter aleatório; após falhas consecutivas, acione o circuit breaker e troque de canal |
| 408 / timeout do cliente | Geração lenta no upstream, timeout configurado curto demais | Retentativa limitada | No canal oficial, ajuste o timeout para 360–600 segundos e faça no máximo 2 retentativas |
| 5xx (erro de sistema) | Falha da plataforma ou do upstream | Retentativa limitada | No máximo 2 retentativas com backoff exponencial; se continuar falhando, troque para o canal de reserva |
| Erro de segurança de conteúdo | O comando ou a imagem de entrada acionou a moderação | Não | Altere o conteúdo antes de pedir de novo; reenviar a mesma requisição só desperdiça cota |
| Indisponibilidade prolongada | Falha em larga escala no upstream | Não | Abra o circuit breaker do canal atual e passe para um canal de reserva que tenha passado no health check |
Aqui vão duas armadilhas fáceis de cair. A primeira: a plataforma já explicou que o erro 500 retornado pelo -all geralmente indica violação de conteúdo (e não é cobrado). Além disso, desde maio, os erros 500 de segurança no -all/-vip passaram a ser informados diretamente, sem retentativa interna. Por isso, o cliente precisa ler a mensagem de erro em vez de reenviar a requisição sempre que vir um 5xx. A segunda: o -vip chegou a retornar “Unknown error”, e a recomendação da plataforma é comprimir cada imagem de entrada para menos de 1,5 MB.
Exemplo mínimo
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
    timeout=600,  # o canal oficial demora mais para gerar imagens; a plataforma já recomendou 360–600 segundos
)

resp = client.images.generate(
    model="gpt-image-2.5-flare",
    prompt="一只在咖啡馆窗边看书的橘猫,柔和晨光,写实摄影风格",
    size="1536x1024",
)
item = resp.data[0]
print(item.b64_json[:60] if item.b64_json else item.url)
Ver o código completo: múltiplos canais com retry + circuit breaker + fallback
import time
import random
import logging
import openai
from openai import OpenAI

logging.basicConfig(level=logging.INFO)
BASE_URL = "https://api.apiyi.com/v1"

# Os canais ficam em ordem de prioridade; grupos diferentes usam tokens diferentes
CHANNELS = [
    {"name": "official", "model": "gpt-image-2.5-flare",
     "key": "KEY_DEFAULT", "params": {"size": "1536x1024", "quality": "high"}},
    # Só habilite se a conta tiver acesso ao grupo image2Enterprise
    {"name": "official-enterprise", "model": "gpt-image-2.5-flare",
     "key": "KEY_ENTERPRISE", "params": {"size": "1536x1024", "quality": "high"}},
    # No -vip, o size precisa ser trocado por uma das 30 predefinições da documentação
    {"name": "vip", "model": "gpt-image-2.5-flare-vip",
     "key": "KEY_DEFAULT", "params": {"size": "1536x1024"}},
    # O -all não suporta size / quality / n, envie apenas o prompt
    {"name": "all", "model": "gpt-image-2.5-all",
     "key": "KEY_DEFAULT", "params": {}},
]

FAIL_THRESHOLD = 3     # Quantas falhas consecutivas até abrir o circuit breaker (valor de exemplo)
COOLDOWN = 120         # Tempo de resfriamento do breaker, em segundos (valor de exemplo)
MAX_RETRY = 2          # Em caso de 5xx / timeout, tenta no máximo 2 vezes
breaker = {c["name"]: {"fails": 0, "open_until": 0} for c in CHANNELS}


def classify(err: Exception) -> str:
    msg = str(err).lower()
    if any(k in msg for k in ("safety", "content_policy", "moderation", "violat")):
        return "content"
    if isinstance(err, openai.RateLimitError):
        return "rate_limit"
    if isinstance(err, openai.APITimeoutError):
        return "timeout"
    if isinstance(err, openai.APIStatusError):
        if err.status_code == 408:
            return "timeout"
        if err.status_code >= 500:
            return "server"
        return "fatal"
    if isinstance(err, openai.APIConnectionError):
        return "network"
    return "fatal"


def generate(prompt: str, need_mask: bool = False):
    for ch in CHANNELS:
        if need_mask and ch["name"] in ("vip", "all"):
            continue  # Edição precisa não faz fallback para canais reversos
        state = breaker[ch["name"]]
        if time.time() < state["open_until"]:
            continue  # Canal com o breaker aberto
        client = OpenAI(api_key=ch["key"], base_url=BASE_URL, timeout=600)
        for attempt in range(MAX_RETRY + 1):
            try:
                resp = client.images.generate(
                    model=ch["model"], prompt=prompt, **ch["params"])
                state["fails"] = 0
                logging.info("ok channel=%s model=%s", ch["name"], ch["model"])
                return ch["name"], resp.data[0]
            except Exception as e:
                kind = classify(e)
                logging.warning("fail channel=%s model=%s kind=%s req_id=%s",
                                ch["name"], ch["model"], kind,
                                getattr(e, "request_id", None))
                if kind in ("content", "fatal"):
                    raise  # Problema de conteúdo ou de parâmetros: ajuste a requisição, não tente de novo
                if attempt < MAX_RETRY:
                    time.sleep(2 ** (attempt + 1) + random.uniform(0, 1))
        state["fails"] += 1
        if state["fails"] >= FAIL_THRESHOLD:
            state["open_until"] = time.time() + COOLDOWN
    raise RuntimeError("所有 GPT-Image 通道均不可用")
🚀 Início rápido: comece usando a cota gratuita de teste para novos usuários no APIYI apiyi.com e faça uma rodada de validação A/B entre os canais 官转, -vip e -all: mesmo comando, mesmo tamanho, anotando separadamente o tempo de resposta, a taxa de sucesso e as diferenças na imagem gerada. Só então defina a ordem de principal e backup.
Recomendações de decisão de canal para o GPT-Image
Se for para guardar só um princípio, que seja este: escolha o canal principal pelas restrições rígidas do negócio e escolha o canal de backup pela diferença na origem das falhas. Operações que exigem edição precisa com mask só podem ter redundância dentro do próprio 官转 — por exemplo, o grupo padrão mais um grupo empresarial. Já para operações que precisam apenas da geração da imagem inteira, vale combinar “官转 + -vip” ou “-all + -vip”, colocando duas rotas com origens de falha distintas para se cobrirem mutuamente. E, em toda requisição, registre o modelo, o canal e o request_id que foram realmente usados: isso facilita a conciliação depois e o diagnóstico de problemas.
💡 Sugestão de escolha: o desempenho dos canais varia conforme os recursos upstream, e estabilidade no passado não garante estabilidade no futuro. Nossa recomendação é conectar ao mesmo tempo duas ou mais rotas na interface unificada do APIYI apiyi.com e rodar verificações de saúde periódicas com pouco tráfego, em vez de fixar uma escolha por longo prazo com base no resultado de um único teste.
Perguntas Frequentes (FAQ)
Q1: O que são “官转” (guanzhuan) e “官逆” (guanni) no GPT-Image?
O **官转** é a rota que encaminha as requisições diretamente pela Images API oficial da OpenAI. Já o **官逆** é a categoria que a plataforma usa para recursos de acesso reverso, e inclui o -all, baseado na rota web do ChatGPT, e o -vip, que a documentação da plataforma descreve como uma rota Adobe/Firefly. O 官逆 não é uma API fornecida oficialmente pela OpenAI.
Q2: Qual é a diferença entre GPT-Image -all e -vip?
Os dois são cobrados por chamada. O -all custa US$ 0,025 por imagem e não suporta size, quality nem 4K. O -vip custa US$ 0,03 por imagem e suporta 30 tamanhos predefinidos e 4K predefinido. Só que o comportamento dos parâmetros depende do canal: já houve casos em que o size deixou de funcionar e depois voltou ao normal.
Q3: O GPT-Image 2.6 também tem -all e -vip?
No registro de modelos de 11/11/2026, só aparecem dois modelos cobrados por Token: gpt-image-2.6-flare e gpt-image-2.6-sunburst. Não existe nenhuma variante -all ou -vip do 2.6. Portanto, não aplique ao 2.6 as capacidades do 2.5 VIP.
Q4: O grupo empresarial image2Enterprise garante que não vai haver falhas?
Não garante. Ele funcionou de forma estável várias vezes quando o grupo padrão estava congestionado, mas em 07/05/2026 também foi afetado por uma falha no upstream da OpenAI. O multiplicador é 1,2x, a elegibilidade para ativação depende do que aparece no console, e ele serve como redundância dentro do 官转, não como seguro contra tudo.
Q5: Como testar rapidamente vários canais do GPT-Image pela API?
1. Crie uma conta no APIYI (apiyi.com) para obter sua chave API e o crédito de teste gratuito;
2. Defina o base_url como `https://api.apiyi.com/v1` e troque o parâmetro model conforme o código deste artigo;
3. Use o mesmo comando em cada canal e registre o tempo de resposta, a taxa de sucesso e a qualidade da imagem.
Com uma interface unificada, trocar de canal exige apenas mudar o nome do modelo, sem precisar manter um SDK separado para cada upstream.
Q6: Devo ficar tentando de novo quando aparecer um erro 5xx?
Não. A documentação da plataforma recomenda no máximo 2 novas tentativas com backoff exponencial para 5xx e timeouts. No -all, o erro 500 normalmente está ligado a violação de conteúdo, então tentar de novo não vai resolver. Depois de esgotar as tentativas, abra o circuit breaker do canal atual e mude para um canal de reserva.
Q7: Quais são as limitações conhecidas dos canais GPT-Image?
– No 官转, comandos com mais de cerca de 8192 tokens não geram erro, mas a imagem sai bagunçada;
– O fundo transparente do gpt-image-2 foi desativado oficialmente; se precisar de fundo transparente, use o 2.5 官转;
– Os canais reversos não suportam o parâmetro n nem máscara (mask) precisa;
– No -vip, é recomendável comprimir a imagem de entrada para no máximo 1,5 MB.
Pontos-chave para escolher o canal do GPT-Image (Key Takeaways)
- Três tipos de canal: o canal oficial (官转) usa a Images API oficial, o -all depende da versão web do ChatGPT e o -vip depende do pool de contas da plataforma;
- Diferença de parâmetros: só o canal oficial suporta por completo qualquer
size, o parâmetrone edição precisa com máscara (mask); - Diferença de cobrança: o canal oficial cobra por token, o -all custa US$ 0,025 por imagem e o -vip, US$ 0,03 por imagem;
- Grupo empresarial: image2Enterprise é um grupo de tokens, com multiplicador de 1,2x, e não um modelo independente;
- Padrão de falhas: cada canal falha por um motivo diferente, e historicamente já aconteceu muitas vezes de um canal cair enquanto o outro continuava normal;
- Regras de retentativa: no erro 429, faça retentativa com backoff; em erros 5xx e timeouts, tente no máximo 2 vezes; erros de segurança de conteúdo não devem ser repetidos;
- Como começar: conecte os dois canais pela interface unificada da APIYI e use testes A/B para decidir qual será o principal e qual será o reserva.
Resumo
Os pontos centrais para escolher o canal do GPT-Image:
- Escolha o canal principal pelas restrições rígidas: se você precisa de edição precisa e tamanhos livres, vá de canal oficial; se quer um preço fixo e baixo, escolha o -all; se precisa de 4K com cobrança por chamada, escolha o -vip;
- Escolha o canal reserva pela origem das falhas: as dependências upstream do canal principal e do reserva não devem se sobrepor, porque mais cedo ou mais tarde um canal único vai enfrentar saturação de recursos ou falha no upstream;
- Monte a rede de segurança por tipo de erro: retentativas limitadas, backoff exponencial, circuit breaker com tempo de resfriamento e registro em log. Faça as quatro coisas;
O histórico de avisos mostra que nenhum canal do GPT-Image consegue garantir zero falhas por muito tempo. A confiabilidade vem do design da arquitetura, e não de apostar em uma única linha. Recomendamos conectar vários canais com a mesma chave pela APIYI (apiyi.com), rodar primeiro uma comparação com pouco tráfego e só depois definir a sua combinação de principal e reserva.
📚 Referências
- Arquivo de atualizações em tempo real da APIYI: histórico de status, variações de preço e atualizações de documentação de cada canal do GPT-Image
- Link:
docs.apiyi.com/live/archive -
Observação: a linha do tempo do post-mortem de falhas deste artigo vem daqui; para ver o status atual, consulte sempre o comunicado mais recente
-
Registro de modelos da APIYI: ID dos modelos, tipo de cobrança, grupos visíveis e multiplicadores de grupo
- Link:
docs.apiyi.com/model-registry.json -
Observação: os dados citados neste artigo foram gerados em 2026-11-11, e os preços são os de tabela, antes de qualquer desconto
-
Página de status da OpenAI: status oficial dos serviços da OpenAI
- Link:
status.openai.com - Observação: a plataforma já recomendou acompanhar esta página para saber se uma falha no canal oficial vem do upstream
Autor: Equipe técnica da APIYI
Troca de experiências: fale com a gente pela página inicial do site da APIYI. Para mais materiais de integração do GPT-Image, acesse a central de documentação em docs.apiyi.com