Hinweis des Autors: Dieser Beitrag vergleicht die drei GPT-Image-Kanäle „官转“ (Official Relay), -all und -vip hinsichtlich Abrechnung, Bildgrößen und lokaler Bearbeitung. Außerdem blickt er auf die Störungen zwischen April und Oktober 2026 zurück und stellt ein Fallback-Konzept aus „begrenzten Wiederholungen + Circuit Breaker + Ausweichkanal“ vor.
Wer GPT-Image anbindet, stößt schnell auf ein Problem: Dasselbe Bildmodell hat auf der Plattform gleich mehrere Namen. 官转 (z. B. gpt-image-2.5-flare), -all und -vip unterscheiden sich in der Abrechnung und in den unterstützten Parametern, und auch die Ursachen für Ausfälle sind jeweils andere. In diesem Beitrag vergleichen wir die drei GPT-Image-Kanäle entlang dieser Dimensionen und zeigen eine Auswahl- und Fallback-Strategie, die sich direkt umsetzen lässt.
Das ist keine „jeder hat seine Vorzüge“-Analyse mit faulem Kompromiss. Die folgenden Einschätzungen stützen sich auf die Kanalvergleichsseite im APIYI-Dokumentationszentrum, die Modellregistrierung sowie die Live-Statusmeldungen von April bis Oktober 2026. Wir unterscheiden dabei, was offizielle Plattformankündigung ist, was die Plattform selbst gemessen hat und was nur historische Aufzeichnung ist.
Kernnutzen: Nach der Lektüre wissen Sie, welchen GPT-Image-Kanal Sie für Ihr Projekt als Hauptkanal und welchen als Ausweichkanal einsetzen sollten – und wie Ihr Programm bei 429, 408 und 5xx reagieren sollte.
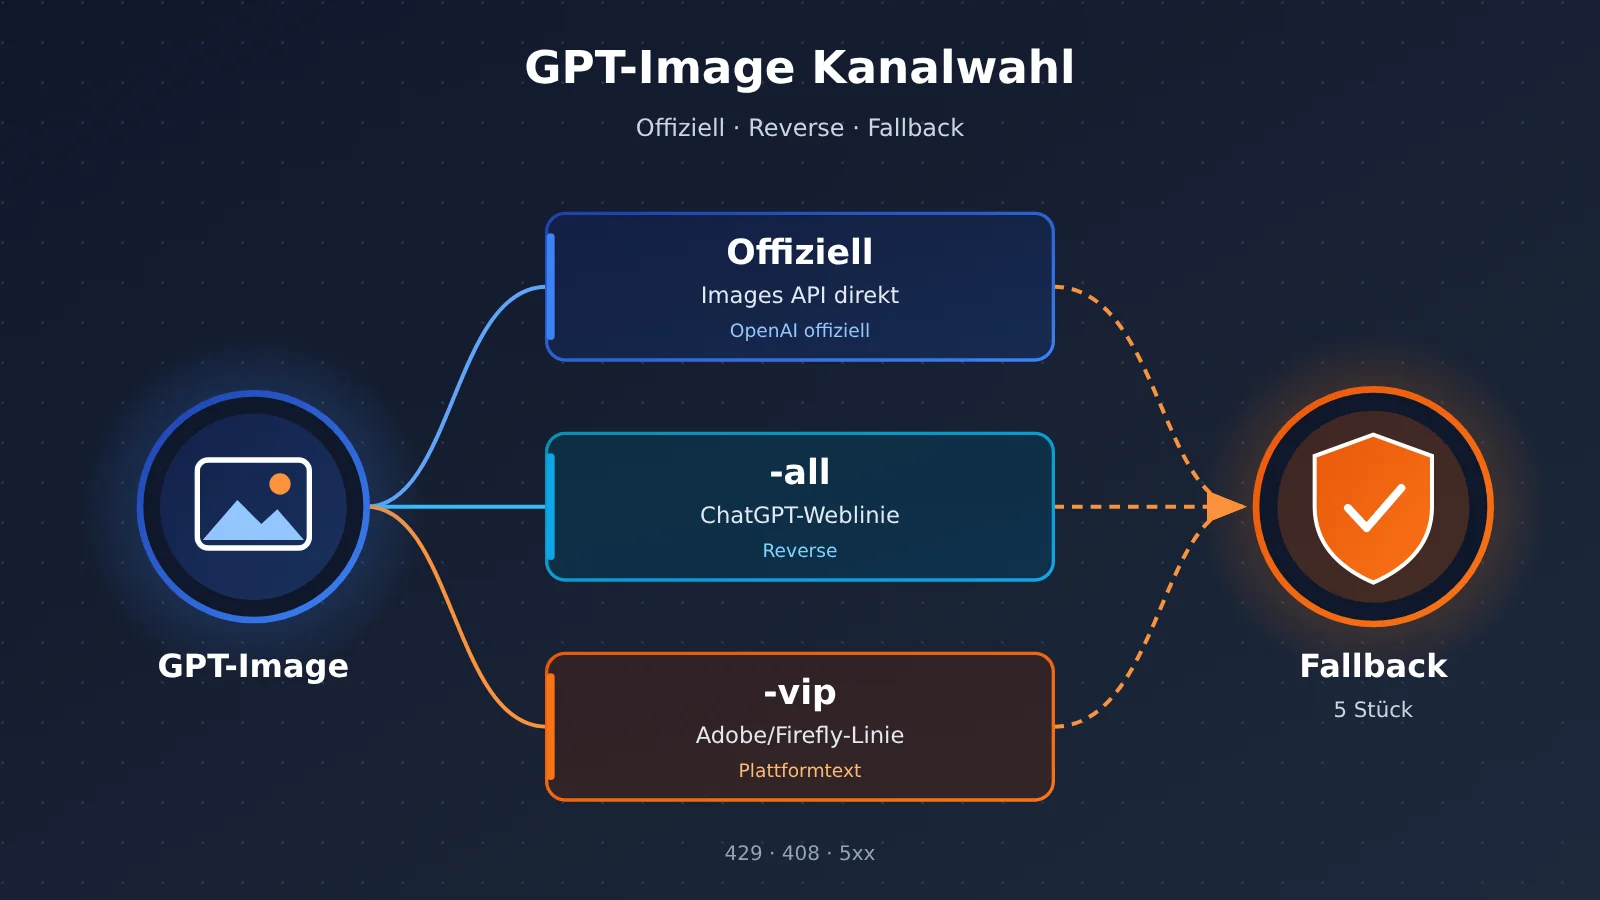
Was sind GPT-Image-Kanäle: Relay (官转), Reverse (官逆) und Enterprise-Gruppe
„官转“ (Relay) und „官逆“ (Reverse) sind die Kanalkategorien der APIYI-Plattform und keine offiziellen OpenAI-Begriffe. Ein Relay-Kanal (官转) leitet Anfragen direkt an die offizielle OpenAI Images API weiter. Ein Reverse-Kanal (官逆) nutzt Ressourcen, die über inoffizielle Reverse-Engineering-Methoden angebunden sind. OpenAI stellt diese Reverse-APIs nicht bereit.
| Kanaltyp | Definition laut Plattformdokumentation | Beispielmodelle | Wichtigste Upstream-Abhängigkeit |
|---|---|---|---|
| Relay (官转) | Direkte Weiterleitung an die offizielle OpenAI Images API | gpt-image-2.5-flare, gpt-image-2.5-sunburst | Rechenleistung und Kontingent der OpenAI API |
| -all (Reverse, 官逆) | Reverse-Anbindung der ChatGPT-Weboberfläche | gpt-image-2-all, gpt-image-2.5-all | Verfügbarkeit der ChatGPT-Webversion |
| -vip (Reverse, 官逆) | Von der Plattformdokumentation als Reverse-Ressource der Adobe-/Firefly-Linie beschrieben | gpt-image-2-vip, gpt-image-2.5-flare-vip, gpt-image-2.5-sunburst-vip | Parallelität des Plattform-Kontopools und Risikokontrolle des Upstreams |
Die Rolle der GPT-Image-Enterprise-Gruppe image2Enterprise
image2Enterprise wird oft für ein eigenständiges Modell gehalten, ist aber tatsächlich eine Token-Gruppe. Sie wurde am 25.04.2026 neu eingeführt und hat im Katalog einen Multiplikator von 1,2x, während die Gruppen Default, image2_OSS und SVIP mit 1,0x abgerechnet werden. Am 27.04.2026 und am 21.09.2026 waren die Ressourcen der Default-Gruppe knapp, während die Enterprise-Gruppe stabil blieb. Deshalb diente sie bisher als Ausweichpfad für den Relay-Kanal.
Auch die Enterprise-Gruppe hat ihre Grenzen. Am 07.05.2026 war der Relay-Kanal der Enterprise-Gruppe ebenfalls von einer Störung bei OpenAI betroffen. Sie kann also die Überlastung der Default-Gruppe abmildern, schützt aber nicht vor allen Upstream-Problemen. Außerdem bedeutet es nicht, dass jedes Konto sie nutzen darf, nur weil die Modellregistrierung eine Gruppe aufführt. Die genauen Freischaltungsbedingungen entnehmen Sie bitte der Konsole.
GPT-Image 2.6 und die Grenze zu älteren Kanälen
Stand 11.11.2026 enthält die APIYI-Modellregistrierung mit gpt-image-2.6-flare und gpt-image-2.6-sunburst zwei tokenbasiert abgerechnete Modelle, aber keine passenden -all- oder -vip-Varianten für 2.6. Die Fähigkeiten von 2.5 VIP bei Größe und Bildqualität lassen sich deshalb nicht einfach auf 2.6 übertragen. Beachten Sie außerdem: Die Vergleichsseite gibt an, dass die offizielle Direktanbindung des alten gpt-image-2 am 30.09.2026 abgeschaltet wurde, die Registrierung diese ID aber weiterhin führt. Für neue Projekte empfehlen wir bei Relay-Beispielen direkt 2.5 Flare oder Sunburst. Laut den Release-Hinweisen der Plattform liefert Flare Bilder schneller, während Sunburst die stärkeren Bearbeitungsfunktionen bietet.
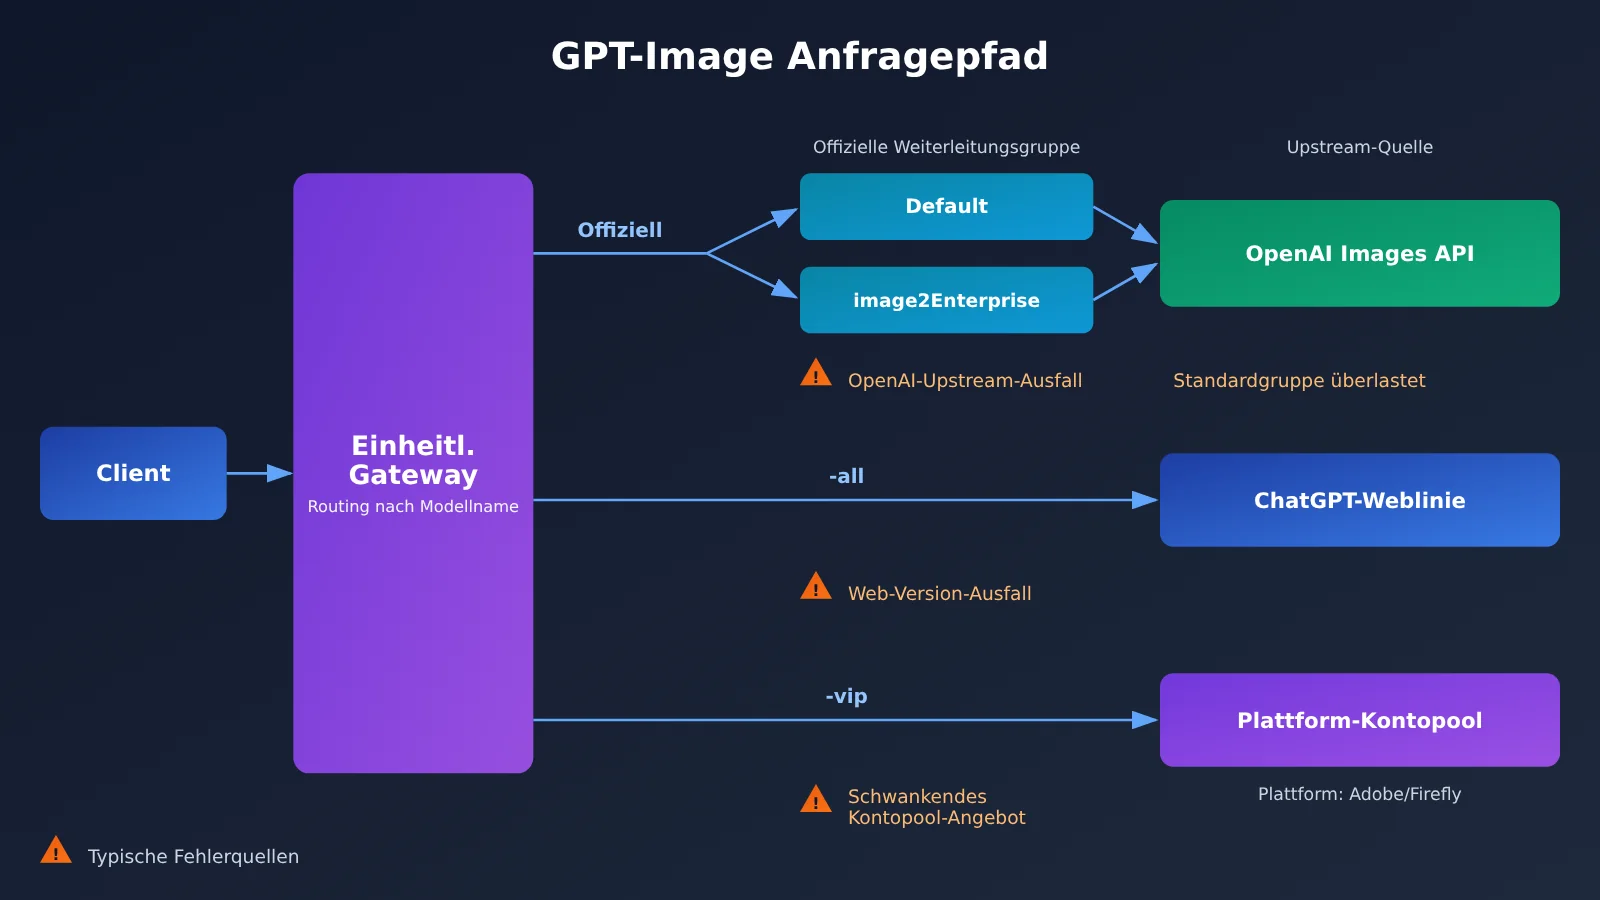
GPT-Image: Die wichtigsten Unterschiede zwischen Official-Relay, -all und -vip
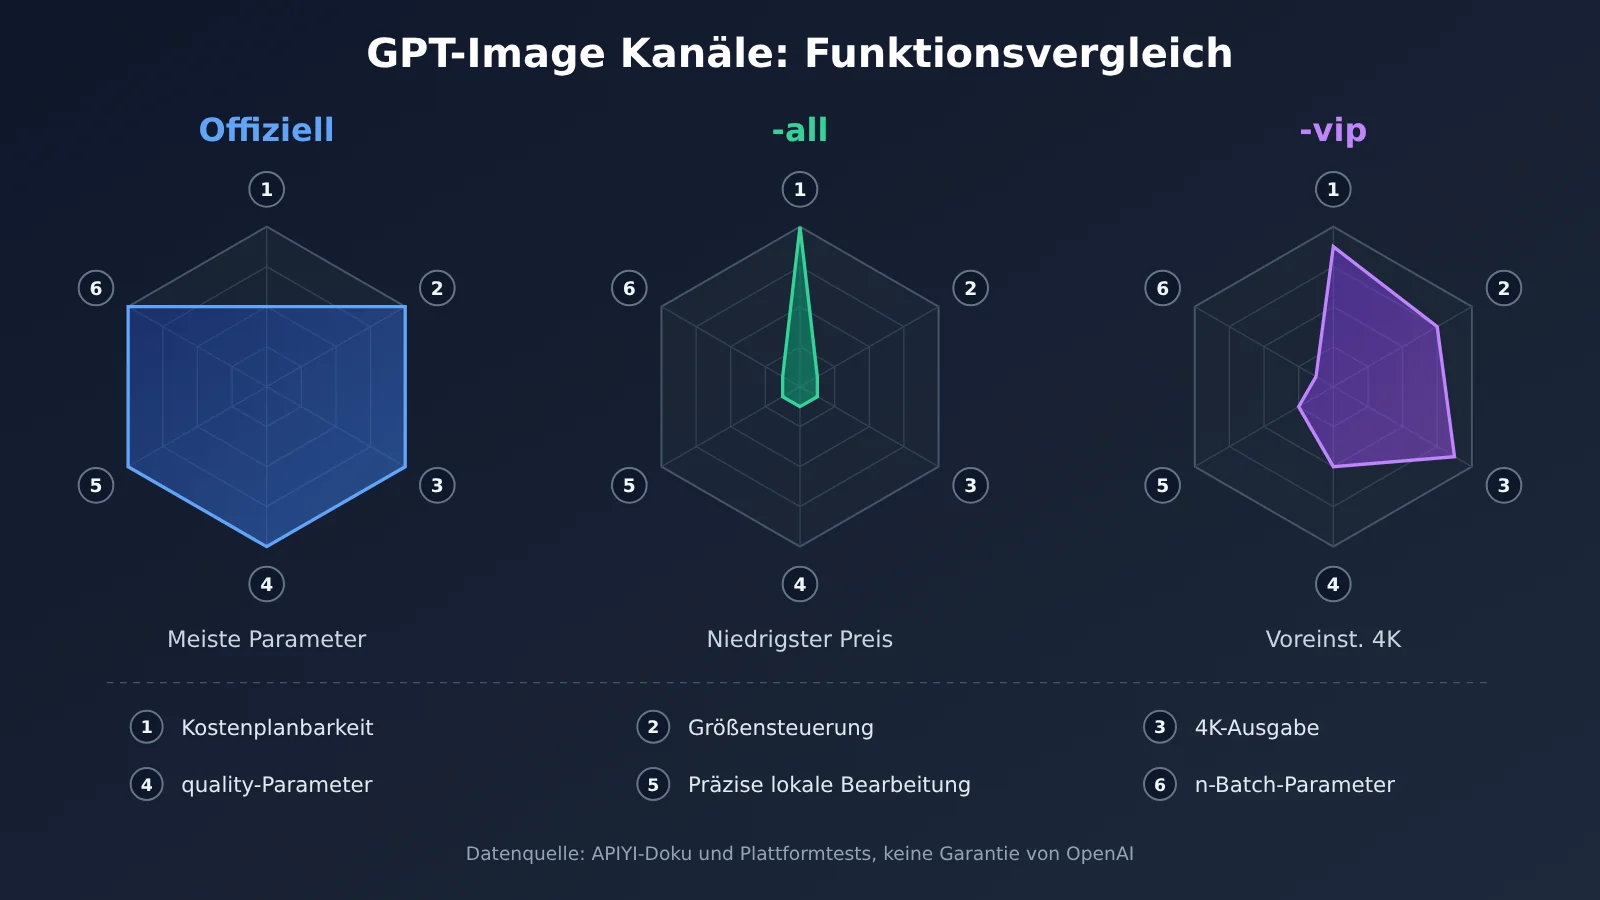
| Vergleichsdimension | Official-Relay (2.5 flare / sunburst) | -all | -vip | Vorteil |
|---|---|---|---|---|
| Abrechnung | Nach Token, abhängig von Größe und Bildqualität | $0.025/Bild (ab 2026-10-10) | $0.03/Bild | Kosten gut vorhersagbar: -all |
| size-Parameter | Beliebige gültige Größe | Nicht unterstützt | 30 gängige Größenstufen | Official-Relay |
| 4K-Ausgabe | Unterstützt | Nicht unterstützt | Voreingestelltes 4K unterstützt | Official-Relay / -vip |
| quality-Parameter | Offizieller Parameter unterstützt | Nicht unterstützt | Kanalverhalten, Umfang je nach Modell unterschiedlich | Official-Relay |
| n (mehrere Bilder erzeugen) | Unterstützt | Nicht unterstützt | Nicht unterstützt | Official-Relay |
| Präzises Inpainting per Maske | Unterstützt | Nicht unterstützt | Nicht garantiert, nur Neuzeichnen des ganzen Bildes | Official-Relay |
| Typischer Einsatz | Parametersteuerung, präzise Bearbeitung | Batch-Bilderzeugung zum Festpreis | Festpreis, voreingestellte Größen und 4K | — |
Die GPT-Image-Kanäle im Vergleich
Official-Relay im Check: Beim Parameterumfang liegt der Official-Relay vorn. size, quality, n und mask funktionieren so wie in der offiziellen Images API und eignen sich damit für Produktionsumgebungen, die feine Kontrolle brauchen. Allerdings wird nach Token abgerechnet: Bei großen Formaten und hoher Bildqualität steigen die Kosten pro Bild, deshalb lässt sich der Preis nicht direkt mit Preisen pro Aufruf vergleichen. Praxistests der Plattform haben außerdem gezeigt, dass die Eingabeaufforderung beim Official-Relay auf etwa 8192 Tokens begrenzt ist. Wird das Limit überschritten, gibt es keinen Fehler, aber das Bild wird chaotisch. Lange Eingabeaufforderungen müssen Sie deshalb auf Client-Seite kürzen. Außerdem hat OpenAI die Funktion für transparente Hintergründe bei gpt-image-2 offiziell abgeschaltet. Wenn Sie einen transparenten Hintergrund brauchen, empfiehlt die Plattform den 2.5 Official-Relay.
-all im Check: Der Vorteil von -all ist der feste und niedrigste Preis. Es eignet sich für große Mengen an Bildern, bei denen die Komposition nicht so streng sein muss. size, quality, n und mask werden nicht unterstützt, beim Aufruf sollten Sie am besten nur prompt übergeben. -all hängt von der ChatGPT-Weboberfläche ab: Fällt diese aus, ist auch -all sofort betroffen.
-vip im Check: -vip liegt zwischen den beiden anderen. Es wird pro Aufruf abgerechnet und bietet gleichzeitig voreingestellte Größen und 4K. Damit passt es, wenn Sie feste Kosten und zugleich hohe Auflösung brauchen. Das Parameterverhalten ist Kanalverhalten und keine offizielle Garantie. Die Qualitätsstufen xhigh und max beim 2.5 VIP hat die Plattform in Praxistests freigeschaltet. Man sollte sie nicht als Fähigkeit aller Reverse-Modelle ansehen.
Hinweis zum Vergleich: Die Preise in der Tabelle entsprechen dem Katalog der APIYI-Plattform (vor Aufladebonus und Gruppenrabatt) und sind keine offiziellen Preise von OpenAI pro Bild. Maßgeblich ist der endgültige Preis, der in der Konsole auf apiyi.com angezeigt wird.
GPT-Image-Kanäle: Rückblick auf historische Störungen – warum man nicht auf nur eine Route setzen sollte
Wer nur auf die Funktionstabelle schaut, übersieht einen wichtigen Faktor: Die drei Kanaltypen fallen aus unterschiedlichen Gründen aus und erholen sich in unterschiedlichem Tempo. Unten finden Sie repräsentative Vorfälle aus den Statusmeldungen der Plattform von April bis Oktober 2026. Das sind ausschließlich historische Aufzeichnungen und sie sagen nichts über den aktuellen Zustand aus.
| Datum (2026) | Kanal | Symptom | Hinweis / Empfehlung der Plattform |
|---|---|---|---|
| 23.–27. April | Offizieller Durchleitungskanal, Standardgruppe | Parallelität am Limit, temporäre Begrenzung, 429 / 408 | Wechsel zu image2Enterprise empfohlen, Timeout auf 360–600 Sekunden erhöhen |
| 7. Mai | Offizieller Durchleitungskanal, Enterprise-Gruppe | Fehlermeldungen | Ursache liegt im Upstream bei OpenAI |
| 9. Mai | Offizieller Durchleitungskanal, Standardgruppe | Erneut ausgelastet | Token auf die Enterprise-Gruppe umstellen |
| 16.–23. Juni | -vip | Der size-Parameter wirkte nicht mehr, die Auflösung fiel zeitweise auf 1,5K bzw. 1K | Als Anpassung der Upstream-Regeln eingestuft, zwischendurch kurzzeitig wieder normal |
| 7.–13. Juli | -all | Upstream-Störung, Timeouts | Zeitweise auf den vip-Kanal umgeleitet, für Timeout-Aufrufe wurde nachträglich Guthaben gutgeschrieben |
| 24.–25. August | -vip | Upstream-Risikokontrolle drosselte die Rate, Auslastung am Limit | 429 kann erneut versucht werden, bei Fehlern der Inhaltssicherheit ist ein Retry sinnlos |
| 10.–15. September | 2.5 -vip | Von 429 betroffen, zu wenig Ressourcen | Offizieller Durchleitungskanal und -all liefen im selben Zeitraum normal |
| 15. Oktober | -all / -vip | -all von der Störung der ChatGPT-Webversion betroffen, -vip stark überlastet | Wenn der inoffizielle Kanal („Guan-Ni“) ausfällt, zunächst den offiziellen Durchleitungskanal als Fallback nutzen |
| 19. Oktober | 2.5 -vip | Parallelität ausgereizt | Ressourcen werden aufgestockt |
Typische Fehlermuster der GPT-Image-Kanäle
Legt man diese Einträge nebeneinander, zeichnen sich vier typische Muster ab:
- Zu wenig Ressourcen in der Standardgruppe des offiziellen Durchleitungskanals: Das zeigt sich durch 429 und 408. Die Enterprise-Gruppe kann einen Teil davon abfedern, schützt aber nicht vor Störungen im OpenAI-Upstream selbst.
- -all folgt den Störungen der Webversion: Sobald die ChatGPT-Webversion Probleme hat, meldet -all gleichzeitig Fehler oder wird langsamer. Die von der Plattform erfassten Laufzeiten reichten von etwa 40 bis etwa 80 Sekunden.
- -vip: überlaufender Ressourcenpool und driftende Parameter: Neben 429 gab es Fälle, in denen size und quality plötzlich nicht mehr wirkten und später wieder funktionierten. Auch die Verfügbarkeit der Parameter ist also nicht stabil.
- Mehrere Kanäle laufen gleichzeitig normal: Am 10. und 15. September arbeiteten der offizielle Durchleitungskanal und -all einwandfrei, während -vip ausfiel. Genau hier zeigt sich der Wert eines Zugangs über zwei Kanäle.
Wichtig ist die zeitliche Abgrenzung: Im Archiv bis zum 11.11.2026 ist die letzte Meldung, die eindeutig den Gesundheitszustand der GPT-Image-Kanäle betrifft, die vom 19. Oktober. Die Einträge vom 5. und 9. November betreffen den Start von 2.6 und eine Aktualisierung der Dokumentation, es sind keine Statusmeldungen. Deshalb liefert dieser Beitrag kein tagesaktuelles Stabilitätsranking, und die historischen Laufzeiten sollten Sie nicht als SLA verstehen.
Empfohlene GPT-Image-Kanäle nach Einsatzszenario
Wann der offizielle Kanal (官转) die richtige Wahl ist
- Hauptbilder für E-Commerce und Werbegrafiken: Hier brauchen Sie exakte Abmessungen oder 4K und steuern die Bildqualität über den Parameter
quality. - Lokales Nachzeichnen und Hintergrundwechsel: Beides setzt auf präzises Editieren per Maske (mask). -vip kann nur das gesamte Bild neu zeichnen, -all unterstützt keine Masken.
- Bestehender Code mit OpenAI-SDK: Die Parameterkompatibilität ist hier am besten, der Migrationsaufwand am geringsten.
Wann -all die richtige Wahl ist
- Massenhaft Material und Ideenskizzen: Es gibt keine festen Vorgaben für die Größe, wichtig ist vor allem ein niedriger Festpreis.
- Content-Produktion mit strengem Kostenbudget: Der Festpreis von $0,025 pro Bild macht die Kostenkalkulation einfach.
Wann -vip die richtige Wahl ist
- 4K gewünscht, aber Abrechnung pro Aufruf: Nutzen Sie einfach die von der Plattform bereitgestellten voreingestellten Größen.
- Hauptsächlich ganze Bilder erzeugen, ohne präzises lokales Editieren: Sie können damit leben, dass die Parameter je nach Kanalverhalten schwanken.
| Geschäftsszenario | Empfohlener Hauptkanal | Empfohlener Ersatzkanal | Hinweise beim Wechsel |
|---|---|---|---|
| Präzises lokales Editieren | Offizieller Kanal (官转) sunburst | Offizieller Kanal, Enterprise-Gruppe (sofern berechtigt) | Nicht auf -all / -vip ausweichen, die Maske wird dort wirkungslos |
| Kommerzielle Bilder in festgelegter Größe | Offizieller Kanal (官转) flare | -vip mit voreingestellten Größen | Ersatzgrößen müssen auf die 30 voreingestellten Stufen abgebildet werden |
| 4K-HD zu festen Kosten | -vip | Offizieller Kanal | Nach dem Wechsel wird nach Token abgerechnet |
| Massenhafte Bilderzeugung | -all | -vip (ebenfalls Abrechnung pro Aufruf) | Die Kosten pro Bild steigen von $0,025 auf $0,03 |
| n Varianten gleichzeitig nötig | Offizieller Kanal | -all in mehreren Schleifendurchläufen aufrufen | Reverse-Kanäle unterstützen den Parameter n nicht |
GPT-Image-Kanal-Fallback-Strategie: Retry, Circuit Breaker und Degradation
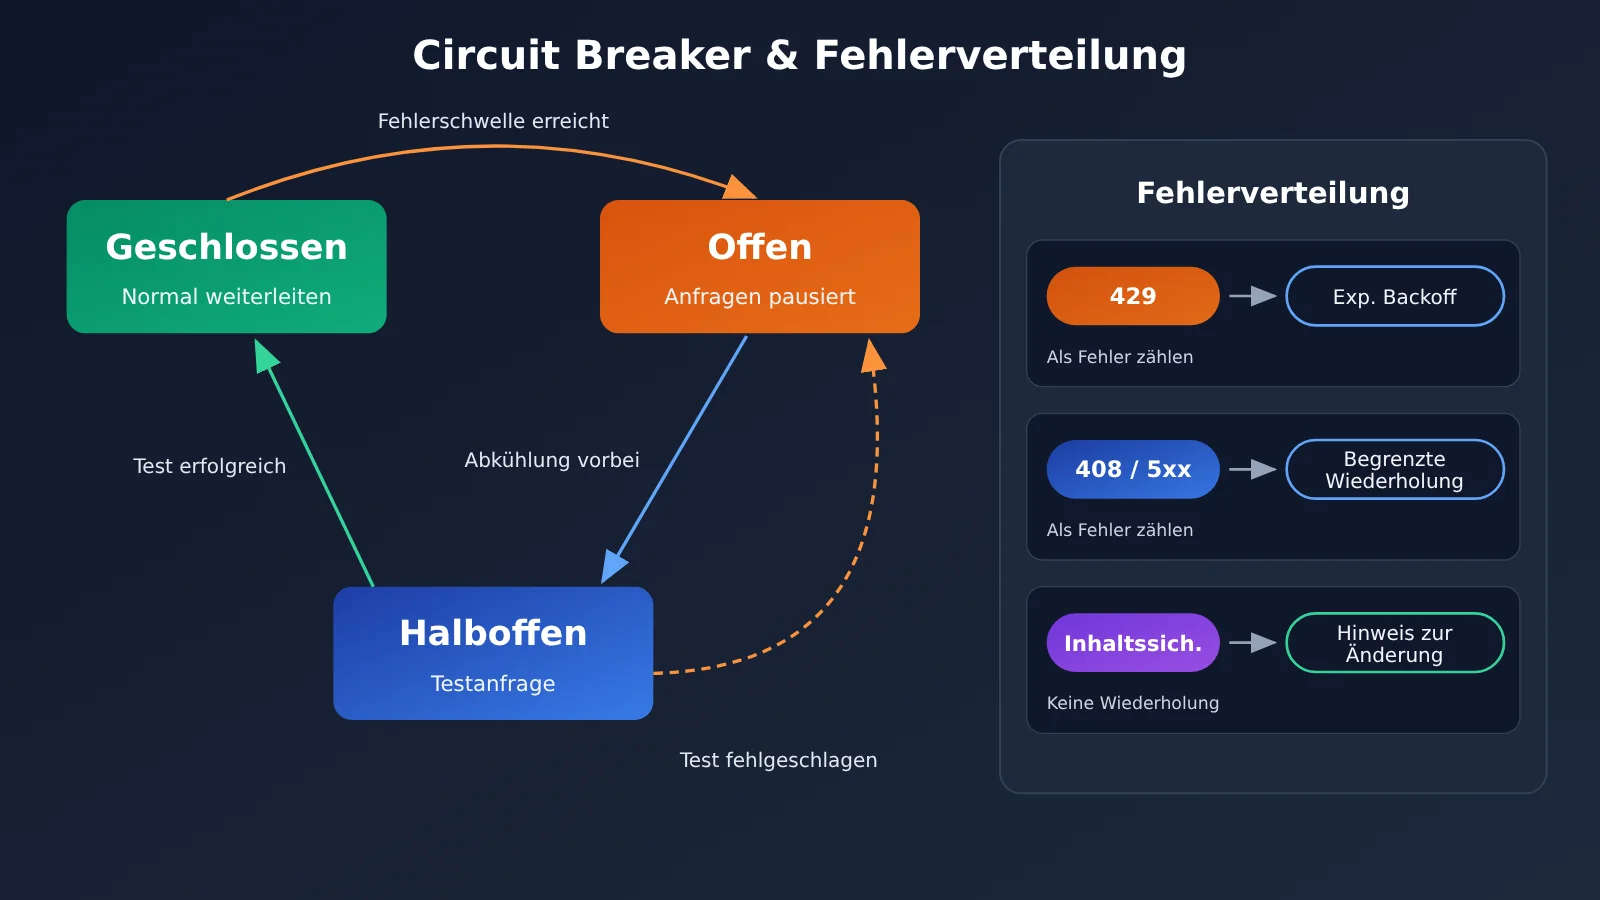
Ein verlässlicher Fallback bedeutet nicht „bei Fehler einfach nochmal senden“. Zuerst erkennen Sie den Fehlertyp, dann wählen Sie die passende Reaktion.
| Fehlertyp | Häufige Ursache | Retry? | Empfohlene Behandlung |
|---|---|---|---|
| 429 | Parallelitäts- oder Ratenlimit, ausgelasteter Ressourcenpool | Ja, zwingend mit Backoff | Exponentielles Backoff mit zufälligem Jitter; nach mehreren Fehlversuchen den Circuit Breaker auslösen und den Kanal wechseln |
| 408 / Client-Timeout | Upstream erzeugt Bilder langsam, Timeout zu kurz gesetzt | Begrenzt | Timeout beim offiziellen Weiterleitungskanal auf 360–600 Sekunden erhöhen, höchstens 2 Wiederholungen |
| 5xx-Systemfehler | Störung bei der Plattform oder beim Upstream | Begrenzt | Höchstens 2 Versuche mit exponentiellem Backoff; schlägt es weiter fehl, auf einen Ersatzkanal wechseln |
| Fehler bei der Inhaltssicherheit | Eingabeaufforderung oder Eingabebild löst die Moderation aus | Nein | Inhalt anpassen und erst dann erneut anfragen; ein unveränderter Retry verschwendet nur Kontingent |
| Dauerhaft keine Erholung | Großflächige Störung beim Upstream | Nein | Den aktuellen Kanal per Circuit Breaker sperren und auf einen per Health-Check geprüften Ersatzkanal umleiten |
Dabei gibt es zwei typische Stolperfallen. Erstens: Die Plattform hat bereits erklärt, dass ein 500er-Fehler bei -all in der Regel auf einen Inhaltsverstoß hinweist (und nicht abgerechnet wird). Außerdem werden sicherheitsbezogene 500er bei -all/-vip seit Mai direkt offengelegt und nicht mehr intern wiederholt. Ihr Client sollte deshalb die Fehlermeldung auslesen und nicht bei jedem 5xx blind erneut senden. Zweitens: Bei -vip trat zeitweise der Fehler „Unknown error“ auf. Die Erfahrung der Plattform: Jedes einzelne Eingabebild auf höchstens 1,5 MB komprimieren.
Minimalbeispiel
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
    timeout=600,  # Die Bilderzeugung über den offiziellen Kanal ist langsam, die Plattform empfahl zeitweise 360–600 Sekunden
)

resp = client.images.generate(
    model="gpt-image-2.5-flare",
    prompt="一只在咖啡馆窗边看书的橘猫,柔和晨光,写实摄影风格",
    size="1536x1024",
)
item = resp.data[0]
print(item.b64_json[:60] if item.b64_json else item.url)
Vollständigen Implementierungscode anzeigen: Mehrkanal-Retry + Circuit Breaker + Fallback
import time
import random
import logging
import openai
from openai import OpenAI

logging.basicConfig(level=logging.INFO)
BASE_URL = "https://api.apiyi.com/v1"

# Kanäle nach Priorität sortiert; verschiedene Gruppen verwenden unterschiedliche Tokens
CHANNELS = [
    {"name": "official", "model": "gpt-image-2.5-flare",
     "key": "KEY_DEFAULT", "params": {"size": "1536x1024", "quality": "high"}},
    # Nur aktivieren, wenn das Konto für die Gruppe image2Enterprise berechtigt ist
    {"name": "official-enterprise", "model": "gpt-image-2.5-flare",
     "key": "KEY_ENTERPRISE", "params": {"size": "1536x1024", "quality": "high"}},
    # Bei -vip muss size durch eines der 30 Presets aus der Dokumentation ersetzt werden
    {"name": "vip", "model": "gpt-image-2.5-flare-vip",
     "key": "KEY_DEFAULT", "params": {"size": "1536x1024"}},
    # -all unterstützt weder size noch quality noch n, nur prompt wird übergeben
    {"name": "all", "model": "gpt-image-2.5-all",
     "key": "KEY_DEFAULT", "params": {}},
]

FAIL_THRESHOLD = 3     # Anzahl aufeinanderfolgender Fehler bis zur Sicherung (Beispielwert)
COOLDOWN = 120         # Abkühlzeit der Sicherung in Sekunden (Beispielwert)
MAX_RETRY = 2          # Bei 5xx / Timeout höchstens 2 Wiederholungen
breaker = {c["name"]: {"fails": 0, "open_until": 0} for c in CHANNELS}


def classify(err: Exception) -> str:
    msg = str(err).lower()
    if any(k in msg for k in ("safety", "content_policy", "moderation", "violat")):
        return "content"
    if isinstance(err, openai.RateLimitError):
        return "rate_limit"
    if isinstance(err, openai.APITimeoutError):
        return "timeout"
    if isinstance(err, openai.APIStatusError):
        if err.status_code == 408:
            return "timeout"
        if err.status_code >= 500:
            return "server"
        return "fatal"
    if isinstance(err, openai.APIConnectionError):
        return "network"
    return "fatal"


def generate(prompt: str, need_mask: bool = False):
    for ch in CHANNELS:
        if need_mask and ch["name"] in ("vip", "all"):
            continue  # Präzise Bearbeitung fällt nicht auf Reverse-Kanäle zurück
        state = breaker[ch["name"]]
        if time.time() < state["open_until"]:
            continue  # Kanal ist durch die Sicherung gesperrt
        client = OpenAI(api_key=ch["key"], base_url=BASE_URL, timeout=600)
        for attempt in range(MAX_RETRY + 1):
            try:
                resp = client.images.generate(
                    model=ch["model"], prompt=prompt, **ch["params"])
                state["fails"] = 0
                logging.info("ok channel=%s model=%s", ch["name"], ch["model"])
                return ch["name"], resp.data[0]
            except Exception as e:
                kind = classify(e)
                logging.warning("fail channel=%s model=%s kind=%s req_id=%s",
                                ch["name"], ch["model"], kind,
                                getattr(e, "request_id", None))
                if kind in ("content", "fatal"):
                    raise  # Inhalts- oder Parameterproblem: Anfrage ändern, nicht wiederholen
                if attempt < MAX_RETRY:
                    time.sleep(2 ** (attempt + 1) + random.uniform(0, 1))
        state["fails"] += 1
        if state["fails"] >= FAIL_THRESHOLD:
            state["open_until"] = time.time() + COOLDOWN
    raise RuntimeError("所有 GPT-Image 通道均不可用")
🚀 Schnellstart: Am besten nutzen Sie zuerst das kostenlose Testguthaben für Neukunden bei APIYI (apiyi.com) und führen eine A/B-Kanalprüfung für den offiziellen Kanal, -vip und -all durch: gleiche Eingabeaufforderung, gleiche Größe, und jeweils Laufzeit, Erfolgsquote und Bildunterschiede festhalten. Erst danach legen Sie die Reihenfolge von Haupt- und Ersatzkanal fest.
Entscheidungshilfe für GPT-Image-Kanäle
Wenn Sie sich nur eine Regel merken wollen, dann diese: Den Hauptkanal wählen Sie nach den harten Anforderungen Ihres Geschäfts, den Ausweichkanal nach den unterschiedlichen Fehlerquellen. Wer präzise Mask-Bearbeitung braucht, kann Redundanz nur innerhalb des offiziellen Weiterleitungskanals aufbauen, zum Beispiel mit der Standardgruppe plus einer Unternehmensgruppe. Wer lediglich ganze Bilder erzeugt, kann „offizielle Weiterleitung + -vip“ oder „-all + -vip“ kombinieren, sodass sich zwei Leitungen mit unterschiedlichen Fehlerquellen gegenseitig absichern. Außerdem sollten Sie bei jeder Anfrage das tatsächlich verwendete Modell, den Kanal und die request_id protokollieren. Das erleichtert später den Abgleich und die Fehlersuche.
💡 Empfehlung: Die Leistung der Kanäle schwankt mit den Ressourcen im Upstream – wer bisher stabil war, bleibt nicht automatisch stabil. Wir empfehlen, über die einheitliche Schnittstelle von APIYI (apiyi.com) mindestens zwei Kanäle parallel anzubinden und sie regelmäßig mit wenig Traffic auf ihre Gesundheit zu prüfen, statt sich dauerhaft auf das Ergebnis eines einzelnen Tests zu verlassen.
Häufig gestellte Fragen (FAQ)
Q1: Was bedeuten „Guanzhuan“ und „Guanni“ bei GPT-Image?
„Guanzhuan“ (官转) ist eine Route, die direkt über die offizielle OpenAI Images API weiterleitet. „Guanni“ (官逆) ist die Plattformkategorie für Reverse-Engineering-Ressourcen. Dazu gehören -all, das auf der ChatGPT-Weboberfläche basiert, und -vip, das laut Plattformdokumentation über eine Adobe/Firefly-Route läuft. Guanni ist keine offiziell von OpenAI bereitgestellte API.
Q2: Was ist der Unterschied zwischen GPT-Image -all und -vip?
Beide werden pro Aufruf abgerechnet. -all kostet $0.025 pro Bild und unterstützt weder size und quality noch 4K. -vip kostet $0.03 pro Bild und unterstützt 30 voreingestellte Größen sowie voreingestelltes 4K. Das Parameterverhalten hängt allerdings vom Kanal ab: In der Vergangenheit fiel size zeitweise aus und funktionierte später wieder.
Q3: Gibt es auch für GPT-Image 2.6 die Varianten -all und -vip?
In der Modellregistrierung vom 2026-11-11 sind nur zwei tokenbasiert abgerechnete Modelle für 2.6 aufgeführt: gpt-image-2.6-flare und gpt-image-2.6-sunburst. Modelle mit -all oder -vip gibt es für 2.6 nicht. Bitte übertragen Sie die Fähigkeiten von 2.5 VIP nicht einfach auf 2.6.
Q4: Garantiert die Unternehmensgruppe image2Enterprise Ausfallsicherheit?
Nein. Sie lief mehrfach stabil, wenn die Standardgruppe überlastet war, war aber am 2026-05-07 ebenfalls von einem Upstream-Ausfall bei OpenAI betroffen. Der Multiplikator beträgt 1.2x, ob Sie freigeschaltet werden können, sehen Sie in der Konsole. Die Gruppe eignet sich als Redundanz innerhalb der Guanzhuan-Routen, ist aber keine Rundum-Versicherung.
Q5: Wie teste ich schnell mehrere GPT-Image-Kanäle per API?
1. Registrieren Sie sich bei APIYI (apiyi.com) und holen Sie sich einen API-Schlüssel samt kostenlosem Testguthaben.
2. Setzen Sie base_url auf `https://api.apiyi.com/v1` und wechseln Sie gemäß dem Code in diesem Artikel den Parameter model.
3. Rufen Sie jeden Kanal mit derselben Eingabeaufforderung auf und notieren Sie Laufzeit, Erfolgsquote und Bildqualität.
Über die einheitliche Schnittstelle müssen Sie für einen Kanalwechsel nur den Modellnamen ändern und kein eigenes SDK pro Upstream pflegen.
Q6: Soll ich bei 5xx-Fehlern immer weiter wiederholen?
Nein. Die Plattformdokumentation empfiehlt, bei 5xx-Fehlern und Timeouts höchstens zwei Wiederholungen mit exponentiellem Backoff zu machen. Ein 500er bei -all hängt meist mit einem Inhaltsverstoß zusammen, ein erneuter Versuch hilft dann nicht. Sind die Wiederholungen aufgebraucht, sollten Sie den aktuellen Kanal per Circuit Breaker sperren und auf einen Ersatzkanal umschalten.
Q7: Welche bekannten Einschränkungen haben die GPT-Image-Kanäle?
– Bei Guanzhuan-Eingabeaufforderungen mit mehr als etwa 8192 Tokens gibt es keine Fehlermeldung, aber das Ergebnis wird unbrauchbar.
– Transparente Hintergründe wurden bei gpt-image-2 offiziell abgeschaltet. Wenn Sie einen transparenten Hintergrund brauchen, nutzen Sie 2.5 Guanzhuan.
– Die Reverse-Kanäle unterstützen weder den Parameter n noch präzise Masken.
– Bei -vip sollten Eingabebilder auf maximal 1,5 MB komprimiert werden.
GPT-Image Kanalwahl: Die wichtigsten Punkte (Key Takeaways)
- Drei Kanaltypen: „官转“ (offizieller Durchlauf) nutzt die offizielle Images API, „-all“ hängt an der ChatGPT-Webversion, „-vip“ an einem plattformeigenen Kontenpool.
- Parameterunterschiede: Nur der offizielle Kanal unterstützt beliebige
size-Werte,nund präzises Mask-Editing vollständig. - Abrechnung: Der offizielle Kanal rechnet nach Token ab, „-all“ kostet $0,025 pro Bild, „-vip“ $0,03 pro Bild.
- Enterprise-Gruppe: image2Enterprise ist eine Token-Gruppe mit Faktor 1,2x und kein eigenständiges Modell.
- Ausfallmuster: Die Ausfälle der Kanäle haben jeweils unterschiedliche Ursachen. In der Vergangenheit war oft ein Kanal gestört, während der andere normal lief.
- Retry-Prinzipien: Bei 429 mit Backoff erneut versuchen, bei 5xx und Timeouts höchstens 2 Mal, bei Content-Safety-Fehlern gar nicht.
- Einstieg: Beide Kanäle über die einheitliche Schnittstelle von APIYI anbinden und per A/B-Test entscheiden, welcher primär und welcher Fallback wird.
Fazit
Die wichtigsten Punkte zur Kanalwahl bei GPT-Image:
- Hauptkanal nach harten Anforderungen wählen: Wer präzise Bearbeitung und beliebige Bildgrößen braucht, nimmt den offiziellen Kanal. Wer einen festen, niedrigen Preis will, nimmt „-all“. Wer 4K mit Abrechnung pro Aufruf braucht, nimmt „-vip“.
- Backup-Kanal nach Ausfallursache wählen: Haupt- und Ersatzleitung sollten keine gemeinsamen Upstream-Abhängigkeiten haben. Ein einzelner Kanal stößt früher oder später an Kapazitätsgrenzen oder erlebt Upstream-Störungen.
- Fehlertypen gezielt abfangen: Begrenzte Wiederholungen, exponentielles Backoff, Circuit Breaker mit Abkühlphase und Logging – alle vier Bausteine gehören dazu.
Die Statusmeldungen der Vergangenheit zeigen: Kein GPT-Image-Kanal läuft dauerhaft völlig störungsfrei. Zuverlässigkeit entsteht durch die Architektur, nicht dadurch, auf die eine richtige Leitung zu setzen. Am besten bindest du über APIYI (apiyi.com) mit einem einzigen Schlüssel mehrere Kanäle an, fährst zuerst eine Runde mit wenig Traffic zum Vergleich und legst dann deine Haupt- und Backup-Lösung fest.
📚 Referenzen
- APIYI Live-Archiv: Historische Statusmeldungen, Preisänderungen und Dokumentationsupdates zu den einzelnen GPT-Image-Kanälen
- Link:
docs.apiyi.com/live/archive -
Hinweis: Quelle für die Zeitleiste der Störungsanalyse in diesem Artikel. Den aktuellen Status entnehmen Sie bitte den neuesten Meldungen
-
APIYI Modellregister: Modell-IDs, Abrechnungsarten, sichtbare Gruppen und Gruppenmultiplikatoren
- Link:
docs.apiyi.com/model-registry.json -
Hinweis: Die in diesem Artikel zitierten Daten wurden am 11.11.2026 erzeugt. Die Preise sind Listenpreise vor Rabatt
-
OpenAI-Statusseite: Offizieller Servicestatus von OpenAI
- Link:
status.openai.com - Hinweis: Die Plattform hat zeitweise empfohlen, diese Seite im Blick zu behalten, um zu beurteilen, ob eine Störung beim offiziellen Kanal vom Upstream ausgeht
Autor: APIYI Technik-Team
Austausch: Melden Sie sich gern über die Startseite der APIYI-Website bei uns. Weitere Infos zur GPT-Image-Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com