Примечание автора: в статье сравниваются Gemini 4 Carbon, Claude Fable 5.2 и GPT-6 Astra по двум системам оценки: комплексному индексу AA и профессиональному бенчмарку MKA. Мы смотрим на результаты, время выполнения и стоимость, а также объясняем, где применимы конфигурации тестов и статистические выводы.
Перед чтением: 7 терминов, которые нужны для сравнения трёх моделей
- MKA (Multimodal Knowledge Agent): бенчмарк для оценки мультимодальных профессиональных рабочих задач. Он проверяет, может ли модель разобраться в сложных документах (чертежах, сканах, медицинских снимках) и выдать законченный профессиональный результат.
- Climb WSR: взвешенная доля выполненных критериев, посчитанная только по самым «разделяющим» пунктам оценки. Помогает увидеть разницу между топовыми моделями.
- Regression WSR: взвешенный показатель того, выполнены ли базовые требования. По сути, это проходной порог для профессиональной сдачи работы.
- Уровень рассуждения: настройка интенсивности рассуждений, доступная модели. Например, LOW, MEDIUM и HIGH у Carbon, а также конфигурации Max и Xhigh у Fable и Astra в рейтинге.
- Стоимость задачи: суммарная плата за все вызовы моделей при выполнении конкретной задачи. Это не фиксированная цена одного API-запроса.
- Чтение из кэша: повторное использование уже закэшированного входного контента, которое тарифицируется по сниженной цене.
- Статистическая значимость: показатель, который говорит, достаточно ли статистических данных, чтобы считать разницу в баллах между двумя моделями реальной. Если разрыв не дотягивает до значимого уровня, его нельзя считать уверенной победой одной из моделей.
Конкуренцию топовых моделей уже непросто описать одной сводной таблицей лидеров. В этой статье мы сравниваем Gemini 4 Carbon, Claude Fable 5.2 и GPT-6 Astra по трём направлениям: общие возможности, профессиональная сдача работы и стоимость задачи. В конце даём рекомендации по выбору модели под разные типы задач.
Это не пересказ рейтинга, где все баллы свалены в одну кучу. Комплексный индекс и MKA — это две разные системы оценки, поэтому мы разбираем их отдельно. Заодно покажем, какие разрывы подтверждены статистикой, а каких для уверенных выводов не хватает.
Главная польза: прочитав статью, вы сможете понять, какую модель стоит выбрать в первую очередь, исходя из требований вашей задачи к качеству, скорости и стоимости.
I. Gemini 4 Carbon, Claude Fable 5.2 и GPT-6 Astra выходят на одну арену
Все три релиза уложились в очень короткий срок. Google впервые представила Gemini 4 Carbon 28 октября 2026 года, Anthropic выпустила Claude Fable 5.2 9 ноября, а 10 ноября Carbon официально открыли для разработчиков, компаний и обычных пользователей. В тот же день Google DeepMind и Artificial Analysis запустили бенчмарк MKA. 11 ноября обновился Artificial Analysis Intelligence Index v5.0.1, в который добавили Fable 5.2.
Публичное позиционирование у моделей заметно различается. Carbon построена на базе Gemini 4 Argon и ориентирована на долгоживущих агентов, сложную программную инженерию и научные исследования. Она принимает на вход текст, изображения, аудио и видео. Fable 5.2 использует Adaptive Thinking, имеет контекстное окно в 1M токенов и максимальный вывод 128K токенов. У GPT-6 Astra есть результаты в обоих бенчмарках, на которые опирается эта статья, поэтому её часто берут как эталон эффективности.
| Критерий | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra | Текущий вывод |
|---|---|---|---|---|
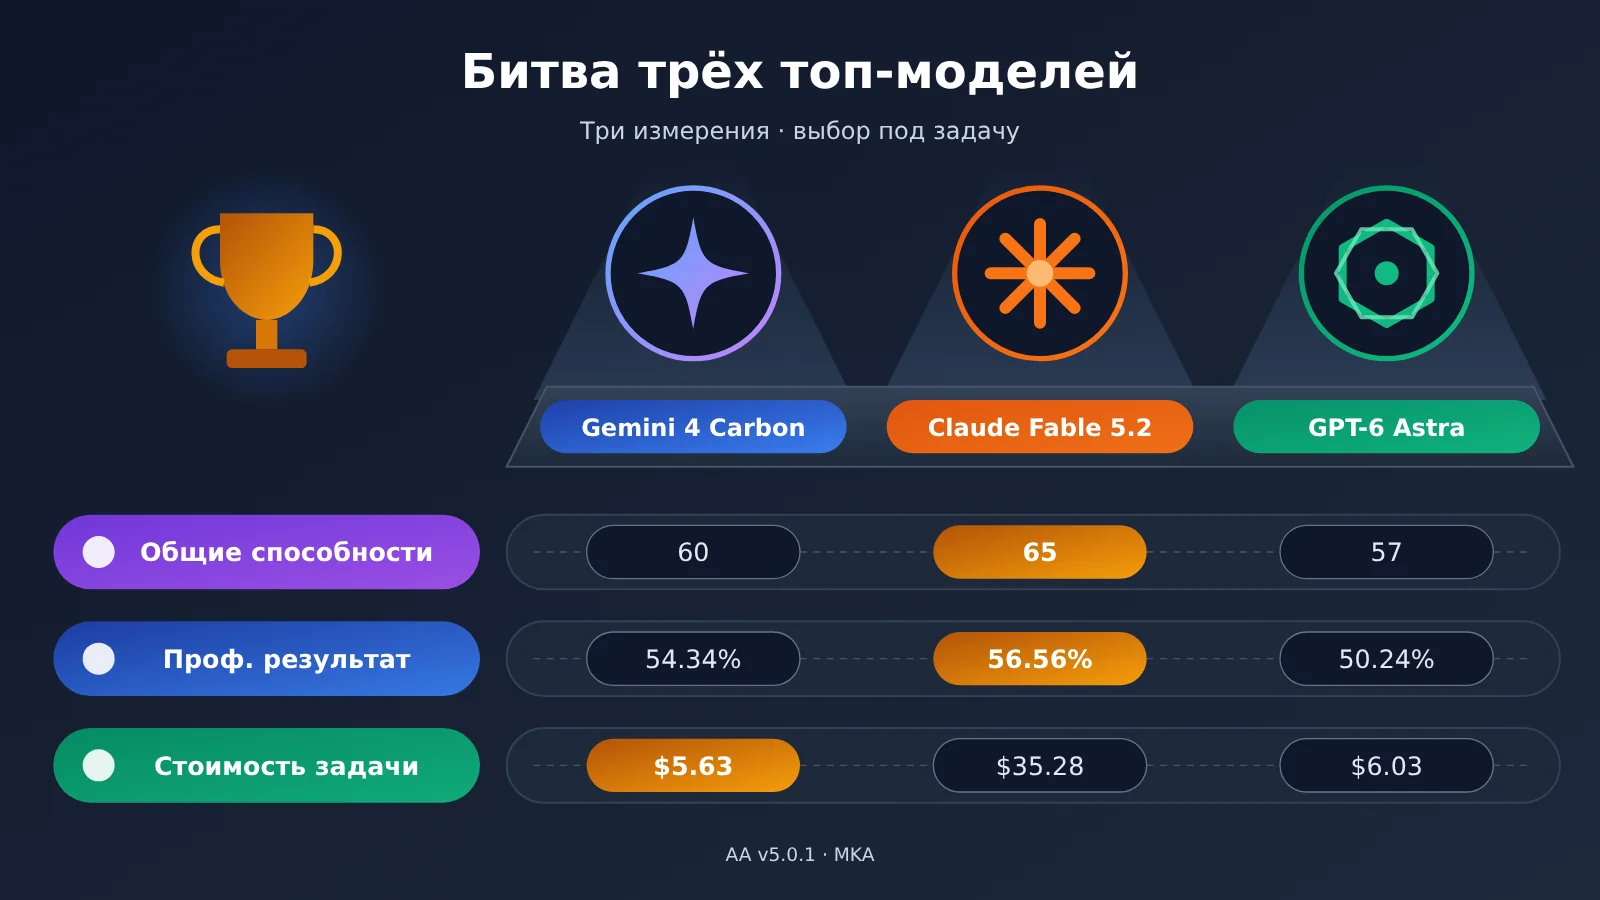
| Общие способности (AA v5.0.1) | 65 (Max) | 60 (High) | 57 (Max) | Лидирует Fable |
| Профессиональная сдача работы (MKA Climb-WSR) | 56.56% | 54.34% | 50.24% | Fable и Carbon близки, обе впереди Astra |
| Стоимость одной задачи (MKA, табл. 4) | $35.28 | $5.63 | $6.03 | Carbon дешевле всех |
| Время выполнения (MKA, табл. 4) | 83.2 мин | 29.2 мин | 18.5 мин | Astra быстрее всех |
| Расход токенов (MKA, табл. 4) | 40.48M | 7.05M | 2.43M | Astra экономнее всех |
Колонка «Текущий вывод» относится только к конкретному показателю в своей строке. Ни одна модель не занимает первое место по всем параметрам сразу.
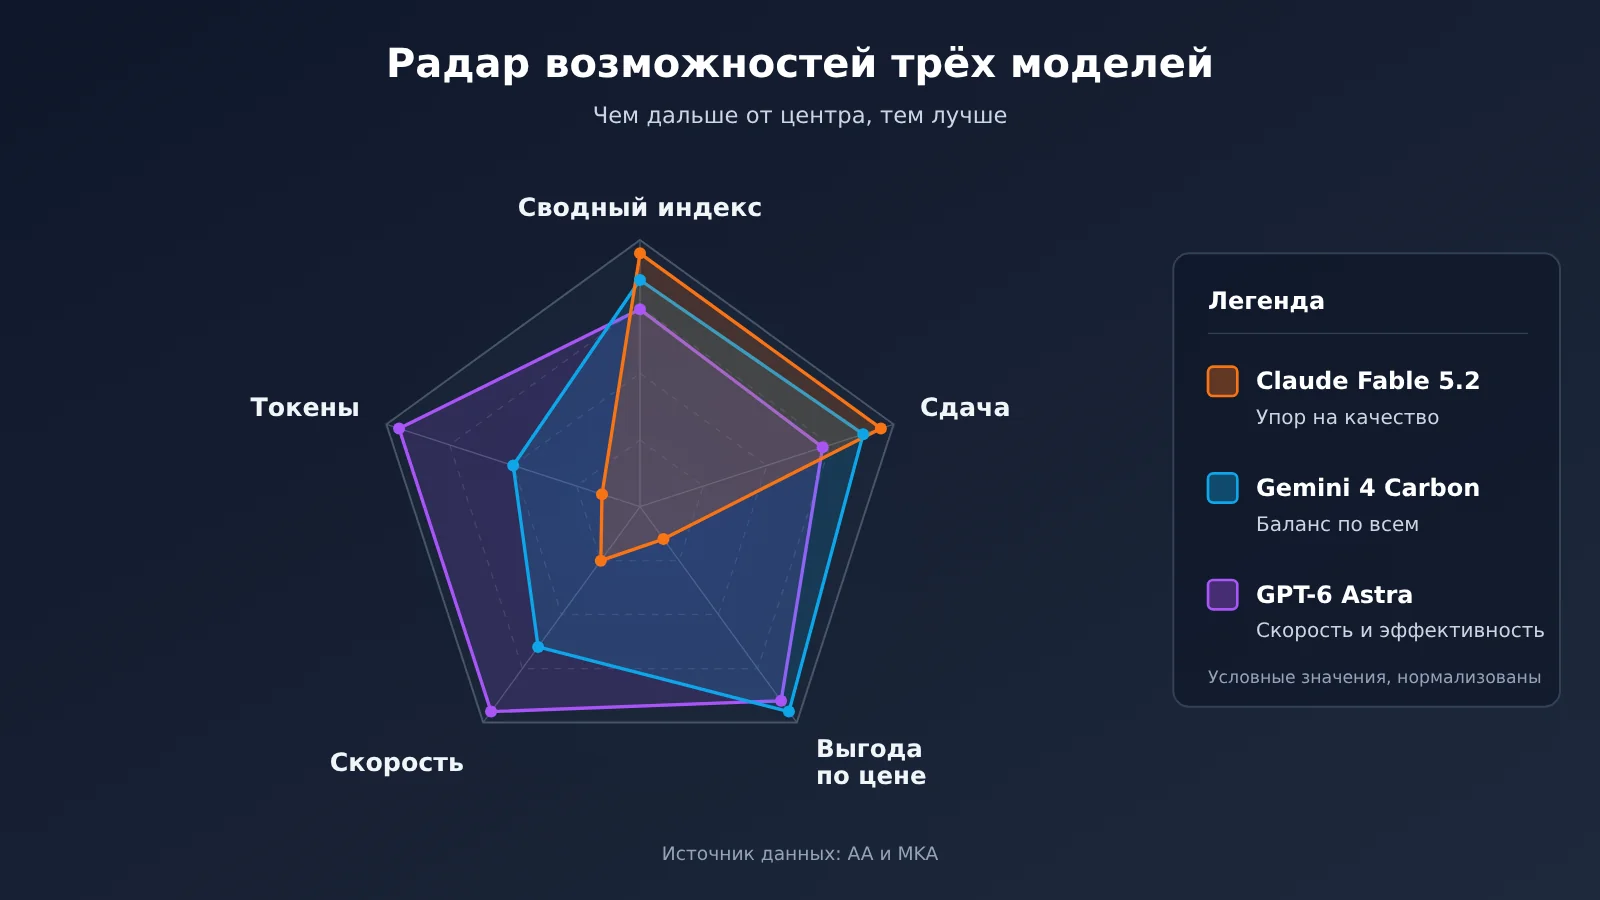
📊 Примечание к данным: цифры в таблице взяты из снимка рейтинга AA и технической статьи MKA. Методики у них разные, поэтому пересчитывать одно в другое нельзя. Чтобы проверить модели на своих задачах, можно через APIYI (apiyi.com) прогнать один и тот же промпт на всех трёх и посмотреть, как они ведут себя на реальной нагрузке.
II. Общий рейтинг AA: Claude Fable 5.2 пока впереди, Gemini 4 Carbon наступает на пятки
Artificial Analysis Intelligence Index v5.0.1 состоит из 9 тестов: AA-Briefcase v1.1, AutomationBench-AA, Terminal-Bench 4.0, FrontierCode 2.0, AA-Omniscience v1.1, GDP.pdf, HLE-Diamond, CritPt v2 и Terminal-Bench-Science 0.1. Они охватывают интеллектуальную работу, автоматизацию, код, научные рассуждения и фактическую надёжность. Индекс отвечает на вопрос: «Насколько сильна модель в целом?»
| Конфигурация модели | AA Index v5.0.1 | Стоимость одной тестовой задачи | Время на одну задачу |
|---|---|---|---|
| Claude Fable 5.2 Max | 65 | $26.54 | 44,4 мин |
| Gemini 4 Carbon High | 60 | $7.76 | 24,9 мин |
| GPT-6 Astra Max | 57 | $6.24 | 23,0 мин |
В этой таблице важно учитывать разницу в конфигурациях. Три модели запускались на уровнях Max, High и Max соответственно, а бюджет на рассуждения у них разный. Поэтому результаты нельзя считать чистым сравнением возможностей в равных условиях. У одной и той же модели оценка меняется и при смене уровня: Xhigh и High у Fable 5.2 дают по 62 балла, а Medium и Low у Carbon — 58 и 54 балла.
Данные по уровням внутри Carbon стоит рассмотреть отдельно. По расчётам AA, стоимость задачи на уровне Medium составляет $6.59, то есть даже ниже, чем на Low ($7.19). У High оценка самая высокая, но задержка до первого токена ответа доходит до 67,54 секунды. Выходит, что повышение уровня рассуждений не всегда даёт пропорциональный выигрыш. Цифра $7.76 в таблице — это средняя стоимость задачи AA при стандартной цене Carbon $4/$20, а не цена обычного запроса.
III. MKA: насколько хорошо три модели справляются с профессиональной работой
Индекс AA показывает общую силу модели, а MKA проверяет, может ли модель выполнить реальную профессиональную работу. В техническом отчёте MKA задана такая постановка:
- Всего 200 закрытых реальных задач из 10 отраслей и 83 профессий. Каждая задача соответствует примерно 3–8 часам работы специалиста.
- В каждой задаче около 70 взвешенных критериев оценки. В 88% задач нужно создать отдельный файл: Word, Excel, PPT, PDF, HTML или изображение.
- Все модели работают в одном и том же Stirrup Agent Harness с одинаковой средой инструментов и единым бюджетом в 250 шагов. Каждая задача запускается один раз.
| Модель | Climb-WSR | Overall WSR | Regression-WSR |
|---|---|---|---|
| Claude Fable 5.2 | 56.56% | 73.26% | 95.71% |
| Gemini 4 Carbon | 54.34% | 71.89% | 96.36% |
| GPT-6 Astra | 50.24% | 69.34% | 95.17% |
У каждой из трёх метрик свой смысл. Regression-WSR показывает, насколько выполняются базовые требования. У всех трёх моделей он выше 95%, у Carbon чуть выше остальных. Climb-WSR учитывает только самые сложные пункты, и именно он лучше всего разделяет топовые модели. Overall WSR — общая взвешенная доля выполненных критериев по всем пунктам. Ни одна из этих цифр не является долей правильных ответов в обычных вопросах и ответах, поэтому сравнивать их с оценками 65, 60 и 57 по индексу AA нельзя.
Статистическая значимость: Claude Fable 5.2 и Gemini 4 Carbon
Именно на статистическую значимость нужно обращать внимание в первую очередь, когда читаешь результаты MKA. В отчёте приведены такие данные:
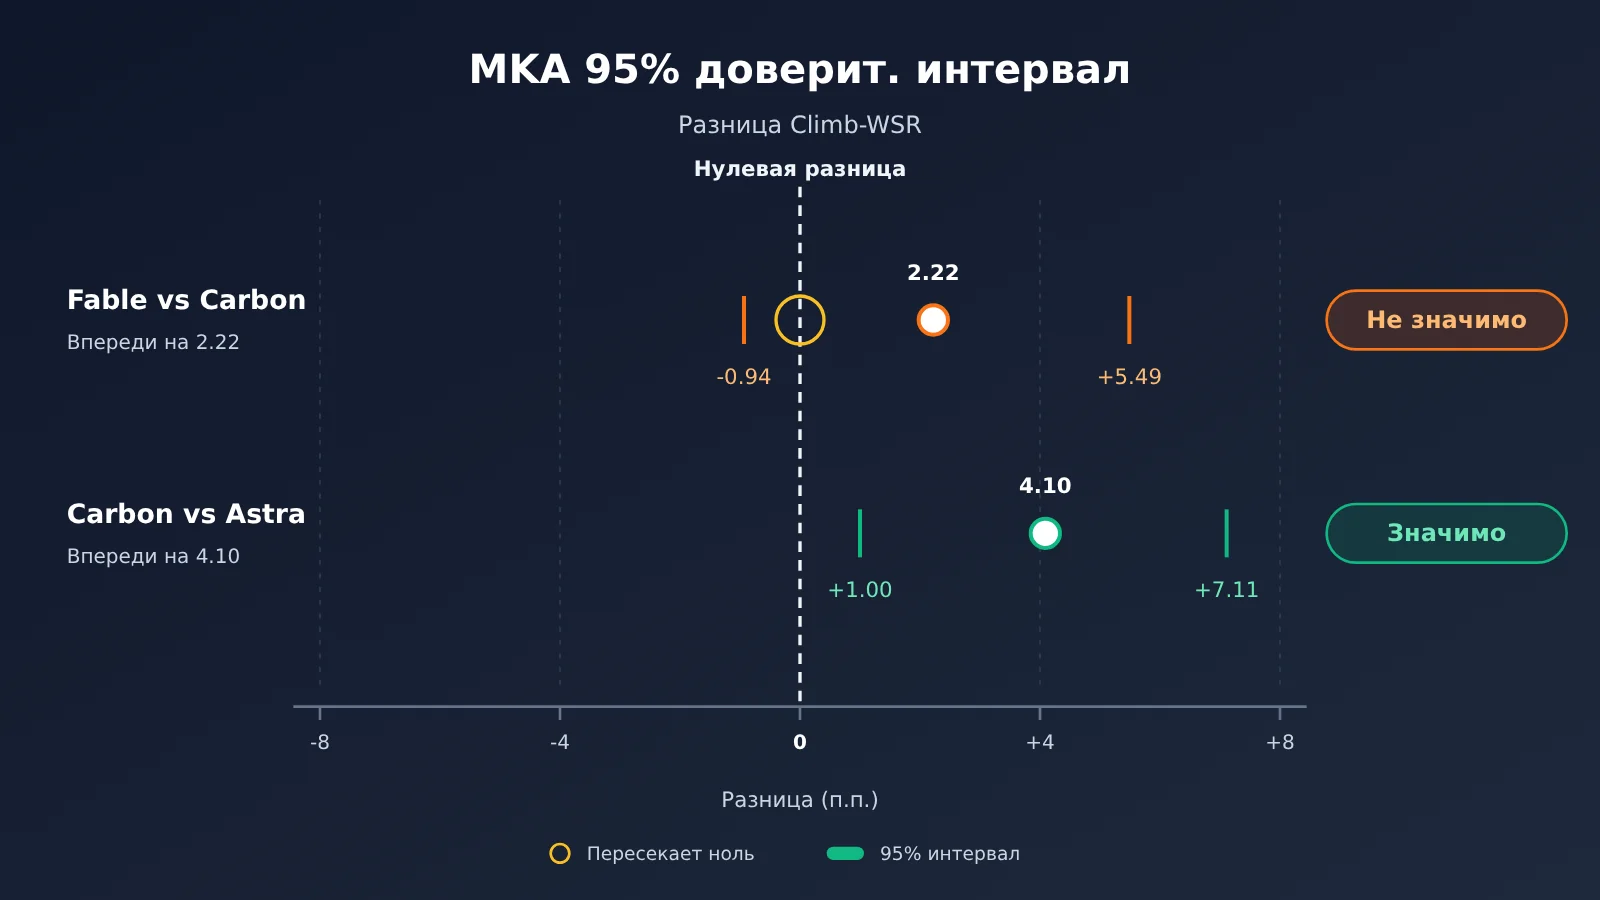
- Fable против Carbon: преимущество 2,22 процентного пункта, 95%-й доверительный интервал от -0,94 до +5,49. Интервал пересекает 0, поэтому разница не достигает статистической значимости.
- Carbon против Astra: преимущество 4,10 процентного пункта, 95%-й доверительный интервал от +1,00 до +7,11. Интервал целиком лежит выше 0, значит, разница статистически значима.
Поэтому корректно говорить так: в MKA Fable 5.2 и Carbon находятся на близком уровне, и имеющихся данных недостаточно, чтобы уверенно утверждать, что Fable лучше Carbon. Вывод отчёта: обе эти модели заметно опережают Astra.
IV. Сравнение стоимости задач: во сколько обходится одна и та же задача трём моделям
В таблице 4 статьи MKA приведён средний расход ресурсов на задачу. Стоимость API посчитана по прайс-листам производителей с учётом тарификации кэширования промптов.
| Средние показатели на задачу | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra |
|---|---|---|---|
| Всего токенов | 40.48M | 7.05M | 2.43M |
| Выходные токены | 378.9K | 129.5K | 42.0K |
| Число ходов агента | 128.8 | 46.6 | 29.0 |
| Время выполнения | 83.2 мин | 29.2 мин | 18.5 мин |
| Стоимость одной задачи | $35.28 | $5.63 | $6.03 |
Из этой таблицы можно сделать три вывода:
- Fable тратит больше всех ресурсов: общее число токенов в 5,74 раза больше, чем у Carbon, а время выполнения — примерно в 2,85 раза. Высокое качество результата достигается за счёт многоходового поиска решения и большого числа вызовов.
- Лучшее соотношение цены и качества у Carbon: стоимость одной задачи примерно в шесть раз ниже, чем у Fable, а по Climb-WSR он отстаёт всего на 2,22 процентного пункта, причём эта разница статистически незначима.
- Astra — самая быстрая и самая экономная по токенам: у неё минимальные время выполнения и расход токенов, но стоимость одной задачи всё равно немного выше, чем у Carbon, а по Climb-WSR она заметно уступает Carbon.
Чем отличаются цена за токен, расход токенов и итоговый счёт за задачу
Эти три понятия часто путают. Начнём с цены за токен: у Fable 5.2 она составляет $8 за миллион входных токенов и $40 за миллион выходных. У Carbon стартовая цена до 30 ноября — $2/$10, а с 1 декабря — $4/$20. Но низкая цена за токен ещё не значит низкий счёт. Astra расходует примерно в три раза меньше токенов, чем Carbon, а стоимость одной задачи у неё чуть выше. Это показывает, что на итоговую сумму влияют и структура цен у разных моделей, и доля попаданий в кэш.
Чтение из кэша — переменная, о которой в сценариях с агентами часто забывают. На каждом ходу агент заново отправляет большой объём контекста. Например, у Carbon цена кэшированного входа составляет около 5% от обычной цены входа. У Fable общее число токенов достигает 40.48M, и значительная их часть — это повторно читаемый контекст, поэтому способ тарификации напрямую влияет на счёт. Кроме того, у Carbon токены рассуждений входят в стоимость выходных токенов, а при использовании Grounding поисковые запросы оплачиваются отдельно.
Данные о стоимости приводятся в трёх разных разрезах, и ссылаться на них нужно по отдельности: таблица 4 статьи MKA (Carbon $5.63, Fable $35.28), динамический рейтинг MKA (Carbon $6.29, Fable $31.97) и стоимость задач по индексу AA ($7.76 и $26.54). У них разный охват статистики, так что смешивать эти цифры нельзя.
V. В чём проявляется мультимодальное преимущество Gemini 4 Carbon
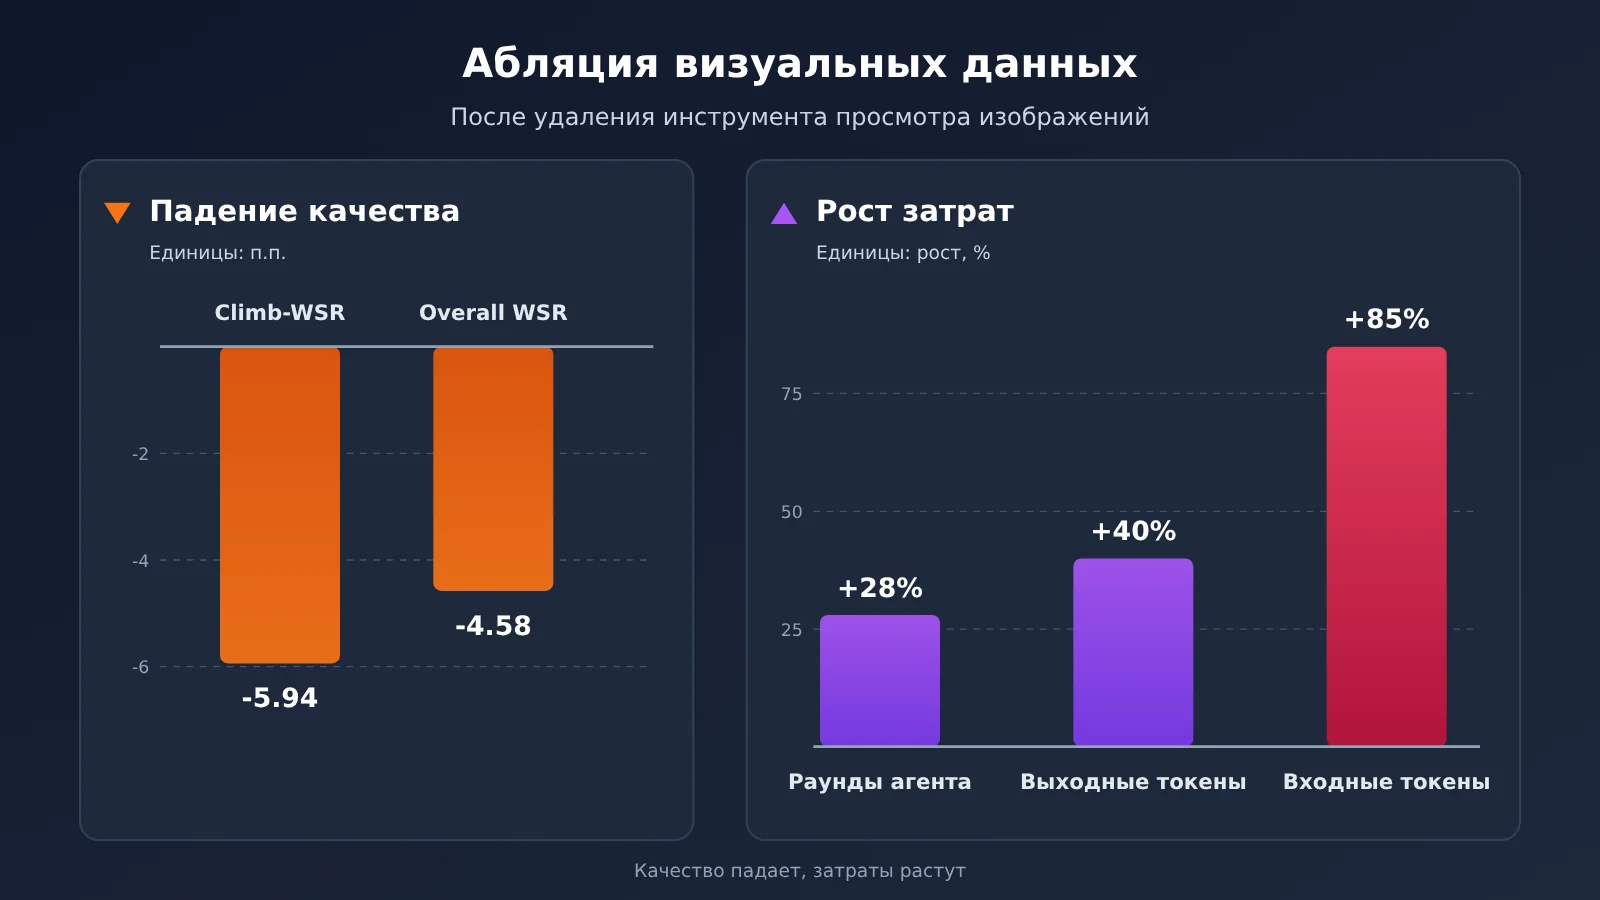
В статье про MKA провели абляционный эксперимент: у Carbon убрали инструмент просмотра изображений view_image и оставили только OCR, выполнение кода и классические методы компьютерного зрения. Результаты такие:
- Climb-WSR упал на 5,94 процентного пункта, Overall WSR — на 4,58 процентного пункта.
- Число шагов агента выросло на 28%, выходных токенов стало больше на 40%, входных — на 85%.
- Модель пыталась компенсировать нехватку зрения с помощью ASCII-изображений, Unicode Braille и OpenCV, но на реальных фотографиях и медицинских снимках у неё всё равно часто не получалось.
Эти цифры показывают: в профессиональной работе визуальное понимание трудно заменить извлечением текста. Пространственные связи на чертежах, расположение очагов поражения на снимках, визуальное кодирование на диаграммах — после OCR всё это в основном теряется. Модели остаётся снова и снова писать код и гадать, что изображено на картинке. В итоге качество падает, а затраты растут.
Отраслевые результаты в рейтинге MKA это подтверждают. Carbon лидирует в сфере здравоохранения, а в задачах, где результат сдаётся в виде изображений, Carbon и Argon показывают лучшие результаты. Fable 5.2 впереди в разработке ПО и данных, инженерии, логистике и картографии, бизнесе, финансах, а также по типам результатов вроде PDF, Word и Spreadsheet. Ни одна модель не лидирует сразу во всех 10 отраслях, а Word и обычные текстовые файлы остаются самыми сложными типами результатов: ни одна модель не преодолела на них порог в 52%.
6. Рекомендации по сценариям: для каких задач подходят Gemini 4 Carbon, Claude Fable 5.2 и GPT-6 Astra
Когда выбирать Claude Fable 5.2
- Сложные профессиональные задачи, где важно максимальное качество результата: например, финансовые аналитические отчёты, инженерные решения и проекты в области разработки ПО и данных. Ошибка в таких задачах обходится дорого, поэтому можно смириться с более долгим выполнением и более высоким счётом.
- Задачи, где основной результат — офисные документы: PDF, Word и таблицы — сильная сторона Fable в MKA.
Когда выбирать Gemini 4 Carbon
- Сложная работа с агентами, где нужен баланс качества и стоимости: в MKA Carbon показал уровень, статистически близкий к Fable, при стоимости примерно в шесть раз ниже.
- Задачи, завязанные на визуальное понимание: например, разбор чертежей, вспомогательный анализ медицинских изображений и результаты в виде изображений. Уровень рассуждений советуем начинать с MEDIUM: в тесте AA на фактическую достоверность у него ниже доля выдуманных ответов.
Когда выбирать GPT-6 Astra
- Конвейеры, где важна скорость выполнения: в MKA у него самое короткое время выполнения и наименьшее число раундов агента, так что он подойдёт для задач, где нужна быстрая обратная связь.
- Сценарии, чувствительные к бюджету токенов или нагрузке на контекст: у Astra самый низкий суммарный расход токенов, но придётся смириться с отставанием в качестве профессиональных результатов.
| Тип задачи | Первый выбор | Запасной вариант | Основание | Способ подключения |
|---|---|---|---|---|
| Ценные профессиональные отчёты | Claude Fable 5.2 | Gemini 4 Carbon | Самые высокие баллы в AA и MKA | Официальный API, APIYI |
| Массовые сложные задачи для агентов | Gemini 4 Carbon | Claude Fable 5.2 | Близкое качество, стоимость примерно в шесть раз ниже | Официальный API, APIYI |
| Анализ чертежей и изображений | Gemini 4 Carbon | Claude Fable 5.2 | Данные визуальной абляции, лидерство в медицинской области | Официальный API, APIYI |
| Конвейеры быстрого выполнения | GPT-6 Astra | Gemini 4 Carbon | Самое короткое время и наименьший расход токенов | Официальный API, APIYI |
七、как на едином интерфейсе протестировать три модели
Публичные рейтинги — это только отправная точка. В итоге всё решает то, как модель справляется именно с вашими задачами. В примере ниже используется OpenAI-совместимый интерфейс: достаточно поменять параметр model, и в одном и том же коде можно вызывать разные модели:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "用三点概括这份季度财报摘要的主要风险。"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # Записываем расход токенов, чтобы потом прикинуть стоимость
Полный код сравнительного теста трёх моделей
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Названия моделей берите из списка моделей на платформе; GPT-6 Astra здесь — условное название
MODELS = ["claude-fable-5-2", "gemini-4-carbon", "gpt-6-astra"]

# Цены (доллары за миллион токенов) укажите по вашему реальному каналу
# Пример: Fable 5.2 — официальная цена; Carbon — стартовая цена, действующая до 30 ноября
PRICES = {
    "claude-fable-5-2": {"input": 8.0, "output": 40.0},
    "gemini-4-carbon": {"input": 2.0, "output": 10.0},
    "gpt-6-astra": None,  # Заполните самостоятельно
}

def build_messages(task, image_url=None):
    content = [{"type": "text", "text": task}]
    if image_url:
        content.append({"type": "image_url", "image_url": {"url": image_url}})
    return [{"role": "user", "content": content}]

def run_once(model, messages):
    start = time.time()
    resp = client.chat.completions.create(model=model, messages=messages)
    elapsed = time.time() - start
    usage = resp.usage
    cost = None
    price = PRICES.get(model)
    if price and usage:
        # Грубая оценка: чтение из кеша не учитывается; токены рассуждений обычно входят в выходные
        cost = (usage.prompt_tokens * price["input"]
                + usage.completion_tokens * price["output"]) / 1_000_000
    return {
        "model": model,
        "seconds": round(elapsed, 1),
        "prompt_tokens": usage.prompt_tokens if usage else None,
        "completion_tokens": usage.completion_tokens if usage else None,
        "est_cost_usd": round(cost, 4) if cost is not None else None,
        "answer": resp.choices[0].message.content[:200],
    }

if __name__ == "__main__":
    task = "根据这张户型图,列出各房间面积估算和三条改造建议。"
    msgs = build_messages(task, image_url="https://example.com/floor-plan.png")
    for m in MODELS:
        try:
            print(run_once(m, msgs))
        except Exception as e:
            print(m, "调用失败:", e)
Этот код считает стоимость одного вызова. В реальной агентной задаче нужно суммировать расходы по всем шагам — это и есть та самая стоимость задачи, о которой шла речь в статье. Кроме того, Carbon не поддерживает thinking_budget: если передать этот параметр, вернётся HTTP 400. Параметры сэмплирования, например temperature, тоже игнорируются, а уровень рассуждений нужно задавать так, как описано в документации платформы.
🚀 Рекомендация для быстрого старта: сначала получите бесплатные тестовые кредиты для новых пользователей на APIYI (apiyi.com) и прогоните сравнительный скрипт, приведённый выше, на 5–10 реальных бизнес-примерах. Запишите время выполнения, расход токенов и оценку качества — и только потом решайте, какая модель станет основной. Платформа даёт доступ к OpenAI, Claude, Gemini и другим популярным моделям через один и тот же API-ключ, оплата по факту использования, а для смены модели достаточно поменять один параметр.
Рекомендации по выбору: как выбрать между тремя моделями
При выборе модели сначала определите самое жёсткое ограничение в вашей задаче, а затем смотрите на соответствующий показатель:
- Жёсткое требование — качество: ориентируйтесь на Climb-WSR из MKA и выбирайте между Fable 5.2 и Carbon. Разрыв между ними незначительный, так что лучше проверить обе модели на собственных примерах.
- Жёсткое требование — бюджет: смотрите на стоимость одной задачи в таблице 4 MKA, а не на цену за токен. По этому показателю Carbon заметно впереди.
- Жёсткое требование — скорость: смотрите на время выполнения и число раундов агента — здесь быстрее всех Astra. Но придётся смириться с тем, что по качеству профессиональной сдачи результата она заметно отстаёт.
💡 Совет по выбору: можно взять на вооружение подход Google /swarm — сильную модель использовать для планирования и проверки, а быструю — для массового выполнения. Через единый интерфейс APIYI (apiyi.com) можно назначать разным ролям агентов разные модели в одном проекте, не поддерживая при этом несколько SDK.
Часто задаваемые вопросы (FAQ)
Q1: Как позиционируются Gemini 4 Carbon, Claude Fable 5.2 и GPT-6 Astra?
Все три — топовые модели для рассуждений второй половины 2026 года. Fable 5.2 лидирует по качеству комплексных и профессиональных результатов. Carbon держит баланс между качеством, мультимодальностью и стоимостью задачи. Сильная сторона Astra — скорость выполнения и экономия токенов.
Q2: В MKA Fable 5.2 опережает Carbon на 2,22 процентного пункта. Значит ли это, что Fable сильнее?
Нет. 95%-й доверительный интервал этой разницы — от -0,94 до +5,49, то есть он включает 0, и статистической значимости нет. Корректнее сказать так: модели находятся примерно на одном уровне, и обе заметно опережают Astra.
Q3: Можно ли сравнивать 65 баллов в индексе AA и 56,56% в MKA?
Нельзя. Индекс AA — это сводная оценка по 9 тестам, где каждая модель работает на своём уровне рассуждений. MKA — взвешенная доля выполненных требований для профессиональных задач в единой тестовой обвязке (Harness). Объекты оценки и способы подсчёта баллов у них разные, поэтому пересчитать одно в другое не получится.
Q4: Токены у Carbon в четыре раза дешевле, чем у Fable. Значит ли это, что и задача обойдётся в четыре раза дешевле?
Не обязательно. В период запуска цена за токен у Carbon действительно составляет 25% от цены Fable 5.2, а с 1 декабря станет 50%. Но реальный счёт зависит от расхода токенов, токенов на размышления, попаданий в кэш и вызовов инструментов. В таблице 4 MKA стоимость одной задачи у этих моделей отличается примерно в шесть раз — потому что Carbon ещё и тратит заметно меньше токенов.
Q5: Как недорого проверить все три модели самостоятельно?
Лучше всего подойдёт агрегатор с поддержкой нескольких моделей:
1. Зарегистрируйтесь на APIYI (apiyi.com), получите API-ключ и бесплатный тестовый лимит;
2. Укажите в коде из этой статьи `base_url` равным `https://api.apiyi.com/v1`;
3. Прогоните сравнение на реальных файлах и задачах из вашего бизнеса и запишите качество, время выполнения и расход токенов.
Q6: GPT-6 Astra экономнее всех расходует токены. Почему тогда стоимость одной задачи у неё не самая низкая?
Мало токенов ещё не значит маленький счёт. У разных моделей разная структура цен на входные и выходные токены и на кэш, а итоговая стоимость — это сумма расходов, умноженных на соответствующие тарифы. В таблице 4 MKA у Astra токенов примерно в три раза меньше, чем у Carbon, а стоимость при этом чуть выше.
Q7: Какие у этих результатов тестирования ограничения?
В MKA каждая задача запускалась только один раз. Судья — GPT-6 Luna Medium, его оценки совпадают с мнением экспертов в 96% случаев. Рейтинг AA — это динамический снимок: после изменения цены Carbon 1 декабря расчёт стоимости по стандартному тарифу тоже изменится. Если вам нужно следить за расходами в долгосрочной перспективе, можно смотреть детализацию использования на APIYI (apiyi.com) и группировать реальные траты по моделям — это станет вашими собственными данными о стоимости.
Главное о сравнении трёх моделей: Key Takeaways
- Общие способности: в AA v5.0.1 Fable 5.2 Max набрала 65 баллов, опередив Carbon High (60) и Astra Max (57).
- Профессиональные задачи: в MKA разрыв между Fable и Carbon статистически незначим, а обе модели заметно опережают Astra.
- Стоимость задачи: по методике из таблицы 4 статьи Carbon обходится в $5,63 за задачу — примерно в шесть раз дешевле Fable.
- Скорость и эффективность: Astra тратит на задачу 18,5 минуты и 2,43M токенов, то есть лидирует по скорости и экономии токенов.
- Ценность мультимодальности: если убрать инструмент просмотра изображений, качество Carbon падает, а количество входных токенов растёт на 85%.
- Границы методики: цена за токен, расход токенов и счёт за задачу — три разные вещи.
- Как попробовать: через APIYI (apiyi.com) можно одним ключом прогнать небольшой сравнительный тест всех трёх моделей.
Итоги: ни одна метрика не определяет «самую сильную» модель
Вернёмся к вопросу из начала статьи. Три топовые модели различаются прежде всего тем, как они балансируют между качеством, скоростью и стоимостью:
- Claude Fable 5.2: лидирует и по комплексному индексу, и по качеству профессиональной работы, но платит за это самым долгим временем выполнения и самой высокой стоимостью задачи.
- Gemini 4 Carbon: по качеству профессиональных задач статистически близка к Fable, при этом у неё самая низкая стоимость задачи, а сильная сторона — понимание изображений.
- GPT-6 Astra: работает быстрее всех и экономнее всех расходует токены, но в профессиональных задачах заметно уступает первым двум.
Общие способности, качество решения задач, скорость отклика и стоимость задачи нужно оценивать по отдельности. Вместо того чтобы смотреть только на место в рейтинге, надёжнее прогнать сравнительный тест на собственных задачах. Быстро проверить, как три модели справляются с вашей бизнес-логикой, можно через APIYI (apiyi.com): платформа даёт бесплатный тестовый лимит и единый интерфейс для нескольких моделей.
📚 Источники
- Техническая статья MKA: MKA: Evaluating Multimodal Knowledge Agents on end-to-end professional tasks
- Ссылка:
storage.googleapis.com/deepmind-media/papers/mka_tech_paper.pdf -
Описание: исходные данные по WSR для трёх моделей, доверительным интервалам, стоимости (таблица 4) и экспериментам по визуальной абляции
-
Рейтинг моделей Artificial Analysis: Intelligence Index v5.0.1
- Ссылка:
artificialanalysis.ai/leaderboards/models -
Описание: актуальный снимок с общими баллами, стоимостью и временем выполнения одной задачи
-
Рейтинг MKA: рейтинг мультимодальных knowledge-агентов
- Ссылка:
artificialanalysis.ai/zh/evaluations/mka -
Описание: результаты ведущих моделей по отраслям и типам итоговых файлов
-
Карточка модели Gemini 4 Carbon: официальные материалы Google DeepMind
- Ссылка:
deepmind.google/models/model-cards/gemini-4-carbon -
Описание: модальности, контекст, уровни рассуждения и известные ограничения
-
Страница цен Gemini API: стандартная цена Carbon, цена с кэшем и цена Batch
- Ссылка:
ai.google.dev/gemini-api/docs/pricing -
Описание: стартовая цена и изменения тарифов с 1 декабря
-
Документация Claude Fable 5.2 API: официальное описание модели от Anthropic
- Ссылка:
platform.claude.com/docs/en/models/fable-5-2/overview - Описание: контекст, максимальный размер вывода, цены за токены и Fast Mode
Автор: команда технической поддержки APIYI
Обратная связь: пишите нам на главной странице сайта APIYI, а больше материалов по подключению найдёте в центре документации docs.apiyi.com