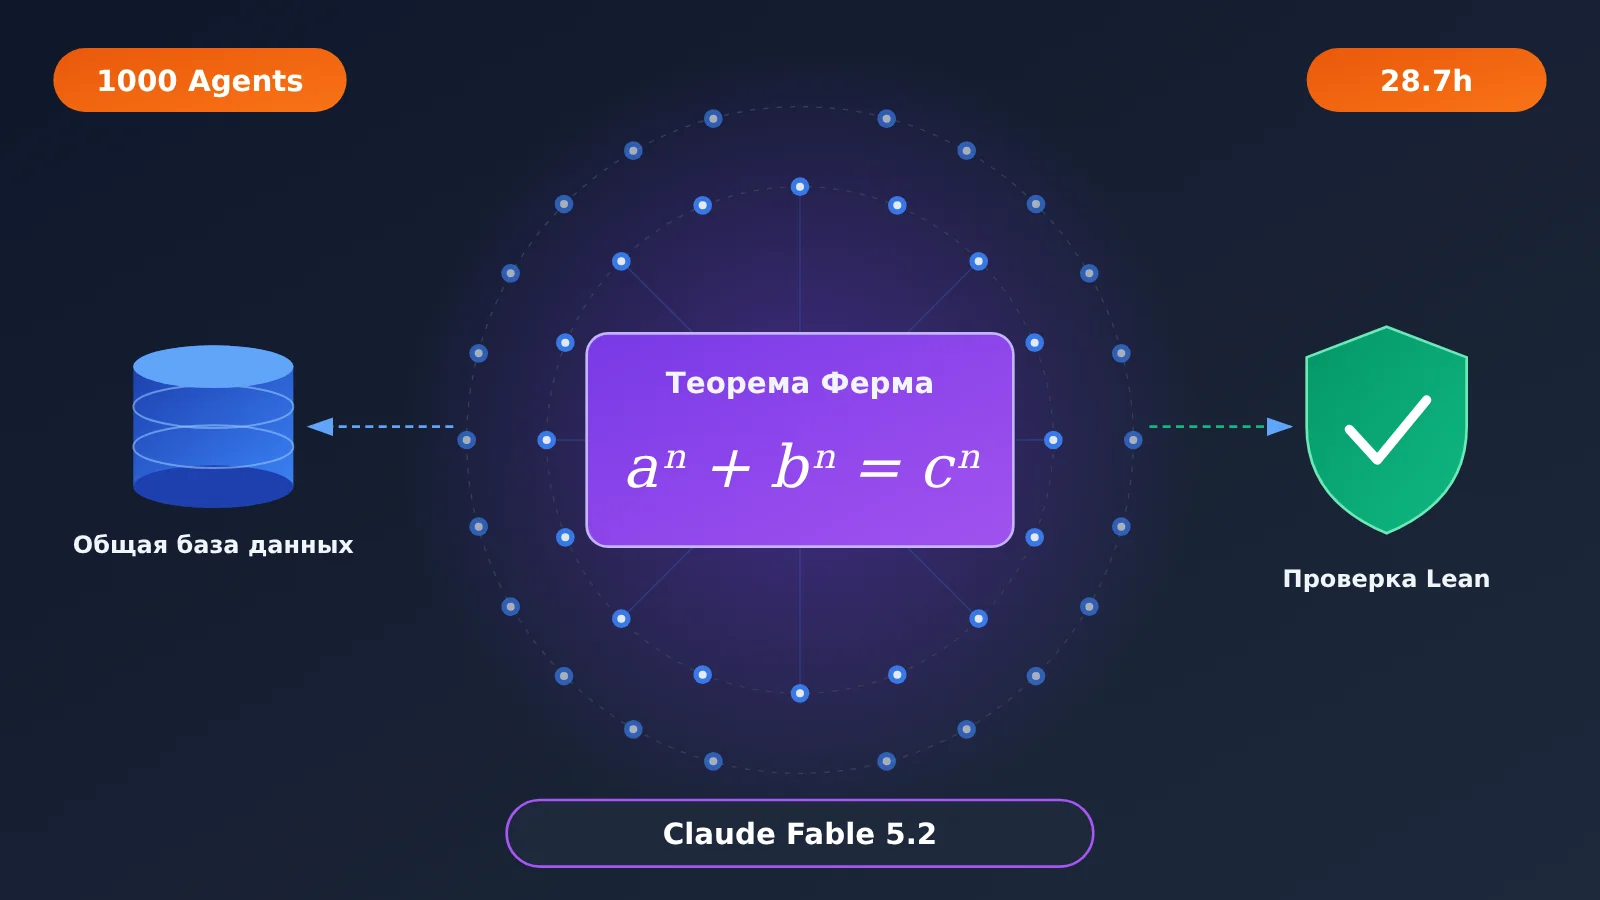
9 ноября 2026 года Anthropic опубликовала в официальном инженерном блоге результаты эксперимента с мультиагентной системой: 1000 агентов Claude Fable 5.2 совместно за 28,7 часа формализовали доказательство Великой теоремы Ферма. В итоге доказательство прошло проверку официальным ядром Lean. Первый эксперимент по формализации, проведённый двумя месяцами ранее, занял 11 дней и потребовал нескольких десятков агентов.
Это не значит, что «ИИ доказал Великую теорему Ферма за 30 часов». Теорему ещё в 1990-х годах доказали Эндрю Уайлс и Ричард Тейлор. В этом эксперименте уже известный ход доказательства перевели в формальную запись, которую компьютер может проверять шаг за шагом. Поэтому главный вопрос этой статьи — как 1000 ИИ-агентов меньше чем за 30 часов справились с такой сложной задачей?
Главное: прочитав статью, вы узнаете ключевые данные эксперимента по формализации доказательства Великой теоремы Ферма, принципы организации и механизмы проверки работы 1000 агентов, а также поймёте, чем этот опыт полезен для корпоративных агентных систем и каковы его границы.
Ключевые факты об эксперименте по формализации великой теоремы Ферма
Для начала — таблица с основными фактами об эксперименте с Claude Fable 5.2. Обратите внимание на несколько моментов, которые легко упустить: использовалась ранняя версия модели, входные данные были заранее подготовлены, а сама Anthropic прямо назвала эксперимент демонстрацией экспериментального характера (toy experiment).
| Пункт | Подробности |
|---|---|
| Дата публикации | 9 ноября 2026 года, официальный инженерный блог Anthropic |
| Использованная модель | Ранняя версия Claude Fable 5.2 (оценка её соответствия требованиям ещё не была завершена перед официальным выпуском) |
| Размер команды | 1 ведущий агент + 999 вспомогательных агентов |
| Время выполнения | 28,7 часа; итоговая теорема прошла проверку официального ядра Lean (в официальном анонсе время округлили до 30 часов) |
| Заранее подготовленные входные данные | 60 утверждений, краткий план классического доказательства, необходимые определения и 47 лемм, доказанных в ходе предыдущей формализации |
| Инструментарий | Инструментарий Lean, Mathlib, Git, общая база данных PostgreSQL, изолированные виртуальные машины |
| Официальная оценка | Демонстрация экспериментального характера, а не первое доказательство великой теоремы Ферма |
Формализация великой теоремы Ферма: сначала разберёмся с условиями эксперимента
Исследователи не просто дали команду «докажите великую теорему Ферма» и оставили агентов разбираться самостоятельно. Они предоставили им 60 утверждений (включая итоговую теорему и 59 промежуточных этапов), краткий план доказательства, определения, а также 47 лемм, доказанных в ходе предыдущего эксперимента. Роли ведущего и вспомогательных агентов исследователи тоже задали заранее.
Поэтому эксперимент проверял другое: сможет ли большая команда агентов, получив математическую базу и необходимые инструменты, самостоятельно организовать работу и полностью формализовать известный путь доказательства так, чтобы его можно было проверить машиной. Это уже не столько вопрос «умеет ли ИИ заниматься математикой», сколько инженерная задача.
Почему так сложно формализовать великую теорему Ферма
Великая теорема Ферма формулируется просто: если целое число n больше 2, то не существует положительных целых чисел a, b и c, удовлетворяющих равенству a^n + b^n = c^n. Пьер де Ферма сформулировал её в XVII веке, и она оставалась нерешённой более 350 лет. Вайлс объявил о доказательстве в 1993 году, а в 1994-м вместе с Тейлором исправил ключевую ошибку. Окончательная версия была опубликована в 1995 году. Первоначальное доказательство занимало около 129 страниц и во многом опиралось на уже известные результаты современной теории чисел и алгебраической геометрии.
Когда математики пишут доказательство, они могут сказать: «Это очевидно следует из предыдущего утверждения», — и читатели сами восстановят пропущенные шаги. Компьютер такой договорённости не понимает: ему нужно знать, какое определение, теорема или правило вывода использовалось на каждом шаге. В этом и заключается главная сложность формализации: то, что человеку кажется «очевидным», в коде может обернуться сотнями или тысячами строк.
Lean, Mathlib и формализация математики
Чтобы понять суть этого эксперимента, сначала нужно разобраться в трёх понятиях:
- Lean — интерактивный доказательный ассистент, который проверяет, соответствует ли доказательство строгим правилам формальной логики.
- Mathlib — математическая библиотека для Lean, содержащая множество формализованных определений и теорем. Это своего рода «стандартная библиотека», на которую можно ссылаться.
- Формализация математики — преобразование математического доказательства, понятного человеку, в логическую структуру, которую компьютер может проверить целиком.
Важно понимать главное: AI строит доказательство, а ядро Lean проверяет его. Заявление модели «я доказала теорему» и фактическое принятие доказательства Lean — совершенно разные вещи. Именно поэтому к результату этого эксперимента можно относиться серьёзно: он основан не на самооценке модели, а на независимой машинной проверке.
Как 1000 ИИ-агентов работают вместе: система управления проектами под управлением ИИ
Это самая интересная часть эксперимента Claude Fable 5.2. 1000 агентов не решали задачу каждый сам по себе — вместо этого они образовали систему совместной работы с управлением задачами, распределением ресурсов и динамической корректировкой планов.
Как устроена команда Claude Fable 5.2
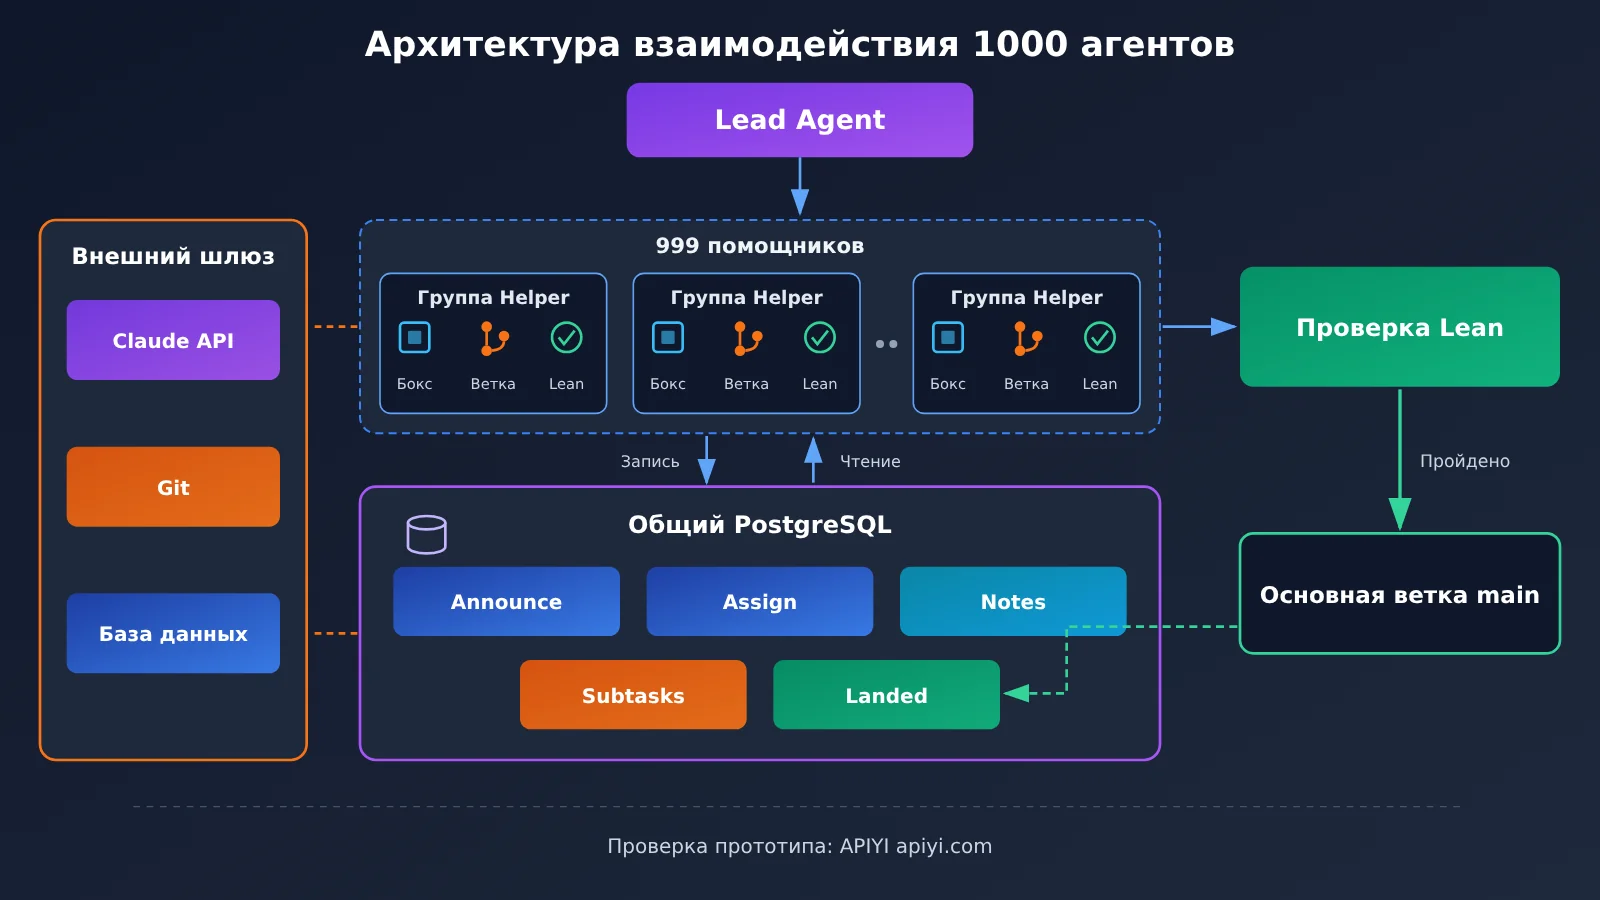
В команде используется простая иерархическая структура: один ведущий агент отвечает за общее планирование, декомпозицию задач и контроль прогресса, а 999 вспомогательных агентов занимаются конкретными доказательствами. У каждого агента есть собственная облегчённая виртуальная машина-песочница с доступом к Shell, редактору файлов, инструментарию Lean и Mathlib. Кроме того, у каждого своя ветка Git, из которой можно отправить запрос на слияние в основную ветку.
Ни у одного агента нет прямого доступа к интернету. Вся связь с Claude API, Git и базой данных проходит через внешний шлюз. Отдельные песочницы и ветки позволяют 1000 агентам одновременно менять код, не перезаписывая файлы друг друга.
Общий PostgreSQL: координационный центр AI-агентов
Если 1000 агентов будут координироваться, отправляя сообщения друг другу, объём коммуникации быстро выйдет из-под контроля. Lead Agent решил эту проблему: в течение 10 минут после начала эксперимента он создал пять общих таблиц в базе данных, превратив общение в «работу с одной общей доской».
| Название таблицы | Назначение | Роль в совместной работе |
|---|---|---|
| Announce | Публикация командных указаний | Общая рассылка для всех, аналог доски объявлений проекта |
| Assign | Распределение задач и назначение ответственных | Помогает понять, «кто чем занимается», и не дублировать работу |
| Notes | Фиксация прогресса, проблем и планов работы | Общий контекст, который помогает избежать информационной изоляции |
| Subtasks | Управление отдельными задачами, которые агенты могут брать в работу | Пул задач, позволяющий агентам самостоятельно выбирать работу |
| Landed | Учёт выполненных и прошедших проверку задач | Список подтверждённых результатов — в него попадает только проверенная работа |
Главное преимущество такого подхода в том, что агентам не нужно связываться с каждым из остальных 999 агентов: достаточно проверить базу данных, чтобы узнать, какие задачи есть, какие уже выполнены и какие от чего зависят. Результаты попадают в основную ветку после слияния в Git. Согласно опубликованным данным, за всё время было выполнено около 36 612 операций записи и 311 734 операций чтения базы данных. Из них примерно 20 600 записей пришлось на Notes и около 14 800 — на Subtasks. В статистику не вошло большинство вызовов скриптов. Чтений намного больше, чем записей, — это показывает, что большую часть времени агенты проверяют «общее состояние дел».
Динамическое распределение задач: от фиксированного назначения к самостоятельному выбору
В этом эксперименте процесс распределения задач менялся по ходу работы. На временной шкале ниже видно, как постепенно эволюционировала организация:
| Время | Ключевое событие |
|---|---|
| 10-я минута | Руководитель создал пять общих таблиц базы данных |
| Примерно 27-я минута | Доказаны 3 утверждения |
| Затем | Руководитель временно отложил 47 утверждений, которые, по его оценке, было трудно доказать в рамках бюджета, и сосредоточил ресурсы на других 10 |
| Примерно 70-я минута | Все 10 утверждений доказаны, после чего руководитель переназначил агентов на более сложные задачи |
| Примерно 3-й час | Руководитель разрешил свободным агентам самостоятельно брать задачи, не дожидаясь назначения |
| 5,6-й час | 73 помощника создали 756 задач |
| Примерно 18-й час | Работа возобновилась с последнего сохранённого состояния и продолжалась ещё 12 часов |
| 28,4-й час | Завершено доказательство утверждения, связанного с теоремой Лэнглендса — Туннелла |
| 28,7-й час | Доказана последняя теорема Ферма и пройдена официальная проверка ядром |
Стоит обратить внимание на две детали. Во-первых, переход от распределения задач руководителем к их самостоятельному выбору агентами означает, что команда перешла от централизованного управления к модели общего пула задач. Это снижает риск того, что руководитель станет узким местом. Во-вторых, примерно через 18 часов эксперимент возобновили из сохранённого состояния, поэтому отметка в 28,7 часа не означает, что все агенты работали непрерывно с самого начала.
Кроме того, 47 временно отложенных утверждений — это не то же самое, что 47 лемм в исходных данных. При чтении официальных материалов не путайте их.
Langlands–Tunnell: 750 агентов вместе решают самый сложный этап формализации Великой теоремы Ферма
Ближе к финишу команда столкнулась с самой сложной частью: утверждением, связанным с Langlands–Tunnell, — важным математическим результатом в рамках доказательства Уайлса. Первые агенты, работавшие над этой частью, оценили, что на неё может потребоваться от 700 тысяч до миллиона строк кода Lean, и считали, что вероятность завершить работу за оставшееся время ниже 1%.
Затем Lead направил на эту задачу около 750 вспомогательных агентов. Они самостоятельно выстроили многоуровневое дерево задач:
- разделили работу на 10 основных направлений;
- создали в общей сложности 2418 подзадач;
- дерево задач достигало глубины в 10 уровней;
- сотни агентов параллельно работали над разными подзадачами.
В итоге работа над Langlands–Tunnell завершилась на 28,4-м часу, а ещё через 0,3 часа была формализована Великая теорема Ферма. Этот пример показывает, что ценность масштабного параллелизма не только в том, что «чем больше участников, тем быстрее вычисления». Гораздо важнее разбить задачу, за которую невозможно взяться целиком, на множество небольших частей, которые можно решать независимо, проверять по отдельности, а затем объединять. Если разбить задачу неудачно, 750 агентов будут лишь ждать друг друга или повторять одну и ту же работу.
Почему формализация великой теоремы Ферма прошла успешно: проверка в Lean и механизмы безопасности
С точки зрения инженерной надёжности успех эксперимента обеспечили три уровня защиты.
Первый уровень — проверка результатов. Каждое вспомогательное утверждение должно пройти проверку Lean, прежде чем его можно будет добавить в основную ветку. В таблицу Landed попадают только прошедшие проверку результаты. Итоговую теорему проверяет официальный верификатор ядра Lean. Lead Agent записал: «Великая теорема Ферма уже в основной ветке; доказательство проверено официальным верификатором ядра».
Второй уровень — изоляция совместной работы. Отдельные песочницы и независимые ветки Git свели к минимуму конфликты файлов и взаимное вмешательство агентов.
Третий уровень — границы безопасности. В эксперименте использовались ранние модели, которые ещё не прошли оценку соответствия перед официальным выпуском. Поэтому Anthropic установила несколько уровней ограничений:
- запретила доступ к интернету и прямой доступ к песочницам других агентов;
- запускала команды от имени непривилегированных пользователей;
- направляла взаимодействие с API, Git и базами данных через внешний шлюз;
- проверяла команды Shell и изменения файлов в реальном времени с помощью классификатора, а записи операций дополнительно анализировал автономный монитор.
За время эксперимента было выполнено более миллиона вызовов инструментов, и ни один из них не достиг порога, при котором требовалась бы блокировка. Anthropic также сообщила, что после эксперимента добавила параллельный мониторинг цепочек рассуждений. Вывод таков: надёжность системы агентов зависит не только от способности модели выполнить задачу — необходимы независимая проверка, чёткие границы полномочий и среда выполнения, в которой можно отследить все действия.
От 11 дней до 28,7 часа: сравнение двух экспериментов с Claude Fable 5.2
У двух экспериментов по формализации Великой теоремы Ферма разные условия, поэтому их стоит рассматривать отдельно:
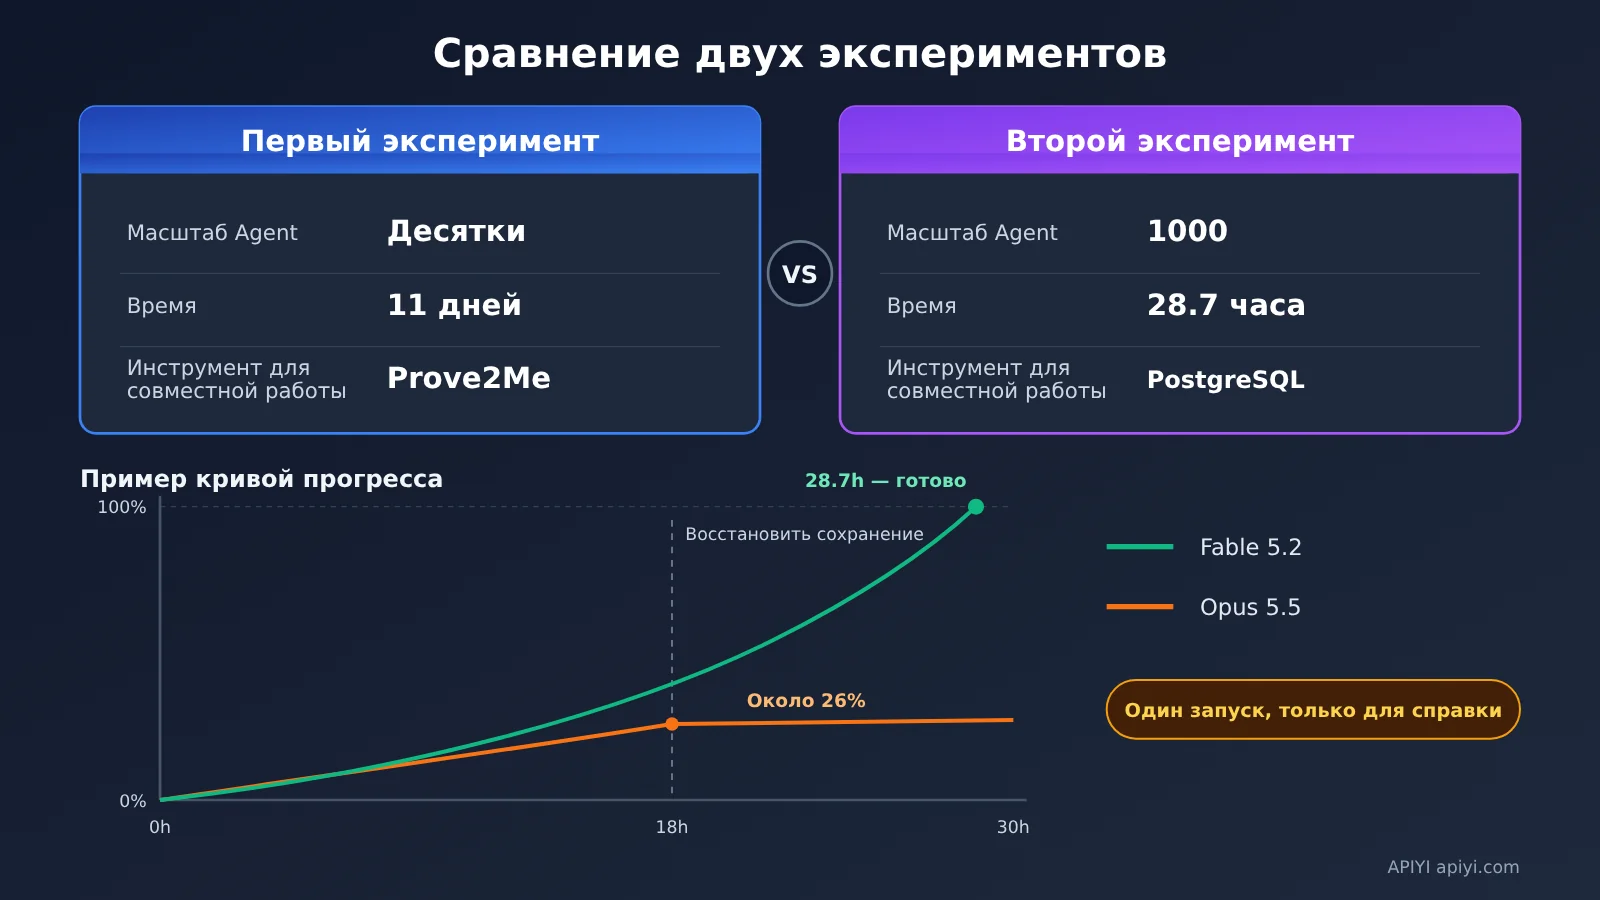
| Показатель | Первый эксперимент (объявлен в сентябре 2026 года) | Второй эксперимент (объявлен 9 ноября 2026 года) |
|---|---|---|
| Модель | Внутренняя исследовательская модель (примерно того же уровня, что Fable 5.1) | Ранняя версия Fable 5.2 |
| Количество агентов | Несколько десятков | 1000 |
| Время выполнения | 11 дней | 28,7 часа |
| Токены на выходе | Около 6 миллиардов | По официальным данным, примерно треть от показателя первого эксперимента |
| Длина доказательства | Базовый показатель (около 13 млн строк кода Lean) | Примерно в 7 раз меньше, чем в первом эксперименте |
| Платформа для совместной работы | Prove2Me + Claude Code Multi-Agent Harness | Универсальные инструменты + PostgreSQL |
| Участие человека | Исследователь Тяньи Пэн давал немного общих рекомендаций | Без постоянных рекомендаций по математическому процессу |
Важно: 6 миллиардов токенов, 13 миллионов строк кода и около 30 300 теорем — это показатели первого эксперимента. Абсолютное количество токенов, общую стоимость и точное число строк кода для второго эксперимента компания не раскрыла.
В начале первого эксперимента тоже возникали трудности: агентам было сложно отслеживать общее состояние работы и понимать, что уже сделали другие, поэтому они дублировали задачи. Позже появилась платформа Prove2Me: она использовала DAG для отслеживания зависимостей между теоремами, а также предоставляла информацию о статусе задач, поиск теорем и ускоренную компиляцию. Во втором эксперименте от этой специализированной платформы отказались: агенты самостоятельно организовали совместную работу с помощью универсальной базы данных и Git. Пять таблиц выполняли функции, аналогичные возможностям Prove2Me.
Anthropic также провела сравнительный тест с теми же 1000 агентами: Opus 5.5 завершила около 26% работы за 18 часов, а затем почти не продвинулась до отметки в 30 часов; Fable 5.2 доказала теорему за 28,7 часа. Обе группы примерно через 18 часов возобновили работу из сохранённого состояния. Однако каждую модель запускали только один раз, поэтому нельзя делать вывод, что между ними есть такая же разница при любых сложных задачах.
Анализ влияния 1000 экспериментов с ИИ-агентами на компании
Для разработчиков: четыре ключевые способности мультиагентных систем
Если отбросить математическую часть, способности, которые показал этот эксперимент, можно соотнести с типичными корпоративными сценариями:
| Способность | Проявление в эксперименте | Применение в бизнесе |
|---|---|---|
| Декомпозиция сложных задач | 2,418 подзадач, дерево задач глубиной до 10 уровней | Масштабный рефакторинг кода, сложные исследовательские отчёты |
| Динамическое распределение ресурсов | Отложенные сложные задачи, 750 Helper, сосредоточенных на их решении | Перераспределение Agent и вычислительных ресурсов с учётом приоритетов |
| Управление общим состоянием | Пять таблиц PostgreSQL и слияние через Git | Единая доска задач, которая помогает избежать дублирования работы |
| Независимая проверка результатов | Ядро Lean проверяет каждый коммит | Модульные тесты, проверка данных, ручная проверка |
Главный практический вывод для разработчиков: не обязательно сразу строить сложную специализированную платформу. Хорошо спроектированная общая база данных вместе с системой контроля версий уже позволяют организовать совместную работу в довольно большом масштабе. Вот минимальный пример вызова модели:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI
)

response = client.chat.completions.create(
    model="claude-fable-5-2",  # Сверяйтесь со списком моделей на платформе
    messages=[{"role": "user", "content": "把这个任务拆成可独立验证的子任务"}]
)
print(response.choices[0].message.content)
Посмотреть пример кода пула задач Lead / Helper
import sqlite3
import openai

# Для локальной работы SQLite имитирует таблицы Subtasks / Landed из эксперимента (в самом эксперименте использовался PostgreSQL)
db = sqlite3.connect("board.db")
db.execute("CREATE TABLE IF NOT EXISTS subtasks (id INTEGER PRIMARY KEY, goal TEXT, status TEXT, owner TEXT)")
db.execute("CREATE TABLE IF NOT EXISTS landed (task_id INTEGER, result TEXT)")

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def lead_plan(goal: str):
    """Lead: разбирает задачу на подзадачи и добавляет их в пул"""
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": f"将目标拆为3-5个子任务,每行一个:{goal}"}]
    )
    for line in resp.choices[0].message.content.splitlines():
        if line.strip():
            db.execute("INSERT INTO subtasks (goal, status) VALUES (?, 'open')", (line.strip(),))
    db.commit()

def verify(result: str) -> bool:
    """Независимый валидатор: в реальном сценарии его следует заменить тестами, скриптами проверки или проверкой Lean"""
    return len(result) > 0

def helper_claim(name: str):
    """Helper: самостоятельно берёт задачу в работу; запись в landed выполняется только после успешной проверки"""
    row = db.execute("SELECT id, goal FROM subtasks WHERE status='open' LIMIT 1").fetchone()
    if not row:
        return
    task_id, goal = row
    db.execute("UPDATE subtasks SET status='doing', owner=? WHERE id=?", (name, task_id))
    db.commit()
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": goal}]
    )
    result = resp.choices[0].message.content
    if verify(result):
        db.execute("INSERT INTO landed VALUES (?, ?)", (task_id, result))
        db.execute("UPDATE subtasks SET status='done' WHERE id=?", (task_id,))
    else:
        db.execute("UPDATE subtasks SET status='open', owner=NULL WHERE id=?", (task_id,))
    db.commit()

lead_plan("为一个开源库补全单元测试")
for i in range(3):
    helper_claim(f"helper-{i}")
🚀 Рекомендация для быстрого старта: если хотите воспроизвести небольшой прототип со схемой «Lead разбивает задачу на подзадачи + Helper берёт их в работу + независимая проверка», начните с бесплатного тестового лимита на APIYI apiyi.com. Платформа предоставляет совместимый с OpenAI интерфейс: с одним API-ключом можно переключаться между Claude, GPT, Gemini и другими моделями — удобно сравнивать, как разные модели справляются с ролью Lead.
Для отрасли: границы важнее цифр
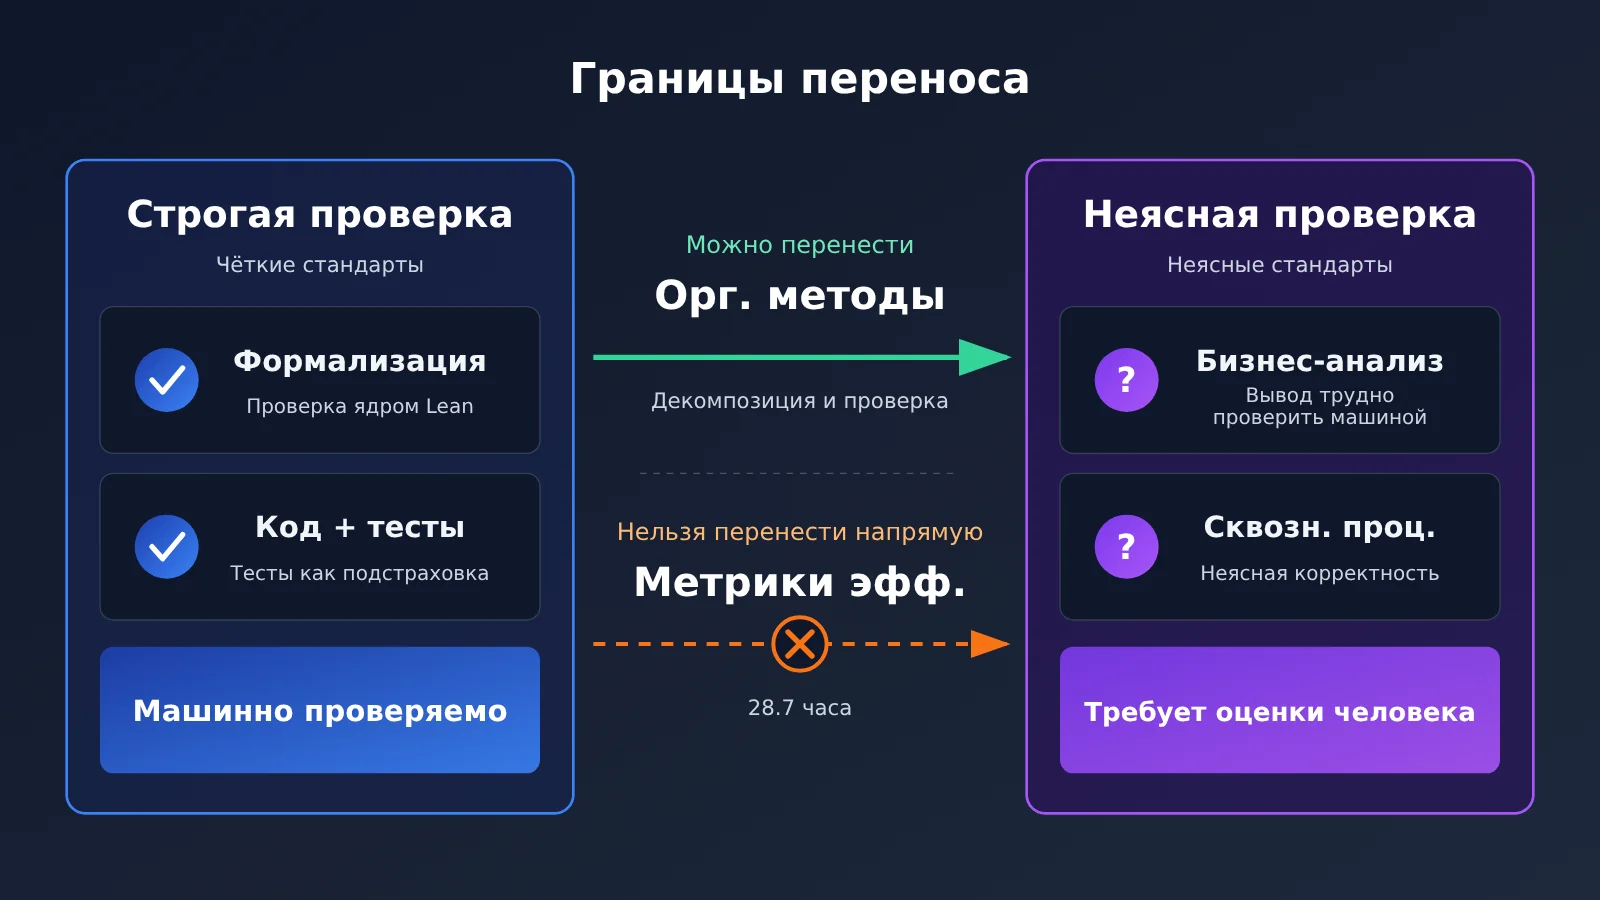
Важно сохранять трезвый взгляд: для математической формализации есть строгий и объективный верификатор вроде Lean, а у большинства корпоративных задач нет столь же чёткого критерия правильности. Код можно проверить тестами, но правильность анализа рынка или межфункциональных процессов зачастую сложно определить автоматически. Поэтому показатели в 28,7 часа и достигнутую в этом эксперименте успешность нельзя напрямую переносить на корпоративные системы Agent.
Anthropic также перечисляет ограничения: Agent могут слишком рано решить, что задачу невозможно выполнить. Например, из 47 утверждений, отложенных на раннем этапе, большинство впоследствии всё же удалось доказать. На сложных этапах по-прежнему полезны наводящие указания человека. Кроме того, специализированные инструменты для предметной области вроде Prove2Me могут и дальше повышать эффективность компиляции, поиска и совместной работы. Эксперимент не доказывает, что чем больше Agent, тем лучше, и не означает, что человеческие эксперты и специализированный Harness больше не нужны.
💡 Рекомендация для разработки: при внедрении многоагентных решений в компании начните с задач, для которых есть чёткие критерии проверки, например с рефакторинга кода, управляемого тестами, а затем постепенно увеличивайте масштаб. Благодаря оплате по факту использования на APIYI apiyi.com можно сначала оценить разбиение задач и проверку на небольшом количестве Agent, а уже потом решать, стоит ли увеличивать вложения.
Часто задаваемые вопросы
Вопрос 1. Доказал ли ИИ в этом эксперименте Великую теорему Ферма?
Нет. Эндрю Уайлс официально опубликовал доказательство Великой теоремы Ферма в 1995 году; вместе с Ричардом Тейлором он исправил ключевую проблему. В эксперименте при наличии 60 утверждений, общего плана доказательства, определений и 47 уже доказанных лемм существующий ход доказательства был преобразован в формальное доказательство, проверяемое Lean.
Вопрос 2. Почему из 60 утверждений доказанными отметили только 54?
Согласно статистике на 30-м часу, 5 вспомогательных утверждений впоследствии оказались ненужными, а от одного утверждения отказались. Итоговая теорема прошла проверку уже через 28,7 часа, поэтому доказывать все 60 утверждений из первоначального списка не потребовалось.
Вопрос 3. Сколько стоит API Claude Fable 5.2?
Официальная цена — $8 за миллион токенов на входе и $40 за миллион токенов на выходе. В режиме Fast Mode цены составляют $16 и $80 соответственно; чтение кэшированных данных стоит $0,20 за миллион токенов. На Batch API действует скидка 50%. Контекстное окно — 1 млн токенов, максимальный объём вывода — 128 тыс. токенов. Официальная стоимость второго эксперимента не раскрывалась, поэтому её нельзя оценить, просто умножив 6 млрд токенов из первого эксперимента на цену за токен.
Вопрос 4. Как быстро попробовать Claude Fable 5.2 через API?
Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ. Затем укажите `https://api.apiyi.com/v1` в параметре `base_url` — и сможете сразу запустить пример кода из этой статьи. Новым пользователям доступен бесплатный тестовый лимит: можно начать с небольшого прототипа с несколькими агентами.
Вопрос 5. Обязательно ли использовать PostgreSQL в мультиагентной системе?
Нет. Главное — общее хранилище состояния, к которому могут обращаться все агенты, а также контроль версий и независимая проверка. Для небольшого прототипа хватит SQLite или Redis. Если вы вызываете модели через APIYI apiyi.com, хранение состояния остаётся задачей вашей системы — эти компоненты можно сочетать как угодно.
Вопрос 6. Какие ограничения у этого эксперимента уже известны?
Разработчики прямо назвали его «игрушечным экспериментом». Сравнение Fable и Opus проводилось лишь по одному разу; использовались ранние модели, которым нужны многоуровневые меры безопасности. Агенты преждевременно отказывались от задачи, а помощь человека и специализированные инструменты для конкретной области по-прежнему полезны.
Ключевые выводы: 1000 AI-агентов формализовали Великую теорему Ферма
- Суть эксперимента: формализация уже существующего доказательства в виде кода, проверяемого Lean, а не первое доказательство Великой теоремы Ферма.
- Ключевые цифры: 1000 ранних агентов Fable 5.2 справились за 28,7 часа; результат прошёл проверку официальным ядром Lean.
- Основа организации: один Lead и 999 Helper работали совместно благодаря пяти общим таблицам базы данных и Git.
- Подход к сложным задачам: около 750 агентов разбили доказательство Langlands–Tunnell на 2418 подзадач глубиной до 10 уровней.
- Источник надёжности: независимая проверка Lean и изоляция в песочнице; более миллиона вызовов инструментов не потребовали вмешательства.
- Границы применимости: в корпоративных задачах часто нет такого верификатора, как Lean, поэтому показатели эффективности нельзя напрямую переносить на них.
- Как попробовать: с помощью единого интерфейса APIYI apiyi.com можно воспроизвести в небольшом масштабе прототип совместной работы Lead и Helper.
Итоги
Главные выводы из эксперимента с тысячей агентов Claude Fable 5.2:
- Система важнее отдельного компонента: результат за 28,7 часа стал возможен благодаря сочетанию возможностей модели, декомпозиции задачи, общего состояния, параллельного выполнения и машинной проверки.
- Проверка — основа доверия: проверка ядром Lean строго отделяет заявление модели о завершении от действительно завершённой работы.
- Важно обозначать границы: заранее заданные входные данные, ранняя версия модели, единичное сравнение и статус игрушечного эксперимента — всё это не позволяет переоценивать результат.
Этот эксперимент ставит перед отраслью важный вопрос: не смещается ли конкуренция в области ИИ от возможностей отдельной модели к способности системы организовать и координировать работу множества агентов над сложными задачами? Разработчики уже сейчас могут попробовать создать небольшой прототип с несколькими агентами и независимой проверкой. Для быстрой оценки результатов можно воспользоваться APIYI apiyi.com: платформа предлагает бесплатный тестовый лимит и единый интерфейс для работы с несколькими моделями.
📚 Источники
- Инженерный блог Anthropic: Safely scaling multi-agent teams with Claude Fable 5.2
- Ссылка:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2 -
Описание: организация команды, совместная работа с базой данных и механизмы безопасности во втором эксперименте, а также сравнение с Opus
-
Исследовательская статья Anthropic: Formalizing Fermat’s Last Theorem
- Ссылка:
anthropic.com/research/formalizing-fermats-last-theorem -
Описание: данные первого эксперимента по формализации и подход к совместной работе с Prove2Me
-
Официальный репозиторий доказательства на Lean от Anthropic: первая версия формального доказательства
- Ссылка:
github.com/anthropics/fermats-last-theorem -
Описание: опубликованный код доказательства за сентябрь. Данные в README не совпадают со статистикой ноябрьского эксперимента
-
Пример на официальном сайте Lean: Formalizing Fermat’s Last Theorem
- Ссылка:
lean-lang.org/use-cases/flt -
Описание: знакомство с Lean и основами формальной математики
-
Документация модели Fable 5.2: спецификации модели и переход на API
- Ссылка:
platform.claude.com/docs/en/models/fable-5-2/overview - Описание: контекстное окно, лимит вывода и информация о стоимости
Автор: техническая команда APIYI
Обсуждение технических вопросов: свяжитесь с нами на главной странице сайта APIYI. Дополнительные материалы доступны в центре документации docs.apiyi.com