Примечание автора: на примере спора о том, как GPT-6 Astra переписала веса Qwen3.5-0.8B, разберём заявления о возможностях моделей в 6 шагов: от базового уровня и доступа к инструментам до условий оценки и доказательств воспроизводимости.
Новость о том, что «передовая модель разобралась в весах другой модели и переписала их, повысив результат по математике с 7.9% до 48.1%», могла бы облететь всё AI-сообщество. Но не прошло и дня, как один из разработчиков опубликовал опровержение, а китайские СМИ подхватили историю с заголовком «Шедевр MIT разнесли в пух и прах». На примере спора об изменении весов Qwen моделью Astra мы покажем, как разбирать заявления о возможностях моделей — и применять этот подход снова и снова.
Эта статья не призывает вставать на чью-либо сторону. Мы не будем решать, кто прав, а кто виноват. Вместо этого шаг за шагом сопоставим исходные журналы эксперимента, заявления автора и аргументы критиков, чтобы превратить громкую новость в практический чек-лист.
Главное: прочитав статью, вы научитесь задавать 6 вопросов о любом заявленном «прорыве в возможностях модели» и сможете принимать более взвешенные решения при выборе модели, подготовке отчётов и технической оценке.
Главное о споре вокруг изменения весов Qwen с помощью Astra
Для начала разберём ключевые факты и спорные моменты в таблице. Дальнейший разбор строится именно на них.
| Пункт | Что произошло | Что это говорит о рекламных заявлениях |
|---|---|---|
| Источник исследования | 2 ноября 2026 года Rikiya Takehi, Jayden Teoh, Alex Zhang и Omar Khattab из MIT CSAIL опубликовали статью в блоге Sparks of Weight-Space Programming, а также журналы экспериментов и модифицированные модели | Наличие открытых журналов — первое, что стоит проверить при оценке достоверности |
| Главный результат | GPT-6 Astra изменила 131 072 из примерно 800 млн весов Qwen3.5-0.8B (около 0,016%), после чего результат на MATH-500 вырос с 7,9% до 48,1% | Чем эффектнее рост в процентах, тем важнее разобраться, почему исходный результат был таким низким |
| Условия работы | В этом эксперименте Astra работала в окружении Python с загруженными весами и могла запустить до 50 тренировочных пакетов оценки | «Понять веса» и «написать код для анализа весов» — разные вещи |
| Основная критика | Matthew Honnibal считает, что в рекламных заявлениях результаты экспериментов с разными правами доступа к инструментам объединили в один общий вывод; Sean Goedecke считает, что исправление Qwen по сути основано на уже известной технике steering | Чтобы оценить новизну метода, нужно сравнить его с существующими техниками |
| Контрпример | Ту же процедуру применили к Gemma 3 270M: результат на MATH-500 вырос с 6,8% максимум до 7,7%. Сами авторы не сочли такое улучшение убедительным | Успех на одной модели не означает, что способность можно обобщить на другие |
Как Astra на самом деле изменяла веса Qwen
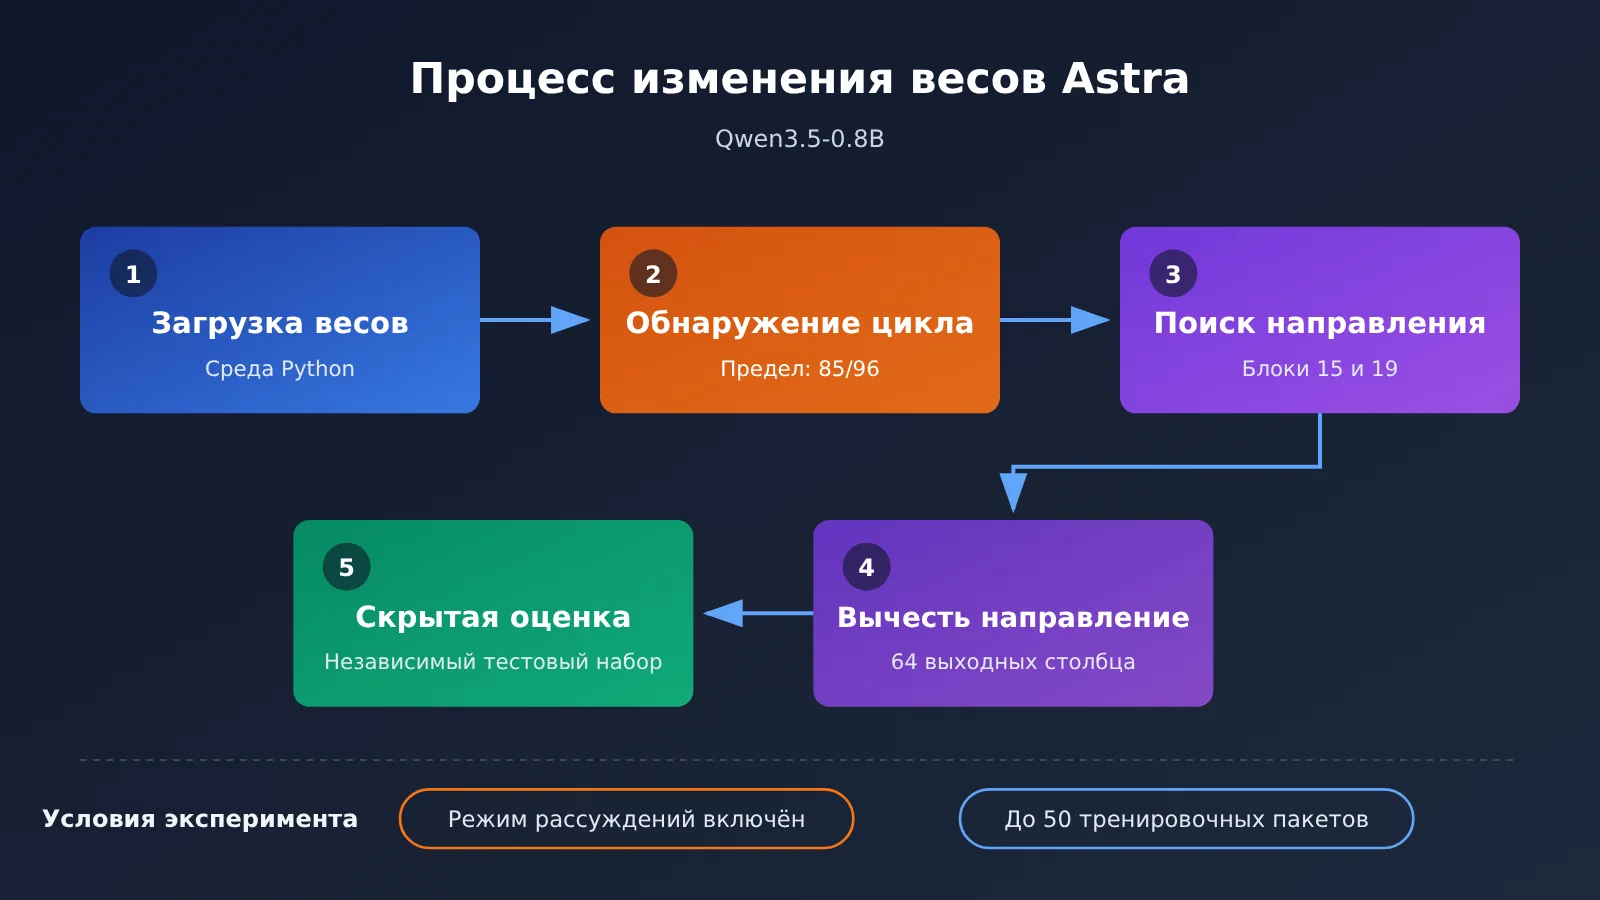
Если разобраться в деталях эксперимента, всё оказывается гораздо сложнее, чем просто «прочитала веса и повысила результат». У Qwen3.5-0.8B при включённом режиме рассуждения возникала серьёзная проблема с зацикливанием: в 85 из первых 96 проверенных Astra тренировочных ответов модель продолжала генерировать текст до предела в 32 768 токенов, так и не дав ответа. Эта слабость уже была описана в официальной карточке модели Qwen. Важно, что по умолчанию модель работает без режима рассуждения — для эксперимента его специально включили.
Затем Astra связала зацикливание с определённым направлением, формируемым слоями прямого распространения в блоках 15 и 19, и вычла это направление из 64 выходных столбцов каждого блока. Согласно README эксперимента, планировалось изменить 131 072 веса, но после округления до точности, используемой при оценке, фактически изменились 130 188. В ходе успешного запуска код Python выполнялся 80 раз. Работа заняла 20,3 часа, включая 4,7 часа простоя сервиса.
Как проверить заявления о возможностях модели: чек-лист из 6 шагов
Этот чек-лист мы составили на основе спора вокруг изменения весов Qwen компанией Astra. Каждый шаг отвечает на конкретный вопрос и подходит для проверки научных статей, презентаций, результатов бенчмарков и даже рекламных описаний продуктов.
Шаг 1. Проверьте исходный результат и причины неудач
При любом заявлении об «улучшении на X процентных пунктов» сначала стоит спросить: почему исходный результат был настолько низким? Базовый результат Qwen3.5-0.8B составил всего 7,9%, а 93,0% ответов на задания MATH-500 достигли лимита токенов. Иными словами, модель зачастую не столько не справлялась с задачей, сколько просто не успевала закончить ответ.
Сравните последний столбец таблицы с первым: заметно, что резкий рост результатов почти совпадает по времени с падением доли ответов, достигших лимита токенов.
| Версия Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Доля ответов MATH-500, достигших лимита токенов |
|---|---|---|---|---|
| Базовая модель | 7,9% | 13,8% | 21,0% | 93,0% |
| Изменённая версия, 10 пакетов упражнений | 12,3% | 25,7% | 49,0% | 87,2% |
| Изменённая версия, 25 пакетов упражнений | 14,1% | 25,1% | 39,9% | 86,4% |
| Изменённая версия, 50 пакетов упражнений | 48,1% | 67,1% | 62,3% | 33,1% |
Источник данных: Takehi и соавторы, MIT CSAIL, 2 ноября 2026 года. Режим размышления включён. В оригинале уточняется, что каждая изменённая версия была получена в ходе отдельного запуска и внесённые изменения различались. Упомянутые в заголовках 131 072 изменения весов соответствуют строке с 50 пакетами упражнений.
Шаг 2: посмотрим, какие инструменты были у модели
Это главный пункт критики Honnibal. В исследовании описаны 8 экспериментов и 1 последующий эксперимент с Gemma, но условия для модели сильно различались: в одних случаях ей давали только сырые веса в виде обычного текста, без каких-либо инструментов, в других — полноценную среду Python и возможность многократно практиковаться и проверять результаты. Если свести всё это к одному выводу — «модель умеет читать и изменять веса», — читатель может переоценить её способность просто «понимать» веса.
| Эксперимент | Размер сети | Условия для Astra | Результат |
|---|---|---|---|
| Определить, в какую игру играет сеть | 17 253 веса | Сырые веса в виде текста | 4/4 правильных ответа |
| Определить фигуру, нарисованную диффузионной моделью | 23 824 | Сырые веса в виде текста | 3/3 правильных ответа |
| Определить обучающий текст небольшой языковой модели | 7,2 млн | Промежуточные слои + Python | 3/3 правильных ответа |
| Исправить застрявшую стратегию вождения | 171 664 | Сырые веса, описание ситуации, 1 запись неудачной попытки | Доля успешных попыток выросла с 0% до 100% |
| С нуля написать сеть для игры в го на доске 9×9 | 1,48 млн | Python, до 50 тренировочных попыток | Превзошла сеть PPO того же размера |
| Найти модель, склонную к поддакиванию | 270 млн | Сначала Python, затем добавлены паттерны внимания | Сначала неудача, затем 3/3 |
| Улучшить математические способности Qwen | 800 млн | Python, до 50 тренировочных пакетов | Результат на MATH-500 вырос с 7,9% до 48,1% |
| Улучшить математические способности Gemma | 270 млн | Python, до 50 тренировочных пакетов | Подтверждённого улучшения нет (не более 0,9 процентного пункта) |
Таблица составлена по обзору исходного исследования на R&D World; классификация условий опирается на предложенную Honnibal. Сразу видно: эксперименты с чтением весов в текстовом виде проводились на небольших сетях с десятками тысяч параметров. А когда дело дошло до языковой модели с 800 млн параметров, в распоряжении модели была среда Python — рабочий инструмент, которым пользуется и человек, инженер машинного обучения.
Шаг 3: Сравните с существующими методами, чтобы понять, насколько подход нов
Goedecke отмечает, что поиск направления активации с последующим вычитанием его из весов — по сути, применение уже известного метода steering (управления активациями). Это не умаляет ценности результата, но меняет смысл вывода: внимания заслуживает то, что «модель способна самостоятельно выполнить стандартный процесс работы с интерпретируемостью», а не то, что «модель обладает сверхчеловеческой способностью читать веса».
Шаг 4: Проверьте, не подобраны ли условия оценки в пользу эксперимента
Стоит последовательно проверить несколько деталей: менялся ли режим рассуждений по умолчанию, какой установлен лимит токенов, сколько заданий разрешено генерировать за одно упражнение (в этом эксперименте за один вызов можно было сгенерировать не более 512 заданий или проверить внутренние активации не более чем для 1 024 текстовых фрагментов), а также были ли оценочные задания изолированы от процесса редактирования. В оригинале сказано, что во время редактирования задания и результаты оценки были недоступны модели — это плюс. Но включение режима размышления как раз усилило склонность Qwen к зацикливанию, и это тоже обязательно нужно отразить в выводах.
Шаг 5: Ищите контрпримеры и границы применимости
Gemma 3 270M дала один из самых ценных наборов данных в этом исследовании. Эта модель сама по себе редко зацикливается: лишь 8,5% её ответов достигали лимита длины, тогда как у Qwen — 93%. Та же процедура не дала на Gemma однозначного улучшения. Сами авторы объясняют это так: редактирование весов может устранить препятствия, мешающие модели проявить свои способности, но не может наделить её способностями, которых у неё изначально не было. Если в рекламных материалах приводят только успешные примеры и умалчивают о неудачах, доверять им стоит с оглядкой.
Шаг 6: Проверьте, есть ли независимое воспроизведение
В карточке модифицированной модели описан независимый повторный запуск, который провёл akhaliq из Hugging Face с помощью ML Intern. Он охватил все 500 задач MATH-500 и включал 2 000 генераций: результат составил 51,0%, а доля ответов, достигших лимита длины, — 31,6%. Независимое воспроизведение в целом подтвердило исходные результаты, поэтому можно считать достоверным, что показатель действительно вырос. Споры идут о том, как его интерпретировать, а не о том, были ли результаты сфальсифицированы.
🎯 Практический совет: прочитав рекламные заявления, лучше самостоятельно сравнить несколько моделей на одном и том же наборе задач. APIYI apiyi.com предоставляет доступ по API к моделям Claude Opus 5.5, Kimi K3.1 Pro, семейству Qwen3.8 и другим. Сервис совместим с форматами интерфейсов OpenAI и Anthropic, поэтому модели удобно переключать в одном скрипте для перекрёстной проверки. Инструкции по подключению — в документации docs.apiyi.com.
Сверяем заявления и критику Astra по чек-листу
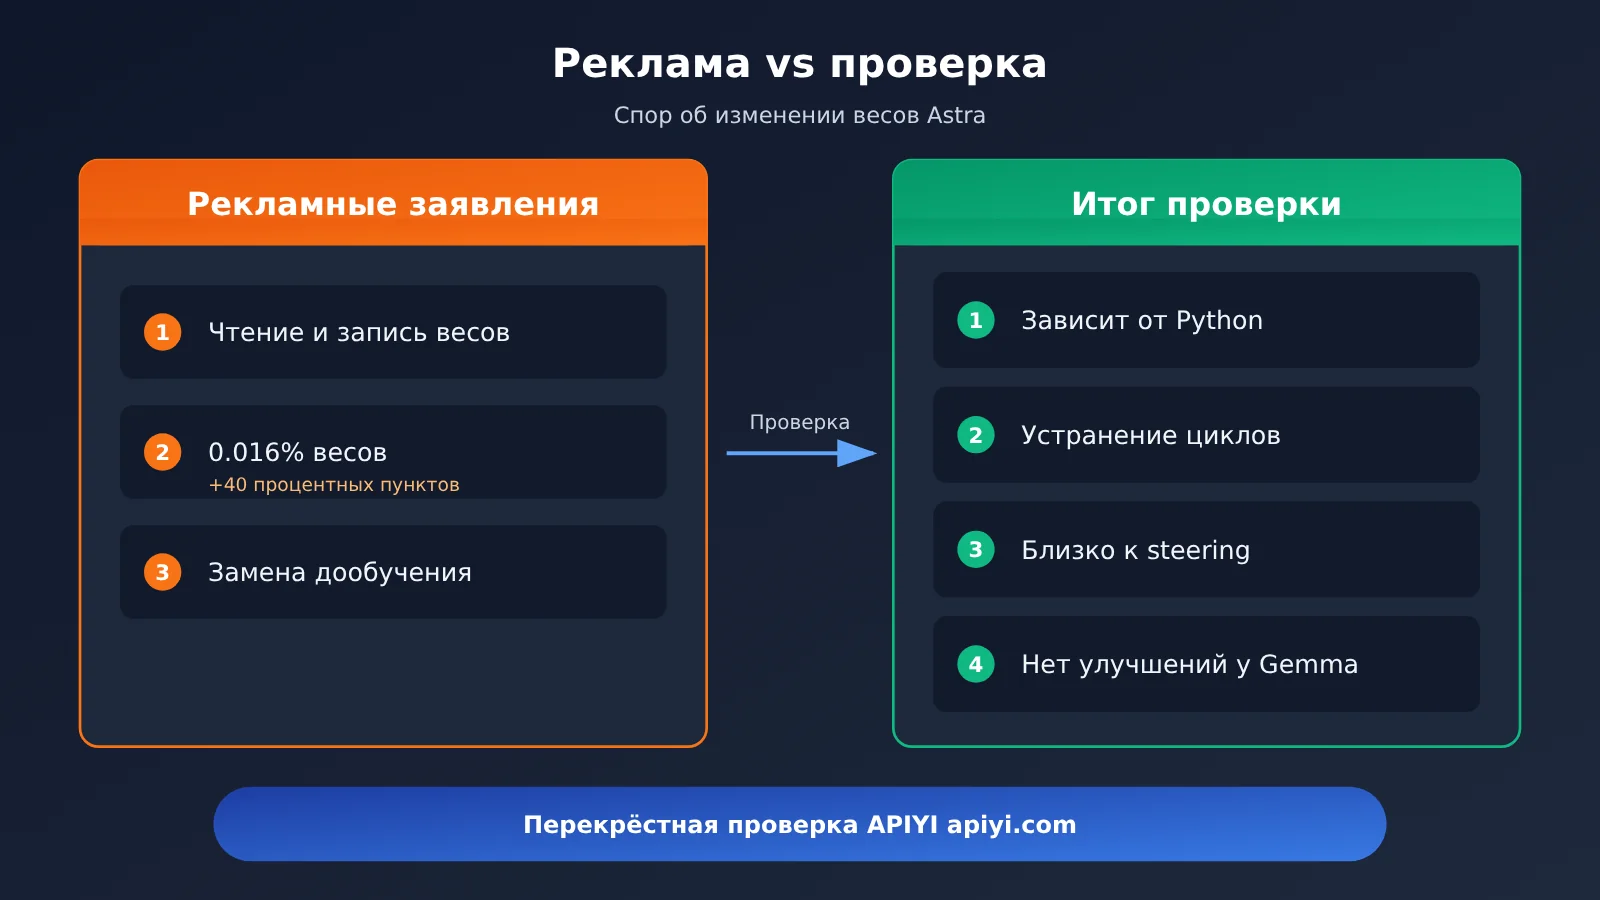
Применим чек-лист из шести шагов к этому спору и составим таблицу «заявление vs результат проверки». Такой формат можно использовать и в будущих отчётах о технической оценке.
| Заявление | Что проверяем | Результат проверки |
|---|---|---|
| Astra понимает веса нейросети | Доступ к инструментам | Для небольшой сети достаточно текста, для модели с 800 млн параметров нужен анализ с помощью Python |
| Изменение 0.016% весов даёт прирост на 40 процентных пунктов | Базовый уровень и причины сбоев | Прирост в основном связан с уменьшением зацикливания: доля случаев достижения лимита снизилась с 93.0% до 33.1% |
| Создан новый подход к программированию в пространстве весов | Новизна метода | Основная операция близка к существующей технике steering |
| Метод может частично заменить дообучение | Способность к обобщению | На Gemma устойчивого прироста нет: метод может устранять препятствия, но не добавлять новые способности |
| Результаты достоверны | Независимое воспроизведение | Сторонние исследователи получили 51.0%, что подтверждает достоверность численных результатов |
Сравнение с конкурентами: как оценивать заявления о схожих возможностях
GPT-6 Astra уже не раз привлекала внимание результатами тестов. В сентябре фонд ARC Prize сообщил о результате 62.7% на ARC-AGI-3 в рамках единой методики оценки. OpenAI также заявила, что Astra достигла порога Critical по возможностям в области кибербезопасности. К этим цифрам применим тот же чек-лист: сначала выясните, использовалась ли общая методика оценки или специально настроенная, затем проверьте доступ к инструментам и количество запусков.
В сравнении R&D World от 23 октября Claude Opus 5.5 и Kimi K3.1 Pro также оценивали наряду с Astra. Модели разных поставщиков могут лидировать в задачах, с которыми они справляются лучше всего, но в рекламных материалах обычно используются наиболее выгодные для них условия. Поэтому самостоятельный тест на одном наборе задач и с одинаковыми параметрами убедительнее любого рекламного постера.
💡 Совет по выбору: если вы хотите сравнить эти модели на своих бизнес-задачах, попробуйте сначала провести небольшое тестирование через единый интерфейс APIYI на apiyi.com. Важно: GPT-6 Astra пока недоступна в APIYI, но мы постараемся добавить её как можно скорее. Claude Opus 5.5 и Kimi K3.1 Pro уже доступны для вызова.
Доступность и цены моделей в APIYI
Все цены в таблице взяты со страницы APIYI docs.apiyi.com/models. Единицы тарификации указаны на странице цен; сторонние расценки в статье не используются.
| Модель | Имя модели в APIYI | Цена за вход | Цена за выход | Цена кэша | Доступность |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 | $4 | $20 | $0.2 | Доступна в APIYI |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | $2 | $10 | $0.1 | Доступна в APIYI |
| Kimi K3.1 Pro | kimi-k3.1-pro | $2 | $10 | $0.2 | Доступна в APIYI |
| DeepSeek V4.1 Flash | deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Доступна в APIYI |
| Серия Qwen3.8 | серия qwen3.8 | См. страницу цен | См. страницу цен | См. страницу цен | Доступна в APIYI |
| GPT-6 Astra | Нет | Нет | Нет | Нет | Пока не доступна в APIYI, будет добавлена в ближайшее время |
| Qwen3.5-0.8B | Нет | Нет | Нет | Нет | Пока не доступна в APIYI, будет добавлена в ближайшее время |
| Gemma 3 270M | Нет | Нет | Нет | Нет | Пока не доступна в APIYI, будет добавлена в ближайшее время |
Qwen3.5-0.8B и Gemma 3 270M — небольшие модели с открытыми весами. Изменённые в ходе исследования контрольные точки Qwen также опубликованы на Hugging Face. Чтобы воспроизвести само редактирование весов, их нужно загрузить локально. А для сравнения возможностей разных моделей удобнее использовать облачный API.
Частые вопросы (FAQ)
Q1: Что это за исследование, в котором Astra изменяет веса Qwen?
Команда MIT CSAIL проверила, способна ли GPT-6 Astra понимать и изменять веса других нейросетей. В главном эксперименте Astra изменила около 0,016% весов Qwen3.5-0.8B, благодаря чему результат на MATH-500 вырос с 7,9% до 48,1%. Логи и модели опубликованы.
Q2: В чём именно расходятся критики и авторы?
Разногласия касаются не достоверности данных, а их интерпретации. Авторы подчёркивают способность модели читать и изменять веса. Honnibal считает, что эксперименты с разными уровнями доступа к инструментам объединили в один общий вывод. Goedecke полагает, что исправление Qwen относится к уже известным методам управления поведением модели (steering), а основную работу выполняет анализ на Python, который мог бы написать и инженер-человек.
Q3: Когда вышло исследование и были ли новые результаты?
Исследование опубликовали в блоге 2 ноября 2026 года. Уже в течение суток появилась публичная критика, а на Hacker News развернулось подробное обсуждение. Авторы сообщили, что разрабатывают бенчмарк и систему оценки этой способности, поэтому за новыми данными стоит следить.
Q4: В каких ситуациях пригодится чек-лист из 6 шагов?
— **Выбор технологий**: оценить результаты тестов и рекламные заявления поставщика перед покупкой или подключением модели
— **Чтение исследований**: быстро разобраться, насколько показательна главная цифра в статье
— **Внутренние отчёты**: объяснить команде суть очередного «прорыва», обозначив границы выводов
— **Написание материалов**: не позволить одному показателю исказить оценку модели
Q5: Как самостоятельно проверить заявления о возможностях моделей через API?
Проще всего подготовить набор задач, близких к вашим рабочим сценариям, зафиксировать режим рассуждения и длину ответа, а затем прогнать его на нескольких моделях. Через APIYI apiyi.com можно вызывать Claude Opus 5.5, Kimi K3.1 Pro, модели серии Qwen3.8 и другие через единый интерфейс, совместимый с форматами OpenAI и Anthropic. Инструкции по подключению доступны на docs.apiyi.com, актуальные цены — на docs.apiyi.com/models.
Q6: Какие ограничения исследования уже известны?
Во-первых, эксперименты с большой языковой моделью зависели от инструментов Python и многократной практики — это было не просто «понимание» весов. Во-вторых, улучшение в основном связано с устранением зацикливания и зависит от включённого режима рассуждения. В-третьих, на Gemma подтверждённого улучшения не получили, что показывает: добавить способности из ниоткуда не удалось. В-четвёртых, такие применения, как самосовершенствование, пока остаются предположениями авторов и не подтверждены.
Q7: Связаны ли упомянутые в исследовании риски взаимодействия агентов с Astra?
В инциденте с Hugging Face, о котором OpenAI рассказала 26 августа, основную роль сыграла внутренняя исследовательская модель IM1. Компания прямо заявила, что Astra к этому инциденту не причастна. Сочетание «сотрудничества нескольких агентов и редактирования весов» пока остаётся лишь предположением: исследование его не подтвердило.
Как разбирать заявления о возможностях моделей: главное
- Начните с базового уровня: низкий результат Qwen в основном связан с тем, что 93% ответов достигали лимита длины. Рост баллов по большей части обеспечило исправление зацикливания.
- Уточните, какие инструменты использовались: читать веса в текстовом виде можно только у небольших сетей. Эксперименты с большими языковыми моделями требуют среды Python.
- Сравните с известными методами: исправление Qwen близко к steering, а его ценность — в самостоятельном выполнении всего инженерного процесса.
- Изучите условия оценки: режим рассуждения, лимит токенов и тренировочные пакеты заданий влияют на итоговый результат.
- Ищите контрпримеры: у Gemma устойчивого улучшения не обнаружено. Это показывает, что редактирование может устранить препятствия, но не добавить новые способности.
- Учитывайте независимое воспроизведение: сторонние исследователи получили 51,0%. Результат заслуживает доверия, но интерпретировать его нужно осторожно.
- Проверьте сами: используйте единый интерфейс APIYI apiyi.com, чтобы сравнить модели на собственных задачах.
Итоги
Главный урок спора о том, как Astra изменяла веса Qwen: даже реальный, воспроизводимый результат можно подать так, будто он доказывает больше, чем на самом деле. Вот на что стоит обращать внимание в заявлениях о возможностях моделей:
- Цифры нужно рассматривать вместе с неудачами: без базового уровня и доли результатов, достигших потолка, показатель 48,1% сам по себе мало о чём говорит
- Выводы нужно сопоставлять с условиями: доступ к инструментам, режим рассуждений и число тренировочных попыток определяют границы применимости выводов
- Успех нужно проверять на контрпримерах и воспроизводимости: контрпример с Gemma и повторные запуски сторонних исследователей вместе помогают понять, что результат действительно означает
В следующий раз, увидев заголовок о «прорыве модели», пройдитесь по этим 6 вопросам и проведите собственный тест на своих данных. Сравнить несколько моделей через единый интерфейс можно с помощью APIYI apiyi.com. Документация доступна на docs.apiyi.com, актуальные цены — на docs.apiyi.com/models.
📚 Источники
- Статья 36Kr: Шедевр MIT раскритиковали: Astra радикально переделала веса Qwen? Да ну
- Ссылка:
36kr.com/p/4056481264866438 -
Описание: публикация китайского СМИ об этой дискуссии
-
Блог с оригинальным исследованием: Sparks of Weight-Space Programming
- Ссылка:
rikiyat.github.io/blog/weight-space-programming -
Описание: описание исходных экспериментов команды MIT CSAIL
-
Репозиторий журналов экспериментов: lm_understand-logs
- Ссылка:
github.com/RikiyaT/lm_understand-logs -
Описание: содержит README эксперимента с Qwen и полные журналы всех экспериментов
-
Критическая статья Matthew Honnibal
- Ссылка:
honnibal.dev/blog/astra-read-write-misleading -
Описание: анализ заявлений с точки зрения доступа к инструментам
-
Критическая статья Sean Goedecke
- Ссылка:
seangoedecke.com/llms-are-not-superhuman-at-reading-and-writing-neural-network-weights -
Описание: сравнение исправления Qwen с техникой steering
-
Карточка модифицированной модели Qwen
- Ссылка:
huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming - Описание: содержит результаты независимых повторных запусков
Автор: техническая команда APIYI
Обсуждение технических вопросов: связаться с нами можно на главной странице APIYI apiyi.com, а дополнительные материалы по подключению доступны в документации на docs.apiyi.com