Примечание автора: на примере опубликованного Microsoft Copilot подхода к созданию синтетической корпоративной среды разбираем три уровня построения оценочного набора — синтетическую среду, автоматическую генерацию запросов и проверку качества. Также приводим шаги и контрольный список, которые пригодятся небольшим командам.
Когда корпоративного AI-ассистента или приложение для работы с базой знаний готовят к запуску, специалисты по оценке часто сталкиваются с проблемой: лучше всего реальные результаты показывают собственные письма компании, протоколы встреч и проектные документы, но эти данные содержат конфиденциальную информацию, поэтому использовать их для тестирования нельзя. При этом общие бенчмарки не выявляют проблем, характерных для конкретных бизнес-сценариев. На примере публикации Microsoft Research от 30 октября 2026 года разберём подход к построению оценочного набора: синтетическая корпоративная среда + автоматическая генерация запросов + проверка качества.
Это не пересказ официальных рекламных материалов. Microsoft опубликовала главным образом общую схему метода: компания не предоставила промпты и код инструментов, а также не раскрыла конкретные показатели Copilot на этих наборах данных. Мы отделим то, что прямо сказано в оригинале, от наших предположений и сформулируем шаги, которые могут взять на заметку небольшие команды.
Главное: из статьи вы узнаете, какие задачи решает каждый из трёх уровней синтетического корпоративного оценочного набора, почему нельзя пренебрегать временным измерением и отраслевой спецификой, а также сможете найти пробелы в своём процессе оценки с помощью контрольного списка.
Главное об оценочных наборах данных для синтетической корпоративной среды
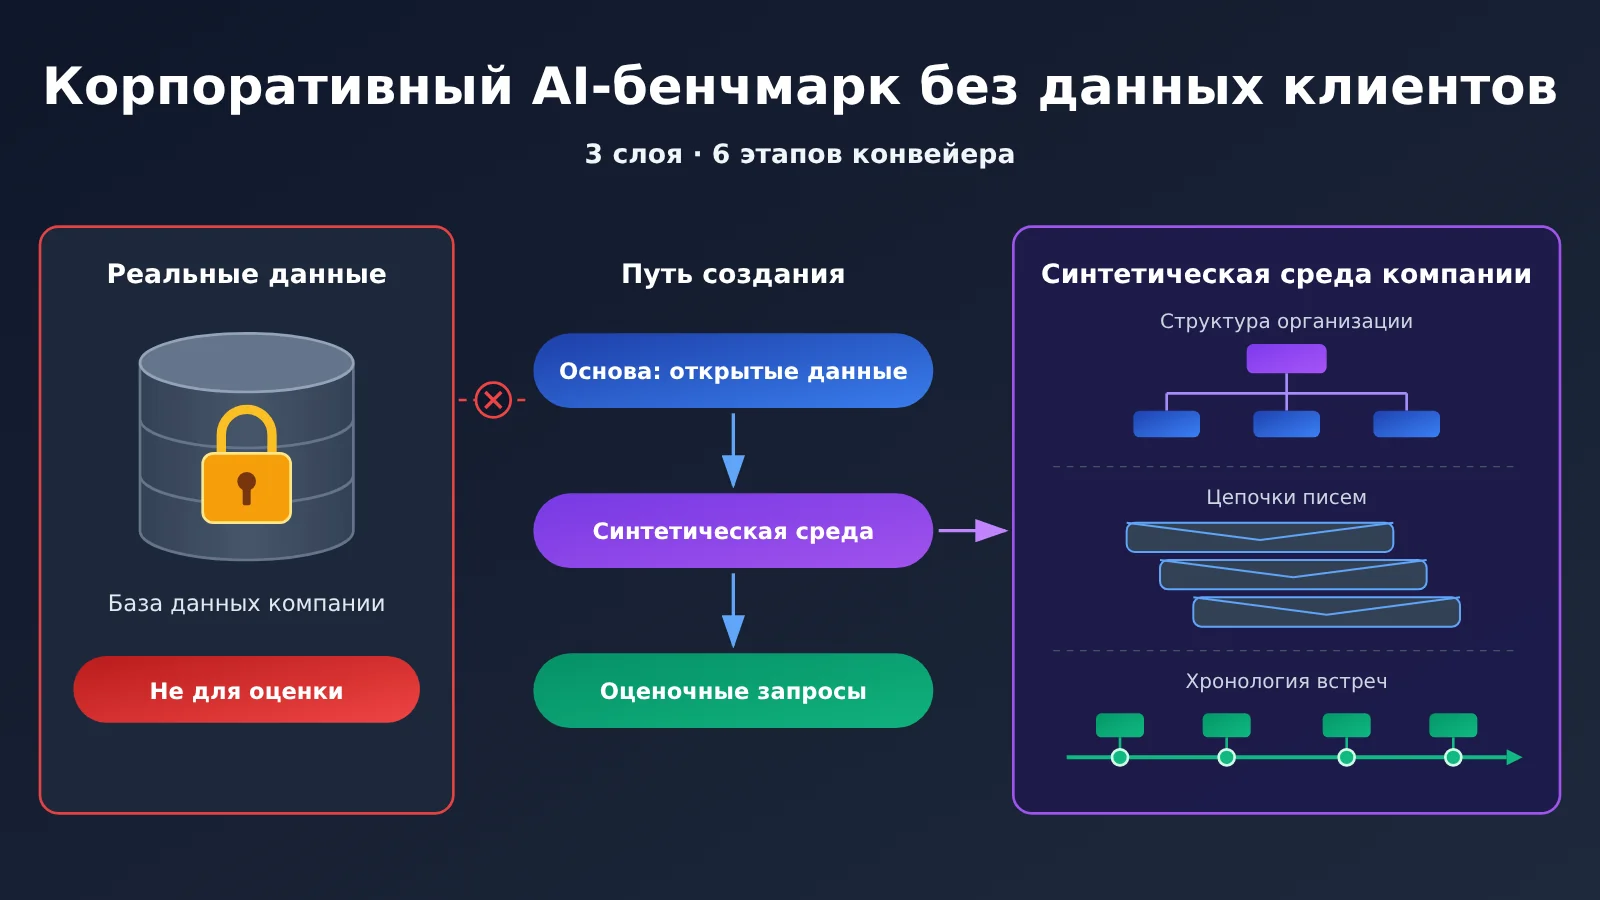
Microsoft называет эту систему Industry Evaluation Data Generation Platform — платформой для генерации отраслевых оценочных данных. В оригинале говорится, что она опирается на три столпа, которые связывает сквозная автоматизация.
| Компонент | Описание в оригинале | Какую проблему решает |
|---|---|---|
| Синтетическая корпоративная среда | Имитация рабочего пространства Copilot с пользователями, встречами, письмами, документами и организационной структурой — без использования данных клиентов | Даёт основу для тестирования, не затрагивая конфиденциальные данные |
| Автоматизированный конвейер генерации запросов | Превращает общие идеи запросов в отраслевые вопросы, привязанные к данным среды | Составлять вручную тысячи запросов, соответствующих данным, слишком затратно |
| Структурированная система оценки качества | Проверяет качество синтетических данных по нескольким критериям | Помогает избежать ошибочных выводов из-за неправдоподобных данных |
| Сквозная автоматизация | Позволяет повторно создавать один и тот же набор данных с той же конфигурацией | Обеспечивает сравнение версий при регрессионном тестировании и согласованность между командами |
Почему общие бенчмарки не выявляют проблемы корпоративных ИИ-приложений
Сложность корпоративных сценариев не в вопросах и ответах за один ход, а в контексте организации. Когда пользователь просит «составить для каждой команды список задач по итогам этого совещания по безопасности», модель должна знать, кто участвовал, кто отвечает за каждый модуль и какие конкретно вопросы обсуждались. А ещё — сослаться в ответе на исходный текст протокола встречи. В оригинале приводится пример медицинской организации, которая просит Copilot подвести итоги совещания и выделить задачи. Проверить нужно, насколько ответ точный, полный и обоснованный.
В общих бенчмарках нет данных о подчинённости, истории проектов, особенностях общения и отраслевых процессах. Поэтому они не выявляют специфические для компаний ошибки — например, когда решение отдела A приписывают отделу B или упускают ключевой вывод встречи с участием разных подразделений. Подход Microsoft таков: если нельзя использовать реальные данные, нужно создать среду, которая по структуре и поведению напоминает настоящую компанию.
Публичные данные как основа синтетической корпоративной среды
Если поручить большой языковой модели придумать организационную структуру с нуля, роли часто получаются однообразными, иерархия — плоской, а рабочие задачи — похожими друг на друга. Microsoft использует три типа публичных данных, чтобы сделать синтетическую среду реалистичнее. Все эти источники прошли проверку и получили одобрение юридического и политического отделов компании.
| Источник публичных данных | Как используется в оригинале | Альтернатива для небольших и средних команд |
|---|---|---|
| База профессий O*NET (Министерство труда США) | Помогает сделать роли и обязанности сотрудников реалистичнее, подобрать сочетание и частоту рабочих задач для разных ролей, адаптировать отраслевые процессы | Составить список ролей на основе публичных должностных инструкций и стандартов классификации профессий в своей отрасли |
| Онлайн-вакансии | Дают реальные названия должностей, представление об иерархии подчинения и составе отделов | Собрать публичные описания вакансий в целевой отрасли и выделить из них должностные уровни и структуру отделов |
| Публичные документы SEC | Помогают определить размер организации, структуру бизнес-подразделений и финансовый контекст | Опирайтесь на описания бизнес-сегментов и численности сотрудников в годовых отчётах публичных компаний |
В терминологии Microsoft каждое моделируемое рабочее пространство называется «tenant» (арендатор). Это изолированная организационная среда со своими пользователями, данными и конфигурацией. В оригинале подчёркивается, что такие среды служат расширяемой основой, которую команды могут развивать дальше.
Временное измерение: почему вопрос «Что решили в прошлый четверг?» требует реалистичной хронологии
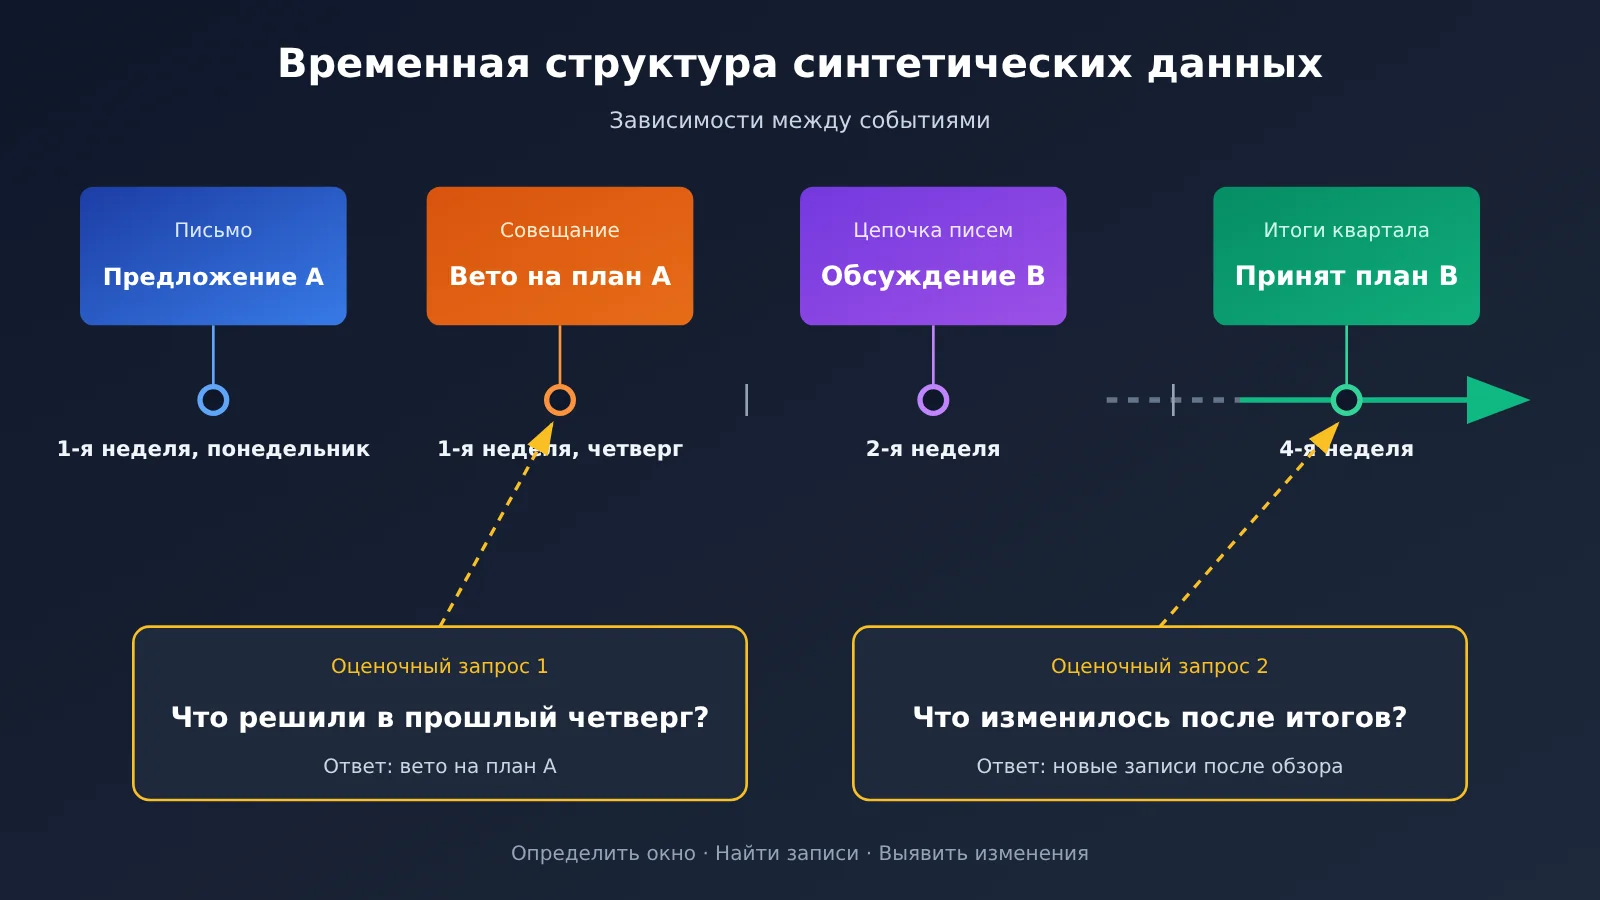
Этот момент особенно важен для небольших и средних команд. Синтетическая среда Microsoft — не статичный снимок, а организация, которая меняется со временем: в ней есть история встреч, хронология проектов, длящиеся неделями цепочки писем и закономерные организационные изменения. Как отмечается в оригинале, многие запросы к Copilot связаны со временем: например, «Что команда решила в прошлый четверг?» или «Что изменилось с последнего квартального обзора?».
Чтобы ответить на такой вопрос, модель должна выполнить три задачи: определить временной интервал, найти в нём нужные записи и понять, что изменилось. Если синтетические данные представляют собой набор документов без связи по датам или все встречи назначены на один день, у таких вопросов либо не будет однозначного ответа, либо ответ окажется слишком простым. В обоих случаях результаты оценки будут бессмысленными. События в синтетических данных должны зависеть друг от друга: например, в понедельник предложили план, в четверг отклонили его на встрече, а на следующей неделе в письмах появился альтернативный вариант. Только тогда вопрос «Что решили в прошлый четверг?» станет настоящей проверкой модели.
Отраслевая специфика: одна и та же модель сталкивается с разными проблемами в разных отраслях
Microsoft создала синтетические среды для трёх отраслей. Каждая из них воспроизводит реальные бизнес-процессы:
- Фармацевтика: подача документов регуляторам, обсуждение клинических исследований, межфункциональные совещания по оценке безопасности
- Рынки капитала: работа со сделками, обсуждение требований комплаенса, анализ клиентских инвестиционных портфелей
- IT и разработка ПО: планирование итераций, обсуждение результатов ревью кода, координация выпуска продуктов
По мнению авторов, учёт отраслевой специфики помогает приблизить оценочные запросы к реальным вопросам пользователей и выявить характерные для отрасли ошибки, которые не обнаруживаются в общих тестовых сценариях. Внутренние команды компаний обычно работают с одной-двумя отраслями, поэтому им проще провести такую оценку глубже.
Автоматическая генерация запросов: шесть этапов конвейера
Одной синтетической среды недостаточно — нужны ещё и запросы для оценки. В оригинале отмечается, что вручную составить тысячи запросов с учётом данных и отраслевой специфики слишком дорого и долго, поэтому для этого создали автоматизированный конвейер. Каждый этап в статье описан лишь вкратце. В таблице ниже мы выделили шесть этапов в порядке описания; точное разделение этапов можно посмотреть на схеме в оригинале.
| Этап | Что говорится в оригинале | Упрощённый подход для небольших команд |
|---|---|---|
| 1. Библиотека задач | За основу берётся большой набор типовых рабочих задач | Составить список из 50–100 распространённых задач сотрудников: подвести итоги встречи, найти принятое решение, сравнить версии |
| 2. Отраслевой отбор | Выбираются задачи, связанные с конкретной отраслью | Попросить представителей бизнеса отметить задачи, актуальные для их отрасли |
| 3. Адаптация к предметной области | Задачи переформулируются с учётом отраслевой терминологии и контекста | Добавить отраслевые термины и типичные виды документов |
| 4. Генерация на основе среды | ИИ генерирует запросы, привязанные к данным синтетической среды | Предложить модели составить вопросы после изучения конкретных документов или веток обсуждений, а также подготовить эталонные ответы и указать источники |
| 5. Переформулировка на естественном языке | Запросы переписываются так, чтобы они больше походили на вопросы реальных людей | Добавить разговорные выражения, пропуски и отсылки к контексту, например: «Что в итоге стало с тем планом?» |
| 6. Проверка | Каждый запрос проверяется на точность и однозначность | Удалить дубликаты и выборочно проверить, есть ли в данных однозначное подтверждение ответа |
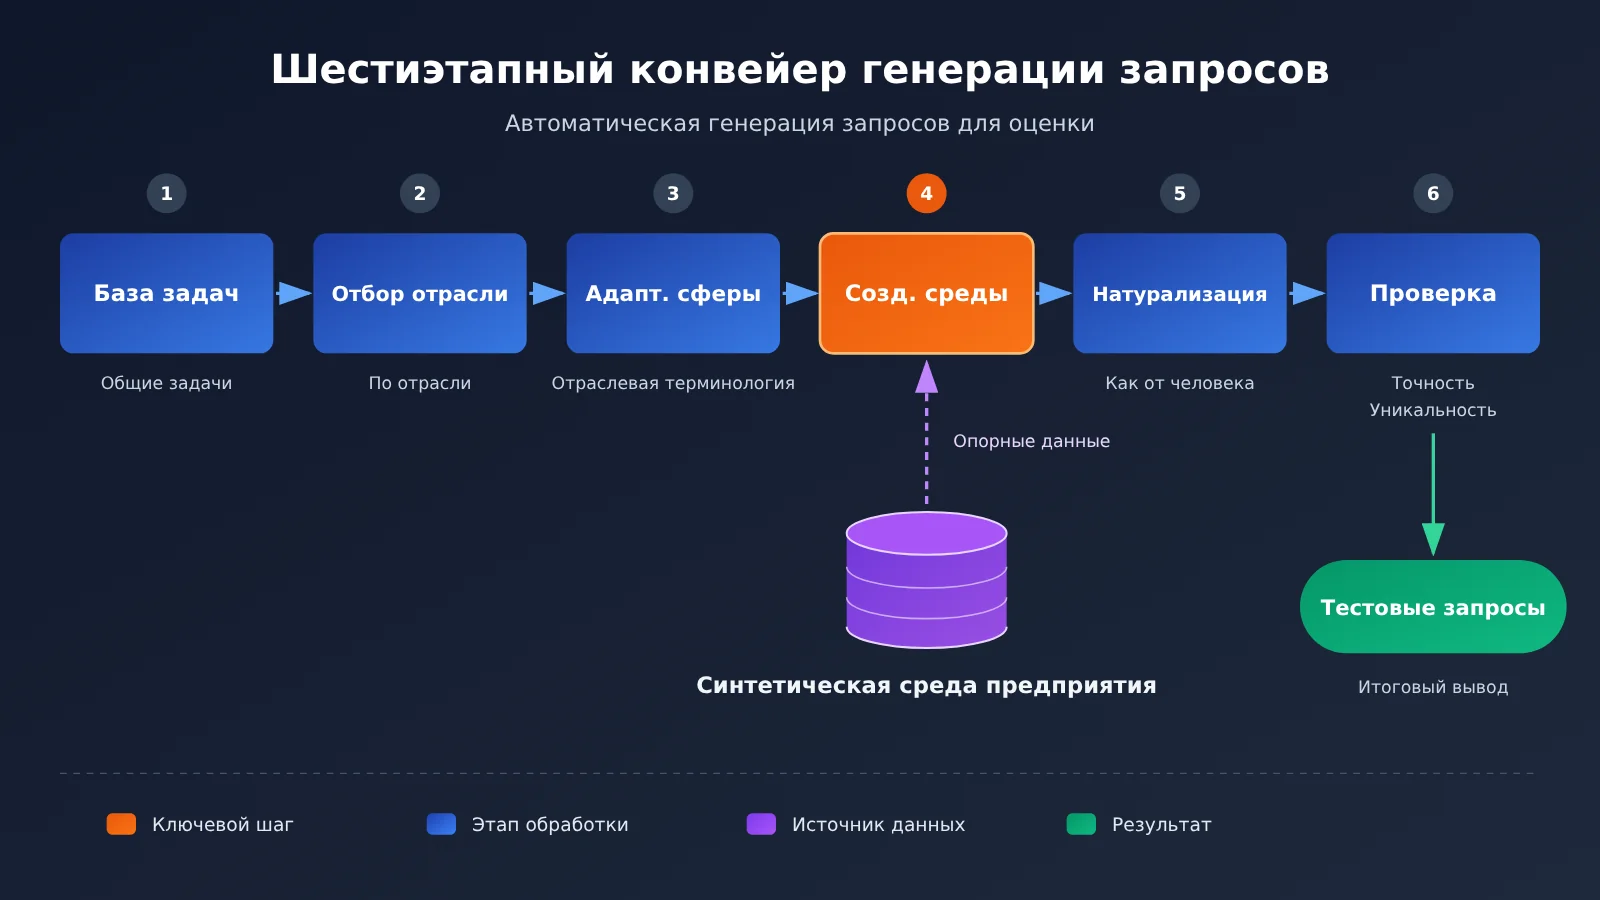
Четвёртый этап — ключевой для всего конвейера: запрос должен быть привязан к конкретным данным среды, иначе нельзя будет определить, правильный ли получен ответ. На шестом этапе легко упустить из виду однозначность. Если на один вопрос данные допускают несколько обоснованных ответов, при оценке возникнут споры.
На четвёртом и пятом этапах можно использовать одну модель для составления вопросов, а другую — для переформулировки или проверки. Это поможет снизить смещение, возникающее, когда одна и та же модель задаёт вопросы и отвечает на них. При вызове нескольких моделей через OpenAI-совместимый интерфейс APIYI apiyi.com для переключения достаточно изменить название модели — сам скрипт генерации почти не придётся менять.
🎯 Технический совет: на этапе генерации запросов зафиксируйте шаблон промпта, название модели и параметры вроде случайного зерна, а затем запишите их в файл конфигурации. Тогда при сравнении моделей единственной переменной останется сама модель. С помощью единого интерфейса APIYI можно переключаться между моделями разных поставщиков в рамках одного процесса генерации и проверки запросов.
Проверка качества синтетических данных: сначала данные, потом модель
Синтетические данные тоже нужно оценивать: иначе высокий результат модели может объясняться тем, что данные слишком простые. В оригинале сказано, что качество измеряли с помощью внутренней системы семантической оценки по «трём направлениям», но перечислены четыре. В таблице ниже приведены все четыре пункта; учитывайте это расхождение при цитировании.
| Направление оценки | Вопрос из оригинала | Как проверить на практике |
|---|---|---|
| Соответствие организационной структуры | Отражает ли структура реальные уровни подчинённости, размеры команд и связи между функциями | Подсчитать количество уровней и распределение команд по численности, сравнить с открытыми данными |
| Релевантность контекста | Отражают ли запросы и рабочие процессы реальные сценарии использования в компаниях | Попросить сотрудников бизнеса оценить выборку запросов вслепую: насколько они похожи на реальные вопросы |
| Реалистичность поведения | Похожи ли способы общения и совместной работы имитируемых пользователей на человеческие | Проверить, есть ли в переписке цепочки ответов, а на встречах — разногласия и последующие действия |
| Безопасность контента | Нет ли вредоносного, оскорбительного контента или данных, позволяющих установить личность, и не выдаются ли пользователи за реальных людей | Автоматически сканировать данные на имена, номера телефонов и документов, затем проверять результаты вручную |
По данным оригинала, по сравнению с первоначальным способом генерации комплексный показатель качества вырос на 39%, а для некоторых отраслевых сред оценка превысила 0,9 из 1,0. Авторы связывают улучшение с двумя факторами: использованием реальных отраслевых данных и автоматическим улучшением качества на основе комплексного показателя. Важно отметить, что этот показатель отражает, насколько синтетические данные похожи на данные реальной компании, а не качество работы самого Copilot. В оригинале показатели Copilot на этих наборах данных не раскрываются.
Воспроизводимость: условие для регрессионного тестирования разных версий на синтетическом наборе
В оригинальной статье перечислены четыре практические проблемы, которые возникают без автоматизации:
- Воспроизводимость: результаты ручной работы каждый раз немного различаются, поэтому сравнивать версии сложно
- Масштаб: количество отраслей и вариантов конфигурации превышает возможности ручной обработки
- Скорость итераций: ручное создание занимает несколько дней и замедляет получение обратной связи
- Согласованность между командами: без стандартных инструментов форматы и качество наборов данных разных команд несовместимы
После автоматизации создание набора данных вместо нескольких дней ручной работы стало выполняться автоматически. По оценке Microsoft, экономия составила около 100 000 долларов на каждом оценочном наборе данных и около 300 000 долларов на всём проекте. Это оценка с учётом масштабов самой компании — напрямую переносить её на другие команды нельзя. Авторы статьи считают более важным другое: любая команда может заново создать набор данных с той же конфигурацией и получить в точности тот же результат.
Это важно для регрессионного тестирования. Если вы изменили стратегию поиска или сменили модель и оценка снизилась, нужно понимать, что причина — в изменениях системы, а не данных. Если тестовый набор при каждом создании немного отличается, сравнение версий теряет смысл.
При сравнении нескольких моделей-кандидатов в APIYI тоже стоит придерживаться этого принципа: зафиксировать синтетический оценочный набор с одним и тем же номером версии, а затем прогнать его через каждую модель. Тогда результаты сравнения будут отражать только различия между моделями.
Быстрый старт: синтетический корпоративный оценочный набор для небольшой команды
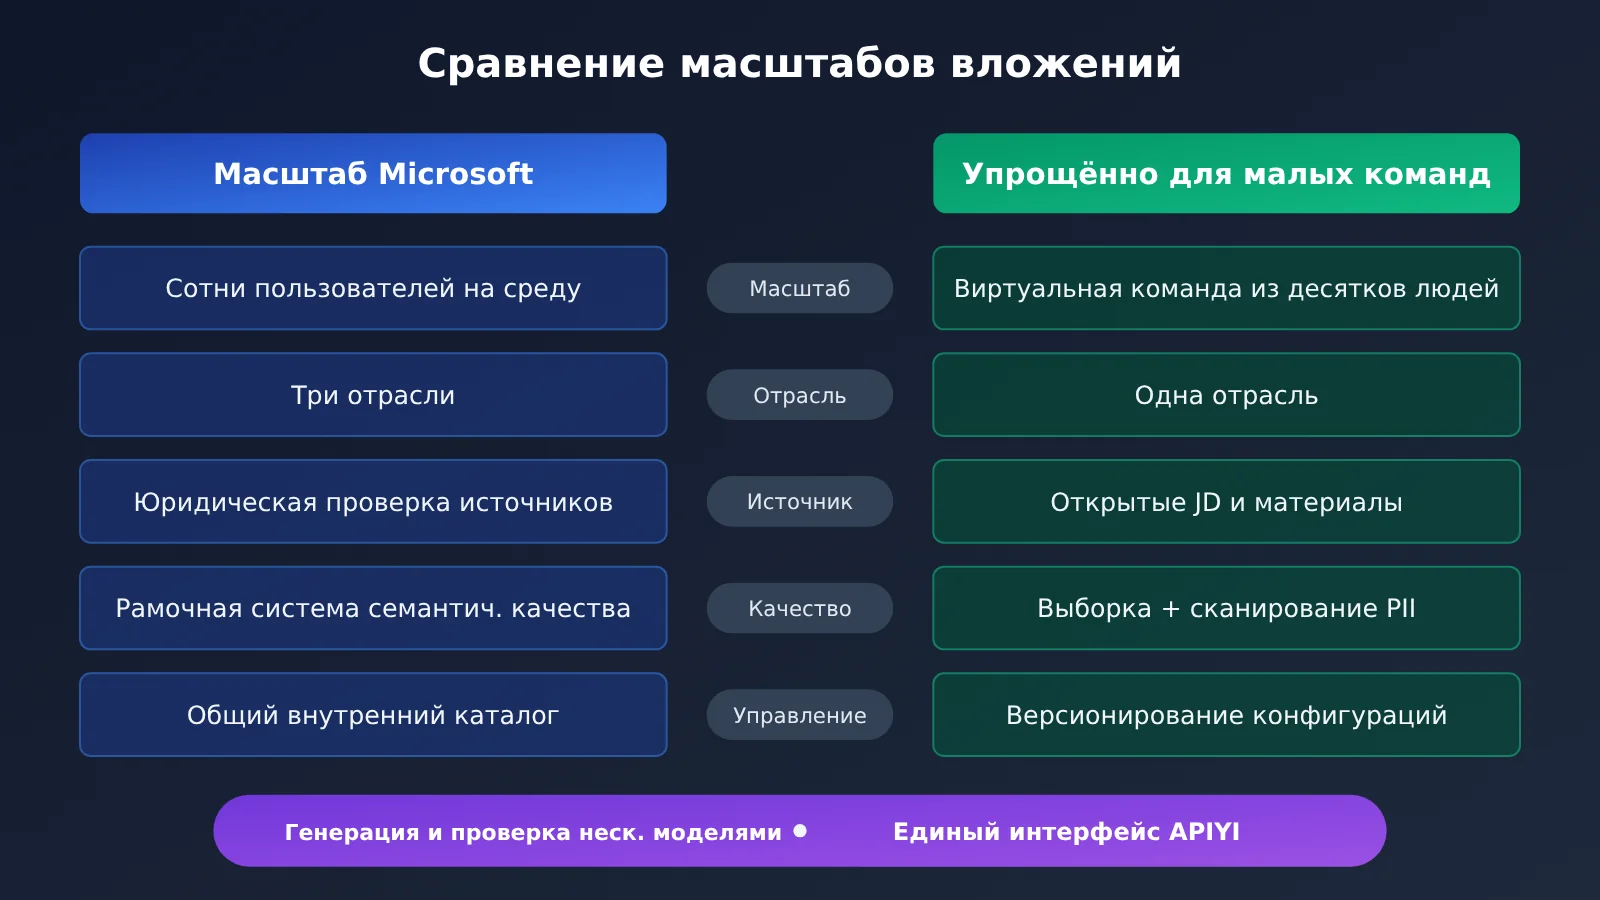
Подход Microsoft охватывает полную историю общения сотен пользователей, три отраслевых контекста, юридическую проверку и общие внутренние каталоги. Небольшим командам не обязательно копировать его целиком. Ниже — упрощённые шаги, основанные на методике из оригинальной статьи.
Порядок работы
- Определите рамки: выберите один бизнес-сценарий, например «ответы на вопросы по протоколам встреч» или «поиск по проектной документации», и ограничьтесь одной отраслью.
- Опишите организацию: опираясь на открытые вакансии и отраслевые материалы, создайте виртуальную организацию из 20–50 человек. Укажите отделы, должности и отношения подчинённости.
- Составьте хронологию: сначала опишите проект на протяжении 4–8 недель, перечислив ключевые события, решения и изменения. Затем на этой основе создайте протоколы встреч, письма и документы, сохраняя связи между событиями.
- Создайте материалы: с помощью большой языковой модели последовательно сгенерируйте документы по хронологии. Добавьте к каждому метаданные: дату, автора, участников и другие сведения.
- Составьте запросы: подготовьте вопросы по описанному выше шестиступенчатому процессу. Для каждого укажите эталонный ответ и номер документа-источника, а запросы, связанные со временем, отметьте отдельно.
- Проверьте данные: выборочно оцените их по четырём критериям качества. Сканирование на наличие персональных данных (PII) обязательно проведите для всего набора.
- Зафиксируйте версию: внесите описание организации, хронологию, промпты, названия моделей и параметры в конфигурацию и присвойте ей номер версии.
- Запустите оценку: выполните тестирование системы на фиксированной версии набора данных и запишите результаты для каждого типа запросов.
🚀 Быстрый старт: на шагах 4 и 5 потребуется многократно вызывать большую языковую модель. Через совместимый с OpenAI интерфейс APIYI apiyi.com можно обращаться к разным моделям одним и тем же способом: использовать одну модель для генерации, а другую — для проверки. Достаточно изменить название модели.
Чек-лист для самопроверки
- [ ] В данных для оценки полностью отсутствуют реальные данные клиентов и сотрудников
- [ ] Организация имеет иерархию и межотдельное взаимодействие, а не представляет собой плоский список
- [ ] Данные имеют реалистичную временную структуру, охватывают как минимум несколько недель, а события связаны причинно-следственными связями
- [ ] Часть запросов содержит временные ориентиры, например «на прошлой неделе» или «с последнего разбора»
- [ ] В запросах используются терминология и типы документов вашей отрасли
- [ ] У каждого запроса есть однозначный эталонный ответ, который можно проверить, и указан источник
- [ ] Синтетические данные прошли проверку качества, а не используются напрямую
- [ ] С одной и той же конфигурацией можно повторно создать идентичный набор данных
Что требует больших вложений, а что можно упростить
| Этап | Подход Microsoft | Объём вложений | Рекомендация для небольших команд |
|---|---|---|---|
| Использование открытых данных | O*NET, объявления о вакансиях, документы SEC с юридической проверкой | Высокий | Можно собрать отраслевые материалы вручную, но всё равно нужно убедиться, что источники разрешено использовать |
| Масштаб среды | Сотни пользователей в каждой среде, включая полную историю общения | Высокий | Нескольких десятков человек достаточно, чтобы охватить основные роли |
| Охват отраслей | Три отрасли | Средний | Ограничиться одной отраслью, для которой вы создаёте продукт |
| Оценка качества | Внутренний фреймворк семантической оценки и комплексные метрики | Высокий | Выборочная проверка вручную + простая статистика + автоматическое сканирование PII |
| Временная структура | Организация, которая развивается со временем | Обязательна | Сначала составить хронологию, затем генерировать контент |
| Воспроизводимость | Одинаковые результаты при одной конфигурации | Обязательна | Версионировать конфигурацию и кешировать результаты генерации |
Сократить можно масштаб и уровень автоматизации, но нельзя отказываться от временной структуры, привязки запросов к данным и воспроизводимости. Именно эти три условия определяют, можно ли использовать результаты оценки для решения о запуске. При этом открытых данных о реальной стоимости и результатах применения этого подхода в небольших командах пока нет. Приведённые рекомендации основаны на выводах из метода, описанного в оригинале.
Частые вопросы FAQ
Q1: Что такое синтетический оценочный набор для корпоративной среды?
Это смоделированное корпоративное рабочее пространство, полностью созданное программным способом. Оно включает сотрудников, организационную структуру, встречи, письма и документы, а также набор оценочных запросов на основе этих данных. С его помощью можно проверить, умеет ли корпоративное AI-приложение находить, объединять и представлять нужную информацию, не обращаясь к реальным данным клиентов.
Q2: Чем синтетический оценочный набор отличается от универсальных бенчмарков?
Универсальные бенчмарки полезны для сравнения общих возможностей, но в них нет структуры подчинения, истории проектов и рабочих процессов конкретной области. Синтетическая корпоративная среда сохраняет эти структуры и помогает выявить ошибки, которые остаются незамеченными при универсальном тестировании. Например, модель может перепутать принадлежность сотрудника к отделу или пропустить решение, принятое на встрече представителей разных подразделений.
Q3: Когда Microsoft опубликовала этот подход?
Microsoft Research опубликовала соответствующую статью в блоге 30 октября 2026 года. В ней говорится, что платформа была размещена во внутреннем общем каталоге и стала первым стандартизированным эталоном для оценки Microsoft Copilot.
Q4: Для каких задач этот подход подходит лучше всего?
— **Ответы на вопросы по итогам встреч**: проверка точности кратких изложений, извлечения задач и цитирования
— **Поиск корпоративных знаний**: проверка способности найти единственный верный источник среди множества документов
— **Запросы, связанные со временем**: проверка ответов на вопросы вроде «Что решили на прошлой неделе?» и «Что изменилось за последнее время?»
— **Проверка регрессий моделей или версий**: сравнение старых и новых решений на фиксированном наборе данных
Q5: Как сравнить разные модели на одном синтетическом оценочном наборе?
Главное — зафиксировать версию набора данных и менять только тестируемую модель. APIYI apiyi.com предоставляет единый интерфейс, совместимый с OpenAI, и поддерживает несколько популярных моделей. Чтобы переключиться между ними, достаточно изменить название модели. Так можно последовательно проверить все модели-кандидаты с помощью одного и того же скрипта оценки. При этом логику выставления оценок и фреймворк для оценки вам всё равно придётся реализовать самостоятельно.
Q6: Могут ли синтетические данные исказить результаты оценки?
Да, поэтому авторы предусмотрели отдельную систему контроля качества: сначала оцениваются данные, а затем модель. Если синтетические данные слишком упорядочены и в них нет реальных разногласий и шума, оценки модели окажутся завышенными. Рекомендуется попросить сотрудников бизнес-подразделений провести слепую оценку выборки данных и регулярно корректировать синтетические данные на основе обезличенной обратной связи из реальных сценариев.
Q7: Какие известные ограничения есть у этого подхода?
В исходном материале не раскрыты промпты, инструменты и детали реализации этапов пайплайна, а также метрики оценки Copilot. В описании системы контроля качества говорится о «трёх измерениях», но перечислены четыре. Сумма экономии — собственная оценка Microsoft. Авторы также отмечают, что в дальнейшем им предстоит решить задачи оценки многораундового взаимодействия агентов, изменений в организации на протяжении месяцев и даже лет, а также ИИ-систем, которые выполняют действия.
Оценочный набор для синтетической корпоративной среды: главное
- Трёхуровневая структура: синтетическая среда как основа, автоматическая генерация запросов и проверка качества данных — без любого из этих уровней оценка будет ненадёжной
- Калибровка по открытым данным: профессиональные базы данных, вакансии и публичная финансовая отчётность помогают приблизить структуру организации к реальной
- Без временной структуры не обойтись: для запросов о событиях во времени данные должны отражать реальную последовательность событий и причинно-следственные связи
- Отраслевая специфика помогает находить больше ошибок: запросы, близкие к предметной области, чаще выявляют характерные для неё сбои
- Сначала проверяйте данные, затем модель: оценивайте синтетические данные по четырём направлениям — структура, контекст, поведение и безопасность
- Воспроизводимость необходима для регрессионного тестирования: если при одной и той же конфигурации получаются одинаковые данные, сравнение между версиями имеет смысл
- Сравнение нескольких моделей: зафиксировав набор данных, можно переключать модели по имени через единый интерфейс APIYI и сравнивать результаты
Итоги
Подход Microsoft Copilot к созданию синтетической корпоративной среды можно свести к трём принципам:
- Синтетические данные для защиты приватности: если данные клиентов не используются изначально, набором данных можно свободно делиться между командами и применять его повторно.
- Структура для реалистичности: от организационной иерархии, временной структуры и отраслевых процессов зависит, поможет ли оценка выявить реальные проблемы.
- Автоматизация для воспроизводимости: одна и та же конфигурация должна давать один и тот же набор данных — тогда результаты оценки помогут принять решение о запуске.
Небольшим и средним командам необязательно повторять масштаб Microsoft, но три приёма стоит перенять: временную структуру, привязку запросов и версионирование конфигурации. Начните с одного сценария, одной отрасли и виртуальной организации из нескольких десятков человек. Пройдите полный цикл, а затем постепенно расширяйте проект.
Когда набор данных зафиксирован, через APIYI apiyi.com можно подключить несколько моделей с помощью единого способа вызова, совместимого с OpenAI, и сравнить их работу на одном и том же синтетическом наборе для оценки.
📚 Источники
- Microsoft Research Blog — From synthetic enterprise data evaluations to real Microsoft Copilot AI confidence: исходный материал для разбора подхода
- Ссылка:
microsoft.com/en-us/research/blog/from-synthetic-enterprise-data-evaluations-to-real-microsoft-copilot-ai-confidence -
Описание: оригинальная статья о синтетической среде, шестиступенчатом конвейере, системе оценки качества, защите приватности и полученных результатах
-
База профессий O*NET: база профессиональной информации Министерства труда США
- Ссылка:
onetonline.org -
Описание: в оригинальной статье использовалась для калибровки распределения ролей, обязанностей и рабочих задач синтетических сотрудников
-
Поиск публичных документов SEC EDGAR: документы, раскрытые Комиссией по ценным бумагам и биржам США
- Ссылка:
sec.gov/edgar - Описание: в оригинальной статье использовались для определения размера синтетической организации, структуры её бизнес-подразделений и финансового контекста
Автор: техническая команда APIYI
Техническое общение: если у вас есть вопросы о едином подключении нескольких моделей, свяжитесь с нами через сайт APIYI apiyi.com