Примечание автора: разбираем Gemini 4 Neon и GPT-6.2 Sol по трём пунктам — кодирование, графики и длинный контекст, — а заодно сверяем стоимость одной задачи, время выполнения, официальную цену за единицу и цену на витрине APIYI. У каждой цифры указан источник.
Многие команды считают GPT-6.2 Sol более дешёвым вариантом. Gemini 4 Neon вышла 2026-11-18, и на странице модели Artificial Analysis её оценка интеллекта — 61, у Sol — 57. То, на каких именно задачах проявляются эти 4 балла, и определяет, сколько они стоят для вашей рабочей нагрузки. В этой статье мы смотрим на кодирование, графики и длинный контекст по отдельности, а стоимость одной задачи и цену за единицу ведём двумя разными счетами.
Каждая цифра в тексте снабжена меткой источника: данные самой компании, карточка модели, страница модели Artificial Analysis, статья Artificial Analysis, сводная таблица APIYI, интерфейс ценообразования. Если цифры из двух источников не сходятся, они стоят рядом — без усреднения и без синтеза новых значений.
Главная ценность: после прочтения вы сможете внятно объяснить, в каких пунктах у Neon появляются дополнительные баллы, по какому пункту Sol, наоборот, выше, насколько они расходятся в стоимости одной задачи и времени выполнения, и как вызвать уже доступную в APIYI модель gpt-6.2-sol.
Ключевые различия Gemini 4 Neon и GPT-6.2 Sol — краткий обзор
Сначала соберём самые важные семь строк вместе. Обратите внимание на уровни: на странице модели в Artificial Analysis 61 балл Neon взят из уровня xhigh, а 57 баллов Sol — из уровня max. Оба — высшие уровни на своих страницах, но названия и смысл уровней разные.
| Критерий сравнения | Gemini 4 Neon | GPT-6.2 Sol | Источник |
|---|---|---|---|
| Общий балл интеллекта | 61 (xhigh) | 57 (max) | Страница модели Artificial Analysis |
| Кодинг: Terminal-bench 4.1 (точность после поправки на читерство) | 65.2% | 61.5% | Модельная карточка |
| Графики: Chartography | 73.5% | 75.1% | Модельная карточка |
| Длинный контекст: GraphWalks (от 256k до 1M, F1 для BFS) | 95.2% | 80.1% | Модельная карточка |
| Стоимость одной задачи | 6.44 доллара | 1.01 доллара | Страница модели Artificial Analysis |
| Время на одну задачу | 21.5 минуты | 8.5 минуты | Страница модели Artificial Analysis |
| Прайс-лист (вход/выход, за миллион токенов) | 3 / 15 доллара | 2 / 10 доллара | По данным самой компании / страница модели Artificial Analysis |
Три оговорки перед чтением таблицы сравнения Gemini 4 Neon и GPT-6.2 Sol
Первая — это природа модельной карточки. В сравнительной таблице карточки DeepMind всего три колонки: Gemini 4 Neon, Claude Opus 5.5 и GPT-6.2 Sol, а в прилагаемом PDF с описанием оценки прямо сказано, что результаты не для Gemini по умолчанию взяты из самопредставленных данных каждой компании. Так что колонка Sol в карточке — это официальные цифры, которые собрала Google, а не повторный замер, сделанный одной и той же лабораторией в один и тот же день.
Вторая — согласованность балла интеллекта. Число 61 совпадает в блоге Google (официальные данные компании), в модельной карточке (в строке AA Index v5.0.1 указано 61 / 59 / 57) и на странице модели Artificial Analysis; 57 у Sol тоже совпадает в карточке и на странице Artificial Analysis. С индексами по кодингу такой стройности нет — ниже разберём их отдельно.
Третья — методика подсчёта стоимости. Стоимость одной задачи в Artificial Analysis — это сумма, полученная после прогона всего набора индексов и распределённая на каждую задачу; на неё влияют и цена за токен, и количество выходных токенов. Это число и цена одного вызова по токенной тарификации платформы — два разных счёта, и подменять один другим нельзя.
Сравнение Gemini 4 Neon и GPT-6.2 Sol в кодировании
Что касается кодирования, то из пяти метрик в карточке модели Neon обходит Sol во всех пунктах, где есть данные, но разрыв очень неравномерный. Все данные в таблице ниже взяты из карточки модели; показатели Sol, согласно примечанию к оценке, — это данные, которые OpenAI предоставила сама.
| Метрика кодирования (карточка модели) | Gemini 4 Neon | GPT-6.2 Sol | Разрыв |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | Нет данных | Сравнить невозможно |
| Terminal-bench 4.1 (с поправкой на читерство) | 65.2% | 61.5% | 3.7 п.п. |
| FrontierCode 2.0 | 46.2% | 43.8% | 2.4 п.п. |
| SWE-sweep (harness вендора) | 39.0% | 8.3% | 30.7 п.п. |
| SWE-sweep (mini-SWE harness) | 12.8% | 11.6% | 1.2 п.п. |
Два harness в SWE-sweep нужно интерпретировать отдельно
Строку SWE-sweep легче всего понять неправильно. 39.0% у Neon получено на harness вендора Google Antigravity; на едином mini-SWE harness результат — 12.8%. В блоге Google (официальные данные) разрыв между 12.8 и 39.0 описывают как раскрытие потенциала за счёт harness, так что эти цифры отражают совокупный эффект «модель плюс инструментальная цепочка».
На одном и том же mini-SWE harness у Neon 12.8% против 11.6% у Sol — разница всего 1.2 процентного пункта. На harness собственного вендора у Sol 8.3% — это даже ниже его результата на mini-SWE. Если ваш агент для кодирования работает не в Antigravity, строка mini-SWE ближе к условиям, которые вы сможете воспроизвести.
Два значения в Coding Agent Index
В блоге Google (официальные данные) указано, что Neon получает 58.6 в Artificial Analysis Coding Agent Index, и он назван первым в общем зачёте. В статье Artificial Analysis указано 59 для Neon xhigh на Antigravity CLI. Эти два числа взяты из разных источников; в статье мы приводим оба и не пытаемся свести их в одно. В справочных материалах нет оценки Sol по этому индексу, поэтому сравнить их здесь невозможно. Кроме того, 46.2% в FrontierCode 2.0, согласно официальным данным, получено в режиме high по умолчанию.
Сравнение возможностей работы с диаграммами у Gemini 4 Neon и GPT-6.2 Sol
Диаграммы — это тот из трёх пунктов, где Sol выше. В строке Chartography карточки модели у Neon 73,5%, у Sol 75,1% — Sol выше на 1,6 процентного пункта. В блоге Google (официальные данные, заявленные самим разработчиком) для Neon указана та же цифра — 73,5%, так что оба источника совпадают.
В LVBench, который тоже относится к мультимодальному пониманию, карточка модели даёт Neon 89,0% и Sol 87,6% — здесь Neon выше на 1,4 процентного пункта. Результаты разнонаправлены, и разрыв в обоих случаях небольшой, поэтому на вопрос «кто сильнее в диаграммах и визуальных задачах» трудно ответить одной фразой. Смотрите, что ближе к вашей задаче — чтение диаграмм или просмотр длинных видео.
Что касается входных модальностей, в карточке модели указано, что Neon принимает текст, изображения, аудио и видео. В справочных материалах перечня входных модальностей Sol нет, поэтому если ваш пайплайн зависит от аудио- или видео-входа, сначала сверьтесь с официальной документацией OpenAI и проверьте, что Sol это поддерживает.
Сравнение длинного контекста Gemini 4 Neon и GPT-6.2 Sol
Для длинного контекста в этой статье используются только данные GraphWalks из карточек моделей. При BFS-обходе в диапазоне от 256k до 1M токенов показатель F1 у Neon составляет 95.2%, у Sol — 80.1%. Разница — 15.1 процентного пункта, и это самый большой разрыв среди трёх показателей.
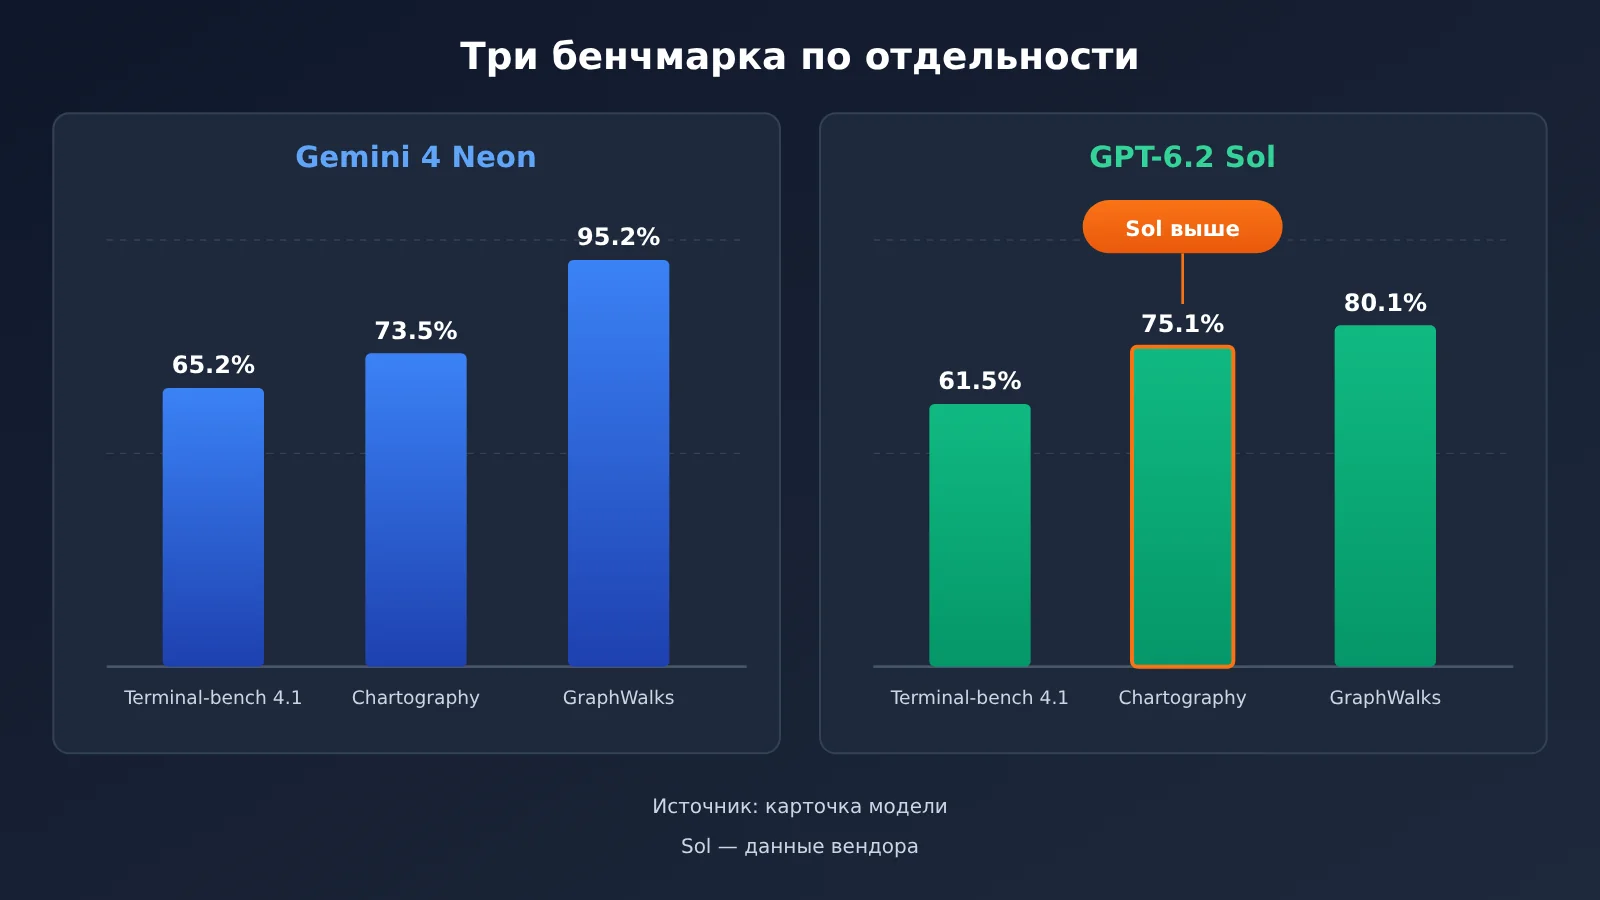
📊 Пояснение к графику: все числа на графике взяты из карточек моделей; столбец Sol, согласно примечанию к оценке, содержит данные, заявленные производителем. Если хотите проверить работу Sol на собственных длинных документах, можно через APIYI apiyi.com тем же ключом напрямую отправить запрос к
gpt-6.2-sol.
Параметры длинного контекста Gemini 4 Neon
Спецификации окна у Neon полностью документированы. В карточке модели указано, что единое окно — до 1 млн токенов, синхронный вывод по умолчанию — до 64 тыс. токенов, а фоновое длинное декодирование — до 1 млн. Руководство для разработчиков Google Cloud приводит точные значения: единый верхний предел — 1048576 токенов, включая и вход, и выход; выход, в свою очередь, включает размышления, вызовы функций и финальный ответ; для одного сегмента по умолчанию — до 65536, а при длинном декодировании — до 1048576 минус объём входа.
Что касается кэширования, руководство для разработчиков прямо говорит: Neon не поддерживает явное кэширование контекста. Неявное кэширование автоматически применяется к общим префиксам длиной более 4096 токенов, а постоянный кэш включён по умолчанию. В сценарии с многократными вопросами по длинному документу это значит, что общий префикс должен оставаться неизменным — только так вы получите цену кэша 0.15 доллара США, указанную на странице цен AI Studio.
Информация о длинном контексте GPT-6.2 Sol
В справочных материалах не указан верхний предел контекстного окна Sol, поэтому размер окна в этой статье не сравнивается. Удалось подтвердить тарификацию: сводная таблица APIYI показывает, что gpt-6.2-sol переходит на другую ценовую ступень после превышения 272000 токенов на входе; подробнее — в разделе о ценах ниже. В задачах с длинным контекстом этот порог напрямую влияет на структуру вашего счёта.
Сравнение Gemini 4 Neon и GPT-6.2 Sol по стоимости и времени
Разница в стоимости одной задачи куда больше, чем разница в цене за токен. На странице модели Artificial Analysis указано: у Neon xhigh стоимость одной задачи — 6.44 доллара, у Sol max — 1.01 доллара, то есть первая примерно в 6.4 раза больше. При этом соотношение входных цен по прайсу — 3 к 2, выходных — 15 к 10, в обоих случаях в 1.5 раза.
Оставшаяся разница объясняется объёмом выхода. На той же странице Neon xhigh в тесте индекса выдал 283 млн токенов, Sol max — 60.9 млн токенов; у первого примерно в 4.6 раза больше. Цена за токен выше в 1.5 раза, объём выхода больше в несколько раз — только вместе эти два фактора дают 6.44 против 1.01.
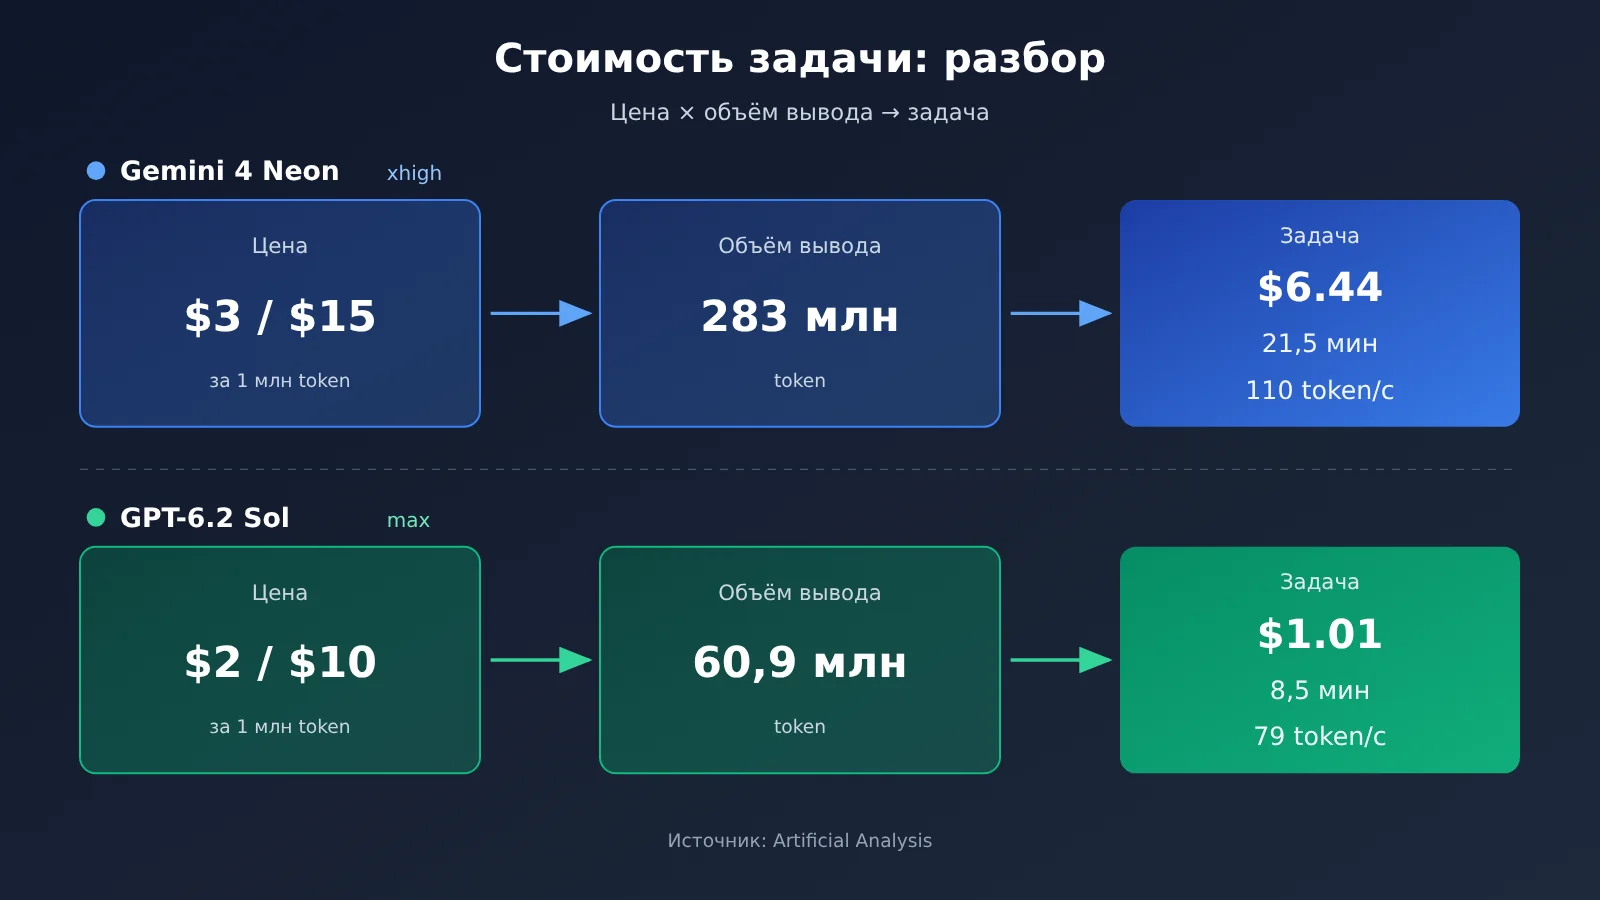
С временем выполнения та же логика. Скорость вывода у Neon xhigh — около 110 токенов/с, выше, чем 79 токенов/с у Sol max, но объём выхода больше, поэтому время на задачу — 21.5 мин против 8.5 мин. Время до первого токена ответа у Neon xhigh — 56.51 секунды, у Sol max — 75.06 секунды; по этому показателю Neon быстрее.
Баллы интеллекта и время на задачу по уровням
У обеих моделей есть несколько уровней рассуждений; таблица ниже взята со страницы модели Artificial Analysis. Стоимость одной задачи есть только в строке самого старшего доступного уровня каждой модели — остальные строки дают баллы, время и скорость.
| Уровень | Балл интеллекта Neon | Время на задачу Neon | Скорость вывода Neon | Балл интеллекта Sol | Время на задачу Sol | Скорость вывода Sol |
|---|---|---|---|---|---|---|
| max | Нет такого уровня | — | — | 57 | 8.5 мин | 79 токенов/с |
| xhigh | 61 | 21.5 мин | 110 токенов/с | 56 | 5.3 мин | 76 токенов/с |
| high | 60 | 14.8 мин | 101 токенов/с | 55 | 4.6 мин | 73 токенов/с |
| medium | 55 | 8.3 мин | 101 токенов/с | 53 | 3.2 мин | 70 токенов/с |
| low | 44 | 3.7 мин | 97 токенов/с | 41 | 1.5 мин | 65 токенов/с |
Эту таблицу можно читать двояко. Если сравнивать одноимённые уровни, на high у Neon 60 баллов против 55 у Sol, а время — 14.8 мин против 4.6 мин. Если смотреть по времени, 8.3 мин у Neon medium и 8.5 мин у Sol max близки, а баллы — 55 против 57. Уровень Neon по умолчанию — high (так написано и в руководстве для разработчиков, и на странице последней модели в AI Studio); именно на нём по умолчанию оказываются многие интеграции. Время до первого токена для трёх последних уровней Neon отдельно указано в FAQ на странице модели: high — 40.64 секунды, medium — 20.14 секунды, low — 13.93 секунды. Эти цифры и сводная таблица находятся в разных разделах страницы.
Сравнение цен Gemini 4 Neon и GPT-6.2 Sol: официальные цены и каталог APIYI
Цены здесь стоит разделить на два уровня: цены, указанные на страницах разработчика модели или третьих сторон, и цены в каталоге APIYI (apiyi.com).
| Пункт | Gemini 4 Neon | GPT-6.2 Sol |
|---|---|---|
| Цена на вход (за миллион токенов) | 3.00 доллара (официально заявленная / страница цен AI Studio) | 2.00 доллара (страница модели на Artificial Analysis) |
| Цена на выход (за миллион токенов) | 15.00 доллара, включая токены рассуждений | 10.00 доллара |
| Кэширование | 0.15 доллара, только неявное кэширование | Скидка на кэширование 95% (страница модели на Artificial Analysis) |
| Бесплатный тариф | Нет (страница цен AI Studio) | В справочных материалах не упоминается |
| ID модели в APIYI | Пока не добавлена в каталог | gpt-6.2-sol |
| Первая ступень APIYI (от 0 до 272000 входных токенов) | — | Вход 2 / чтение кэша 0.1 / выход 10 долларов |
| Высокая ступень APIYI (свыше 272000 входных токенов) | — | Вход 3 доллара; выход по данным интерфейса цен — около 11.25 доллара |
| Эндпоинт APIYI | — | responses (рекомендуется), chat |
| Доступные платформы | Официальные каналы, например Gemini API в Google AI Studio | APIYI apiyi.com и другие |
gemini-4-neon пока отсутствует и в общем списке APIYI, и в интерфейсе цен — модель ещё не добавлена в каталог. Мы скоро добавим её; актуальные модели и цены смотрите в списке моделей на платформе.
Детали изменения тарифа gpt-6.2-sol на APIYI
В сводной таблице APIYI (на странице указано, что она обновлена 2026-11-16 09:39, UTC+8) для gpt-6.2-sol в первом тарифе указаны вход 2 доллара, чтение из кеша 0,1 доллара и выход 10 долларов — это совпадает с ценой 2/10 на странице модели в Artificial Analysis. А вот про вход свыше 272000 token в тексте таблицы написано только одно: вход подскакивает с 2 до 3 долларов.
Запрошенный 2026-11-19 интерфейс ценообразования (версия shell-api-modelmak-v1, всего 285 моделей) даёт более полную картину. В нём model_ratio, равный 1, соответствует входу 2 доллара за миллион token, а completion_ratio, равный 5, означает, что выход стоит в 5 раз дороже входа. После превышения 272000 token CompletionRatio меняется с 5 на 3.75 — если считать по входу 3 доллара, выход получается около 11,25 доллара за миллион token, а вовсе не по-прежнему 10 долларов.
Названия групп в двух местах написаны немного по-разному: в сводной таблице — CodexResponses, Codex_Reverse, Default, SVIP, а в интерфейсе ценообразования — CodexResponses, CodexReverse, default, svip. И ещё раз подчеркну: 1,01 доллара у Artificial Analysis — это стоимость прогона индекса в пересчёте на одну задачу, и это вовсе не то же самое, что реальные расходы на token за один вызов на платформе.
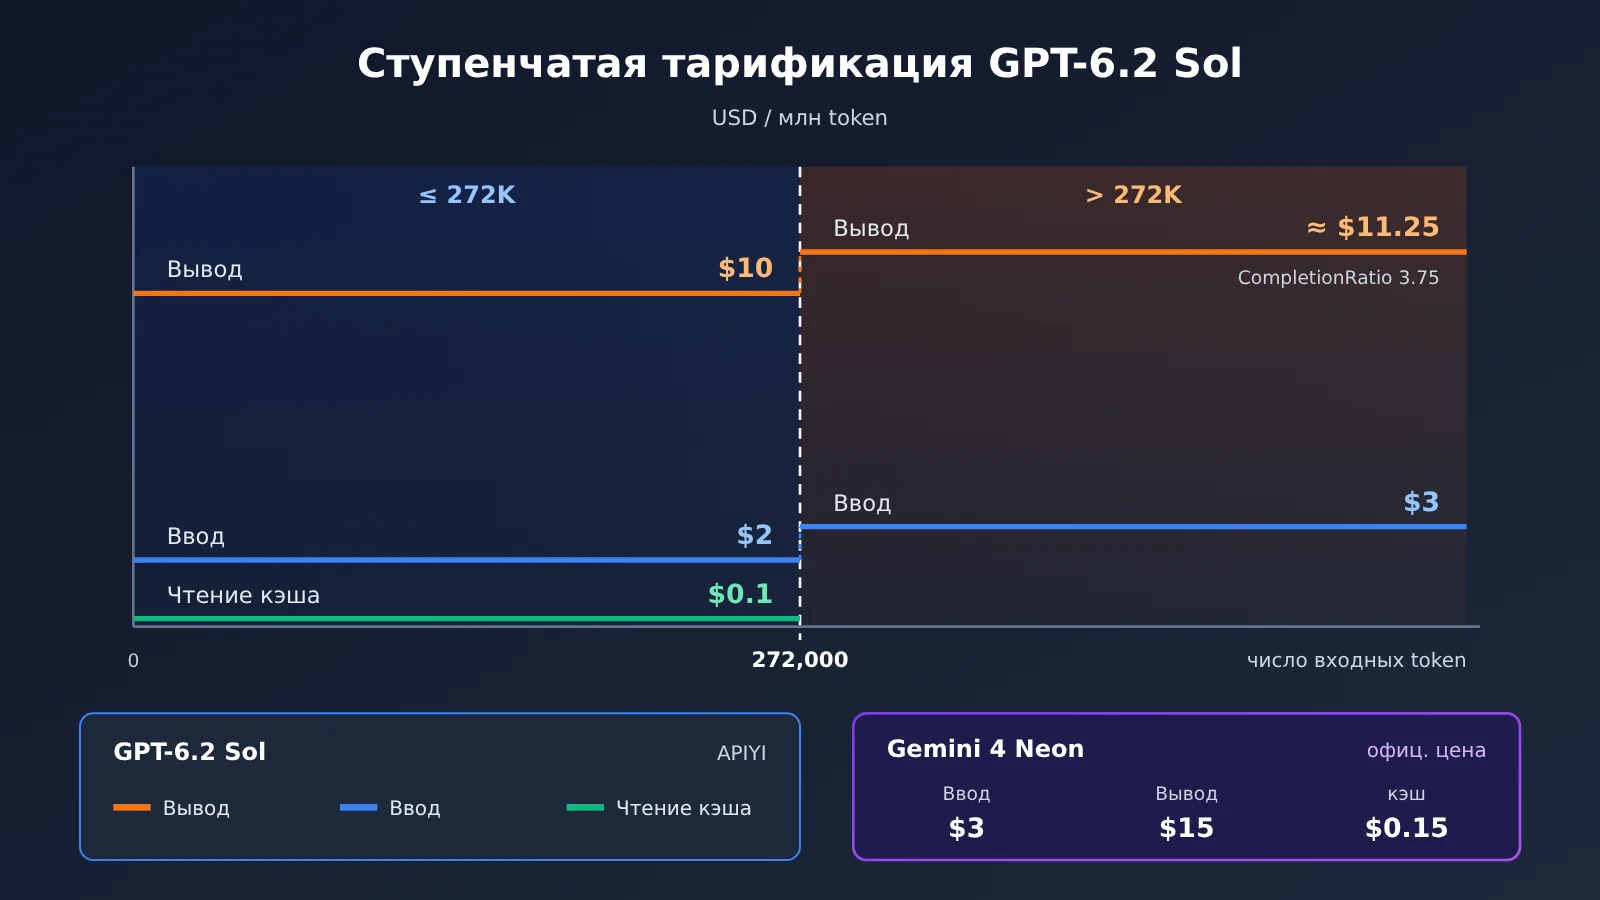
Сопоставление Gemini 4 Neon и GPT-6.2 Sol по сценариям
Ниже по типам задач собраны наиболее релевантные цифры — они помогут соотнести результаты оценки с вашей реальной нагрузкой. Какая модель подойдёт лучше, зависит от распределения задач и бюджета; здесь только сопоставление, без окончательных выводов.
Цифры, связанные с кодинг-агентами
- Работа внутри Google Antigravity: смотрите строку SWE-sweep с harness от вендора — Neon 39,0%, Sol 8,3%, и при этом помните, что Google сам объясняет этот разрыв особенностями harness.
- Работа в универсальном harness: смотрите строку mini-SWE — 12,8% против 11,6%, а также Terminal-bench 4.1: 65,2% против 61,5%.
- Частые мелкие правки: здесь важнее время на одну задачу — сопоставляйте его со временем из таблицы уровней для того же диапазона баллов.
Цифры, связанные с графиками и длинными документами
- Вопросы по графикам из финансовых отчётов и скриншотам дашбордов: в Chartography Sol — 75,1%, Neon — 73,5%, то есть по этому пункту направление противоположно итоговому баллу.
- Обход графовых структур или документов объёмом в сотни тысяч токенов: в GraphWalks Neon — 95,2%, Sol — 80,1%, и при этом нужно учитывать ступенчатое изменение тарификации Sol в APIYI при превышении 272000 токенов.
- Понимание длинных видео: в LVBench Neon — 89,0%, Sol — 87,6%, и в карточке модели прямо указано, что Neon поддерживает видео на входе.
Gemini 4 Neon и GPT-6.2 Sol: рекомендации по выбору — сначала проверка, потом решение
Перед выбором лучше проверить свой сценарий в порядке, указанном ниже, а не принимать решение, просто сравнив 61 и 57.
- Посчитайте, какую долю в ваших задачах занимают три категории — программирование, диаграммы и длинный контекст, — а затем сопоставьте результат с тремя таблицами по подкатегориям выше.
- Оцените средний объём вывода на одну задачу. Данные Artificial Analysis показывают, что разница в стоимости одной задачи между моделями в основном определяется объёмом вывода: чем длиннее вывод в ваших задачах, тем заметнее эта разница.
- Проверьте, не превышает ли длина ввода 272000 токенов. После преодоления этого порога цены на ввод и вывод для
gpt-6.2-solв APIYI изменяются. - Определитесь с уровнем размышлений. Neon поддерживает только четыре уровня: low, medium, high, xhigh; если передать
thinking_budgetилиMINIMAL, вернётся HTTP400(руководство для разработчиков). - Прогоните небольшую контрольную выборку на собственном наборе данных, фиксируя оценки, время выполнения и расход токенов.
💡 Рекомендация по выбору: у каждой из двух моделей есть свои сильные и слабые стороны по подкатегориям, и итоговый выбор зависит от распределения ваших задач и бюджета. Советуем сначала подключить уже доступную в APIYI apiyi.com модель
gpt-6.2-sol, записать расход токенов и время выполнения на своих примерах, а когда Neon появится в каталоге — прогнать сравнение тем же скриптом.
Как быстро вызвать GPT-6.2 Sol через APIYI
APIYI для gpt-6.2-sol рекомендует эндпоинт responses, а совместимый с OpenAI base_url — https://api.apiyi.com/v1. Вся интеграция укладывается в четыре шага:
- Подготовьте ключ: сгенерируйте API-ключ в консоли платформы и запишите его в переменную окружения
APIYI_API_KEY. В коде читайте ключ только из переменной окружения, не храните его в открытом виде. - Определите адрес запроса: эндпоинт Responses —
POST https://api.apiyi.com/v1/responses, в заголовках запроса передаютсяAuthorization: Bearer $APIYI_API_KEYиContent-Type: application/json. - Соберите тело запроса: минимальное тело —
{"model": "gpt-6.2-sol", "input": "请总结这份季度报告里的三张图表"}. - Вызовите через OpenAI SDK: инициализируйте
OpenAI(base_url="https://api.apiyi.com/v1", api_key=os.environ["APIYI_API_KEY"]), затем вызовитеclient.responses.create(model="gpt-6.2-sol", input=...)и читайте результат изoutput_textвозвращаемого объекта.
Если ваш существующий код построен на Chat Completions, можно отправить тот же ID модели на эндпоинт chat — путь /v1/chat/completions. Нативный протокол Gemini работает через https://api.apiyi.com с версией v1beta и подходит для моделей Gemini, уже размещённых на платформе.
При тестировании длинного контекста советуем в логах заодно фиксировать число входных токенов каждого запроса — так проще понять, не перешагнули ли вы порог в 272000. Конкретные значения параметра уровня рассуждений смотрите в официальной документации OpenAI и на странице модели на платформе.
🚀 Быстрый старт: новые пользователи могут получить бесплатную тестовую квоту на APIYI apiyi.com и одним ключом вызывать уже размещённые модели OpenAI, Claude, Gemini и другие. Сначала наладьте цепочку responses для
gpt-6.2-sol, а при последующем переключении модели достаточно поменять полеmodel.
Часто задаваемые вопросы (FAQ)
Q1: Какое позиционирование у Gemini 4 Neon и GPT-6.2 Sol?
Neon создана на базе Gemini 4 Carbon (карточка модели). В руководстве Google для разработчиков она находится между Hydrogen (быстрый повседневный цикл) и Carbon (сложные длительные задачи). На странице модели GPT-6.2 Sol в Artificial Analysis указана цена 2/10 долларов, а максимальный балл интеллекта в топовом режиме max — 57.
Q2: За счёт чего Neon получает дополнительные 4 балла по сравнению с Sol?
Если смотреть на разбивку по отдельным пунктам в карточке модели, наибольший разрыв — в длинноконтекстном GraphWalks (95,2% против 80,1%) и в SWE-sweep под harness вендора (39,0% против 8,3%). По показателю Chartography у Sol результат выше (75,1% против 73,5%).
Q3: Когда выпущена Gemini 4 Neon и на каких каналах она доступна?
Дата публикации в блоге Google — 2026-11-18. Согласно посту Сундара Пичаи о запуске, в тот же день модель стала доступна в Gemini API в Google AI Studio, в Gemini for business, в Google Antigravity для платных подписок Google AI Pro и Ultra, а также в Gemini App для Pro и Ultra. Идентификатор модели — `gemini-4-neon`.
Q4: Можно ли считать 1,01 доллара за задачу бюджетом на вызов?
Это сумма, которую Artificial Analysis получила, распределив стоимость полного набора индексов на каждую задачу; Sol max в этом тесте вывела 60,9 млн токенов. Ваши фактические расходы зависят от количества входных и выходных токенов и тарифного уровня. Рекомендуем самостоятельно оценить их по первой ступени в сводной таблице APIYI — 2 / 0.1 / 10 долларов — и учитывать переход на другую ступень при превышении 272000 токенов.
Q5: Как быстро вызвать обе модели через API?
`gpt-6.2-sol` уже доступна на APIYI. Зарегистрируйтесь на apiyi.com и получите тестовый лимит, затем укажите base_url `https://api.apiyi.com/v1` и вызывайте endpoint `responses`. `gemini-4-neon` пока нет ни в сводной таблице, ни в API цен — модель ещё не добавлена на платформу. Мы добавим её как можно скорее; актуальные модели и цены смотрите в списке моделей на платформе.
Q6: Какие ограничения есть у этих сравнительных данных?
В основном три:
— **Методика**: оценки Sol в карточке модели, согласно примечаниям к оценке, заявлены самим производителем, а не получены повторным тестом в тот же день.
— **Уровни**: в Artificial Analysis максимальный уровень у Neon — xhigh, у Sol — max, поэтому уровни не полностью сопоставимы.
— **Расхождения в цифрах**: Coding Agent Index в блоге Google — 58.6, а в статье Artificial Analysis — 59; WebExploitBench v1.2 в блоге указан как 51.26%, в карточке модели — 51.3%. В этой статье все значения оставлены как в источниках.
Gemini 4 Neon и GPT-6.2 Sol: ключевые выводы
- Сводный балл: на странице модели Artificial Analysis у Neon xhigh — 61 балл, у Sol max — 57 баллов.
- Код: в карточке модели Terminal-bench 4.1 — 65.2% против 61.5%; разницу в SWE-sweep стоит оценивать отдельно по каждому harness.
- Графики: в Chartography выше Sol — 75.1% против 73.5%.
- Длинный контекст: F1 на GraphWalks от 256k до 1M — 95.2% против 80.1%, это самая большая разница.
- Стоимость и время: на одну задачу — $6.44 против $1.01 и 21.5 против 8.5 минуты; главная причина — объём вывода различается в несколько раз.
- Цена за токены: Neon — $3/$15, Sol — $2/$10; в APIYI у
gpt-6.2-solпосле 272000 входных токенов тариф переключается.
Итог
Если разложить различия между Gemini 4 Neon и GPT-6.2 Sol по полочкам, картина получается гораздо понятнее, чем по сводному баллу:
- Код: Neon выше в тех подпунктах, по которым в карточке модели есть данные, но в одном и том же harness mini-SWE разница составляет всего 1.2 процентного пункта.
- Графики: в Chartography выше Sol, а в LVBench немного выше Neon.
- Длинный контекст: на GraphWalks Neon опережает на 15.1 процентного пункта — это самая заметная разница из трёх пунктов.
- Стоимость: цена за токены отличается в 1.5 раза, стоимость одной задачи — примерно в 6.4 раза; дополнительное увеличение даёт количество выходных токенов.
Какой вариант выбрать, зависит от распределения ваших задач и длины вывода. Рекомендую сначала подключить gpt-6.2-sol через APIYI apiyi.com, записать расход и время на реальных примерах, а после появления Neon в продаже пройти тот же сценарий и добавить сравнение.
📚 Справочные материалы
-
Блог Google «Introducing Gemini 4 Neon»: официальный анонс и собственные бенчмарки
- Ссылка:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Описание: сводные показатели, программирование, наука и позиционирование по цене — всё из официальных заявлений
- Ссылка:
-
Модельная карточка DeepMind Gemini 4 Neon: источник трёхколоночной сравнительной таблицы
- Ссылка:
deepmind.google/models/model-cards/gemini-4-neon - Описание: данные по отдельным тестам Chartography, GraphWalks, SWE-sweep и другим
- Ссылка:
-
Руководство для разработчиков Google Cloud по Gemini 4 Neon: правила окна, уровней «мышления» и кэширования
- Ссылка:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Описание: единый лимит 1048576 token, правила HTTP 400, описание неявного кэширования
- Ссылка:
-
Страница тарифов Google AI Studio: официальная цена за единицу для Neon
- Ссылка:
aistudio.google.com/docs/pricing - Описание: вход 3, выход 15, кэш 0,15 доллара за миллион token
- Ссылка:
-
Страница модели на Artificial Analysis: данные по разным конфигурациям Neon и Sol
- Ссылка:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/gpt-6-2-sol - Описание: оценка интеллекта, стоимость одной задачи, время, скорость вывода
- Ссылка:
-
Статья Artificial Analysis: трактовка независимых измерений Neon
- Ссылка:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Описание: данные вроде Coding Agent Index 59 и прочее
- Ссылка:
-
Сводная таблица и API тарифов APIYI: уже доступные модели и ступенчатые цены
- Ссылка:
docs.apiyi.com/models.md,api.apiyi.com/api/pricing - Описание: первая ступень
gpt-6.2-solи правило перехода на следующую ступень при 272000 token
- Ссылка:
Автор: техническая команда APIYI
Техническая связь: пишите нам через главную страницу сайта APIYI, больше информации о моделях и подключении — в документации docs.apiyi.com