Nota do autor: se a taxa de acerto do cache de comandos do Claude caiu de repente para 0, ou se a fatura não baixa de jeito nenhum, você pode usar os três passos do diagnostics para encontrar onde o prefixo divergiu e, junto com o usage, verificar se o cache realmente foi usado. O artigo também explica como fazer essa checagem por conta própria ao usar o serviço proxy de API da APIYI. (Se você está com esse problema, depois de ler o artigo pode enviá-lo ao seu agente e pedir que ele investigue.)
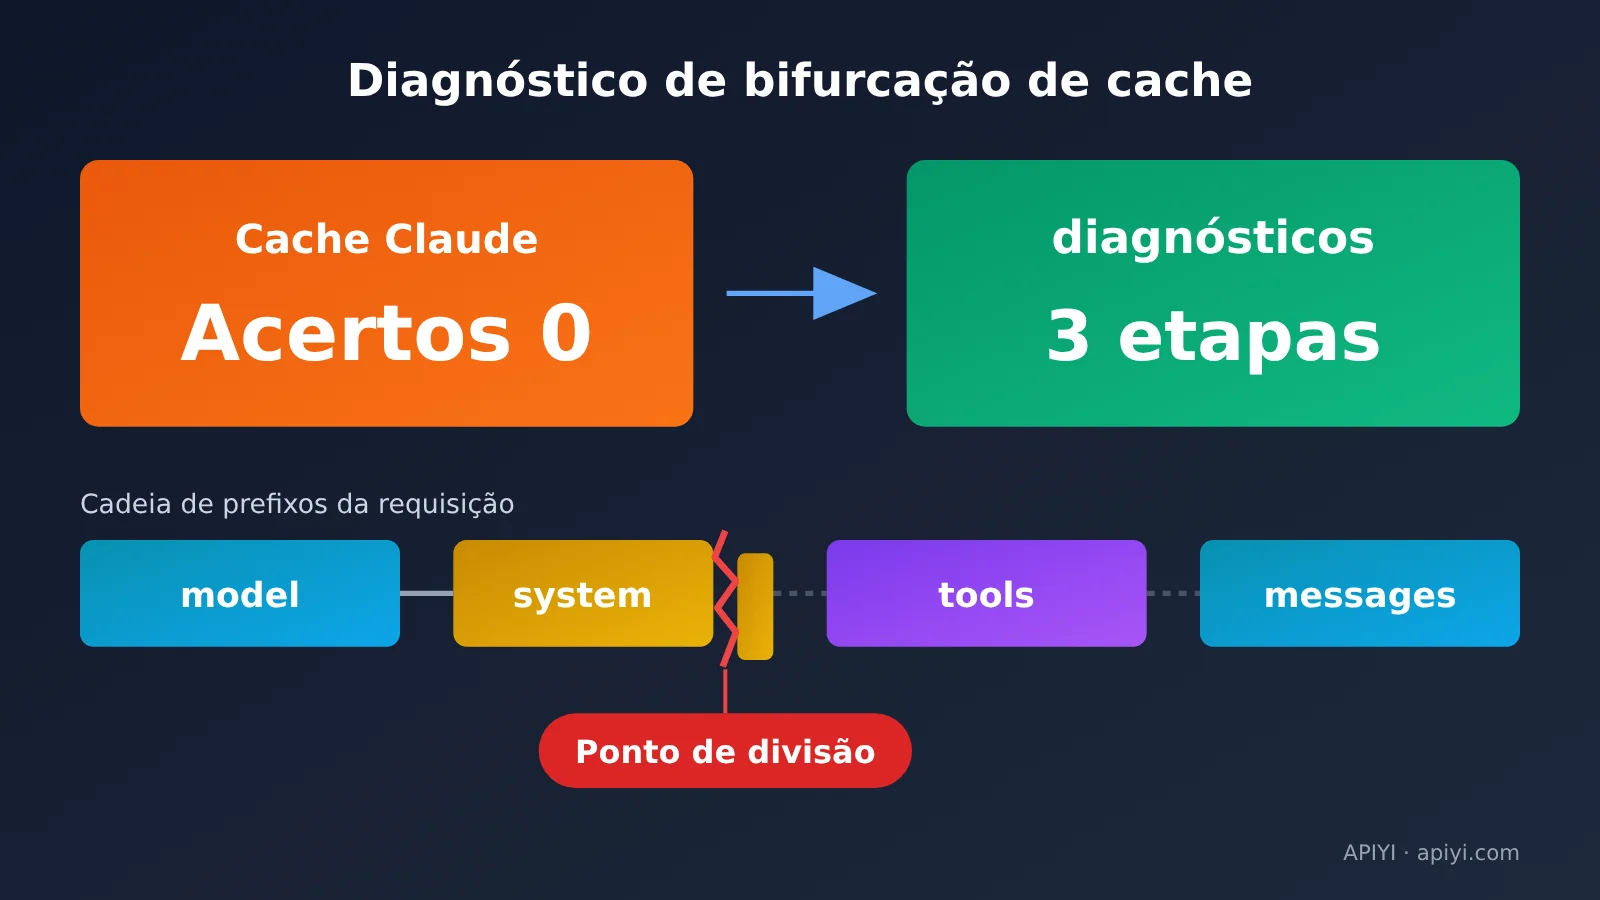
Cache não acertar não é mágica: a API mostra em qual trecho o prefixo começa a divergir. Basta enviar de volta o id da resposta da rodada anterior para ver se o primeiro ponto de divergência está em model, system, tools ou messages.
Este não é um artigo sobre lançamento de funcionalidade. Ele é para desenvolvedores que já usam o cache de comandos do Claude, mas tiveram a taxa de acerto zerada de repente ou estão com a fatura nas alturas. Todos os passos de investigação deixam claro o que você vai ver em cada etapa.
O que você leva daqui: ao terminar a leitura, você consegue identificar a causa da falha do cache em até três requisições. Também vai entender o que diagnostics e usage mostram separadamente e quais dois campos comparar entre si quando estiver usando um proxy de API.
Pontos-chave do diagnóstico de cache (diagnostics) do Claude
Em uma frase: você passa o id da resposta anterior e a API compara as duas requisições, apontando onde fica o primeiro ponto de divergência — se em model, system, tools ou messages. Antes, quando o cache falhava silenciosamente, você só via usage.cache_read_input_tokens virar 0, sem saber qual trecho tinha mudado.
| Ponto | O que é | Valor para você |
|---|---|---|
| Chave de ativação | A impressão digital só é armazenada se o objeto diagnostics estiver no nível superior do corpo da requisição |
Não precisa mexer na lógica de negócio, basta adicionar um campo |
| Forma de comparação | Passe o id da resposta anterior em previous_message_id |
Localiza direto o primeiro segmento divergente |
| Campo de conclusão | cache_miss_reason retorna um entre seis tipos |
Cada tipo aponta um local claro de correção |
| Junto com as métricas | Precisa ser lido em conjunto com usage.cache_read_input_tokens |
Evita confundir “sem divergência” com “não entrou em vigor” |
| Disponibilidade | Só a API oficial do Claude oferece | Em outros canais, é preciso usar a autoinspeção via usage |
Linha do tempo do diagnóstico de cache do Claude
O recurso chegou em beta em maio de 2026 e, na época, exigia o header anthropic-beta: cache-diagnosis-2026-04-07. Ao longo de setembro as regras ficaram mais rígidas uma vez: só as requisições que trazem explicitamente o objeto diagnostics guardam a impressão digital; as que só têm o header não são registradas.
Em 23 de setembro ele passou a versão estável, sem precisar mais do cache-diagnosis-2026-04-07, e requisições com o header antigo continuam funcionando normalmente. Agora o campo diagnostics sempre aparece na resposta de POST /v1/messages, com valor null quando não está habilitado. Ou seja, ver esse campo como null não significa que a interface tenha dado problema.
A impressão digital guarda apenas o hash e uma estimativa da contagem de tokens, sem salvar o conteúdo original do comando. Ela é indexada pelo response id, tem escopo limitado à sua organização e ao seu workspace, e o tempo de retenção é curto.
3 passos para investigar a taxa de acerto do cache do Claude com diagnostics
Os três passos abaixo seguem a descrição oficial dos campos. Se você fizer a chamada via APIYI, na interface nativa Messages, preencha o base_url com https://api.apiyi.com/v1 e o caminho da requisição é /v1/messages. Mas atenção: a seção de testes práticos mais adiante vai mostrar como o diagnostics realmente retorna no cenário de serviço proxy de API.
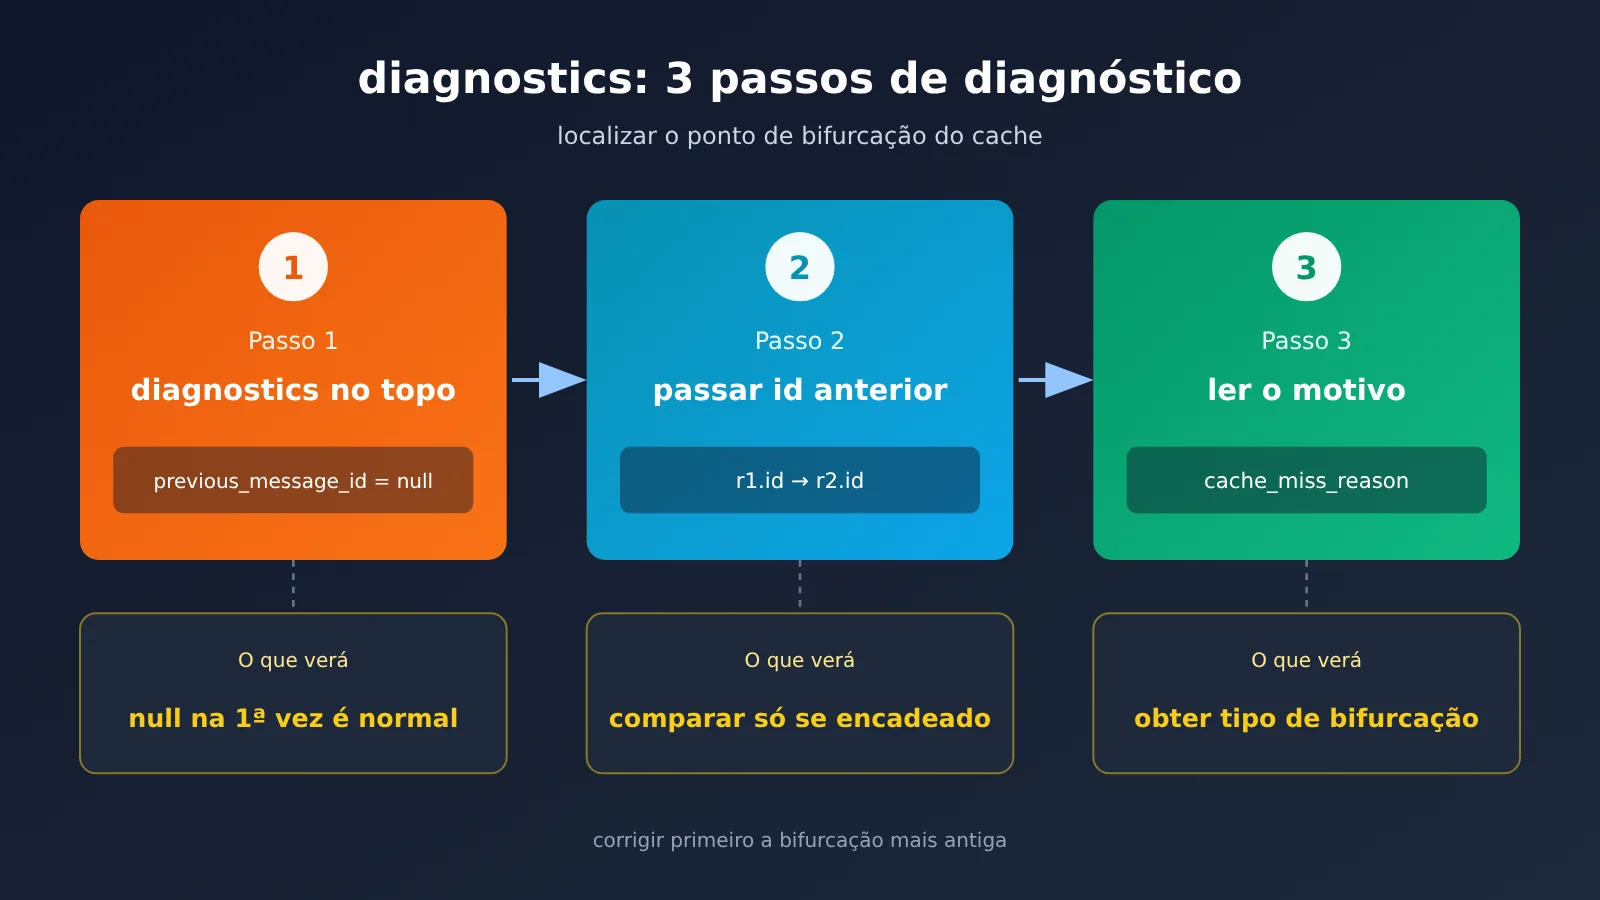
Passo 1: adicionar o objeto diagnostics no nível superior da requisição
diagnostics é o único interruptor. Requisições sem ele não armazenam a impressão digital, então depois não há como comparar. Na primeira rodada não existe nada para comparar, então passe previous_message_id como null, o que significa “começar a registrar a partir desta rodada”.
- Mantenha o cabeçalho de versão normal:
anthropic-version: 2023-06-01 - Depois da versão oficial, não é mais necessário enviar:
anthropic-beta: cache-diagnosis-2026-04-07 - Adicione no nível superior do corpo da requisição:
"diagnostics": {"previous_message_id": null} - O bloco system que precisa de cache continua com o ponto de cache normalmente:
"cache_control": {"type": "ephemeral"} - O que você verá: na resposta,
diagnosticsvem comonull,cache_read_input_tokensnormalmente é 0 ecache_creation_input_tokensé maior que 0
Ver null na primeira rodada não significa falha. Nesta rodada o cache está sendo gravado; não existe uma rodada anterior para comparar, então não há o que solucionar.
Passo 2: a cada rodada seguinte, envie o id da resposta anterior
A partir da segunda rodada, coloque o id da resposta anterior em previous_message_id. O erro mais comum é incluir diagnostics só na primeira rodada e esquecer nas seguintes. A requisição que a rodada seguinte aponta acaba não sendo registrada, e o retorno é previous_message_not_found.
- Corpo da segunda requisição:
"diagnostics": {"previous_message_id": "<id da resposta da primeira rodada>"} - Corpo da terceira requisição:
"diagnostics": {"previous_message_id": "<id da resposta da segunda rodada>"} - A lógica do ciclo de várias rodadas: na primeira você passa
null, na segunda passar1.id, na terceira passar2.id, e assim por diante - Em chamadas com streaming, o resultado aparece no evento
message_start, e o id segue sendo repassado rodada a rodada - O que você vai ver: quando o intervalo entre duas rodadas consecutivas é curto o suficiente e ambas estão no mesmo workspace, o resultado da comparação começa a aparecer na resposta
Passo 3: leia o cache_miss_reason e corrija conforme a tabela
diagnostics tem três valores possíveis, então entenda bem antes de ler:
null: a requisição não trouxediagnostics; ou oprevious_message_ideranull; ou a comparação já terminou e não foram encontradas divergências{"cache_miss_reason": null}: a comparação ainda está em andamento, porque a resposta começou rápido demais e nesta rodada não dá para concluir nada — espere a próximacache_miss_reasoné um objeto: já existe uma conclusão, com o tipo de bifurcação e os detalhes- O que você vai ver: depois de obter o tipo, corrija seguindo a tabela de correspondência da próxima seção. Comece pela bifurcação mais antiga, porque ele reporta apenas o primeiro ponto de divergência e os problemas seguintes podem estar escondidos atrás dele
🚀 Início rápido: se quiser primeiro confirmar se o seu prefixo de cache consegue gravar e acertar, você pode usar a mesma Key no APIYI apiyi.com, alternando entre os modelos Claude em duas rodadas de comparação, e olhar principalmente se os dois números de gravação e leitura de cache no usage batem.
Os seis tipos de cache_miss_reason e onde corrigir
Depois de obter o cache_miss_reason, basta cruzar com a tabela abaixo para saber o que alterar:
| Tipo | Significado | O que alterar |
|---|---|---|
model_changed |
O modelo é diferente do turno anterior — por exemplo, roteamento, teste A/B ou fallback trocaram o modelo. A cache é isolada por modelo | Fixe o modelo durante toda a conversa em cache |
system_changed |
O system mudou. O caso mais comum é ter inserido timestamp, request ID ou outro valor que muda a cada requisição | Transforme o system em uma constante estável byte a byte e mova os dados dinâmicos para a primeira mensagem de user depois do breakpoint |
tools_changed |
Ferramentas foram adicionadas, removidas, tiveram a ordem alterada, ou o resultado da serialização de input_schema não é estável |
Envie a mesma lista de ferramentas em todo turno, com ordem fixa e serialização com chaves ordenadas |
messages_changed |
Mensagens anteriores foram modificadas, reordenadas ou removidas, em vez de apenas anexadas ao final | O histórico só cresce: devolva o conteúdo do assistant e os resultados de ferramentas exatamente como vieram |
previous_message_not_found |
Não foi possível encontrar a impressão digital correspondente — isso não significa que a requisição mudou | Envie diagnostics em todo turno, não atravesse workspaces e não deixe intervalos muito longos entre as chamadas |
unavailable |
Neste turno não foi possível obter o diagnóstico — por exemplo, tool_choice, thinking, context_management, output_config, output_format ou o conjunto de beta headers estão inconsistentes, ou a conversa está longa demais |
Mantenha esses parâmetros inalterados durante todo o ciclo de vida de uma conversa em cache |
Os quatro tipos *_changed também trazem cache_missed_input_tokens, que indica aproximadamente quantos tokens de entrada cacheáveis foram perdidos depois do ponto de divergência. Esse número é calculado a partir do comprimento em bytes, serve apenas para estimar a ordem de grandeza e não é o valor da fatura — às vezes ele é até maior que usage.input_tokens.
Olhar só o diagnostics leva a erro: combine com usage para avaliar o cache hit do Claude
O diagnostics responde a pergunta «minha requisição mudou?», enquanto usage.cache_read_input_tokens responde «o cache foi atingido?». São duas perguntas diferentes, e olhar apenas uma delas facilmente leva a uma conclusão errada.
| Resultado do diagnostics | Tokens lidos do cache | Conclusão | O que fazer |
|---|---|---|---|
null |
Alto | Prefixo estável, cache atingido | Não precisa fazer nada |
null |
Baixo ou 0 | Requisição não mudou, mas o cache já expirou | Encurtar o intervalo entre requisições, ou usar TTL de 1 hora |
*_changed |
Baixo | Requisição mudou, por isso não houve hit | Corrigir conforme a tabela de referência da seção anterior |
*_changed |
Alto | A mudança ocorreu numa posição mais ao final, os breakpoints anteriores ainda atingem | Vale a pena corrigir, mas o impacto é pequeno |
Vale reforçar mais uma vez: null não significa que não funcionou, pode ser justamente o melhor resultado. Há ainda alguns casos em que esta tabela não se aplica: na primeira rodada, cache_miss_reason é null (a comparação ainda está em andamento), além de previous_message_not_found e unavailable. Nesses casos não houve nenhuma comparação válida.
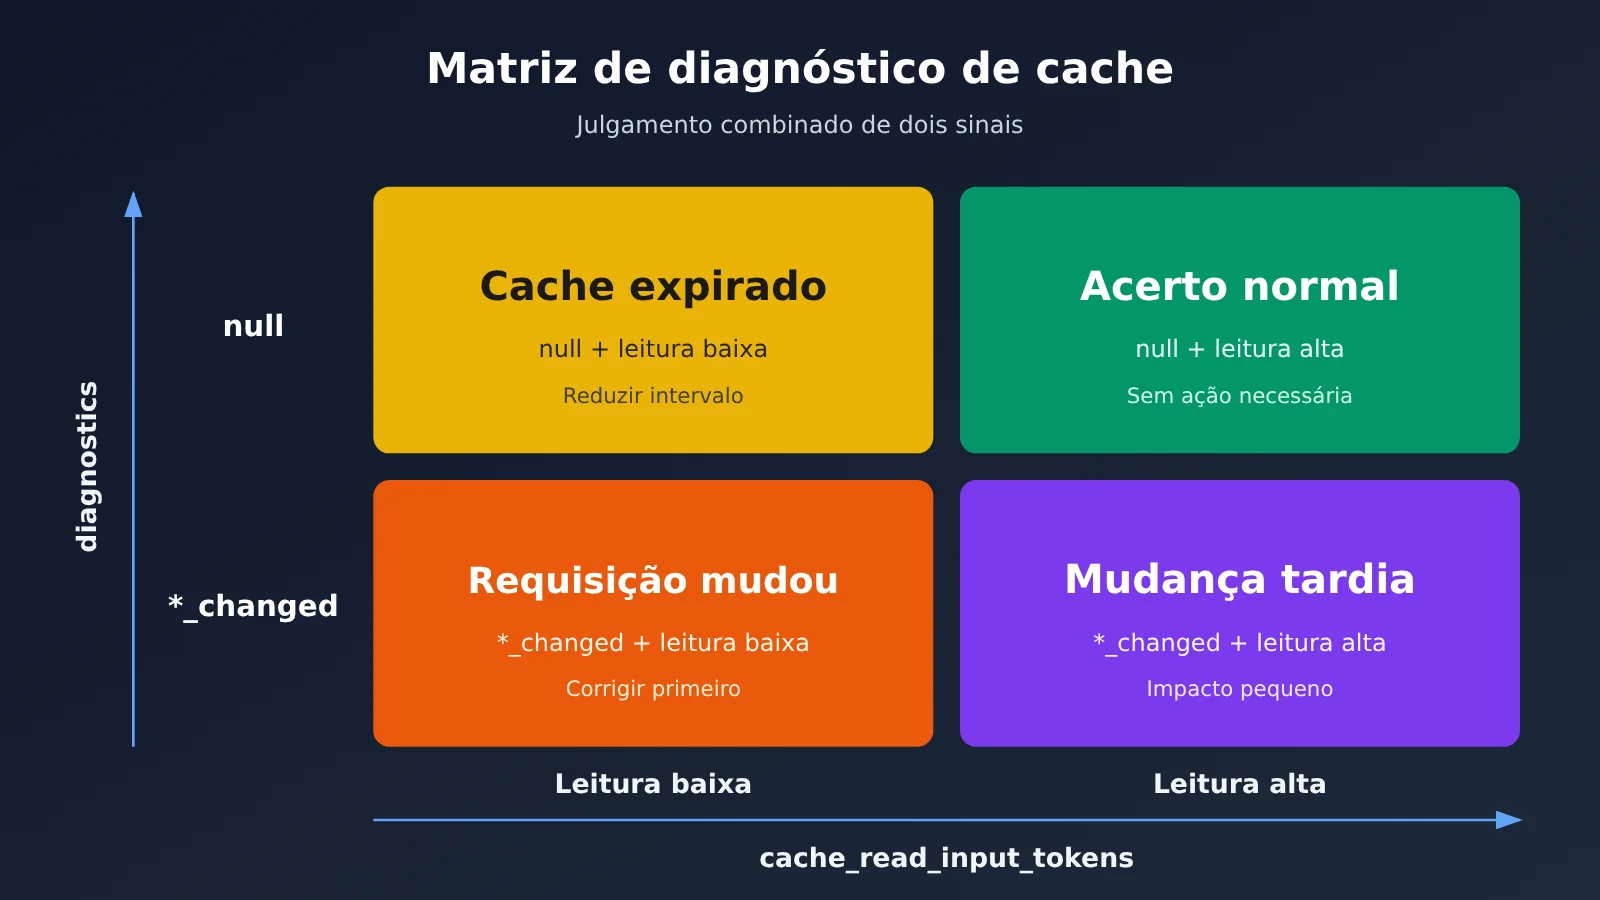
Se você ainda não sabe a qual célula cada rodada pertence, pode enviar a mesma requisição duas vezes seguidas no APIYI apiyi.com, registrar os números de leitura e escrita do cache de cada rodada e depois excluir item por item conforme a matriz acima.
Causas comuns de baixa taxa de acerto de cache no Claude: três condições obrigatórias
Muitas vezes a taxa de acerto baixa não tem nada a ver com a requisição ter mudado — o problema é que o cache nunca foi gravado desde o início. Se faltar qualquer uma das três condições abaixo, o cache simplesmente não entra em ação:
- É preciso marcar o
cache_controlexplicitamente: você pode colocá-lo em um bloco de conteúdo específico para criar um ponto de corte explícito, ou colocar umcache_controlno nível superior da requisição, e aí o sistema marca automaticamente o ponto de corte no último bloco cacheável. Se ocontentfor uma string pura, sem nenhum bloco de conteúdo onde pendurar a marcação, nunca haverá cache. - O comprimento precisa atingir o mínimo cacheável: na API do Claude, tanto o Sonnet 5.5 quanto o Opus 5.5 exigem 512 tokens. Se o prefixo não for longo o suficiente, o cache é ignorado silenciosamente, sem nem retornar erro.
- O prefixo precisa ser idêntico byte a byte: o histórico só cresce no final, e
systemetoolspermanecem estáveis. Qualquer mudança em um espaço, na ordem dos campos do JSON ou em um timestamp faz com que tudo seja tratado como um novo prefixo.
A documentação de cache da APIYI também menciona dois limites rígidos: no máximo 4 pontos de corte cache_control por requisição, e cada ponto de corte só retrocede até os 20 content blocks mais recentes. Em conversas longas de múltiplos turnos, marcar apenas a última mensagem não cobre todo o histórico.
O TTL também costuma passar batido. O padrão é 5 minutos, e cada acerto renova o prazo — mas a contagem começa no momento da requisição que gravou ou leu o cache, não quando a resposta termina. Se uma resposta em streaming levou 4 minutos para sair, a próxima requisição precisa ser enviada em cerca de 1 minuto. Se você precisa de uma janela maior, basta escrever "ttl": "1h" dentro do cache_control.
A conta de custos quando a taxa de acerto do cache do Claude cai a 0
Primeiro, a tabela de preços. Valores em dólares por milhão de tokens, com data de referência 2026-10-25 — vale sempre o preço em tempo real do console:
| Modelo | Entrada | Saída | Leitura de cache | Escrita 5 min | Escrita 1 hora |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | $2.50 | $4 |
| Claude Opus 5.5 | $4 | $20 | $0.20 | $5 | $8 |
| Claude Haiku 5.5 (até 100 mil tokens) | $0.1 | $0.5 | $0.01 | $0.125 | $0.20 |
| Claude Haiku 5.5 (acima de 100 mil tokens) | $0.50 | $2.50 | $0.05 | $0.625 | $1 |
Os multiplicadores precisam ser analisados separadamente. A referência geral do guia de cache da APIYI é: acerto 0.1×, escrita de 5 minutos 1.25×, escrita de 1 hora 2×. O Sonnet 5.5 acompanhou o ajuste oficial em 7 de outubro: a leitura de cache caiu de $0.20 para $0.10, passando a ser 0.05× do preço base de entrada, enquanto o preço de escrita não mudou.
Esse ajuste não foi um corte geral de preços — a leitura de cache do Sonnet 5 continua em $0.20. Então não use 0.1× para calcular o Sonnet 5.5; para modelo e preço específicos, vale a lista de modelos da plataforma.
O ponto de equilíbrio, pela referência geral de 0.1× da plataforma: com TTL de 5 minutos, basta reutilizar duas vezes para empatar (1.25 + 0.1 = 1.35, abaixo de 2.0 sem cache); com TTL de 1 hora, são necessárias três reutilizações (2 + 0.2 = 2.2, abaixo de 3.0).
Agora um exemplo de cálculo. Sonnet 5.5, prefixo fixo de 30 mil tokens, 200 requisições por dia, todas dentro do TTL de 5 minutos:
- Tudo acerta o cache: 200 × 30 mil × $0.10/milhão = $0.60, mais uma escrita de $0.075, total de aproximadamente $0.675/dia
- Nada acerta o cache: 200 × 30 mil × $2/milhão = $12/dia
A diferença na conta do dia inteiro é de cerca de 17.8 vezes — e isso não é a diferença de preço unitário. O preço unitário é $2 contra $0.10, uma diferença de 20 vezes. Se usar TTL de 1 hora, uma escrita custa $0.12 e o preço de acerto não muda. Quando o intervalo entre requisições costuma passar de 5 minutos, vale comparar: o custo extra dessa escrita versus o custo de reconstruir o prefixo repetidamente — qual sai mais barato?
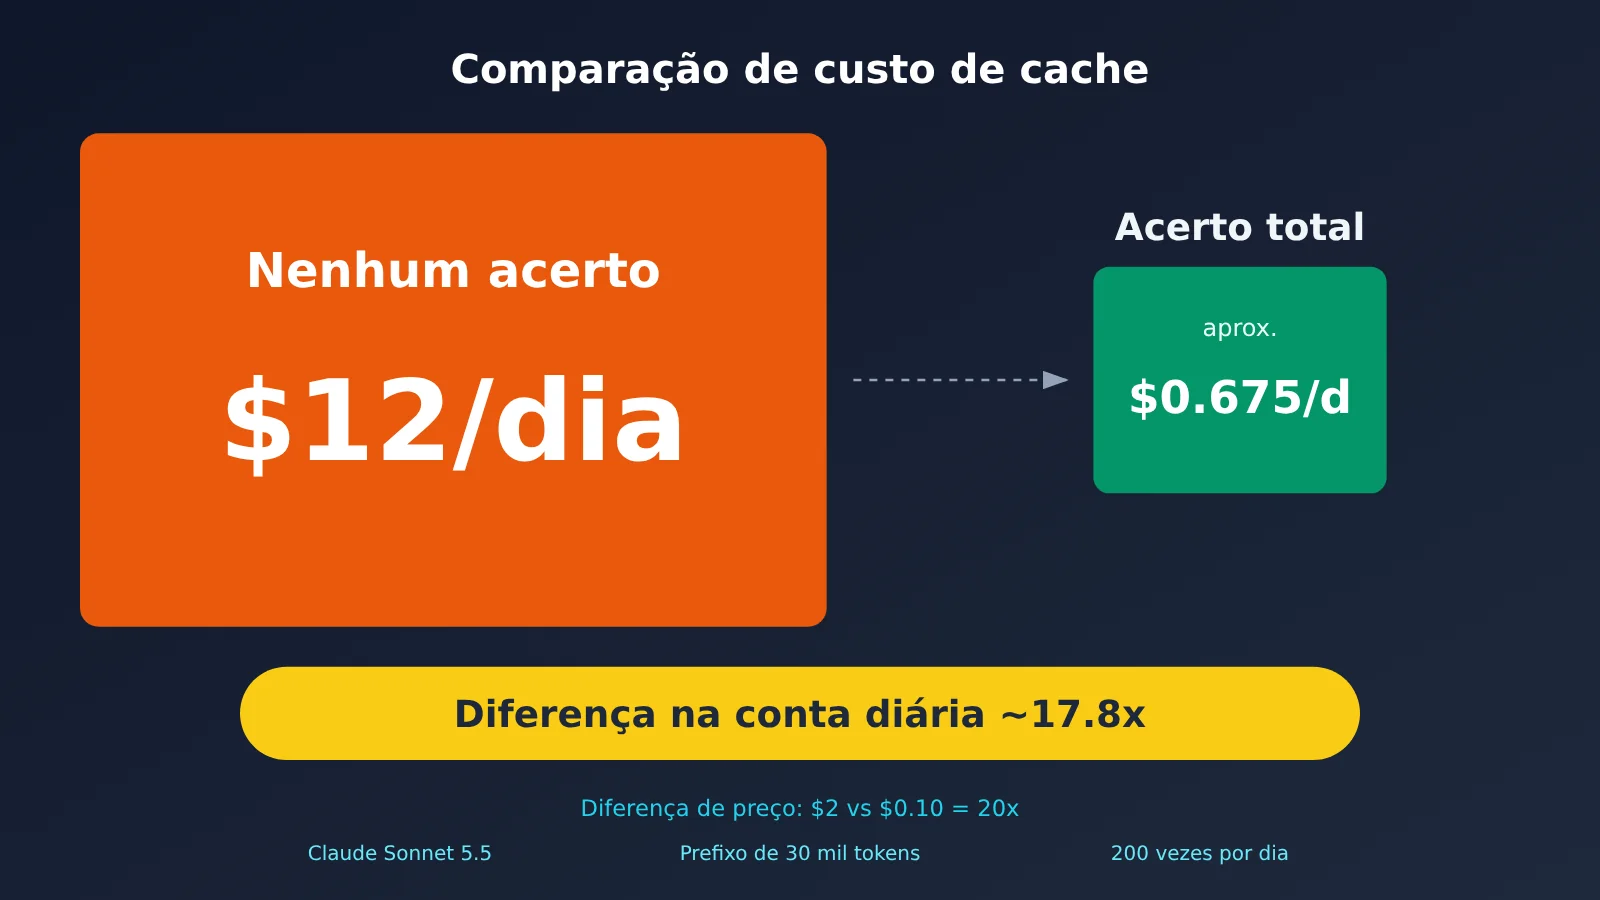
Como investigar a taxa de acerto de cache do Claude ao usar a APIYI
Primeiro, o resultado do teste real. Em 26/10/2026 fizemos um teste na APIYI usando o Claude Sonnet 5.5 em duas rodadas: na primeira, o cache gravou 2523 e leu 0; na segunda, enviando exatamente o mesmo conteúdo, o cache leu 2523 e gravou 0 — os números de tokens batem perfeitamente. O Claude Opus 5.5, com um prefixo longo, também consegue gravar e acertar.
Mas o campo diagnostics não aparece na resposta. Não aparece em chamadas não-streaming, nem no message_start das chamadas streaming. Reenviamos com o beta header e ainda alteramos o system de propósito para forçar um caso real de não-acerto (leitura 0, escrita 2526) — e mesmo assim o campo não veio. Todas as requisições retornaram 200, sem erro. O canal upstream da camada de proxy não é necessariamente o da API oficial do Claude, então nesse cenário o jeito é comparar os dois campos do usage entre si.
| Sintoma na autoverificação | O que significa |
|---|---|
O cache_read_input_tokens desta rodada é exatamente igual ao cache_creation_input_tokens da rodada anterior |
O prefixo foi acertado por completo |
| A leitura desta rodada é bem menor que a escrita da anterior | Só acertou um trecho mais no início; alguma coisa no meio mudou |
| A escrita fica sempre em 0 | Não aplicou a marcação, o tamanho não é suficiente, ou você usou o formato compatível com OpenAI |
| Na segunda rodada volta a escrever e a leitura é 0 | O prefixo mudou; verifique timestamps, UUIDs e a ordem de serialização |
Vale destacar um ponto: o cache só funciona no /v1/messages nativo. Se você chamar o Claude pelo formato compatível com OpenAI, em /v1/chat/completions, não há como obter cobrança de cache, não importa como você passe os parâmetros.
💡 Sugestão de investigação: a APIYI (apiyi.com) repassa o
cache_controlpara o upstream exatamente como você enviou, e devolve os dois campos de cache da resposta sem alteração — seu código não precisa de nenhum ajuste extra por causa da camada de proxy. Basta transformar a regra “leitura desta rodada = escrita da rodada anterior” em um alerta de log para substituir boa parte da verificação manual.
Limitações do diagnóstico de cache (diagnostics) do Claude
O diagnostics não resolve tudo — antes de usar, vale conhecer os limites:
- Só está disponível na API oficial do Claude; as versões hospedadas no Amazon Bedrock e no Google Cloud não oferecem o recurso
- A impressão digital fica retida por pouco tempo, então é preciso enviar requisições em várias rodadas seguidas, com intervalos curtos
- As duas requisições precisam pertencer à mesma organização e ao mesmo workspace; dá para conferir pelo cabeçalho de resposta
anthropic-workspace-id - Em conversas longas, se a mudança estiver escondida bem no fundo da lista de mensagens, pode ser que só retorne
unavailable - É um mecanismo best-effort: se não conseguir o resultado, não bloqueia a requisição nem faz ela falhar
Perguntas frequentes (FAQ)
Q1: Por que o diagnostics fica sempre null?
São três casos possíveis: você não enviou o objeto `diagnostics`; é a primeira rodada e `previous_message_id` está `null`; ou a comparação terminou e não houve divergência. Vale combinar com a leitura do cache: leitura alta indica que está tudo certo, leitura 0 provavelmente significa que o cache expirou. Se estiver passando por um serviço proxy de API, o campo pode simplesmente não voltar na resposta — nesse caso, use o próprio `usage` para se verificar.
Q2: O previous_message_not_found significa que a requisição mudou?
Não. Ele só indica que não foi possível encontrar a impressão digital correspondente. Há três causas comuns: a rodada anterior não levou `diagnostics`, a rodada anterior veio de outro workspace, ou o intervalo foi longo demais. Basta incluir `diagnostics` em todas as rodadas e encurtar o intervalo.
Q3: O diagnóstico gera cobrança extra?
A documentação oficial não lista “taxa de diagnóstico” como um item separado; ele é cobrado junto com as requisições normais de Messages. A documentação também não afirma explicitamente que não há acréscimo, então considere a fatura e o console como referência para a cobrança.
Q4: Dá para usar esse diagnóstico passando por um proxy?
Nos nossos testes na APIYI, não recebemos o campo `diagnostics`, mas a escrita e o acerto do cache funcionaram normalmente. Dá para avaliar pela regra “a leitura desta rodada é exatamente igual à escrita da rodada anterior”; para saber como integrar, consulte a documentação de cobrança de cache da APIYI em apiyi.com.
Q5: Coloquei cache_control e nada foi escrito no cache. Por quê?
Verifique três pontos: o `content` é uma string simples? O prefixo atingiu 512 tokens (Sonnet 5.5 e Opus 5.5)? Você está usando o formato compatível com OpenAI? Se qualquer um dos três não for atendido, o cache é ignorado silenciosamente.
Q6: Se aparecerem vários problemas ao mesmo tempo, qual devo corrigir primeiro?
Corrija primeiro o que o `cache_miss_reason` aponta. Ele só reporta o ponto de divergência mais antigo; depois de corrigir, rode outra vez e os problemas que estavam escondidos atrás vão aparecer. Reenviar a mesma requisição repetidamente na APIYI (apiyi.com) ajuda a eliminar os problemas um por um com bastante agilidade.
Principais pontos do diagnóstico de cache do Claude
- O que é
diagnostics: passe o id da resposta da rodada anterior para localizar o primeiro segmento divergente do prefixo - Como ativar: inclua
diagnosticsno nível superior; na primeira rodada passenull; nas rodadas seguintes, sempre passe - O que significa
null: na primeira rodada ou quando não há divergência, também énull; isso sozinho não pode ser tratado como sinal de falha - Como avaliar: só dá para concluir olhando
diagnosticsjunto comcache_read_input_tokens - Condições obrigatórias: marcar explicitamente, atingir 512 tokens, prefixo idêntico byte a byte
- Diferença de custo: prefixo de 30 mil tokens, 200 vezes por dia, a conta do dia inteiro difere cerca de 17,8 vezes
- Autoverificação no proxy: no APIYI apiyi.com, verifique se a leitura desta rodada é igual à escrita da rodada anterior
Resumo
A investigação da taxa de acerto de cache do Claude pode ser resumida em três coisas:
- Localizar a divergência: inclua
diagnosticsem cada rodada, leiacache_miss_reasone corrija primeiro o ponto reportado mais cedo - Fazer a avaliação cruzada: analise
diagnosticseusagejuntos;nullnão significa que não funcionou - Respeitar as condições obrigatórias: marque corretamente, atinga o comprimento exigido, apenas acrescente ao histórico e mantenha
systemetoolsestáveis
Se sua cadeia de chamadas não consegue obter diagnostics, use os dois campos de usage para montar uma autoverificação. Recomendo validar os números de leitura e escrita do cache no APIYI apiyi.com com duas requisições antes de colocar em produção.
📚 Referências
- Documentação oficial do Claude: Cache diagnostics: campos de diagnóstico, seis tipos e matriz de decisão
- Link:
platform.claude.com -
Descrição: Os campos, a linha do tempo e as limitações do diagnostics deste artigo seguem esta documentação
-
Documentação oficial do Claude: Prompt caching: regras de cache, TTL, comprimento mínimo e preços
- Link:
platform.claude.com -
Descrição: Fonte do comprimento mínimo cacheável e da tabela de preços oficial
-
Lista de modelos da APIYI: preços de entrada, saída e leitura de cache de cada modelo Claude
- Link:
docs.apiyi.com/models -
Descrição: Dados de preços atualizados em 2026-10-25
-
Guia de cobrança de cache do Claude Prompt Caching da APIYI: multiplicadores, ponto de equilíbrio e critérios de autoverificação
- Link:
docs.apiyi.com/api-capabilities/claude-prompt-caching - Descrição: Base para diagnóstico no cenário de serviço proxy de API
Autor: Equipe técnica da APIYI
Contato técnico: Fale com a gente pela página inicial do site da APIYI; mais materiais estão disponíveis no centro de documentação docs.apiyi.com