Nota do autor: um guia prático que explica de uma vez por todas como funciona a cobrança do MiniMax M3.1 Flash, como economizar e se vale mais a pena comprar uma API por uso ou assinar o M Plan.
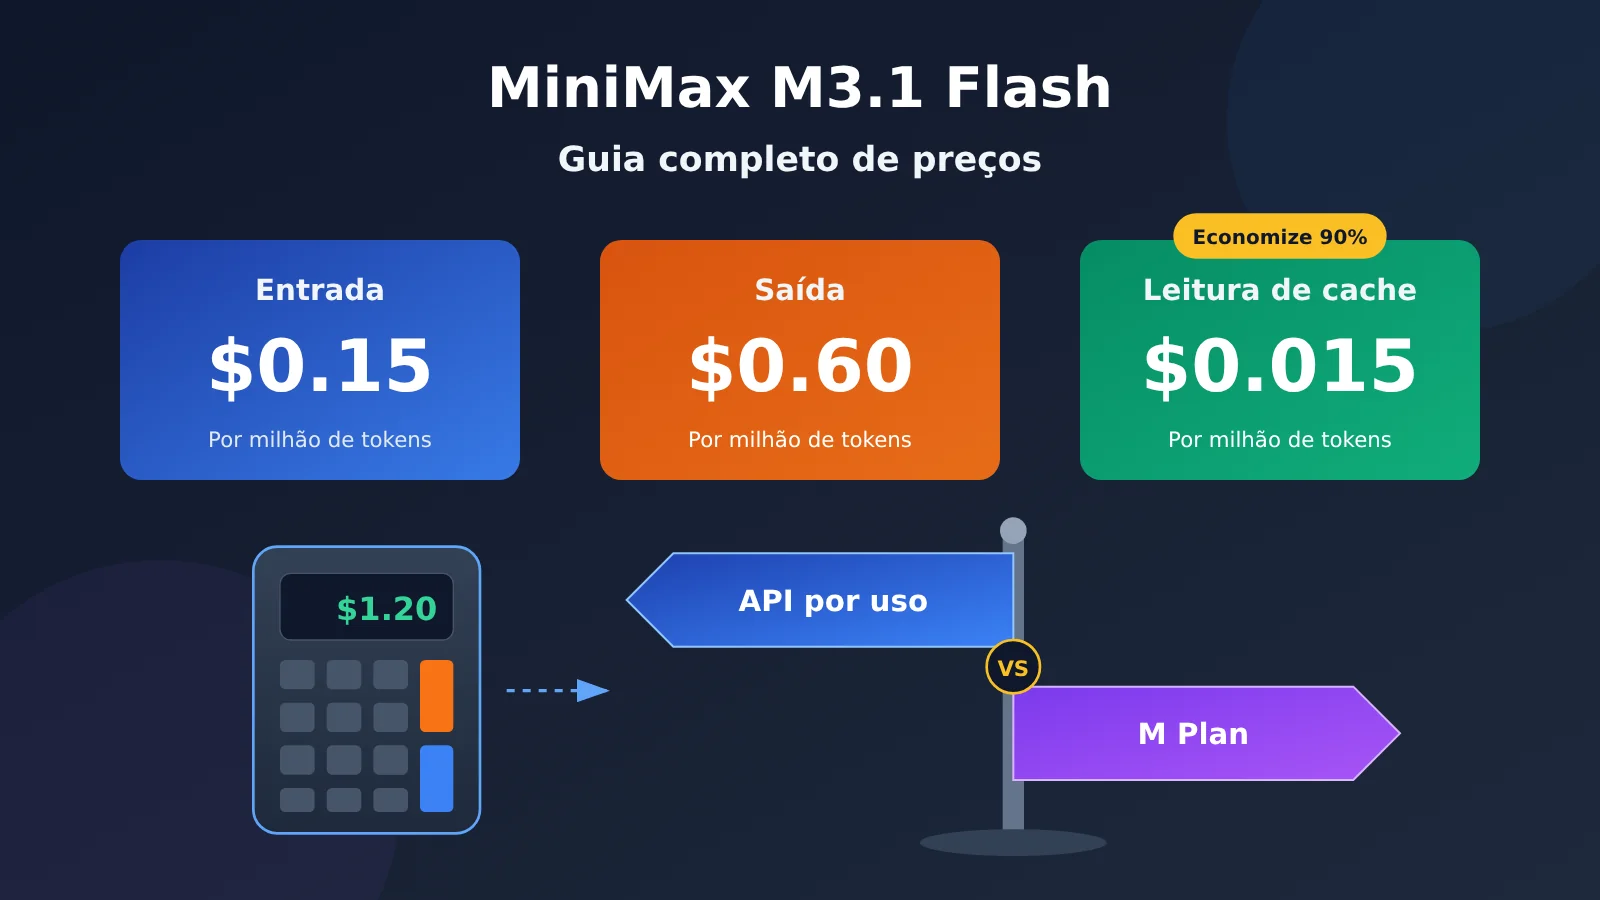
A conclusão para levar com você: o MiniMax M3.1 Flash custa US$ 0,15 por milhão de tokens de entrada, US$ 0,60 por milhão de tokens de saída e US$ 0,015 por milhão de tokens lidos do cache. A maior parte da conta costuma vir da saída (que inclui o processo de raciocínio do modelo). Por isso, há duas formas de economizar: reduzir o nível de esforço ou colocar o conteúdo fixo no início da solicitação, para que ele seja atendido pelo cache.
Este não é mais um artigo sobre o lançamento. Já cobrimos o lançamento aqui no site. Este artigo trata apenas dos custos: quais são os três preços unitários, quanto custa aproximadamente uma conversa ou uma tarefa de agente, onde o M3.1 é mais barato que o M3 e como escolher entre pagar por uso ou assinar um plano mensal.
O principal benefício: ao terminar este artigo, você vai conseguir estimar por conta própria os gastos mensais com o MiniMax M3.1 Flash, evitar as duas armadilhas de cobrança mais comuns e escolher a forma de pagamento mais adequada para você.
Principais pontos sobre os preços do MiniMax M3.1 Flash
Primeiro, vamos explicar um termo: token é a menor unidade usada para cobrar pelo modelo. Dá para pensar nele como um “fragmento de texto”. Segundo a conversão divulgada oficialmente, cerca de 750 palavras em inglês equivalem a 1.000 tokens. A página de preços não informa a proporção para o chinês; por isso, consulte o uso real na fatura do console.
A tabela abaixo mostra todos os preços unitários do MiniMax M3.1 Flash, conforme os valores fixos publicados na página oficial de preços da MiniMax:
| Item de cobrança | Preço (por milhão de tokens) | Em termos simples | Conteúdo típico |
|---|---|---|---|
| Entrada | US$ 0,15 | Tudo o que você envia ao modelo | Comando do sistema, histórico de conversa, documentos enviados, imagens e vídeos |
| Saída | US$ 0,60 | Tudo o que o modelo gera, incluindo o processo de raciocínio | Resposta final e conteúdo de raciocínio (reasoning) |
| Leitura de cache | US$ 0,015 | Parte da entrada repetida em relação a solicitações anteriores e encontrada no cache | Comando do sistema sempre igual e documentos longos citados várias vezes |
| Adicional: web_search | US$ 0,01 por chamada | Ferramenta de busca na internet executada no servidor, cobrada por chamada | Busca acionada por um agente |
Há dois pontos importantes para lembrar. Primeiro, o preço da saída é 4 vezes o da entrada. Por isso, “quanto o modelo fala” afeta mais a fatura do que “quanto você envia”. Segundo, a leitura de cache custa apenas 1/10 do preço da entrada — ou seja, a parte da entrada encontrada no cache tem um desconto de 90%.
Como entender a fórmula de cobrança do MiniMax M3.1 Flash
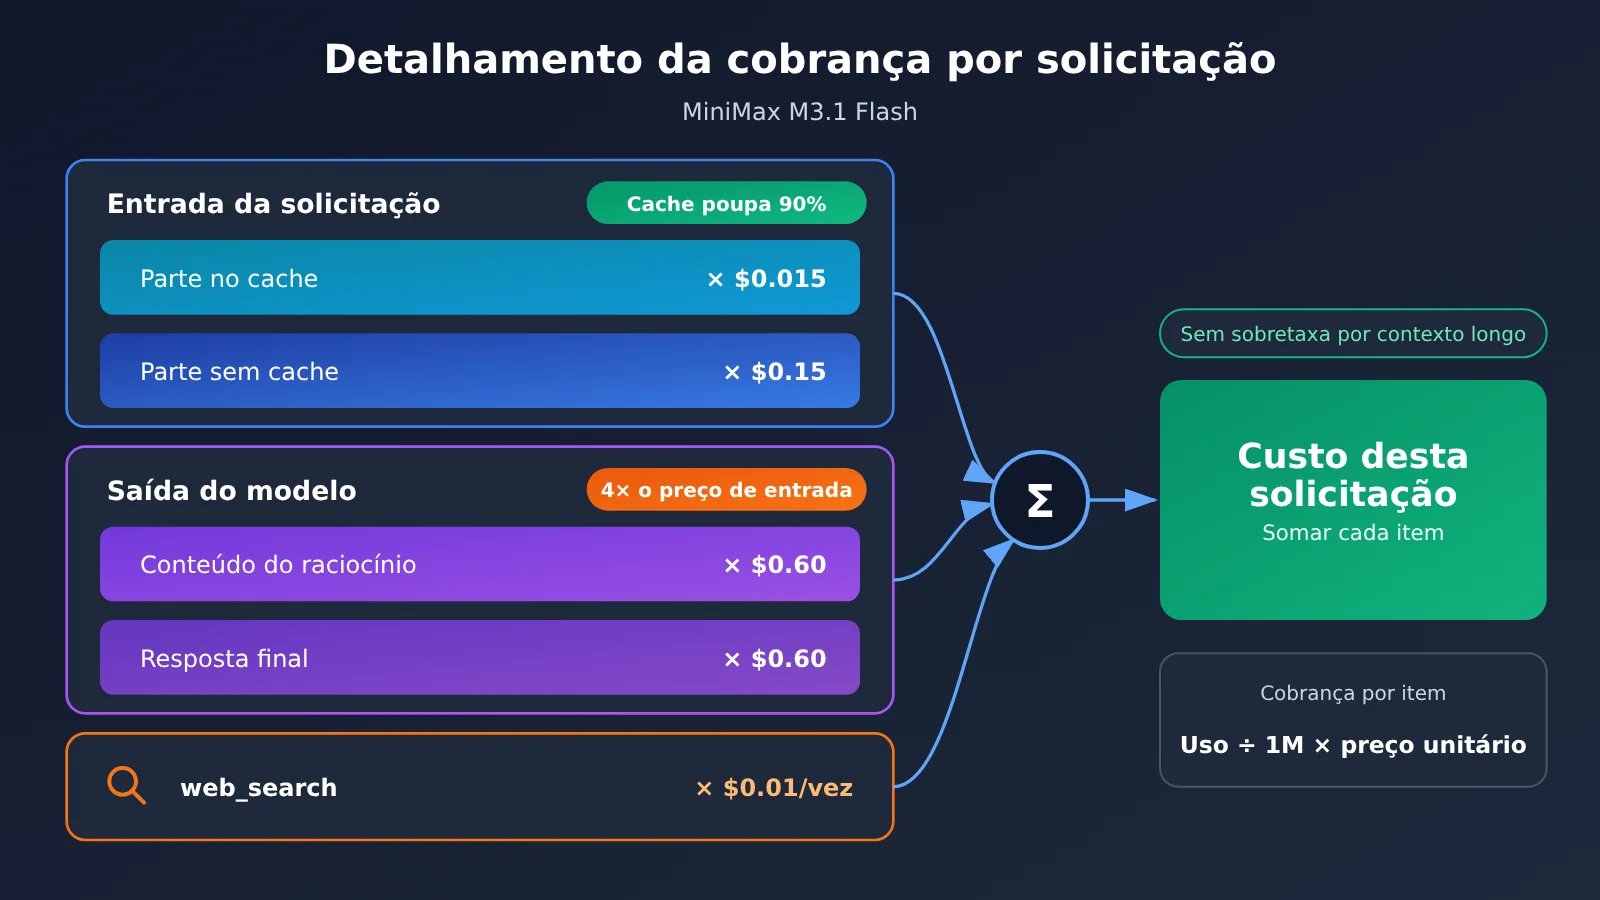
O cálculo oficial é bem simples: custo = uso ÷ 1.000.000 × preço unitário. Cada item de cobrança é calculado separadamente; depois, os valores são somados e descontados do saldo da conta.
A fatura de uma solicitação pode ser dividida em três partes: entrada encontrada no cache × US$ 0,015, entrada não encontrada no cache × US$ 0,15 e saída (resposta + raciocínio) × US$ 0,60. Por fim, soma-se o número de chamadas de busca × US$ 0,01.
Além disso, a janela de contexto do MiniMax M3.1 Flash é de 1.000.000 de tokens. A janela de contexto é o volume máximo de conteúdo que o modelo consegue “ver” de uma vez. A página oficial de preços informa claramente que não há cobrança adicional por contexto longo: tanto faz incluir 100 mil ou 800 mil tokens, o preço unitário é o mesmo.
Calculando os custos do MiniMax M3.1 Flash: 3 exemplos
O número de tokens nos três exemplos abaixo é hipotético e serve apenas para demonstrar o cálculo. Não são dados medidos. Você pode substituir pelos seus próprios números e fazer as contas da mesma forma.
Exemplo 1: uma conversa comum
Suponha: 2.000 tokens de entrada (sem acerto no cache) e 1.500 tokens de saída (incluindo o raciocínio).
- Entrada: 2.000 ÷ 1.000.000 × US$ 0,15 = US$ 0,0003
- Saída: 1.500 ÷ 1.000.000 × US$ 0,60 = US$ 0,0009
- Total: US$ 0,0003 + US$ 0,0009 = US$ 0,0012
Conferindo: em 1.000 conversas desse tipo, o uso seria de 2 milhões de tokens de entrada e 1,5 milhão de tokens de saída. 2 × US$ 0,15 + 1,5 × US$ 0,60 = US$ 0,30 + US$ 0,90 = US$ 1,20, o mesmo que US$ 0,0012 × 1.000.
Exemplo 2: uma tarefa de agente (várias rodadas)
Um agente é um modelo que divide uma tarefa em etapas, aciona ferramentas e trabalha em várias rodadas até concluí-la. Como ele precisa reenviar o contexto anterior a cada rodada, o volume de entrada é alto — e é aí que o cache faz mais diferença.
Suponha: 20 rodadas no total, com 30.000 tokens de entrada por rodada. Desses, 25.000 têm acerto no cache e 5.000 são conteúdo novo. Cada rodada gera 2.000 tokens de saída.
- Leitura do cache: 25.000 × 20 = 500.000 tokens, 0,5 × US$ 0,015 = US$ 0,0075
- Nova entrada: 5.000 × 20 = 100.000 tokens, 0,1 × US$ 0,15 = US$ 0,015
- Saída: 2.000 × 20 = 40.000 tokens, 0,04 × US$ 0,60 = US$ 0,024
- Total: US$ 0,0075 + US$ 0,015 + US$ 0,024 = US$ 0,0465
Para comparar: sem nenhum acerto no cache, os 600.000 tokens de entrada custariam 0,6 × US$ 0,15 = US$ 0,09. Somando os US$ 0,024 da saída, o total seria US$ 0,114. O cache economizou US$ 0,114 − US$ 0,0465 = US$ 0,0675 nessa tarefa, ou cerca de 59%.
Exemplo 3: 1.000 chamadas em lote por dia
Suponha: cada chamada inclui 1.000 tokens de comando do sistema fixo (com acerto no cache), 500 tokens de conteúdo novo e 1.000 tokens de saída.
- Leitura do cache: 1.000 × 1.000 = 1 milhão de tokens, 1 × US$ 0,015 = US$ 0,015
- Nova entrada: 500 × 1.000 = 500.000 tokens, 0,5 × US$ 0,15 = US$ 0,075
- Saída: 1.000 × 1.000 = 1 milhão de tokens, 1 × US$ 0,60 = US$ 0,60
- Total diário: US$ 0,015 + US$ 0,075 + US$ 0,60 = US$ 0,69; em 30 dias, cerca de US$ 20,70 por mês
Se você definir um nível de esforço alto e a saída passar a 3.000 tokens por chamada (também uma hipótese), o custo da saída sobe para 3 × US$ 0,60 = US$ 1,80, e o total diário chega a US$ 1,89. Os custos de entrada e do cache não mudam, mas a conta fica quase 2,7 vezes maior (US$ 1,89 ÷ US$ 0,69 ≈ 2,74). Isso mostra que a saída é o principal custo em tarefas em lote.
🚀 Dica para começar: faça primeiro um teste com um pequeno lote de dados reais. Anote a média de tokens de entrada, o volume com acerto no cache e os tokens de saída. Depois, use esses valores na fórmula acima para estimar o custo mensal — é bem mais preciso do que chutar. Se também quiser comparar os custos de modelos como MiniMax-M3 e Claude, você pode alternar entre eles usando a mesma chave na APIYI, em apiyi.com.
Duas armadilhas de cobrança fáceis de encontrar no MiniMax M3.1 Flash
Armadilha 1: não dá para desativar o raciocínio, e o nível de effort define a conta
effort é o parâmetro de “profundidade do raciocínio”: quanto mais alto o nível, mais o modelo pensa. O MiniMax M3.1 Flash tem uma configuração diferente da de muitos modelos: não é possível desativar o raciocínio. A documentação oficial informa que enviar thinking disabled ou effort none retorna diretamente um erro 400, com a mensagem de que o modelo “MiniMax-M3.1-Flash” requires adaptive thinking.
O conteúdo do raciocínio é cobrado como saída e, se você não enviar effort, o padrão é max, ou seja, o nível mais caro. Para economizar, a única opção é reduzir o nível manualmente. O nome do campo varia conforme o protocolo: no protocolo Anthropic, use output_config.effort; no protocolo OpenAI, reasoning_effort; e no protocolo Responses, reasoning.effort.
| Nível de effort | Volume de raciocínio | Impacto na conta | Cenários recomendados |
|---|---|---|---|
| low | Mínimo | Menor volume de saída, mais econômico e com menor latência | Classificação, extração, reescrita e conversão de formato |
| medium | Baixo | Mais econômico | Perguntas e respostas do dia a dia, resumos simples |
| high | Maior | Mais caro | Programação em geral, raciocínio em várias etapas |
| xhigh | Muito alto | Caro | Análises complexas, depuração de problemas difíceis |
| max (padrão) | Máximo | Mais caro e com maior latência | Tarefas realmente difíceis, agentes com fluxos longos |
A documentação oficial não informa quantos tokens a mais, em média, cada nível consome. A tabela acima indica apenas a diferença relativa entre eles. Também vale saber que as avaliações oficiais e os testes de terceiros da Vals usaram níveis altos (a Vals especifica claramente effort max). No momento, não há dados públicos sobre quanto o desempenho cai ao reduzir o nível. A recomendação é começar com low ou medium em uma amostra de tarefas e aumentar o nível se os resultados não forem bons o suficiente.
Outra mudança: agora o conteúdo do raciocínio é retornado separadamente. No protocolo compatível com OpenAI, ele fica no campo reasoning_content, enquanto content contém apenas a resposta final. Se você costumava extrair o conteúdo das tags de raciocínio na saída do M3, será necessário ajustar essa lógica de análise.
Armadilha 2: a leitura em cache custa apenas 1/10 do preço de entrada, mas a ordem do conteúdo faz diferença
O cache funciona assim: quando o sistema reconhece uma parte da solicitação que é exatamente igual à de uma solicitação anterior, cobra por ela o preço de leitura em cache. O valor é de US$ 0,015, 90% abaixo dos US$ 0,15.
Para aumentar as chances de aproveitar o cache, o segredo é manter o início da solicitação sempre igual:
- Coloque o comando de sistema fixo no começo e não inclua nele carimbos de data e hora, números aleatórios ou nomes de usuário.
- Logo depois do comando de sistema, inclua conteúdos reutilizados com frequência, como documentos longos, bases de conhecimento e instruções de ferramentas.
- Deixe para o final o conteúdo que muda a cada solicitação, como a pergunta do usuário e os dados da rodada atual.
- Em conversas com várias rodadas, evite apagar ou alterar o histórico anterior sem necessidade. Se você mudar um trecho no meio, será difícil aproveitar o cache para o conteúdo seguinte.
A documentação informa apenas o preço da leitura em cache. Para conhecer as regras específicas do cache e outras informações de cobrança relacionadas, consulte a página oficial de preços da MiniMax.
Comparação de preços entre MiniMax M3.1 Flash e M3
Muita gente pergunta quanto o MiniMax M3.1 Flash custa a menos que a geração anterior, o M3. A tabela abaixo usa os preços da página oficial. Para o M3, consideramos a tarifa padrão com desconto permanente de 50% (por milhão de tokens):
| Modelo | Entrada | Saída | Leitura de cache | Acréscimo por contexto longo |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 | $0.60 | $0.015 | Nenhum |
| MiniMax-M3 (entrada ≤512K) | $0.30 | $1.20 | $0.06 | — |
| MiniMax-M3 (entrada >512K) | $0.60 | $2.40 | $0.12 | Preço unitário dobrado |
| MiniMax-M3 Priority | Tarifa padrão × 1.5 | Tarifa padrão × 1.5 | — | — |
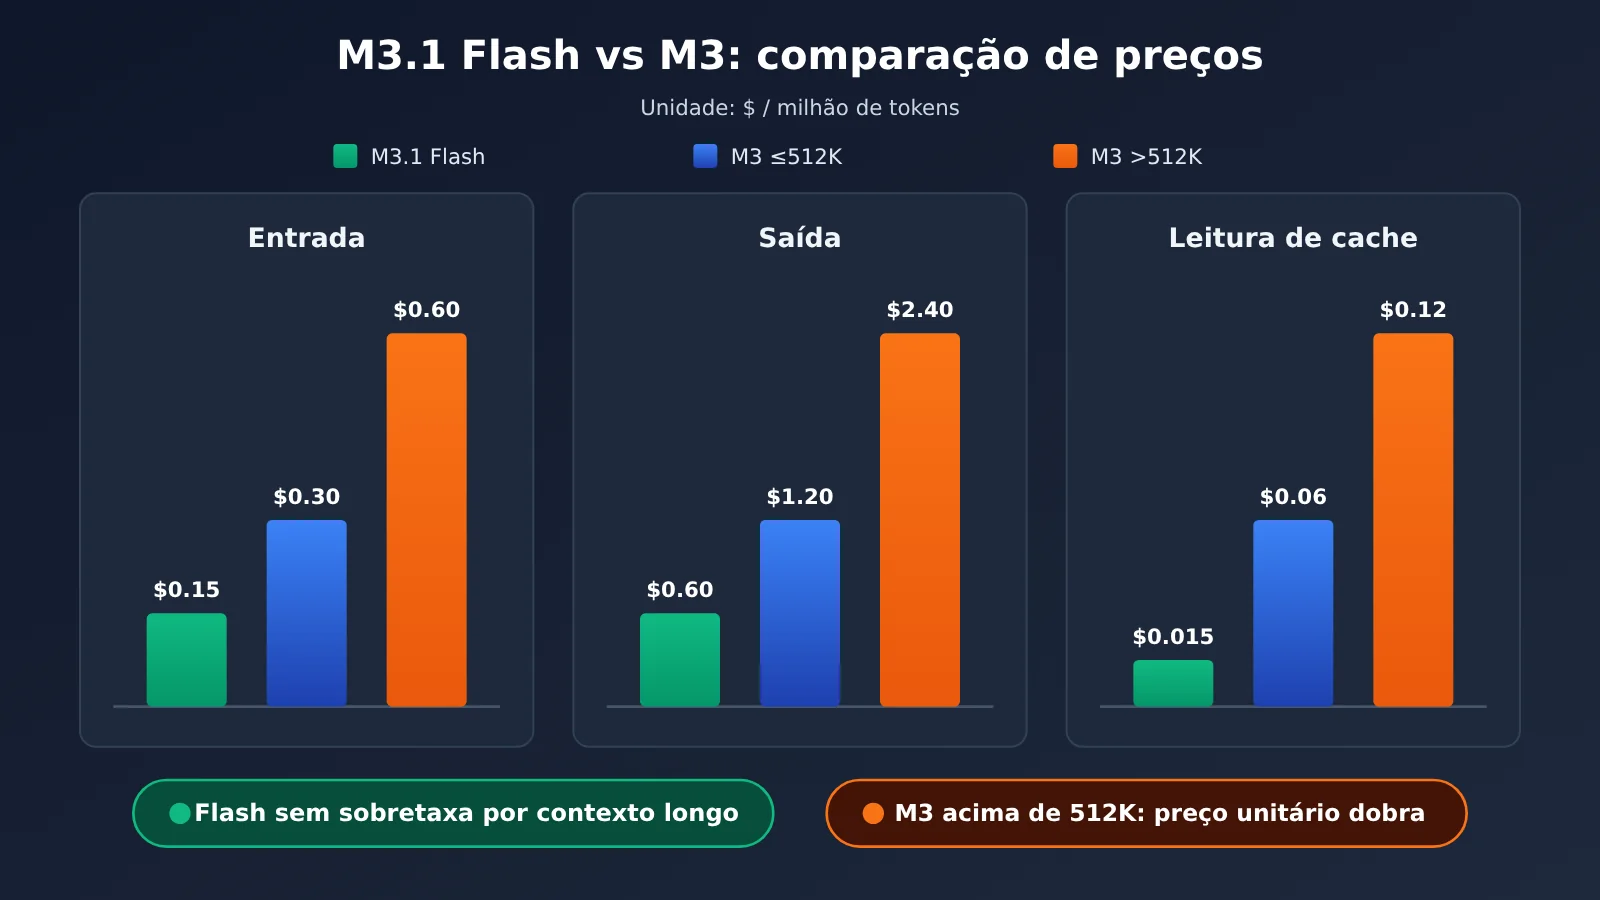
Legenda: os preços são da página oficial do MiniMax. A cobrança efetiva em plataformas de terceiros depende dos preços informados por cada uma. Por exemplo, ao chamar a série MiniMax pela APIYI (apiyi.com), consulte os valores exibidos na página de preços da plataforma.
A tabela mostra três diferenças:
- Contexto comum: os preços unitários de entrada e saída do Flash são metade dos valores do M3, e a leitura de cache custa apenas 1/4 ($0.015 contra $0.06). Vamos conferir com o caso de uso 3: com o mesmo volume, o custo diário no M3 é 1 × $0.06 + 0.5 × $0.30 + 1 × $1.20 = $1.41. No Flash, fica em $0.69, cerca de 49% desse valor.
- Contexto muito longo: quando a entrada ultrapassa 512K, o preço unitário do M3 dobra, enquanto o Flash não cobra adicional. Nesse caso, os preços de entrada e saída do Flash são apenas 1/4 dos valores do M3.
- Cache mais vantajoso: no Flash, a leitura de cache custa 1/10 do preço de entrada; no M3, custa 1/5. Por isso, quanto mais o cenário depender de cache, maior será a vantagem do Flash.
Se o preço unitário cai pela metade, por que a divulgação oficial fala em “1/3 do custo”?
As duas afirmações não se contradizem. Preço unitário pela metade é o valor por token. Já 1/3 do custo (em uma publicação oficial no X) e “redução de 70% no custo total de tarefas de agente” (no blog oficial) se referem ao gasto total para concluir uma tarefa. Ambos os números são declarações da própria empresa.
Custo total para concluir uma tarefa = preço unitário × quantidade de tokens usados. Se o novo modelo conclui a mesma tarefa com menos etapas ou tokens, o custo da tarefa pode cair mais do que o preço unitário. Mas a empresa não divulgou o cálculo detalhado que resulta em 1/3. Além disso, o número do Automation-Bench no gráfico oficial (62.8) não bate com o valor da tabela (62.2). Por isso, para fazer seu orçamento, o ideal é calcular com base nos preços unitários e tratar o “1/3” como uma referência.
Como escolher entre a API por uso do MiniMax M3.1 Flash e a assinatura M Plan
O MiniMax M3.1 Flash tem duas formas de pagamento. Com a API por uso, você paga pelo que consome, com descontos no saldo da conta. Já o M Plan é uma assinatura mensal com três opções: Go, Explore e Build. Todas incluem o modelo de texto M3.1 Flash. Segundo a documentação oficial, o limite de uso do Explore é 3 vezes o do Go, e o do Build é 7,5 vezes o do Go. Além disso, os planos Explore e Build incluem o modelo de vídeo H3. Os valores mensais de cada plano devem ser consultados no site oficial. Também há um anúncio oficial de desconto no primeiro mês para pagamentos mensais; os detalhes da promoção devem ser conferidos no site.
| Critério | Escolha a API por uso | Escolha a assinatura M Plan |
|---|---|---|
| Quanto você usa | O uso é irregular ou baixo no geral | Você usa com frequência todos os dias e quer um gasto mensal fixo |
| Onde você usa | No back-end do seu produto, em scripts em lote ou no processamento de dados | Para escrever código e contar com assistência de IA no dia a dia |
| Quais ferramentas usa | Programas próprios, com chamadas diretas pelo endereço da API | MiniMax Code, Claude Code, Codex, Cursor, OpenCode |
| Precisa de vídeo? | O custo é calculado à parte, conforme o uso | Os planos Explore e Build incluem o modelo de vídeo H3 |
| Controle de custos | Dá para controlar o custo de cada solicitação e otimizar com precisão o parâmetro effort e o cache |
Não é preciso calcular tokens; as regras para uso acima do limite do plano devem ser consultadas no site oficial |
Em resumo: se for para um programa, escolha a cobrança por uso; se for para você, escolha a assinatura. Se você costuma programar em ferramentas como Claude Code ou Cursor, pode conectar diretamente a chave da assinatura M Plan. Se está desenvolvendo um produto ou executando tarefas em lote, a API por uso oferece mais transparência e permite aplicar os métodos de cálculo de custos deste artigo.
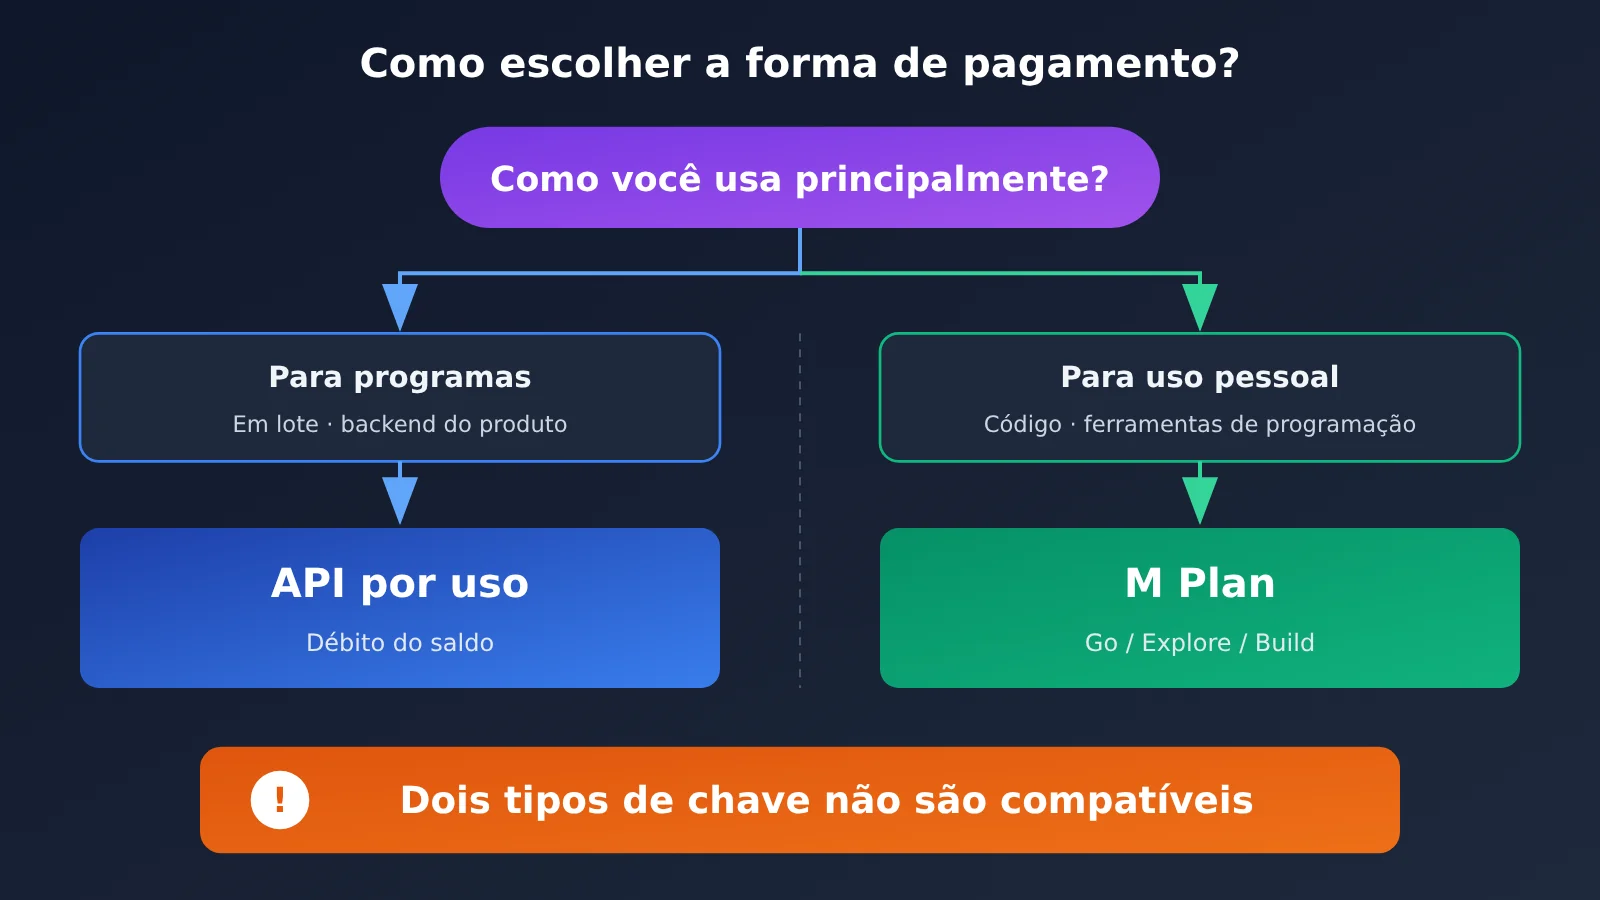
⚠️ Importante: as duas chaves não são intercambiáveis. O FAQ oficial explica que a chave API de cobrança por uso e a chave de assinatura do M Plan são diferentes e ficam em áreas distintas do painel. Usar a chave de assinatura para chamar uma API de cobrança por uso, ou vice-versa, vai causar problemas. Antes de configurar, confira se você copiou a chave correta. Além disso, o nome antigo do modelo, MiniMax-M3.1-Flash-Preview, foi descontinuado. As solicitações enviadas com esse nome agora são processadas pelo MiniMax-M3.1-Flash.
Quando não usar o MiniMax M3.1 Flash
Ser barato não significa que ele seja adequado para qualquer tarefa. Nos casos abaixo, é melhor não migrar ainda ou fazer a migração apenas em parte.
1. Agentes com fluxos longos e tarefas que envolvem operações no terminal. Uma avaliação de terceiros da Vals AI mostra que o M3.1 Flash obteve 25,25% no Terminal-Bench 4.0, ficando em 22º lugar entre 51 modelos. No HLAB-Vals-1.1, fez 7,50%, ocupando a 17ª posição entre 23 modelos. Nos dados divulgados pela própria empresa, o resultado no Terminal Bench 4.0 foi 38,1, também 13,7 pontos abaixo dos 51,8 do Claude Opus 5.
2. Grandes refatorações de código. Segundo dados divulgados pela própria empresa, o resultado no SWE Refactor Bench foi 23,0, enquanto o Claude Opus 5 fez 31,0.
3. Quando você precisa desativar o modo de raciocínio e busca latência muito baixa. Não é possível desativar o raciocínio; o nível mínimo disponível é low.
4. Quando as integrações atuais dependem da análise das tags de raciocínio. Se você estiver migrando do M3, ajuste primeiro a lógica de análise. Caso contrário, o conteúdo do raciocínio não será recuperado.
5. Se você quer usar o modelo na APIYI agora mesmo. Até a data de publicação, o MiniMax-M3.1-Flash ainda não aparecia na página de preços da APIYI. Consulte essa página para confirmar se o modelo está disponível para uso.
Agora, uma comparação com o Claude. A tabela de comparação oficial usa o Claude Opus 5 como referência, não o Opus 5.5. O Claude Opus 5.5 continua sendo o modelo mais avançado da Anthropic, e a MiniMax não o comparou item por item. Portanto, não dá para afirmar que o Flash alcançou ou superou o Opus 5.5. No ranking geral, o Vals Index coloca o M3.1 Flash em 15º lugar entre 22 modelos (53,78%) e em 5º entre os modelos com pesos abertos.
| Modelo | Entrada / saída (por milhão de tokens) | Comparação de benchmarks | Mais indicado para | Canais de acesso |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | US$ 0,15 / US$ 0,60 | Dados divulgados pela empresa + avaliação da Vals | Processamento em lote, programação do dia a dia e uso de ferramentas | Site oficial da MiniMax; disponibilidade na APIYI sujeita à página de preços |
| claude-opus-5 | US$ 5 / US$ 25 (preço oficial) | Modelo usado como referência na tabela oficial | Tarefas complexas | APIYI, apiyi.com etc. |
| claude-opus-5-5 | US$ 4 / US$ 20 (preço oficial) | Não foi comparado oficialmente | Planejamento complexo, design de arquitetura e grandes refatorações | APIYI, apiyi.com etc. |
Pelo preço unitário, a saída do Opus 5.5 custa cerca de 33 vezes mais que a do Flash (US$ 20 ÷ US$ 0,60 ≈ 33,3), e a entrada custa cerca de 27 vezes mais (US$ 4 ÷ US$ 0,15 ≈ 26,7). Com uma diferença tão grande, o mais sensato é dividir as tarefas entre os modelos, em vez de escolher apenas um.
Como combinar MiniMax e Claude Opus 5.5 na APIYI
Em 22 de outubro de 2026, os modelos MiniMax disponíveis diretamente na página de preços da APIYI são MiniMax-M3 (compatível com os formatos de API da OpenAI e da Anthropic, além de disponível no grupo ClaudeCode), MiniMax-M2.7, MiniMax-M2.7-highspeed, MiniMax-M2.5, MiniMax-M2.5-lightning e o modelo de vídeo MiniMax-H3. O MiniMax-M3.1-Flash ainda não aparece na página de preços. Para saber se ele pode ser chamado, consulte a página de preços da APIYI.
Do lado da Claude, claude-opus-5-5 e claude-opus-5 podem ser chamados diretamente. A vantagem da APIYI é usar uma única chave para chamar tanto a série MiniMax quanto o Claude Opus 5.5, sem precisar se cadastrar e adicionar créditos em serviços diferentes. Uma divisão de tarefas recomendada seria:
- Deixe os trabalhos em lote mais baratos com a MiniMax: limpeza de dados, classificação de conteúdo, reescrita em lote e geração de código simples. Use modelos com boa relação custo-benefício, como o MiniMax-M3, junto com cache e níveis de raciocínio mais baixos.
- Deixe o planejamento complexo e as grandes refatorações com o Opus 5.5: arquitetura de sistemas, grandes refatorações que envolvem vários módulos e planejamento geral de tarefas longas. Para isso, use
claude-opus-5-5. - Planeje primeiro e execute depois: peça ao Opus 5.5 para elaborar um plano e dividir o trabalho em tarefas. Em seguida, delegue as tarefas menores à MiniMax para execução em lote, equilibrando qualidade e custo.
💡 Sugestão: se ainda não souber quais tarefas podem ser delegadas a um modelo mais barato, use a APIYI em apiyi.com para testar a mesma amostra com o MiniMax-M3 e o
claude-opus-5-5. Compare os resultados e os custos antes de definir a proporção de tarefas para cada um.
Perguntas frequentes
P1: Afinal, quanto custa o MiniMax M3.1 Flash?
De acordo com a página oficial de preços, o custo é de US$ 0,15 por milhão de tokens de entrada, US$ 0,60 por milhão de tokens de saída e US$ 0,015 por milhão de tokens de leitura do cache. Os preços são fixos, sem cobrança adicional por contexto longo. A busca na web do lado do servidor, `web_search`, custa mais US$ 0,01 por chamada.
P2: Por que a saída tem tantos tokens se fiz só uma pergunta?
Porque o processo de raciocínio também conta como saída. Além disso, se você não definir o parâmetro `effort`, o padrão será `max`. Não é possível desativar o raciocínio; para reduzir a quantidade de tokens de saída, ajuste `effort` para `low` ou `medium`.
P3: Quanto o MiniMax M3.1 Flash custa a menos que o M3?
O preço unitário de entrada e saída corresponde à metade do preço padrão do M3; o de leitura do cache equivale a um quarto. Quando a entrada ultrapassa 512K tokens, o preço unitário do M3 dobra, enquanto o do Flash não aumenta. O “custo de 1/3” divulgado oficialmente é um dado da própria empresa, calculado por tarefa. O método de cálculo não foi divulgado.
P4: Posso usar diretamente uma chave API de pagamento por uso no Claude Code com o M Plan?
Não. A chave API de pagamento por uso e a chave de assinatura do M Plan são diferentes. Elas são obtidas em áreas distintas do painel e não podem ser usadas uma no lugar da outra. Para conectar ferramentas usando a assinatura, copie a chave de assinatura.
P5: Já dá para usar o MiniMax M3.1 Flash pela APIYI?
Até a publicação deste artigo, o MiniMax-M3.1-Flash ainda não aparecia na página de preços da APIYI. Consulte essa página para saber se o modelo está disponível; vamos adicioná-lo o mais rápido possível. No momento, você pode usar diretamente modelos como MiniMax-M3 e claude-opus-5-5 na APIYI, em apiyi.com, e alternar entre eles com uma única chave.
P6: Existe alguma forma de testar grátis?
A plataforma de terceiros OpenRouter oferece um endpoint gratuito com limite de uso: `minimax/minimax-m3.1-flash:free`. É uma boa opção para experimentar o modelo. Para uso em produção, recomendamos estimar os custos com um pequeno conjunto de dados, seguindo o método deste artigo.
P7: Quais são os pontos fracos do MiniMax M3.1 Flash?
Avaliações de terceiros indicam que ele tem desempenho abaixo da média em tarefas de Agent com cadeias longas e em tarefas de terminal — ficou em 22º lugar entre 51 modelos no Vals Terminal-Bench 4.0. Nos testes de refatoração divulgados pela própria empresa, também ficou atrás do Claude Opus 5. Além disso, a MiniMax ainda não publicou um relatório técnico explicando o que mudou no Flash.
P8: O que devo fazer primeiro para gastar menos?
Primeiro, reduza o `effort`, que vem definido como `max`. Depois, coloque o comando fixo do sistema e os documentos longos no início da requisição para aproveitar o cache. Em geral, essas duas medidas trazem resultados mais imediatos do que trocar de modelo. Se quiser comparar os custos de vários modelos ao mesmo tempo, você pode fazer os testes pela APIYI, em apiyi.com.
MiniMax M3.1 Flash: principais pontos sobre preços
- Três preços por milhão de tokens: US$ 0,15 para entrada, US$ 0,60 para saída e US$ 0,015 para leitura de cache. Não há cobrança extra por contexto longo.
- A saída concentra a maior parte da conta: os tokens de raciocínio são cobrados como saída. O nível
max, usado por padrão, é o mais caro; para economizar, comece reduzindo oeffort. - Não dá para desativar o raciocínio: enviar
disabledounonegera um erro 400. O nível mínimo disponível élow. - O cache reduz o custo em 90%: coloque o conteúdo fixo no início e o conteúdo variável no final.
- O preço unitário é metade do preço do M3: a afirmação de “custo de 1/3” usa uma métrica oficial baseada em tarefas. As duas comparações não se contradizem.
- API por uso para programas; assinatura para pessoas: as chaves dos dois formatos não são compatíveis. Consulte o site oficial para ver o preço mensal do M Plan.
- Combinar modelos pode sair mais em conta: na APIYI, use uma única chave para deixar o MiniMax cuidar do processamento em lote e o Opus 5.5 do planejamento.
Resumo
Os principais pontos sobre os preços do MiniMax M3.1 Flash:
- Saiba calcular: custo = uso ÷ 1 milhão × preço unitário. Calcule entrada, leitura de cache e saída separadamente e depois some os valores.
- Saiba economizar: reduza o
effortpara controlar a quantidade de tokens de raciocínio e coloque o conteúdo fixo no início para aproveitar melhor o cache. - Saiba escolher: para programas, escolha a API por uso; para uso pessoal, escolha o M Plan. Para agentes com fluxos longos e grandes refatorações, ainda vale recorrer a modelos mais potentes.
Recomendamos começar com um pequeno lote de dados reais para calcular seu custo por execução e, então, decidir o formato de pagamento e como dividir as tarefas. Se quiser comparar o desempenho e os custos de vários modelos, recomendamos fazer os testes pela APIYI, em apiyi.com, usando uma única chave. Consulte a página de preços para confirmar a disponibilidade do MiniMax-M3.1-Flash.
📚 Referências
- Blog oficial de lançamento da MiniMax: velocidade, custos e resultados de benchmark divulgados pela própria empresa para o M3.1 Flash
- Link:
minimax.io/blog/minimax-m31f -
Observação: fonte dos preços oficiais e da afirmação de que o custo de tarefas com agentes caiu 70%
-
Página oficial de preços da MiniMax: preços unitários completos do Flash e do M3
- Link:
platform.minimax.io/docs/guides/pricing -
Observação: fórmula de cobrança, faixas para janelas de contexto longas e preço do
web_search -
Documentação oficial da MiniMax: invocação de modelos: níveis de
efforte regras de raciocínio - Link:
platform.minimax.io/docs/guides/text-generation -
Observação: o raciocínio não pode ser desativado e os nomes dos campos
effortem cada protocolo -
Informações sobre a assinatura M Plan da MiniMax: três planos — Go, Explore e Build
- Link:
platform.minimax.io/docs/m-plan/intro -
Observação: multiplicadores de uso, ferramentas compatíveis e informações sobre os modelos
-
FAQ oficial da MiniMax: diferenças entre a chave API e a chave da assinatura
- Link:
platform.minimax.io/docs/faq/about-apis -
Observação: explicação oficial de que os dois tipos de chave não são intercambiáveis
-
Página de avaliação da Vals AI: resultados de uma avaliação independente
- Link:
vals.ai/models/minimax_MiniMax-M3.1-flash - Observação: posição no Vals Index, pontos fortes e fracos
Autor: equipe técnica da APIYI
Contato técnico: entre em contato conosco pela página inicial do site APIYI, em apiyi.com. Para mais informações de integração, acesse a central de documentação em docs.apiyi.com.