Nota do autor: separamos as capacidades anunciadas, o preço listado no APIYI e o endpoint de chamada de Gemini 4 Neon, GPT-6.2 Astra e Claude Fable 5.2 em três colunas para conferência individual, ajudando você a escolher com base em profundidade de raciocínio, agentes de codificação ou preço unitário para contexto longo.
Em novembro de 2026, três fornecedores lançaram novos modelos em um intervalo de dez dias: a Anthropic lançou o Claude Fable 5.2 em 9 de novembro, o Google anunciou o Gemini 4 Neon em 18 de novembro, e o GPT-6.2 Astra também já apareceu na tabela geral de preços do APIYI. O erro mais comum na hora de escolher é misturar os rankings das três empresas, os preços das três empresas e três interfaces diferentes em uma única conclusão de “quem tem o melhor custo-benefício”.
Este não é um artigo de ranking. As fontes dos rankings são diferentes, as faixas de precificação são diferentes e os formatos dos endpoints também são. Forçar a conversão de tudo isso em uma única pontuação só leva a decisões equivocadas. Este artigo divide os três modelos em três colunas e verifica cada uma separadamente: os dados de capacidade citados oficialmente ou nos anúncios, o preço listado no APIYI apiyi.com (verificado em 2026-11-20) e o endpoint que cada modelo deve usar.
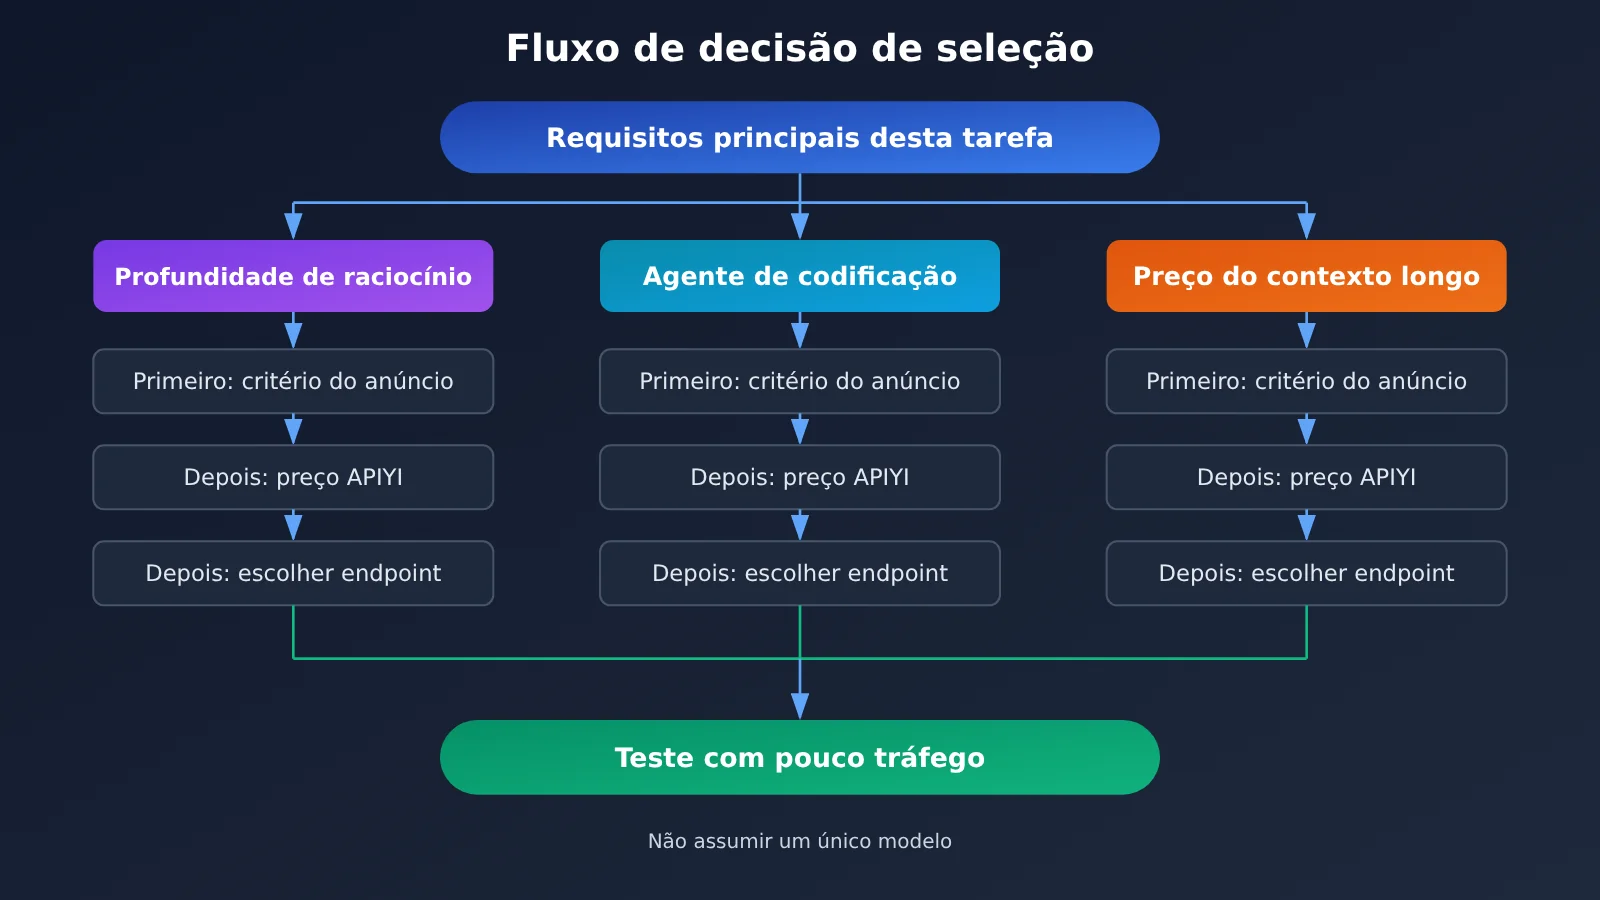
Valor principal: depois de ler este artigo, você conseguirá decidir qual modelo testar primeiro com base no que esta tarefa específica valoriza mais — profundidade de raciocínio, agentes de codificação ou preço unitário para contexto longo — e saberá qual interface usar para chamar cada um.
Pontos-chave de Gemini 4 Neon, GPT-6.2 Astra e Claude Fable 5.2
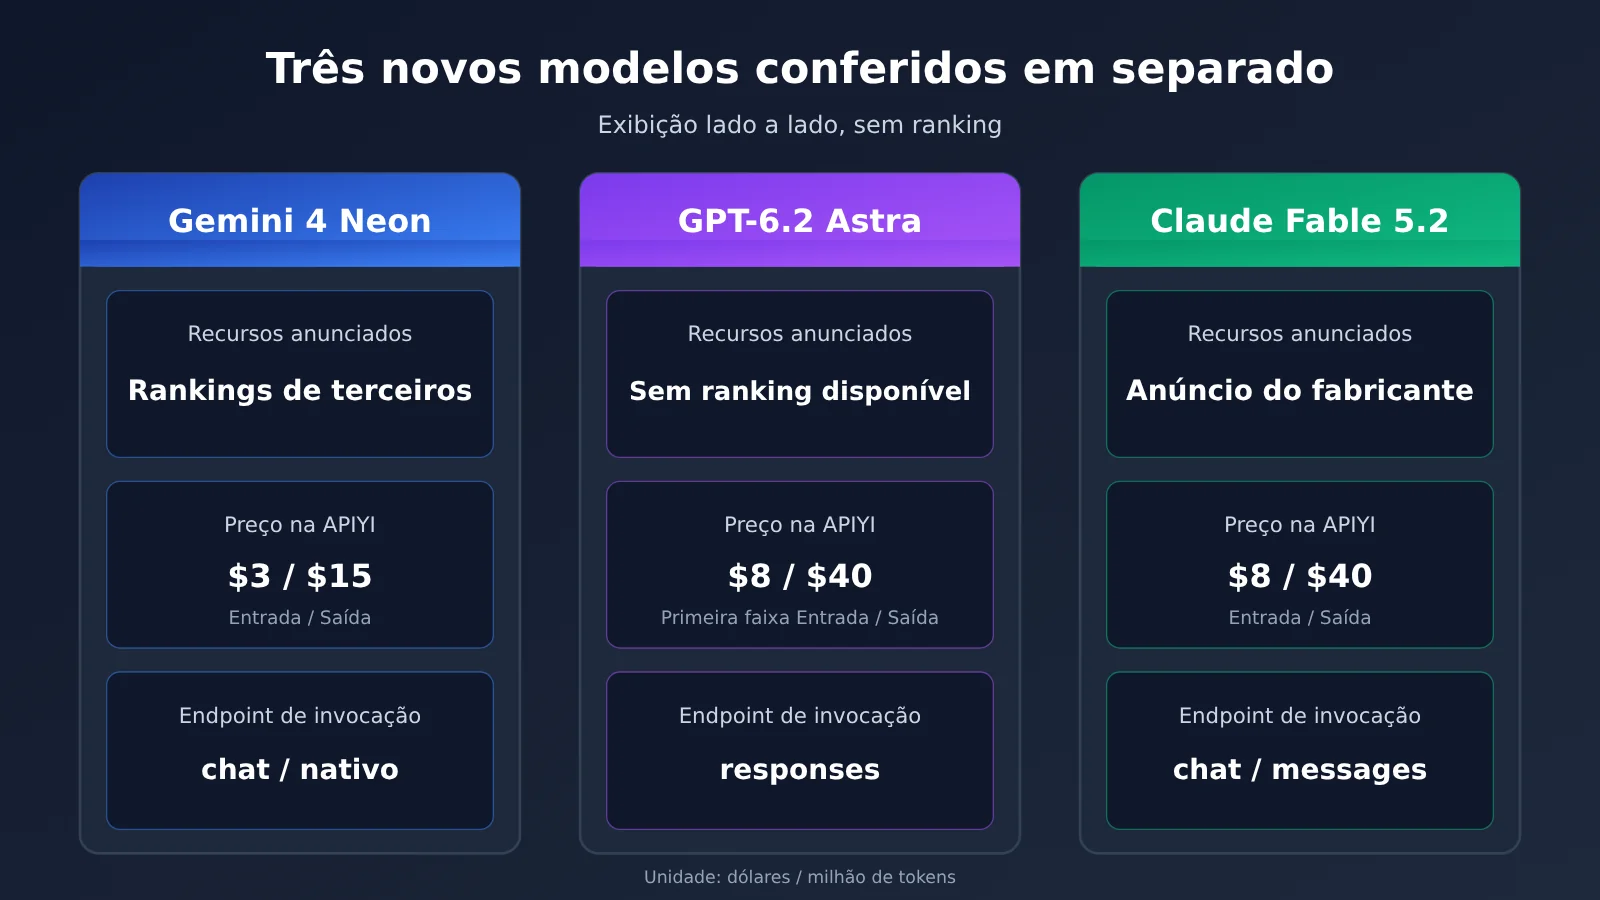
Primeiro, uma tabela para leitura rápida. As três linhas vêm de três tipos diferentes de fontes; a tabela apenas coloca as informações lado a lado, sem somar nada horizontalmente.
| Dimensão | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Fonte dos dados de capacidade | Rankings de terceiros citados no anúncio do Google (Artificial Analysis, Vals) | Os materiais de referência não cobrem dados de ranking do anúncio | Anúncio da Anthropic repercutido no log de atualizações do APIYI (FrontierCode 2.0 etc.) |
| Preço de catálogo no APIYI (USD/milhão de tokens) | Entrada 3, leitura de cache 0.15, saída 15 |
Primeira faixa de entrada 8, leitura de cache 0.4, saída 40, contexto longo tem outra faixa |
Entrada 8, leitura de cache 0.2, saída 40 |
| Endpoint recomendado | chat ou formato nativo Gemini | responses (recomendado), também aceita chat | chat ou messages |
| Contexto | 1 milhão de tokens | Usa 272000 tokens como limite de faixa de preço | Contexto de 1M, saída de até 128K |
Pontos principais para conferir nos três modelos
Na coluna de capacidade, os critérios dos três modelos não estão alinhados. Os dados do Gemini 4 Neon são rankings de terceiros citados pelo Google no anúncio; os dados do Claude Fable 5.2 são o conteúdo publicado pela Anthropic, repercutido no log de atualizações do APIYI; o GPT-6.2 Astra não tem números de ranking correspondentes nos materiais de referência desta análise. Como os rankings e os conjuntos de teste são diferentes, não dá para colocar a porcentagem do Vals Index do Neon e a porcentagem do FrontierCode do Fable na mesma escala numérica.
A coluna de preço parece a mais direta, mas também não dá para comparar apenas os números. Os três modelos têm preços diferentes de leitura de cache, faixas de contexto longo e cobrança do modo de raciocínio; o custo real de uma tarefa depende da proporção entre entrada e saída, da taxa de acerto do cache e de ultrapassar ou não o limite da faixa. Já a coluna de endpoint decide diretamente como o código será escrito; escolher o endpoint errado leva a parâmetros incompatíveis ou funcionalidades ausentes.
Diferenças de desempenho entre Gemini 4 Neon, GPT-6.2 Astra e Claude Fable 5.2 (citações de anúncios)
Esta seção reúne apenas as informações de capacidade que aparecem em anúncios dos fabricantes ou em paráfrases desses anúncios. Nenhum dos dados abaixo foi medido na prática pelo APIYI; ao citá-los, mantenha a indicação da fonte.
| Modelo | Item de dado | Valor | Natureza da fonte |
|---|---|---|---|
| Gemini 4 Neon | Artificial Analysis Intelligence Index (xhigh) | 61, 3º lugar no ranking geral | Ranking de terceiros citado no anúncio do Google |
| Gemini 4 Neon | Vals Index | 2º lugar, 70.9% | Ranking de terceiros citado no anúncio do Google |
| Claude Fable 5.2 | FrontierCode 2.0 | de 32.4% para 49.1% | Paráfrase do anúncio (changelog do APIYI) |
| Claude Fable 5.2 | Velocidade de geração | até 30% mais rápido | Paráfrase do anúncio (changelog do APIYI) |
| GPT-6.2 Astra | Rankings públicos | não fornecidos nos materiais de referência | — |
Como interpretar os rankings de raciocínio do Gemini 4 Neon
No anúncio de 18/11/2026, o Google cita os 61 pontos no Artificial Analysis Intelligence Index no nível xhigh e o 3º lugar no ranking geral, além do 2º lugar no Vals Index com pontuação de 70.9%. Esses dois são índices abrangentes, que priorizam medir raciocínio geral e tarefas de conhecimento. Vale notar que xhigh é um nível de alta intensidade de raciocínio — o desempenho em chamadas do dia a dia, em níveis mais baixos, não necessariamente corresponde a essa pontuação.
Como interpretar os dados de codificação do Claude Fable 5.2
O dado central do Claude Fable 5.2 é o FrontierCode 2.0, que subiu de 32.4% na geração anterior para 49.1% — uma avaliação voltada para tarefas de codificação. O anúncio também menciona geração até 30% mais rápida que, somada à janela de contexto de 1M e à saída máxima de 128K, fica mais próxima de cenários de agentes de codificação que exigem entrada de bases de código longas e saída de patches longos. O FrontierCode e o Vals medem capacidades diferentes, e não existe relação de conversão entre os dois conjuntos de números.
Como verificar as capacidades do GPT-6.2 Astra
Os materiais de referência deste artigo não trazem dados de ranking divulgados para o GPT-6.2 Astra, então essa célula fica em branco, sem especulação. Se a sua tarefa tem requisitos claros sobre a capacidade do Astra, o caminho mais seguro é comparar diretamente com seus próprios dados de negócio em um teste de pequeno tráfego, em vez de extrapolar a partir dos rankings de outros modelos.
Verificação de preços do Gemini 4 Neon, GPT-6.2 Astra e Claude Fable 5.2 (preços de prateleira na APIYI)
Os preços desta seção foram verificados em 2026-11-20 na APIYI apiyi.com, com duas fontes: a tabela geral de modelos (versão atualizada em 2026-11-19 10:59 UTC+8) e a interface de preços (versão shell-api-modelmak-v1). A unidade é dólares por milhão de tokens.
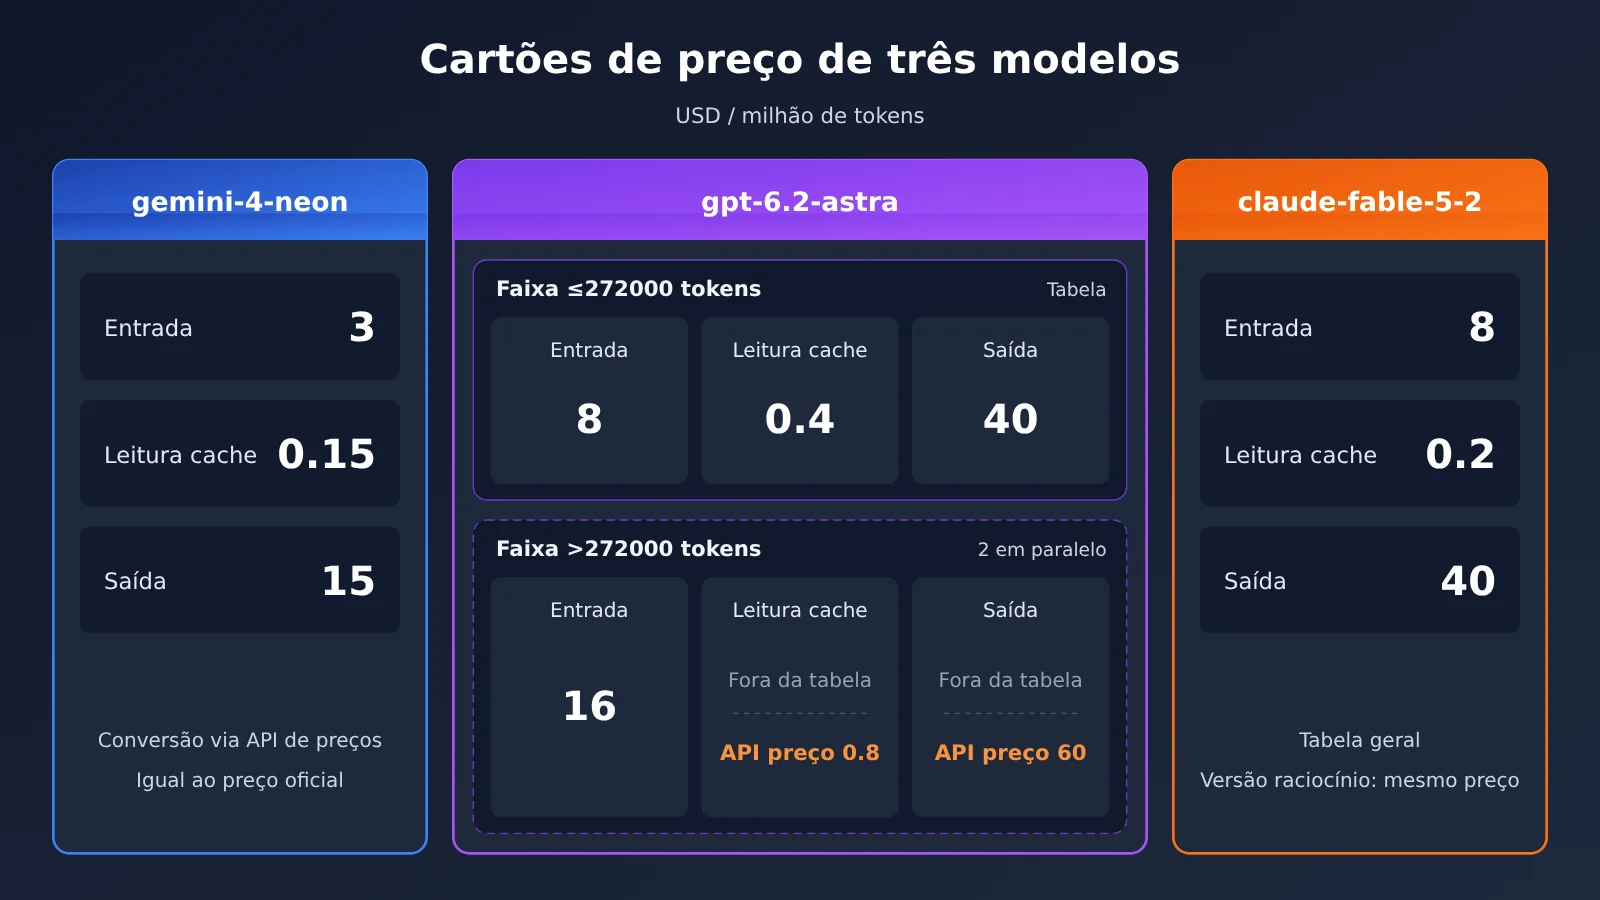
| ID do modelo | Entrada | Leitura de cache | Saída | Fonte dos dados |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
Conversão pela interface de preços, igual ao preço divulgado pelo Google |
gpt-6.2-astra (primeira faixa) |
8 |
0.4 |
40 |
Tabela geral |
gpt-6.2-astra (>272000 tokens) |
16 |
não consta na tabela geral / 0.8 na interface de preços |
não consta na tabela geral / 60 na interface de preços |
Tabela geral e interface de preços lado a lado |
claude-fable-5-2 |
8 |
0.2 |
40 |
Tabela geral |
claude-fable-5-2-thinking |
8 |
0.2 |
40 |
Tabela geral |
Como converter o multiplicador da interface de preços em dólares
A interface de preços da APIYI representa o preço por meio de multiplicadores, e a convenção é que model_ratio igual a 1 equivale a uma entrada de 2 dólares por milhão de tokens. Tomando o gemini-4-neon como exemplo: model_ratio é 1.5, então a entrada fica em 1.5 × 2 = 3; completion_ratio é 5, então a saída fica em 3 × 5 = 15; cache_ratio é 0.05, então a leitura de cache fica em 3 × 0.05 = 0.15. O resultado da conversão bate exatamente com o preço de tabela anunciado pelo Google em 2026-11-18, e na hora de conferir você pode usar essa fórmula para verificar por conta própria.
Por que as faixas de contexto longo do GPT-6.2 Astra aparecem em dois lugares
O GPT-6.2 Astra usa 272000 tokens como linha divisória. A tabela geral traz o preço da primeira faixa e informa que, acima de 272000 tokens, a entrada é 16, mas não mostra o preço de saída dessa faixa; já a interface de preços informa que, acima de 272000 tokens, a saída é cobrada a 60 e a leitura de cache a 0.8. As duas informações são mantidas lado a lado, e este artigo não as funde em um único número. Se suas requisições costumam ultrapassar 272000 tokens, a recomendação é usar como referência o resultado retornado pela interface de preços no momento da chamada.
Informações sobre a redução de preço do Claude Fable 5.2
De acordo com o registro de atualizações da APIYI em 2026-11-10, a Anthropic anunciou que os preços de entrada e saída do Claude Fable 5.2 são 8 e 40, 20% mais baixos que os do 5.1, e a leitura de cache é 0.2. claude-fable-5-2 e claude-fable-5-2-thinking têm o mesmo preço na tabela geral; ao escolher a versão thinking, não é necessário converter o preço unitário separadamente, mas os tokens de saída gerados pelo processo de raciocínio aparecerão no uso.
Referência de preços do Gemini 4 da mesma família
Se você estiver decidindo dentro da família Gemini 4, os preços de tabela dos modelos abaixo podem ser consultados em conjunto. Entre eles, o preço do gemini-4-carbon corresponde ao preço introdutório do Google até 2026-11-30; o Google anunciou que, a partir de 1º de dezembro, o preço padrão será entrada 4 e saída 20. Se o preço de tabela será ajustado nessa data, consulte a tabela geral do dia.
| Modelo ID | Entrada | Leitura de cache | Saída | Observações |
|---|---|---|---|---|
gemini-4-carbon |
2 |
0.1 |
10 |
Corresponde ao preço introdutório do Google (até 2026-11-30) |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
— |
gemini-4-argon |
2 |
0.1 |
10 |
Preço da tabela geral |
Endpoints da API para Gemini 4 Neon, GPT-6.2 Astra e Claude Fable 5.2
Os três modelos têm endpoints recomendados diferentes — não existe um único bloco de código que funcione para todos sem ajustes. A única parte comum é a base_url: ao chamar pela APIYI, use https://api.apiyi.com/v1 e depois escolha o caminho e o formato de requisição de acordo com o modelo.
| Modelo | Endpoint recomendado | Endpoint alternativo | Pontos-chave |
|---|---|---|---|
| Gemini 4 Neon | chat (compatível com OpenAI, /chat/completions) |
formato nativo do Gemini | Projetos que já usam o SDK da OpenAI podem usar chat; se precisar de parâmetros nativos do Gemini, use o formato nativo |
| GPT-6.2 Astra | responses (/responses) |
chat (/chat/completions) |
Recomendamos responses; o corpo da requisição usa o campo input; chat usa messages |
| Claude Fable 5.2 | chat (/chat/completions) |
messages (formato Anthropic Messages) | Use messages quando precisar de recursos nativos da Anthropic; a versão de raciocínio usa claude-fable-5-2-thinking |
Por que o GPT-6.2 Astra tem responses como recomendação
responses é o formato de interface da nova geração da OpenAI e oferece suporte mais completo a recursos como estado de múltiplas rodadas e chamada de ferramentas. Por isso, para o Astra, recomendamos priorizar esse endpoint. O endpoint chat continua disponível e é adequado para projetos que já têm muito código no formato chat e que, por enquanto, não querem refatorar. Os campos do corpo da requisição são diferentes entre os dois endpoints; ao migrar, não basta trocar apenas o nome do modelo.
Por que Neon e Fable têm duas opções de endpoint
Gemini 4 Neon e Claude Fable 5.2 oferecem tanto o endpoint chat compatível com OpenAI quanto o formato nativo de cada fabricante. A vantagem do chat é poder compartilhar o mesmo SDK com outros modelos; a do formato nativo é poder usar parâmetros específicos do fabricante. Se o seu caso de uso envolve apenas conversas e gerações comuns, o endpoint chat geralmente já basta.
Início rápido com Gemini 4 Neon, GPT-6.2 Astra e Claude Fable 5.2
Conforme solicitado neste artigo, não vou entregar um trecho de código genérico, mas sim listar os parâmetros principais de cada modelo separadamente. A configuração comum aos três modelos é: preencha api_key com a chave obtida no painel do APIYI e base_url com https://api.apiyi.com/v1.
- Invocar o Gemini 4 Neon: aponte o SDK da OpenAI para o base_url acima, chame
chat.completions.create, preenchamodelcomgemini-4-neone passemessagescom o array de conversa; se precisar de parâmetros nativos, use o formato nativo do Gemini. - Invocar o GPT-6.2 Astra: no mesmo cliente do SDK, chame
responses.create, preenchamodelcomgpt-6.2-astrae passe o conteúdo do comando eminput; se estiver reaproveitando código antigo, também pode usarchat.completions.create. - Invocar o Claude Fable 5.2: em cenários comuns, chame
chat.completions.createcommodelpreenchido comclaude-fable-5-2; quando precisar de raciocínio profundo, troque paraclaude-fable-5-2-thinking; se precisar de parâmetros nativos do Anthropic, mude para o formato messages. - Registrar o uso: após cada chamada, anote os números de tokens de entrada, saída e cache retornados — você vai precisar disso depois para calcular o custo por tarefa.
🚀 Início rápido: recomendo primeiro resgatar o crédito de teste gratuito para novos usuários no APIYI apiyi.com e rodar os três modelos com o mesmo lote de amostras de negócio. Uma única chave API permite alternar entre os três modelos com cobrança por uso, o que facilita comparar qualidade e custo sob carga real.
Recomendações por cenário: avalie conforme a necessidade desta tarefa
O ponto de partida para escolher não é “qual é o melhor modelo”, mas sim o que esta tarefa específica mais valoriza. A seguir, separei três necessidades comuns e indiquei qual coluna de informação você deve consultar primeiro.
Cenários em que a profundidade de raciocínio pesa mais
- Análises complexas e raciocínio em várias etapas: consulte primeiro os dados do Artificial Analysis e do Vals Index citados no anúncio do Gemini 4 Neon; atenção que a pontuação 61 é o resultado obtido no nível xhigh.
- Tarefas que exigem um nível alto de raciocínio: o Claude Fable 5.2 tem um ID de modelo próprio,
claude-fable-5-2-thinking, o que permite testá-lo em comparação com a versão sem raciocínio usando o mesmo preço unitário. - Se você precisa do GPT-6.2 Astra: os materiais de referência não trazem dados de ranking para ele; a recomendação é validar diretamente com amostras do seu próprio negócio.
Cenários em que o agente de código pesa mais
- Entradas de bases de código grandes e saídas de patches longos: o avanço no FrontierCode 2.0 e o limite de 128K tokens de saída mencionados no anúncio do Claude Fable 5.2 são informações que vale a pena levar em conta.
- Chamadas de ferramentas e estado de múltiplos turnos com mais peso: o endpoint responses recomendado pelo GPT-6.2 Astra é mais adequado para carregar esse tipo de interação, e a forma de integração por si só já é um ponto a considerar.
- Se você já tem código compatível com OpenAI: os três modelos funcionam no endpoint chat, então o custo de migração fica relativamente controlado.
Cenários em que o preço do contexto longo pesa mais
- Entradas muito longas e recorrentes: confirme primeiro se a requisição ultrapassa a faixa de 272000 tokens do GPT-6.2 Astra; ao passar dessa linha, o preço unitário muda para outra faixa.
- Alta taxa de acerto de cache: o preço unitário de leitura de cache varia bastante entre os três modelos, então negócios com alta taxa de acerto de cache precisam calcular esse valor separadamente.
- Contexto na casa de 1M: tanto Gemini 4 Neon quanto Claude Fable 5.2 declaram contexto na faixa de 1 milhão de tokens, mas os preços unitários de entrada e saída são diferentes — é preciso calcular conforme a sua própria proporção entre entrada e saída.
Recomendação de decisão: conferir as três colunas separadamente e depois validar com baixo volume de tráfego
Conferir as três colunas separadamente é a maneira mais simples de evitar erros na escolha do modelo. A coluna de capacidade apenas indica “o desempenho em determinado ranking e em determinada faixa”; a coluna de preço apenas indica “o preço unitário por milhão de tokens”; e a coluna de endpoint apenas indica “como o código deve ser escrito”. Nenhuma coluna sozinha permite concluir “qual modelo usar neste caso”.
Uma abordagem mais prática é calcular primeiro o custo por tarefa: use uma requisição típica do seu negócio para estimar o número de tokens de entrada, saída e cache, e multiplique cada um pelo preço unitário correspondente de cada um dos três modelos. No caso do GPT-6.2 Astra, ainda é preciso verificar se ultrapassa 272000 tokens. Depois, teste a qualidade com o mesmo lote de amostras e avalie custo e qualidade em conjunto, em vez de olhar apenas para o ranking ou apenas para o preço unitário.
💡 Sugestão de escolha: qual modelo escolher depende da estrutura da sua tarefa e dos requisitos de qualidade. Recomendamos usar a APIYI apiyi.com com uma chave unificada para fazer uma comparação de baixo volume de tráfego entre os três modelos, calcular o custo com base no uso real e então decidir o modelo principal e o modelo de backup.
FAQ — Perguntas Frequentes
Q1: O que são, respectivamente, Gemini 4 Neon, GPT-6.2 Astra e Claude Fable 5.2?
Os três são Modelos de Linguagem Grande de nova geração surgidos por volta de novembro de 2026: o Gemini 4 Neon foi anunciado pelo Google em 2026-11-18, o Claude Fable 5.2 foi lançado pela Anthropic em 9 de novembro, e o GPT-6.2 Astra já consta na tabela geral de preços da APIYI. As três soluções diferem no escopo de capacidade, na forma de precificação e no formato de endpoint.
Q2: As pontuações de ranking dos três modelos podem ser comparadas diretamente?
Não. Os dados do Gemini 4 Neon vêm do Artificial Analysis e do Vals Index citados no anúncio do Google; os do Claude Fable 5.2 são do FrontierCode 2.0, conforme reproduzido no anúncio — os dois medem capacidades diferentes; já o GPT-6.2 Astra não tem dados de ranking neste material. Não existe relação de conversão entre rankings diferentes.
Q3: Quando os três modelos foram lançados?
De acordo com o changelog da APIYI de 2026-11-10, a Anthropic lançou o Claude Fable 5.2 em 9 de novembro; o Google publicou o anúncio do Gemini 4 Neon em 2026-11-18. Os preços deste artigo foram conferidos em 2026-11-20, e a versão da tabela geral de referência foi atualizada em 2026-11-19 10:59 (UTC+8).
Q4: Qual é exatamente o preço de saída do GPT-6.2 Astra após 272000 tokens?
As duas fontes escrevem de forma diferente: a tabela geral da APIYI indica que, acima de 272000 tokens, a entrada é `16`, mas não informa o preço de saída; a interface de precificação especifica que, acima de 272000 tokens, a saída é `60` e a leitura de cache é `0.8`. Este artigo mantém as duas versões lado a lado; para a cobrança real, recomenda-se usar a interface de precificação no momento da invocação.
Q5: Como invocar rapidamente esses três modelos via API?
Recomenda-se usar uma plataforma agregadora multimodelo para acesso unificado:
1. Acesse APIYI apiyi.com, crie uma conta e obtenha a chave API e a cota de teste gratuita
2. Preencha `base_url` de forma unificada com `https://api.apiyi.com/v1`
3. Escolha o endpoint conforme o modelo: Neon via chat ou formato nativo do Gemini, Astra via responses (também pode via chat), Fable via chat ou messages
Com uma única key você alterna entre os três modelos, o que facilita comparar em um mesmo lote de amostras.
Q6: Como conferir por conta própria o preço de prateleira da APIYI?
Você pode consultar ao mesmo tempo a tabela geral de modelos e a interface de precificação da APIYI apiyi.com. A interface de precificação usa multiplicadores: `model_ratio` igual a 1 equivale a entrada de 2 dólares por milhão de tokens; a saída é igual à entrada multiplicada por `completion_ratio`; a leitura de cache é igual à entrada multiplicada por `cache_ratio`. Por exemplo, `gemini-4-neon` converte-se assim em entrada 3, saída 15 e leitura de cache 0.15.
Q7: A versão com raciocínio do Claude Fable 5.2 exige pagamento extra?
`claude-fable-5-2` e `claude-fable-5-2-thinking` têm o mesmo preço unitário na tabela geral: entrada 8, leitura de cache 0.2 e saída 40. O preço unitário não muda, mas o processo de raciocínio gera tokens de saída extras, então o custo real varia conforme o uso.
Q8: Quais são as limitações a que se deve ficar atento nesses três modelos?
– **Dados de capacidade**: os dados do Neon e do Fable são citações ou paráfrases de anúncios, não testes independentes; o Astra não tem dados públicos de ranking.
– **Faixas de preço**: o Astra tem uma linha de corte em 272000 tokens, e as duas fontes escrevem de formas diferentes.
– **Validade dos preços**: o `gemini-4-carbon` da mesma família corresponde ao preço de lançamento do Google válido até 30 de novembro; a partir de dezembro, o preço padrão do Google é entrada 4 e saída 20.
– **Diferenças de endpoint**: os três endpoints recomendados são diferentes; na migração não basta trocar o nome do modelo.
Gemini 4 Neon, GPT-6.2 Astra e Claude Fable 5.2: principais pontos (Key Takeaways)
- Três colunas separadas: capacidade anunciada, preço de prateleira do APIYI e endpoint de invocação são independentes; não se combinam em uma única nota.
- Critérios de ranking diferentes: o Neon cita Artificial Analysis e Vals, o Fable cita FrontierCode; não dá para comparar entre si.
- Preço do Neon dá para conferir: a conversão de multiplicador da interface de preços resulta em entrada 3, leitura de cache 0.15, saída 15.
- Atenção às faixas do Astra: acima de 272000 tokens de entrada é 16; o preço de saída não aparece na tabela geral, mas a interface de preços informa 60.
- Preço unitário do Fable é uniforme: versão normal e versão de raciocínio são ambas entrada 8, leitura de cache 0.2, saída 40.
- Endpoints diferentes entre si: o Neon vai por chat ou nativo, o Astra recomenda responses, o Fable vai por chat ou messages.
- Como começar: acesse os três modelos com uma única chave via APIYI apiyi.com e compare com um lote pequeno das mesmas amostras.
Resumo
A comparação entre Gemini 4 Neon, GPT-6.2 Astra e Claude Fable 5.2 depende de não misturar três tipos de informação:
- Coluna de capacidade: considere apenas os rankings e as faixas citados nos anúncios. As métricas de Neon e Fable usam critérios diferentes, e Astra precisa ser verificado por conta própria.
- Coluna de preço: use o preço de tabela da APIYI como referência. Fique atento ao preço unitário de leitura de cache, à faixa de 272000 tokens do Astra e às diferenças entre as duas fontes.
- Coluna de endpoint: os endpoints recomendados para os três modelos são diferentes. O
base_urlé o mesmo para todos:https://api.apiyi.com/v1; os caminhos e os corpos das requisições devem ser escritos separadamente para cada modelo.
Primeiro, deixe claro se este caso valoriza mais a profundidade de raciocínio, o agente de programação ou o preço unitário de contexto longo. Depois, confira na coluna correspondente e, por fim, valide com amostras reais em pequeno volume. Recomendamos resgatar o crédito gratuito pela APIYI apiyi.com e concluir o teste comparativo dos três modelos usando a mesma chave API.
📚 Materiais de referência
-
Tabela geral de modelos da APIYI: IDs de modelo e preços de tabela (versão verificada neste artigo atualizada em 2026-11-19 10:59 UTC+8)
- Link:
docs.apiyi.com/models.md - Descrição: consultar o preço unitário por faixa dos modelos
gpt-6.2-astra,claude-fable-5-2e outros.
- Link:
-
Interface de preços da APIYI: preços em tempo real em formato de multiplicador (versão
shell-api-modelmak-v1)- Link:
api.apiyi.com/api/pricing - Descrição: usar
model_ratio,completion_ratioecache_ratiopara converter em preço unitário em dólares.
- Link:
-
Anúncio do Google Gemini 4 Neon: publicado em 2026-11-18
- Descrição: inclui preço de tabela, contexto de 1 milhão e dados citados do Artificial Analysis e do Vals Index.
-
Changelog da APIYI (2026-11-10): relata as informações de lançamento do Anthropic Claude Fable 5.2
- Descrição: inclui ajuste de preços, dados do FrontierCode 2.0, contexto de 1M e saída de 128K.
Autor: Equipe técnica da APIYI
Contato técnico: Sinta-se à vontade para nos contatar na página inicial do site oficial da APIYI para obter mais materiais sobre integração de modelos e verificação de preços.