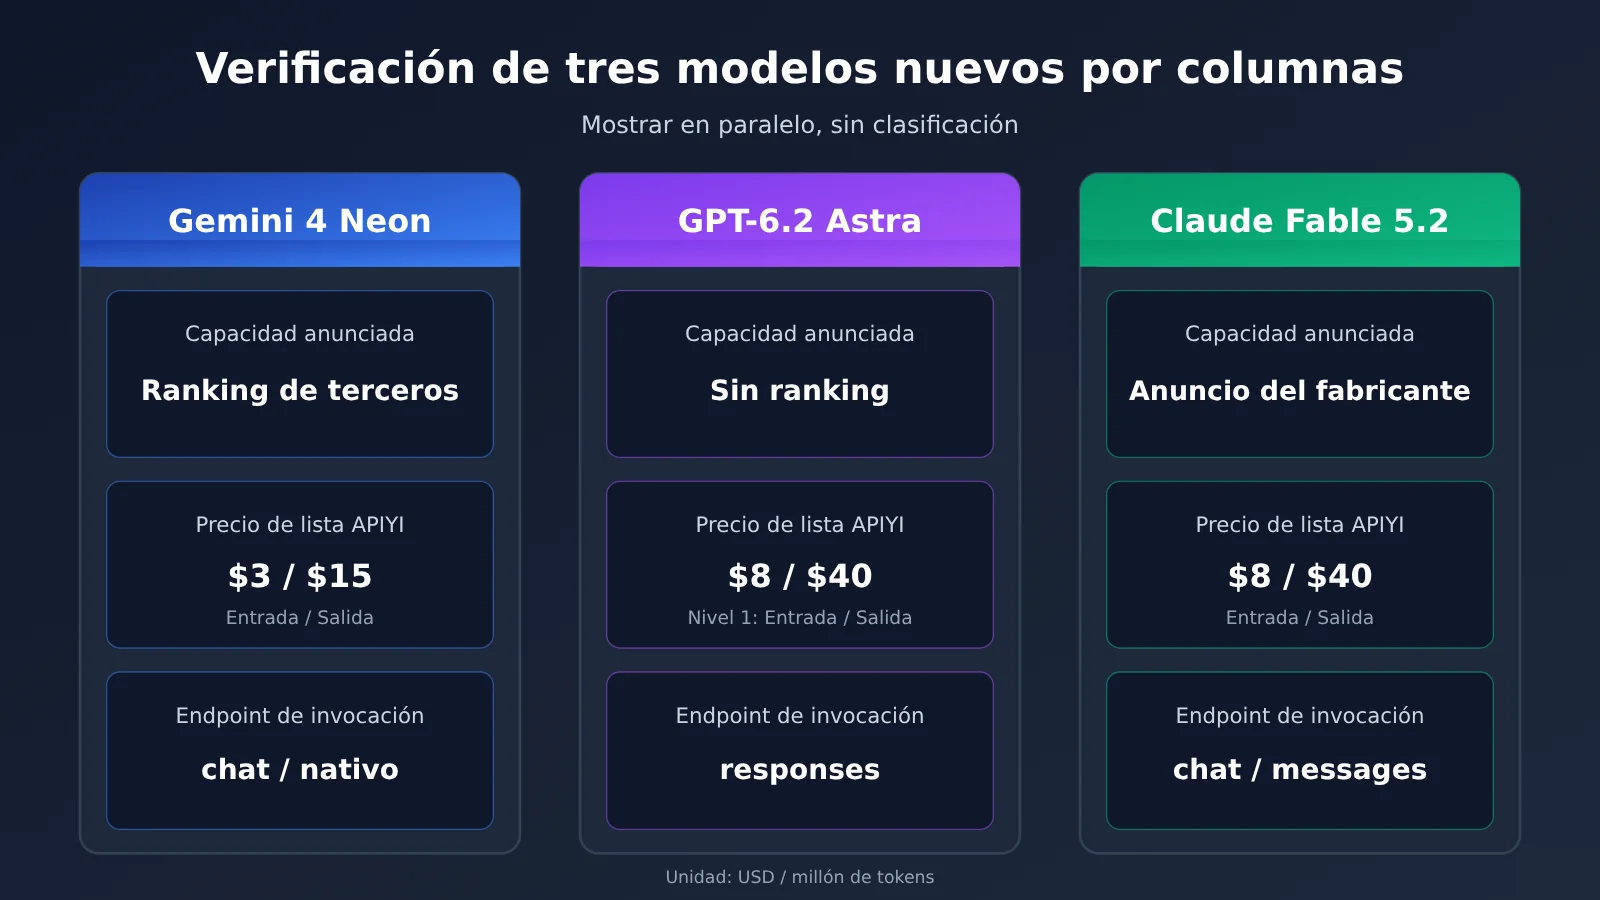
Nota del autor: separamos en tres columnas las capacidades anunciadas de Gemini 4 Neon, GPT-6.2 Astra y Claude Fable 5.2, el precio de catálogo en APIYI y el endpoint de invocación, para que puedas compararlos uno por uno y elegir según la profundidad de razonamiento, el agente de programación o el precio unitario en contextos largos.
En noviembre de 2026, tres fabricantes lanzaron nuevos modelos en un lapso de diez días: Anthropic presentó Claude Fable 5.2 el 9 de noviembre, Google anunció Gemini 4 Neon el 18 de noviembre, y GPT-6.2 Astra ya aparecía en la tabla general de precios de APIYI. A la hora de elegir, el error más común es mezclar los rankings de los tres, los precios de los tres y tres interfaces distintas en una sola conclusión sobre “cuál conviene más”.
Este no es un artículo que reparte puestos. Las fuentes de los rankings son distintas, los tramos de precios son distintos y los formatos de endpoint también son distintos; forzarlos a convertirse en una sola puntuación solo lleva a decisiones equivocadas. Aquí verificamos los tres modelos en tres columnas separadas: los datos de capacidad citados por las fuentes oficiales o por los anuncios, el precio de catálogo en APIYI apiyi.com (verificado el 20-11-2026) y el endpoint que debería usar cada modelo.
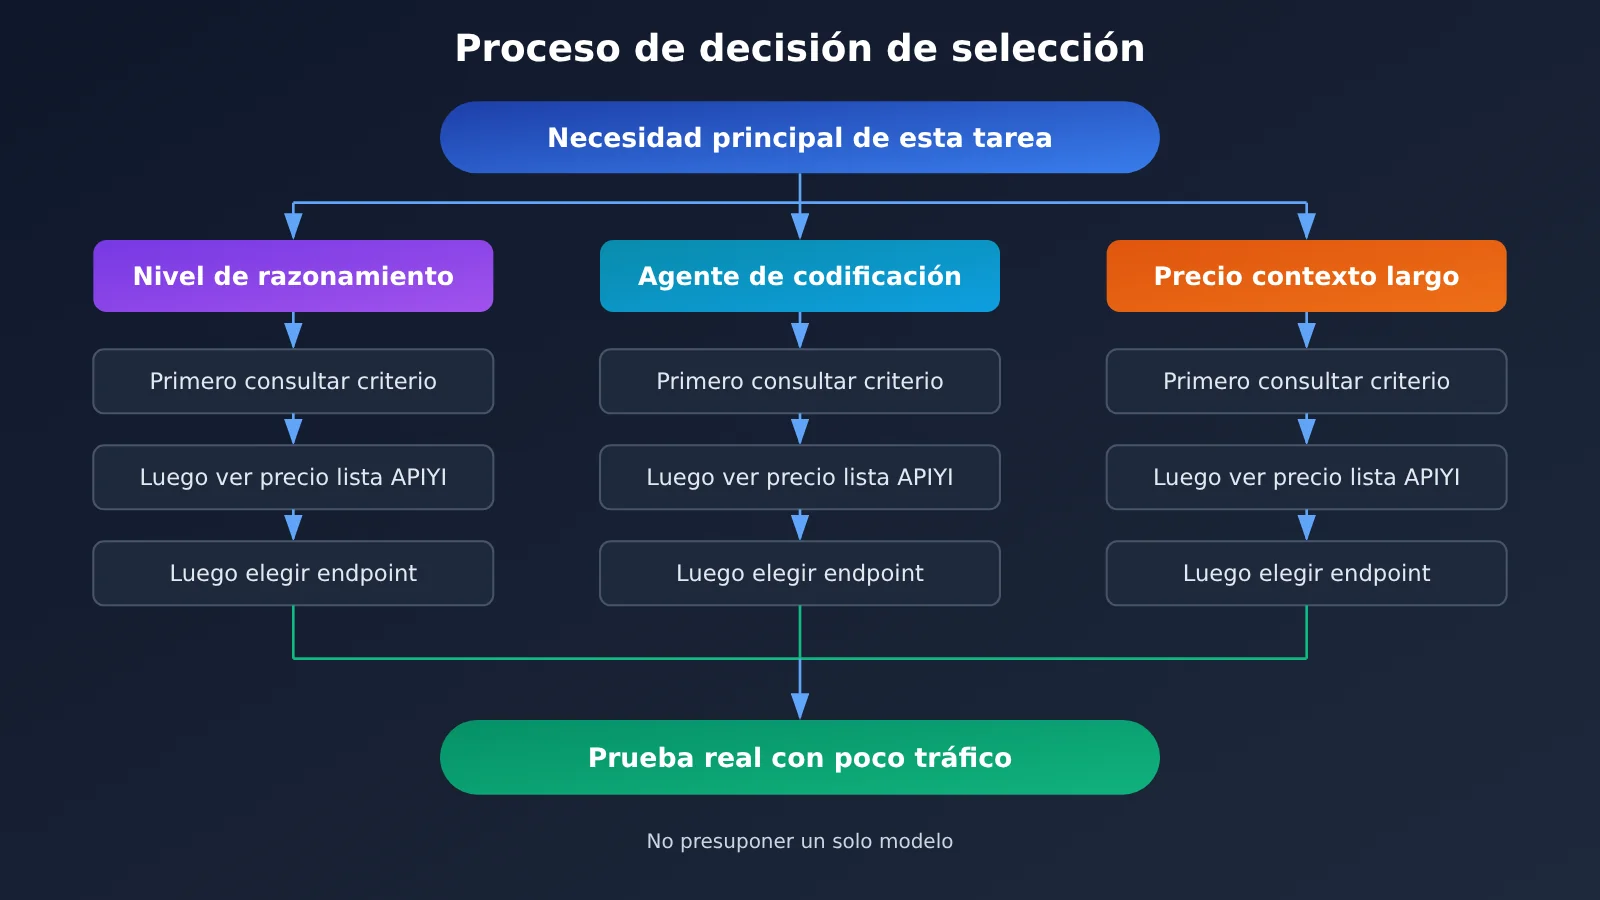
Valor central: después de leer este artículo, podrás decidir por tu cuenta cuál modelo probar primero según si esta tarea concreta valora más la profundidad de razonamiento, el agente de programación o el precio unitario en contextos largos, y sabrás con qué interfaz invocar cada uno.
Puntos clave de Gemini 4 Neon, GPT-6.2 Astra y Claude Fable 5.2
Primero, una tabla de lectura rápida. La información de las tres filas proviene de tres tipos de fuentes distintas; la tabla solo la presenta en paralelo, sin hacer una suma horizontal.
| Dimensión | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Fuente de los datos de capacidad | Rankings de terceros citados en el anuncio de Google (Artificial Analysis, Vals) | Los materiales de referencia no cubren los datos de rankings del anuncio | Anuncio de Anthropic reproducido en el registro de actualizaciones de APIYI (FrontierCode 2.0, etc.) |
| Precio de catálogo de APIYI (USD/millón de tokens) | entrada 3, lectura de caché 0.15, salida 15 |
entrada del primer tramo 8, lectura de caché 0.4, salida 40; el contexto largo tiene otros tramos |
entrada 8, lectura de caché 0.2, salida 40 |
| Endpoint recomendado | chat o formato nativo de Gemini | responses (recomendado), también compatible con chat | chat o messages |
| Contexto | 1 millón de tokens | con 272000 tokens como umbral de tramos de precio | contexto de 1M, salida de hasta 128K |
Detalles clave de verificación de los tres modelos
En la columna de capacidad, los criterios de los tres modelos no están alineados. Los datos de Gemini 4 Neon provienen de rankings de terceros citados por Google en su anuncio; los de Claude Fable 5.2 son contenido publicado por Anthropic y reproducido en el registro de actualizaciones de APIYI; GPT-6.2 Astra no tiene cifras de rankings correspondientes en los materiales de referencia de esta ocasión. Como los rankings y los conjuntos de prueba son distintos, no se puede comparar el porcentaje de Vals Index de Neon con el porcentaje de FrontierCode de Fable en el mismo eje numérico.
La columna de precios parece la más intuitiva, pero tampoco se trata de comparar solo el tamaño de las cifras. El precio de lectura de caché, los tramos de contexto largo y la facturación del modo de razonamiento difieren entre los tres modelos; el coste real de una tarea depende de la proporción de entrada y salida, de la tasa de aciertos de caché y de si se supera o no el umbral de tramo. La columna de endpoints determina directamente cómo escribir el código: elegir el endpoint equivocado provoca incompatibilidad de parámetros o funciones ausentes.
Diferencias de rendimiento entre Gemini 4 Neon, GPT-6.2 Astra y Claude Fable 5.2 (citas de anuncios)
Esta sección recopila únicamente la información sobre capacidades que aparece en anuncios de los fabricantes o en paráfrasis de dichos anuncios. Ninguno de los siguientes datos proviene de pruebas reales de APIYI; al citarlos, conserva la indicación de la fuente.
| Modelo | Dato | Valor | Naturaleza de la fuente |
|---|---|---|---|
| Gemini 4 Neon | Artificial Analysis Intelligence Index (xhigh) | 61, puesto 3 en la clasificación general | Clasificación de terceros citada en el anuncio de Google |
| Gemini 4 Neon | Vals Index | Puesto 2, 70,9 % | Clasificación de terceros citada en el anuncio de Google |
| Claude Fable 5.2 | FrontierCode 2.0 | De 32,4 % a 49,1 % | Paráfrasis del anuncio (registro de actualizaciones de APIYI) |
| Claude Fable 5.2 | Velocidad de generación | Hasta 30 % más rápida | Paráfrasis del anuncio (registro de actualizaciones de APIYI) |
| GPT-6.2 Astra | Clasificaciones públicas | No proporcionadas en los materiales de referencia | — |
Cómo interpretar las clasificaciones de razonamiento de Gemini 4 Neon
En el anuncio de Google del 18/11/2026 se citan los 61 puntos y el puesto 3 en la clasificación general del Artificial Analysis Intelligence Index en el nivel xhigh, así como el puesto 2 y una puntuación de 70,9 % en el Vals Index. Ambos son índices integrales que se centran en medir el razonamiento general y las tareas de conocimiento. Conviene tener en cuenta que xhigh es un nivel de alta intensidad de razonamiento, por lo que el rendimiento con invocaciones diarias en niveles bajos no tiene por qué coincidir con esta puntuación.
Cómo interpretar los datos de código de Claude Fable 5.2
El dato central de Claude Fable 5.2 es que FrontierCode 2.0 pasa del 32,4 % de la generación anterior al 49,1 %, una evaluación orientada a tareas de código. Además, el anuncio menciona que la generación es hasta un 30 % más rápida y, junto con una ventana de contexto de 1M y una salida máxima de 128K, encaja mejor con escenarios de agentes de código que necesitan entradas de bases de código extensas y salidas de parches largos. FrontierCode y Vals miden capacidades distintas, y no existe una relación de conversión entre ambos conjuntos de cifras.
Cómo verificar las capacidades de GPT-6.2 Astra
Estos materiales de referencia no incluyen datos de clasificaciones anunciadas para GPT-6.2 Astra, así que esta casilla se deja vacía y no se hacen suposiciones. Si tu tarea tiene requisitos claros sobre las capacidades de Astra, lo más prudente es hacer una comparación directa con poco tráfico usando tus propias muestras de negocio, en lugar de extrapolar a partir de las clasificaciones de otros modelos.
Verificación de precios de Gemini 4 Neon, GPT-6.2 Astra y Claude Fable 5.2 (precio de catálogo de APIYI)
Los precios de esta sección se verificaron el 2026-11-20 en APIYI apiyi.com. Hay dos fuentes: la tabla general de modelos (versión actualizada el 2026-11-19 a las 10:59 UTC+8) y la interfaz de precios (versión shell-api-modelmak-v1). Todas las unidades están en USD por millón de tokens.
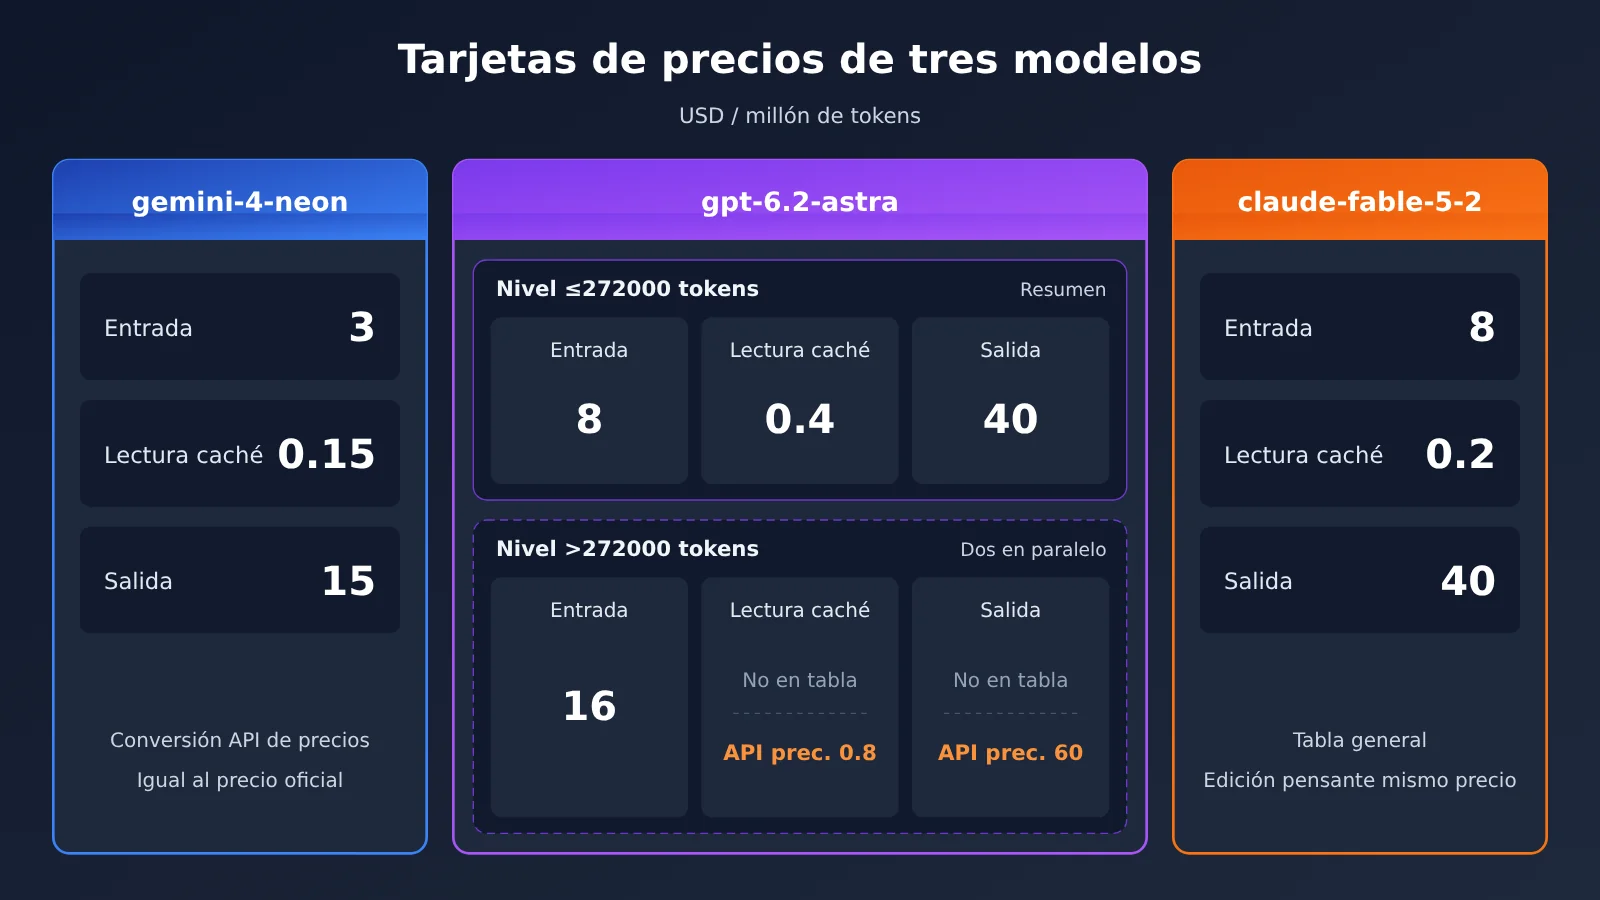
| ID del modelo | Entrada | Lectura de caché | Salida | Fuente de datos |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
Convertido desde la interfaz de precios; coincide con el precio anunciado por Google |
gpt-6.2-astra (primer tramo) |
8 |
0.4 |
40 |
Tabla general |
gpt-6.2-astra (>272000 tokens) |
16 |
No consta en la tabla general / interfaz de precios 0.8 |
No consta en la tabla general / interfaz de precios 60 |
Tabla general e interfaz de precios, en paralelo |
claude-fable-5-2 |
8 |
0.2 |
40 |
Tabla general |
claude-fable-5-2-thinking |
8 |
0.2 |
40 |
Tabla general |
Cómo convertir los multiplicadores de la interfaz de precios a dólares
La interfaz de precios de APIYI expresa el precio mediante multiplicadores, con la convención de que un model_ratio igual a 1 equivale a 2 dólares por millón de tokens de entrada. Tomemos como ejemplo gemini-4-neon: su model_ratio es 1.5, así que la entrada queda en 1.5 × 2 = 3; su completion_ratio es 5, por lo que la salida queda en 3 × 5 = 15; y su cache_ratio es 0.05, lo que deja la lectura de caché en 3 × 0.05 = 0.15. El resultado de la conversión coincide exactamente con el precio oficial que Google anunció el 2026-11-18, así que al verificar puedes usar directamente esta fórmula para comprobarlo tú mismo.
Por qué los niveles de contexto largo de GPT-6.2 Astra aparecen escritos en dos lugares distintos
GPT-6.2 Astra usa 272000 tokens como línea divisoria entre niveles. La tabla general indica el precio del primer nivel y también que, al superar los 272000 tokens, la entrada cuesta 16, pero no incluye el precio de salida de ese nivel; la interfaz de precios, en cambio, sí especifica que por encima de 272000 tokens la salida se calcula con 60 y la lectura de caché con 0.8. Aquí mantenemos ambas informaciones una junto a otra y no las fusionamos en un solo número. Si tus solicitudes cruzan con frecuencia los 272000 tokens, te recomendamos tomar como referencia el resultado que devuelve la interfaz de precios en el momento de la invocación.
Información sobre la reducción de precios de Claude Fable 5.2
Según el registro de cambios de APIYI del 10 de noviembre de 2026, Anthropic anunció que los precios de entrada y salida de Claude Fable 5.2 son 8 y 40, un 20 % menos que 5.1, y que la lectura de caché es 0.2. claude-fable-5-2 y claude-fable-5-2-thinking tienen el mismo precio en la tabla general, así que al elegir la versión con razonamiento no hace falta convertir el precio unitario por separado; eso sí, los tokens de salida que genera el proceso de razonamiento se reflejarán en el consumo.
Referencia de precios de la misma familia Gemini 4
Si estás decidiendo dentro de la familia Gemini 4, estos precios de catálogo de algunos modelos pueden servirte de referencia. Ojo: el precio de gemini-4-carbon corresponde al precio introductorio de Google vigente hasta el 30 de noviembre de 2026. Google anunció que a partir del 1 de diciembre el precio estándar será 4 de entrada y 20 de salida, así que, cuando llegue esa fecha, conviene consultar la tabla general del día para ver si el precio de catálogo se ajusta.
| ID del modelo | Entrada | Lectura de caché | Salida | Nota |
|---|---|---|---|---|
gemini-4-carbon |
2 |
0.1 |
10 |
Corresponde al precio introductorio de Google (hasta el 30/11/2026) |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
— |
gemini-4-argon |
2 |
0.1 |
10 |
Precio de la tabla general |
Endpoints de API de Gemini 4 Neon, GPT-6.2 Astra y Claude Fable 5.2
Los endpoints recomendados para estos tres modelos son distintos: no existe un único fragmento de código que sirva para los tres. Lo único unificado es base_url: al llamar a través de APIYI, usa https://api.apiyi.com/v1 y luego elige la ruta y el formato de solicitud correspondientes al modelo.
| Modelo | Endpoint recomendado | Endpoint alternativo | Puntos clave de implementación |
|---|---|---|---|
| Gemini 4 Neon | chat (compatible con OpenAI /chat/completions) |
Formato nativo de Gemini | Los proyectos que ya tienen OpenAI SDK usan chat; si necesitas parámetros nativos de Gemini, usa el formato nativo |
| GPT-6.2 Astra | responses (/responses) |
chat (/chat/completions) |
Se recomienda responses; el cuerpo de la solicitud usa el campo input; chat usa el campo messages |
| Claude Fable 5.2 | chat (/chat/completions) |
messages (formato Anthropic Messages) | Usa messages cuando necesites capacidades nativas de Anthropic; para la versión thinking, usa claude-fable-5-2-thinking |
Por qué se recomienda responses para GPT-6.2 Astra
responses es el formato de interfaz de nueva generación de OpenAI y ofrece un soporte más completo para capacidades como el estado multi-turno y las llamadas a herramientas; por eso Astra recomienda usar este endpoint primero. El endpoint chat sigue disponible y resulta adecuado para proyectos que ya tienen mucho código en formato chat y que, por ahora, no quieren refactorizarlo. Los campos del cuerpo de la solicitud son distintos entre ambos endpoints; al migrar, no cambies solo el nombre del modelo.
Por qué Neon y Fable tienen dos puntos de entrada cada uno
Gemini 4 Neon y Claude Fable 5.2 admiten tanto el endpoint chat compatible con OpenAI como el formato nativo de cada proveedor. La ventaja del endpoint chat es que el código puede compartir un mismo SDK con otros modelos; la ventaja del formato nativo es que permite usar parámetros específicos del proveedor. Si tu caso de uso solo implica conversación y generación habituales, el endpoint chat normalmente ya es suficiente.
Inicio rápido con Gemini 4 Neon, GPT-6.2 Astra y Claude Fable 5.2
Como pide este artículo, aquí no vamos a dar un bloque de código genérico, sino a listar los parámetros clave para cada modelo. La configuración común a los tres modelos es: en api_key se pone la clave API obtenida en el panel de APIYI, y en base_url se pone https://api.apiyi.com/v1.
- Invocar Gemini 4 Neon: el SDK de OpenAI apunta a la
base_urlanterior, se llamachat.completions.create,modelse rellena congemini-4-neonymessagesrecibe el array de conversación; si necesitas los parámetros nativos, cambia a la solicitud con formato nativo de Gemini. - Invocar GPT-6.2 Astra: con el mismo cliente SDK se llama
responses.create,modelse rellena congpt-6.2-astray el contenido de la indicación se pasa eninput; si reutilizas código antiguo, también puedes usarchat.completions.create. - Invocar Claude Fable 5.2: en escenarios habituales se llama
chat.completions.createconmodel=claude-fable-5-2; cuando necesitas razonamiento profundo, cambia aclaude-fable-5-2-thinking; cuando necesitas los parámetros nativos de Anthropic, usa el formato messages. - Registrar el consumo: después de cada llamada, anota los números de tokens de entrada, salida y caché que devuelve la respuesta; los necesitarás luego para calcular el coste por tarea.
🚀 Inicio rápido: te recomendamos reclamar primero el crédito de prueba gratuito para nuevos usuarios en APIYI apiyi.com y ejecutar los tres modelos con el mismo lote de muestras de negocio. Con una sola clave API puedes cambiar entre los tres modelos, con facturación por uso, lo que facilita comparar resultados y costes bajo carga real.
Recomendación por escenario: analicemos cada caso según lo que más importa en este encargo
El punto de partida para elegir no es “qué modelo es el mejor”, sino qué es lo que más importa en esta tarea. A continuación, según tres necesidades habituales, indicamos qué columna de información conviene revisar primero.
Escenarios en los que prima la profundidad de razonamiento
- Análisis complejo y razonamiento multietapa: revisa primero los datos de Artificial Analysis y Vals Index citados en el anuncio de Gemini 4 Neon; ten en cuenta que los 61 puntos corresponden al nivel xhigh.
- Tareas que requieren un nivel alto de razonamiento: Claude Fable 5.2 tiene un ID de modelo independiente,
claude-fable-5-2-thinking, que puedes comparar con la versión sin razonamiento usando el mismo precio unitario. - Si necesitas GPT-6.2 Astra: los materiales de referencia no incluyen datos de ranking para este modelo, así que conviene validarlo directamente con muestras de tu propio negocio.
Escenarios en los que prima el agente de programación
- Entradas de repositorios de código extensos y salidas de parches largos: la mejora de FrontierCode 2.0 y el límite de salida de 128K mencionados en el anuncio de Claude Fable 5.2 son información útil como referencia.
- Llamadas a herramientas y estado multironda con bastante peso: el endpoint
responsesrecomendado por GPT-6.2 Astra se adapta mejor a este tipo de interacciones; la forma de integración en sí ya es un punto a considerar. - Si ya tienes código compatible con OpenAI: los tres modelos pueden usar el endpoint
chat, así que el costo de migración resulta relativamente controlable.
Escenarios en los que prima el precio unitario con contexto largo
- Entradas ultra largas persistentes: confirma primero si la solicitud supera el umbral de tramo de 272000 tokens de GPT-6.2 Astra; al superarlo, el precio unitario se calcula según el otro tramo.
- Alta tasa de aciertos de caché: el precio unitario de lectura de caché varía bastante entre los tres modelos; si tu negocio tiene una alta tasa de aciertos de caché, debes calcular por separado ese precio unitario.
- Contexto de nivel 1M: tanto Gemini 4 Neon como Claude Fable 5.2 indican contexto de nivel de 1 millón de tokens, pero sus precios unitarios de entrada y salida son distintos, así que debes calcular según tu propia proporción de entrada y salida.
Recomendación de decisión: revisar las tres columnas por separado y validar después con poco tráfico
Revisar la información de las tres columnas por separado es la forma más sencilla de evitar errores al elegir un modelo. La columna de capacidades solo indica «el rendimiento en un ranking concreto y en un nivel concreto»; la columna de precios solo indica «el precio por millón de tokens»; la columna de endpoints solo indica «cómo hay que escribir el código». Ninguna de las tres columnas, por sí sola, permite concluir «qué modelo usar para esta tarea».
Lo más práctico es calcular primero el costo por tarea: toma una solicitud típica de tu negocio para estimar el número de tokens de entrada, salida y caché, multiplícalos por el precio correspondiente de cada uno de los tres modelos y, en el caso de GPT-6.2 Astra, además determina si se superan los 272000 tokens. Después mide la calidad con el mismo lote de muestras y analiza el costo y la calidad en conjunto, en lugar de mirar solo el ranking o solo el precio unitario.
💡 Recomendación de elección: qué modelo escoger depende de la estructura de tu tarea y de tus requisitos de calidad. Te sugiero usar una clave API unificada a través de APIYI apiyi.com para comparar los tres modelos con poco tráfico, calcular el costo según el uso real y, a partir de ahí, decidir el modelo principal y el modelo de respaldo.
Preguntas frecuentes (FAQ)
P1: ¿Qué son Gemini 4 Neon, GPT-6.2 Astra y Claude Fable 5.2, respectivamente?
Los tres son Modelos de Lenguaje Grande de nueva generación que surgieron alrededor de noviembre de 2026: Gemini 4 Neon fue anunciado por Google el 2026-11-18, Claude Fable 5.2 fue publicado por Anthropic el 9 de noviembre y GPT-6.2 Astra ya figura en la tabla general de precios de APIYI. Los tres difieren en especificaciones de capacidad, forma de facturación y formato de endpoint.
P2: ¿Se pueden comparar directamente los puntajes de benchmark de los tres modelos?
No. Los datos de Gemini 4 Neon provienen de Artificial Analysis y Vals Index, citados en el anuncio de Google; los de Claude Fable 5.2 corresponden a FrontierCode 2.0, citado en el anuncio. Ambos miden capacidades diferentes. GPT-6.2 Astra no tiene datos de benchmark en los materiales de esta ocasión. No existe una relación de conversión entre benchmarks distintos.
P3: ¿Cuándo se publicaron estos tres modelos?
Según el registro de cambios de APIYI del 2026-11-10, Anthropic publicó Claude Fable 5.2 el 9 de noviembre; Google publicó el anuncio de Gemini 4 Neon el 2026-11-18. Los precios de este artículo se verificaron el 2026-11-20; la versión de la tabla general consultada se actualizó el 2026-11-19 a las 10:59 (UTC+8).
P4: ¿Cuál es exactamente el precio de salida de GPT-6.2 Astra después de superar los 272000 tokens?
Las dos fuentes lo expresan de forma diferente: la tabla general de APIYI indica que, después de superar los 272000 tokens, la entrada es `16`, pero no indica el precio de salida; la interfaz de precios especifica que, al superar los 272000 tokens, la salida se cobra a `60` y la lectura de caché a `0.8`. Este artículo conserva ambas referencias en paralelo; para la facturación real, se recomienda guiarse por la interfaz de precios en el momento de la llamada.
P5: ¿Cómo invocar rápidamente estos tres modelos mediante API?
Se recomienda usar una plataforma de agregación multimodelo para un acceso unificado:
1. Visite APIYI apiyi.com, regístrese y obtenga una clave API y una cuota de prueba gratuita
2. Rellene `base_url` siempre con `https://api.apiyi.com/v1`
3. Elija el endpoint según el modelo: Neon usa chat o el formato nativo de Gemini, Astra usa responses (también puede usar chat) y Fable usa chat o messages
Con una sola clave puede cambiar entre los tres modelos, lo que facilita compararlos con el mismo lote de muestras.
P6: ¿Cómo verificar por cuenta propia el precio de lista de APIYI?
Puede consultar al mismo tiempo la tabla general de modelos y la interfaz de precios de APIYI apiyi.com. La interfaz de precios usa multiplicadores: `model_ratio` igual a 1 equivale a una entrada de 2 USD por millón de tokens; la salida equivale a la entrada multiplicada por `completion_ratio`; la lectura de caché equivale a la entrada multiplicada por `cache_ratio`. Por ejemplo, con esta conversión, `gemini-4-neon` queda en entrada 3, salida 15 y lectura de caché 0.15.
P7: ¿La versión con razonamiento de Claude Fable 5.2 tiene un costo adicional?
`claude-fable-5-2` y `claude-fable-5-2-thinking` tienen el mismo precio unitario en la tabla general: entrada 8, lectura de caché 0.2 y salida 40. El precio unitario no cambia, pero el proceso de razonamiento genera tokens de salida adicionales, por lo que el costo real variará según el uso.
P8: ¿Qué limitaciones hay que tener en cuenta en estos tres modelos?
– **Datos de capacidad**: los datos de Neon y Fable provienen de anuncios citados o parafraseados, no de pruebas independientes; Astra no cuenta con datos públicos de rankings.
– **Tramos de precios**: Astra tiene un umbral de 272000 tokens y las dos fuentes lo describen de forma distinta.
– **Vigencia de precios**: el `gemini-4-carbon` de la misma familia corresponde al precio introductorio de Google hasta el 30 de noviembre; desde diciembre, el precio estándar de Google es entrada 4 y salida 20.
– **Diferencias entre endpoints**: los endpoints recomendados para los tres modelos son distintos; al migrar, no basta con cambiar el nombre del modelo.
Gemini 4 Neon, GPT-6.2 Astra y Claude Fable 5.2: puntos clave
- Tres columnas separadas: la capacidad anunciada, el precio de catálogo de APIYI y el endpoint de invocación son independientes; no se combinan en una única puntuación.
- Criterios de ranking distintos: Neon cita Artificial Analysis y Vals; Fable cita FrontierCode; no son comparables entre sí.
- El precio de Neon se puede verificar: el multiplicador del endpoint de precios se traduce en entrada 3, lectura de caché 0.15 y salida 15.
- Ojo con los tramos de Astra: por encima de 272000 tokens, la entrada es 16; el precio de salida no aparece en la tabla general, pero el endpoint de precios indica 60.
- Precio unitario uniforme en Fable: la versión normal y la versión de razonamiento comparten entrada 8, lectura de caché 0.2 y salida 40.
- Endpoints distintos: Neon usa chat o nativo; Astra recomienda responses; Fable usa chat o messages.
- Cómo empezar: accede a los tres modelos con una sola clave API a través de APIYI apiyi.com y compáralos con el mismo lote de muestras y poco tráfico.
Resumen
La clave para comparar Gemini 4 Neon, GPT-6.2 Astra y Claude Fable 5.2 es no mezclar tres tipos de información:
- Columna de capacidades: mira solo los rankings y niveles citados en los anuncios; Neon y Fable usan criterios de datos distintos, y Astra requiere verificación propia.
- Columna de precios: toma como referencia el precio de estantería de APIYI, y presta atención al precio unitario de lectura de caché, al tramo de 272000 tokens de Astra y a las diferencias entre las dos fuentes.
- Columna de endpoints: los tres endpoints recomendados son distintos entre sí; el base_url es uniformemente
https://api.apiyi.com/v1, y la ruta y el cuerpo de la petición se escriben por separado según el modelo.
Primero define si este pedido valora más la profundidad de razonamiento, el agente de programación o el precio unitario de contexto largo; después revisa la columna correspondiente, y finalmente valida con muestras reales en tráfico pequeño. Recomendamos obtener la cuota gratuita a través de APIYI apiyi.com y completar la prueba comparativa de los tres modelos bajo la misma Key.
📚 Referencias
-
Tabla general de modelos de APIYI: ID de modelo y precio de estantería (versión verificada, actualizada el 2026-11-19 10:59 UTC+8)
- Enlace:
docs.apiyi.com/models.md - Descripción: consulta el precio unitario por tramos de modelos como
gpt-6.2-astrayclaude-fable-5-2
- Enlace:
-
Interfaz de precios de APIYI: precios en tiempo real en forma de multiplicador (versión
shell-api-modelmak-v1)- Enlace:
api.apiyi.com/api/pricing - Descripción: convierte el precio unitario en dólares usando
model_ratio,completion_ratioycache_ratio
- Enlace:
-
Anuncio de Google Gemini 4 Neon: publicado el 2026-11-18
- Descripción: incluye precio de lista, contexto de 1 millón y los datos citados de Artificial Analysis y Vals Index
-
Registro de cambios de APIYI (2026-11-10): reproduce la información del lanzamiento de Anthropic Claude Fable 5.2
- Descripción: incluye ajuste de precios, datos de FrontierCode 2.0, contexto de 1M y salida de 128K
Autor: equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página principal del sitio oficial de APIYI para obtener más material sobre integración de modelos y verificación de precios