Note de l’auteur : les capacités annoncées de Gemini 4 Neon, GPT-6.2 Astra et Claude Fable 5.2, les prix catalogue APIYI et les points de terminaison d’appel sont répartis en trois colonnes à vérifier séparément, pour vous aider à choisir en fonction de la profondeur de raisonnement, de l’agent de codage ou du prix unitaire en contexte long.
En novembre 2026, trois éditeurs ont publié de nouveaux modèles en l’espace de dix jours : Anthropic a lancé Claude Fable 5.2 le 9 novembre, Google a annoncé Gemini 4 Neon le 18 novembre, et GPT-6.2 Astra figure déjà dans le tableau global des prix d’APIYI. L’erreur la plus fréquente au moment du choix consiste à mélanger les classements des trois éditeurs, leurs trois grilles tarifaires et leurs trois interfaces distinctes pour en tirer une conclusion du type « lequel est le plus avantageux ».
Ce n’est pas un article de classement. Les classements viennent de sources différentes, les paliers tarifaires diffèrent et le format des points de terminaison aussi ; les convertir de force en un score unique ne ferait qu’induire en erreur. Cet article décompose les trois modèles en trois colonnes à vérifier séparément : les données de capacités citées dans les documents officiels ou les annonces, les prix catalogue APIYI sur apiyi.com (relevés au 2026-11-20), et le point de terminaison à utiliser pour chaque modèle.
L’essentiel : après avoir lu cet article, vous saurez, selon que cette tâche précise privilégie la profondeur de raisonnement, l’agent de codage ou le prix unitaire en contexte long, quel modèle tester en premier, et avec quelle interface l’appeler.
Points clés de Gemini 4 Neon, GPT-6.2 Astra et Claude Fable 5.2
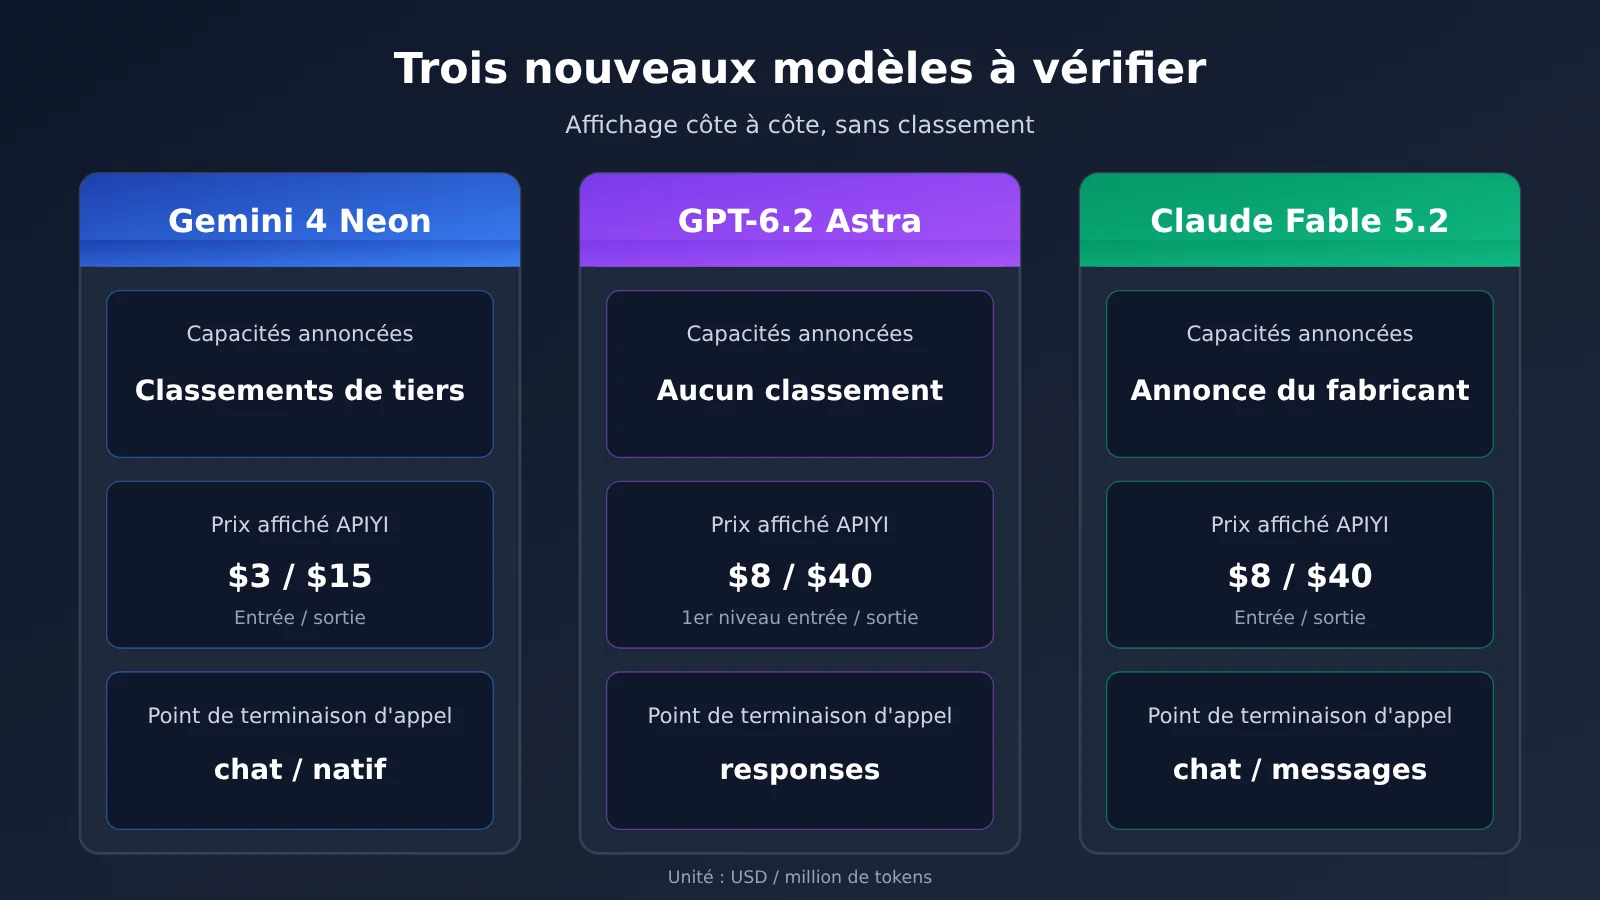
Commençons par un tableau de lecture rapide. Les informations de ces trois lignes proviennent de trois types de sources différents ; le tableau se contente de les présenter côte à côte, sans additionner quoi que ce soit horizontalement.
| Dimension | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Source des données de capacités | Classements de tiers cités dans l’annonce de Google (Artificial Analysis, Vals) | Les documents de référence ne couvrent pas les chiffres de classement de l’annonce | Annonce d’Anthropic relayée par le journal des mises à jour d’APIYI (FrontierCode 2.0, etc.) |
| Prix catalogue APIYI (USD / million de tokens) | Entrée 3, lecture de cache 0.15, sortie 15 |
Premier palier : entrée 8, lecture de cache 0.4, sortie 40 ; autres paliers pour le contexte long |
Entrée 8, lecture de cache 0.2, sortie 40 |
| Endpoint recommandé | chat ou format natif Gemini | responses (recommandé), chat également pris en charge | chat ou messages |
| Contexte | 1 million de tokens | Ligne de démarcation tarifaire fixée à 272 000 tokens | Contexte de 1M, jusqu’à 128K en sortie |
Ce qu’il faut vérifier en détail sur les trois modèles
Sur la colonne des capacités, les trois modèles ne sont pas mesurés avec la même règle. Les chiffres de Gemini 4 Neon viennent de classements de tiers que Google cite dans son annonce ; ceux de Claude Fable 5.2 viennent d’une publication d’Anthropic relayée par le journal des mises à jour d’APIYI ; et GPT-6.2 Astra n’a aucun chiffre de classement correspondant dans les documents de référence de cette analyse. Les classements diffèrent, les jeux de tests diffèrent : impossible de comparer le pourcentage Vals Index de Neon et le pourcentage FrontierCode de Fable sur une même échelle.
La colonne des prix paraît la plus parlante, mais là encore, on ne peut pas se contenter de comparer la taille des nombres. Les trois modèles n’ont ni le même tarif de lecture de cache, ni les mêmes paliers de contexte long, ni la même facturation du mode réflexion. Le coût réel d’une tâche dépend du ratio entrée/sortie, du taux de succès du cache et du fait de franchir ou non la ligne de démarcation tarifaire. La colonne des endpoints, elle, détermine directement la façon dont on écrit le code : choisir le mauvais endpoint conduit à des paramètres incompatibles ou à des fonctionnalités manquantes.
Différences de performances entre Gemini 4 Neon, GPT-6.2 Astra et Claude Fable 5.2 (d’après les annonces)
Cette section rassemble uniquement les informations sur les capacités qui apparaissent dans les annonces des fournisseurs ou dans leur reprise. Les données ci-dessous ne proviennent pas de tests réalisés par APIYI ; merci de conserver l’indication de source lorsque vous les citez.
| Modèle | Donnée | Valeur | Nature de la source |
|---|---|---|---|
| Gemini 4 Neon | Artificial Analysis Intelligence Index (xhigh) | 61, 3e au classement général | Classement d’un tiers cité dans l’annonce de Google |
| Gemini 4 Neon | Vals Index | 2e, 70,9 % | Classement d’un tiers cité dans l’annonce de Google |
| Claude Fable 5.2 | FrontierCode 2.0 | De 32,4 % à 49,1 % | Reprise de l’annonce (journal des mises à jour d’APIYI) |
| Claude Fable 5.2 | Vitesse de génération | Jusqu’à 30 % plus rapide | Reprise de l’annonce (journal des mises à jour d’APIYI) |
| GPT-6.2 Astra | Classements publics | Non fourni dans les références | — |
Comment lire les classements de raisonnement de Gemini 4 Neon
Dans son annonce du 18 novembre 2026, Google cite un score de 61 au Artificial Analysis Intelligence Index en mode xhigh, une 3e place au classement général, ainsi qu’une 2e place et un score de 70,9 % au Vals Index. Ces deux indices sont des indices composites, centrés sur l’évaluation des tâches de raisonnement général et de connaissances. À noter que xhigh est un niveau élevé d’intensité de raisonnement ; les performances lors d’appels quotidiens à un niveau inférieur ne sont pas nécessairement alignées sur ce score.
Comment lire les données de codage de Claude Fable 5.2
Les données clés de Claude Fable 5.2 concernent FrontierCode 2.0, qui passe de 32,4 % sur la génération précédente à 49,1 % ; il s’agit d’une évaluation orientée vers les tâches de codage. L’annonce indique également une génération jusqu’à 30 % plus rapide, avec une fenêtre de contexte de 1M et une sortie maximale de 128K, ce qui correspond mieux aux scénarios d’agents de codage qui nécessitent l’entrée de grandes bases de code et la sortie de longs patchs. FrontierCode et Vals mesurent des capacités différentes ; il n’existe pas de relation de conversion entre les deux ensembles de chiffres.
Comment vérifier les capacités de GPT-6.2 Astra
Les références fournies cette fois-ci ne contiennent aucune donnée de classement issue d’une annonce pour GPT-6.2 Astra ; cette case reste donc vide, sans extrapolation. Si votre tâche exige des capacités précises d’Astra, la démarche la plus sûre est de comparer directement avec un faible volume de trafic et vos propres échantillons métier, plutôt que d’extrapoler à partir des classements d’autres modèles.
Vérification des prix de Gemini 4 Neon, GPT-6.2 Astra et Claude Fable 5.2 (prix catalogue APIYI)
Les prix de cette section ont été vérifiés le 2026-11-20 sur APIYI apiyi.com, à partir de deux sources : le tableau récapitulatif des modèles (version mise à jour du 2026-11-19 10:59 UTC+8) et l’interface de tarification (version shell-api-modelmak-v1). L’unité est le dollar par million de tokens.
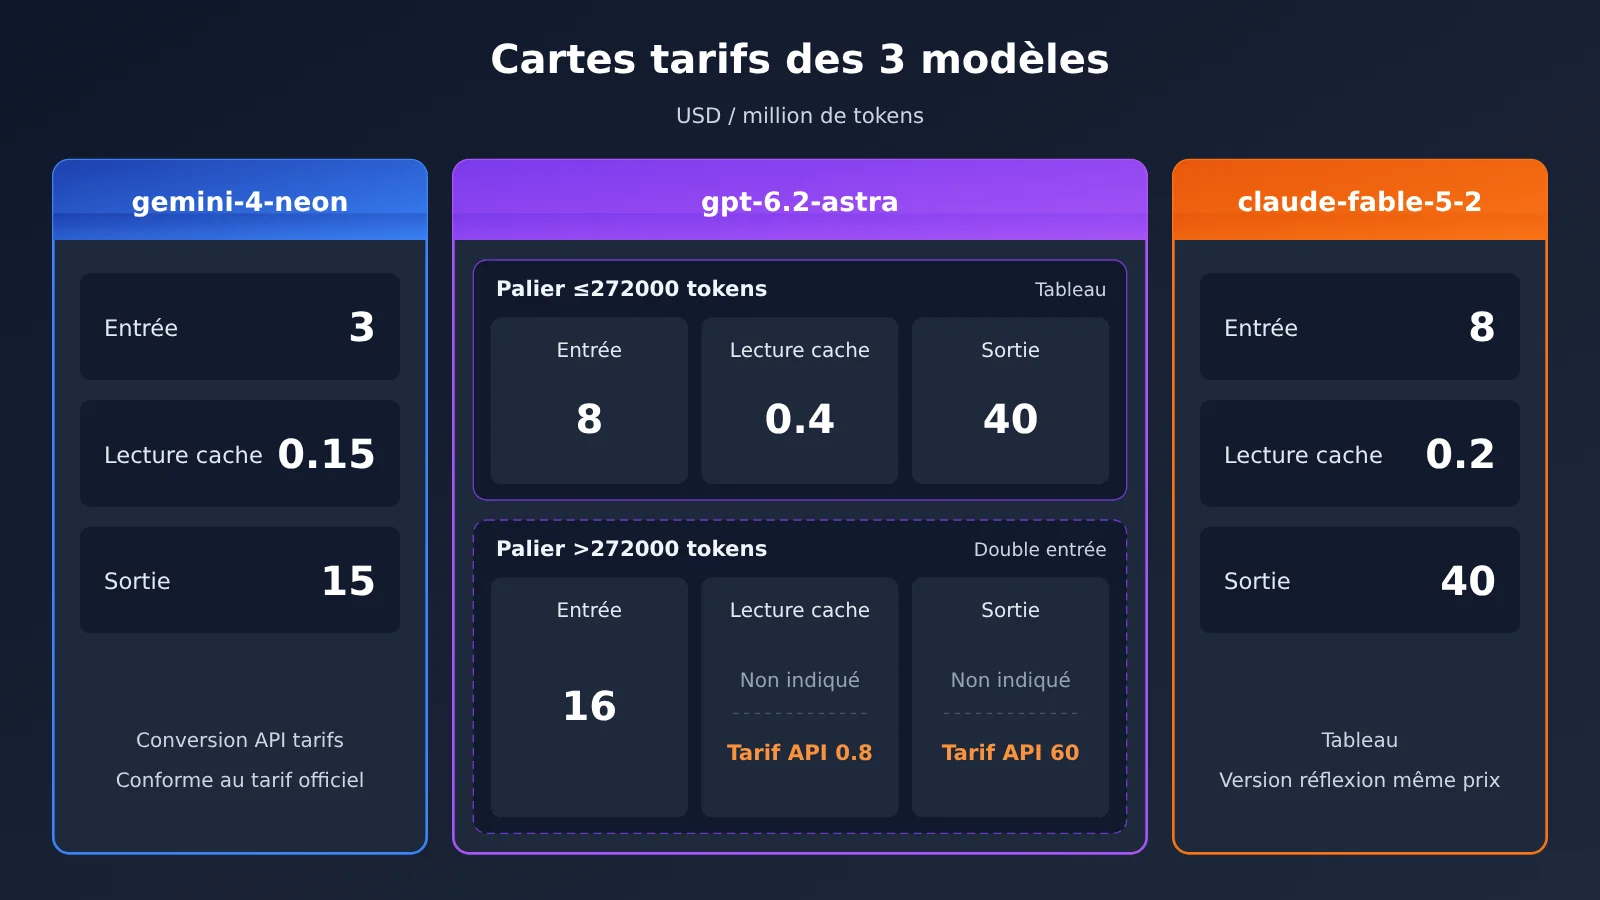
| ID du modèle | Entrée | Lecture du cache | Sortie | Source des données |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
conversion via l’interface de tarification, identique au prix annoncé par Google |
gpt-6.2-astra (premier palier) |
8 |
0.4 |
40 |
tableau récapitulatif |
gpt-6.2-astra (>272000 tokens) |
16 |
non renseigné dans le tableau / interface de tarification 0.8 |
non renseigné dans le tableau / interface de tarification 60 |
tableau récapitulatif et interface de tarification, côte à côte |
claude-fable-5-2 |
8 |
0.2 |
40 |
tableau récapitulatif |
claude-fable-5-2-thinking |
8 |
0.2 |
40 |
tableau récapitulatif |
Comment convertir les multiplicateurs de l’interface de tarification en dollars
L’interface de tarification d’APIYI exprime les prix sous forme de multiplicateurs, avec la convention suivante : lorsque model_ratio vaut 1, cela correspond à une entrée à 2 dollars par million de tokens. Prenons l’exemple de gemini-4-neon : model_ratio vaut 1.5, donc l’entrée est à 1.5 × 2 = 3 ; completion_ratio vaut 5, donc la sortie est à 3 × 5 = 15 ; cache_ratio vaut 0.05, donc la lecture du cache est à 3 × 0.05 = 0.15. Le résultat de cette conversion correspond exactement au tarif officiel annoncé par Google le 2026-11-18, vous pouvez donc utiliser cette formule pour vérifier par vous-même.
Pourquoi les paliers de contexte long de GPT-6.2 Astra sont écrits à deux endroits
GPT-6.2 Astra utilise 272000 tokens comme seuil de palier. Le tableau récapitulatif indique le prix du premier palier, ainsi que l’entrée à 16 au-delà de 272000 tokens, mais il ne donne pas le prix de sortie pour ce palier ; l’interface de tarification, de son côté, précise qu’au-delà de 272000 tokens la sortie est facturée à 60 et la lecture du cache à 0.8. Les deux sources d’information sont conservées côte à côte, et cet article ne les fusionne pas en un seul chiffre. Si vos requêtes dépassent fréquemment 272000 tokens, je vous conseille de vous fier au résultat renvoyé par l’interface de tarification au moment de l’appel.
Informations sur la baisse de prix de Claude Fable 5.2
D’après le journal des mises à jour d’APIYI du 10 novembre 2026, Anthropic annonce pour Claude Fable 5.2 des prix d’entrée et de sortie de 8 et 40, soit 20 % de moins que la version 5.1, avec une lecture de cache à 0,2. claude-fable-5-2 et claude-fable-5-2-thinking affichent le même prix dans le tableau récapitulatif : pas besoin de recalculer un tarif unitaire à part si vous optez pour la version réflexion, mais les tokens de sortie produits par le raisonnement apparaîtront bien dans l’usage.
Prix de référence dans la série Gemini 4
Si vous hésitez au sein de la série Gemini 4, voici les prix affichés de quelques modèles pour vous aider à comparer. Le prix de gemini-4-carbon correspond au tarif de lancement de Google valable jusqu’au 30 novembre 2026 ; Google a annoncé un tarif standard à partir du 1er décembre, avec une entrée à 4 et une sortie à 20. Le moment venu, vérifiez sur le tableau récapitulatif du jour si le prix affiché a été ajusté.
| ID du modèle | Entrée | Lecture de cache | Sortie | Remarque |
|---|---|---|---|---|
gemini-4-carbon |
2 |
0.1 |
10 |
Correspond au tarif de lancement Google (jusqu’au 30 novembre 2026) |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
— |
gemini-4-argon |
2 |
0.1 |
10 |
Prix du tableau récapitulatif |
Points de terminaison d’API pour Gemini 4 Neon, GPT-6.2 Astra et Claude Fable 5.2
Les trois modèles recommandent des points de terminaison différents : il n’existe pas de code unique capable de gérer les trois d’un coup. Le seul élément commun, c’est le base_url : lors d’un appel via APIYI, on renseigne toujours https://api.apiyi.com/v1, puis on choisit le chemin et le format de requête selon le modèle.
| Modèle | Point de terminaison recommandé | Point de terminaison alternatif | Points clés de la mise en œuvre |
|---|---|---|---|
| Gemini 4 Neon | chat (compatible OpenAI /chat/completions) |
format natif Gemini | Les projets qui utilisent déjà le SDK OpenAI passent par chat ; lorsqu’il faut des paramètres natifs Gemini, on passe par le format natif |
| GPT-6.2 Astra | responses (/responses) |
chat (/chat/completions) |
responses est recommandé, le corps de la requête utilise le champ input ; chat utilise le champ messages |
| Claude Fable 5.2 | chat (/chat/completions) |
messages (format Anthropic Messages) | Lorsqu’on a besoin des capacités natives d’Anthropic, on passe par messages ; pour la version réflexion, utilisez claude-fable-5-2-thinking |
Pourquoi responses est recommandé pour GPT-6.2 Astra
responses est le nouveau format d’interface d’OpenAI : il gère plus complètement les états multi-tours, les appels d’outils et autres capacités. C’est pourquoi Astra est plutôt dirigé vers ce point de terminaison. Le point de terminaison chat reste disponible, adapté aux projets qui disposent déjà de beaucoup de code au format chat et qui ne souhaitent pas refactoriser tout de suite. Les champs du corps de requête diffèrent entre les deux points de terminaison : lors d’une migration, ne changez pas seulement le nom du modèle.
Pourquoi Neon et Fable ont chacun deux entrées
Gemini 4 Neon et Claude Fable 5.2 prennent tous deux en charge à la fois le point de terminaison chat compatible OpenAI et le format natif de leur fournisseur respectif. L’avantage du point de terminaison chat, c’est que le code peut partager un même SDK avec d’autres modèles ; l’avantage du format natif, c’est de pouvoir utiliser les paramètres spécifiques au fournisseur. Si votre activité se limite à des conversations et de la génération classiques, le point de terminaison chat suffit généralement.
Prise en main rapide de Gemini 4 Neon, GPT-6.2 Astra et Claude Fable 5.2
Comme demandé dans cet article, nous ne donnons pas ici un code générique : nous listons plutôt les paramètres clés pour chaque modèle. La configuration commune aux trois modèles est la suivante : api_key contient la clé récupérée dans la console APIYI, et base_url vaut https://api.apiyi.com/v1.
- Appeler Gemini 4 Neon : pointez le SDK OpenAI vers le
base_urlci-dessus, appelezchat.completions.create, renseignezmodelavecgemini-4-neonet passez le tableau de conversation dansmessages; pour utiliser les paramètres natifs, passez plutôt par une requête au format natif Gemini. - Appeler GPT-6.2 Astra : avec le même client SDK, appelez
responses.create, renseignezmodelavecgpt-6.2-astraet transmettez le contenu de l’invite viainput; si vous réutilisez l’ancien code, vous pouvez aussi passer parchat.completions.create. - Appeler Claude Fable 5.2 : dans les cas d’usage standard, appelez
chat.completions.createavecmodeldéfini surclaude-fable-5-2; pour une réflexion approfondie, utilisez plutôtclaude-fable-5-2-thinking; pour les paramètres natifs Anthropic, passez par le formatmessages. - Suivre l’utilisation : après chaque appel, notez les nombres de tokens d’entrée, de sortie et mis en cache renvoyés. Vous en aurez besoin plus tard pour calculer le coût par tâche.
🚀 Démarrage rapide : nous vous conseillons de commencer par récupérer vos crédits d’essai gratuits pour nouveaux utilisateurs sur APIYI apiyi.com, puis de faire tourner les trois modèles sur le même jeu d’échantillons métier. Une seule clé API suffit pour passer d’un modèle à l’autre, avec une facturation à l’usage, ce qui facilite la comparaison des résultats et des coûts dans des conditions de charge réelles.
Recommandations d’usage : à voir selon l’objectif de la tâche
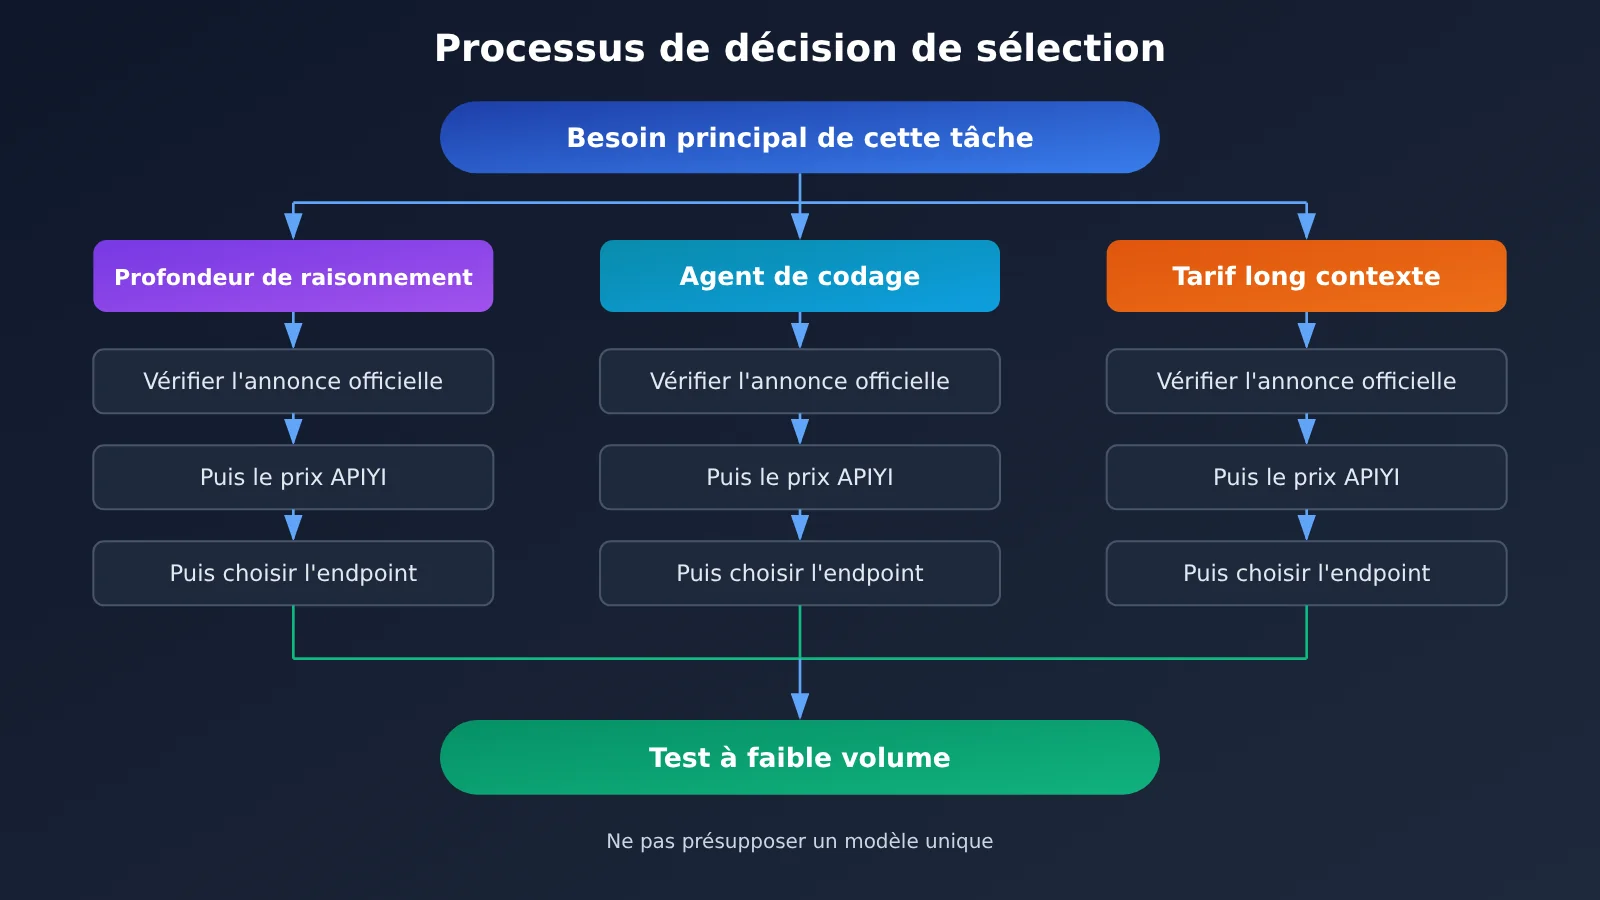
Le point de départ pour choisir n’est pas « quel modèle est le meilleur », mais ce qui compte le plus pour cette tâche précise. Voici, pour trois besoins courants, la colonne d’informations à consulter en priorité.
Quand la profondeur de raisonnement prime
- Analyse complexe et raisonnement en plusieurs étapes : consultez d’abord les données Artificial Analysis et Vals Index citées dans l’annonce de Gemini 4 Neon, en gardant en tête que le score de 61 correspond au niveau xhigh.
- Besoins d’un niveau de raisonnement élevé : Claude Fable 5.2 dispose d’un ID de modèle distinct,
claude-fable-5-2-thinking, ce qui permet de le tester face à la version sans réflexion au même tarif unitaire. - Si GPT-6.2 Astra vous intéresse : les sources ne fournissent pas de données de classement pour ce modèle ; mieux vaut le valider directement avec vos échantillons métier.
Quand l’agent de codage prime
- Entrées de gros dépôts de code, sorties de longs patches : les gains FrontierCode 2.0 rapportés dans l’annonce de Claude Fable 5.2 et la limite de sortie de 128K sont des éléments utiles à prendre en compte.
- Appels d’outils et états multi-tours lourds : le point de terminaison responses recommandé pour GPT-6.2 Astra est mieux adapté à ce type d’interactions ; la façon de l’intégrer devient en soi un critère de choix.
- Si vous avez déjà du code compatible OpenAI : les trois modèles fonctionnent via le point de terminaison chat, ce qui limite le coût de migration.
Quand le prix du contexte long prime
- Entrées très longues en permanence : vérifiez d’abord si la requête dépasse le seuil de 272000 tokens de GPT-6.2 Astra, car au-delà le tarif unitaire bascule sur un autre palier.
- Taux de succès du cache élevé : les prix de lecture du cache diffèrent nettement entre les trois modèles ; si votre activité a un fort taux de succès du cache, calculez ce prix de lecture séparément.
- Contexte de l’ordre du million : Gemini 4 Neon et Claude Fable 5.2 annoncent tous deux un contexte d’un million de tokens, mais avec des prix d’entrée et de sortie différents : il faut calculer selon votre propre ratio entrée/sortie.
Recommandation de décision : vérifier les trois colonnes séparément, puis valider sur un faible volume
Comparer séparément les informations des trois colonnes est la méthode la plus simple pour éviter une erreur de sélection. La colonne « capacités » indique uniquement « les performances sur un classement donné, à un niveau donné » ; la colonne « prix » indique uniquement « le prix unitaire par million de tokens » ; la colonne « endpoint » indique uniquement « comment écrire le code ». Aucune colonne, à elle seule, ne permet de déduire « quel modèle utiliser pour cette tâche ».
Une approche plus utile consiste à calculer d’abord le coût par tâche : à partir d’une requête typique de votre activité, estimez le nombre de tokens en entrée, en sortie et en cache, puis multipliez chacun par le prix unitaire correspondant des trois modèles. Pour GPT-6.2 Astra, il faut en plus déterminer si l’on dépasse les 272000 tokens. Ensuite, testez la qualité sur le même lot d’échantillons et examinez le coût et la qualité ensemble, plutôt que de regarder uniquement le classement ou uniquement le prix unitaire.
💡 Conseil de choix : le modèle à retenir dépend de la structure de votre tâche et de vos exigences de qualité. Je vous suggère de comparer les trois modèles sur un faible volume via APIYI apiyi.com avec une clé unique, de calculer les coûts sur la base de votre consommation réelle, puis de choisir le modèle principal et le modèle de secours.
FAQ — Questions fréquentes
Q1 : Que sont respectivement Gemini 4 Neon, GPT-6.2 Astra et Claude Fable 5.2 ?
Les trois sont des grands modèles de langage de nouvelle génération apparus autour de novembre 2026 : Gemini 4 Neon a été annoncé par Google le 2026-11-18, Claude Fable 5.2 a été publié par Anthropic le 9 novembre, et GPT-6.2 Astra figure déjà dans le tableau tarifaire d’APIYI. Leurs périmètres de capacités, leurs modes de tarification et leurs formats d’endpoint diffèrent tous les trois.
Q2 : Les scores de classement des trois modèles sont-ils directement comparables ?
Non. Les données de Gemini 4 Neon proviennent d’Artificial Analysis et du Vals Index cités dans l’annonce de Google ; celles de Claude Fable 5.2 proviennent de FrontierCode 2.0, repris dans l’annonce. Les deux mesurent des capacités différentes ; GPT-6.2 Astra n’a aucune donnée de classement dans les présentes sources. Il n’existe pas de relation de conversion entre classements distincts.
Q3 : Quand les trois modèles sont-ils sortis ?
D’après le journal de mise à jour d’APIYI du 2026-11-10, Anthropic a publié Claude Fable 5.2 le 9 novembre ; Google a publié l’annonce de Gemini 4 Neon le 2026-11-18. Les prix de cet article ont été vérifiés le 2026-11-20 ; la version du tableau récapitulatif de référence a été mise à jour le 2026-11-19 à 10:59 (UTC+8).
Q4 : Quel est exactement le prix de sortie de GPT-6.2 Astra au-delà de 272000 tokens ?
Les deux sources ne le formulent pas de la même manière : le tableau récapitulatif d’APIYI indique une entrée à `16` au-delà de 272000 tokens, mais ne précise pas le prix de sortie ; l’interface de tarification indique que, au-delà de 272000 tokens, la sortie est à `60` et la lecture de cache à `0.8`. Cet article conserve les deux côte à côte ; pour la facturation réelle, mieux vaut se fier à l’interface de tarification au moment de l’appel.
Q5 : Comment appeler rapidement ces trois modèles via API ?
Je recommande de passer par une plateforme d’agrégation multi-modèles pour un accès unifié :
1. Rendez-vous sur APIYI apiyi.com pour créer un compte, récupérer une clé API et un quota de test gratuit
2. Renseignez `https://api.apiyi.com/v1` comme base_url dans tous les cas
3. Choisissez l’endpoint selon le modèle : Neon passe par chat ou par le format natif Gemini, Astra par responses (ou aussi chat), Fable par chat ou messages
Une seule clé suffit pour basculer entre les trois modèles, ce qui facilite la comparaison sur un même lot d’échantillons.
Q6 : Comment vérifier soi-même les prix catalogue d’APIYI ?
Vous pouvez consulter en parallèle le tableau des modèles et l’interface de tarification d’APIYI apiyi.com. L’interface de tarification s’exprime en coefficients : `model_ratio` à 1 correspond à 2 USD par million de tokens en entrée ; la sortie vaut l’entrée multipliée par `completion_ratio` ; la lecture de cache vaut l’entrée multipliée par `cache_ratio`. Par exemple, `gemini-4-neon` donne ainsi 3 en entrée, 15 en sortie et 0.15 en lecture de cache.
Q7 : La version « réflexion » de Claude Fable 5.2 est-elle facturée en plus ?
`claude-fable-5-2` et `claude-fable-5-2-thinking` ont le même prix unitaire dans le tableau récapitulatif : entrée 8, lecture de cache 0.2, sortie 40. Le prix unitaire ne change pas, mais le processus de réflexion génère des tokens de sortie supplémentaires, donc le coût réel varie selon l’usage.
Q8 : Quelles limitations faut-il garder à l’esprit avec ces trois modèles ?
– **Données de capacités** : les données de Neon et de Fable proviennent de citations ou de reprises d’annonces, pas de tests indépendants ; Astra manque de données publiques de classement.
– **Paliers tarifaires** : Astra a un seuil à 272000 tokens, et les deux sources ne l’écrivent pas de la même manière.
– **Validité des prix** : le `gemini-4-carbon` de la même série correspond au tarif de lancement de Google jusqu’au 30 novembre ; à partir de décembre, le prix standard de Google est de 4 en entrée et 20 en sortie.
– **Différences d’endpoints** : les trois modèles recommandent des endpoints différents ; lors d’une migration, on ne peut pas se contenter de changer le nom du modèle.
Points clés (Key Takeaways) : Gemini 4 Neon, GPT-6.2 Astra, Claude Fable 5.2
- Trois colonnes à lire séparément : les capacités annoncées, le prix affiché chez APIYI et l’endpoint d’appel sont indépendants ; on ne les fusionne pas en un seul score.
- Référentiels de classement différents : Neon cite Artificial Analysis et Vals, Fable cite FrontierCode ; impossible de les comparer entre eux.
- Prix de Neon vérifiable soi-même : le multiplicateur de l’API de tarification se convertit en 3 en entrée, 0.15 en lecture de cache et 15 en sortie.
- Astra : attention aux paliers : au-delà de 272000 tokens, l’entrée est à 16 ; le prix de sortie n’apparaît pas dans le tableau récapitulatif, mais l’API de tarification indique 60.
- Fable : tarif uniforme : la version standard et la version « réflexion » sont toutes deux à 8 en entrée, 0.2 en lecture de cache et 40 en sortie.
- Endpoints tous différents : Neon passe par chat ou par l’endpoint natif, Astra recommande responses, Fable passe par chat ou par messages.
- Pour démarrer : accédez aux trois modèles avec une seule clé via APIYI apiyi.com, puis comparez-les sur un petit volume avec le même lot d’échantillons.
Récapitulatif
Comparer Gemini 4 Neon, GPT-6.2 Astra et Claude Fable 5.2 : l’essentiel est de ne pas mélanger les trois catégories d’informations.
- Colonne capacités : ne regardez que les classements et les niveaux cités dans les annonces officielles. Les données de Neon et de Fable ne sont pas mesurées selon la même méthode, et celles d’Astra demandent une vérification personnelle.
- Colonne prix : fiez-vous au prix catalogue APIYI, en prêtant attention au prix unitaire de lecture du cache, au palier de 272000 tokens d’Astra et aux écarts entre les deux sources.
- Colonne endpoints : les trois points de terminaison recommandés sont différents ; le base_url est uniformément
https://api.apiyi.com/v1, mais le chemin et le corps de requête s’écrivent séparément pour chaque modèle.
Commencez par déterminer ce qui compte le plus pour ce cas d’usage — profondeur de raisonnement, agent de codage ou prix unitaire en contexte long — puis vérifiez la colonne correspondante, et terminez par une validation à faible volume sur de vrais échantillons. Nous vous recommandons de récupérer un crédit gratuit via APIYI apiyi.com et de réaliser le test comparatif des trois modèles avec la même clé.
📚 Références
-
Tableau récapitulatif des modèles APIYI : ID de modèle et prix catalogue (version vérifiée dans cet article, mise à jour du 2026-11-19 10:59 UTC+8)
- Lien :
docs.apiyi.com/models.md - Détails : consulter le prix unitaire par palier des modèles
gpt-6.2-astra,claude-fable-5-2et autres
- Lien :
-
Interface de tarification APIYI : tarification en temps réel sous forme de multiplicateurs (version
shell-api-modelmak-v1)- Lien :
api.apiyi.com/api/pricing - Détails : convertir
model_ratio,completion_ratioetcache_ratioen prix unitaire en dollars
- Lien :
-
Annonce Google Gemini 4 Neon : publiée le 2026-11-18
- Détails : contient le prix affiché, le contexte d’un million de tokens, ainsi que les données citées d’Artificial Analysis et de Vals Index
-
Journal des mises à jour APIYI (2026-11-10) : reprend les informations de sortie d’Anthropic Claude Fable 5.2
- Détails : contient l’ajustement tarifaire, les données FrontierCode 2.0, le contexte 1M et la sortie 128K
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site officiel APIYI pour obtenir davantage de ressources sur l’intégration des modèles et la vérification des tarifs