Nota do autor: partindo da estrutura de custos do serviço de inferência, explicar por que o serviço de Token dá prejuízo com facilidade e apresentar uma lista executável para avaliar provedores de API de modelo.
O Token já virou item de venda em transmissões ao vivo, mas o desempenho financeiro de provedores de inferência como a SiliconFlow ainda não é animador. Em outra notícia, uma empresa considerou o Claude caro demais, migrou para o GLM e passou a usar 56 placas B200 para atender 2000 engenheiros, reduzindo o custo de IA em cerca de 90%. Olhando para as duas coisas juntas, a estrutura de custos do serviço de Token segue uma lógica própria. Este artigo parte da estrutura de custos do serviço de inferência para explicar por que o serviço de Token tende a dar prejuízo e, em seguida, chega ao que realmente importa para quem desenvolve: como avaliar se um provedor de API de modelo é confiável.
Não é mais uma análise de fofoca do setor. As análises do artigo giram em torno de variáveis técnicas, incluindo depreciação de GPU, utilização, a diferença de custo entre Prefill e Decode, KV Cache, taxa de acerto de cache e estratégias de subsídio. Depois da leitura, você pode aplicar tudo isso diretamente na avaliação de seleção do fornecedor.
Valor principal: ao terminar este artigo, você vai entender a composição de custos por trás do preço do Token e terá em mãos um método de avaliação de provedores em 6 dimensões. Também vai saber como usar dados reais de chamadas para verificar se a cobrança é transparente.
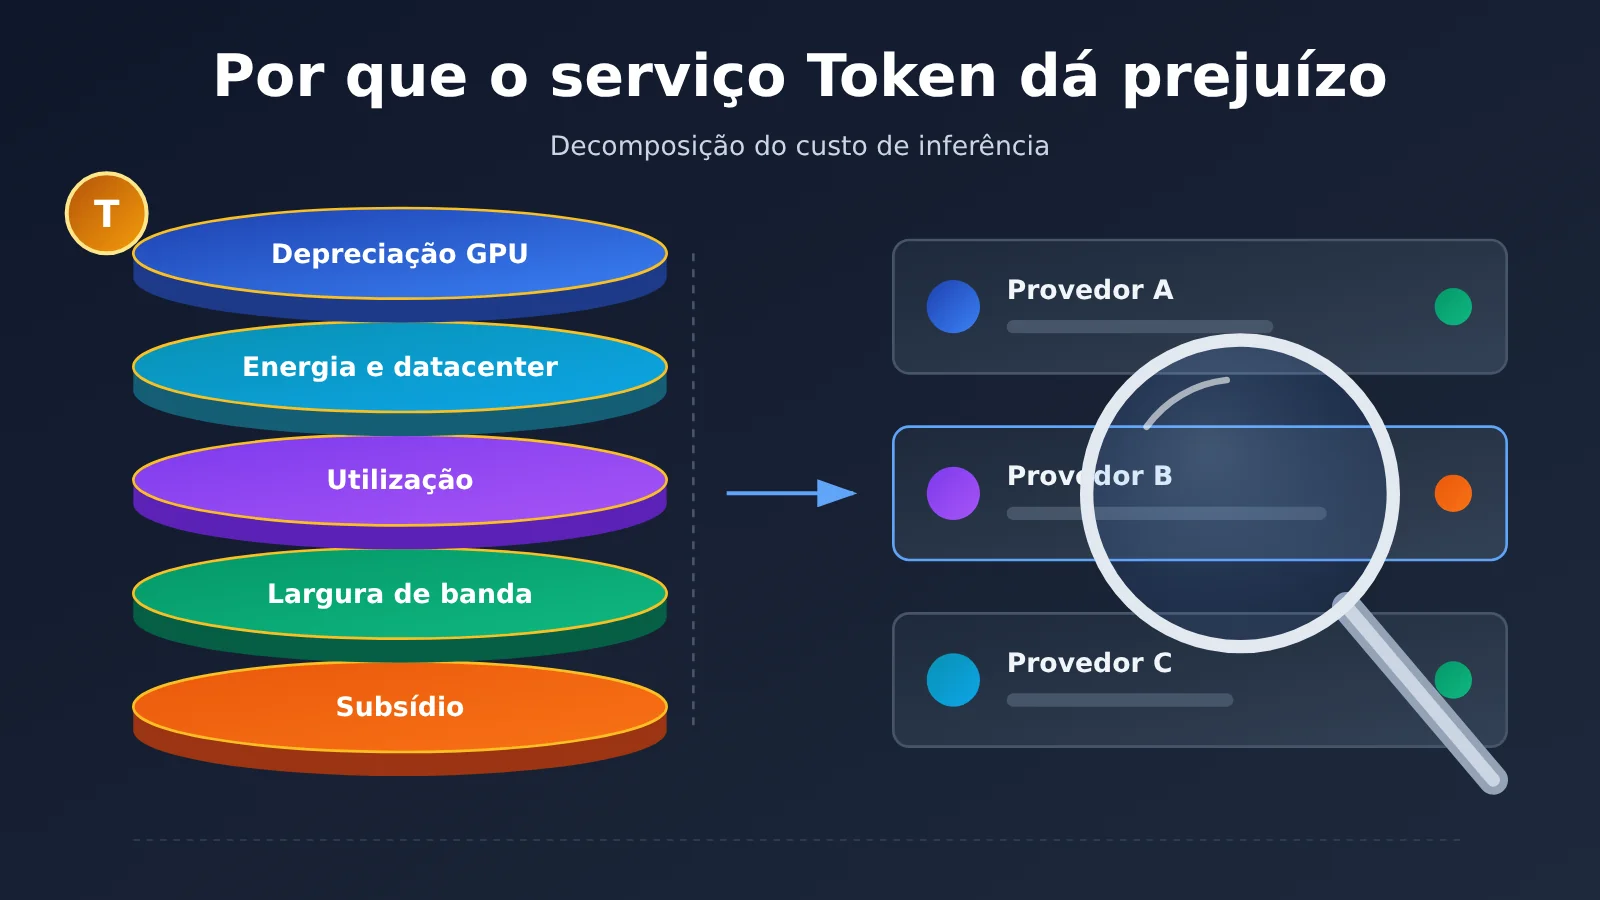
Por que serviços de Token dão prejuízo: pontos centrais da estrutura de custos de inferência
Vamos direto à conclusão. A maior parte do custo de um serviço de inferência é fixa, mas a receita é cobrada por volume de Token. O que conecta os dois é a “utilização”. Se a utilização não sobe, ou se a concorrência empurra o preço para perto do custo marginal, as contas fecham no vermelho.
| Elemento de custo | Descrição | Impacto no preço unitário por Token |
|---|---|---|
| Capex e depreciação de GPU | Compra ou aluguel de longo prazo de GPUs de alto padrão, amortizados ao longo dos anos | Custo fixo: quanto menor a utilização, maior o rateio por Token |
| Datacenter, energia elétrica e rede | Colocation, refrigeração, largura de banda e recuperação de desastres entre regiões | Custo semifixado; só se dilui com escala |
| Utilização da GPU | Percentual de tempo em que a GPU realmente roda inferência e saturação do processamento em lote | A alavanca central do lucro/prejuízo; a diferença entre pico e vale come o lucro diretamente |
| Estrutura Prefill / Decode | A entrada é processada em paralelo; a saída é gerada Token a Token | Tokens de saída custam mais; cenários com saídas longas pressionam mais |
| Contexto longo e KV Cache | A memória da GPU fica ocupada pelo cache, reduzindo a capacidade de concorrência | Requisições com contexto longo reduzem o número de usuários que podem ser atendidos |
| Subsídios e aquisição de clientes | Cota gratuita, tráfego atraído por preço baixo e repartição de receita com canais | Aumenta o volume no curto prazo, mas reduz a margem bruta no longo prazo |
Detalhamento dos pontos-chave da estrutura de custos de serviços de Token
O descasamento entre custos fixos e receita por uso é o primeiro motivo. Um servidor GPU totalmente equipado gera depreciação, conta de luz e custos de datacenter esteja ou não recebendo requisições. O usuário, porém, só paga pelos Tokens efetivamente consumidos. No pico do dia, é preciso reservar capacidade suficiente para garantir a latência; no vale noturno, essa capacidade fica ociosa. O custo dos períodos ociosos acaba rateado nos Tokens vendidos no horário de pico. Se o preço for definido apenas com base no “custo teórico com carga máxima”, a operação real quase certamente vai dar prejuízo.
A concorrência de preços empurra o preço unitário para perto do custo marginal é o segundo motivo. Pesos de modelos open source estão disponíveis para todo mundo e vários provedores de inferência implantam o mesmo modelo. O espaço para diferenciação é pequeno, então o preço vira naturalmente o principal instrumento de competição. Colocar Token em promoção dentro de transmissões ao vivo mostra que esse tipo de produto já está perto de uma “commodity padronizada”. Nesse cenário, fica difícil para o provedor cobrir custos fixos com prêmio de preço; resta competir por escala e eficiência de escalonamento.
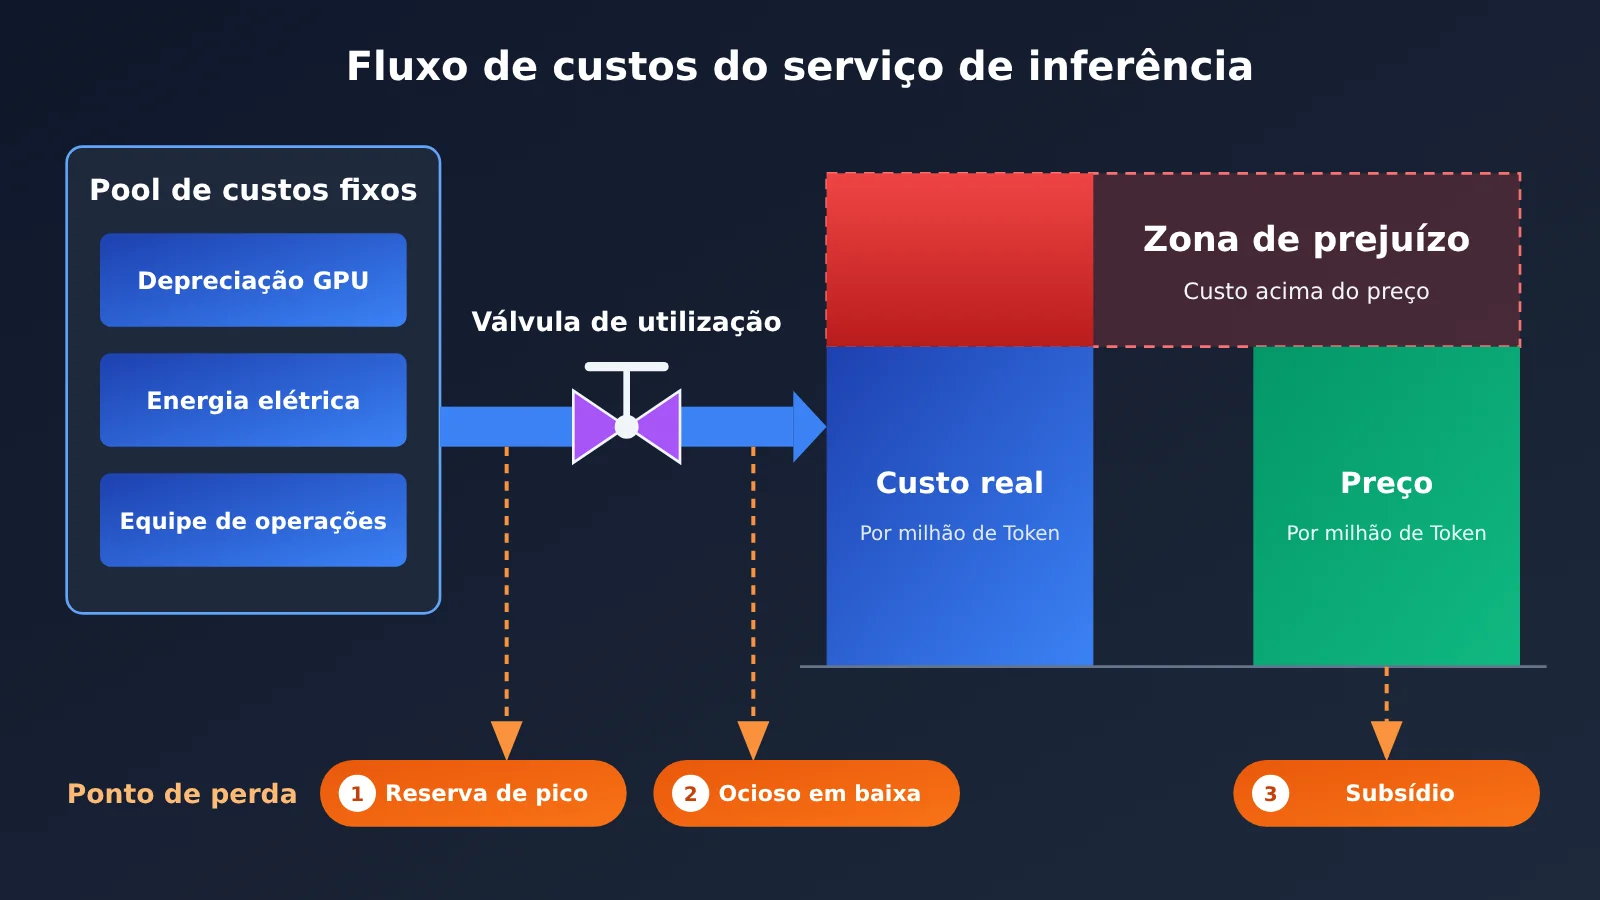
Detalhando o custo dos serviços de inferência: como o preço unitário por Token é calculado
Para entender por que os serviços de Token dão prejuízo, é preciso dividir uma requisição de inferência em duas fases. Cada fase consome recursos diferentes, e a métrica de cobrança muda junto. É exatamente por isso que muitos provedores precificam entrada, saída e cache separadamente.
Prefill e Decode: por que o Token de saída é mais caro
Uma requisição entra primeiro na fase de Prefill. O modelo processa todos os Tokens de entrada em paralelo: é intensivo em processamento, mas eficiente, e o poder computacional da GPU é bem aproveitado. Depois vem a fase de Decode, em que o modelo gera apenas um Token por vez e precisa reler repetidamente o KV Cache anterior. Essa fase é mais limitada pela largura de banda da memória de vídeo, e a capacidade de processamento da GPU dificilmente é totalmente utilizada.
Por isso, para a mesma quantidade de Tokens, o custo unitário de saída costuma ser bem maior que o de entrada. A precificação dos principais provedores também segue essa lógica: o preço unitário de saída é maior que o de entrada. Se o seu negócio é dominado por saídas longas — geração de código, redação de textos longos ou raciocínio multi-turno de Agent —, o custo se concentra no lado da saída. Ao avaliar um provedor, priorize o preço unitário de saída e a vazão de saída.
KV Cache e contexto longo: o imposto invisível sobre a memória de vídeo
O custo de uma requisição com contexto longo não se resume a “mais entrada”. O KV Cache ocupa mais memória de vídeo conforme o contexto cresce, e o número de requisições simultâneas que uma única placa consegue atender cai na mesma proporção. Ou seja, um usuário com contexto ultra-longo pode ocupar a vaga de concorrência de vários usuários comuns. Esse custo não aparece necessariamente por inteiro no preço unitário; os provedores só conseguem equilibrar isso com preços por faixas, limitação de taxa ou limites de comprimento de contexto.
Acerto de cache: tanto uma forma de reduzir custo quanto uma armadilha de precificação
O cache de comando (Prompt Caching) permite que prefixos repetidos não sejam recalculados, e a parte que acerta no cache é cobrada pelo preço mais baixo de leitura de cache. Para negócios como Agent e RAG, em que o comando de sistema é longo e repetitivo, a taxa de acerto de cache afeta bastante a fatura final. Atenção: os provedores têm métricas de cobrança diferentes para escrita de cache, leitura de cache e validade do cache, e alguns exigem ativação explícita. Na avaliação, confirme se o campo usage retornado inclui as estatísticas de Tokens relacionadas a cache.
| Métrica de cobrança | Característica do consumo de recursos | O que confirmar na avaliação |
|---|---|---|
| Token de entrada | Cálculo paralelo no Prefill, eficiência alta | Se o preço é escalonado pelo comprimento do contexto |
| Token de saída | Gerado um a um no Decode, limitado pela largura de banda da memória de vídeo | Preço unitário de saída, vazão de saída (Token/s) |
| Escrita de cache | Primeira gravação no cache, algumas plataformas cobram à parte | Se a escrita tem acréscimo de preço e qual a validade |
| Leitura de cache | Acerta o prefixo, pula o cálculo repetido | Desconto na parte que acerta, se o usage é exposto |
| Token de raciocínio | Processo de raciocínio interno do modelo de raciocínio | Se entra na saída, se é possível limitar o orçamento |
💰 Sobre a métrica de preço: a tabela acima apenas explica as dimensões de cobrança e não envolve preços concretos. Para os preços unitários de entrada e saída e os preços de leitura/escrita de cache dos modelos citados neste artigo, use os dados reais da página de preços do APIYI em
https://docs.apiyi.com/models. Modelos e grupos diferentes podem ter métricas de cobrança diferentes; confira item por item antes de fechar o pedido.
Inferência própria vs. chamada de API: como fechar a conta do custo por token
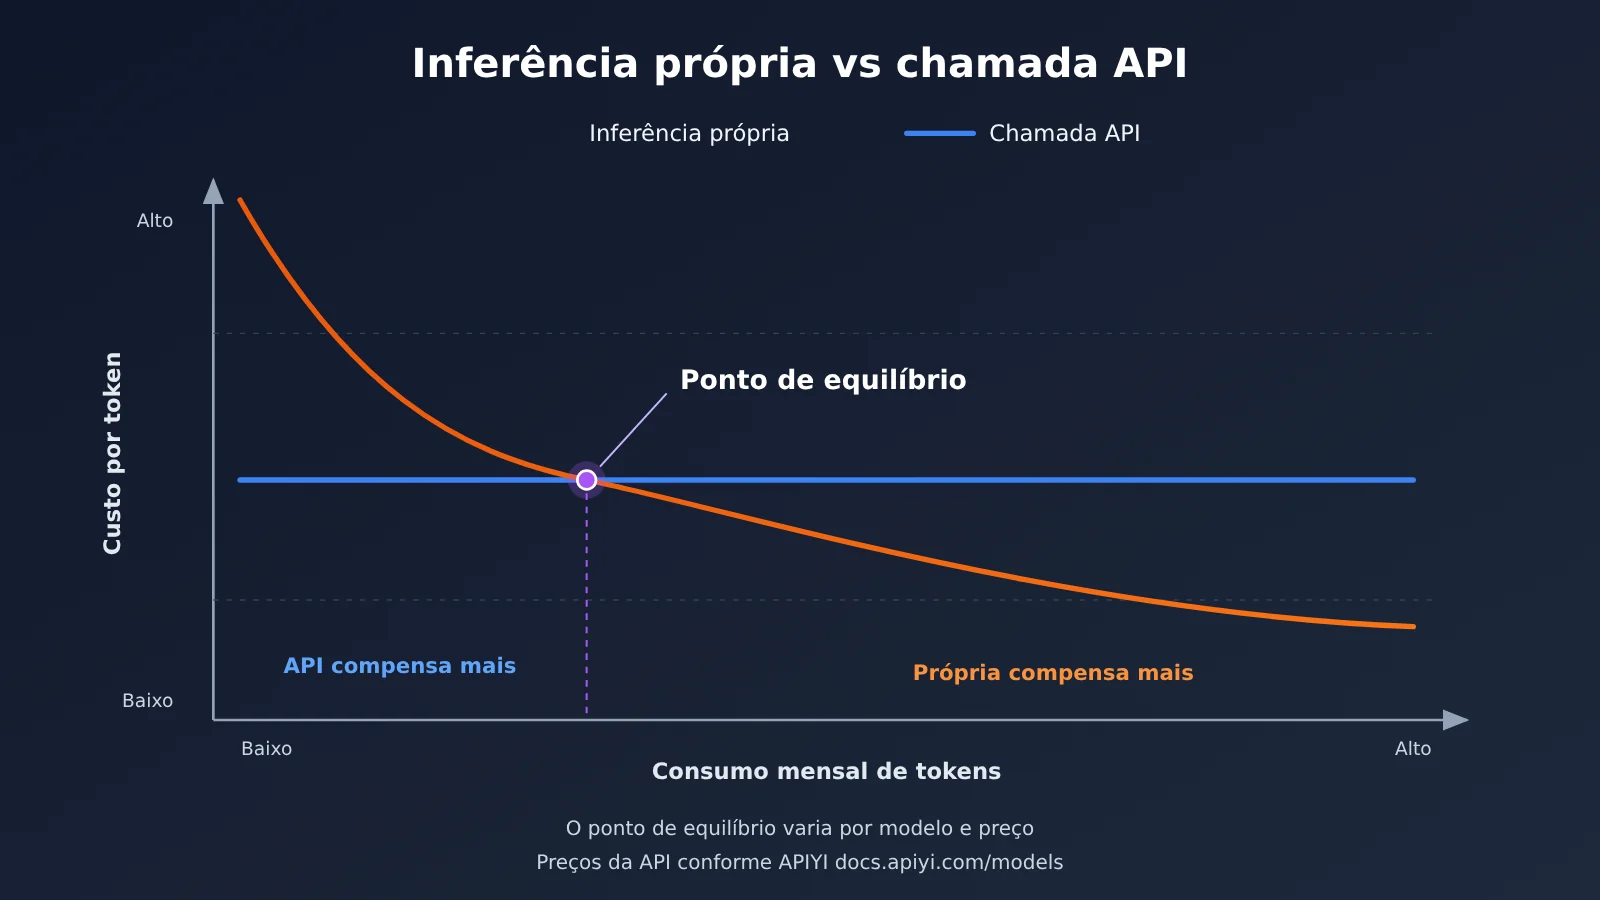
O caso “56 GPUs B200 sustentando 2.000 engenheiros, com redução de custo de cerca de 90%” só se sustenta sobre alguns pré-requisitos. A carga dessa empresa vem dos engenheiros internos: volume de requisições alto e relativamente estável. Concentrada no horário de trabalho, com forte previsibilidade. E o modelo foi trocado pelo GLM, open source e autoimplantável. Esses três pontos permitem diluir bem o custo fixo e justamente contornam o problema de utilização, que é a maior dor de cabeça dos provedores de inferência pública.
Por outro lado, esse caso não significa que todo time deva construir a própria infraestrutura. Se o volume de requisições é pequeno, oscila muito, ou se é preciso alternar com frequência entre vários modelos de código fechado, o custo ocioso do cluster de GPUs próprio rapidamente ultrapassa a fatura da API. O valor dos provedores de inferência pública está exatamente em usar a carga de muitos clientes para “nivelar picos e vales” entre si, em troca de uma utilização geral mais alta.
| Solução | Estrutura de custo | Cenários de uso | Principais riscos |
|---|---|---|---|
| Cluster de GPUs próprio | Custo fixo alto, custo marginal baixo | Times grandes, com volume alto, carga estável e modelo fixo | Desperdício por ociosidade, mão de obra de operação, depreciação do hardware |
| API oficial de um único modelo | Pagamento puramente por uso | Negócios fortemente dependentes de um modelo de código fechado | Preço único, custo de troca alto, disponibilidade regional limitada |
| Plataforma agregadora de múltiplas APIs | Pagamento por uso, interface unificada | Necessidade de comparar, alternar e combinar vários modelos | É preciso verificar a transparência da cobrança e a estabilidade |
| Arquitetura híbrida | Tarefas de alta frequência na infraestrutura própria, tarefas de cauda longa via API | Escala de negócio média/grande, camadas de modelo bem definidas | Aumento da complexidade arquitetural |
Análise comparativa da solução própria: construir a própria infraestrutura tem vantagem no piso do custo unitário, mas o pré-requisito é utilização suficientemente alta e um time capaz de lidar com implantação, quantização, escalonamento e recuperação de falhas. Em comparação, a solução via API tem custo unitário mais previsível, sendo mais adequada a times com carga oscilante e que precisam validar vários modelos em paralelo.
Análise comparativa das plataformas agregadoras: as APIs oficiais levam vantagem na velocidade de lançamento dos modelos, mas na maioria dos casos uma conta cobre apenas os modelos de um fornecedor. A vantagem das plataformas agregadoras multi-modelo é conectar vários modelos por meio de um único conjunto de interfaces, o que facilita o teste A/B e a estratificação de custos. Plataformas como a APIYI apiyi.com são compatíveis tanto com o formato de interface da OpenAI quanto com o da Anthropic, então dá para trocar de modelo com pouquíssima alteração no código existente.
Como avaliar provedores de serviços de API de modelos: checklist rápido de 6 dimensões
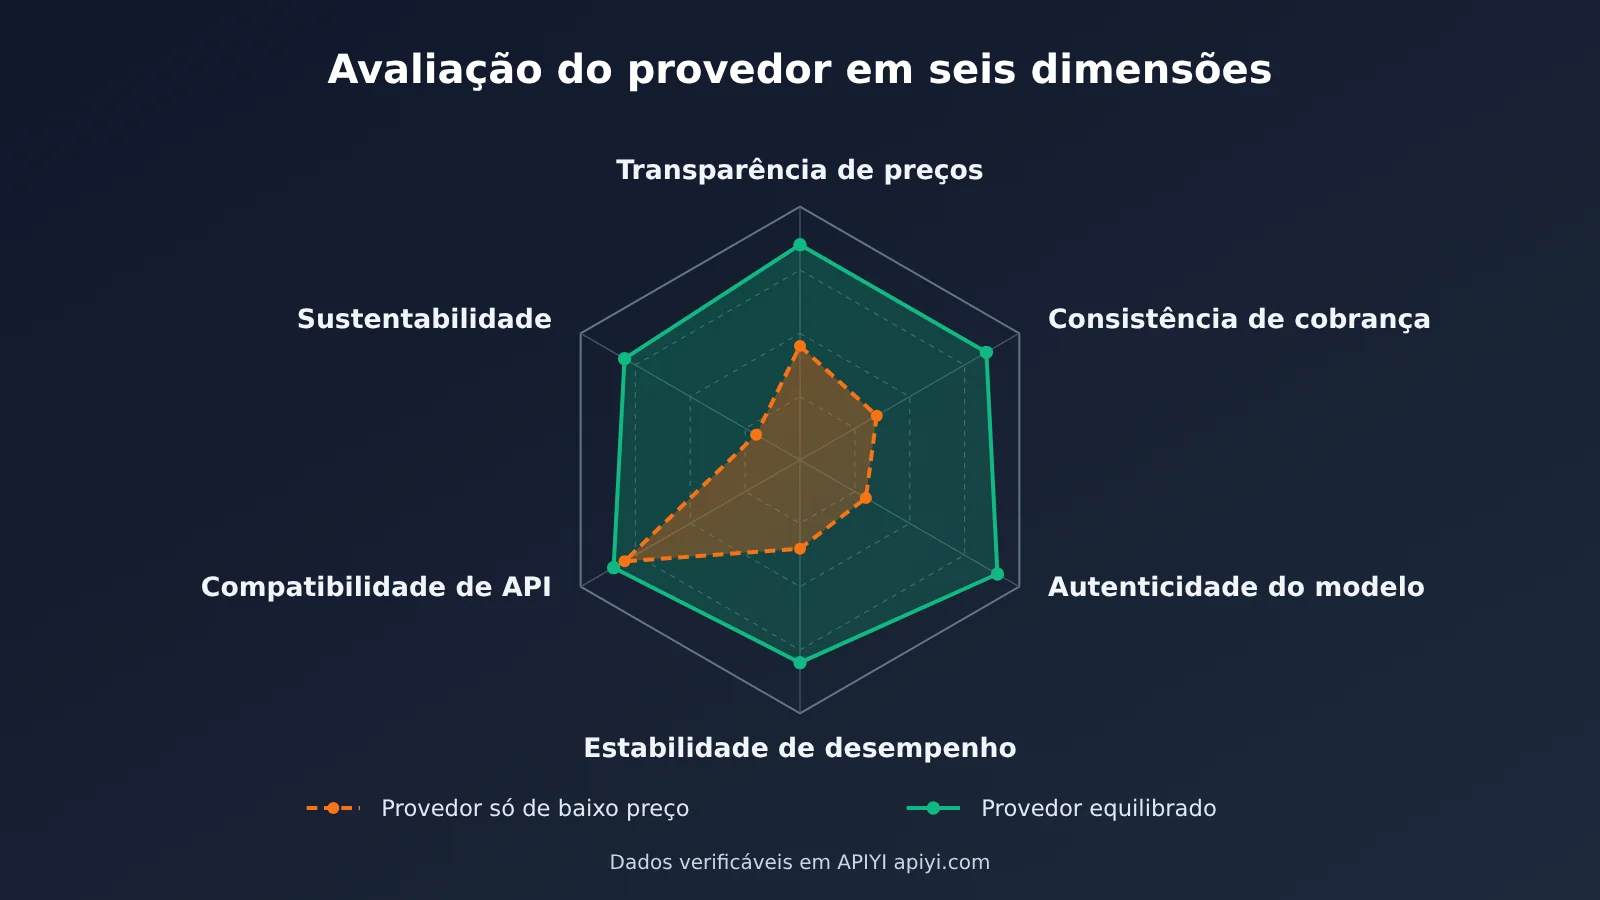
Depois de entender a estrutura de custos, dá para inferir uma conclusão: preços abaixo do custo por muito tempo não são sustentáveis. O provedor ou economiza em alguma etapa, ou se sustenta com subsídios por um período. Ao avaliar um provedor, não basta olhar o preço de tabela; é preciso considerar as 6 dimensões abaixo em conjunto.
| Dimensão | Pergunta central | Método de verificação |
|---|---|---|
| 1. Transparência de preços | Entrada, saída e cache são divulgados separadamente? | Comparar com a página de preços e registrar o critério item por item |
| 2. Consistência de cobrança | A cobrança real é consistente com usage? |
Fazer chamadas em pequeno lote e conferir os detalhes da fatura |
| 3. Autenticidade do modelo | Há downgrade, mistura de modelos ou quantização excessiva? | Comparar a qualidade da saída com um conjunto de testes fixo |
| 4. Estabilidade de desempenho | Como estão a latência do primeiro token, o throughput e a taxa de erro? | Testar uma rodada em horário de pico e outra em horário de baixa |
| 5. Compatibilidade de interface | É compatível com os formatos OpenAI / Anthropic? | Testar com o SDK existente trocando apenas base_url |
| 6. Sustentabilidade | O preço está claramente abaixo da faixa de custo razoável? | Avaliar o risco de subsídio com base na estrutura de custos |
Primeiro passo: integrar via interface compatível e fazer a chamada mínima
Dá para explicar o fluxo de teste sem escrever código. Se seu projeto já usa o SDK da OpenAI, normalmente basta mudar duas configurações: trocar api_key pela chave fornecida pelo provedor e trocar base_url pelo endereço da API do provedor. No caso da APIYI, o base_url no formato compatível com OpenAI é https://api.apiyi.com/v1, as requisições de chat passam por /v1/chat/completions, e basta preencher o campo model com o nome do modelo desejado.
Se o projeto usa o SDK da Anthropic — por exemplo, com modelos da linha Claude ou ferramentas do tipo Claude Code — também dá para trocar o endereço da API e usar o formato nativo da Anthropic no caminho /v1/messages. Consulte a documentação da APIYI em https://docs.apiyi.com para conferir os endereços e nomes de modelos. Na chamada mínima, vale ativar também a saída em streaming com stream, para facilitar a medição da latência do primeiro token mais adiante.
Segundo passo: conferir os critérios de cobrança e o campo usage
Na resposta de cada chamada, o formato OpenAI retorna usage.prompt_tokens e usage.completion_tokens; alguns modelos também trazem cached_tokens, referente a acertos de cache. No formato Anthropic, os campos correspondentes são input_tokens, output_tokens e os campos de leitura e gravação de cache. Você pode estimar o custo de uma chamada com uma fórmula simples: quantidade de tokens de entrada multiplicada pelo preço unitário de entrada, mais quantidade de tokens de saída multiplicada pelo preço unitário de saída, mais tokens de leitura/gravação de cache multiplicados pelo preço unitário de cache correspondente.
Compare o valor estimado com o detalhamento da fatura da plataforma; a diferença deve ter uma explicação. Fique atento se, por muito tempo, “a fatura vier maior do que a estimativa baseada em usage” ou se os acertos de cache nunca aparecerem na cobrança. Para os preços unitários usados na estimativa, considere os dados publicados na página de preços da APIYI em https://docs.apiyi.com/models.
Passo 3: testar desempenho, qualidade e horários de pico
Nos testes de desempenho, vale registrar três métricas: latência do primeiro token (TTFT), throughput de saída (tokens por segundo) e taxa de erro (timeout, 429 de rate limit, 5xx). Rode uma rodada no pico do dia útil e outra no vale da madrugada — quanto menor a variação, mais folgado é o planejamento de capacidade do provedor. Já o teste de qualidade usa um conjunto fixo de comandos cobrindo código, raciocínio e textos longos, comparando as saídas com as do canal oficial ou de outras plataformas; isso ajuda a flagrar modelos rebaixados ou trocados.
| Item de teste | Parâmetros / campos-chave | Referência aceitável |
|---|---|---|
| Latência do primeiro token | Ativar stream e registrar o tempo até o primeiro chunk |
Diferença entre pico e vale não pode ser grande |
| Throughput de saída | completion_tokens ÷ tempo de geração |
Próximo de outros canais do mesmo modelo |
| Conferência de cobrança | Campos de usage × preço unitário da página de preços |
Desvio em relação à fatura que possa ser explicado |
| Acerto de cache | cached_tokens ou campo de leitura de cache |
Requisições repetidas com prefixo longo apresentam acerto |
| Estabilidade | Número de 429 / 5xx / timeouts | Taxa de erro baixa e com explicação sobre retries |
🚀 Início rápido: se quiser comparar custo e desempenho de vários modelos sob a mesma interface, cadastre-se na APIYI apiyi.com e obtenha créditos de teste. A plataforma oferece chamadas de API dos principais modelos citados neste artigo, compatíveis com os formatos OpenAI e Anthropic — basta trocar o
base_urlporhttps://api.apiyi.com/v1para começar a validar. Os preços de cada modelo seguemhttps://docs.apiyi.com/models.
Perguntas frequentes (FAQ)
Q1: Por que o serviço de Tokens dá prejuízo?
Os serviços de inferência têm custo dominado por itens fixos, como depreciação de GPU e energia do datacenter, mas a receita é cobrada por volume de Tokens. No pico é preciso reservar capacidade de computação; no vale, essa capacidade fica ociosa, e é difícil manter a utilização alta por muito tempo. Somando a guerra de preços provocada pela homogeneização dos modelos abertos e os subsídios de cota gratuita, o preço de venda facilmente cai abaixo do custo.
Q2: Por que o Token de saída costuma custar mais caro que o de entrada?
A entrada é calculada em paralelo na fase de Prefill, com alta eficiência de uso da GPU. A saída é gerada token por token na fase de Decode, exigindo leituras repetidas do KV Cache, ficando limitada principalmente pela largura de banda da memória de vídeo — o que eleva o custo unitário. Por isso, operações com saídas longas devem ficar de olho no preço unitário de saída e na vazão (throughput).
Q3: Montar GPU própria é sempre mais barato do que chamar uma API?
Não necessariamente. Casos como “56 B200 sustentando 2000 engenheiros” dependem de uma carga interna de grande escala, estável e previsível. Equipes com uso pequeno ou muito oscilante acabam com ociosidade alta após montar a infraestrutura, e o custo unitário sai maior. A recomendação é primeiro rodar com API para levantar a curva real de consumo e só depois avaliar o ponto de equilíbrio.
Q4: Dá para usar provedores de API com preço muito baixo?
Pode testar, mas vale validar bastante. Preços claramente abaixo da faixa razoável de custo normalmente significam algum destes fatores: subsídio, limitação de taxa, downgrade de modelo ou desconto por instabilidade. Fazer a checagem de qualidade e de cobrança com a lista de 6 dimensões deste artigo é mais confiável do que olhar apenas o preço de tabela.
Q5: Como comparar o desempenho de vários modelos via API com baixo custo?
Recomendo usar uma plataforma multimodelo compatível com os formatos de interface mais usados para fazer um teste unificado:
1. Crie uma conta na APIYI apiyi.com e obtenha a API Key
2. Configure a interface compatível com OpenAI ou Anthropic conforme a documentação `https://docs.apiyi.com`
3. Com um conjunto de testes fixo, alterne o campo `model` e registre latência, qualidade e `usage`
Com o mesmo código você conclui a comparação lado a lado, e o custo de troca é bem baixo.
Q6: Como consultar o preço de cache? A métrica é igual entre as plataformas?
Não é. Algumas plataformas cobram separadamente pela escrita em cache, outras dão desconto apenas na leitura, e o prazo de validade e a forma de habilitação também variam. Ao chamar na APIYI, os preços de leitura e escrita de cache seguem os dados reais da página de preços `https://docs.apiyi.com/models`; confira a cobrança junto com os campos de cache retornados em `usage`.
Q7: Qual é a métrica mais negligenciada na hora de avaliar um provedor?
Consistência de cobrança e estabilidade em horário de pico. Muitas equipes fazem um único teste em horário de baixa e já colocam em produção — e depois enfrentam 429 ou timeouts com frequência no pico. Também há muitas equipes que nunca conferem a correspondência entre `usage` e a fatura. Esses dois pontos deveriam entrar na checklist fixa antes do lançamento.
Custos do serviço de Token e avaliação de provedores de API: principais conclusões
- Origem do prejuízo: custos fixos altos, receita por volume e oscilação de utilização — a incompatibilidade entre esses três fatores faz o serviço de Token perder dinheiro facilmente
- Saída é mais cara: o Decode é limitado pela largura de banda da memória de vídeo; negócios com saídas longas precisam ficar de olho no preço unitário de saída e na taxa de transferência
- Contexto longo tem custo oculto: o KV Cache ocupa memória de vídeo e reduz a concorrência; os provedores só conseguem equilibrar com faixas de preço e limitação de requisições
- Auto-hospedagem tem barreira: só cargas de trabalho grandes e estáveis conseguem diluir o custo fixo das GPUs; equipes pequenas devem priorizar o uso de API
- Avaliação em seis dimensões: transparência de preço, consistência de cobrança, autenticidade do modelo, estabilidade de desempenho, compatibilidade de interface e sustentabilidade
- Como começar: faça testes rápidos e reais via APIYI, compatível com os formatos OpenAI / Anthropic; os preços têm como referência
docs.apiyi.com/models
Resumo: entenda o serviço de Token pela estrutura de custos e escolha o provedor de API certo
Por que o serviço de Token dá prejuízo? Em última análise, isso é determinado pela estrutura de custos do serviço de inferência:
- Lado do custo: depreciação das GPUs e energia do data center são custos fixos; a utilização é a alavanca de lucro ou prejuízo; a saída de Token e o contexto longo aumentam ainda mais o custo
- Lado da receita: a homogeneização dos modelos de código aberto torna a guerra de preços inevitável, e os subsídios para atrair volume acabam reduzindo a margem bruta
- Lado da escolha: preço baixo não significa vantagem; é preciso avaliar de forma abrangente pelas 6 dimensões: transparência de preço, consistência de cobrança, autenticidade do modelo, estabilidade de desempenho, compatibilidade de interface e sustentabilidade
Para desenvolvedores, em vez de adivinhar qual provedor vai aguentar quanto tempo, é melhor usar dados reais de invocação para decidir. Primeiro faça um teste com pouco tráfego para conferir a cobrança e comparar a qualidade, e depois defina o modelo principal e os canais de backup.
Recomendo validar os resultados rapidamente pela APIYI apiyi.com. A plataforma oferece invocação de API dos modelos citados neste artigo, compatível com os formatos de interface OpenAI e Anthropic; a documentação de integração está em https://docs.apiyi.com. Os preços de entrada, saída e cache de todos os modelos têm como referência os dados reais da página de preços https://docs.apiyi.com/models.
📚 Materiais de referência
- 36Kr – Tokens já são vendidos até na live da Li Jiaqi, então por que empresas como a “SiliconFlow” ainda estão no prejuízo?:Reportagem sobre a dificuldade de lucrar dos provedores de serviços de inferência
- Link:
36kr.com/p/4055385238017664 -
Descrição: Entenda o contexto do setor sobre a commoditização de Tokens e os prejuízos dos provedores de inferência
-
36Kr – Tem gente queimando US$ 10 mil por mês, achando o Claude caro demais — e essa empresa migrou para o GLM:Caso real de empresa que adotou inferência própria para reduzir custos
- Link:
36kr.com/p/4055383551038595 -
Descrição: Caso de inferência própria com 56 GPUs B200 atendendo 2000 engenheiros, útil para entender a fronteira de custo entre infraestrutura própria e API
-
Central de documentação da APIYI:Integração de interfaces e preços de modelos
- Link:
docs.apiyi.com - Descrição: Confira as formas de integração compatíveis com OpenAI / Anthropic; os preços dos modelos estão em
docs.apiyi.com/models
Autor: Equipe de tecnologia da APIYI
Contato técnico: Para dúvidas sobre seleção de modelos e avaliação de custos de Token, fale com a gente pelo site oficial da APIYI (apiyi.com). Para mais materiais de integração, acesse a central de documentação em docs.apiyi.com