Nota do autor: para desenvolvedores independentes, planeje a solução de integração multi-modelo do AI Agent e do Workflow de um projeto individual em 5 etapas: camadas por tarefa, interface unificada, roteamento com fallback, controle de custos e observabilidade/avaliação.
Quando você está sozinho construindo um produto de IA, o que costuma travar primeiro não é o prompt, e sim a integração de múltiplos modelos. Ao planejar um Agent e um Workflow, você logo esbarra em algumas perguntas: qual modelo escolher, se vale integrar vários provedores ao mesmo tempo, como gerenciar as chaves de API, como controlar a fatura e o que fazer quando o serviço de um provedor oscila. Este artigo apresenta um método de planejamento de integração multi-modelo com “camadas por tarefa + interface unificada + roteamento com fallback”, para ajudar você a fazer isso no seu projeto individual de um jeito tranquilo e extensível.
Este texto não é uma versão reduzida da arquitetura de uma grande empresa de tecnologia. Times têm pessoas dedicadas a manter gateway, monitoramento e conciliação financeira; um projeto individual não tem essas condições. As sugestões abaixo giram em torno de um princípio: obter flexibilidade suficiente com o menor custo de manutenção possível.
Valor principal: depois de ler este artigo, você vai saber como definir camadas de modelos para seu AI Agent e Workflow, unificar a forma de integração, projetar cadeias de fallback e enxergar quanto cada invocação custou.
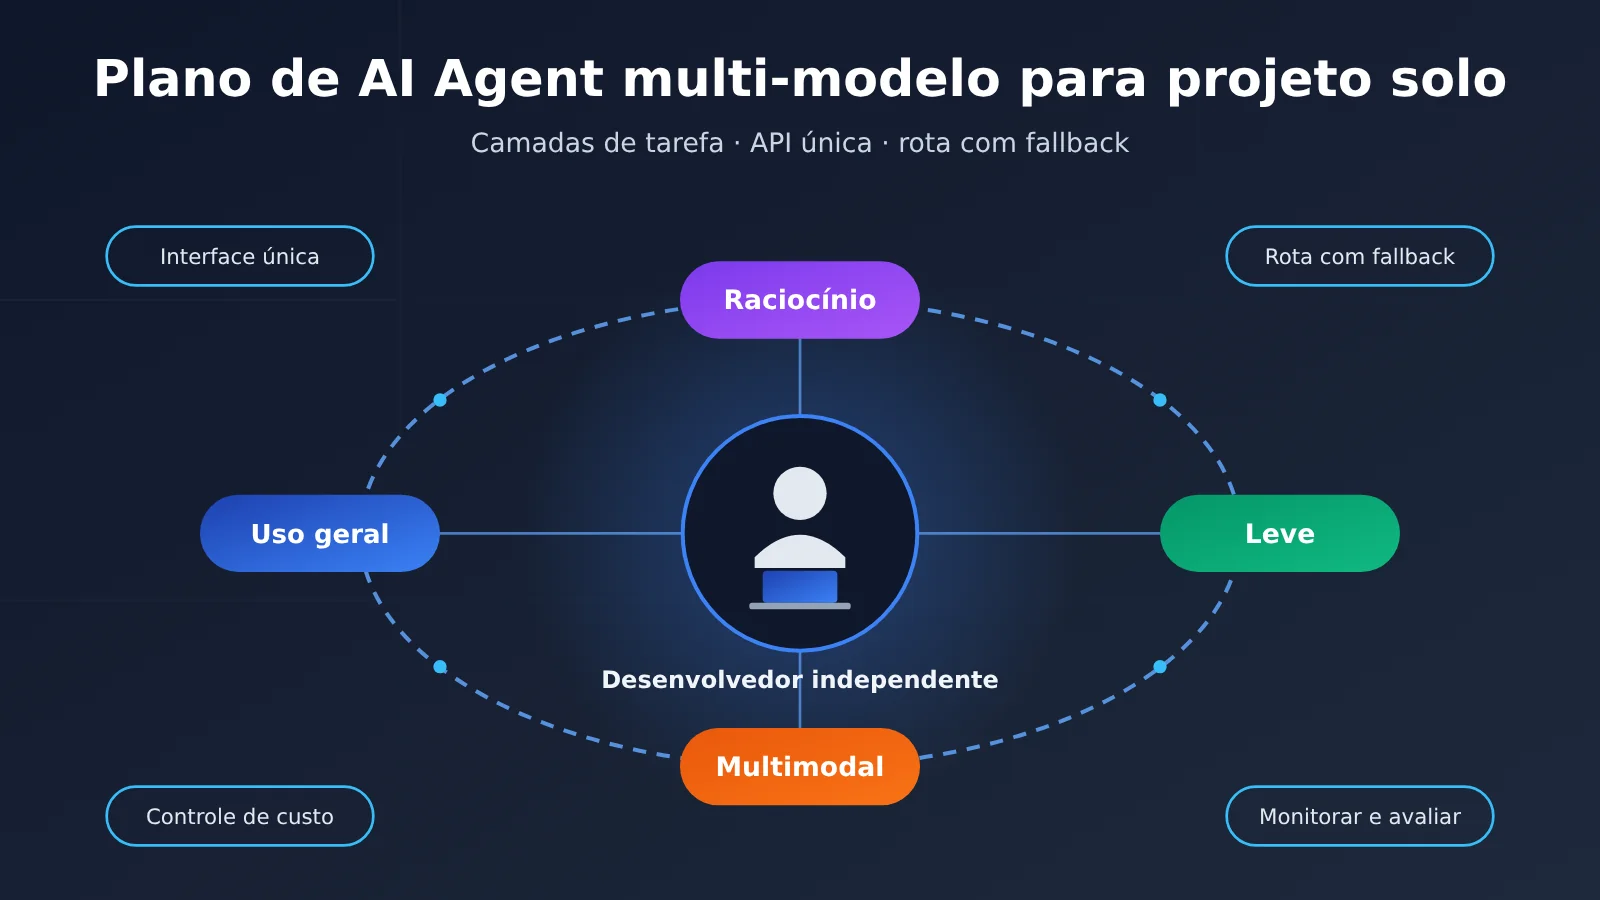
Pontos centrais da integração multimodelo em um AI Agent de projeto individual
Antes de começar a escrever código, deixe claros os 5 pontos abaixo. Eles definem se, nos próximos três meses, você estará iterando o produto ou consertando a camada de integração.
| Ponto | Descrição | Valor para um projeto individual |
|---|---|---|
| Segmentação de tarefas | Divida as chamadas no Agent e no Workflow em 3–4 camadas por dificuldade e frequência | Modelos caros só nos pontos críticos, com o custo total sob controle |
| Interface unificada | Todos os modelos usam um mesmo formato de requisição, por exemplo o formato compatível com OpenAI | Trocar de modelo muda só um parâmetro, sem reescrever o código de negócio |
| Roteamento e fallback | Configure modelo principal e modelo de reserva em cada camada | Se um serviço falhar, o produto não fica totalmente indisponível |
| Critério de custo | Separe itens de cobrança como entrada, saída e cache, usando a página de preços da plataforma como referência | Evita que a fatura saia do controle no fim do mês |
| Observabilidade e avaliação | Registre modelo, tempo de resposta, tokens e qualidade do resultado de cada chamada | Trocar ou não de modelo com base em dados, não em sensação |
Detalhes dos pontos-chave do planejamento de integração multimodelo
A segmentação de tarefas é o ponto de partida de todo o planejamento. Um AI Agent típico faz muitas coisas de naturezas diferentes: entende a intenção do usuário, planeja etapas, chama ferramentas, resume resultados e formata a saída. Essas etapas exigem níveis muito diferentes de capacidade do modelo. Para tarefas como classificação de intenção e extração de campos, um modelo leve geralmente basta; planejamento em várias etapas, geração de código complexo e raciocínio sobre documentos longos é que pedem um modelo de ponta. Se todo o fluxo usar o modelo mais forte, custo e latência aumentam várias vezes; por outro lado, se usar só modelos leves, as etapas críticas ficam propensas a erro. Primeiro segmentar, depois escolher o modelo: essa é a abordagem mais vantajosa para um projeto individual.
A interface unificada determina seu custo de manutenção. As SDKs oficiais de cada modelo não são totalmente consistentes em nomes de parâmetros, formato de retorno em streaming e estrutura de chamada de ferramentas. Conectar-se diretamente a três ou quatro APIs oficiais ao mesmo tempo significa manter três ou quatro conjuntos de código de adaptação, três ou quatro contas e três ou quatro faturas. Para uma pessoa, essa energia deveria ir para o produto. Uma abordagem mais realista é escolher uma camada de agregação e integração compatível com os formatos OpenAI e Anthropic; a camada de negócio só precisa reconhecer um protocolo, e os modelos viram itens de configuração substituíveis.
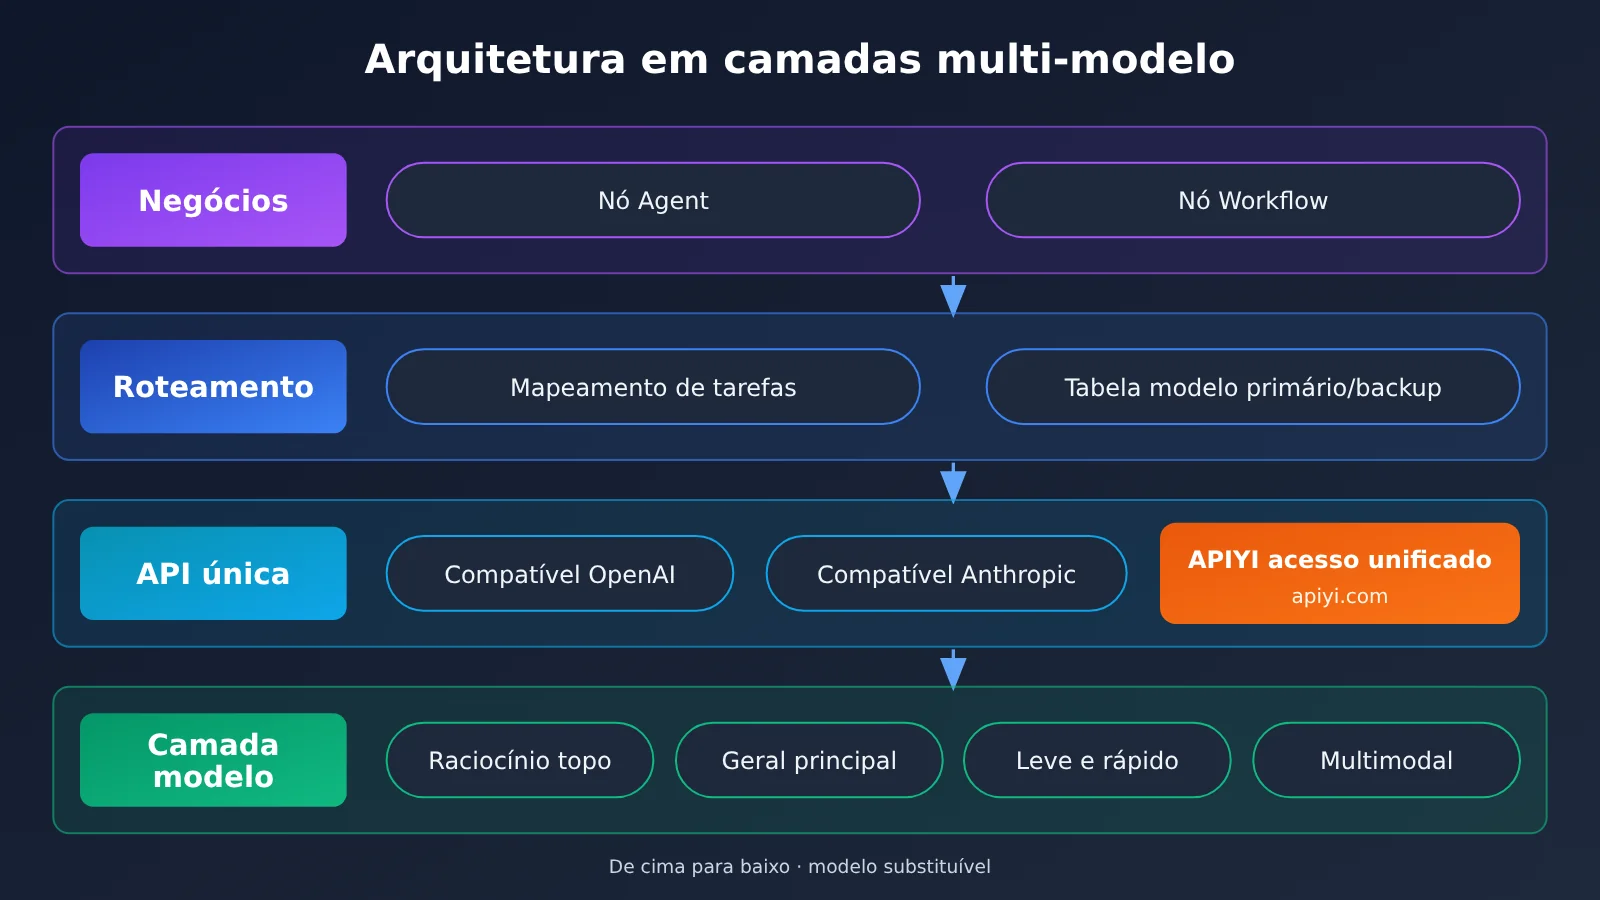
Como um projeto individual de AI Agent escolhe modelos por camadas de tarefa
O ponto central do particionamento em camadas é dividir por características da tarefa, não por nome de modelo. A seguir está uma divisão em quatro camadas aplicável à maioria dos AI Agents e Workflows, que pode servir diretamente como ponto de partida e depois ser ajustada ao seu negócio.
| Camada | Tarefas típicas | Requisitos de capacidade do modelo | Critério de seleção |
|---|---|---|---|
| L1 Camada de raciocínio | Planejamento em múltiplas etapas, código complexo, análise de documentos longos | Raciocínio profundo, forte aderência às instruções, janela de contexto longa | Modelos flagship ou de raciocínio de cada fornecedor, com baixa frequência de invocação |
| L2 Camada principal | Conversas rotineiras, geração de conteúdo, chamada de ferramentas | Capacidade geral equilibrada, chamada de ferramentas estável | Modelos generalistas mainstream, responsáveis pela maior parte do tráfego |
| L3 Camada leve | Classificação de intenção, extração de campos, resumo, reescrita | Rapidez, preço baixo, formato estável | Modelos leves ou da linha mini, com alta frequência de invocação |
| L4 Camada especializada | Compreensão de imagens, geração de imagens, voz, vetorização | Capacidade de modalidade específica | Seleção separada por função, desacoplada do fluxo de texto |
Três princípios para aplicar as camadas no Workflow de um projeto individual
Desenhar a tabela de camadas não é difícil; o difícil é realmente colocá-la em prática no Workflow. Os três princípios abaixo ajudam você a evitar desvios:
- Comece pela camada de baixo e só suba depois de validar. Ao adicionar um novo nó, primeiro teste com um modelo leve da L3 e, se o resultado não atingir o esperado, suba para L2 ou L1. Isso evita o hábito de usar sempre o modelo mais caro para tudo.
- Separe planejamento e execução. Deixe o “pensar no que fazer” do Agent para a L1 e o “executar de fato” para a L2 ou L3. Muitos frameworks de Agent permitem configurar modelos diferentes para o planejador e o executor, e essa é a otimização com melhor custo-benefício.
- Para saídas estruturadas, prefira modelos com formato estável. O downstream do Workflow costuma precisar interpretar JSON, e um texto extra ocasional do modelo pode quebrar toda a cadeia. A escolha para esse tipo de nó deve considerar a estabilidade de formato, não apenas o “nível de inteligência”.
Vale lembrar que as versões dos modelos evoluem muito rápido, e a tabela acima propositalmente não fixa modelos específicos. A abordagem mais segura é escolher 2 a 3 candidatos por camada na lista de modelos da plataforma de integração e testá-los com suas próprias amostras reais antes de decidir. A lista de modelos da APIYI cobre modelos de texto, raciocínio e multimodal dos principais fornecedores, permitindo comparações lado a lado dentro de uma mesma conta, o que é ideal para testes de seleção em projetos individuais.
Workflow de projeto individual: primeiros passos com múltiplos modelos
Esta seção apresenta os passos de implementação na ordem em que devem ser executados. Para facilitar a leitura, todos os itens de configuração são descritos em tabelas e texto, sem blocos de código.
Primeiro passo: definir um protocolo de acesso unificado
Recomenda-se que o lado de negócio adote de forma unificada o formato Chat Completions compatível com OpenAI. Os principais frameworks de Agent, ferramentas de orquestração de Workflow e a maioria dos projetos open source já suportam esse formato por padrão, o que garante a melhor compatibilidade de ecossistema. Se você usa intensamente recursos específicos da família Claude, como a estrutura nativa de chamada de ferramentas ou o cache de prompts, também é possível usar o formato Anthropic Messages nos nós correspondentes. O APIYI é compatível com os formatos de interface OpenAI e Anthropic ao mesmo tempo, e os dois protocolos podem compartilhar uma única conta e uma única chave.
Segundo passo: transformar os parâmetros do modelo em configuração
Não deixe o nome do modelo fixo no código de negócio. Todos os parâmetros relacionados ao modelo devem ser extraídos para arquivos de configuração ou variáveis de ambiente. A tabela abaixo lista os itens de configuração que vale a pena separar:
| Item de configuração | Função | Prática recomendada |
|---|---|---|
base_url |
Endereço da interface | Preencha o endereço de acesso indicado na documentação do APIYI, docs.apiyi.com, em um único lugar do projeto |
api_key |
Chave de autenticação | Coloque em variável de ambiente e use chaves diferentes para desenvolvimento e produção |
model |
Nome do modelo | Nomeie por camada, como MODEL_L1, MODEL_L2, MODEL_L3 |
fallback_model |
Modelo de reserva | Configure pelo menos um por camada, de preferência de fornecedores diferentes |
timeout |
Tempo limite | Defina valores curtos para L3 e longos para L1, para evitar que modelos de raciocínio sejam interpretados erroneamente como timeout |
max_tokens |
Limite de saída | Defina por nó para evitar que saídas anormalmente longas elevem o custo |
Depois disso, trocar de modelo exige apenas alterar a configuração, sem mexer na lógica do Agent nem na orquestração do Workflow.
Terceiro passo: marcar as camadas nos nós do Workflow
Abra seu diagrama de orquestração de Workflow e marque cada nó que invoca um modelo com L1 a L4. Seja usando uma ferramenta de orquestração visual ou código de fluxo escrito por você mesmo, basta indicar a camada na descrição do nó ou nos parâmetros e então ler o modelo correspondente da configuração. Esse passo é rápido, mas permite enxergar de imediato em quais nós o custo está concentrado.
Quarto passo: configurar degradação e retentativas
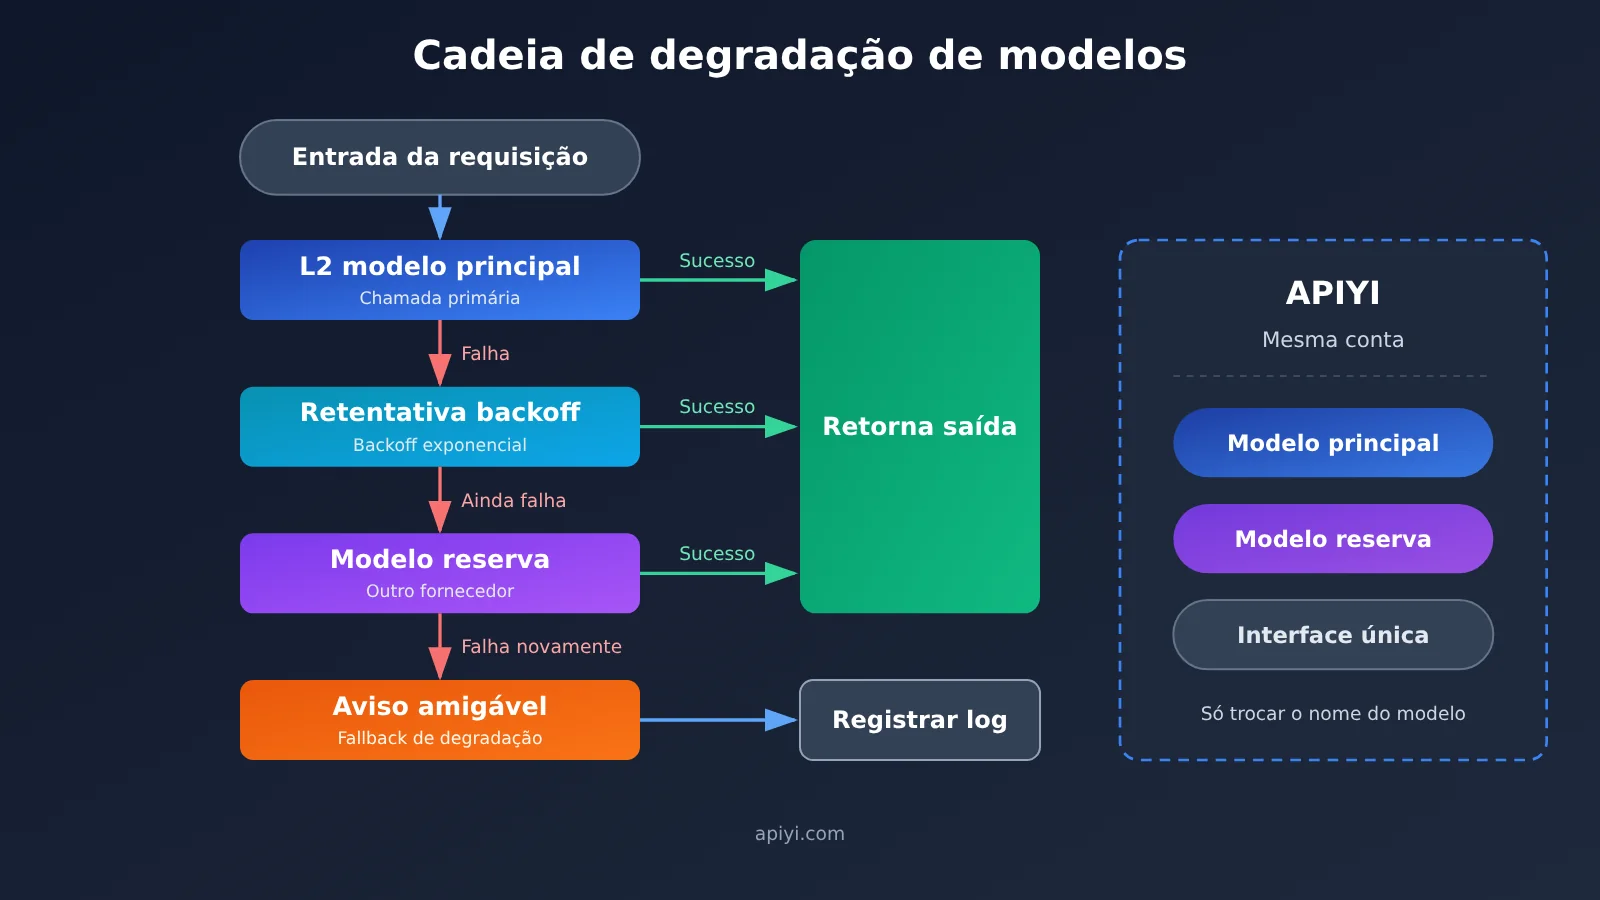
Configure em cada camada a ordem “modelo principal → modelo de reserva”. Quando o modelo principal retornar limite de requisições, timeout ou erro de servidor, faça primeiro uma ou duas retentativas com backoff e, se ainda falhar, mude para o modelo de reserva. Procure escolher como reserva um produto equivalente de outro fornecedor, para escapar de falhas concentradas em um mesmo serviço.
Quinto passo: registrar cada invocação
Registre pelo menos estes itens: horário, nome do nó, camada, nome do modelo, tokens de entrada, tokens de saída, tempo gasto, se houve degradação e se a execução terminou com sucesso. Uma tabela de log simples ou uma ferramenta de observabilidade leve já é suficiente; o essencial é registrar de forma consistente.
🚀 Sugestão para começar rápido: em um projeto individual, vale a pena primeiro se registrar no APIYI apiyi.com e obter a cota de teste, e então rodar uma amostra real com cada um dos modelos candidatos de L1 a L3 usando a mesma chave. Definir a seleção antes de escrever a configuração economiza muito mais tempo do que integrar primeiro e ficar alterando o código depois.
Comparação de soluções de integração multi-modelo para AI Agent em projeto individual
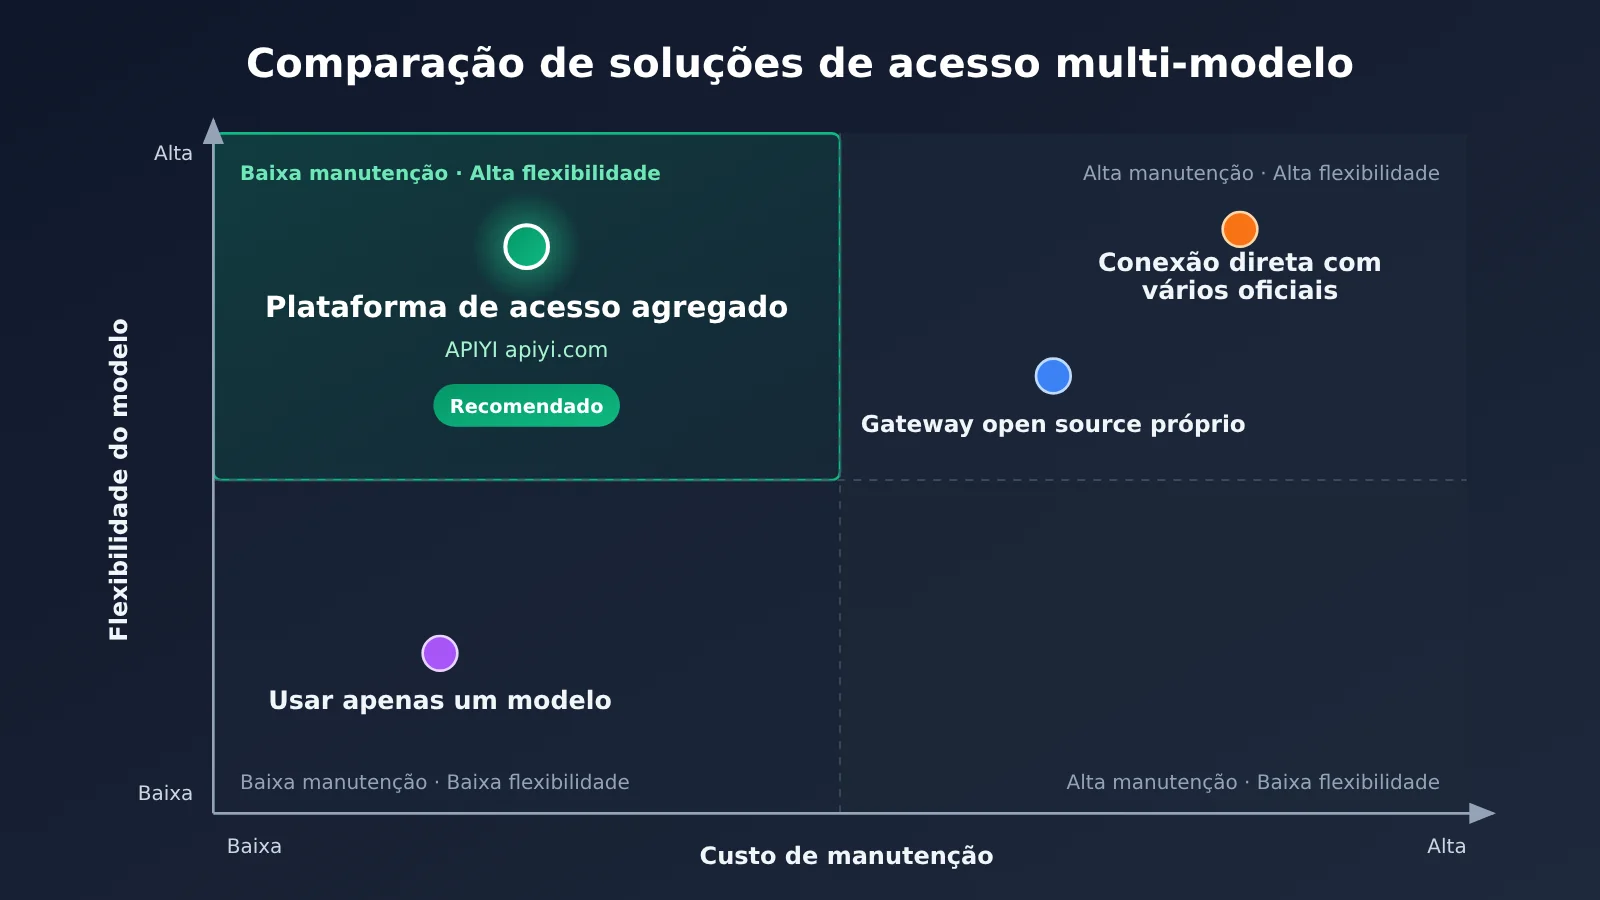
Existem basicamente quatro caminhos para integrar vários modelos, e o custo de manutenção de cada um varia bastante.
| Solução | Característica principal | Cenário de aplicação | Carga de manutenção no projeto individual |
|---|---|---|---|
| Usar apenas um único modelo | Um fornecedor, um modelo, o mais simples | Validação de protótipo, ferramentas pequenas com função única | Baixa, mas sem mecanismos de fallback |
| Conexão direta com várias oficiais | Integração separada com a API oficial de cada fornecedor | Dependência profunda de recursos de um fornecedor específico | Alta, exige vários SDKs, contas e faturas |
| Gateway de código aberto auto-hospedado | Você mesmo implanta uma camada de proxy unificada | Ter experiência em operações e precisar de ambiente privado | Média a alta, exige implantação, atualização e diagnóstico de falhas por conta própria |
| Plataforma de agregação | Uma interface para acessar vários modelos | Precisa de múltiplos modelos, mas não quer manter a camada de integração | Baixa, plataformas como APIYI apiyi.com oferecem interface unificada |
Análise comparativa das soluções de integração multi-modelo
Comparação da solução de modelo único: usar apenas um modelo é o mais eficiente na fase inicial, pois não exige nenhum design de roteamento. Mas isso coloca disponibilidade e custo totalmente nas mãos de um único serviço; se o fornecedor limitar a taxa ou ajustar o preço, você praticamente não terá margem de manobra. Em contrapartida, já deixar preparada uma interface unificada e parâmetros de modelo configuráveis quase não aumenta o esforço de desenvolvimento, mas abre bastante espaço para expansão futura.
Comparação da conexão direta com várias oficiais: conectar diretamente às interfaces oficiais tem vantagem na velocidade de acompanhar novos recursos, permitindo usar imediatamente o que um fornecedor acabou de lançar. Porém, manter vários códigos de adaptação, várias contas de recarga e várias conciliações consome continuamente a energia de uma só pessoa. Para a maioria dos projetos individuais, é mais realista fazer conexão direta apenas nos pontos que realmente dependem de algum recurso exclusivo oficial, e usar a interface unificada no restante.
Comparação do gateway auto-hospedado: um gateway de código aberto auto-hospedado oferece o maior controle, sendo adequado a cenários que exigem ambiente privado. Mas implantação, atualização, monitoramento e diagnóstico de falhas ficam todos por sua conta, o que equivale a manter mais um serviço. Se o seu objetivo principal é entregar o produto o quanto antes, uma plataforma de agregação costuma ser um ponto de partida mais seguro; depois que o negócio crescer, avalie se vale a pena construir o seu próprio.
💡 Sugestão de escolha: se você ainda está em dúvida, comece rodando todos os nós com APIYI e mantenha o lado de negócio dependente apenas do formato compatível com OpenAI. Assim, mesmo que no futuro você migre para um gateway auto-hospedado ou para a conexão direta com as oficiais, as mudanças ficarão concentradas na camada de configuração.
Controle de custos e estabilidade na integração de múltiplos modelos em projetos solo
Em um projeto tocado por uma só pessoa não existe um colega do financeiro para ficar de olho na fatura, então o controle de custos precisa estar embutido na arquitetura. A tabela abaixo reúne as alavancas de custo mais usadas:
| Alavanca de custo | Como fazer | Observações sobre a cobrança |
|---|---|---|
| Redução de nível em camadas | Usar modelos leves L3 nos nós de alta frequência | Os preços unitários variam bastante entre modelos; consulte a página de preços da APIYI |
| Controlar o comprimento da saída | Definir max_tokens para cada nó |
Na maioria dos modelos, o preço unitário da saída é maior que o da entrada; confira na página de preços |
| Aproveitar o cache | Colocar prompts de sistema fixos e definições de ferramentas no início da requisição | Se há suporte a cache e como ele é cobrado varia por modelo; confira na página de preços |
| Comprimir o contexto | Resumir periodicamente as conversas de múltiplos turnos do Agent, sem acumular histórico infinitamente | Os tokens de entrada crescem linearmente com os turnos — é o grande custo invisível |
| Configurar alertas de orçamento | Contabilizar o uso de tokens por dia e notificar quando passar do limite | Cruzar com os logs de chamada e a fatura da plataforma |
Sobre preços, este artigo deliberadamente não traz nenhum número concreto. O preço unitário de entrada, o de saída, os valores de leitura e escrita de cache e os critérios de cobrança mudam conforme a estratégia de cada fornecedor, e estimar de memória ou com base em material antigo dá erro com facilidade. Ao planejar custos, use os dados reais da página de preços da APIYI em docs.apiyi.com/models, estime o gasto mensal com a lógica de “chamadas médias por dia em cada camada × tokens de entrada médios × preço unitário de entrada + tokens de saída médios × preço unitário de saída” e reserve uma coluna separada para a taxa de acerto do cache.
Do lado da estabilidade, há três coisas que valem a pena estar concluídas antes do lançamento:
- Simulação da cadeia de degradação: troque manualmente o nome do modelo principal por um valor inválido e confirme que o Workflow consegue alternar automaticamente para o modelo de reserva e concluir normalmente.
- Timeouts por camada: modelos de raciocínio pensam por mais tempo, então o limite de timeout precisa ser claramente maior que o dos modelos leves — caso contrário aparece aquela situação de “quanto mais inteligente, mais fácil de dar timeout”.
- Projeto idempotente: chamadas de ferramentas com efeitos colaterais, como enviar e-mail ou gravar no banco de dados, precisam ser protegidas contra execução duplicada durante novas tentativas.
Perguntas Frequentes (FAQ)
Q1: O que é o planejamento de integração de múltiplos modelos em um projeto individual?
É quando, em um cenário de desenvolvimento independente, você decide antecipadamente quais tipos de modelo usar em cada etapa do AI Agent e do Workflow, por qual interface fazer a integração, como fazer o fallback em caso de erro e como contabilizar os custos. O objetivo é obter vantagem de custo e garantia de disponibilidade ao mesmo tempo, sem aumentar demais a carga de manutenção.
Q2: Qual é a diferença entre AI Agent e Workflow na integração de modelos?
No Workflow, as etapas são orquestradas previamente, então o modelo de cada nó pode ser definido de forma estática e a divisão em camadas fica bem direta. Já o Agent decide sozinho a ordem e a quantidade de chamadas, e o volume de invocações é difícil de estimar. Por isso, ele exige ainda mais uma separação entre modelos de planejamento e de execução, além de definir um número máximo de rodadas e um orçamento de Tokens por tarefa.
Q3: Preciso integrar vários modelos logo no começo?
Não é necessário integrar muitos fornecedores logo de início, mas o design da interface deve ser unificado desde o começo. A recomendação é, já na primeira versão, transformar o nome do modelo em configuração, adotar o formato compatível com OpenAI e reservar um modelo de backup para os nós principais. O esforço extra de desenvolvimento é pequeno e a expansão futura fica muito mais tranquila.
Q4: Em quais cenários de projeto individual a integração de múltiplos modelos se encaixa melhor?
– **Ferramentas de escrita com IA ou de conteúdo**: esboço com L1, corpo do texto com L2, reescrita de títulos com L3.
– **Agent de atendimento inteligente**: reconhecimento de intenção com L3, questões complexas escaladas para L2 ou L1.
– **Workflow de processamento de dados**: extração e classificação em lote com L3, amostras anômalas revisadas pelo L2.
– **Ferramentas de apoio à programação**: planejamento de código com L1, autocompletar e comentários com L2 ou L3.
Q5: Como chamar vários modelos rapidamente por uma interface unificada?
Você pode usar a APIYI, que é compatível com os formatos de interface da OpenAI e da Anthropic:
1. Acesse APIYI apiyi.com, crie uma conta e obtenha a API Key.
2. Configure o `base_url` e a Key conforme a documentação da APIYI em docs.apiyi.com.
3. Basta alterar o parâmetro `model` para trocar de modelo entre diferentes fornecedores, sem mudar o código de negócio.
Os modelos de raciocínio, modelos gerais, modelos leves e modelos multimodais abordados neste artigo podem todos ser chamados e comparados pela interface unificada da APIYI.
Q6: Como estimar o custo mensal de uma solução com múltiplos modelos?
Primeiro, levante nos logs de chamadas o número médio de invocações diárias e a média de Tokens de cada camada; depois, calcule com base nos preços de entrada, saída e cache de cada modelo na página de preços da APIYI em docs.apiyi.com/models. Não use preços de artigos antigos nem de memória: considere os dados reais da página de preços e revise uma vez por mês.
Q7: Quais são as limitações conhecidas de uma solução com múltiplos modelos?
Modelos diferentes respondem ao mesmo prompt com estilos distintos; ao trocar para um modelo de backup, pode haver pequenas diferenças no formato de saída, então o parsing downstream precisa ser tolerante a falhas. Alguns recursos exclusivos de certos fornecedores podem não estar totalmente disponíveis no formato compatível. Além disso, quanto mais modelos, maior o esforço de avaliação — recomenda-se manter de dois a três modelos candidatos por camada.
Pontos-chave da integração multi-modelo em AI Agents de projeto solo
- Primeiro as camadas, depois a escolha do modelo: classifique as tarefas em L1 a L4 pela dificuldade e frequência, e não pelo nome do modelo.
- Interface unificada: o lado de negócio depende de um único protocolo, e o nome do modelo é apenas um item de configuração substituível.
- Separar planejamento da execução: o planejamento do Agent usa um modelo forte; a execução fica com o modelo principal ou com um modelo leve.
- Fallback precisa ser ensaiado: modelo principal e de reserva vêm de fornecedores diferentes; simule a falha manualmente antes de publicar.
- Preço: vale a página de preços: confira todos os preços unitários e a cobrança de cache em docs.apiyi.com/models.
- Os logs são a base da decisão: registre modelo, Tokens, tempo de execução e ocorrências de fallback — e use os dados para decidir quando trocar de modelo.
- Para começar, uma plataforma agregadora resolve: a APIYI é compatível com os formatos OpenAI e Anthropic, e uma única chave API já permite testar vários modelos.
Resumo
Ao montar AI Agents e Workflows em um projeto solo, o planejamento de integração multi-modelo se resume a três pontos:
- Camadas de tarefa: faça cada etapa usar o modelo que é exatamente suficiente — custo e qualidade ficam controlados ao mesmo tempo.
- Interface unificada com configuração: o modelo vira um parâmetro substituível, e o esforço de manutenção fica sempre dentro do que uma pessoa consegue tocar.
- Fallback e observabilidade: com rede de segurança na disponibilidade e dados para decidir, o projeto consegue iterar de forma estável no longo prazo.
A sugestão é primeiro colocar todos os nós rodando com uma interface unificada e, depois, refinar a escolha dos modelos camada por camada com base nos dados dos logs. Se você não quer manter a camada de integração por conta própria, pode chamar os principais modelos de forma unificada pela APIYI apiyi.com, com interface compatível com os formatos OpenAI e Anthropic. As instruções de integração estão na documentação da APIYI, em docs.apiyi.com; preços dos modelos e critérios de cobrança seguem a página de preços docs.apiyi.com/models.
📚 Materiais de referência
- Central de documentação da APIYI: instruções sobre endereço de acesso, autenticação e formato das interfaces
- Link:
docs.apiyi.com -
Descrição: consulte ao configurar o
base_url, a chave e ao alternar entre os formatos OpenAI ou Anthropic -
Página de modelos e preços da APIYI: lista de modelos, preço unitário de entrada e saída e cobrança de cache
- Link:
docs.apiyi.com/models -
Descrição: todos os valores de custo neste artigo seguem os dados reais desta página
-
Documentação da API OpenAI: referência de formato da interface Chat Completions
- Link:
platform.openai.com/docs -
Descrição: entenda os parâmetros do formato compatível com OpenAI e a estrutura de chamada de ferramentas
-
Documentação oficial da Anthropic: interface Messages e cache de prompts
- Link:
docs.anthropic.com - Descrição: referência para usar o formato Anthropic em nós do Claude
Autor: Equipe técnica da APIYI
Contato técnico: fale com a gente pela página inicial do site oficial da APIYI. Mais materiais de integração estão disponíveis na central de documentação docs.apiyi.com