Nota do autor: Este artigo é baseado na apresentação pública do YC Paper Club Harness Night e organiza um conjunto de métodos de avaliação de modelos que pode ser colocado em prática, ajudando equipes a distinguir se a diferença de pontuação vem do modelo ou do Harness.
O mesmo Claude Opus tem melhor resultado de 30% em um conjunto privado reservado; ao ser colocado no Prime Agent, a pontuação divulgada na apresentação pública é de 95.5%. Se você olhar apenas para o ranking, pode pensar que o modelo passou por uma mudança qualitativa, mas esses números, antes de tudo, nos lembram: a avaliação de modelos muitas vezes compara o sistema inteiro, não apenas o modelo.
Este não é um artigo que tenta convencer você a abandonar os rankings, nem defende que o Harness consegue fazer qualquer modelo ganhar pontos sem limite. Este artigo não realizou uma revalidação independente; as pontuações citadas vêm do conteúdo da palestra organizado pelo InfoQ, e o foco é transformar essas experiências em um processo de avaliação executável.
Valor central: depois de ler este artigo, você aprenderá a usar 6 etapas para desenhar experimentos controlados entre modelo e Harness, identificar de onde vem a diferença de pontuação e chegar a conclusões mais confiáveis para a escolha da solução.
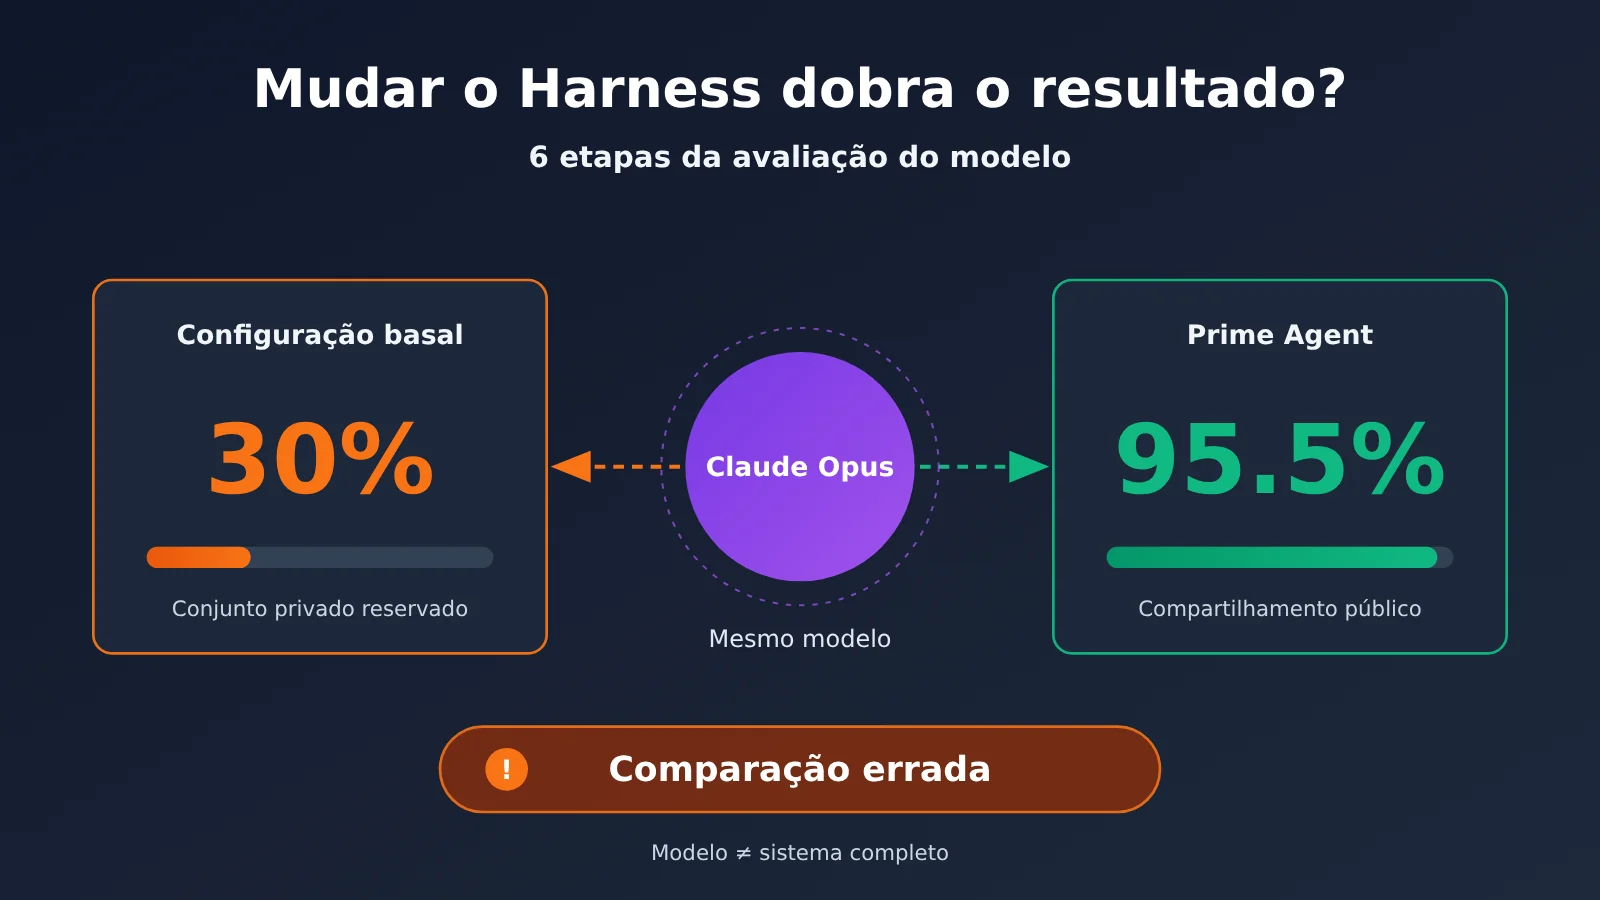
Trocar o Harness dobra a pontuação: pontos centrais da avaliação de modelos
O Harness é uma camada de sistema entre o LLM e o mundo externo, responsável por fornecer estado persistente, ferramentas e capacidade de computação. Seth Karten usou uma analogia: um LLM puro é como uma máquina de Turing, e o Harness é como um computador de von Neumann capaz de ler e gravar memória externa. Ao avaliar um agente, a capacidade de raciocínio do modelo e o poder expressivo dessa camada de sistema afetam o resultado ao mesmo tempo.
A tabela abaixo lista alguns dados públicos relacionados ao ARC-AGI apresentados na palestra. Esses resultados vêm de modelos, Harness ou configurações de avaliação diferentes e não podem ser usados diretamente como ranking de modelos.
| Configuração | Resultado público | O que observar ao ler |
|---|---|---|
| Claude Opus, validação em conjunto privado reservado | Melhor resultado: 30% | Este é o baseline da apresentação e não representa todas as condições de execução |
| Prime Agent + Opus | 95.5% | O material não detalha item a item todas as diferenças em relação ao baseline; não convém atribuir o resultado a uma única variável |
| Prime Agent + GPT-5.6 Sol | 78% | Este é o resultado após o isolamento do sandbox |
| Prime Agent + GPT-5.6 Terra | 25.7% | Com o mesmo Harness, a diferença entre modelos continua evidente |
| Nvidia AVO | 100% | A apresentação fornece apenas o resultado; antes de comparar, ainda é preciso verificar a configuração específica |
A relação entre Harness e avaliação de modelos
O Prime Agent divide o contexto em três camadas: L1 são os pesos do modelo, L2 é o contexto ativo e o REPL, e L3 é o estado de agendamento, como o sistema de arquivos. O Harness realiza compressão, operações de CRUD e refinement entre as camadas, com um papel próximo de cache mais coleta de lixo. Isso significa que, ao trocar o Harness de um mesmo modelo, a memória e a capacidade de computação disponíveis podem mudar.
Mas isso não significa que o modelo não importa. O Prime Agent se destaca no ARC-AGI, mas em avaliações de longo prazo como Oolong e Emulator Bench fica principalmente empatado ou ligeiramente melhor, e em tarefas de kernel de GPU também fica mais ou menos empatado. O tipo de tarefa determina quanto o Harness consegue ampliar a diferença, então não dá para extrapolar o resultado de um item para todos os cenários.
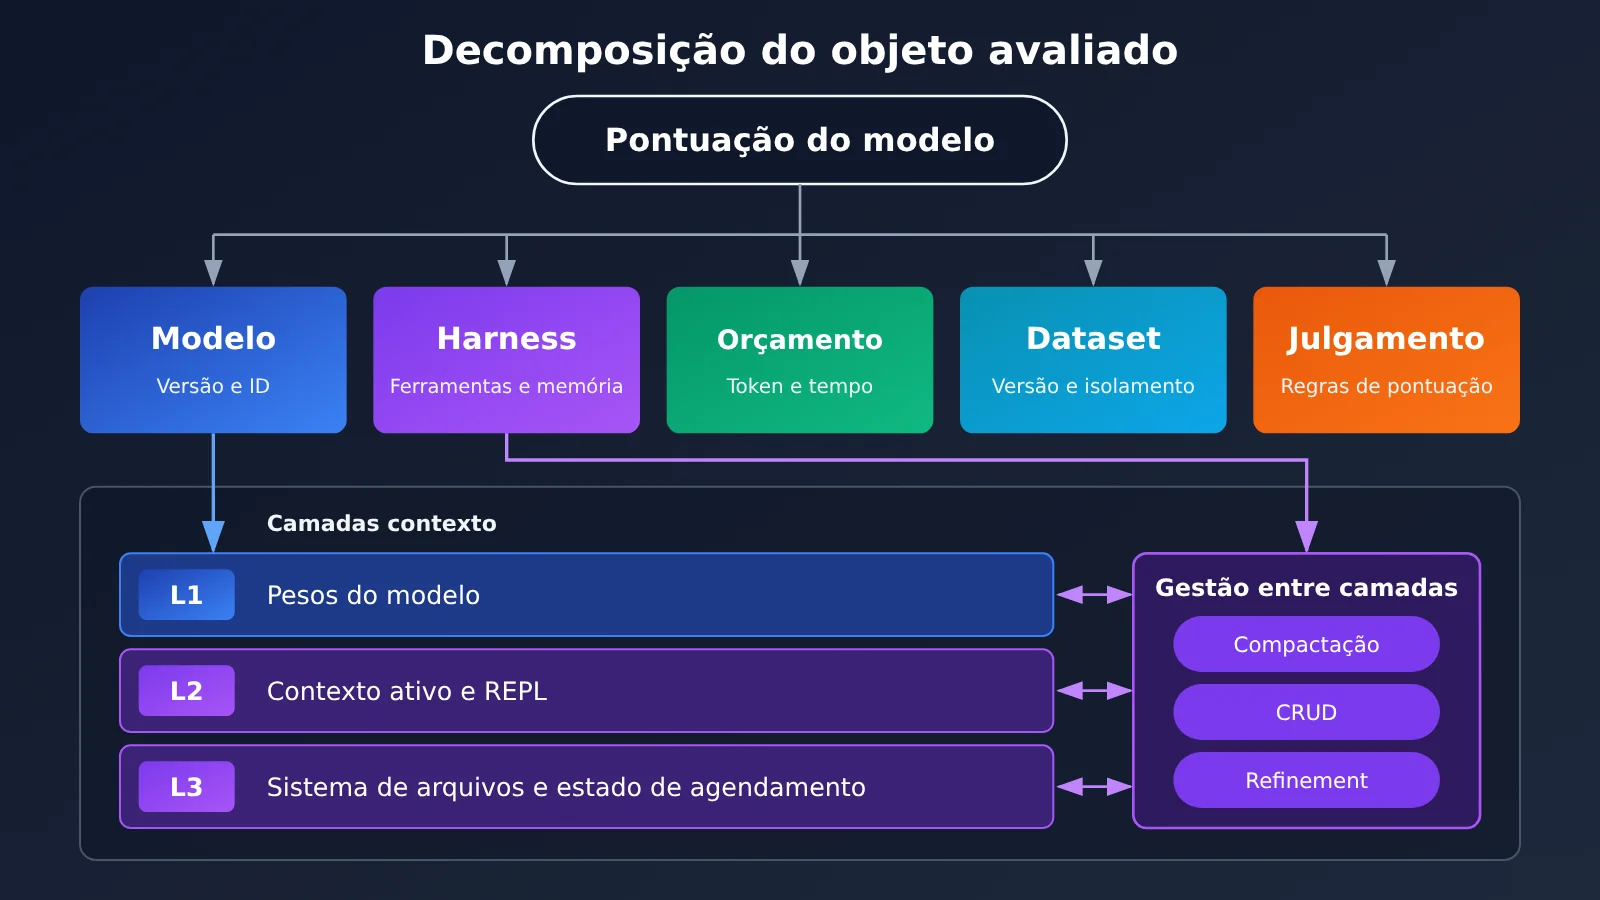
As 5 variáveis mais fáceis de comparar errado na avaliação de modelos
| Variável | Comparação errada comum | O que deve ser registrado |
|---|---|---|
| Modelo | Escrever apenas o nome da família, sem a versão específica | ID do modelo, registro real das chamadas, casos de fallback ou troca |
| Harness | Tratar a configuração padrão como capacidade do modelo | Ferramentas, comando de sistema, subagentes, memória e mecanismos de compressão |
| Orçamento | A roda até atingir um platô, B para antes do tempo | Tokens, tempo real, custo, condições de parada antecipada |
| Conjunto de avaliação | Comparar resultados de conjunto público com resultados de conjunto privado | Versão do dataset, forma de isolamento, se existe vazamento de informação |
| Forma de julgamento | Deixar o LLM apenas julgar se a correção ou a resposta foi bem-sucedida | Regras de pontuação, proporção de verificação manual por amostragem, amostras contestadas |
Sugestão prática: se você quiser comparar vários modelos no mesmo fluxo de avaliação, pode chamar os modelos abordados neste artigo via APIYI apiyi.com, reduzindo diferenças de integração. A APIYI é compatível com os formatos de interface da OpenAI e da Anthropic; para nomes específicos de modelos e formas de integração, consulte a documentação em docs.apiyi.com.
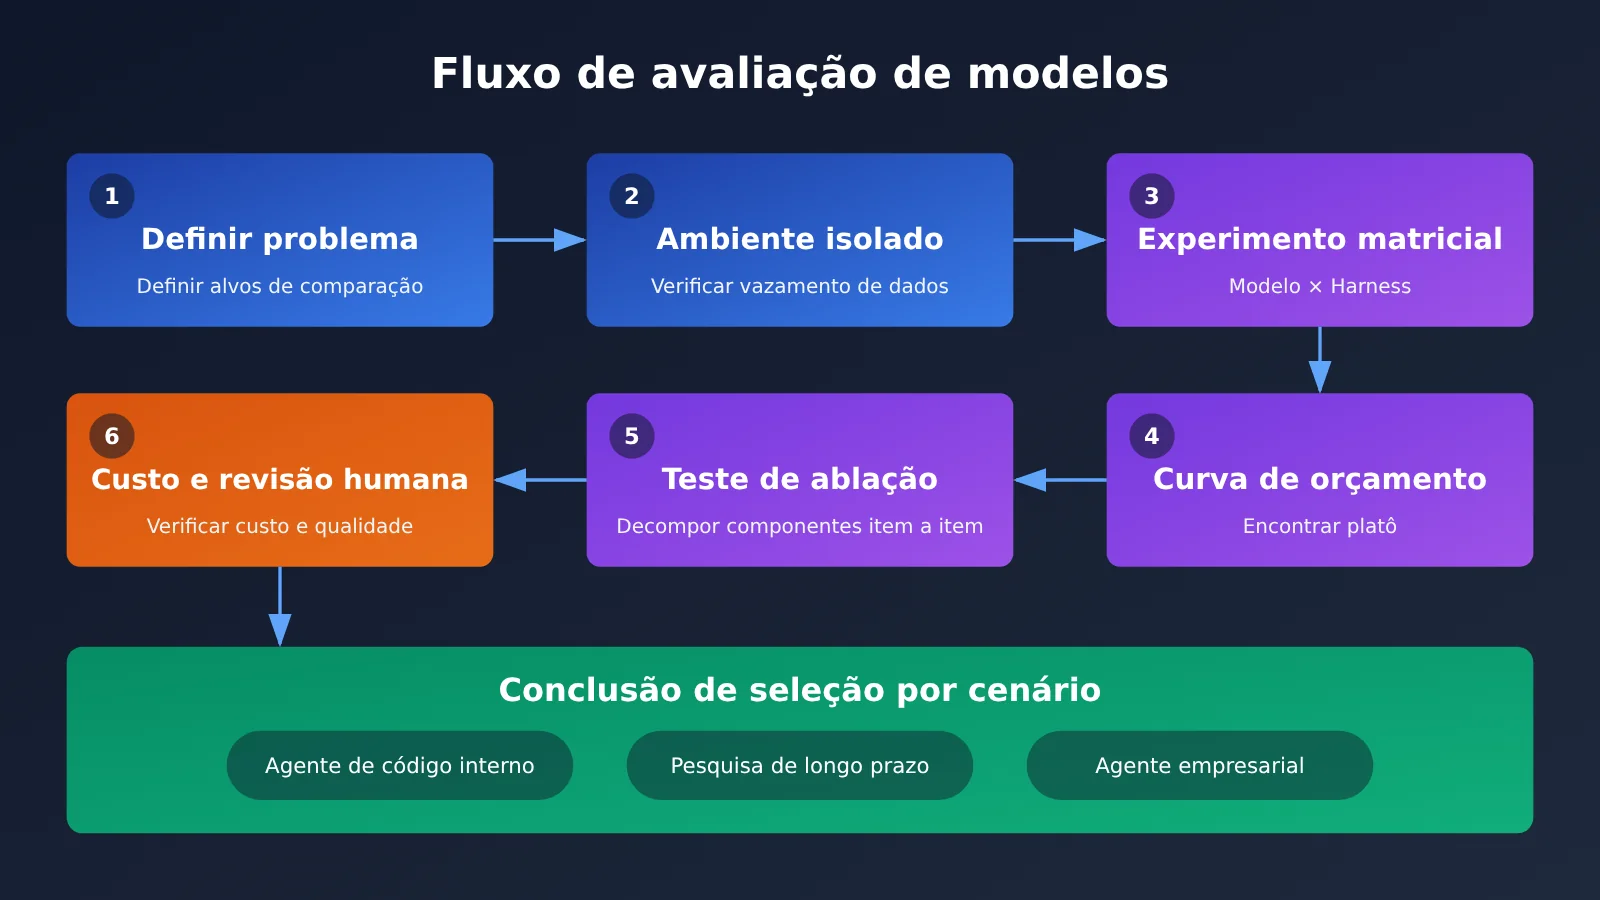
Guia rápido de avaliação de modelos com Harness: 6 etapas
O fluxo abaixo serve para seleção de modelos, atualização de Agentes e testes de benchmark internos. Você não precisa montar uma plataforma enorme de avaliação logo de cara: primeiro registre as variáveis por completo e depois vá adicionando tarefas e modelos aos poucos.
Etapa 1: defina claramente o que será comparado na avaliação do modelo
Comece definindo o problema experimental em uma frase, por exemplo: “sob o mesmo Harness e orçamento, comparar a capacidade de dois modelos de concluir tarefas internas de programação”. Se a pergunta for “qual Agente é melhor?”, o objeto de comparação é a combinação de modelo e Harness, e a conclusão também não pode ser escrita como “qual modelo é mais forte”.
A especificação da avaliação deve fixar pelo menos model, o comando de sistema, a lista de ferramentas, max_tokens, o número máximo de rodadas e o orçamento total. Se o Harness permitir que o Agente escolha o runtime de forma autônoma, registre também qual modelo foi realmente usado em cada etapa. O design do QM permite que o Agente mude para outro modelo quando encontra uma recusa; nesse caso, a pontuação final já não pertence a um único modelo.
Etapa 2: Isolar o ambiente e os dados de avaliação do Harness
Seth certa vez colocou o prompt de sistema do ranking da comunidade no Prime Agent e, na primeira execução, obteve 99,9%. Ao inspecionar os logs, descobriu que estava trapaceando; depois disso, passou um dia inteiro fazendo o isolamento em sandbox, e a pontuação do GPT-5.6 Sol caiu para 78%. Uma pontuação alta não significa necessariamente erro, mas pontuações anormalmente altas exigem, antes de tudo, uma checagem dos logs.
Ao verificar, foque em três coisas: se o Agent consegue ler as respostas ou resultados históricos, se o prompt contém informações exclusivas do conjunto de avaliação e se as chamadas de ferramentas ultrapassaram as permissões previstas. Para tarefas fora dos benchmarks públicos, reserve também um conjunto de amostras retidas que não participam do ajuste, para evitar que o prompt e o Harness sofram overfitting.
Etapa 3: Comparar com a matriz “modelo × Harness”
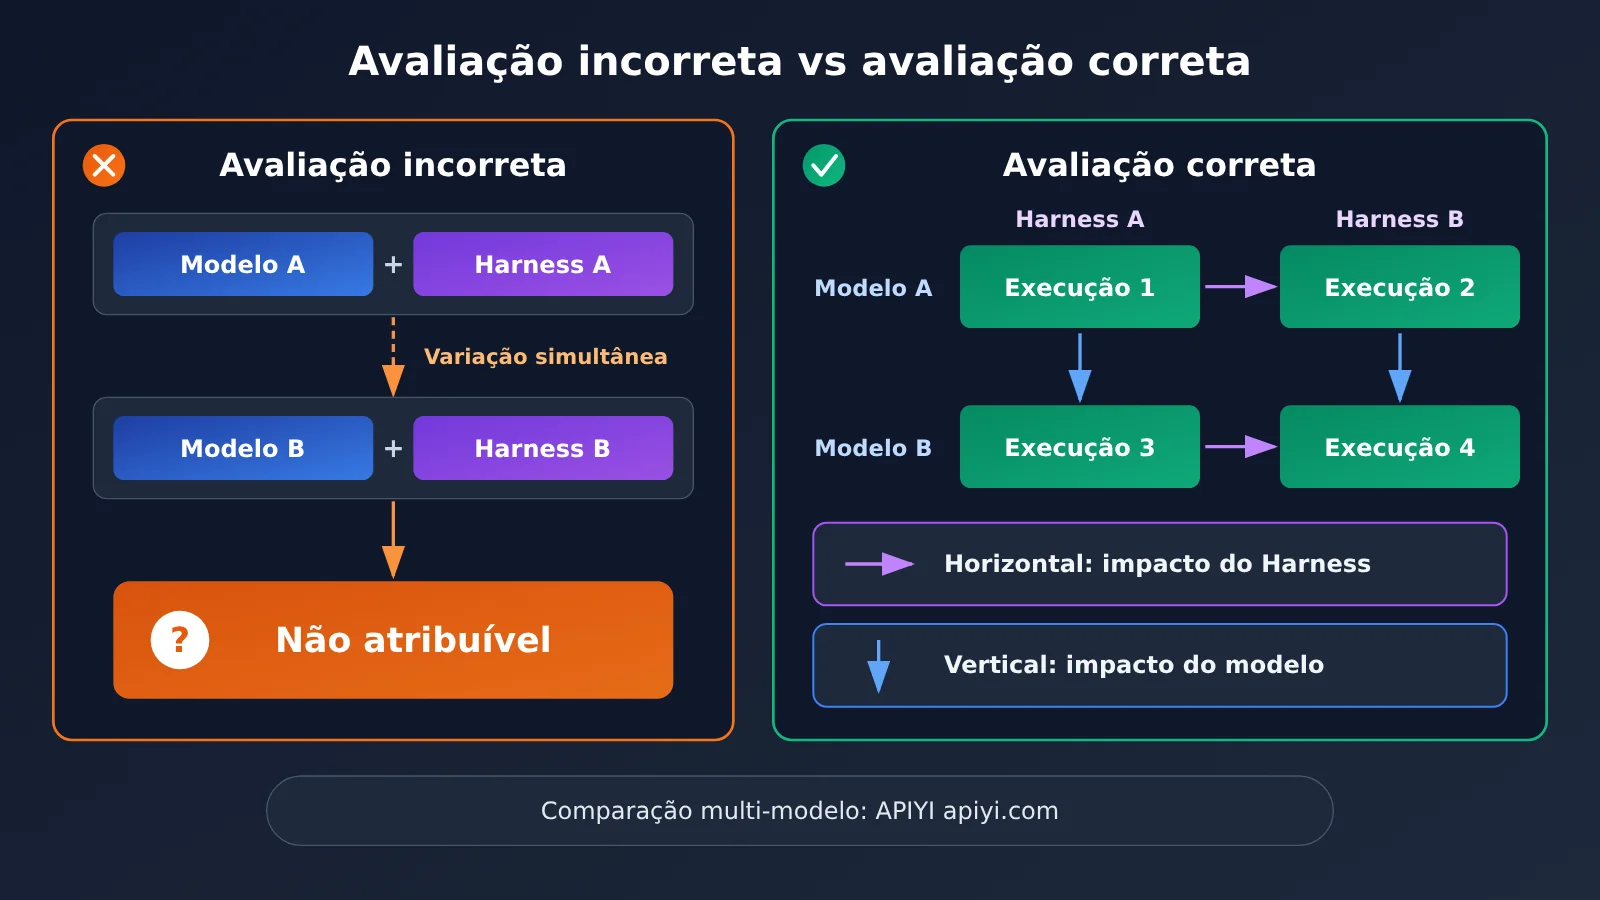
Não execute apenas “modelo A + Harness A” e “modelo B + Harness B”, porque, com duas variáveis mudando ao mesmo tempo, não é possível atribuir causalidade. A solução mínima é uma matriz 2 × 2: dois modelos rodando em dois conjuntos de Harness, mantendo o mesmo conjunto de tarefas e o mesmo orçamento.
| Resultado da matriz | Explicação mais provável | Próxima ação |
|---|---|---|
| Trocar o modelo muda bastante, trocar o Harness muda pouco | A tarefa atual depende mais da capacidade do modelo | Priorizar a seleção de modelo |
| Trocar o Harness muda bastante, trocar o modelo muda pouco | A capacidade do sistema é o principal gargalo | Priorizar a melhoria das ferramentas e da gestão de contexto |
| Há influência cruzada evidente entre os dois | Existe uma relação de adequação entre modelo e Harness | Selecionar por combinação, sem escrever um ranking único |
| Nenhum dos dois muda de forma evidente | A tarefa é simples demais, difícil demais ou a avaliação é insensível | Redesenhar o conjunto de avaliação e as métricas |
Sugestão de experimento controlado: experimentos em matriz exigem trocar de modelo com frequência. Você pode usar a APIYI apiyi.com para invocar modelos diferentes com uma conta e uma configuração de interface unificadas, e manter o ID do modelo nos registros do experimento para facilitar a rastreabilidade posterior.
Passo 4: Alinhar o orçamento e observar o platô de desempenho do modelo
Seth aponta em sua apresentação que, se um modelo não roda por tempo suficiente, ou para quando o orçamento se esgota enquanto outro continua trabalhando, você não está comparando pelo mesmo gasto e ainda está escondendo o desempenho real. O mais razoável é definir vários pontos de orçamento e observar a curva de pontuação crescendo em função de Tokens ou tempo.
A experiência da equipe QM também mostra a importância do orçamento. Eles descobriram que os Agentes costumavam desistir cedo demais, então tentaram “afiar as ferramentas”: definir um orçamento para o objetivo e não permitir desistir antes de atingir o tempo real ou o consumo de Tokens — e a qualidade do resultado da pesquisa melhorou. Portanto, a especificação da avaliação não deve apenas definir o teto de orçamento, mas também deixar claro se existe exigência de investimento mínimo.
Passo 5: Fazer testes de ablação no Harness
Depois de ver que o Harness traz ganhos, o próximo passo é descobrir de qual capacidade vem esse ganho. O Prime Agent enfatiza a expressividade e considera que compressão, REPL Python, subagentes programáveis, acesso a estado e mecanismos de feedback não devem ser removidos facilmente, mas, na sua tarefa, a contribuição real de cada capacidade ainda precisa ser testada.
A abordagem é desligar uma capacidade por vez, por exemplo desativar o REPL, desativar subagentes ou desativar a memória de longo prazo, mantendo as demais configurações inalteradas. Se, ao desligar, a pontuação praticamente não mudar e o custo cair de forma evidente, essa capacidade pode não valer a pena ser mantida por enquanto. Já para tarefas de alta variância, como pesquisa automatizada, é preciso repetir as execuções várias vezes, pois, como Seth também menciona, esse tipo de tarefa é difícil de atribuir diretamente ao Harness ou ao modelo.
Passo 6: Calcular custos e incluir revisão manual
Seth também mencionou que, ao rodar avaliações com o Hermes Agent, gastou rapidamente US$ 5,000 e não viu uma melhoria clara, tendo que interromper. Isso não significa que seja o limite de capacidade do Hermes Agent, mas já basta para mostrar que a relação custo-desempenho deve entrar nas conclusões da avaliação. O relatório final recomenda listar, ao mesmo tempo, taxa de sucesso, tempo de conclusão, consumo de tokens e custo por sucesso.
Ao calcular custos, não deixe os preços fixos na documentação do script de avaliação. Para os preços unitários de entrada e saída dos modelos, preço de cache e critério de cobrança, use os dados reais da página de preços da APIYI https://docs.apiyi.com/models e indique a data da consulta no relatório.
Na etapa de pontuação, também é preciso manter a inspeção manual por amostragem. A equipe QM descobriu que, ao pedir para um LLM julgar o resultado da correção, aparece a “síndrome do protagonista”: ele vê apenas parte do elefante, não o sistema inteiro. Quando o assunto envolve processos de negócio, também é preciso testar limites de permissão, porque o Agent entende pior contextos sociais e informações privilegiadas podem vazar para contextos onde não deveriam aparecer.
Como colocar em prática a matriz de avaliação de modelos com API
Na execução real, recomendo dividir a avaliação em três partes: conjunto de tarefas, configuração de execução e registro de resultados. Assim, ao trocar o modelo ou o Harness, basta alterar um item de configuração, sem reescrever todo o fluxo.
| Item de configuração | O que registrar | Observação |
|---|---|---|
| Formato da interface | Compatível com OpenAI ou formato Anthropic | Diferentes formatos podem ter estruturas de mensagens e chamadas de ferramentas distintas; é preciso validar separadamente |
| Endereço de acesso e chave | base_url, nome da variável de ambiente |
O endereço deve seguir a documentação em docs.apiyi.com; não grave a chave no relatório de avaliação |
| Parâmetros de execução | model, max_tokens, número máximo de rodadas, número de repetições |
Garanta que cada experimento possa ser reproduzido |
| Critério de custo | Entrada, saída, cache e data da consulta | Use os dados reais da página de preços da APIYI: docs.apiyi.com/models |
| Resultados da execução | Pontuação, motivo da falha, tokens, duração, log de chamadas | Para analisar períodos de estagnação e a relação custo-desempenho |
Se o seu Harness suporta as duas interfaces ao mesmo tempo, recomendo primeiro fazer uma comparação de formato com o mesmo modelo. Assim você confirma que a conversão de mensagens, a definição de ferramentas e o retorno em streaming não afetaram os resultados, evitando que problemas de integração sejam mal interpretados como diferenças de capacidade do modelo.
Dica de integração: A APIYI oferece chamadas de API para os modelos deste artigo, compatíveis com os formatos OpenAI e Anthropic. Antes de começar os experimentos, verifique no docs.apiyi.com os modelos disponíveis no momento e a forma de chamada; depois grave o ID do modelo na especificação da avaliação.
Perguntas frequentes (FAQ)
Q1: O que é um Harness na avaliação de modelos?
O Harness é a camada de sistema que conecta o modelo ao mundo externo, normalmente incluindo controle de loop, gerenciamento de contexto, ferramentas, subagentes, memória e acesso a estado. Ele determina o que o modelo consegue ver, o que consegue chamar e por quanto tempo consegue executar.
Q2: Uma pontuação mais alta no Harness significa que o modelo ficou mais forte?
Não. Com os pesos inalterados, uma pontuação maior provavelmente indica que o sistema liberou mais capacidade, ou que a configuração está mais adequada para essa tarefa. Se Harness, orçamento e modelo mudarem ao mesmo tempo, não dá para atribuir o resultado isoladamente — e também pode haver vazamento no ambiente de avaliação.
Q3: Quando é preciso refazer a avaliação do modelo?
Sempre que a versão do modelo, o comando de sistema, as permissões de ferramentas, a estratégia de compactação ou as tarefas de negócio mudarem, é preciso reavaliar. A área de Harness evolui muito rápido; os dados deste artigo vêm de um material organizado publicado pelo InfoQ em novembro de 2026, e os resultados podem mudar depois.
Q4: Para quais cenários esse método de avaliação de modelos é adequado?
Principalmente para os seguintes cenários:
– **Seleção interna de agentes de codificação**: comparar a taxa de conclusão de tarefas por combinação de modelo e Harness.
– **Tarefas de pesquisa de longo prazo**: observar o platô e a variância dos resultados depois de aumentar o orçamento.
– **Validação antes de colocar agentes corporativos em produção**: testar ao mesmo tempo qualidade, custo e limites de permissão.
Q5: Como integrar rapidamente vários modelos para comparar Harness?
Primeiro defina a tarefa de avaliação e a lista de modelos, depois integre via APIYI apiyi.com. A plataforma oferece chamadas de API para os modelos citados neste artigo, compatíveis com os formatos de interface da OpenAI e da Anthropic. Consulte a documentação em docs.apiyi.com para os IDs de modelo e os métodos de configuração, e mantenha as demais variáveis constantes durante o experimento.
Q6: Como devem ser escritos os preços dos modelos no relatório de avaliação?
Recomenda-se citar apenas dados de preço já verificados e indicar a data da consulta. Os preços unitários de entrada e saída, os preços de cache e os critérios de cobrança dos modelos devem seguir os dados reais da página de preços da APIYI https://docs.apiyi.com/models, sem reaproveitar tabelas antigas ou valores estimados.
Q7: Quais são as limitações desse método de avaliação de Harness?
Experimentos em matriz, execuções repetidas e revisão manual aumentam o tempo e o custo. A variância em tarefas de longo prazo também pode ser alta; mesmo controlando as principais variáveis, ainda é difícil fazer uma atribuição precisa. Por isso, ele é mais adequado para apoiar decisões e não deve tratar um único resultado como ranking absoluto.
Pontos-chave da avaliação de modelos com Harness
- Defina primeiro o objeto de comparação: deixe claro se a comparação é entre modelos ou entre a combinação modelo + Harness.
- Pontuação anormalmente alta? Verifique os logs primeiro: em 99,9% dos casos, o ambiente isolado é pré-requisito para a avaliação.
- Use uma matriz para separar as variáveis: acesse vários modelos via APIYI e monte um comparativo modelo × Harness.
- O orçamento precisa estar alinhado: observe a curva em vários pontos de orçamento para encontrar o platô real.
- Ablação para localizar a contribuição: desative uma capacidade por vez e confirme de onde vem o ganho.
- Confirme os dados de custo: preços e critérios de cobrança devem seguir a página de preços da APIYI.
- Mantenha o julgamento humano: a avaliação feita por LLM pode ser parcial, e os riscos de permissão também exigem testes específicos.
Conclusão
A ideia de que “trocar o Harness dobra a pontuação” merece atenção, mas não deve ser interpretada de forma simplista como “o modelo não importa”. Os dados compartilhados mostram tanto o efeito amplificador do Harness quanto o fato de que ainda existem diferenças claras entre modelos e tarefas: conclusões confiáveis precisam se basear em experimentos controlados.
Na hora de aplicar, vale lembrar três pontos prioritários:
- Deixe claro o objeto de avaliação: registre modelo, Harness, orçamento, conjunto de avaliação e método de julgamento.
- O desenho experimental precisa permitir atribuição de causa: use experimentos em matriz e testes de ablação para separar as variáveis, além de isolar o ambiente de avaliação.
- As conclusões devem ser orientadas ao cenário: analise ao mesmo tempo o platô, a relação custo-desempenho, os resultados da revisão humana e os riscos de permissão.
Se você pretende validar sua própria combinação de modelos, pode acessar os modelos citados neste artigo via APIYI apiyi.com e concluir a configuração seguindo a documentação em docs.apiyi.com. Para estimativas de custo, consulte https://docs.apiyi.com/models e obtenha os dados de preço atuais.
📚 Materiais de referência
- InfoQ: O mesmo modelo foi de 30 para 95 pontos: o que cria a diferença não é o modelo, é o Harness
- Link:
infoq.cn/article/C1C1DThg8z1Dy0rZAmLB -
Descrição: Os resultados, casos e pontos de vista de design citados neste artigo vêm todos deste texto compilado.
-
Vídeo da palestra YC Paper Club Harness Night
- Link:
youtube.com/watch?v=n9xKblqyQ28 -
Descrição: Aqui você pode conferir o contexto completo das três apresentações: Prime Agent, OpenJarvis e QM.
-
Central de documentação APIYI
- Link:
docs.apiyi.com -
Descrição: Para verificar os modelos disponíveis, o formato das interfaces e a configuração de integração.
-
Página de preços de modelos da APIYI
- Link:
docs.apiyi.com/models - Descrição: O preço unitário dos modelos, o preço de cache e os critérios de cobrança seguem os dados reais desta página.
Autor: Equipe técnica da APIYI
Contato técnico: Se quiser entender como integrar modelos, fique à vontade para visitar o site oficial da APIYI em apiyi.com; mais materiais estão disponíveis na central de documentação em docs.apiyi.com.