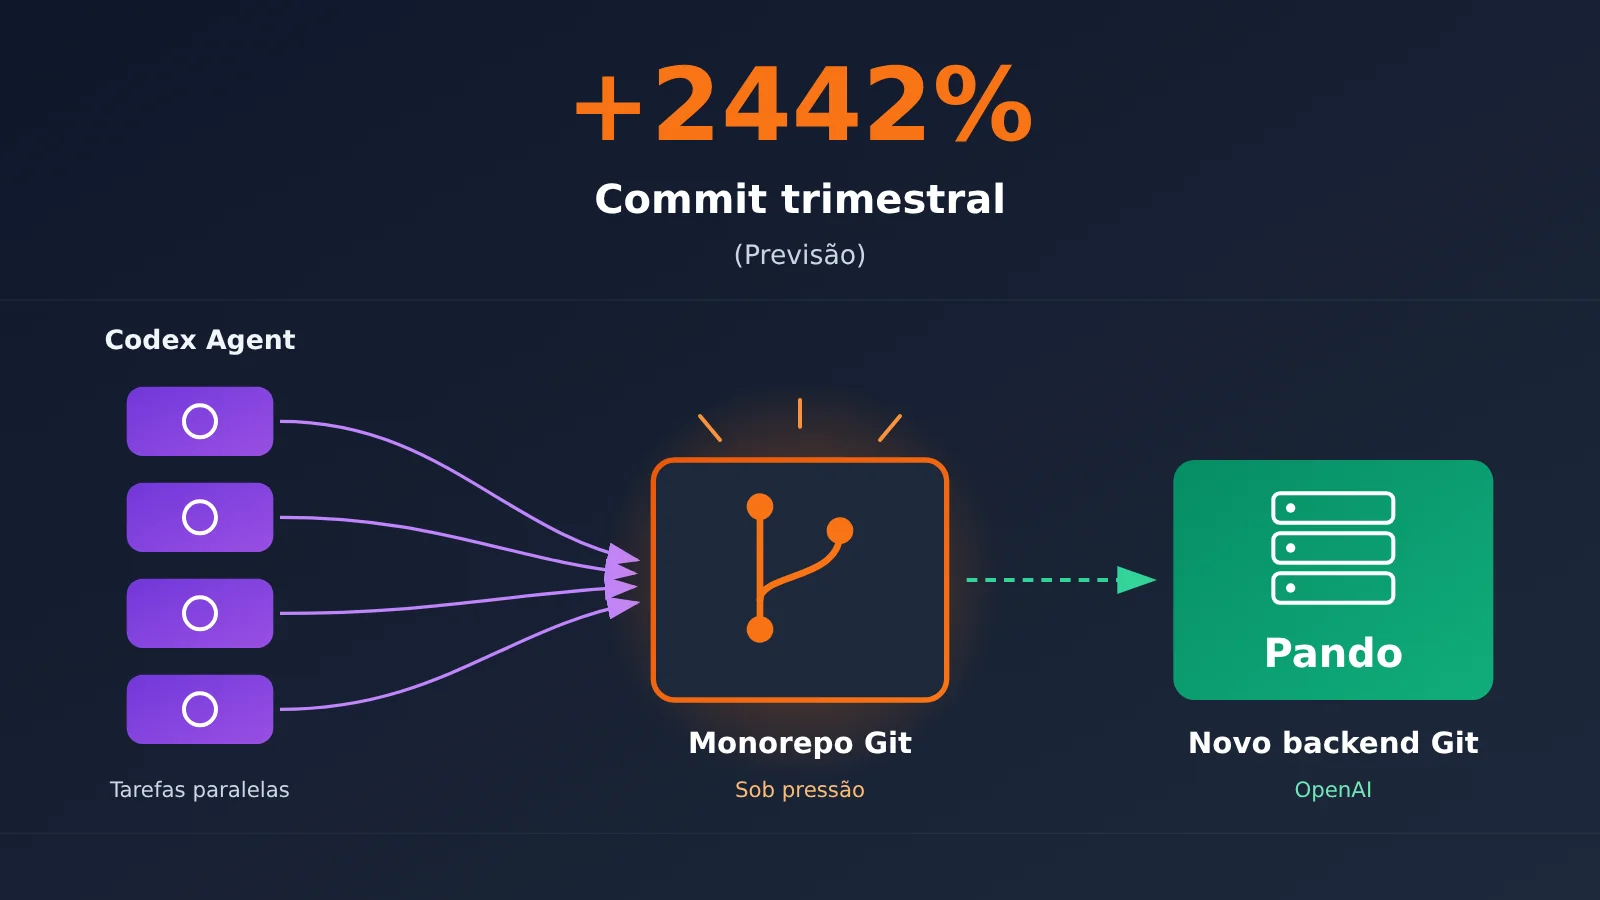
Nota do autor: a OpenAI apresentou o Pando, seu novo backend para Git. Com o Codex, o volume trimestral de commits no monorepositório deve crescer 2442% em relação ao primeiro trimestre de 2024. Este artigo mostra como os efeitos da programação com IA se propagam da geração de código para o Git, a CI e a revisão de código.
Em 2 de novembro de 2026, a OpenAI publicou o artigo técnico “Scaling Git at OpenAI”. Um gráfico do artigo mostra que o volume trimestral de commits no monorepositório da OpenAI deve crescer 2442% no quarto trimestre de 2026 em relação ao primeiro trimestre de 2024. Para lidar com a pressão do desenvolvimento paralelo impulsionado pelo Codex, a OpenAI criou um novo backend para Git, chamado Pando.
Isso não é um boato nem um slogan de marketing sobre “a IA multiplicar o volume de código por 24”. Os dados vêm do blog oficial de engenharia da OpenAI, em um artigo assinado por Aaron Friel, Taylor Blau e Ted Nyman. Vale esclarecer dois pontos: os 2442% são uma projeção, já que o quarto trimestre ainda não terminou; e a métrica é o número de commits incorporados à branch master, não o número de linhas de código, muito menos a produtividade.
O que você vai entender: como o Codex está mudando a escala do desenvolvimento de software na OpenAI por meio de tarefas paralelas, por que isso pressiona a infraestrutura do Git e para onde os gargalos do desenvolvimento estão migrando.
Codex e a infraestrutura Git da OpenAI: resumo das informações
Vamos começar com uma tabela dos fatos. Todas as informações abaixo foram divulgadas oficialmente pela OpenAI; o que não foi informado está indicado.
| Item | Detalhes |
|---|---|
| Data de publicação | 2 de novembro de 2026, em “Scaling Git at OpenAI” |
| Responsáveis | Equipe de engenharia da OpenAI (Aaron Friel, Taylor Blau e Ted Nyman) |
| Conteúdo principal | Pando, um novo backend de servidor Git compatível com o protocolo e os clientes Git padrão |
| Contexto | O Codex aumentou o paralelismo no desenvolvimento, e o sistema Git antigo passou a apresentar problemas de desempenho e confiabilidade |
| Início em produção | Abril de 2026; cerca de 10 semanas entre o início do projeto e a entrada em produção |
| Principais resultados | Redução de quase 80% na latência mediana de push e entrega de quase 1 PB de dados Git por dia |
| Disponibilidade | Apenas para uso interno da OpenAI; não há servidor público, preços ou data de abertura divulgados |
Panorama do crescimento trimestral de commits impulsionado pelo Codex
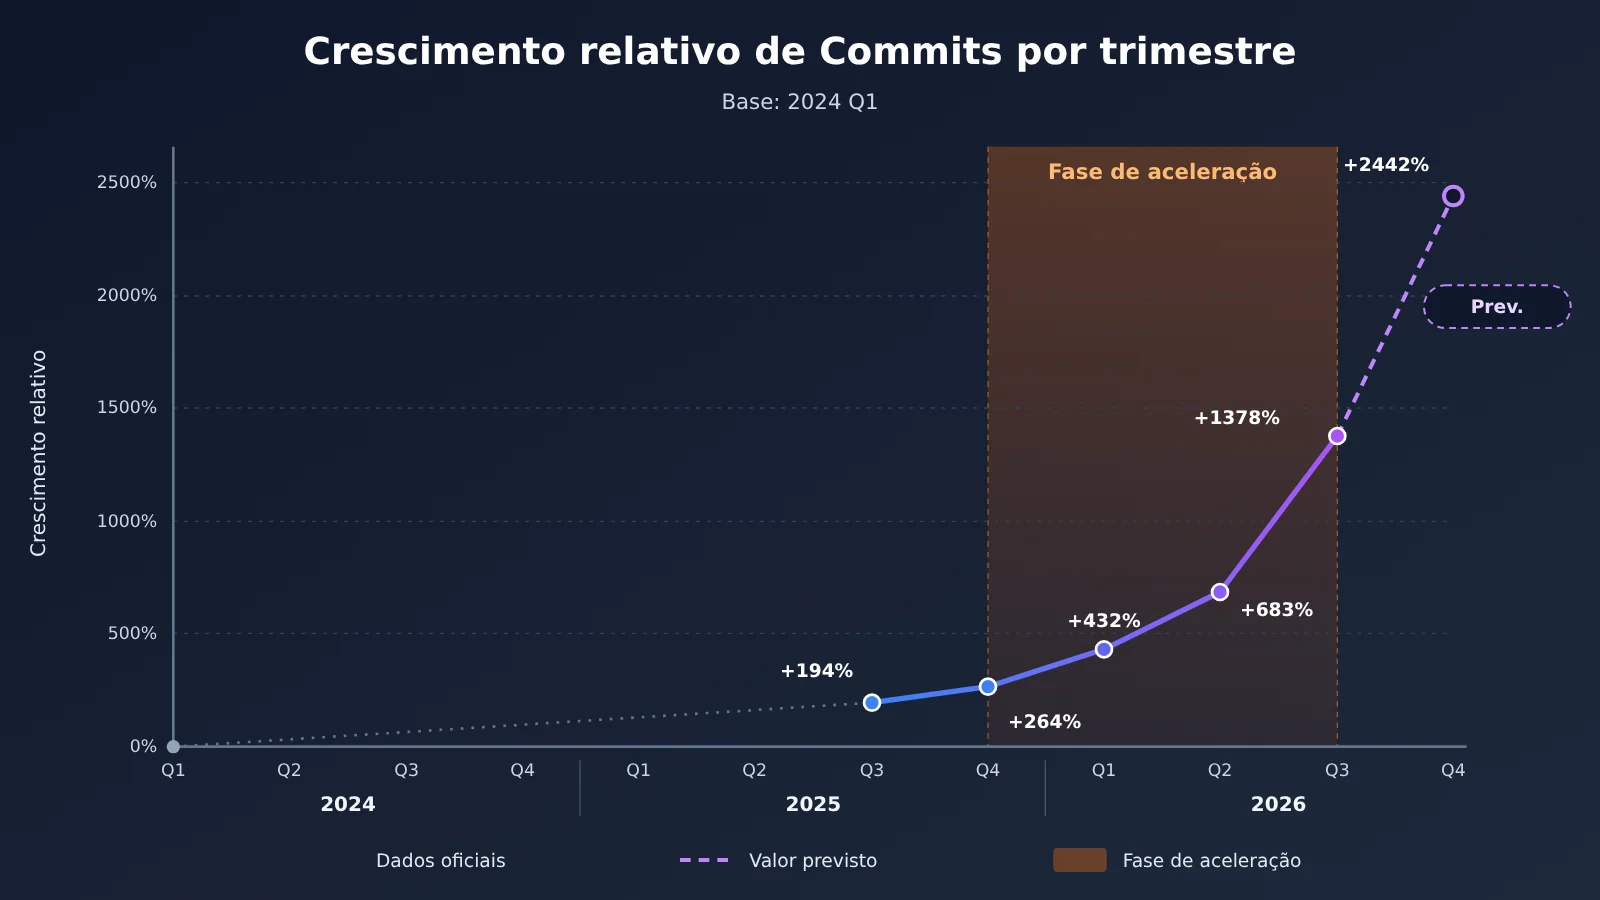
Muitas notícias citam apenas o crescimento de 2.442%. A sequência trimestral completa ajuda a entender melhor o cenário. A tabela abaixo usa o primeiro trimestre de 2024 como base e contabiliza os commits incorporados à branch master do monorepositório da OpenAI a cada trimestre.
| Trimestre | Crescimento em relação ao 1º trimestre de 2024 | Múltiplo aproximado da base |
|---|---|---|
| 2º trimestre de 2024 | +35% | 1,35 |
| 4º trimestre de 2024 | +98% | 1,98 |
| 2º trimestre de 2025 | +194% | 2,94 |
| 4º trimestre de 2025 | +264% | 3,64 |
| 1º trimestre de 2026 | +432% | 5,32 |
| 2º trimestre de 2026 | +683% | 7,83 |
| 3º trimestre de 2026 | +1.378% | 14,78 |
| 4º trimestre de 2026 | +2.442% (previsão) | 25,42 |
Esses dados mostram três coisas. Primeiro, o crescimento já vinha acontecendo entre 2024 e 2025, então não dá para atribuí-lo inteiramente ao Codex. Segundo, a curva fica claramente mais íngreme entre os +264% do quarto trimestre de 2025 e os +1.378% do terceiro trimestre de 2026. Essa aceleração é compatível com a tendência de desenvolvimento paralelo com agentes descrita pela OpenAI. Terceiro, a empresa divulgou apenas as taxas de crescimento relativo, sem informar o número absoluto de commits por trimestre.
Outro conjunto de dados, medido de forma diferente, aponta na mesma direção. Em 20 de julho de 2026, ao apresentar o Codex Code Review, o blog de desenvolvedores da OpenAI informou que o número semanal de pull requests internos havia mais que dobrado em relação ao quarto trimestre anterior. Como os critérios e períodos de medição são diferentes dos usados para o crescimento trimestral de commits, os números não podem ser somados nem convertidos entre si. Ainda assim, ambos indicam uma rápida expansão das atividades de alteração de código.
Como o Codex transfere pressão para a infraestrutura Git
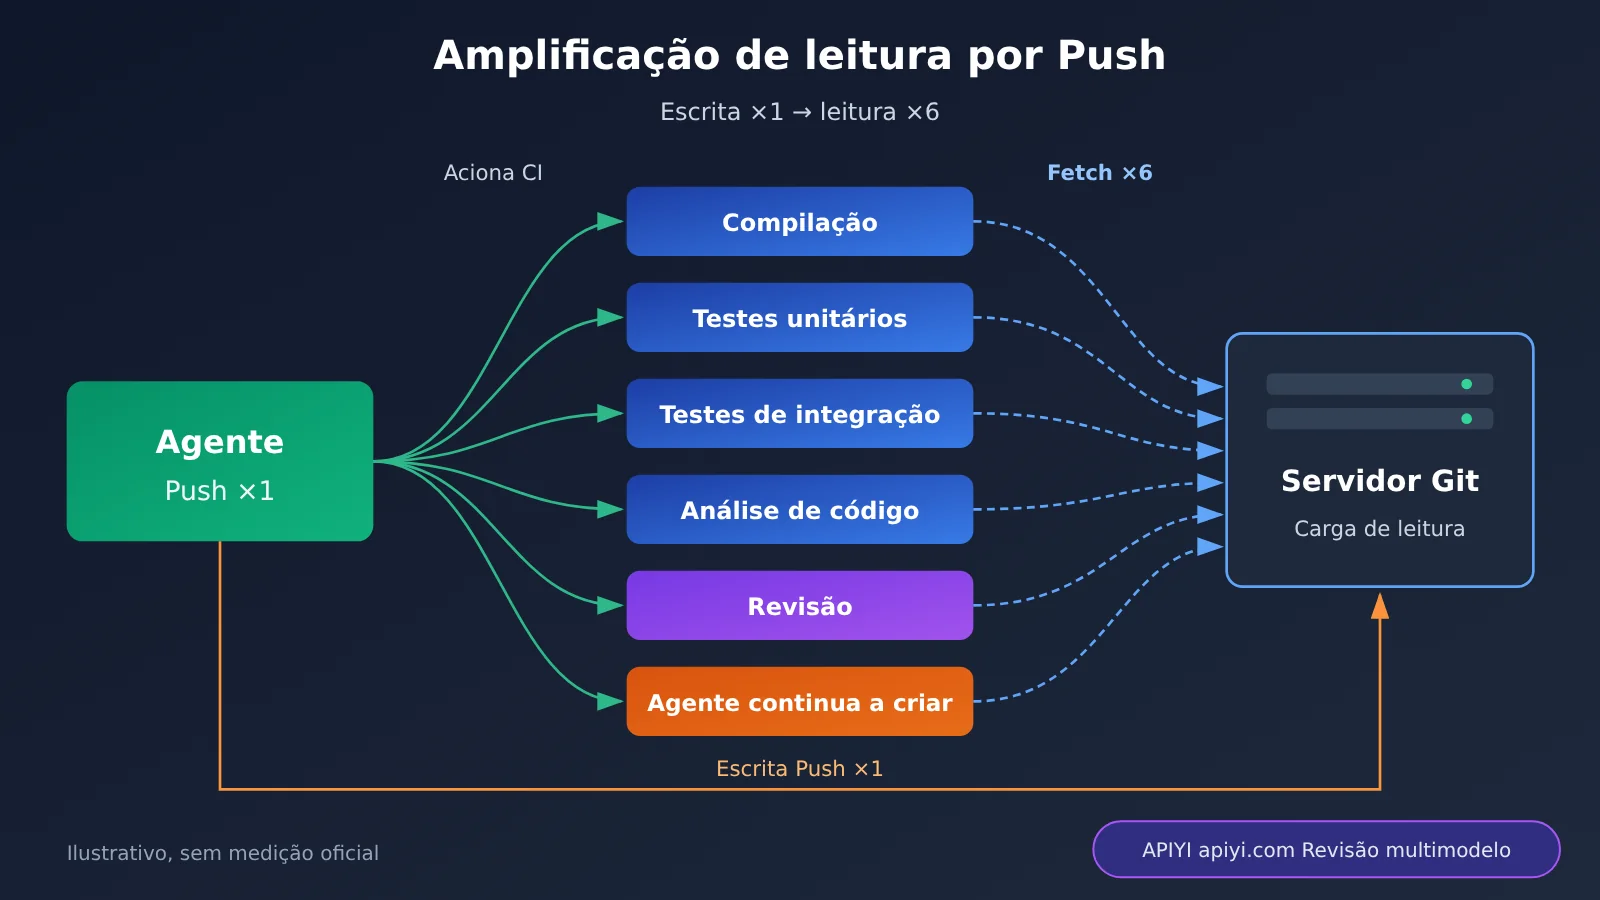
À primeira vista, “a IA escreve código mais rápido” parece afetar apenas o próprio desenvolvedor. Mas a explicação da OpenAI aponta para outra dimensão: o Codex aumenta a quantidade de tarefas executadas simultaneamente em todo o sistema de engenharia. Um engenheiro pode colocar vários agentes para trabalhar ao mesmo tempo em funcionalidades independentes. Cada agente gera branches, commits e pushes, que, por sua vez, acionam uma série de leituras automatizadas.
A tabela abaixo resume essa cadeia de causa e efeito com base na descrição oficial da OpenAI.
| Etapa | O que acontece | Impacto na infraestrutura Git |
|---|---|---|
| A. Redução do custo de execução | O engenheiro coloca vários agentes para modificar funcionalidades independentes ao mesmo tempo | Aumenta a quantidade de tarefas de desenvolvimento |
| B. Mais paralelismo | Mais branches, commits e pushes no Git | Aumentam as solicitações de gravação e as atualizações de branches |
| C. Amplificação pelo pipeline | Um push aciona várias compilações, testes e varreduras de CI | O mesmo commit é buscado repetidamente por meio de operações de fetch |
| D. Pressão sobre a infraestrutura compartilhada | Aumentam simultaneamente as mesclagens, a sincronização de status e a entrega de dados de versão | Push e fetch ficam mais lentos, e merges falham |
| E. Deslocamento do gargalo | O modelo escreve código mais rápido, mas Git, CI e revisão de código não acompanham o aumento de capacidade | A velocidade de entrega fica limitada pelas etapas seguintes |
Um cenário ilustrativo de amplificação de carga
O exemplo a seguir serve apenas para facilitar o entendimento; os números não são medições reais da OpenAI. Suponha que um push acione 6 tarefas de CI, cada uma fazendo um fetch do código. Nesse caso, 100 pushes podem gerar cerca de 600 leituras de código. Se os agentes multiplicarem o número de pushes, o volume de leituras também crescerá na mesma proporção.
O volume real de solicitações depende do cache de CI, do reaproveitamento de tarefas e da arquitetura de compilação, mas a tendência é clara: o aumento das gravações é amplificado no lado das leituras. É justamente aí que o servidor Git começa a sentir a pressão. O texto da OpenAI também destaca que um mesmo commit pode ser buscado repetidamente por várias tarefas de CI, projetos de pesquisa e ambientes de desenvolvimento.
O que deu errado no antigo sistema Git da OpenAI
A OpenAI revelou que, a partir do fim de 2025, os sistemas que sustentavam seu monorepositório passaram a ter cada vez mais dificuldade para lidar com a nova carga. Entre os sintomas estavam operações de Git Fetch e Push mais lentas, falhas de Merge e uma confiabilidade da infraestrutura que, em alguns períodos, ficou abaixo de 90%.
É importante entender o que significa “abaixo de 90%”. O número descreve a confiabilidade do sistema em determinados períodos; os critérios exatos de medição e a série temporal completa não foram divulgados. Isso não significa que “10% do código tinha defeitos” nem que “mais de 10% dos commits da OpenAI falharam”.
Do ponto de vista técnico, a arquitetura antiga tinha dois gargalos estruturais:
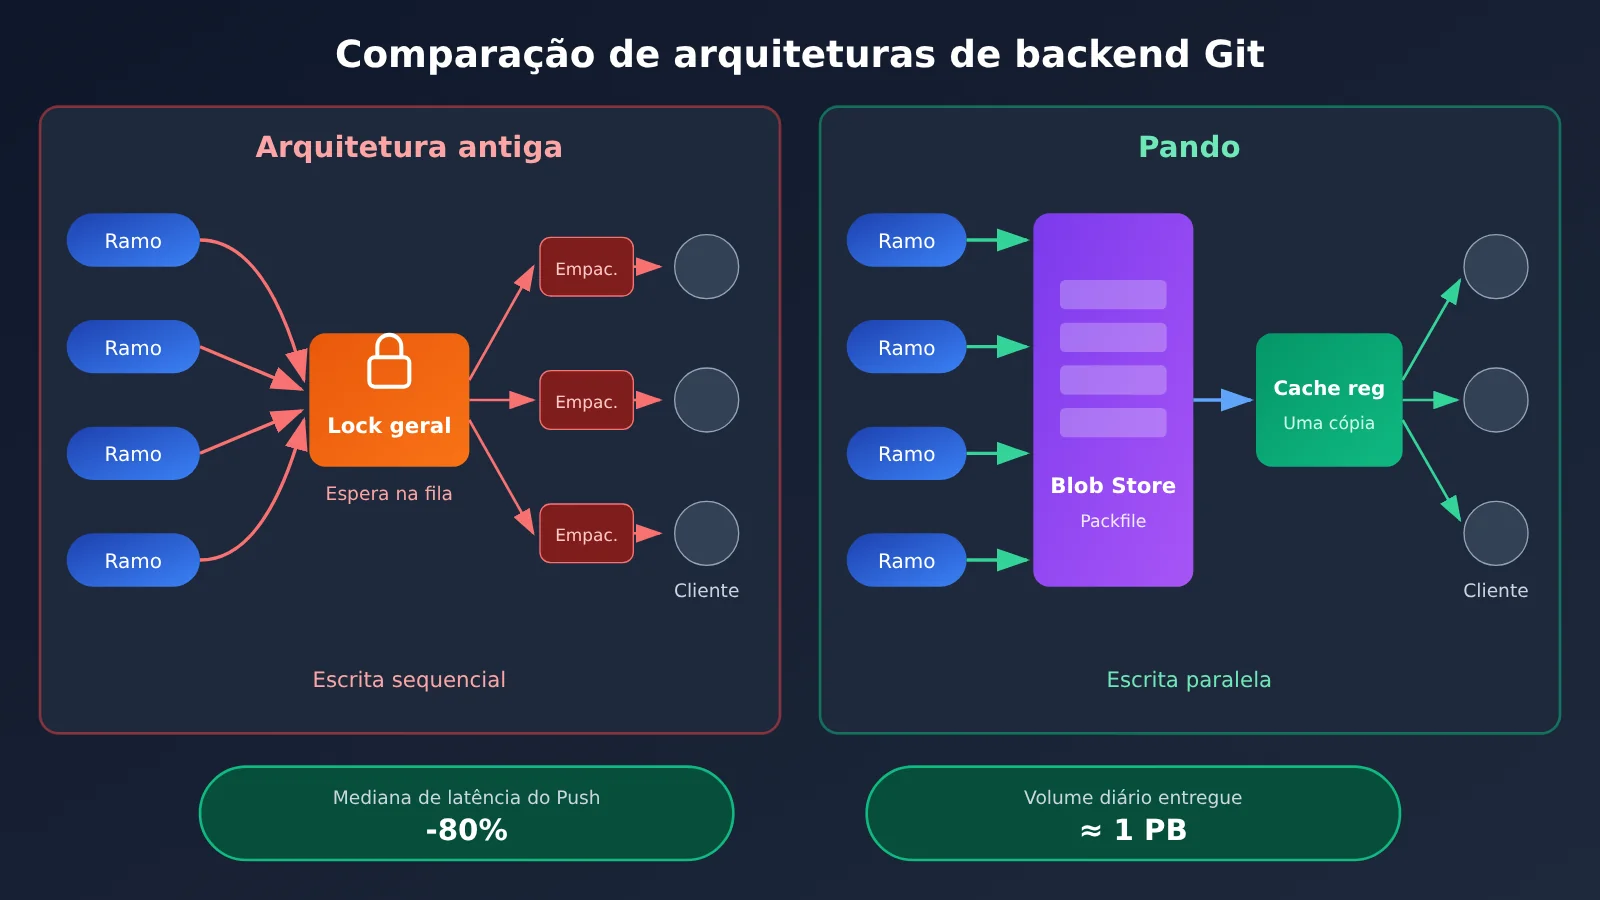
- Atualizações de branches exigiam coordenação global: muitos serviços Git distribuídos tradicionais precisam manter um estado consistente de todas as referências do repositório. Mesmo quando dois agentes modificam branches sem nenhuma relação entre si, eles podem acabar disputando o mesmo fluxo de coordenação.
- Pacotes de download eram calculados repetidamente: como cada cliente já possui um histórico Git diferente, o servidor muitas vezes precisa percorrer objetos, empacotá-los e compactá-los separadamente para cada cliente. Quando vários agentes leem a mesma versão, esse trabalho custoso é repetido.
Na época em que engenheiros humanos dominavam o fluxo de trabalho, esses problemas ainda eram toleráveis. Mas, quando um grande número de agentes e tarefas de CI passou a chegar ao mesmo tempo, eles se tornaram gargalos para o sistema.
Como o Pando responde à pressão que o Codex impõe ao Git
A OpenAI não abandonou o Git. O Pando continua usando o protocolo e os clientes Git padrão, e os comandos e fluxos de trabalho dos engenheiros permanecem praticamente iguais. O que mudou foi a forma como o servidor armazena dados, atualiza referências e entrega conteúdo. A tabela abaixo compara as principais diferenças entre a solução anterior e o Pando.
| Dimensão | Servidor Git tradicional | Pando |
|---|---|---|
| Escrita em branches | Coordenação rígida em todo o repositório; branches sem relação podem esperar umas pelas outras | Cada branch é atualizada de forma independente; a coordenação só é necessária para a mesma Ref |
| Modelo de consistência | Snapshot consistente de todo o repositório | Consistência causal, com garantia de ordem e leitura das próprias escritas na mesma branch |
| Entrega de dados | Reempacotamento e compressão conforme o estado do cliente | Reutilização do Packfile salvo no Push, com distribuição via cache |
| Cache | Depende da implementação | Serviço de cache regional, com taxa de acerto superior a 99% para Packfiles |
| Compatibilidade com clientes | Git padrão | Git padrão, com entrega pelo mecanismo packfile-uri |
As duas ideias centrais do Pando
A primeira é a concorrência na escrita. O Pando deixa de manter um snapshot consistente de todo o repositório em um único momento e passa a gerenciar as versões de cada branch de forma independente. Os Pushes para branches diferentes podem ocorrer em paralelo, e só as requisições que alteram a mesma Ref precisam resolver conflitos. A contrapartida é que, ao ler várias branches de uma vez, o cliente pode ver versões de momentos diferentes. A OpenAI considera essa troca adequada para seu cenário.
A segunda é a reutilização na leitura. O Pando armazena o Packfile recebido em cada Push como dados imutáveis em um Blob Store. Quando outro cliente faz Fetch, o servidor seleciona e entrega Packfiles já existentes com base nos Commits que o cliente tem e nos que deseja receber, em vez de empacotá-los novamente. Em segundo plano, muitos Packfiles pequenos também são mesclados em conjuntos maiores, em camadas, para evitar que clientes desatualizados há muito tempo precisem baixar arquivos demais.
Os dados de produção divulgados incluem: queda de quase 80% na mediana da latência de Push; entrega de quase 1 PB de dados Git por dia; e pico de entrega de Packfiles superior a 57 TB em uma única hora. Vale lembrar que 1 PB é o volume entregue: leituras repetidas dos mesmos dados também entram na conta. Isso não significa que 1 PB de código novo seja produzido diariamente.
Vale mencionar que o próprio Pando é resultado de um desenvolvimento com participação de agentes. Segundo a OpenAI, sua arquitetura central foi projetada por um engenheiro, e várias equipes de agentes participaram da implementação. A validação contou com uma suíte de testes de compatibilidade com Git e testes de simulação determinística. A empresa, porém, não afirmou que todo o código foi escrito por IA.
Análise do impacto da programação com IA: o gargalo está deixando de ser a escrita de código
Impacto para desenvolvedores e equipes
O que realmente chama a atenção na história do Pando não é o fato de a OpenAI ter criado seu próprio backend para o Git, mas o padrão que ela revela: a programação com IA reduz o custo de gerar código, transferindo a pressão para as etapas seguintes do fluxo de engenharia. O Git foi apenas o primeiro ponto em que isso ficou evidente; revisão de código, testes e integração também estão sob pressão.
No artigo sobre o Codex Code Review, a OpenAI reconhece que cada vez mais PRs aguardam revisão. Para quem revisa, é difícil entender a tempo as restrições históricas e avaliar os riscos de compatibilidade de API. Por isso, o Codex Code Review consegue ler as regras de revisão definidas no AGENTS.md do repositório. Elas ajudam a proteger contratos de API existentes, identificar logs que possam vazar dados de clientes e evitar a quebra de integrações com serviços já existentes.
Para equipes de desenvolvimento que usam IA, isso significa fazer alguns ajustes práticos:
- Documentar as regras de revisão: registre as restrições implícitas da equipe em arquivos de regras como o AGENTS.md, para que a revisão por IA tenha uma base.
- Reservar capacidade para a CI: com a execução de agentes em paralelo, o número de jobs de CI pode crescer antes dos custos de pessoal. Avalie com antecedência o cache e as cotas de concorrência.
- Rever as métricas: não acompanhe apenas o número de commits ou PRs; observe também o tempo de entrega e a taxa de falhas nas mudanças.
- Priorizar a capacidade de validação: cobertura de testes, testes com simulações e testes de compatibilidade determinam se o código produzido pelos agentes pode ser integrado com segurança.
Exemplo mínimo de revisão de código com vários modelos de IA
Se você quiser experimentar no seu repositório um fluxo de revisão de Diff baseado em regras, pode criar um protótipo rapidamente usando uma interface compatível com a OpenAI. O exemplo abaixo lê o Diff local e pede ao modelo que faça a revisão conforme as regras:
import openai, subprocess

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
diff = subprocess.run(["git", "diff", "HEAD~1"], capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="YOUR_MODEL",  # Substitua por um modelo de programação disponível na plataforma
    messages=[{"role": "user", "content": f"请审查以下改动,重点关注 API 兼容性和日志泄露风险:\n{diff}"}],
)
print(resp.choices[0].message.content)
Veja o código completo (leitura das regras em AGENTS.md + comparação entre modelos)
import subprocess
from pathlib import Path
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Uma única chave para acessar modelos de vários provedores
)

def load_rules(path: str = "AGENTS.md") -> str:
    """Lê as regras de revisão do repositório ou retorna regras padrão se o arquivo não existir"""
    p = Path(path)
    if p.exists():
        return p.read_text(encoding="utf-8")
    return "1. 不得破坏已有 API 契约\n2. 日志中不得输出客户数据\n3. 不得破坏已有服务集成"

def get_diff(base: str = "HEAD~1") -> str:
    """Obtém o Diff a ser revisado"""
    return subprocess.run(
        ["git", "diff", base], capture_output=True, text=True
    ).stdout

def review(diff: str, rules: str, model: str) -> str:
    """Chama o modelo para revisar as alterações de código conforme as regras"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": f"你是严格的代码审查者,请依据以下仓库规则审查:\n{rules}"},
            {"role": "user", "content": f"待审查 Diff:\n{diff}\n请逐条列出风险点和修改建议。"},
        ],
        max_tokens=1500,
    )
    return resp.choices[0].message.content

if __name__ == "__main__":
    rules, diff = load_rules(), get_diff()
    # Substitua pelos nomes dos modelos que deseja comparar e observe as diferenças entre as revisões
    for model in ["MODEL_A", "MODEL_B"]:
        print(f"===== {model} =====")
        print(review(diff, rules, model))
🚀 Dica para começar: ao criar um protótipo de AI Review, você pode obter créditos gratuitos para testes pela APIYI em apiyi.com. Com a mesma chave API, é possível acessar modelos como OpenAI, Claude e Gemini e comparar a qualidade das revisões de acordo com as regras do seu repositório.
Impacto no setor
Em sua cobertura, o The New Stack avalia que a OpenAI adotou o Agent Coding cedo e em larga escala. A pressão sobre sua infraestrutura pode antecipar problemas que outras grandes empresas e plataformas de hospedagem de código enfrentarão no futuro. Essa é uma avaliação de tendência da imprensa, não uma prova de que GitHub e GitLab já tenham enfrentado as mesmas falhas.
A comunidade de desenvolvedores também está dividida. Os otimistas acreditam que a redução do custo de programação tornará viáveis muitos projetos pequenos que antes não compensavam. Já os críticos apontam que mais commits não significam maior valor de software: se a revisão e os testes não acompanharem o ritmo, a entrega pode não ficar mais rápida. Outros comentários lembram que os problemas de escala em grandes monorepos não surgiram com a era da IA.
Entendendo os dados do Codex: cinco métricas que não devem ser confundidas
Ao discutir os resultados da programação com IA, um erro comum é misturar métricas diferentes. A tabela abaixo ajuda a entender o que cada dado pode ou não demonstrar.
| Métrica | O que mede | Situação nesta notícia |
|---|---|---|
| Número de commits | Frequência de commits | Crescimento trimestral estimado em +2.442%, com apenas o valor relativo disponível |
| Número de PRs | Propostas de alteração e atividades de merge | PRs semanais mais que dobraram em relação ao Q4 anterior |
| Linhas de código | Tamanho do código | Não divulgado; não pode ser calculado com base no crescimento dos commits |
| Lead Time | Tempo entre o início da alteração e sua entrega | Não divulgado |
| Taxa de falhas de alterações | Proporção de alterações que causam falhas após a entrada em produção | Não divulgada |
O caso Pando mostra que a carga de trabalho de desenvolvimento de código da OpenAI cresceu significativamente e que a infraestrutura Git existente encontrou gargalos. Ele não demonstra que a qualidade do software ou a produtividade dos desenvolvedores cresceram na mesma proporção, nem permite estimar quantos engenheiros o Codex substituiu.
Além disso, o Harness Engineering, publicado pela OpenAI em fevereiro de 2026, é outro experimento independente: a partir de um repositório vazio, um projeto da ordem de um milhão de linhas foi concluído em cerca de cinco meses, com aproximadamente 1.500 PRs acumulados. Esses dados são de outro projeto e não têm relação com o Pando, mas também refletem uma tendência: o foco do trabalho dos engenheiros está migrando para arquitetura, cadeia de ferramentas, ciclos de feedback e aceitação de código.
💡 Sugestão: se sua equipe também está adotando um Coding Agent, comece comparando em pequena escala o desempenho de diferentes modelos na geração e revisão de código. A interface unificada da APIYI apiyi.com permite alternar rapidamente entre modelos e avaliá-los com o mesmo conjunto de testes antes de escolher o principal.
Perguntas frequentes (FAQ)
Q1: O Codex realmente multiplicou por 24 a quantidade de código da OpenAI?
Não é bem assim. O dado oficial é uma previsão de que o número trimestral de commits incorporados à branch master cresça 2.442% em relação ao primeiro trimestre de 2024. Além de ser uma previsão, a métrica conta commits, não linhas de código. Um commit pode conter alterações grandes ou pequenas, então esse número não equivale nem à quantidade de código nem à produtividade.
Q2: O Pando é uma alternativa ao GitHub?
Não. O Pando é um backend de servidor compatível com o protocolo Git padrão, usado apenas internamente pela OpenAI. Até 3 de novembro de 2026, não havia servidor público, preços ou data de lançamento divulgados. O que a OpenAI publicou foi um repositório de uma versão aprimorada do cliente Git, com parte das alterações contribuídas ao projeto Git original. Isso não significa que o servidor Pando tenha sido disponibilizado como código aberto.
Q3: Equipes comuns precisam reconstruir sua infraestrutura Git como a OpenAI?
A maioria não precisa. A OpenAI lida com um monorepositório de escala enorme e com alta concorrência de agentes. Para equipes pequenas e médias, os gargalos mais comuns costumam ser cotas de CI, cobertura de testes e disponibilidade de pessoas para revisar código. Vale priorizar melhorias nessas áreas.
Q4: Como experimentar revisão de código com IA ou fluxos com agentes de programação gastando pouco?
Você pode começar com um protótipo mínimo usando uma interface compatível com a OpenAI: leia o diff e o arquivo de regras conforme o exemplo de código deste artigo e envie-os ao modelo para revisão. Ao se cadastrar na APIYI, em apiyi.com, você recebe créditos gratuitos para testes. Basta trocar o base_url por `https://api.apiyi.com/v1` para comparar as revisões de modelos de diferentes provedores com a mesma chave.
Q5: A programação com IA pode estar apenas gerando mais código de baixa qualidade?
Esse é justamente o foco do debate na comunidade, e ainda não há uma conclusão. A OpenAI não divulgou mudanças nas taxas de defeitos, nas taxas de reversão ou no custo líquido de desenvolvimento. Por isso, não dá para afirmar nem que a qualidade piorou em geral, nem que melhorou. Uma abordagem mais segura é acompanhar, na sua equipe, tanto o tempo de entrega quanto a taxa de falha das alterações. Você também pode usar a APIYI, em apiyi.com, para acessar vários modelos e fazer revisões cruzadas, reduzindo o risco de um único modelo deixar passar algum problema.
Codex e as mudanças na infraestrutura Git: principais pontos
- A métrica precisa estar correta: 2442% é o crescimento projetado no número de commits trimestrais para o 4º trimestre de 2026, não nas linhas de código.
- O crescimento acelerou bastante: a curva ficou mais íngreme após o 4º trimestre de 2025, mas já vinha crescendo desde 2024.
- A pressão vem da concorrência: o Codex aumentou o paralelismo das tarefas, e o crescimento das gravações é amplificado pelas leituras de CI.
- O sistema antigo deixou de dar conta: desde o fim de 2025, Push e Fetch ficaram mais lentos, e a confiabilidade às vezes caía abaixo de 90%.
- A solução Pando: gravações independentes por branch, reutilização de Packfiles e cache reduziram a latência mediana de Push em quase 80%.
- O gargalo mudou de lugar: revisão de código, testes, integração e entrega se tornaram os novos fatores limitantes.
- Por onde começar: use a interface unificada da APIYI em apiyi.com para criar rapidamente um protótipo de revisão com vários modelos.
Resumo
O impacto do Codex na OpenAI pode ser resumido em três pontos:
- Escala: o número de commits trimestrais no monorepo deve crescer 2442% em relação ao 1º trimestre de 2024, e o número de PRs também está dobrando. A atividade de alteração de código aumentou significativamente.
- Infraestrutura: agentes trabalhando em paralelo geram mais branches, operações de Push e leituras de CI. O backend Git antigo passou a apresentar problemas de desempenho e confiabilidade, e a OpenAI levou cerca de 10 semanas para criar o Pando como resposta.
- Processo de engenharia: escrever código já não é a etapa mais lenta. A capacidade de revisar, testar e entregar determina se a programação com IA pode realmente gerar valor.
Para a maioria das equipes, em vez de perseguir o número de commits, vale mais fortalecer primeiro os processos de aceitação e revisão e depois aumentar gradualmente o paralelismo dos agentes. Se você quer validar rapidamente um fluxo de revisão com IA ou de agentes de programação, a recomendação é usar os créditos gratuitos da APIYI em apiyi.com para comparar o desempenho real de vários modelos.
📚 Referências
- Scaling Git at OpenAI: artigo técnico oficial da OpenAI sobre o Pando (2026-11-02)
- Link:
openai.com/index/scaling-git-at-openai -
Descrição: principal fonte dos fatos apresentados e dos dados de crescimento trimestral de commits
-
Custom Code Review rules for Codex: blog de desenvolvedores da OpenAI (2026-07-20)
- Link:
developers.openai.com/blog/custom-code-review-rules-for-codex -
Descrição: fonte da informação sobre a duplicação semanal do número de PRs e das regras de revisão em AGENTS.md
-
Harness engineering: experimento independente da OpenAI sobre desenvolvimento com agentes (2026-02-11)
- Link:
openai.com/index/harness-engineering -
Descrição: caso independente para entender a mudança no papel dos engenheiros, sem relação com o projeto Pando
-
OpenAI Git Fork: repositório público do cliente Git mantido pela OpenAI
- Link:
github.com/openai/git -
Descrição: consulte as melhorias no cliente, como o packfile-uri
-
Cobertura do The New Stack: análise do Pando pela imprensa especializada (2026-11-02)
- Link:
thenewstack.io - Descrição: referência para a análise de tendências do setor
Autor: equipe técnica da APIYI
Troca de ideias sobre tecnologia: entre em contato conosco pela página inicial do site oficial da APIYI. Para mais materiais sobre integração de modelos, acesse a central de documentação em docs.apiyi.com