Nota do autor: a partir do design do superagente da DeepSeek, vamos entender a lógica de distribuição de modelos entre router e workers em sistemas multiagente e como os tokens de leitura de cache afetam o custo da arquitetura.
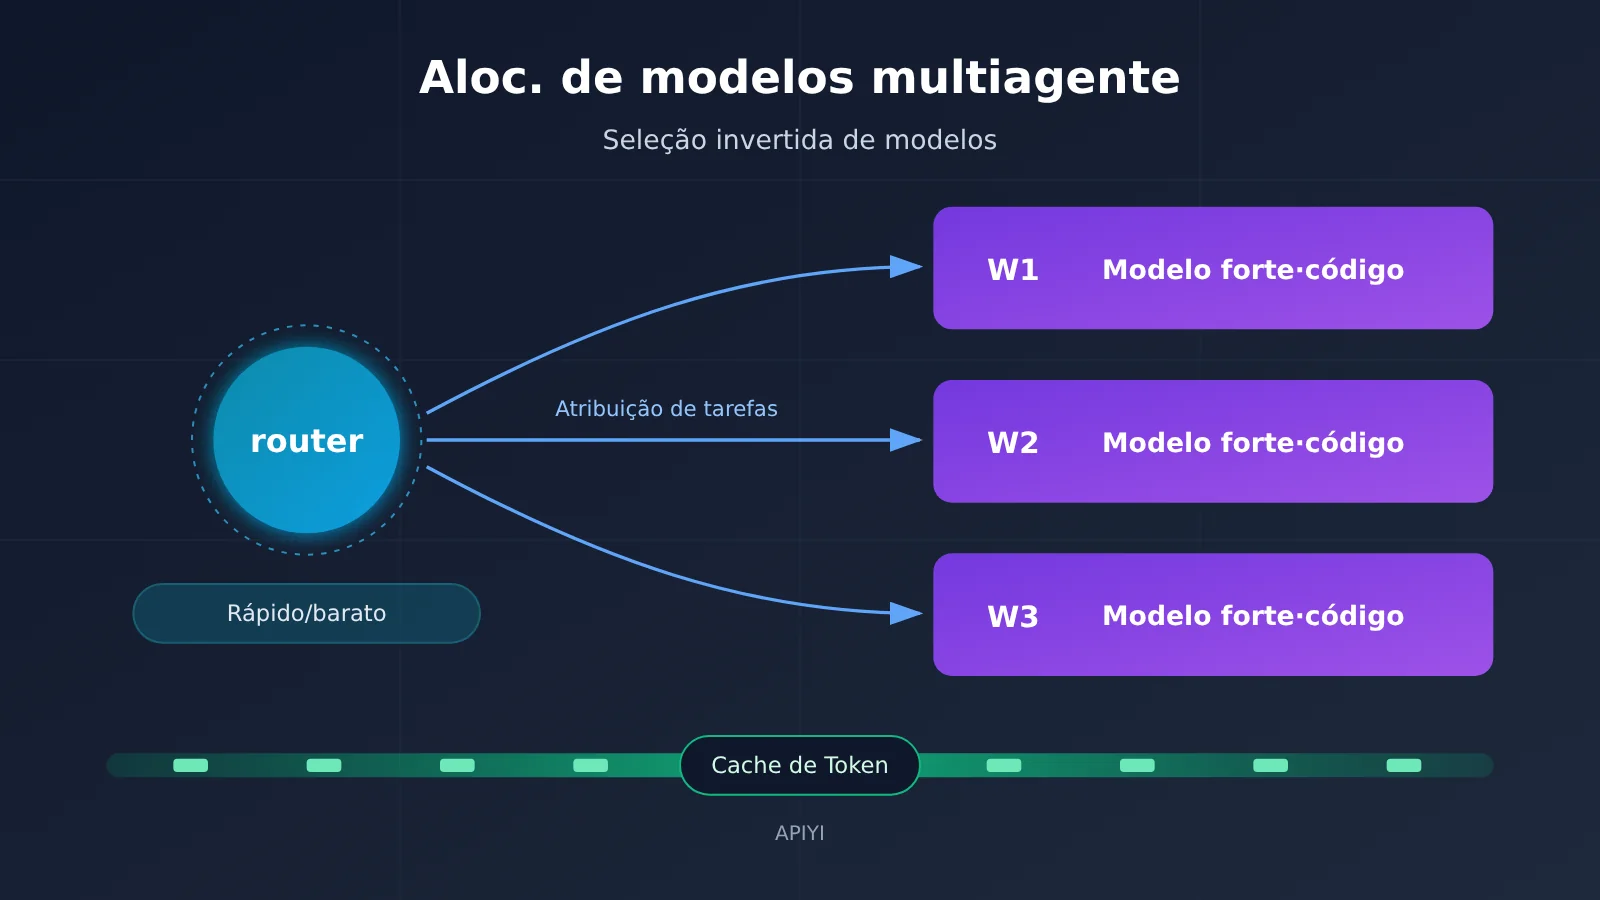
Ao montar um sistema multiagente para programação, muita gente coloca o modelo mais poderoso no “comando geral” e deixa modelos baratos para os executores. O design do superagente apresentado pela equipe DeepSeek Harness em novembro de 2026 propõe o contrário: modelo barato no router, modelo poderoso nos workers. O router, responsável pela conversa e pela distribuição de tarefas, usa um modelo leve. Os workers, que de fato escrevem o código, usam o modelo mais poderoso.
Este não é um artigo que apenas reconta uma notícia. Vamos transformar essa arquitetura em critérios práticos para escolher modelos: quais capacidades o router e os workers precisam ter, como estimar os tokens de leitura de cache e quando vale escolher um modelo mais barato. A própria DeepSeek descreve os dados de teste citados aqui apenas como resultados “indicativos”; vamos deixar claros os limites desses dados.
O que você vai levar: ao final da leitura, você conseguirá criar um plano de distribuição de modelos por função para seu sistema multiagente e estimar aproximadamente seu custo com base no volume de leitura de cache.
Pontos principais da distribuição de modelos entre agentes
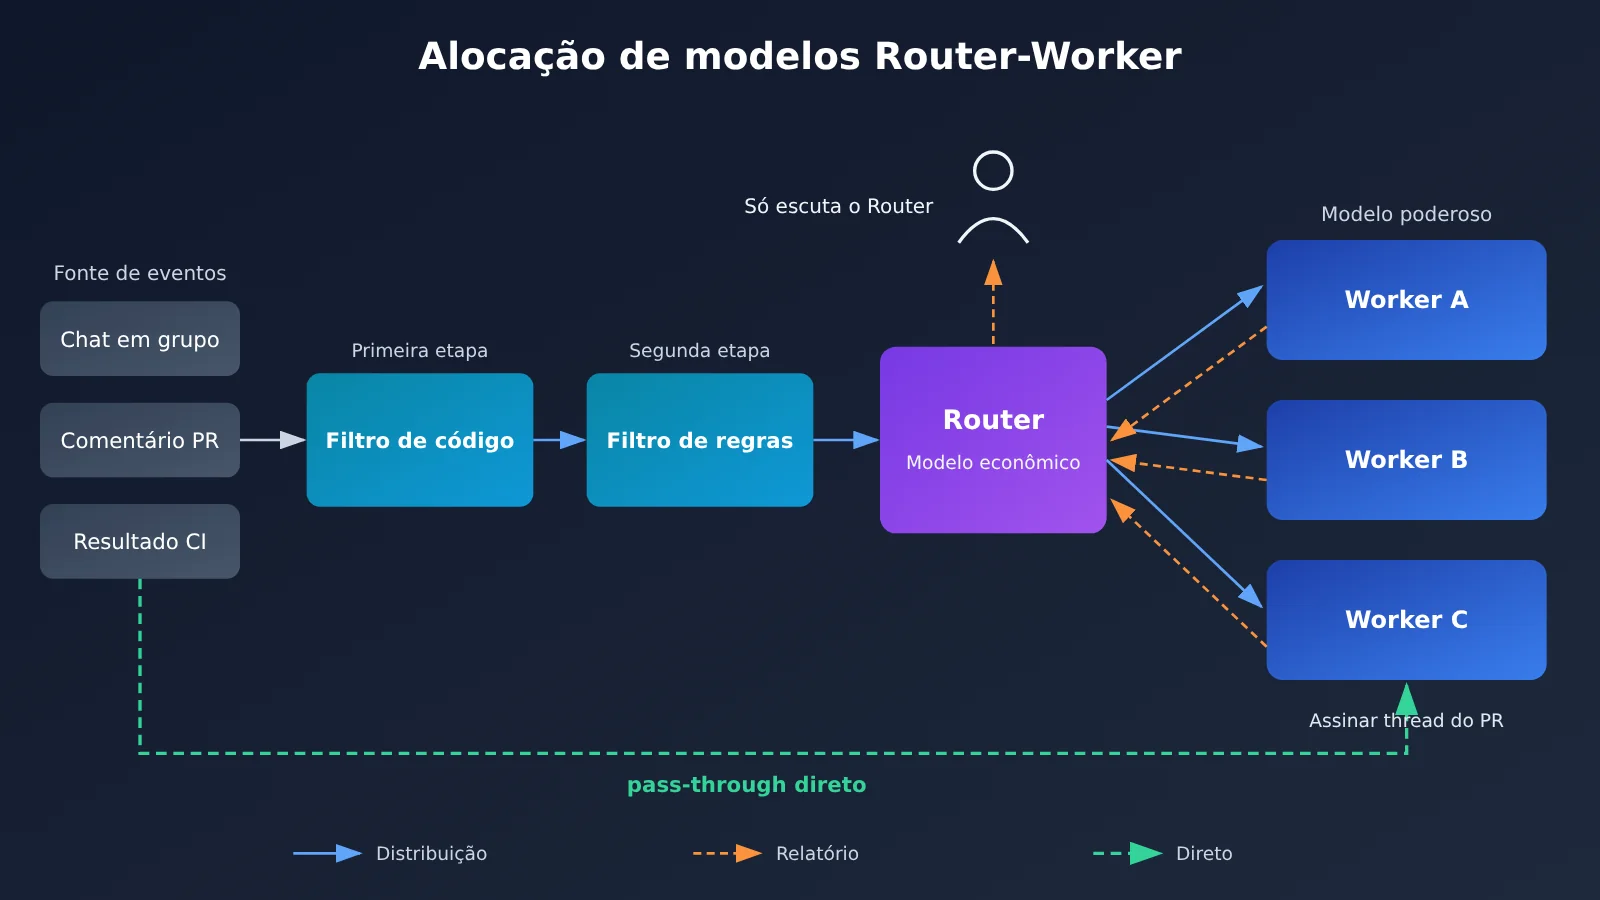
O design da DeepSeek tem duas camadas. O router é uma sessão persistente, responsável por conversar com as pessoas, distribuir tarefas e acompanhar as relações entre elas. Cada worker recebe uma tarefa por vez, trabalha com um contexto independente e limpo e nunca conversa diretamente com as pessoas: ele só informa seu status ao router. Com essa divisão de responsabilidades, a tabela abaixo serve como ponto de partida para distribuir os modelos.
| Papel | Responsabilidade principal | Escreve código? | Categoria de modelo recomendada | Motivo da escolha |
|---|---|---|---|---|
| router | Conversar, distribuir tarefas e acompanhar suas relações | Não; pode ficar sem acesso ao shell | Leve, barato e rápido | O trabalho é simples, mas as chamadas são frequentes; latência e custo por chamada importam mais |
| worker | Receber uma única tarefa e concluir a implementação | Sim | O melhor modelo de codificação disponível no momento | A qualidade do código determina diretamente o resultado da entrega |
| Camada de filtragem de gatilhos | Eliminar ruídos de chats em grupo e notificações de CI | Não | Código comum na primeira etapa e um modelo pequeno na segunda | A maioria dos eventos não precisa chegar ao modelo |
Por que “inverter” a distribuição de modelos entre agentes
Para a DeepSeek, o gargalo da programação assistida por IA deixou de ser a capacidade dos modelos e passou a ser a atenção humana. Uma pessoa normalmente consegue acompanhar de 3 a 5 sessões ativas de agentes ao mesmo tempo. Acima disso, fica difícil saber qual está aguardando aprovação, qual está travada ou quais duas estão modificando o mesmo PR sem avisar. Por isso, o valor do router não está em ser “inteligente”, mas em “distribuir tarefas e manter o controle de forma estável”. Ele não divide as tarefas em etapas: apenas as distribui e acompanha. Isso é diferente do padrão comum em que um “agente principal divide a tarefa em etapas”.
Como o router não precisa de raciocínio profundo nem escreve código, usar o modelo mais caro nele seria um desperdício. É no worker que o código é produzido de fato, e sua qualidade determina o sucesso da entrega. Portanto, é ali que deve ser investido o orçamento para modelos mais potentes. Essa é a ideia por trás da “inversão na escolha dos modelos”: quanto mais próximo do usuário, mais leve o modelo; quanto mais próximo do código, mais potente.
Quais capacidades o router e o worker precisam ter
Para escolher os modelos certos, vale dividir as responsabilidades de cada papel em capacidades específicas. A lista abaixo ajuda a avaliar os candidatos.
| Capacidade | Requisitos do router | Requisitos do worker | Dica para a escolha |
|---|---|---|---|
| Seguir instruções e classificar tarefas | Alto: precisa identificar o responsável pela tarefa de forma consistente | Médio | Para o router, priorize testes de precisão na distribuição |
| Contexto longo e consulta ao histórico | Médio: usa IDs e resumos para acessar detalhes gradualmente | Alto: precisa ler grandes volumes de código | Para o worker, avalie a janela de contexto e a capacidade de buscar código |
| Qualidade da geração de código | Não é necessária | Prioridade máxima | Não economize no orçamento do worker |
| Latência de resposta | Alta prioridade: toma decisões com frequência | Média: cada tarefa pode demorar um pouco mais | Escolha um modelo rápido da classe Flash para o router |
| Sensibilidade ao preço unitário | Muito alta: o volume de leituras do cache é enorme | Média | O preço unitário do router afeta o custo total |
| Chamadas de ferramentas | Poucas: pode até ficar sem acesso ao shell | Muitas: precisa executar código e testes | Defina limites de permissão para cada papel |
Há ainda um requisito do router que passa facilmente despercebido: sua estrutura não deve permitir que ele “coloque a mão na massa”. A DeepSeek deixou o router sem acesso ao shell justamente para impedir que ele execute tarefas diretamente. Portanto, ao escolher seu modelo, não é preciso buscar um que “saiba fazer tudo”: aceite que ele “só saiba distribuir tarefas”.
Custo de tokens de leitura de cache na distribuição de modelos entre múltiplos agentes
Não basta que o router seja barato: o maior custo dessa arquitetura vem dos tokens de leitura de cache. O router mantém uma sessão longa e lê repetidamente o contexto em cache; vários workers rodam em paralelo e também leem grandes quantidades de contexto. Os dados de teste da DeepSeek mostram o problema com clareza.
| Métrica | Valor | Observação |
|---|---|---|
| Mensagens por rodada | Cerca de 300 | Aproximadamente 20 são solicitações reais de trabalho |
| Tempo médio de conclusão do superagente | 12,4 minutos | No caso mais lento, 15,7 minutos |
| Tempo do caso mais lento na referência de sessão única | 29,5 minutos | Usado para comparação |
| Carga de decisões do router | De cerca de 1 para cerca de 40 por minuto | O tempo por decisão caiu de 6,4 para 1,6 segundo |
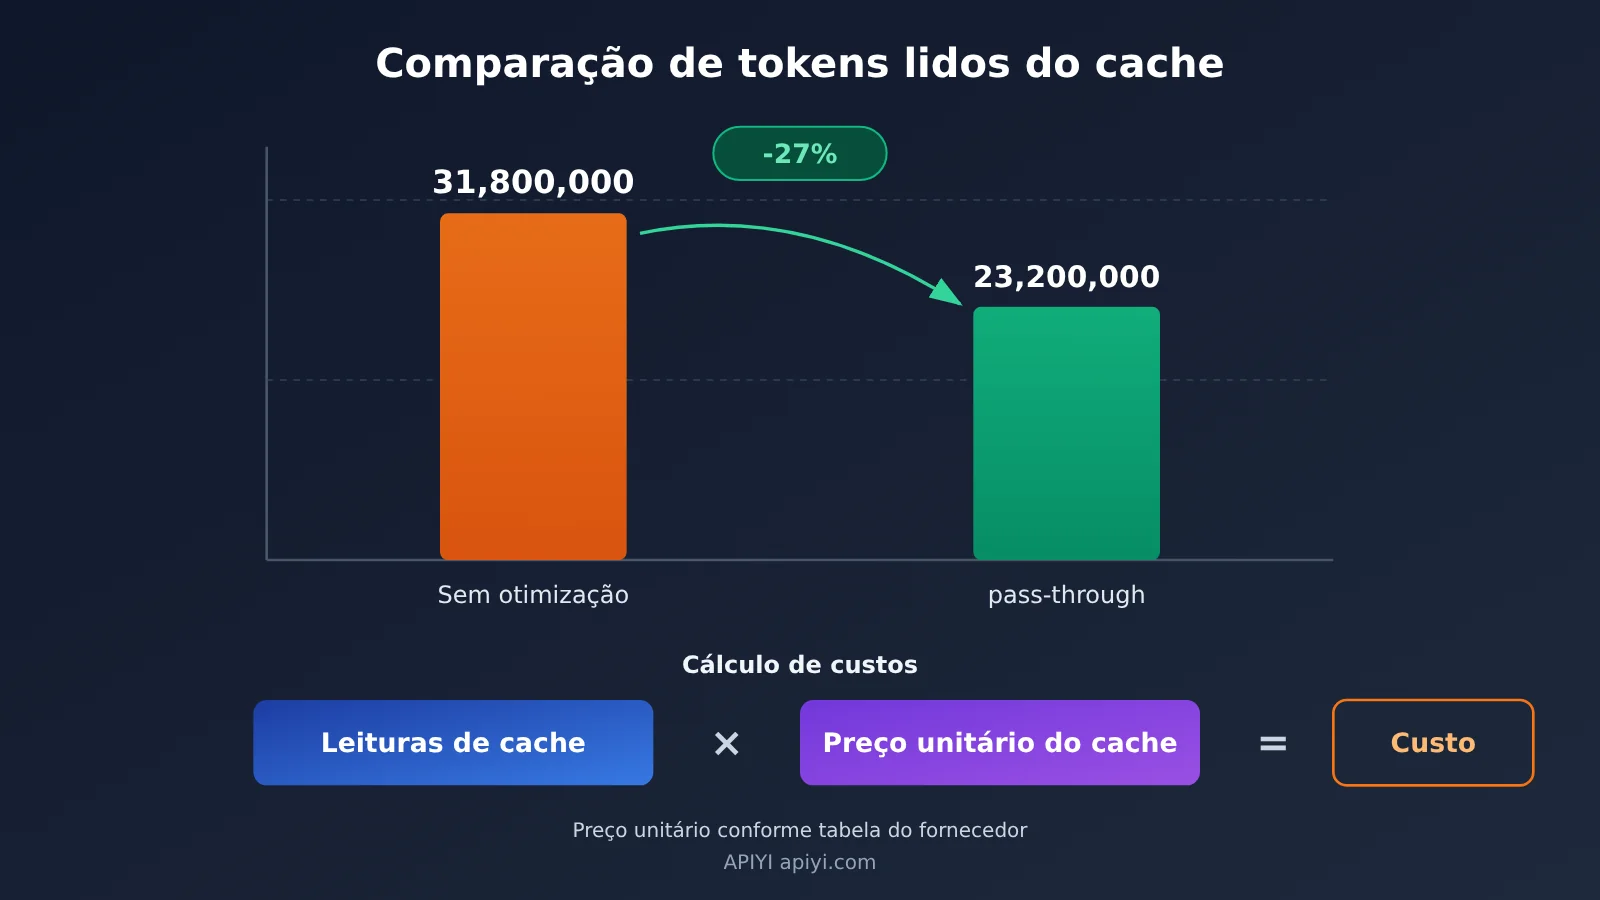
| Tokens de leitura de cache | 23,2 milhões | Com a otimização pass-through ativada |
| Leitura de cache sem otimização | 31,8 milhões | Quando os workers não assinam a thread diretamente |
| Custo de cache | Cerca de US$ 7 | Com base no preço da própria DeepSeek para a categoria Flash fora dos horários de pico |
Como estimar o custo da distribuição de modelos entre múltiplos agentes pela leitura de cache
Para fazer a estimativa, você pode dividir o custo de uma execução em três partes: tokens de leitura de cache multiplicados pelo preço unitário de leitura de cache, mais tokens de entrada não encontrados no cache multiplicados pelo preço unitário de entrada, mais tokens de saída multiplicados pelo preço unitário de saída. Na arquitetura router-worker, a primeira parcela costuma ser disparada a maior. Por isso, o preço de leitura de cache é o item que merece mais atenção na escolha do modelo.
Calculando a partir dos números divulgados: cerca de US$ 7 por 23,2 milhões de tokens de leitura de cache equivale a aproximadamente US$ 0,30 por milhão de tokens. Esse é apenas um valor aproximado calculado a partir dos números divulgados, não um preço oficial. Para saber o preço real, consulte a tabela atual do fornecedor do modelo. Com essa referência, você pode inserir o preço de leitura de cache dos modelos candidatos e ver rapidamente quanto o custo da mesma carga de trabalho aumentaria com um modelo mais caro.
A própria otimização pass-through também merece atenção. Quando os workers assinam a thread, novos eventos chegam diretamente a eles, sem precisar passar pelo router. Com isso, a leitura de cache caiu de 31,8 milhões para 23,2 milhões de tokens, uma redução de cerca de 27%. Ou seja, otimizações na arquitetura, assim como a escolha de um modelo mais barato, podem reduzir diretamente a conta.
Três limitações dos dados originais
- A etapa de programação foi simulada: no teste, a tarefa de “escrever código” foi substituída por uma ferramenta que apenas consumia tempo. O teste mediu o comportamento do escalonamento, não a qualidade do código. Portanto, não dá para usá-lo para provar qual modelo funciona melhor para os workers.
- Os dados são apenas indicativos: a DeepSeek afirma claramente que os números são indicativos, e não resultados de um benchmark rigoroso.
- A comparação de preços com a categoria Sonnet é inconsistente: o resumo da reportagem menciona uma estimativa de cerca de US$ 4,64 usando preços da categoria Sonnet, mas o texto diz que o mesmo uso seria “consideravelmente mais caro” em uma categoria de preço mais alta. As duas afirmações se contradizem. Antes de consultar o artigo original da DeepSeek para verificar os dados, não é recomendável citar essa comparação específica.
Primeiros passos para distribuir modelos entre agentes
Para aplicar a lógica acima ao seu sistema, siga os passos abaixo. Não vamos usar código aqui: todas as configurações são apresentadas em linha, para facilitar a comparação com o seu framework.
- Defina os papéis antes de escolher os modelos: liste todos os papéis do sistema que invocam modelos. Distinga pelo menos três categorias: router, worker e filtro de acionamento. Para cada uma, registre se escreve código e se precisa de ferramentas.
- Configure os nomes dos modelos: crie parâmetros separados para cada papel, como
router_model,worker_modelefilter_model. Evite fixar os nomes dos modelos no código da aplicação. - Garanta a delegação pela estrutura: remova do router ferramentas de execução, como o shell. No experimento da DeepSeek, um agente em sessão única não delegou nenhuma tarefa em cinco execuções com um comando neutro, e a execução mais lenta levou quase meia hora. Mesmo quando o comando exigia explicitamente a delegação, em uma das cinco execuções o agente considerou a tarefa pequena demais e a executou por conta própria.
- Filtre primeiro: use código convencional para eliminar o ruído dos eventos de acionamento com base na origem e em listas de permissão. Só depois envie os eventos restantes ao modelo, para que ele os avalie segundo as regras da equipe.
- Registre as leituras de cache: em cada execução, registre três categorias de tokens: leituras de cache, entrada não armazenada em cache e saída. Use a fórmula apresentada anteriormente para calcular o custo de cada execução.
- Compare modelos: mantenha o mesmo conjunto de tarefas e troque apenas o
router_model. Observe as mudanças na precisão da distribuição de tarefas, na latência e no custo antes de decidir se vale usar um modelo de categoria inferior.
Nas etapas 2 e 6, a forma de integração afeta diretamente a eficiência dos testes. Se o router e o worker usam modelos de fornecedores diferentes, manter chaves e configurações de SDK separadas significa alterar vários pontos a cada troca. Com uma plataforma de interface unificada como APIYI apiyi.com, você pode usar a mesma chave API e o mesmo formato de requisição compatível com OpenAI, alterando apenas o parâmetro model para atribuir modelos de fornecedores diferentes ao router e ao worker. Isso reduz bastante o custo dos testes comparativos.
🚀 Sugestão para começar: ao validar o protótipo, configure os parâmetros de modelo do router e do worker no APIYI apiyi.com usando a mesma chave. Execute o mesmo conjunto de tarefas e registre o uso de tokens. Para saber quais modelos estão disponíveis, como os da categoria Flash da DeepSeek, consulte a lista atual da plataforma.
Quando escolher modelos mais baratos para cada função em sistemas multiagente
Modelos de baixo custo não servem para tudo. A tabela abaixo reúne critérios para ajudar você a decidir quais funções podem usar um modelo mais barato.
| Características do cenário | Recomendação | Motivo | Forma de acesso |
|---|---|---|---|
| A função apenas distribui tarefas, acompanha o progresso e verifica o contexto em cache | Escolha um modelo rápido e barato | A tarefa é simples, e o preço unitário e a latência têm maior impacto na experiência | APIYI apiyi.com ou API oficial do fornecedor |
| A função gera e modifica código | Escolha um modelo mais potente | A qualidade do código determina o resultado da entrega | APIYI apiyi.com ou API oficial do fornecedor |
| O volume de leitura do cache chega à casa das dezenas de milhões, com execuções diárias | Priorize a redução do preço unitário de leitura do cache | O custo do cache cresce linearmente com o número de execuções | Calcule com base na tabela de preços do fornecedor |
| Tarefa única, leve e ocasional | O pagamento por uso é suficiente | O volume de uso é pequeno e não compensa aumentar a complexidade da arquitetura | Qualquer canal com pagamento por uso |
| Tarefas automatizadas frequentes e intensivas em tokens | Avalie planos mensais ou com limites mais altos | O custo marginal de cada execução deixa de aparecer na cobrança | Depende das condições da assinatura |
A última linha tem uma referência: segundo reportagens da mesma época, o Claude Code Pass custava US$ 9,99 por mês e oferecia limites de uso cerca de 2 a 5 vezes maiores para modelos abertos como Kimi K3.1 Pro, GLM 5.3 e DeepSeek V4.1 Flash, com três limites de uso: a cada 5 horas, semanal e mensal. As reportagens também apontavam que, em etapas que apenas tomam decisões de roteamento ou verificam o contexto em cache, um modelo rápido e barato é tecnicamente mais adequado, além de ser mais econômico. Por outro lado, esses planos restringem você aos modelos incluídos no pacote. Se um worker depender de um modelo de fora do pacote, ainda será necessário outro canal de acesso.
Riscos e limites da distribuição de modelos entre agentes
A distribuição de modelos resolve questões de custo e divisão de tarefas, mas não os desafios que essa arquitetura ainda carrega. A DeepSeek reconhece dois problemas sem solução. O primeiro é a memória de longo prazo: depois de meses de operação, ainda é difícil preservar o histórico relevante sem estourar a janela de contexto. O segundo é a injeção de comandos: qualquer agente que leia eventos externos, como conversas em grupo ou comentários em PRs, pode ser manipulado. Como router e workers estão conectados por um ciclo compartilhado na nuvem, uma fonte de eventos comprometida poderia, em teoria, espalhar instruções para todas as máquinas com as quais o sistema interage.
Isso afeta diretamente a distribuição de modelos. Usar um modelo barato no router não significa que sua proteção possa ser relaxada: afinal, ele é o primeiro a entrar em contato com eventos externos. Na implantação interna da DeepSeek, os comportamentos proativos foram testados primeiro em um modo de registro que mostrava “o que teria sido feito”, sem executar as ações de imediato. Um exemplo é a estratégia de “reproduzir e corrigir silenciosamente”: quando alguém relata um bug, o agente tenta reproduzi-lo em segundo plano. Se confirmar e corrigir o problema, ele abre um PR enquanto a conversa ainda está em andamento; se não conseguir reproduzi-lo, não envia nada. Ao colocar um sistema novo em operação, é mais seguro observar os logs primeiro e ampliar suas permissões aos poucos.
Além disso, o protótipo DSH Super Agent está claramente identificado no GitHub como código de pesquisa, não como um produto oficial. Não há problema em usar suas ideias de design como referência, mas não é recomendável implantá-lo diretamente em produção.
Perguntas frequentes (FAQ)
Q1: O que é a “inversão na escolha de modelos” em sistemas multiagente?
É usar um modelo leve e barato para o router e o modelo mais potente para os workers. O router só conversa, distribui e acompanha tarefas, sem escrever código. Como os workers fazem a programação, o orçamento para modelos mais potentes deve ser direcionado a eles, não ao “comandante geral”.
Q2: Qual é a diferença entre a arquitetura router-worker e o padrão em que um agente principal divide as tarefas?
No padrão de agente principal, ele precisa dividir a tarefa em etapas, o que exige mais capacidade de raciocínio. O router da DeepSeek não faz essa divisão: apenas distribui e acompanha as tarefas, então pode usar um modelo mais leve. Em contrapartida, cada worker precisa conseguir concluir a tarefa inteira de forma independente.
Q3: Quando esse design foi divulgado? É possível usar o DSH Super Agent diretamente?
A reportagem sobre o assunto foi publicada em 3 de novembro de 2026. O DSH Super Agent é um protótipo de pesquisa publicado no GitHub junto com o artigo sobre o design. A equipe responsável deixa claro que ele não é um produto com suporte e serve apenas para entender a arquitetura.
Q4: É viável ensinar um único agente a delegar usando apenas comandos?
Os testes da DeepSeek indicam que não é confiável: com um comando neutro, nenhuma das 5 execuções teve delegação; mesmo com um comando que enfatizava a delegação, houve 1 execução sem delegação. Para delegar com confiabilidade, é preciso isolar as funções na arquitetura, por exemplo, separando sessões e removendo ferramentas de execução, em vez de escrever comandos mais longos.
Q5: Como configurar facilmente modelos de diferentes fornecedores para o router e os workers no mesmo sistema?
O segredo é configurar o nome do modelo por função e padronizar a forma de acesso:
1. Cadastre-se na APIYI apiyi.com e obtenha uma chave API
2. Configure separadamente o parâmetro `model` do router e dos workers
3. Mantenha o formato das requisições e altere apenas o nome do modelo para fazer testes comparativos
Assim, não é necessário manter uma configuração de SDK separada para cada fornecedor. Os modelos disponíveis dependem da lista atual da plataforma.
Q6: Os dados de custo do artigo original podem ser usados diretamente para fazer um orçamento?
Não é recomendável aplicá-los diretamente. A etapa de programação foi simulada, os dados são apenas indicativos e a comparação de preços com a categoria Sonnet apresenta inconsistências ao longo do texto. É melhor medir o volume de leituras do cache com seu próprio conjunto de tarefas e multiplicá-lo pelo preço unitário atual. Na APIYI apiyi.com, mantenha as tarefas iguais e execute uma rodada com cada modelo para obter dados adequados ao seu cenário.
Q7: Quais são as limitações conhecidas dessa arquitetura?
Há três limitações principais: a degradação da memória após longos períodos de execução; o risco de injeção de comandos ao ler eventos externos; e o alto volume de tokens lidos do cache, que pode aumentar bastante os custos com modelos mais caros. Além disso, ainda faltam dados sobre o desempenho de modelos específicos no papel de router, então é preciso testá-los por conta própria.
Pontos principais sobre a distribuição de modelos entre agentes
- Escolha de modelos invertida: use um modelo leve e barato no router e um modelo mais potente nos workers que escrevem código.
- O gargalo é a atenção: em geral, uma pessoa só consegue acompanhar de 3 a 5 sessões; o router centraliza a comunicação.
- Delegação depende da estrutura: remover as ferramentas de execução do router é muito mais confiável do que alterar o comando.
- O cache pesa no custo: em uma rodada de testes, a leitura de cache chegou a 23,2 milhões de tokens; o preço por token é decisivo.
- Otimizar a arquitetura também economiza: o pass-through direto reduziu as leituras de cache em cerca de 27%.
- Cite os dados com cautela: a codificação foi simulada, os resultados são apenas indicativos e a comparação de preços precisa ser verificada.
- Use uma interface unificada nos experimentos: na APIYI apiyi.com, basta alterar o parâmetro
modelpara comparar diferentes configurações.
Resumo
A ideia central dessa distribuição de modelos entre agentes é usar um modelo barato no router e modelos mais potentes nos workers:
- Escolha por responsabilidade: use um modelo rápido e barato para o papel que apenas distribui e acompanha tarefas, e um modelo potente para quem escreve código.
- Calcule os custos de cache: os tokens de leitura de cache são a principal despesa nessa arquitetura. Ao escolher o modelo, priorize a comparação do preço por token de leitura de cache.
- Decida com testes próprios: os dados do artigo original servem apenas como referência; a decisão final deve considerar o custo e os resultados no seu próprio conjunto de tarefas.
Comece com um pequeno conjunto de tarefas para montar um protótipo router-worker. Configure o nome do modelo por função e, depois, substitua gradualmente o modelo do router para observar as mudanças na precisão da distribuição e nos custos. Para fazer essa comparação, você pode usar a APIYI apiyi.com e acessar modelos de diferentes provedores com uma única chave, tomando a decisão com base nos seus próprios dados.
📚 Referências
- DeepSeek’s Super Agent Harness: Fixing the Attention Bottleneck in AI Coding: análise do design do superagente da DeepSeek
- Link:
mindstudio.ai/blog/deepseek-super-agent-harness-design -
Descrição: aborda a arquitetura router-worker, experimentos de delegação, dados de tokens em cache e questões em aberto
-
Claude Code Pass Pricing: What’s in the $9.99/Month Plan: análise do plano mensal com limites elevados
- Link:
mindstudio.ai/blog/claude-code-pass-pricing - Descrição: discute as vantagens e desvantagens da cobrança por uso e dos planos mensais em fluxos de trabalho com múltiplos agentes e uso intensivo de tokens
Autor: Equipe técnica da APIYI
Discussões técnicas: Entre em contato pela página inicial da APIYI, em apiyi.com, para conversar sobre a distribuição de modelos entre múltiplos agentes. Para mais informações sobre integração, acesse a central de documentação em docs.apiyi.com.