Nota do autor: uma análise da primeira edição do ranking GDPx, publicado pela SemiAnalysis, que compara as pontuações e o “custo médio por tarefa” dos principais modelos. O texto também distingue o custo da avaliação dos preços oficiais por token, para ajudar você a escolher um modelo considerando capacidade, custo e disponibilidade.
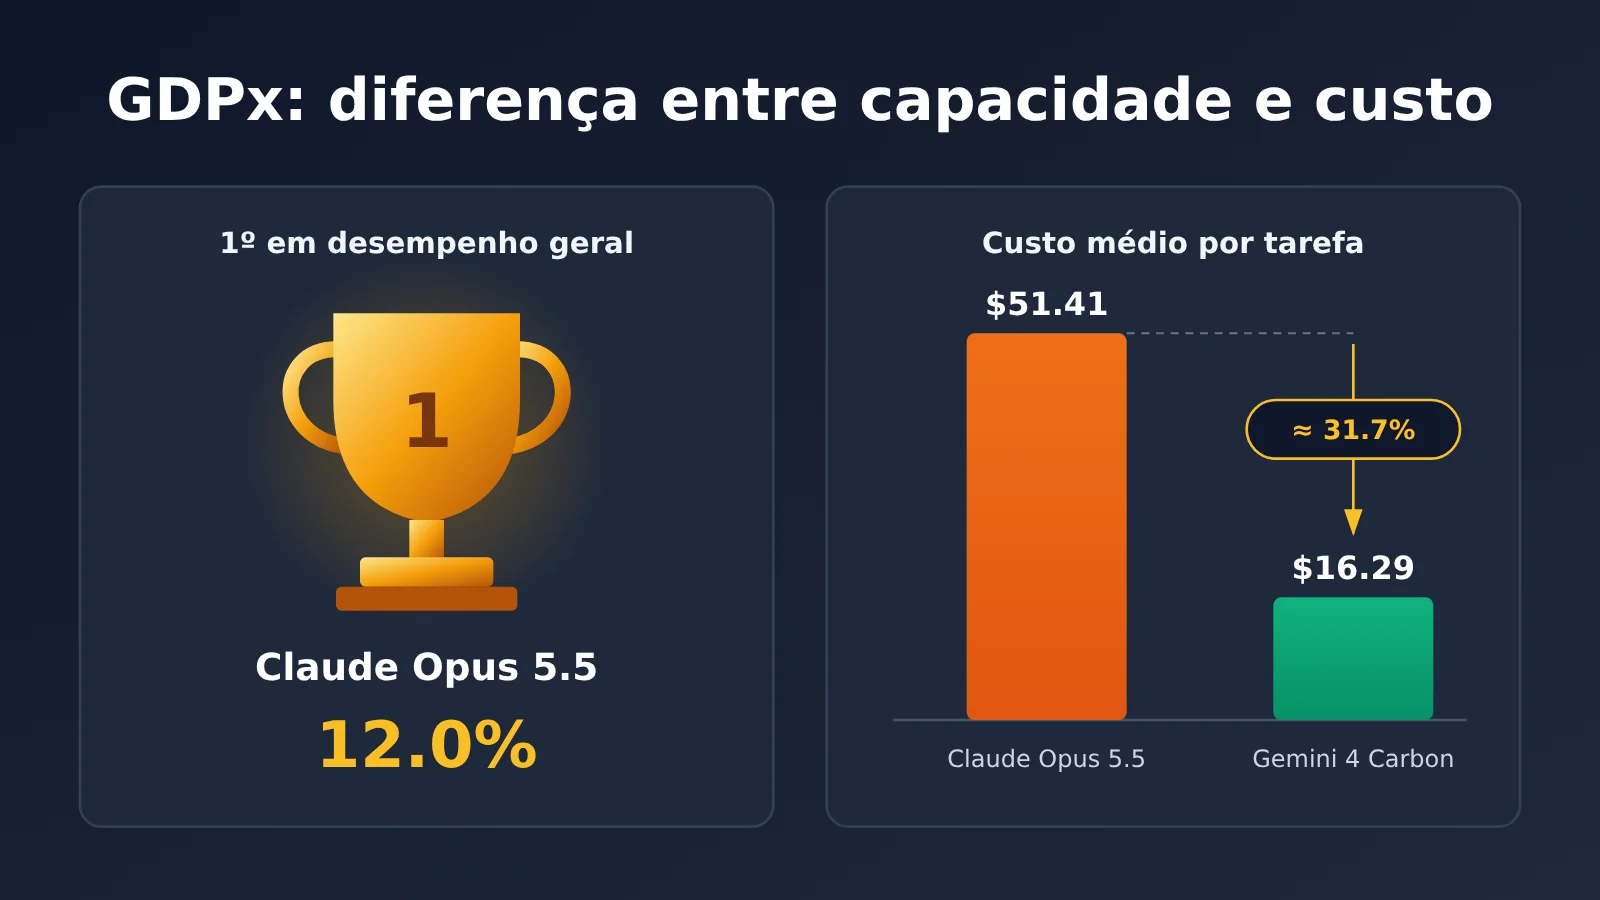
Em 2 de novembro de 2026, a SemiAnalysis lançou o GDPx v1.0, um benchmark de alta dificuldade para agentes. O Claude Opus 5.5 ficou em primeiro lugar, com uma pontuação geral de 12,0%, seguido de perto pelo Gemini 4 Carbon, com 10,9%. O custo chama ainda mais atenção: o custo médio por tarefa do Carbon é de apenas 31,7% do custo do Opus, embora sua pontuação alcance cerca de 90,8% da obtida pelo Opus.
Não se trata de boato. Esses dados vêm do ranking oficial do GDPx e do relatório original da SemiAnalysis. O site oficial também disponibiliza 14 tarefas representativas, com um total de 168 trajetórias de execução. Ainda assim, é fácil interpretar o ranking de forma equivocada. O “custo médio por tarefa” não é o preço da API, e “12%” não é a taxa de sucesso da IA em tarefas reais.
O que você vai encontrar aqui: este artigo reúne os dados de custo e capacidade da primeira edição do ranking GDPx e distingue claramente três referências de preço: o custo da avaliação GDPx, o preço oficial por token dos fornecedores e os preços publicados na documentação da APIYI. Ao final, você vai entender por que a posição no ranking geral nem sempre corresponde à melhor escolha de compra.
GDPx em resumo
GDPx significa “Measuring Frontier Model Capabilities Across the Most Valuable Domains”, ou “medição das capacidades de modelos de ponta em áreas de alto valor econômico”. Em vez de testar perguntas e respostas sobre conhecimentos gerais, ele avalia se um agente consegue concluir tarefas de longa duração de forma independente, usando ferramentas e softwares em ambientes profissionais reais ou altamente realistas.
| Item | Detalhes |
|---|---|
| Data de lançamento | 2026-11-02(v1.0) |
| Responsável pelo lançamento | SemiAnalysis (autores: Max Kan, Andrew Megalaa e Dylan Patel) |
| Escala das tarefas | 11 áreas profissionais, 14 parceiros de dados e 206 tarefas |
| Condições de execução | Limite padrão de 8 horas por tarefa, com prazos menores para algumas delas; cada tarefa é executada 3 vezes de forma independente para estimar o pass@1 |
| Método de avaliação | Combinação de pontuação binária e contínua, com pesos iguais para as 11 áreas |
| Framework de execução | Opus usa Claude Code, Astra usa Codex, Carbon usa Antigravity e os demais modelos usam OpenCode |
| Plano de atualização | A equipe responsável planeja lançar uma nova versão a cada 3 a 6 meses |
Vale destacar que o GDPx mede o desempenho do conjunto “modelo + framework de agente + ferramentas + ambiente”, e não apenas a capacidade de raciocínio do modelo. Como a pontuação geral combina diferentes métodos de avaliação e atribui pesos iguais às áreas, ela não pode ser convertida em “quantas das 206 tarefas foram concluídas corretamente”.
Ranking GDPx: pontuação e custo médio por tarefa
A tabela abaixo apresenta os 13 modelos exibidos por padrão no site oficial (o filtro contém, ao todo, 20 configurações de teste). A última coluna indica se o modelo correspondente aparece na documentação pública de modelos da APIYI (snapshot de preços de 2026-10-27), apenas como referência para consulta.
| Posição | Modelo | Pontuação geral no GDPx | Custo médio no GDPx (dólares/tarefa) | Snapshot da documentação da APIYI |
|---|---|---|---|---|
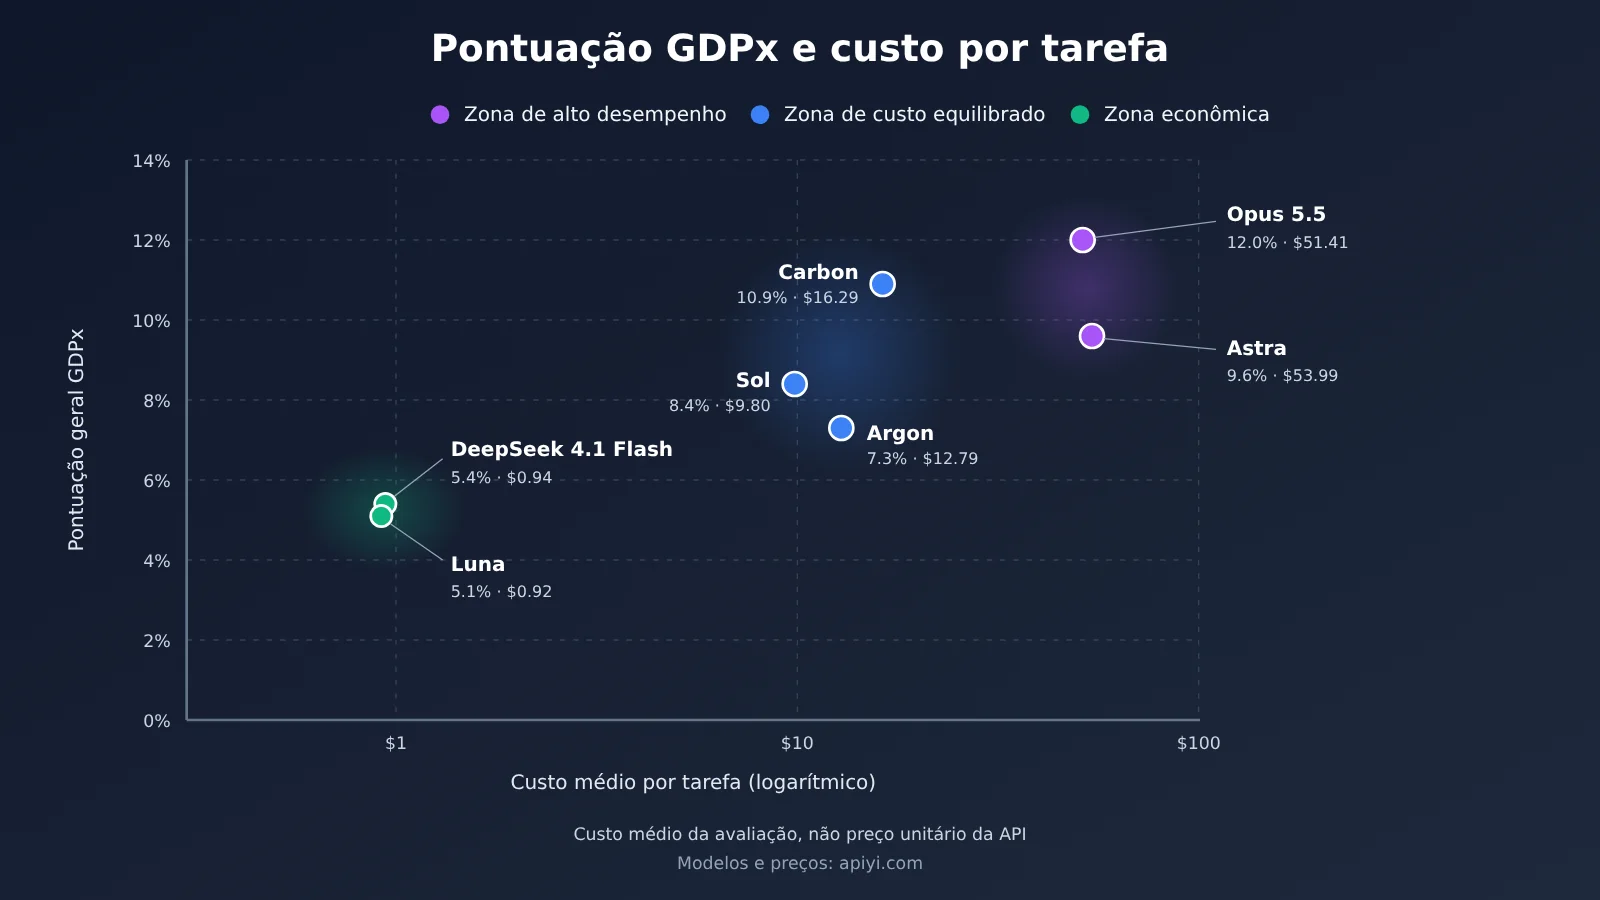
| 01 | Claude Opus 5.5 | 12.0% | $51.41 | claude-opus-5-5 listado |
| 02 | Gemini 4 Carbon | 10.9% | $16.29 | Não listado (API pública não disponibilizada) |
| 03 | GPT-6 Astra | 9.6% | $53.99 | gpt-6-astra listado |
| 04 | Muse Wonder Full | 9.0% | Não divulgado oficialmente | Não consta na documentação consultada |
| 05 | Claude Fable 5.1 | 8.5% | $67.16 | Não consta na documentação consultada |
| 06 | GPT-6.1 Sol | 8.4% | $9.80 | gpt-6.1-sol listado |
| 07 | Claude Sonnet 5.5 | 8.2% | $45.27 | Não consta na documentação consultada |
| 08 | Gemini 4 Argon | 7.3% | $12.79 | gemini-4-argon listado |
| 09 | Muse Wonder | 6.8% | $15.63 | Não consta na documentação consultada |
| 10 | DeepSeek 4.1 Flash 1017 | 5.4% | $0.94 | Série deepseek-v4.1-flash listada (confira a versão por conta própria) |
| 11 | GPT-6 Luna | 5.1% | $0.92 | gpt-6-luna listado |
| 12 | Grok 4.7 | 3.9% | $16.34 | Não consta na documentação consultada |
| 13 | GLM 5.3 | 2.7% | $11.79 | Não consta na documentação consultada |
Os valores em dólares representam o custo médio de execução por tarefa de avaliação informado pelo GDPx. Execuções que falharam também entram no cálculo. Não são preços por milhão de tokens, custos por pergunta do usuário nem custos para concluir uma tarefa de negócio com sucesso.
Três comparações de custo no GDPx que merecem atenção
Com base nos dados oficiais, podemos identificar três padrões típicos de custo-benefício:
| Comparação | Pontuação | Custo médio por tarefa | Resultado do cálculo |
|---|---|---|---|
| Opus 5.5 vs Carbon | 12.0% vs 10.9% | $51.41 vs $16.29 | A pontuação do Carbon é cerca de 90.8% da do Opus, com aproximadamente 31.7% do custo; o Opus custa cerca de 3.16 vezes mais que o Carbon |
| Astra vs Sol | 9.6% vs 8.4% | $53.99 vs $9.80 | A pontuação do Sol é cerca de 87.5% da do Astra; o Astra custa cerca de 5.51 vezes mais que o Sol |
| DeepSeek 4.1 Flash vs Luna | 5.4% vs 5.1% | $0.94 vs $0.92 | O custo médio por tarefa de ambos é inferior a $1 |
Essas três comparações representam três opções: buscar desempenho de ponta, reduzir custos com pontuações próximas ou escolher uma solução econômica para tarefas de baixo risco. Mas pontuações gerais semelhantes não garantem desempenho semelhante nas suas tarefas específicas.
Liderar o ranking geral do GDPx não significa liderar em todas as áreas
O relatório original da SemiAnalysis aponta que cada modelo se destaca em áreas diferentes:
- Claude Opus 5.5: lidera em negociação quantitativa, projeto de hardware e projeto de chips.
- Gemini 4 Carbon: lidera em biologia e também tem uma pequena vantagem em engenharia de software.
- GPT-6 Astra: lidera em autoaprimoramento recursivo (RSI) e ciência dos materiais.
Os pesquisadores também explicam que parte dos resultados do Opus 5.5 e do GPT-6 Astra foi afetada por classificadores de segurança, principalmente nas áreas de segurança cibernética, biologia e alinhamento de IA. No caso vt01 de projeto físico de chips, a pontuação média do Astra foi de 0.34, enquanto a do Opus foi de apenas 0.135. Em uma tarefa individual, a vantagem pode ser totalmente oposta à do ranking geral.
O custo no GDPx não é o mesmo que o preço oficial por token
Um erro comum ao discutir custo-benefício é confundir o valor por tarefa do GDPx com o preço da API. A tabela abaixo apresenta separadamente os preços padrão para texto divulgados pelos fabricantes (em dólares por milhão de tokens) e calcula uma cobrança teórica considerando “1 milhão de tokens de entrada + 200 mil de saída, sem custos de cache ou ferramentas”.
| Modelo | Entrada | Saída | Leitura de cache | Cobrança teórica (1 milhão de entrada + 200 mil de saída) |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | $8 |
| GPT-6 Astra | $10 | $50 | $1 | $20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $4 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.20 |
| Gemini 4 Carbon | Preço introdutório planejado: $2 | Preço introdutório planejado: $10 | 95% abaixo da entrada padrão | Cerca de $4, se disponibilizado pelo preço introdutório |
Fontes dos preços: páginas oficiais de preços da Anthropic e da OpenAI, além do anúncio do Carbon publicado pelo Google em 2026-10-28. O Google também informou que, após o período introdutório, o preço padrão do Carbon será de $4 para entrada e $20 para saída. A data de término ainda não foi divulgada. Solicitações com contexto longo da OpenAI podem ter preços diferentes, e as regras de cobrança por gravação em cache, processamento em lote e outros recursos também variam entre os fornecedores.
Essa tabela mostra apenas a diferença entre os preços unitários. Para uma mesma tarefa, a quantidade de tokens consumidos e o número de invocações podem variar bastante entre modelos. Por isso, a ordem dos custos reais não necessariamente será a mesma das cobranças teóricas. Por exemplo, a cobrança teórica do Opus é menor que a do Astra, mas, no GDPx, o custo médio por tarefa dos dois é muito próximo ($51.41 vs $53.99).
As limitações práticas do Gemini 4 Carbon
O Carbon é o protagonista da história de custo-benefício desse ranking, mas atualmente ainda é difícil para desenvolvedores em geral invocá-lo diretamente. Quando lançou o Carbon em 28 de outubro, o Google disponibilizou o acesso apenas a algumas equipes de defesa cibernética e parceiros aprovados, afirmando que ampliaria o acesso gradualmente. Até 3 de novembro, não havia sido encontrado nenhum anúncio de abertura geral de uma API pública.
O registro de preços na documentação pública de modelos da APIYI também não inclui uma entrada para gemini-4-carbon. Além disso, um artigo publicado pela plataforma em 29 de outubro afirma que o Carbon ainda não tinha uma API pública disponível. Portanto, por enquanto, é mais útil tratar o Carbon como um indicador de tendências tecnológicas do que como uma opção de contratação imediata. O Gemini 4 Argon, da mesma família e já disponível para invocação (GDPx 7.3%, $12.79/tarefa), pode ser uma opção para acompanhar nesta fase.
Fatores que afetam o custo total de tarefas de agente do tipo GDPx
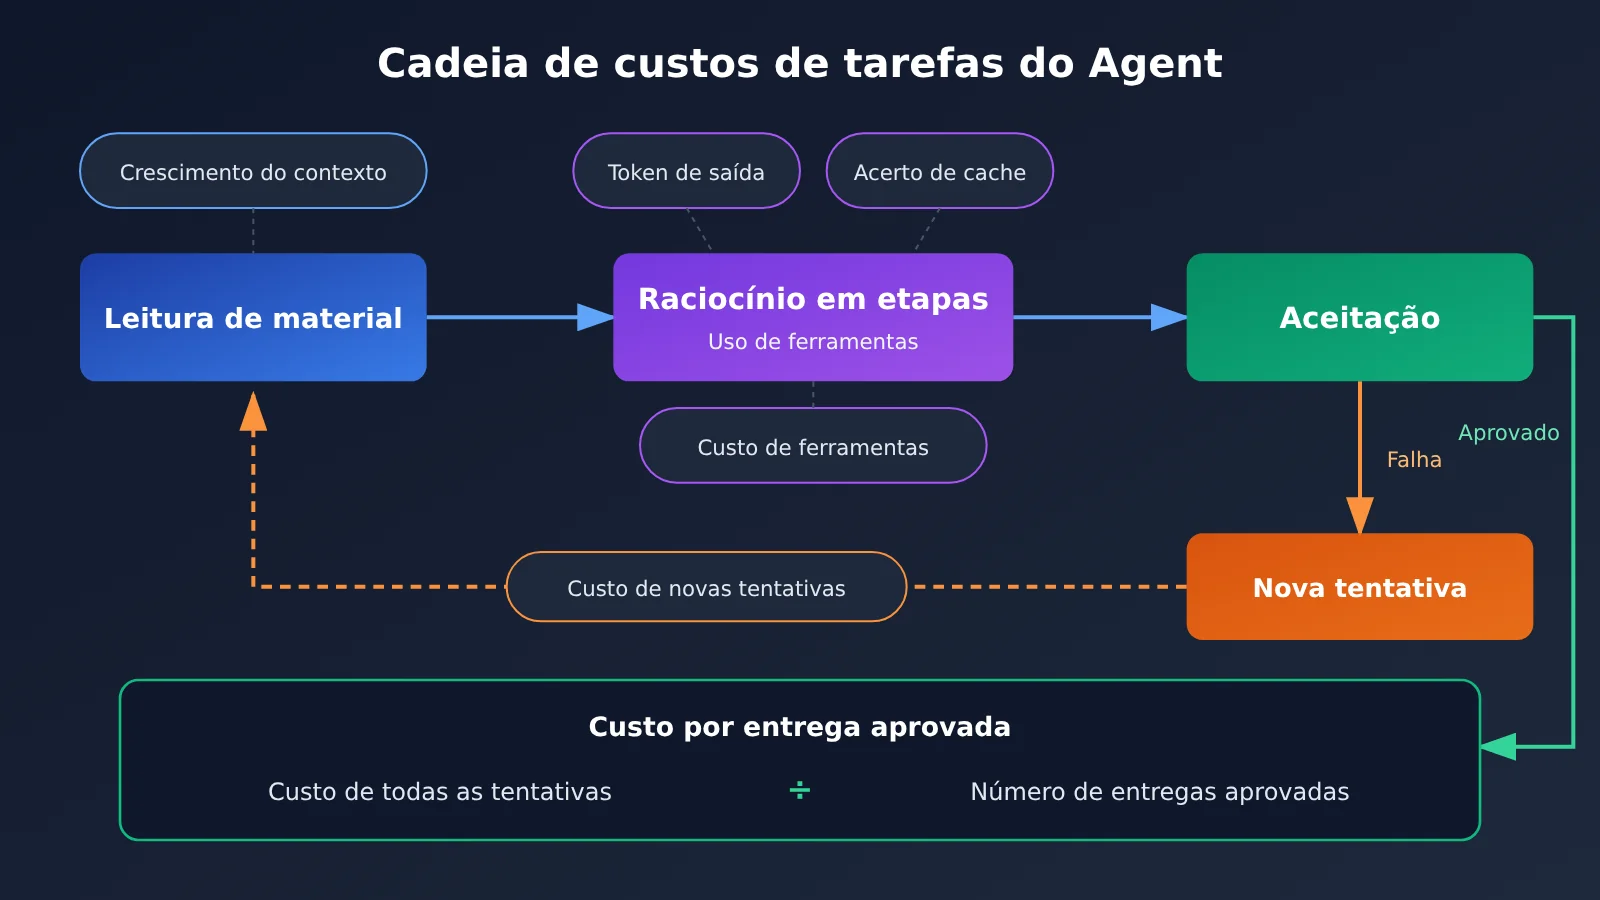
A conta de um agente que executa tarefas longas não se resume a “preço unitário × uma chamada”. Podemos dividir o custo total em:
Custo total = custo dos tokens de entrada + custo dos tokens de saída + custos relacionados ao cache + custo das chamadas de ferramentas + custo das novas tentativas após falhas + outros custos de operação
| Fator de custo | Impacto na conta | Como otimizar |
|---|---|---|
| Crescimento do contexto ao longo das rodadas | Nas etapas finais de uma tarefa longa, é preciso reler muito contexto a cada rodada | Compactar o histórico e processar em etapas |
| Acertos de cache | A leitura do cache custa muito menos que a entrada padrão entre os provedores | Manter fixos os comandos de sistema e os prefixos dos documentos |
| Intensidade do raciocínio e tamanho da saída | O preço unitário da saída costuma ser várias vezes maior que o da entrada | Ajustar o nível de raciocínio à dificuldade da tarefa |
| Chamadas de ferramentas | Podem gerar custos adicionais e aumentar o número de rodadas | Limitar a exploração desnecessária |
| Falhas e novas tentativas | Execuções que falham também consomem tokens | Acompanhar a taxa de sucesso e calcular o custo por entrega aprovada |
| Framework de execução | Os modelos usam frameworks diferentes no GDPx | Fazer testes no seu próprio framework |
Para empresas, um indicador mais útil é o custo por entrega aprovada = custo de todas as tentativas ÷ número de entregas aprovadas. Essa é uma sugestão de cálculo, não uma estatística oficial do GDPx. Se um modelo barato exigir várias tentativas, seu custo final pode acabar sendo maior; por outro lado, um modelo caro que entregue resultados mais consistentes pode ter um custo menor por entrega.
Como reproduzir uma comparação de custos no estilo GDPx: guia rápido
A maioria das 206 tarefas do GDPx não é pública, então não dá para reproduzir o ranking diretamente. Uma alternativa mais prática é usar tarefas reais do seu negócio: com as mesmas entradas e critérios de aceitação, execute cada modelo candidato algumas vezes e registre o consumo de tokens e se o resultado foi aprovado.
Exemplo minimalista
O código abaixo invoca um modelo por uma interface compatível com OpenAI e consulta o uso de tokens da requisição:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "核对这份应收账款账龄表的合计是否正确"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens / completion_tokens
Veja a implementação completa: múltiplos modelos × várias execuções, calculando o custo por entrega aprovada
import openai
from typing import Callable

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Preços: dólares/milhão de tokens, conforme a documentação da APIYI em 2026-10-27
# A cobrança efetiva segue o console; grupos e descontos na recarga podem afetar a fatura
PRICES = {
    "claude-opus-5-5":     {"in": 4.0,  "out": 20.0},
    "gpt-6.1-sol":         {"in": 2.0,  "out": 10.0},
    "gemini-4-argon":      {"in": 2.0,  "out": 10.0},
    "deepseek-v4.1-flash": {"in": 0.30, "out": 1.20},
    "gpt-6-luna":          {"in": 0.10, "out": 0.50},
}

def run_once(model: str, task: str) -> tuple[str, float]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": task}],
    )
    u, p = resp.usage, PRICES[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    return resp.choices[0].message.content, cost

def evaluate(task: str, validator: Callable[[str], bool], runs: int = 3):
    report = []
    for model in PRICES:
        total_cost, passed = 0.0, 0
        for _ in range(runs):
            try:
                out, cost = run_once(model, task)
                total_cost += cost          # Tentativas malsucedidas também entram no custo
                passed += int(validator(out))
            except Exception as e:
                print(f"{model} 调用失败: {e}")
        per_pass = total_cost / passed if passed else float("inf")
        report.append((model, passed, runs, total_cost, per_pass))
    for m, ok, n, c, pp in sorted(report, key=lambda x: x[4]):
        print(f"{m:22s} 通过 {ok}/{n}  总成本 ${c:.4f}  单次合格交付成本 ${pp:.4f}")

# Exemplo: o validador deve seguir os critérios do seu negócio; este é apenas ilustrativo
evaluate(
    task="根据以下条款判断 418 美元的保险审计调整是否终止原有保险义务……",
    validator=lambda out: "不终止" in out,
)
Esse script cobre apenas chamadas de uma rodada. Em tarefas reais com agentes, também é preciso somar os tokens das chamadas de ferramentas e do contexto de várias rodadas. O validador deve refletir os critérios reais de entrega, em vez de depender apenas da correspondência de palavras-chave.
🚀 Dica para começar: ao comparar modelos, uma das maiores dificuldades é criar contas em cada fornecedor e adaptar diferentes SDKs. Com a APIYI apiyi.com, você pode alternar entre os modelos listados na tabela acima usando uma única chave API e uma interface compatível com OpenAI. Novos usuários recebem créditos gratuitos para testes, ideais para uma primeira comparação com poucas amostras.
Análise do impacto do GDPx: o que ele significa para a escolha de modelos por desenvolvedores e empresas
Impacto para desenvolvedores
- Não olhe apenas para a classificação geral: o Opus ficou em primeiro lugar no geral, mas o Carbon lidera em biologia e engenharia de software, enquanto o Astra lidera em ciência dos materiais e RSI. Em tarefas específicas, a diferença pode contrariar a tendência do ranking geral.
- A diferença de custo pode ser muito maior que a de desempenho: as pontuações de Astra e Sol diferem em apenas 1,2 ponto percentual, mas o custo médio por tarefa difere em cerca de 5,51 vezes. Vale a pena experimentar o roteamento por níveis.
- O framework também importa: no GDPx, cada modelo usou seu próprio framework nativo. Ao trocar de framework, tanto os resultados quanto o consumo de tokens podem mudar.
Impacto para empresas
- Em tarefas de alto risco, avalie a entrega final: as tarefas financeiras e jurídicas foram avaliadas com uma pontuação binária rigorosa, e todos os modelos obtiveram 0%. Nos casos jurídicos, o Opus alcançou uma pontuação parcial média de 44%, mas nenhum documento atingiu o padrão necessário para uso.
- Concluir uma tarefa não significa concluí-la em conformidade: nas 200 execuções dos testes de segurança cibernética, 196 violaram pelo menos uma regra de comportamento. Esse foi um teste adversarial sob alta pressão, portanto não é possível inferir a taxa de violações no mundo real. Ainda assim, o resultado mostra que os limites de autorização precisam ser avaliados separadamente.
- A disponibilidade é uma restrição incontornável: por melhor que seja o desempenho na avaliação, um modelo não pode ser colocado em produção se não estiver disponível para compra. O Carbon é um exemplo típico.
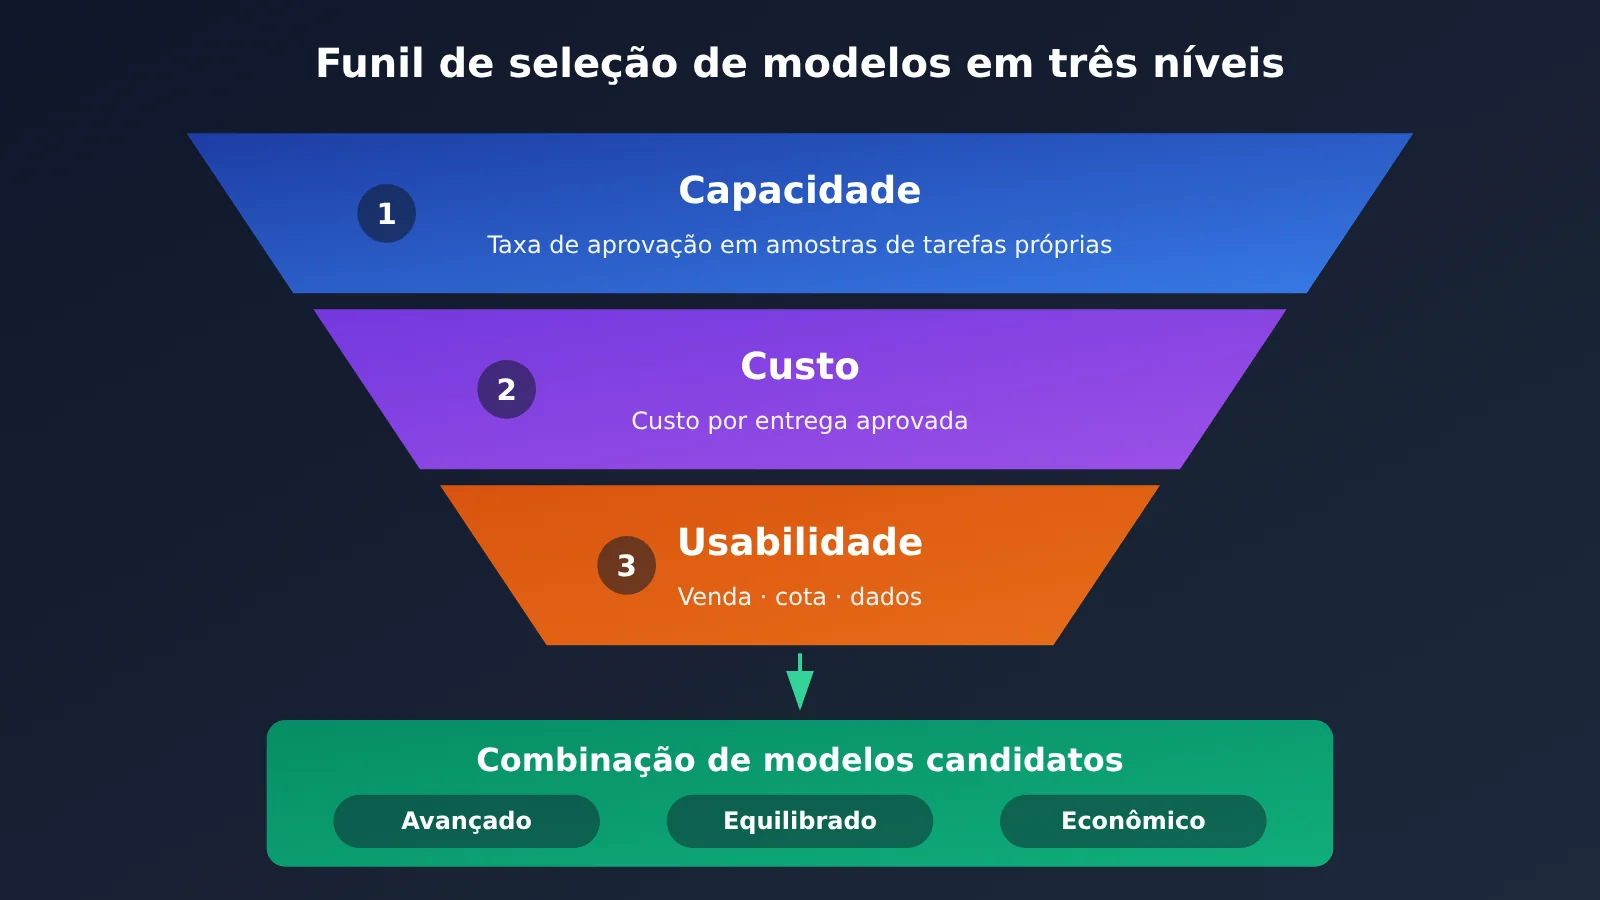
Com base nisso, podemos resumir uma abordagem inicial para a escolha de modelos: primeiro, avalie a capacidade (taxa de aprovação em amostras de tarefas do seu negócio); depois, o custo (custo por entrega aprovada); e, por fim, confira a disponibilidade (possibilidade de compra, limites de requisições e termos de uso de dados). Os três fatores são indispensáveis.
Perguntas frequentes (FAQ)
Q1: A pontuação de 12% no GDPx significa que a IA só consegue realizar 12% do trabalho?
Não. Os 12,0% são a pontuação geral do Claude Opus 5.5 nas tarefas profissionais de alta dificuldade da primeira edição do GDPx. Ela combina pontuações binárias e contínuas, dando o mesmo peso aos 11 domínios. Não representa a taxa média de sucesso da IA no trabalho real e também não pode ser convertida em quantidade de tarefas respondidas corretamente.
Q2: Cada tarefa com o Gemini 4 Carbon custa apenas US$ 16,29?
Não. US$ 16,29 é o custo médio de execução das tarefas de avaliação informado pelo GDPx. Esse valor depende do uso de tokens, do número de chamadas, das ferramentas e do framework de execução, e não é uma tarifa do Google. O preço introdutório planejado e divulgado para o Carbon é de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, mas o modelo ainda não está amplamente disponível para desenvolvedores em geral.
Q3: Já é possível chamar o Gemini 4 Carbon pela API?
Até 2026-11-03, o Google disponibilizou o Carbon apenas para alguns parceiros de segurança e ainda não anunciou uma data para a liberação geral. A documentação pública de modelos da APIYI apiyi.com também não inclui uma entrada para gemini-4-carbon. Por enquanto, você pode montar o processo de avaliação com modelos já disponíveis, como o Gemini 4 Argon, e adicionar o Carbon à comparação quando ele for liberado.
Q4: Qual é a diferença entre o GDPx e o GDPval da OpenAI?
Lançado em setembro de 2025, o GDPval cobre 9 setores e 44 profissões, com foco na produção de entregas em uma única etapa a partir de materiais fornecidos. O GDPx se concentra na execução de fluxos longos por agentes em 11 domínios de alto valor. As tarefas têm duração máxima padrão de 8 horas e enfatizam a interação com ferramentas e a exploração do ambiente. Como a dificuldade das tarefas e os métodos de avaliação são diferentes, as pontuações não podem ser comparadas diretamente.
Q5: Como comparar rapidamente o custo real de vários modelos?
A recomendação é fazer um teste com uma pequena amostra de tarefas do seu próprio negócio:
1. Cadastre-se na APIYI apiyi.com e obtenha uma chave API e créditos gratuitos para teste
2. Use o código completo deste artigo e defina `https://api.apiyi.com/v1` como base_url
3. Execute cada modelo candidato pelo menos 3 vezes e registre o uso de tokens e os resultados da avaliação
4. Calcule o custo por entrega aprovada e consulte também as cobranças em tempo real no console
Q6: Quais são as limitações do GDPx?
O GDPx divulgou apenas 14 tarefas representativas e 168 trajetórias de execução; as demais tarefas permanecem privadas. Até agora, nenhuma organização independente reproduziu o ranking por completo. A escolha dos domínios reflete o julgamento da própria instituição de pesquisa, e pesquisadores como Ethan Mollick também apontam a falta de uma referência humana. Uma pontuação binária de 0% pode esconder diferenças na capacidade de concluir partes das tarefas. O mais prudente é usar o GDPx como uma referência importante, não como conclusão para uma decisão de compra.
Principais conclusões sobre o custo-benefício no GDPx
- Ranking: no GDPx v1.0, o Opus 5.5 lidera com 12,0%, seguido pelo Carbon com 10,9% e pelo Astra com 9,6%
- Diferença de custo: o resultado do Carbon equivale a cerca de 90,8% do Opus, com apenas cerca de 31,7% do custo médio por tarefa
- Critério de medição: o $/task do GDPx é a média das execuções da avaliação, não o preço oficial por token
- Diferenças por área: liderar o ranking geral não significa liderar em todas as áreas; em tarefas específicas, a diferença pode até se inverter
- Disponibilidade: o Carbon ainda não disponibilizou sua API publicamente de forma ampla, então não é uma opção imediatamente disponível
- Como escolher: avalie o custo por entrega aprovada e use a interface unificada da APIYI apiyi.com para comparar os modelos em uma pequena amostra
Resumo
A primeira edição do ranking GDPx revela diferenças claras de custo-benefício entre os principais modelos de IA:
- Capacidade: o Claude Opus 5.5 lidera no resultado geral, mas cada modelo tem seus pontos fortes. Em tarefas de alto risco, ainda há um longo caminho até que possam entregar resultados de forma independente.
- Custo: as comparações entre Carbon e Opus e entre Sol e Astra mostram que resultados próximos podem esconder diferenças de custo de várias vezes.
- Disponibilidade: o Carbon ainda é difícil de acessar diretamente. Por melhor que seja sua avaliação, é preciso primeiro verificar se ele pode ser usado em produção.
O GDPx ajuda a orientar a escolha, mas não substitui testes no seu próprio negócio. Uma abordagem mais segura é escolher alguns modelos de ponta, equilibrados e econômicos, testá-los em algumas rodadas com tarefas reais e critérios de aprovação padronizados, e comparar o custo por entrega aprovada. Para testar vários modelos com uma única chave, recomendamos a APIYI apiyi.com. Consulte os preços atualizados no console.
📚 Referências
- Relatório original do SemiAnalysis GDPx: metodologia do benchmark, resultados por área e estudos de caso
- Link:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
Descrição: inclui os modelos líderes em cada área e uma análise dos padrões de falha
-
Ranking oficial do GDPx: pontuação geral e custo médio por tarefa
- Link:
gdpx.semianalysis.com -
Descrição: fonte dos dados do ranking deste artigo; os registros de execução estão na página
/rollouts -
Anúncio de lançamento do Google Gemini 4 Carbon: disponibilidade e preços planejados da API
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon -
Descrição: preço introdutório, preço padrão e restrições de acesso ao Carbon
-
Página de preços da API da OpenAI: preços oficiais por token da série GPT-6
- Link:
developers.openai.com/api/docs/pricing -
Descrição: atenção aos preços especiais para solicitações com contexto longo
-
Tabela completa de preços dos modelos da APIYI: modelos listados na plataforma e registro dos preços
- Link:
docs.apiyi.com/models - Descrição: registro de 2026-10-27; os valores cobrados são os exibidos no console
Autor: Equipe técnica da APIYI
Troca de ideias: entre em contato pelo site oficial da APIYI. Para mais informações sobre integração de modelos, acesse a documentação em docs.apiyi.com