Nota do autor: uma análise da arquitetura de duas camadas Router + Worker do DeepSeek Super-agent, de como ela separa a coordenação global da execução independente e de quando vale a pena adotar um design semelhante em sistemas de agentes.
Se você mantém quatro ou cinco janelas de agentes de programação abertas ao mesmo tempo, já deve ter enfrentado um problema bem prático. Uma janela está corrigindo um bug de login, outra está revisando uma migração de banco de dados e uma terceira aguarda o resultado do CI. Você precisa lembrar o que cada janela está fazendo, quem está esperando sua resposta e quais tarefas estão relacionadas. Os modelos estão cada vez mais capazes de trabalhar de forma independente, mas o esforço de gerenciar essas sessões continua nas mãos das pessoas.
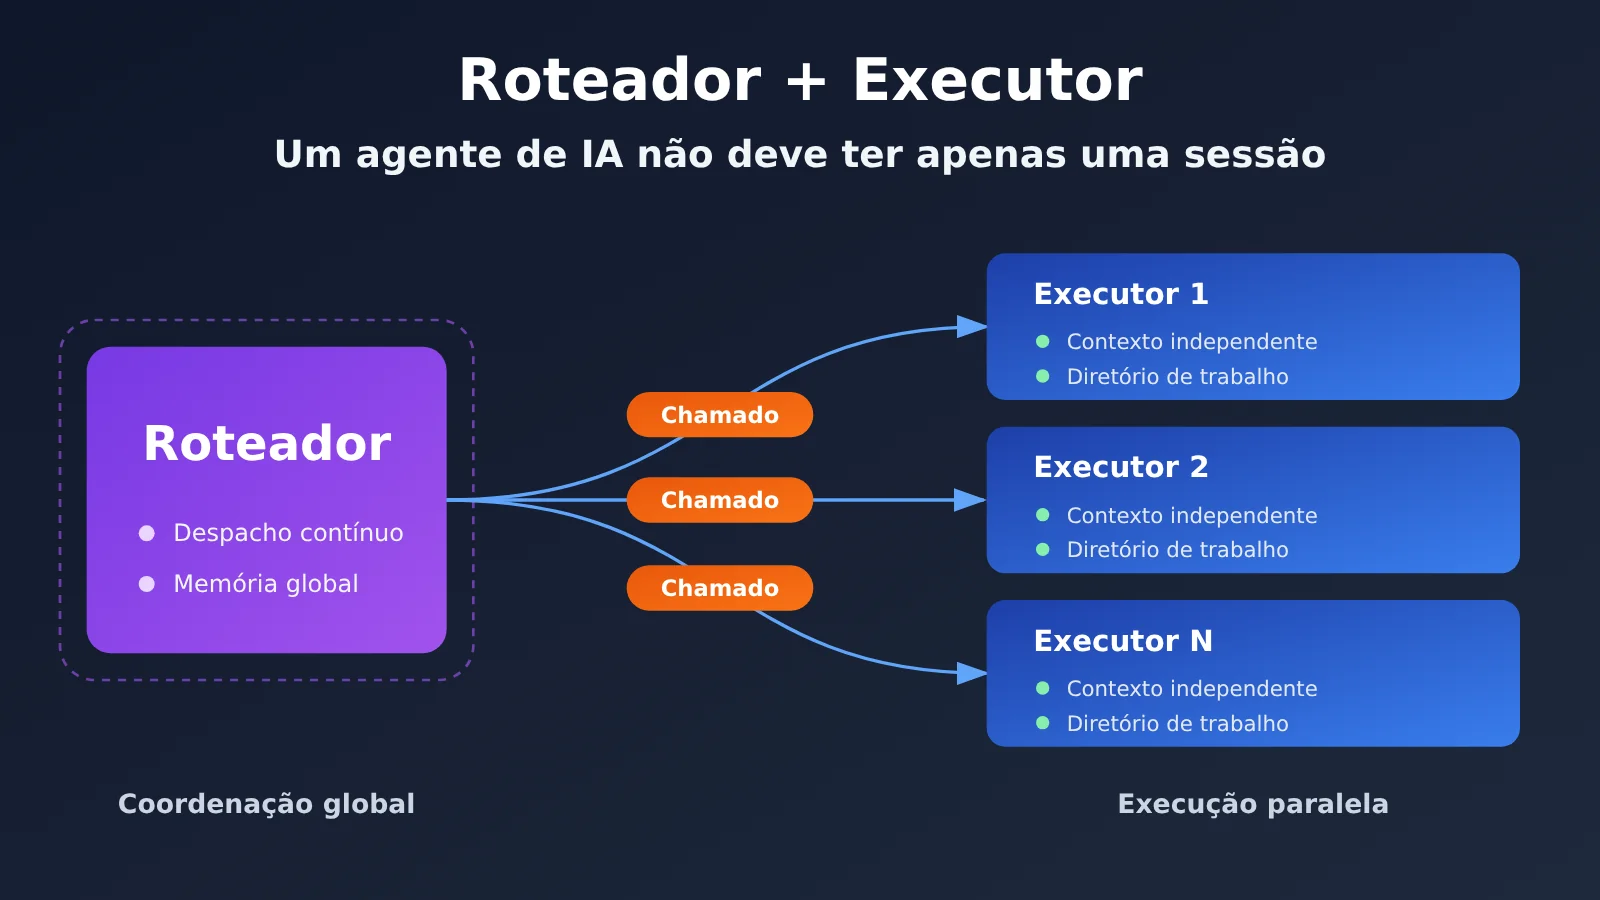
Em 31 de outubro de 2026, a equipe DeepSeek Harness publicou o artigo técnico «Explorando o design do Super-agent: rumo a sistemas de agentes mais autônomos» e disponibilizou o protótipo de pesquisa dsh-superagent-prototype como código aberto sob a licença MIT. O ponto central do projeto é a arquitetura de duas camadas Router + Worker: um Router permanente cuida da coordenação global, enquanto vários Workers isolados executam as tarefas.
Não se trata apenas de fazer uma IA executar mais tarefas ao mesmo tempo. O foco do Super-agent é usar a arquitetura do sistema para separar a coordenação global da execução independente, reduzindo o esforço humano de gerenciar várias sessões. Neste artigo, vamos seguir a sequência «problema — mecanismo — evidências — valor para a engenharia» para entender as motivações do projeto, seus mecanismos principais, os dados dos experimentos oficiais e as lições para chamadas de API e gestão de custos.
O que você vai aprender: ao final, você entenderá qual problema a arquitetura Router + Worker realmente resolve e saberá avaliar quando vale a pena adotar um design semelhante no seu sistema de agentes.
Router + Worker: principais informações
Antes de entrar na arquitetura, vale alinhar os fatos básicos sobre o lançamento. Um ponto importante: o que a DeepSeek disponibilizou em código aberto é um protótipo de pesquisa, não um produto comercial oficial nem um novo modelo de base.
| Item | Detalhes |
|---|---|
| Data de lançamento | 31 de outubro de 2026 (artigo técnico e repositório no GitHub publicados no mesmo dia) |
| Responsável pelo lançamento | Equipe DeepSeek Harness |
| Nome do projeto | dsh-superagent-prototype, desenvolvido principalmente em TypeScript, com licença MIT |
| Proposta do projeto | Protótipo de pesquisa, não um produto comercial oficial; depende do DeepSeek Harness para funcionar |
| Arquitetura central | Estrutura de duas camadas: Router para coordenação global e Worker para execução isolada |
| Recursos atuais | Monitoramento de um único repositório GitHub, integração opcional com o Feishu, gerenciamento de tickets, sessões independentes de Worker e geração de PRs |
| Interesse da comunidade | Cerca de 8.900 estrelas e 898 forks em 2 de novembro (números sujeitos a alterações) |
A equipe responsável definiu quatro características como objetivos para o Super-agent: Continuous (continuidade de contexto entre canais), Productive (execução paralela de tarefas), Proactive (resposta proativa a eventos dentro dos limites autorizados) e Persistent (operação contínua e recuperação de algumas falhas). Esses são objetivos de projeto, não uma garantia de que o protótipo de código aberto já implemente todos eles.
Por que um agente de IA não deveria ter apenas uma sessão
A equipe da DeepSeek acredita que o gargalo das ferramentas de programação com IA está deixando de ser a “capacidade do modelo” e passando a ser a “atenção humana”. Pela observação diária da equipe, uma pessoa geralmente consegue acompanhar de forma eficaz cerca de 3 a 5 sessões de agentes ativas. Essa é uma avaliação baseada na experiência da equipe, não uma estatística pública obtida com um grande número de usuários, mas descreve bem o que muitos desenvolvedores sentem na prática.
O dilema entre uma e várias sessões
As duas abordagens mais comuns têm limitações importantes. A arquitetura Router + Worker foi proposta justamente para combinar a “continuidade do contexto global” com a “capacidade de processamento paralelo em segundo plano”.
| Abordagem arquitetural | Vantagens | Problema principal |
|---|---|---|
| Uma única sessão para todo o trabalho | O contexto global é naturalmente contínuo | As informações das tarefas interferem umas nas outras; chamadas de ferramentas demoradas bloqueiam novas tarefas; há a limitação de um único ciclo ReAct |
| Uma sessão independente para cada tarefa | Execução paralela e isolamento de contexto | Falta memória global; a pessoa precisa lembrar das relações entre as tarefas; conversas e notificações ficam espalhadas por várias janelas |
| Arquitetura de duas camadas Router + Worker | Estado global centralizado + contextos de execução isolados | Maior consumo de recursos de inferência; o Router pode se tornar um gargalo |
O problema de uma única sessão é o “congestionamento”; o de várias sessões é a “dispersão”. A primeira faz uma única janela de contexto carregar as etapas intermediárias de todas as tarefas. A segunda transfere todo o custo de coordenação para a pessoa. A ideia da DeepSeek é introduzir no sistema um componente responsável por “lembrar do contexto global”, para que os executores possam se concentrar na execução.
Como funciona a arquitetura de duas camadas Router + Worker
Router: a camada global de coordenação
O Router é uma camada lógica que permanece ativa continuamente. Na arquitetura que a equipe oficial está explorando, ele é implementado principalmente por uma sessão de LLM persistente, mas o conceito não precisa corresponder exatamente a uma sessão de modelo. Seu papel é mais “gerenciar” do que “executar”:
- Receber mensagens dos usuários e eventos externos do GitHub, IM, CI e outras fontes;
- Manter as associações entre tarefas e decidir se é necessário criar um novo trabalho;
- Verificar autorizações, distribuir tarefas aos Workers e coordenar atividades entre elas;
- Reunir as informações que precisam ser entregues às pessoas e recuperar o contexto de tarefas anteriores quando necessário.
Um detalhe importante: segundo a equipe oficial, o Router pode até funcionar sem acesso à ferramenta Bash. Ao não executar tarefas complexas de programação, ele evita ficar bloqueado por chamadas de ferramentas demoradas. Além disso, suas tarefas nem sempre exigem o modelo de raciocínio mais poderoso: às vezes, um modelo mais leve já atende às necessidades de interação e distribuição de tarefas. Isso dá uma base técnica para configurar modelos diferentes conforme a função.
Worker: a camada de execução isolada das tarefas
O Worker cuida do trabalho propriamente dito. No protótipo público, cada Ticket corresponde a uma sessão de Executor e tem seu próprio diretório de trabalho. Dentro dos limites da autorização recebida, o Worker modifica o código, executa testes e lida com feedback posterior. Ao concluir, gera um Report; quando precisa de uma decisão humana, define o status Attention. O resultado é entregue pelo canal original, como um PR no GitHub.
Os contextos dos modelos usados por diferentes Workers são independentes, o que evita misturar as etapas intermediárias de várias tarefas na mesma janela. Mas atenção: sessões e diretórios independentes não equivalem a um isolamento de segurança robusto. A documentação oficial de implantação informa que, por padrão, os Workers executam comandos com a identidade do usuário do sistema operacional que os opera.
Como um GitHub Issue percorre o fluxo Router + Worker
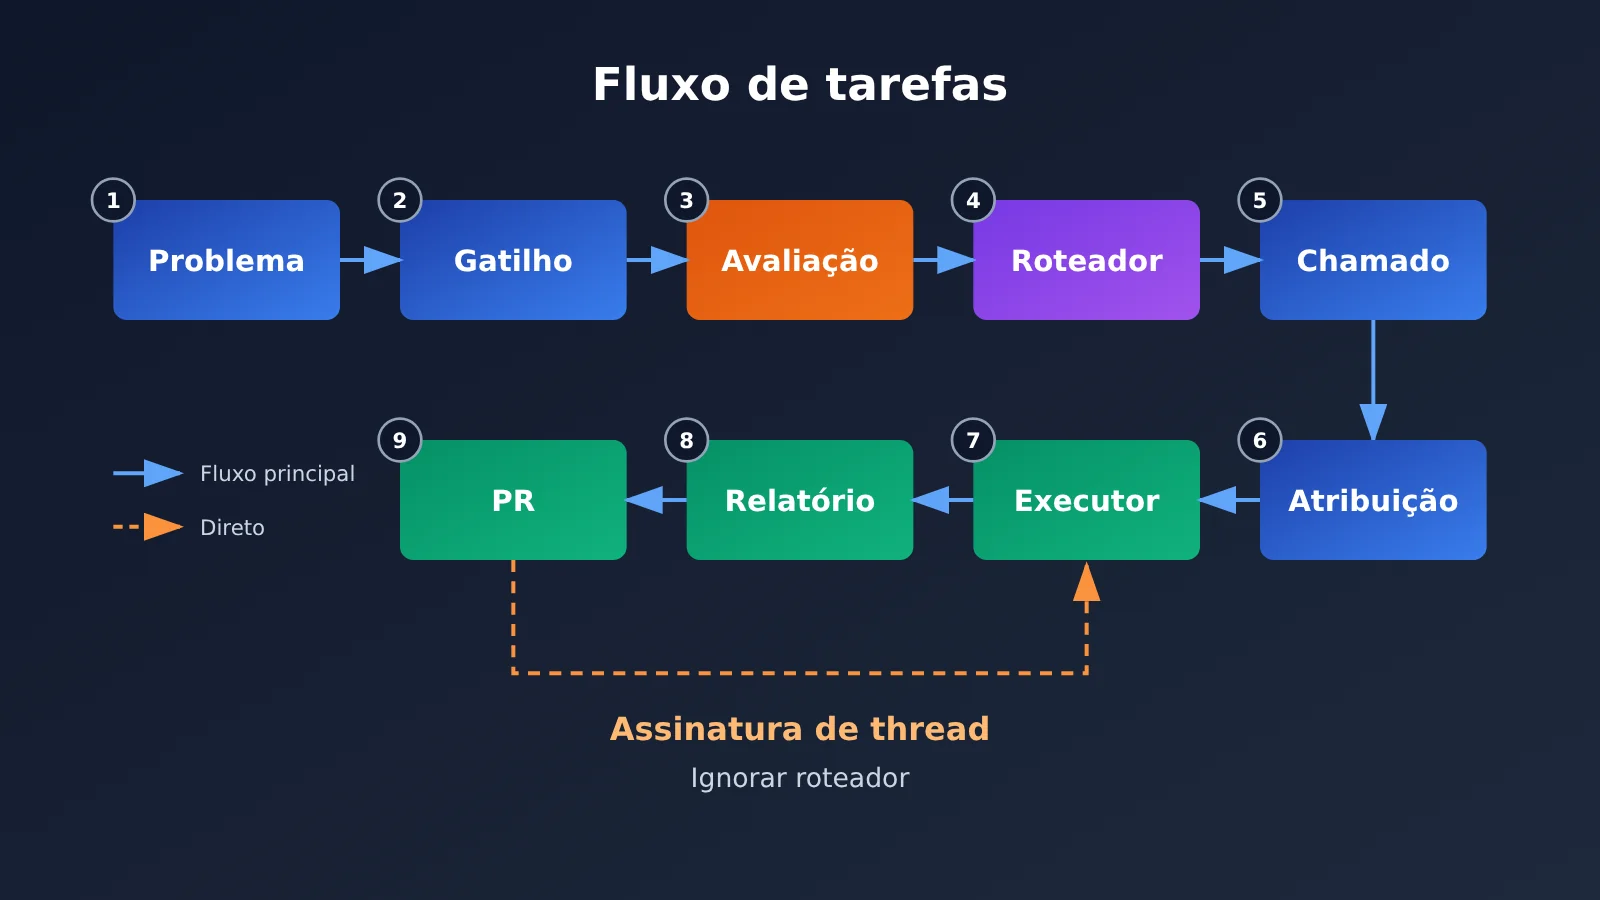
De acordo com o Domain Model da implementação de código aberto, o fluxo de uma tarefa pode ser resumido assim: Source → Trigger → Eval → Decision → Ticket → Assignment → Executor → Report. Veja o exemplo de um usuário autorizado que solicita a correção de um bug em um GitHub Issue:
- A Source do GitHub recebe um comentário no Issue e gera um Trigger;
- O sistema primeiro filtra as permissões com regras determinísticas; depois, o modelo avalia se a solicitação atende às regras de aceitação de tarefas;
- O Router aceita a tarefa e cria um Ticket, que registra seu escopo e a autorização (Mandate);
- O sistema cria uma Assignment para o Ticket e o atribui ao Worker correspondente;
- O Executor realiza a correção em um diretório e uma sessão independentes;
- O Worker informa o progresso ou apresenta o resultado, gerando um PR;
- O sistema entrega o resultado ao usuário pela conversa do Issue ou do PR original.
Se depois o usuário pedir alterações nesse PR, a nova mensagem pode ser associada automaticamente à tarefa original. Assim, ele não precisa procurar “qual sessão de Agent estava cuidando disso”. Esse é um exemplo concreto de como a arquitetura de duas camadas reduz o esforço humano de gerenciamento.
4 decisões de design essenciais para Router + Worker
A arquitetura em duas camadas é apenas o esqueleto. O que realmente a torna viável são algumas decisões de engenharia, cada uma voltada a um problema específico:
| Design | Problema de engenharia | Mecanismo principal |
|---|---|---|
| Entrega direta por assinatura de Thread | Todas as mensagens passam pelo Router, sobrecarregando o nó central | O Worker assina a Thread pela qual é responsável e recebe os eventos relacionados diretamente |
| Processamento em lote no Router | Processar eventos um a um durante picos limita a vazão | Os Triggers acumulados durante a inferência são reunidos e analisados em lote |
| Inline & Spill | A janela de contexto é limitada e injetar todo o conteúdo custa caro | Informações recentes e necessárias entram na janela; conteúdos longos ficam apenas com resumo e referência de leitura |
| Recuperação encadeada | É difícil recuperar informações de tarefas anteriores | As relações entre Trigger, Thread, Ticket e Worker são percorridas para buscar informações anteriores |
Entrega direta por assinatura de Thread: menos redistribuições pelo Router
Imagine que o Worker A seja responsável por um PR. Os comentários posteriores e os resultados de CI desse PR podem ser entregues diretamente ao Worker A com base na Thread, sem que o Router precise decidir novamente o destino de cada mensagem relacionada. É um exemplo clássico de como tirar do nó central decisões frequentes e de baixo valor.
Mas essa entrega direta tem limites claros de autorização. A documentação oficial afirma que mensagens recebidas por assinatura podem fornecer contexto, mas não podem ampliar o Mandate do Ticket original. Se um comentário posterior solicitar um trabalho fora do escopo autorizado, o Worker deve devolvê-lo ao sistema para uma nova avaliação. Isso é importante para se proteger de instruções não autorizadas em comentários externos.
Processamento em lote no Router: como lidar com picos de eventos
Enquanto o Router executa uma rodada de inferência, os novos Triggers ficam acumulados e são analisados juntos na rodada seguinte. Na prática, isso troca “uma invocação do modelo por mensagem” por “várias mensagens por rodada de inferência”, diluindo significativamente o custo de inferência de cada decisão quando há muitos eventos.
Inline & Spill e recuperação encadeada: o contexto como cache
A DeepSeek trata a janela de contexto como uma espécie de cache. Inline é colocar diretamente na janela informações recentes que provavelmente serão usadas, como os comentários mais recentes da tarefa atual, linhas de código relevantes e o código necessário ao redor delas. Spill é deixar fora da janela conteúdos pouco usados ou longos demais, mantendo apenas o resumo, os IDs associados e uma referência para leitura, como no caso de uma discussão antiga e extensa. Já mensagens históricas sem relação com a tarefa não precisam ser injetadas toda vez.
A partir daí surge o Chain of Recall (recuperação encadeada): o modelo pode seguir as relações entre os objetos Trigger → Thread → Ticket → Worker para recuperar informações anteriores gradualmente, conforme a necessidade. Isso economiza mais contexto do que “inserir o histórico completo toda vez” e se aproxima da lógica de uma consulta a banco de dados por índice. Ainda assim, a documentação oficial reconhece que a memória ao longo de meses ou períodos ainda maiores continua sendo um problema sem solução.
Entendendo os dados dos experimentos com Router + Worker
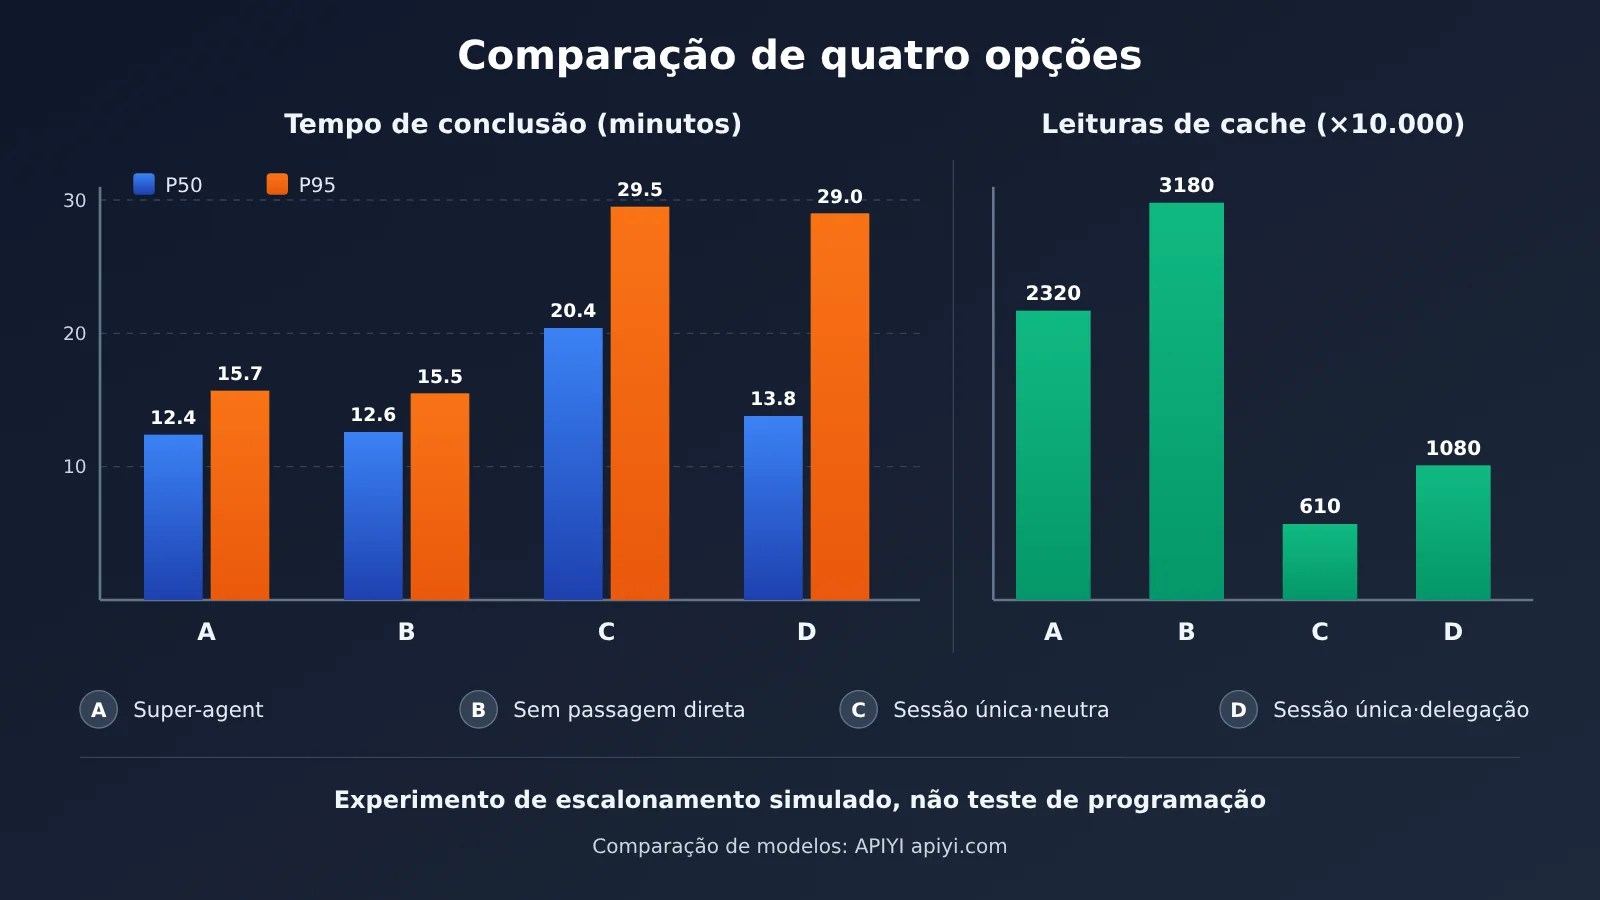
A DeepSeek realizou uma série de experimentos preliminares com cargas de trabalho sintéticas. Cada simulação teve cerca de 300 mensagens, das quais aproximadamente 20 eram solicitações de trabalho; o restante consistia em conversas informais, feedback posterior, pedidos de cancelamento e mensagens de CI. Cada configuração foi executada 5 vezes. O trabalho de programação foi substituído por ferramentas simuladas que consomem tempo, então os dados medem o desempenho do sistema de agendamento, não a qualidade do código gerado.
Comparação do agendamento de ponta a ponta
| Configuração | Tempo de conclusão P50 | Tempo de conclusão P95 | Tokens de leitura de cache por experimento |
|---|---|---|---|
| Super-agent | 12,4 minutos | 15,7 minutos | Cerca de 23,2 milhões |
| Super-agent, sem passagem direta de assinaturas | 12,6 minutos | 15,5 minutos | Cerca de 31,8 milhões |
| Session única + Subagent, comando neutro | 20,4 minutos | 29,5 minutos | Cerca de 6,1 milhões |
| Session única + Subagent, delegação prioritária | 13,8 minutos | 29,0 minutos | Cerca de 10,8 milhões |
Em comparação com a configuração de sessão única e comando neutro, o Super-agent reduziu o tempo de conclusão P50 em cerca de 39% e o P95 em cerca de 47%. Em relação à configuração de sessão única com delegação prioritária, a vantagem no P50 foi pequena, mas a cauda longa do P95 ficou bem menor. Em outras palavras, o maior benefício da arquitetura de duas camadas é evitar que as tarefas mais lentas demorem tanto para terminar.
O custo dessa melhoria também é claro: o volume de leitura de cache do Super-agent foi cerca de 3,8 vezes maior que o da configuração de sessão única com comando neutro. Ele usa mais sessões paralelas e recursos de inferência para obter tempos de conclusão menores e mais estáveis. Mas isso não significa que o custo total tenha aumentado 3,8 vezes: o gasto real também depende do preço de cada modelo, dos acertos de cache, dos tokens comuns de entrada e saída, da escolha dos modelos para Router e Worker e das chamadas de ferramentas. A DeepSeek ainda não divulgou o custo médio de API para tarefas reais.
O experimento de ablação da passagem direta de assinaturas também merece atenção. Ao removê-la, o número de decisões que o Router precisava processar aumentou cerca de 30%, e os tokens de leitura de cache aumentaram cerca de 37%, mas o tempo de conclusão praticamente não mudou. A conclusão é que, nesse teste, a passagem direta de assinaturas economizou principalmente invocações do modelo e custos de contexto do Router, sem acelerar diretamente a conclusão.
Teste de estresse do processamento em lote do Router
Nesses testes, o Router usou um modelo real, enquanto o Worker usou um modelo simulado:
| Métrica | Baixa densidade de eventos | Alta densidade de eventos |
|---|---|---|
| Taxa de chegada de eventos | Cerca de 1 por minuto | Cerca de 40 por minuto |
| Tamanho médio do lote | 1,0 | 2,8 |
| Tempo por requisição ao modelo | 2,5 segundos | 3,9 segundos |
| Tempo de inferência rateado por decisão | 6,4 segundos | 1,6 segundo |
Com o aumento da densidade de eventos, cada requisição ficou mais lenta, mas o tempo de inferência rateado por decisão diminuiu, indicando que o processamento em lote aumentou a vazão efetiva. A conclusão oficial é cautelosa: para o tamanho atual da equipe, um único Router é suficiente por enquanto, mas isso não significa que ele possa processar uma quantidade ilimitada de mensagens.
Impacto do Router + Worker para desenvolvedores
Separação de modelos: um modelo leve para o Router e modelos escolhidos por tarefa para os Workers
A implicação mais direta dessa arquitetura de duas camadas é que funções diferentes não precisam usar o mesmo modelo. O Router cuida principalmente de classificação, encaminhamento e resumo, tarefas adequadas a um modelo rápido e de baixo custo. Já para o Worker, o modelo é escolhido conforme a complexidade da tarefa e a capacidade de raciocínio necessária. O próprio protótipo também permite definir separadamente o provedor e o modelo do Router e dos Workers.
Veja um exemplo mínimo que usa uma interface compatível com a OpenAI para o Router decidir como encaminhar uma tarefa:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,一个 Key 切换多家模型
)

ROUTER_MODEL = "your-fast-cheap-model"   # 替换为控制台中可用的轻量模型名

resp = client.chat.completions.create(
    model=ROUTER_MODEL,
    messages=[{"role": "user", "content": "判断这条 Issue 评论是否需要新建 Ticket:修复登录页 500 错误"}]
)
print(resp.choices[0].message.content)
Ver exemplo de código para invocação em camadas com Router + Worker
import json
import openai
from typing import Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 角色与模型分层:模型名请替换为你实际可用的模型
ROLE_MODELS: Dict[str, str] = {
    "router": "your-fast-cheap-model",
    "worker_simple": "your-mid-tier-model",
    "worker_complex": "your-strong-reasoning-model",
}

usage_log = []  # 按 Ticket 记录 Token 消耗

def call(role: str, ticket_id: str, prompt: str) -> str:
    resp = client.chat.completions.create(
        model=ROLE_MODELS[role],
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    usage_log.append({
        "ticket": ticket_id, "role": role,
        "input": u.prompt_tokens, "output": u.completion_tokens,
    })
    return resp.choices[0].message.content

def router_dispatch(ticket_id: str, event: str) -> str:
    prompt = (
        "你是任务调度器,只做分类,不执行任务。"
        "输出 JSON:{\"accept\": bool, \"complexity\": \"simple\"|\"complex\"}\n"
        f"事件:{event}"
    )
    decision = json.loads(call("router", ticket_id, prompt))
    if not decision["accept"]:
        return "ignored"
    role = "worker_complex" if decision["complexity"] == "complex" else "worker_simple"
    return call(role, ticket_id, f"在授权范围内处理任务:{event}")

print(router_dispatch("T-001", "CI 失败:单元测试 test_login 超时"))
print(usage_log)
🎯 Dica técnica: ao criar agentes em camadas, teste primeiro, com a mesma chave API da APIYI em apiyi.com, o desempenho de modelos leves e de raciocínio avançado nas funções de Router e Worker. Depois, escolha a configuração final para evitar usar o modelo mais caro em todas as funções.
Controle de custos: registre por Ticket, não apenas no total
Os experimentos oficiais mostram que a arquitetura em duas camadas consome mais recursos de inferência. Por isso, o gerenciamento de custos precisa ser mais detalhado. Algumas práticas úteis:
- Registre os tokens por Ticket: separe o custo das decisões do Router do custo de execução dos Workers para identificar os tipos de tarefa mais caros;
- Separe os tipos de custo: contabilize separadamente os gastos com modelos, ferramentas (como busca e acesso a páginas web) e ambiente de execução;
- Acompanhe os acertos de cache: a maior parte dos tokens do Super-agent vem de leituras de cache, e o preço por token pode variar bastante entre acertos e falhas. Nos preços oficiais da DeepSeek, por exemplo, a diferença pode chegar a dezenas de vezes;
- Reduza decisões desnecessárias: aproveite a ideia de encaminhamento direto por assinatura para enviar eventos posteriores ao Worker responsável, eliminando redistribuições repetidas pelo Router.
💰 Otimização de custos: vários Workers em paralelo podem multiplicar o número de chamadas. Com o pagamento por uso da APIYI apiyi.com, é possível acessar modelos de diferentes provedores e comparar, na mesma fatura, os gastos reais de cada função e modelo. Isso facilita a otimização de custos por camada.
Quando vale a pena adotar Router + Worker
Uma arquitetura em duas camadas não é necessariamente melhor só por ser mais complexa. Alguns critérios para avaliar:
- Vale a pena adotar: há vários trabalhos independentes acontecendo ao mesmo tempo (por exemplo, o Ticket A corrige um bug, o Ticket B revisa uma migração e o Ticket C cuida do CI), com eventos vindos de vários canais que exigem respostas contínuas;
- Pode esperar: há poucas tarefas, elas dependem muito umas das outras ou o trabalho gira principalmente em torno de uma única tarefa complexa. Nesses casos, um único Agent ou um Agent Team tradicional consome menos recursos;
- É preciso preparar a infraestrutura: se o isolamento de permissões, o tratamento de conflitos na edição de arquivos e os registros de custos por tarefa ainda não estiverem prontos, começar a executar tarefas em paralelo pode aumentar os riscos.
Também vale lembrar que Router + Worker e um Agent Team comum têm focos diferentes. Um Agent Team costuma dividir uma tarefa complexa entre funções como pesquisa, programação e testes. Já o Router do Super-agent se concentra em coordenar vários trabalhos independentes, sem se aprofundar nos detalhes técnicos de cada um. A documentação oficial também explica que, se a sessão principal de um Agent Team comum cuidar apenas da interação centralizada e da distribuição entre tarefas, ela pode formar uma estrutura semelhante. A arquitetura em duas camadas não é um conceito exclusivo da DeepSeek.
Limitações da arquitetura Router + Worker e limites do protótipo
Ao analisar esse tipo de arquitetura, um erro comum é tratar o projeto completo descrito nos artigos de design como se já estivesse disponível no protótipo open source. É importante distinguir o que as fontes de fato comprovam:
- Já suportado pelo protótipo: monitoramento de um único repositório GitHub, integração opcional com o Feishu, gerenciamento de Tickets, sessões e diretórios independentes para cada Worker, geração de PRs, exibição de tarefas que precisam de intervenção humana no painel de gerenciamento e continuidade do trabalho a partir de mensagens posteriores;
- Planejado, mas sem comprovação de implementação completa: gerenciamento automático de múltiplos repositórios, execução contínua em nuvem em nível de produção com ambiente compartilhado entre dispositivos e reparo autônomo por um Watchdog independente. O ReAct Loop assíncrono já foi implementado no Harness, mas ainda não está ativado por padrão;
- Proatividade com limites: tarefas identificadas por inferência usam o modo
observepor padrão, que apenas registra, sem executar. O merge automático de PRs também fica desativado por padrão.
No nível da arquitetura, ainda existem alguns desafios reconhecidos publicamente. O primeiro é a escalabilidade de um único Router: os responsáveis dizem apenas que ele atende ao tamanho atual da equipe, sem uma resposta para como dividi-lo em escala maior. O segundo é a memória de longo prazo: Inline & Spill e a recuperação encadeada resolvem o contexto de curto e médio prazo, mas a memória entre meses continua sem solução. O terceiro são os limites de permissão: as configurações padrão do Router e dos Workers usam o modo danger-full-access e executam tarefas com a identidade do usuário do sistema que os opera. Os responsáveis recomendam usar um usuário de sistema dedicado. Prompt Injection por meio de comentários externos e gerenciamento de credenciais também estão na lista de problemas a resolver. A comunidade ainda publicou um relatório de auditoria independente do código-fonte para um commit específico, mas o processo completo de ataque não foi reproduzido de forma independente e, por isso, deve ser tratado apenas como um risco potencial.
Testes da comunidade também reforçam o caráter de “protótipo”: um usuário conseguiu executar todo o fluxo, de uma Issue a um PR, partindo de um clone novo e seguindo o SETUP.md. Ao mesmo tempo, relatou problemas como identificação de processos no Node.js 24, mensagens perdidas por atrasos nas notificações do GitHub e falhas nas verificações dos testes quando o idioma do sistema estava em chinês.
Perguntas frequentes (FAQ)
Q1: O que é a arquitetura de duas camadas Router + Worker?
É a estrutura básica do DeepSeek Super-agent: o Router atua como uma camada permanente de coordenação global, responsável por receber eventos, manter as relações entre tarefas e distribuir o trabalho. Já o Worker é a camada de execução isolada: cada Ticket é processado em uma Session e em um diretório independentes. A ideia central é separar a coordenação global da execução independente.
Q2: Qual é a diferença entre Router + Worker e uma equipe comum de múltiplos agentes?
Uma equipe comum de agentes geralmente divide uma tarefa complexa entre funções como pesquisa, programação e testes. Já o Router + Worker dá mais ênfase à coordenação entre atividades independentes, sem que o Router entre nos detalhes de cada tarefa. Se a sessão principal de uma equipe comum cuidar apenas da interação centralizada e da distribuição entre tarefas, ela também pode formar uma estrutura semelhante de duas camadas.
Q3: O experimento oficial comprova que o Super-agent aumenta a eficiência de programação em 47%?
Não. O experimento usou ferramentas de programação simuladas, executou cada abordagem apenas 5 vezes e mediu o tempo de conclusão do agendamento de tarefas, não a qualidade do código nem a capacidade de programação. A redução de cerca de 47% no P95 indica apenas que, nessa carga sintética, os casos mais demorados de agendamento levaram menos tempo. Não é possível extrapolar esse resultado para a eficiência real de programação nem usá-lo para comparar a capacidade de programação com Claude Code ou Codex.
Q4: O Router + Worker sai mais barato?
Não necessariamente. No experimento sintético oficial, o volume de leitura de cache do Super-agent foi cerca de 3,8 vezes maior que o da abordagem neutra de sessão única: ele usa mais recursos em troca de velocidade e estabilidade. A oportunidade de economizar está em usar modelos de diferentes níveis: um modelo leve para o Router e modelos escolhidos conforme a complexidade para os Workers. Com o APIYI apiyi.com, você pode testar o custo real de diferentes combinações de modelos por uma interface unificada e decidir qual faz mais sentido.
Q5: Como testar rapidamente o uso de modelos de diferentes níveis com Router + Worker no meu projeto?
Siga estes passos:
1. Crie uma conta no APIYI apiyi.com para obter uma chave API e créditos gratuitos para testes;
2. Use o código deste artigo e defina `base_url` como `https://api.apiyi.com/v1`;
3. Configure modelos diferentes para o Router e os Workers, registre o consumo de tokens por Ticket e compare os resultados.
Como a interface é compatível com a OpenAI, basta alterar o parâmetro model para trocar de modelo.
Q6: O protótipo de código aberto pode ser usado diretamente em produção nas empresas?
Por enquanto, não é recomendado usá-lo diretamente em produção. Ele é um protótipo de pesquisa: por padrão, os Workers são executados com os altos privilégios do operador, não há suporte ao GitHub Enterprise Server e a comunidade também relatou falhas, como notificações não recebidas, além de possíveis problemas de segurança. O mais indicado é usá-lo em um ambiente isolado para validar o desenho do fluxo de trabalho.
Router + Worker: principais conclusões
- Papel central: o Super-agent é uma arquitetura de sistema que vai além do modelo. O projeto de código aberto é um protótipo de pesquisa, não um produto comercial;
- O problema: o gargalo passa da capacidade do modelo para a atenção humana. Uma única sessão pode ficar “congestionada”; várias sessões podem deixar tudo “disperso”;
- Separação de responsabilidades: o Router cuida apenas da coordenação geral e pode até operar sem Bash. Os Workers executam tarefas de forma independente, em sessões isoladas;
- Mecanismos principais: o encaminhamento direto por assinatura reduz as decisões do Router, o processamento em lote dilui o custo de inferência e o Inline & Spill trata o contexto como cache;
- Limites dos dados: os experimentos de escalonamento mostram tempos de conclusão menores para as tarefas mais demoradas, mas com maior consumo de tokens. Eles não medem a capacidade de programação;
- Como começar: use a interface unificada da APIYI apiyi.com para configurar modelos diferentes para cada papel e gerenciar os custos por ticket.
Resumo
A DeepSeek usou a arquitetura Router + Worker para responder à pergunta: “Por que um agente de IA não deveria ter apenas uma sessão?”
- Valor da arquitetura: separar a coordenação geral da execução independente permite que o sistema acompanhe as relações entre tarefas, em vez de deixar isso para as pessoas;
- Projeto de engenharia: encaminhamento direto por assinatura, processamento em lote, Inline & Spill e recuperação encadeada abordam, respectivamente, a carga central, a vazão em picos, a capacidade de contexto e a recuperação do histórico;
- Visão realista: os experimentos demonstram uma troca entre eficiência de escalonamento e consumo de recursos. A escalabilidade de um único Router, a memória de longo prazo e o isolamento de permissões ainda precisam ser resolvidos.
Se o seu sistema já precisa lidar com várias tarefas independentes ao mesmo tempo, vale considerar essa arquitetura de duas camadas. Se as tarefas são poucas e concentradas, um único agente ainda é a opção mais econômica. Seja qual for a estrutura, usar modelos de diferentes níveis e contabilizar os custos por tarefa é essencial para manter os gastos sob controle.
Uma boa forma de testar rapidamente diferentes modelos nos papéis de Router e Worker é usar a APIYI apiyi.com. A plataforma oferece uma interface compatível com OpenAI, cobrança por uso e créditos gratuitos para testes de novos usuários.
📚 Referências
- Artigo oficial da DeepSeek sobre arquitetura: Explorando o design de superagentes: rumo a sistemas de agentes mais autônomos
- Link:
x.com/DeepSeekHarness/article/2116857257245987236 -
Descrição: fonte primária sobre a arquitetura de duas camadas, os cinco módulos, os dados experimentais e as questões ainda em aberto
-
Repositório oficial da DeepSeek no GitHub: dsh-superagent-prototype
- Link:
github.com/deepseek-ai/dsh-superagent-prototype -
Descrição: status do projeto, código-fonte, protocolo e escopo de uso atual
-
Documentação de código aberto do Domain Model: objetos de tarefa e modelo de fluxo
- Link:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
Descrição: definições de conceitos centrais, como Source, Trigger, Ticket e Assignment
-
Documentação de autorização e assinatura: regras de Mandate e assinatura de Thread
- Link:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
Descrição: explicação oficial de que a assinatura de mensagens não amplia o escopo de autorização
-
Documentação de implantação: dependências, contas e orientações de segurança
- Link:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/006-deployment.md -
Descrição: modo de execução com privilégios elevados e recomendação de usar um usuário de sistema independente
-
Preços oficiais da API DeepSeek: preços de modelos e ferramentas
- Link:
api-docs.deepseek.com/quick_start/pricing - Descrição: diferenças de preço entre acertos e falhas de cache, como referência para estimativas de custo
Autor: Equipe técnica da APIYI
Troca de ideias técnicas: Entre em contato conosco pela página inicial da APIYI em apiyi.com para conversar sobre arquitetura de agentes e práticas de invocação de múltiplos modelos. Para mais informações, acesse a central de documentação em docs.apiyi.com