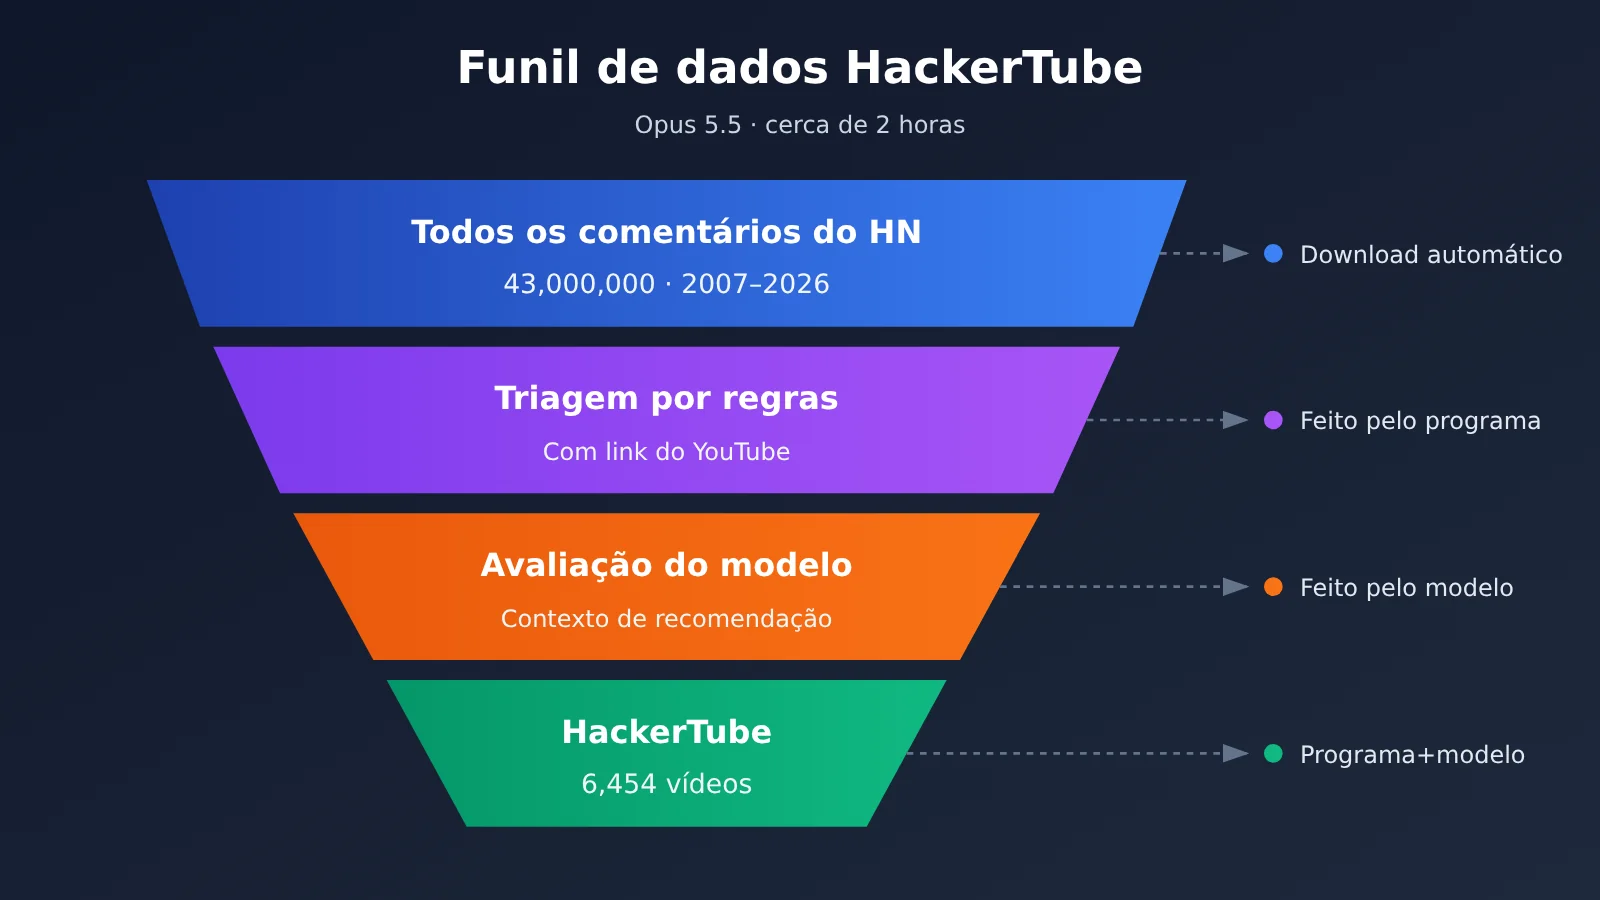
Andrej Karpathy passou cerca de duas horas em um fim de semana criando o HackerTube, um site de vídeos. Ele pediu ao Claude que analisasse cerca de 43 milhões de comentários publicados no Hacker News ao longo de 20 anos e selecionasse 6.454 vídeos do YouTube recomendados repetidas vezes. A maior parte do processo aconteceu por meio de conversas com o Claude. Nas palavras de Karpathy no X (01/11/2026): «~2 hours with Opus 5.5».
Com base na publicação original de Karpathy, no site do HackerTube e em relatos públicos da comunidade, vamos dividir o processo em 6 passos que qualquer desenvolvedor pode seguir e mostrar os 3 pontos em que é mais fácil encontrar dificuldades.
O que você vai encontrar: um fluxo de 6 passos que deixa claro o papel de pessoas, programas e modelos, uma estimativa de custos com as premissas identificadas e o caminho mais curto para acessar o Claude Code pela APIYI apiyi.com.
O que o HackerTube de Karpathy realmente fez
Em resumo: ele reuniu 20 anos de recomendações coletivas do tipo “você precisa assistir a este vídeo” da comunidade Hacker News (HN) em um site de vídeos que dá para explorar.
Esta foi a publicação completa de Karpathy no X (2026-11-01 18:14 UTC):
“Projeto de fim de semana: HackerTube. Eu estava incomodado com as recomendações do YouTube, então pedi ao Claude que filtrasse 43 milhões de comentários de 20 anos do HN e encontrasse 6.454 vídeos que continuam sendo recomendados. Uma experiência muito melhor para assistir a vídeos, ~2 horas com o Opus 5.5.”
A descrição do site hackertube.org diz: “Os vídeos do YouTube que os usuários do Hacker News vivem recomendando uns aos outros.” Ou seja, o foco não é um algoritmo de recomendação, mas uma filtragem semântica de discussões já existentes na comunidade.
| Ponto | Informação pública | Natureza da fonte |
|---|---|---|
| Volume de dados | Cerca de 43 milhões de comentários em 20 anos de HN; 6.454 vídeos selecionados | Publicação original de Karpathy (2026-11-01) |
| Tempo e modelo | Cerca de 2 horas, usando o Opus 5.5 | Publicação original de Karpathy (2026-11-01) |
| Ambiente de trabalho | Versão para desktop do Claude Code | Segundo relatos da comunidade |
| Ações manuais | Apenas três tarefas: solicitar uma chave API do YouTube, preparar o servidor e comprar o domínio | Segundo relatos da comunidade |
| Formato do site | Cerca de 150 temas, cobrindo o período de 2007 a 2026, sem necessidade de login | Segundo levantamento da comunidade |
Como o HackerTube funciona
Segundo relatos da comunidade, Karpathy disse: “Eu só converso com o Claude e peço que ele faça tudo.” Ou seja, tarefas como baixar os dados, escrever scripts de filtragem, invocar o modelo para avaliar os comentários e gerar as páginas foram feitas em grande parte pelo Claude no Claude Code. A pessoa ficou responsável principalmente por definir o que queria e cuidar das etapas que exigiam uma conta ou pagamento.
Isso é bem diferente de “a IA escreveu um modelo de página”. A parte realmente difícil está nos dados: não dá para colocar 43 milhões de comentários de uma vez no contexto, e o simples fato de um link aparecer não significa que ele foi recomendado. Por isso, o projeto se parece mais com um pipeline de dados acompanhado de um front-end bem enxuto.
Processo de 6 etapas para recriar o HackerTube com o Opus 5.5
A conclusão é simples: o segredo é primeiro deixar o programa reduzir o volume de dados e depois usar o modelo apenas para as decisões que exigem compreensão. As 6 etapas abaixo estão em ordem de execução, com o responsável e o critério de validação de cada uma.
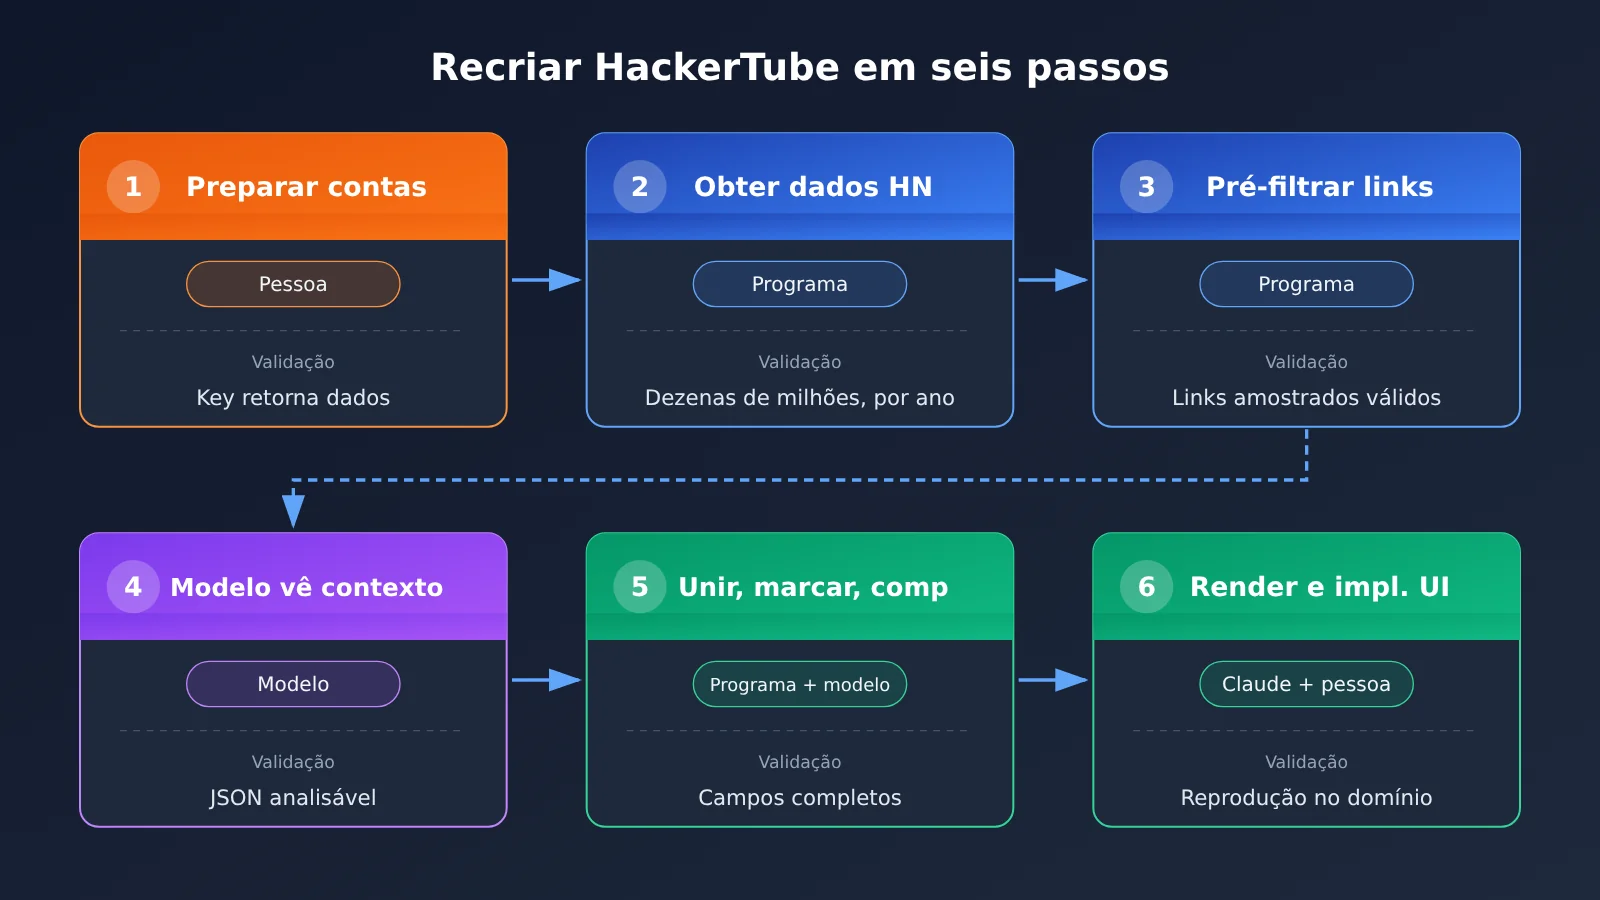
| Etapa | O que fazer | Quem faz | Como validar |
|---|---|---|---|
| 1 | Solicitar uma chave API do YouTube, preparar o servidor e comprar um domínio | Pessoa | É possível acessar os três, e a chave retorna informações de um vídeo |
| 2 | Coletar todos os comentários do HN | Programa (escrito pelo Claude) | Há arquivos locais separados por ano, com uma quantidade de registros na ordem de grandeza esperada |
| 3 | Extrair comentários com links do YouTube usando expressões regulares | Programa | Conferir uma amostra de 50 registros e confirmar que todos contêm links válidos para vídeos |
| 4 | Pedir ao modelo que avalie, em lotes, se o contexto é de recomendação e retorne JSON | Modelo | O JSON pode ser interpretado diretamente, e uma amostra é verificada manualmente |
| 5 | Agregar e contar por videoId, atribuir temas e complementar títulos e canais | Programa + modelo | Todos os vídeos têm campos completos e a quantidade de temas está dentro de um limite gerenciável |
| 6 | Gerar e publicar a página de frontend | Claude escreve o código; pessoa vincula o domínio | Ao abrir o domínio no navegador, é possível navegar por tema e reproduzir os vídeos |
Etapas 1-2: preparar os recursos e coletar dados do HN
A etapa 1 é feita por uma pessoa. Crie um projeto no console do Google Cloud, ative a YouTube Data API e gere uma chave API. O servidor pode ser qualquer hospedagem em nuvem ou serviço de hospedagem estática; o domínio pode ser comprado em um registrador para uso posterior. As três tarefas exigem uma conta ou pagamento e correspondem à parte que, segundo os relatos da comunidade, Karpathy cuidou pessoalmente.
Na etapa 2, Claude escreve o programa. Há duas fontes públicas de dados do HN: a API oficial do Firebase permite buscar itens individualmente pelo ID, enquanto o BigQuery oferece um conjunto de dados público do HN que pode ser consultado diretamente com SQL. Para baixar o conjunto completo, vale priorizar o BigQuery e exportar os dados por ano. Na validação, confira apenas dois pontos: se os arquivos foram separados por período e se o total de registros está na casa das dezenas de milhões.
Etapas 3-4: pré-filtragem por regras e avaliação semântica com Opus 5.5
A etapa 3 é fundamental para economizar e fica inteiramente por conta do programa. Use expressões regulares para identificar formatos de link como youtube.com/watch e youtu.be/, mantendo apenas comentários que contenham links de vídeo. Inclua também o ID e a data do comentário e o título do post original como contexto. Basta descrever o que você precisa no Claude Code, por exemplo: “Escreva um script que extraia os comentários com links do YouTube e os salve em JSONL”.
É só na etapa 4 que o modelo entra para avaliar os comentários. Envie alguns milhares de comentários por lote ao Opus 5.5 e peça que retorne apenas resultados estruturados, com os campos videoId, indicação de recomendação, tema e trecho de um comentário representativo. Deixe claro no comando que frases como “esse vídeo é muito ruim” e “não assista a isso” não contam como recomendações; apenas expressões como “vale a pena assistir” devem ser consideradas. Para validar, selecione uma amostra aleatória dos resultados e confira manualmente se a taxa de erro é aceitável.
Etapas 5 e 6: agregação, classificação e implantação do frontend
Na etapa 5, use primeiro regras e depois o modelo. O programa contabiliza o número de recomendações por videoId e chama a YouTube Data API para obter os títulos e canais. O modelo fica responsável por consolidar as tags de tema, evitando uma fragmentação excessiva com rótulos como “aprendizado de máquina”, “ML” e “introdução ao aprendizado profundo”. Segundo dados da comunidade, o HackerTube acabou com cerca de 150 temas, um nível de detalhamento que pode servir de referência.
Na etapa 6, separe os dados da página. O resultado final é um arquivo de dados JSON e um frontend estático que o lê. Os vídeos são incorporados com iframes do YouTube e ordenados por tema e popularidade. Quando os dados forem atualizados, basta gerar o JSON novamente, sem alterar o código da página. A implantação pode ser feita em um serviço de hospedagem estática ou no seu servidor; por fim, uma pessoa configura o apontamento do domínio.
🚀 Comece rapidamente: as etapas 4 e 5 exigem chamadas frequentes ao modelo. Ao conectar o Claude Code pela APIYI apiyi.com, você pode usar a mesma chave para alternar entre Opus e Sonnet. Primeiro, teste o fluxo com um pequeno lote de dados e depois decida qual modelo usar no processamento completo.
Três armadilhas que podem travar a recriação do HackerTube
Indo direto ao ponto: os maiores obstáculos estão nos dados, não na criação da página. As três armadilhas abaixo estão na ordem em que aparecem no processo.
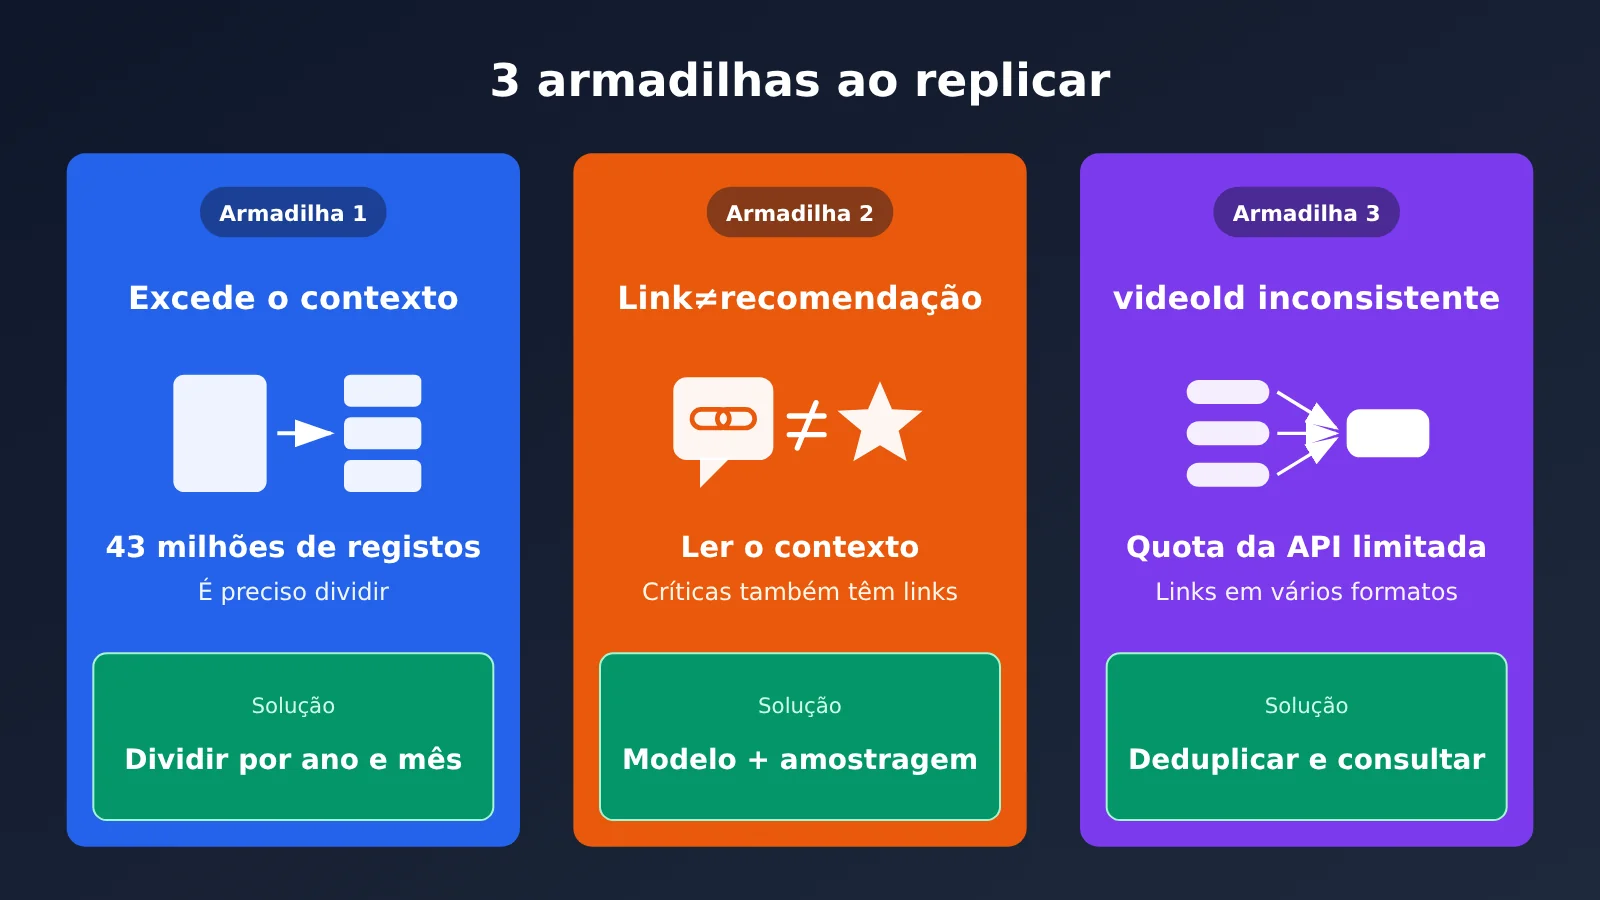
| Armadilha | Manifestação típica | Solução |
|---|---|---|
| O contexto não comporta tudo | Pedir ao modelo para “ler todos os comentários” gera um erro de limite excedido ou uma resposta truncada | Dividir por ano e mês, com alguns milhares por lote, e retornar apenas JSON estruturado |
| Link ≠ recomendação | Links em críticas, ironias e correções são tratados como recomendações | Pedir ao modelo que avalie o contexto do comentário e verificar amostras manualmente |
| IDs inconsistentes e cota | O mesmo vídeo aparece em diferentes formatos de link; vídeos são removidos; a cota da API se esgota | Padronizar o videoId antes de agregar os resultados e consultar metadados apenas dos IDs sem duplicatas |
Armadilha 1: o contexto do Opus 5.5 não comporta 43 milhões de comentários
Um erro comum de quem está começando é pedir diretamente: “Leia todos os comentários do HN e encontre os vídeos recomendados”. Não importa o tamanho da janela de contexto do modelo: ela não comporta de uma vez um texto com mais de um bilhão de tokens. O caminho é pedir ao Claude que escreva um script de divisão por ano ou mês, com alguns milhares de comentários por lote, e exigir que o modelo retorne apenas JSON, sem explicações.
Também é importante criar um mecanismo para retomar o processamento de onde ele parou: salve o resultado de cada lote separadamente e registre os números dos lotes já processados. Se ocorrer um erro no meio do caminho, basta executar novamente os lotes que falharam, sem começar do zero.
Armadilha 2: um link do YouTube não é necessariamente uma recomendação
Um link do YouTube em um comentário do HN pode ser uma recomendação, mas também pode aparecer como contraexemplo, crítica ou em algo como “esse vídeo explica isso errado”. Identificar apenas as URLs acrescenta muito ruído ao resultado. Nessa etapa, é preciso que o modelo leia o contexto: é aqui que o uso de um Modelo de Linguagem Grande realmente faz diferença no processo.
Vale incluir exemplos positivos e negativos no comando e pedir que cada classificação venha acompanhada de um trecho que a justifique. Assim, na verificação manual por amostragem, fica mais fácil entender por que o modelo fez aquela classificação. O frontend também pode usar esse trecho diretamente como “O que o HN diz” no cartão do vídeo.
Armadilha 3: videoId inconsistente e cota da API do YouTube
O mesmo vídeo pode aparecer como youtube.com/watch?v=, youtu.be/, um link para dispositivos móveis ou um link com parâmetro de tempo, entre outros formatos. Se os links não forem padronizados primeiro em um videoId de 11 caracteres, as recomendações de um mesmo vídeo ficarão espalhadas, distorcendo a ordenação. Além disso, ao longo de 20 anos, muitos vídeos foram removidos ou definidos como privados e precisam ser marcados e filtrados separadamente.
A YouTube Data API tem uma cota diária. Por isso, elimine as duplicatas antes de consultar os metadados em lote, em vez de fazer uma consulta para cada comentário. A interface de consulta em lote permite buscar vários IDs de uma vez, reduzindo bastante o consumo.
Quanto custa reproduzir o HackerTube (estimativa)
Direto ao ponto: processar tudo com o Opus 5.5 custaria alguns milhares de dólares; com uma pré-triagem por regras, o custo pode cair para dezenas ou centenas de dólares. Todos os valores abaixo são estimativas, não cobranças reais.
Primeiro, os preços unitários. A tabela abaixo vem da tabela de preços dos modelos da APIYI, com dados de 2026-10-27 14:50 (UTC+8), em dólares por milhão de tokens.
| Modelo | Entrada | Saída | Leitura de cache | Plataformas disponíveis |
|---|---|---|---|---|
| opus-5-5 | $4 | $20 | $0.2 | APIYI apiyi.com, API oficial |
| sonnet-5-5 | $2 | $10 | $0.1 | APIYI apiyi.com, API oficial |
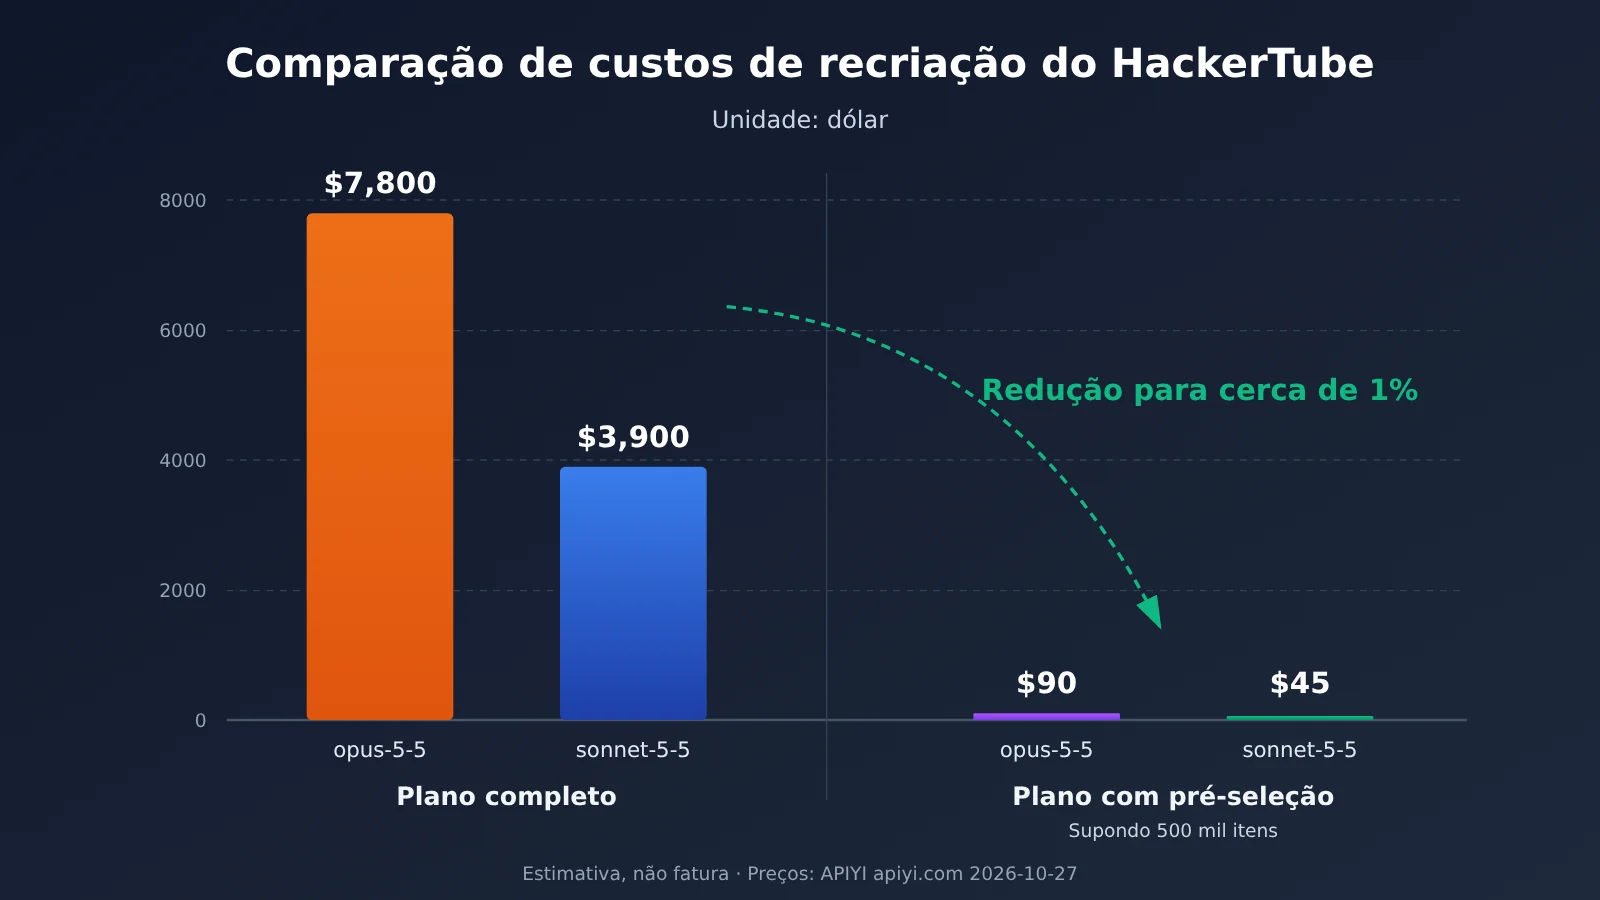
Premissas da estimativa: 43 milhões de comentários, com média de 30 tokens cada, totalizando cerca de 1,3 bilhão de tokens; cada lote tem 50 mil tokens de entrada e 5 mil de saída, num total de aproximadamente 26 mil lotes. Os «500 mil comentários restantes» no cenário de pré-triagem são apenas uma hipótese para demonstrar o cálculo, não uma estatística real do HN. Você só saberá a quantidade efetiva depois de executar a etapa 3.
| Abordagem | Tokens de entrada | Tokens de saída | Estimativa com opus-5-5 | Estimativa com sonnet-5-5 |
|---|---|---|---|---|
| Enviar tudo diretamente ao modelo | Cerca de 1,3 bilhão | Cerca de 130 milhões | Cerca de $5,200 + $2,600 ≈ $7,800 | Cerca de $2,600 + $1,300 ≈ $3,900 |
| Fazer uma pré-triagem por regras (supondo que restem 500 mil comentários) | Cerca de 15 milhões | Cerca de 1,5 milhão | Cerca de $60 + $30 ≈ $90 | Cerca de $30 + $15 ≈ $45 |
Como a tabela mostra, a pré-triagem por regras da etapa 3 determina a ordem de grandeza do custo do projeto. Além disso, o comando de sistema e os exemplos positivos e negativos se repetem em cada lote de requisições. Com o preço de leitura de cache, essa parte do custo pode cair ainda mais. Há também uma referência na comunidade: o usuário @thisiskp_ do X disse ter criado uma demonstração de um site de vídeos do Show HN com o Opus 5.5 em cerca de 19 minutos, por aproximadamente 2 dólares. É apenas um caso isolado, com escala e volume de dados diferentes, então não dá para compará-lo diretamente.
💰 Dica de custo: antes de processar todos os dados, teste o fluxo com dados de um mês e registre o consumo real de tokens. Depois, multiplique pelo número de meses para estimar o total. Na APIYI apiyi.com, a cobrança é por uso, sem mensalidade fixa, o que combina com essa abordagem de «testar um lote pequeno antes de decidir a escala».
Como conectar o Claude Code à APIYI para executar o fluxo do HackerTube
Em resumo: basta configurar duas variáveis de ambiente para que o Claude Code acesse o Opus 5.5 pela APIYI. Com a mesma chave, você pode alternar entre opus-5-5 e sonnet-5-5.
[Espaço para captura de tela: documentação de integração do Claude Code com a APIYI]
Seguindo a documentação de integração do Claude Code com a APIYI (docs.apiyi.com/scenarios/programming/claude-code), configure estas duas variáveis no terminal:
ANTHROPIC_BASE_URL=https://api.apiyi.comANTHROPIC_AUTH_TOKEN=<你的 APIYI Key>
Depois, inicie o Claude Code e selecione opus-5-5 ou sonnet-5-5 nas opções de modelo. Na prática, você pode usar um modelo mais potente para planejar e um mais econômico para executar:
- Use opus-5-5 para planejar e escrever código: peça a ele que desenhe a estratégia de divisão em lotes, escreva os scripts de coleta e pré-seleção e gere o front-end. Essa etapa consome poucos tokens, mas exige alta qualidade.
- Compare os dois modelos na avaliação em lote: execute opus-5-5 e sonnet-5-5 sobre a mesma amostra de algumas centenas de itens. Compare manualmente a precisão das avaliações e decida qual usar nos 26 mil lotes ou nos lotes que restarem após a pré-seleção.
- Volte ao opus-5-5 para agrupar os temas: agrupar cerca de 150 temas exige uma visão geral, mas poucas invocações. Por isso, é mais seguro usar o modelo mais potente.
🎯 Dica técnica: depois de criar uma chave no console da APIYI, em apiyi.com, você pode definir um limite de gastos específico para o projeto. Assim, evita custos fora de controle caso o script de processamento em lote entre em um ciclo de chamadas. O crédito gratuito para novos usuários é suficiente para processar uma amostra de dados de um mês.
Em quais outros dados é possível usar o método HackerTube de Karpathy?
Conclusão direta: sempre que houver recomendações de algum tipo de recurso em meio a muitas discussões de uma comunidade, dá para aplicar o mesmo pipeline.
- Comunidades de tecnologia no Reddit: filtre livros, cursos ou repositórios de código aberto recomendados várias vezes. A estrutura do pipeline é praticamente a mesma; basta trocar a expressão regular dos links.
- Issues e discussões no GitHub: extraia links de artigos de blog ou soluções citados várias vezes e organize uma “lista de leitura essencial” para um projeto.
- Mensagens internas ou comentários em documentos da equipe: equipes de conteúdo podem encontrar materiais de referência que colegas compartilharam repetidamente em discussões antigas, desde que confirmem a permissão para usar os dados.
- Recomendações de podcasts e artigos acadêmicos: troque a expressão regular dos links pelo formato do arXiv ou de plataformas de podcast para encontrar os “artigos / episódios que a comunidade realmente recomenda”.
Ao adaptar o método, só é preciso ajustar dois pontos: as regras de pré-filtragem da etapa 3 e os exemplos positivos e negativos no comando da etapa 4. O pipeline de dados, as chamadas em lotes, a estrutura JSON e o frontend estático podem ser reaproveitados.
Perguntas frequentes (FAQ)
Q1: Dá para criar um site como o HackerTube sem uma chave API do YouTube?
Dá para criar a parte principal. O videoId é extraído dos links nos comentários, e a reprodução usa um iframe incorporado. Nenhum dos dois depende de uma chave API; o que fica faltando são metadados como título e canal. Para começar, você pode usar o contexto dos comentários do HN para que o modelo gere descrições e adicionar a chave depois.
Q2: Como obter os dados de comentários do Hacker News?
Há duas opções: a API oficial do HN no Firebase (github.com/HackerNews/API) permite buscar dados por ID de item e é adequada para atualizações incrementais; o conjunto de dados público do HN no BigQuery é adequado para uma exportação completa de uma só vez. Para reproduzir o projeto com todos os dados, a segunda opção é a mais indicada.
Q3: Por que não criar um algoritmo de recomendação diretamente?
O ponto de partida da publicação original de Karpathy foi justamente sua insatisfação com as recomendações do YouTube. O HackerTube usa o julgamento coletivo da comunidade ao longo de 20 anos, não precisa de dados de comportamento dos usuários, não tem problema de partida a frio e pode ser concluído em duas horas. Já um algoritmo de recomendação exige acúmulo de dados a longo prazo e ajustes contínuos.
Q4: O projeto foi concluído em “2 horas” de forma totalmente automática?
Não totalmente. Segundo relatos da comunidade, Karpathy solicitou manualmente uma chave API do YouTube, preparou o servidor e comprou o domínio. O restante foi feito por meio de conversas com Claude. A pessoa ainda é responsável por definir os requisitos, validar os resultados e cuidar das etapas que exigem contas. Quem quiser reproduzir o projeto também deve reservar tempo para ajustar os comandos e fazer verificações manuais por amostragem.
Q5: O custo desse método pode sair do controle?
Se você pular a pré-filtragem e enviar todos os dados diretamente ao modelo, a estimativa pode chegar a milhares de dólares, então o custo pode realmente sair do controle. Há três maneiras de controlá-lo: primeiro, faça uma pré-filtragem por regras; depois, rode uma amostra de um mês para estimar o custo; por fim, defina um limite para a chave na APIYI apiyi.com. Consulte a lista de modelos da plataforma para verificar os modelos e preços.
Resumo
O HackerTube de Karpathy mostra que, com Claude Code e Opus 5.5, uma pessoa pode transformar dezenas de milhões de discussões de uma comunidade em um produto utilizável durante um fim de semana. Mas o que realmente fez a diferença foi o design do pipeline de dados, não a ideia de que “a IA cria sites automaticamente”.
- Fluxo: preparação dos recursos → coleta de dados → pré-seleção por regras → avaliação pelo modelo → agregação e classificação → deploy, com responsabilidades bem definidas para pessoas, programas e modelos.
- Desafios: divisão do contexto em trechos, avaliação do contexto das recomendações, normalização de videoId e cotas da API.
- Custo: o processamento completo fica na casa dos milhares de dólares; com pré-seleção, pode cair para dezenas ou centenas de dólares. Nos dois casos, use os dados obtidos com sua própria amostra para estimar o custo.
- Primeiros passos: basta configurar duas variáveis de ambiente para que o Claude Code acesse opus-5-5 e sonnet-5-5 por meio da APIYI.
Se quiser aplicar esse método aos seus próprios dados, comece com uma pequena amostra de um mês e use os créditos gratuitos da APIYI em apiyi.com para testar todo o fluxo antes de decidir a escala definitiva.
Referências
- Publicação original de Karpathy (2026-11-01): anúncio de lançamento do HackerTube
- Link:
x.com/karpathy/status/2116957135661945283 -
Descrição: fonte primária sobre o volume de dados, o tempo gasto e os modelos usados
-
Site do HackerTube: produto final
- Link:
hackertube.org -
Descrição: permite explorar as categorias de temas e o formato das páginas
-
Documentação de integração da APIYI com Claude Code: configuração das variáveis de ambiente
- Link:
docs.apiyi.com/scenarios/programming/claude-code -
Descrição: etapas para integrar o Claude Code
-
Tabela completa de preços dos modelos da APIYI: preços por modelo
- Link:
docs.apiyi.com/models -
Descrição: consulte a tabela para conferir os modelos e preços atualizados
-
Documentação oficial da API do Hacker News: obtenção de dados
- Link:
github.com/HackerNews/API - Descrição: estrutura dos itens e métodos de coleta