Nota do autor: este artigo explica os mecanismos centrais da arquitetura orientada a eventos do DeepSeek Super-agent, distinguindo os recursos já disponíveis no protótipo de código aberto, os casos internos da DeepSeek e as propostas para a arquitetura futura. Também discute o valor para produtos e as escolhas de engenharia envolvidas em agentes proativos.
Imagine um grupo de conversa de uma equipe de desenvolvimento. Alguém comenta de passagem: “A página de login não abre de novo no Safari”. Ninguém menciona o bot com @, nem cria uma Issue. Algum tempo depois, o grupo recebe uma notificação breve: o problema foi reproduzido, a causa identificada e um PR com a correção está pronto para revisão. Segundo o artigo técnico oficial da DeepSeek, essa estratégia de “reproduzir e corrigir silenciosamente” já é usada em um grupo interno do DeepSeek Harness.
Esta não é uma história sobre “a IA começar a agir por conta própria”. A principal mudança trazida pelo DeepSeek Super-agent é que o sistema consegue acompanhar eventos externos continuamente e, com permissões e regras bem definidas, identificar tarefas, preparar o trabalho com antecedência e entregar resultados no momento certo. O controle de permissões e a execução proativa foram projetados em conjunto: um não funciona sem o outro.
O que você vai aprender: neste artigo, você conhecerá os 5 mecanismos fundamentais da arquitetura orientada a eventos do Super-agent, entenderá quais já foram implementados no protótipo de código aberto e quais são apenas casos internos ou propostas de arquitetura. Também verá como aproveitar essas ideias para projetar agentes proativos controlados e que não interrompam o usuário desnecessariamente.
DeepSeek Super-agent: principais informações
Antes de entrar nos detalhes, esta tabela reúne as informações públicas sobre o Super-agent. É importante distinguir o que já foi implementado do que ainda é apenas uma proposta: essa diferença é fundamental para entender o projeto.
| Item | Detalhes | Status |
|---|---|---|
| Objetivo do projeto | Explorar uma arquitetura orientada a eventos que permita a um agente passar de respostas passivas para uma atuação proativa | Artigo técnico oficial e documentação do protótipo de código aberto |
| Fontes de eventos (Trigger) | Mensagens instantâneas, GitHub Issues, comentários em PRs, revisão de código, CI, e-mail, agenda e eventos de colaboração em projetos | O protótipo público oferece suporte principalmente ao GitHub, com integração opcional ao Feishu; e-mail e calendário fazem parte de uma visão mais ampla da arquitetura |
| Modos de aceitação de tarefas | off, observe, auto |
Documentados na seção de autorização do projeto de código aberto; o padrão é observe |
| Mecanismo de autorização | Mandate, que registra a origem da tarefa, o nível de autorização, o escopo e a versão da política | Documentado na seção de autorização do projeto de código aberto |
| Tarefas assíncronas | Após o início da tarefa, retorna Started e executa em segundo plano sem bloquear a interação | Implementado no DeepSeek Harness, mas ainda não habilitado por padrão |
| Caso interno | “Reproduzir e corrigir silenciosamente” um bug em um chat em grupo | Caso de uso interno da DeepSeek, sem verificação independente de terceiros |
| Evidência da comunidade | Em 1º de novembro de 2026, um usuário relatou que concluiu o fluxo de Issue → PR | Ocorreram vários problemas de configuração durante a implantação |
O que é a arquitetura orientada a eventos do DeepSeek Super-agent
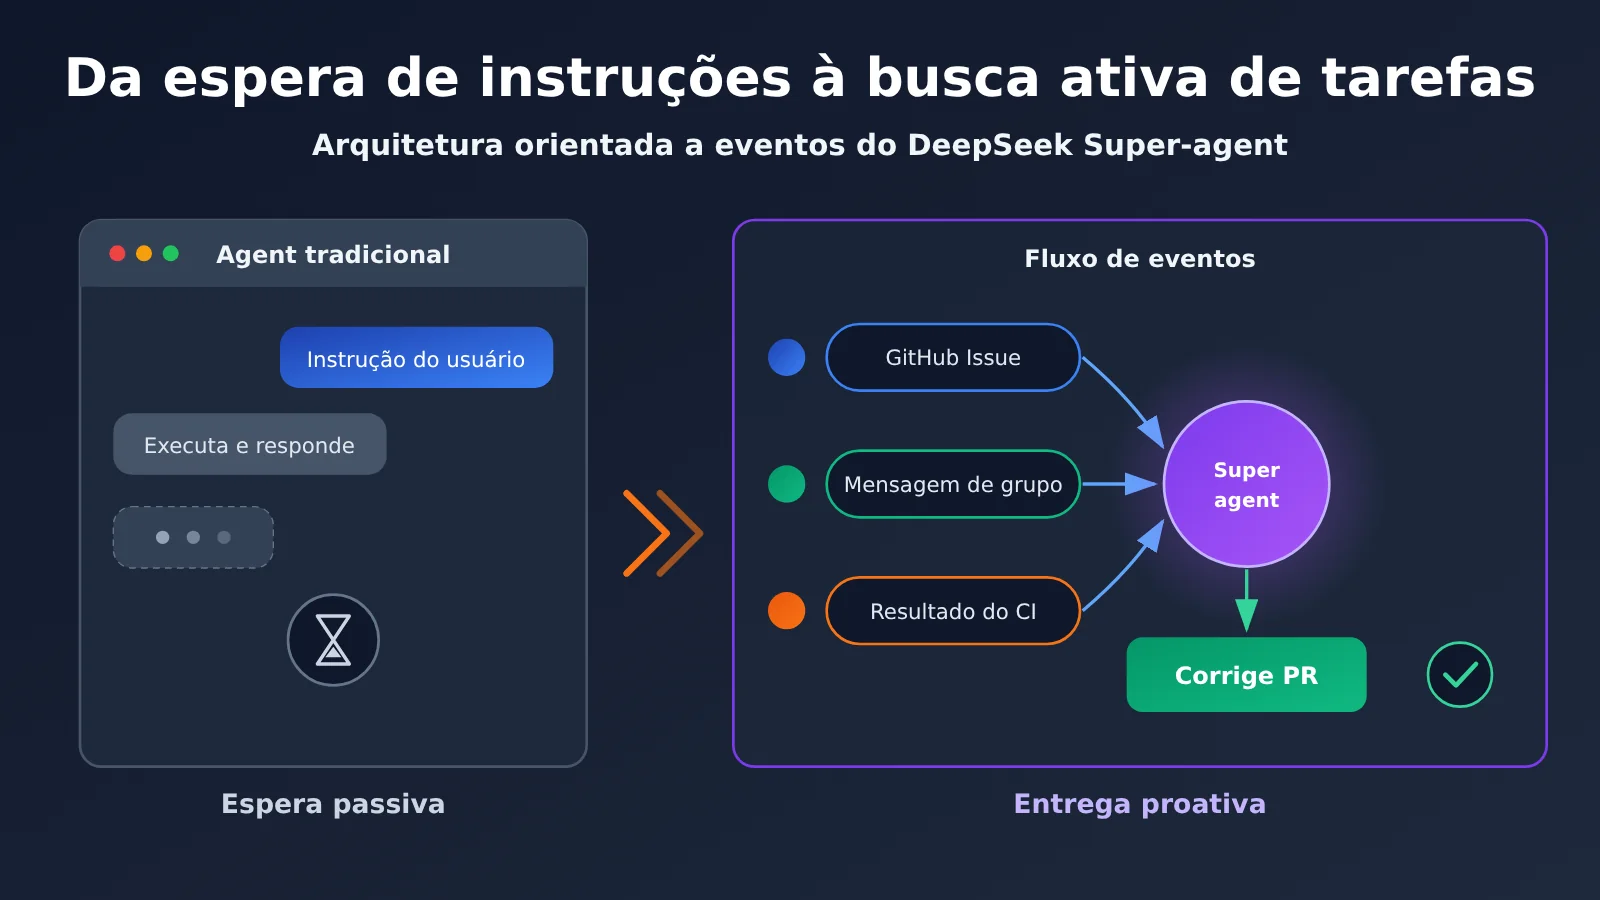
Um Agent de chat tradicional funciona em um ciclo fechado: o usuário dá uma instrução, o Agent executa, retorna o resultado e espera a próxima instrução. Por mais inteligente que seja o Agent, seu trabalho sempre começa com uma conversa iniciada pelo usuário. Cabe à pessoa identificar o problema, descrevê-lo com clareza e lembrar de voltar para conferir o resultado.
A proposta do DeepSeek Super-agent é inverter esse fluxo. O sistema recebe continuamente eventos do ambiente, avalia se há algo que vale a pena resolver, cria tarefas conforme as autorizações concedidas, executa o trabalho em segundo plano e notifica a pessoa no momento adequado. Em outras palavras, o próprio ambiente de trabalho passa a fornecer entradas para o Agent, e a janela de chat deixa de ser a única porta de entrada.
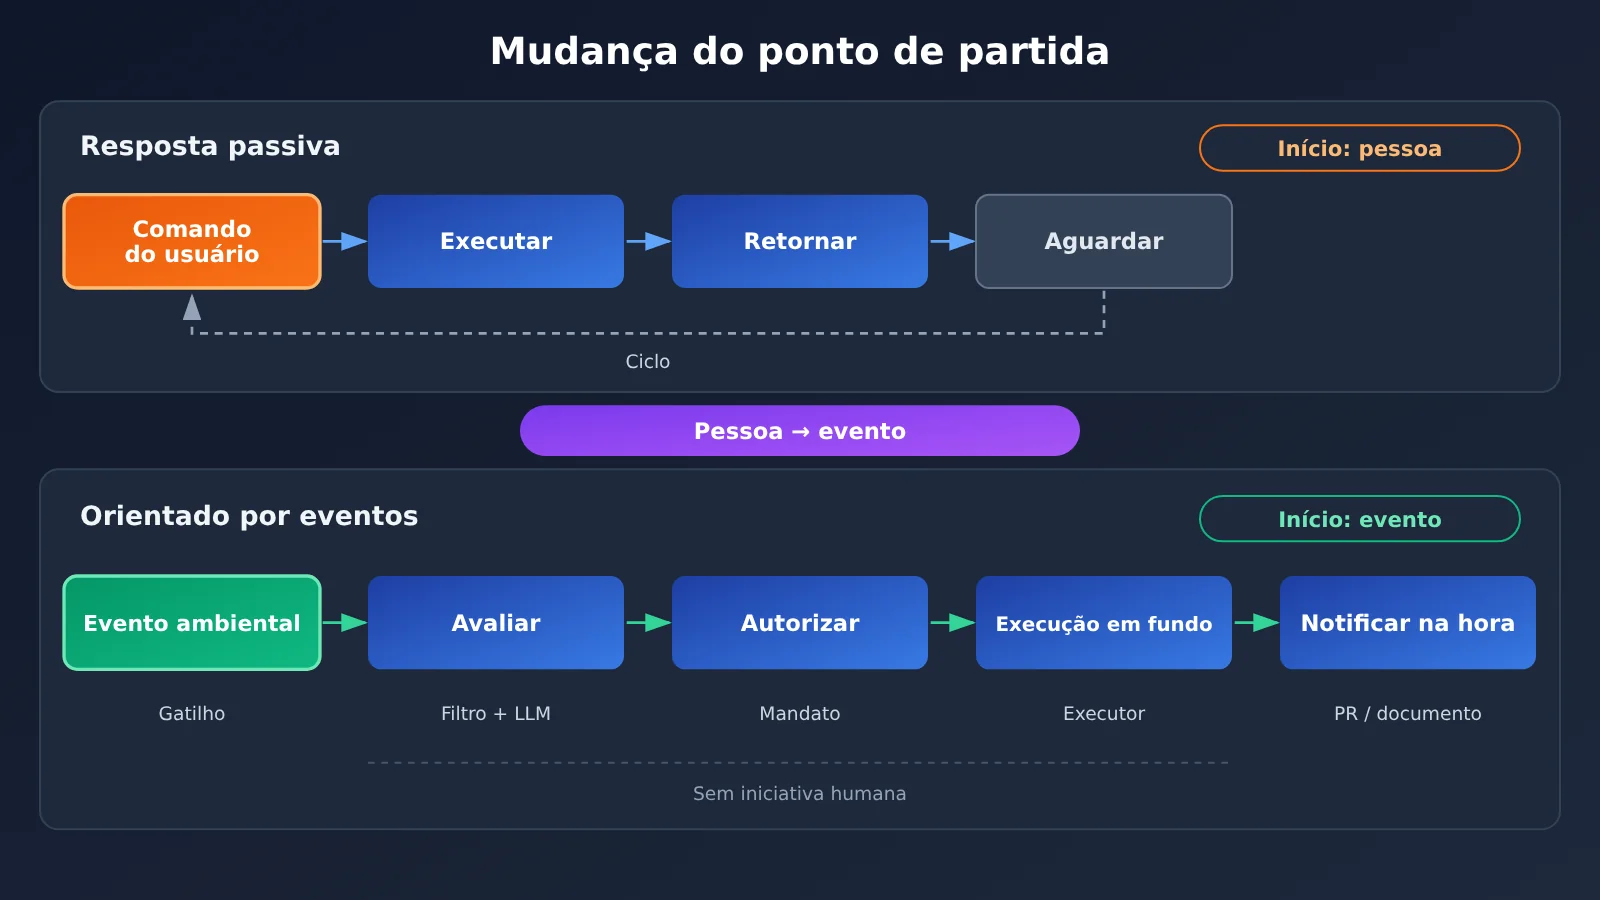
| Dimensão | Agent de resposta passiva | Super-agent orientado a eventos |
|---|---|---|
| Ponto de partida | O usuário inicia uma conversa | Evento do ambiente externo (Trigger) |
| Identificação de tarefas | A pessoa identifica e descreve o problema | O sistema identifica indícios de tarefas; a pessoa autoriza e valida o resultado |
| Execução | Geralmente síncrona, com espera pelo resultado | Assíncrona, em segundo plano, com possibilidade de preparação especulativa |
| Entrega | Resultado apresentado gradualmente na conversa | Notificação concisa ou entrega estruturada (PR, documento) |
| Controle | Cada etapa depende de uma instrução do usuário | Modo de aceitação de tarefas, escopo de autorização do Mandate e regras de aprovação |
| Principais riscos | Alta carga de gerenciamento manual | Acionamentos indevidos, avalanche de tarefas, extrapolação de permissões e ataques de injeção |
O papel do Trigger no Super-agent
A DeepSeek chama os eventos do ambiente externo de Trigger. Uma mensagem em um chat de grupo, uma nova Issue ou uma falha em um build de CI podem ser Triggers. O ponto importante é que um Trigger é apenas um “indício”, não uma “tarefa”. O que realmente determina se haverá alguma ação são as etapas seguintes de filtragem, avaliação e autorização.
Como o Super-agent filtra eventos: Gate programático e LLM Assessment
Ambientes de trabalho reais geram muito ruído. Um grupo de desenvolvedores pode acumular, todos os dias, muitas conversas informais, emojis e mensagens repetidas. Se cada uma delas for enviada a um Modelo de Linguagem Grande para avaliação, os custos com tokens e a latência de resposta vão subir rapidamente. A solução da DeepSeek é uma filtragem em dois níveis: primeiro, regras determinísticas e baratas descartam a grande maioria dos eventos irrelevantes; depois, um pequeno número de candidatos é enviado ao modelo para avaliação semântica.
| Nível de filtragem | Critérios de avaliação | Invoca o Modelo de Linguagem Grande? | Principal função |
|---|---|---|---|
| Primeiro nível: Gate programático | Origem do evento, autorização do usuário, pertencimento a um grupo ou repositório monitorado, menção explícita ao Agent e inclusão no escopo de eventos configurado | Evita a invocação sempre que possível | Bloquear eventos irrelevantes e não autorizados com baixo custo |
| Segundo nível: LLM Assessment | Conteúdo semântico e contexto dos eventos candidatos | Sim | Avaliar se há trabalho que vale a pena executar, como investigar indícios de uma falha |
Veja o exemplo: “A página de login parou de abrir no Safari de novo”. Se a mensagem vier de uma discussão autorizada sobre o projeto, o modelo pode identificá-la como um indício de falha. Se for apenas uma conversa sem relação com o trabalho, o sistema pode não fazer nada. Essa estrutura combina regras de baixo custo com compreensão semântica mais cara — um ponto essencial para controlar os custos de um Agent orientado a eventos.
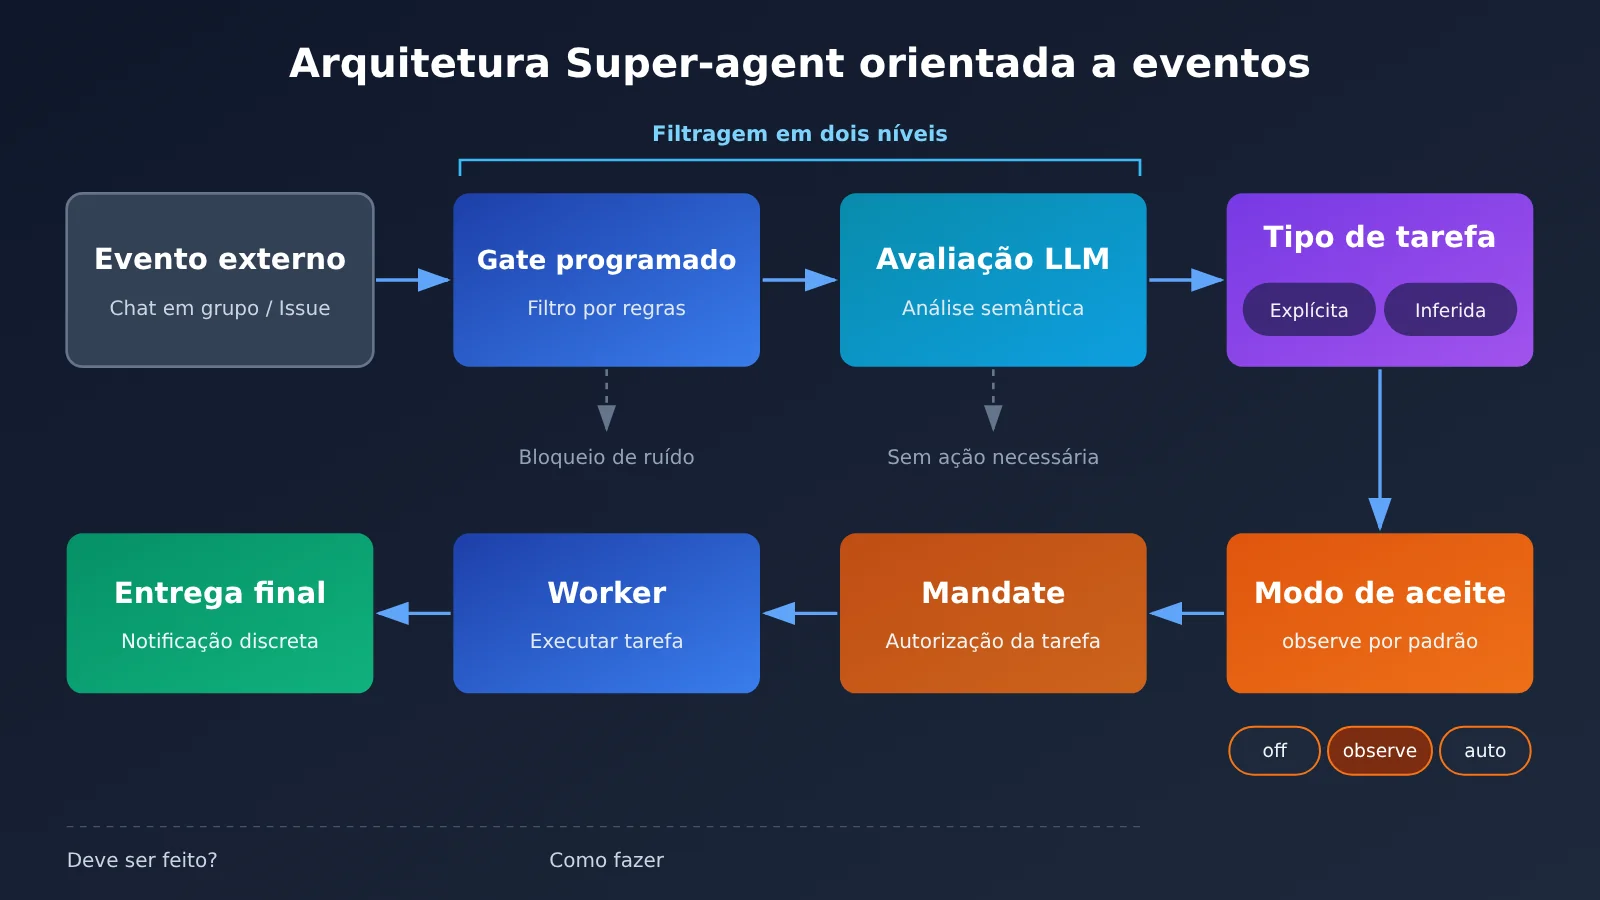
No diagrama acima, tanto a avaliação semântica quanto a execução de tarefas dependem de APIs de modelos. Ao reproduzir uma arquitetura semelhante, desenvolvedores podem usar interfaces compatíveis com OpenAI, como a APIYI em apiyi.com, para acessar diferentes modelos de forma unificada e facilitar a configuração e a comparação por camada.
Explicit e Inferred: a diferença entre solicitações explícitas e tarefas inferidas
A documentação oficial de autorização do DeepSeek divide as tarefas em duas categorias. Explicit são solicitações com autorização explícita, como quando uma pessoa desenvolvedora autorizada pede diretamente ao Agent para corrigir um bug em uma issue. Inferred são tarefas inferidas, como quando alguém comenta em uma discussão que “o build às vezes falha”, sem pedir formalmente uma correção, mas o sistema identifica ali um indício que vale investigar.
O ponto mais importante é: inferir uma tarefa não significa ter permissão para executá-la. As tarefas Inferred ainda precisam respeitar as regras de admissão da organização, o escopo de execução e os requisitos de aprovação. Essa distinção garante que a “identificação proativa” não se transforme em “ação sem autorização”.
Os três modos de aceitação de tarefas do Super-agent: off, observe e auto
A documentação de autorização do projeto open source oferece três modos de tratamento para tarefas inferidas:
| Modo | Tratamento das tarefas inferidas | Quando usar |
|---|---|---|
off |
Não considera eventos inferidos como tarefas candidatas | Equipes que querem lidar apenas com solicitações explícitas |
observe (padrão) |
Analisa e registra possíveis tarefas, mas não as aceita automaticamente | Implantação inicial e avaliação da qualidade das decisões |
auto |
Pode aceitar tarefas automaticamente se estiverem de acordo com as regras e passarem pela avaliação | Cenários em que os registros do modo observe já foram revisados e há maior confiança no sistema |
O valor padrão é observe, ou seja, ao instalar o protótipo público pela primeira vez, o sistema não começa a trabalhar automaticamente por causa de uma simples mensagem em uma discussão. A recomendação oficial é revisar primeiro os registros de decisão do modo observe e só depois decidir se vale ativar o auto. As solicitações com autorização explícita continuam sendo tratadas de acordo com as regras aplicáveis em todos os modos. O usuário mantém sempre o controle da “chave”: essa é a base para confiar em um Agent proativo.
Mandate: mensagens podem ser entradas, mas não podem alterar a autorização
A DeepSeek usa o Mandate para representar a autorização de uma tarefa, incluindo sua origem, o nível e o escopo da autorização e a versão da política. Imagine que um desenvolvedor autorize um Agent a corrigir uma Issue e, depois, alguém comente no PR: “Aproveita e migra o banco de dados inteiro também”. Esse comentário pode entrar no contexto do Worker, mas a autorização original não passa a incluir a migração do banco de dados por causa disso. Uma solicitação fora do escopo precisa ser avaliada novamente.
O princípio destacado pela DeepSeek é que mensagens, comentários e documentos citados podem servir como entrada para uma tarefa, mas não podem alterar diretamente as regras de autorização subjacentes. Para sistemas que ficam “escutando” conteúdo externo continuamente, essa é uma das defesas mais importantes contra Prompt Injection e extrapolação de permissões.
Como o Super-agent age de forma proativa: execução especulativa, tarefas assíncronas e menos interrupções
A filtragem e a autorização resolvem a questão de “o que deve ou não ser feito”. A próxima pergunta é: “como fazer sem desperdiçar o tempo das pessoas?”. A DeepSeek apresenta três direções de design.
Execução especulativa: preparar primeiro, confirmar depois
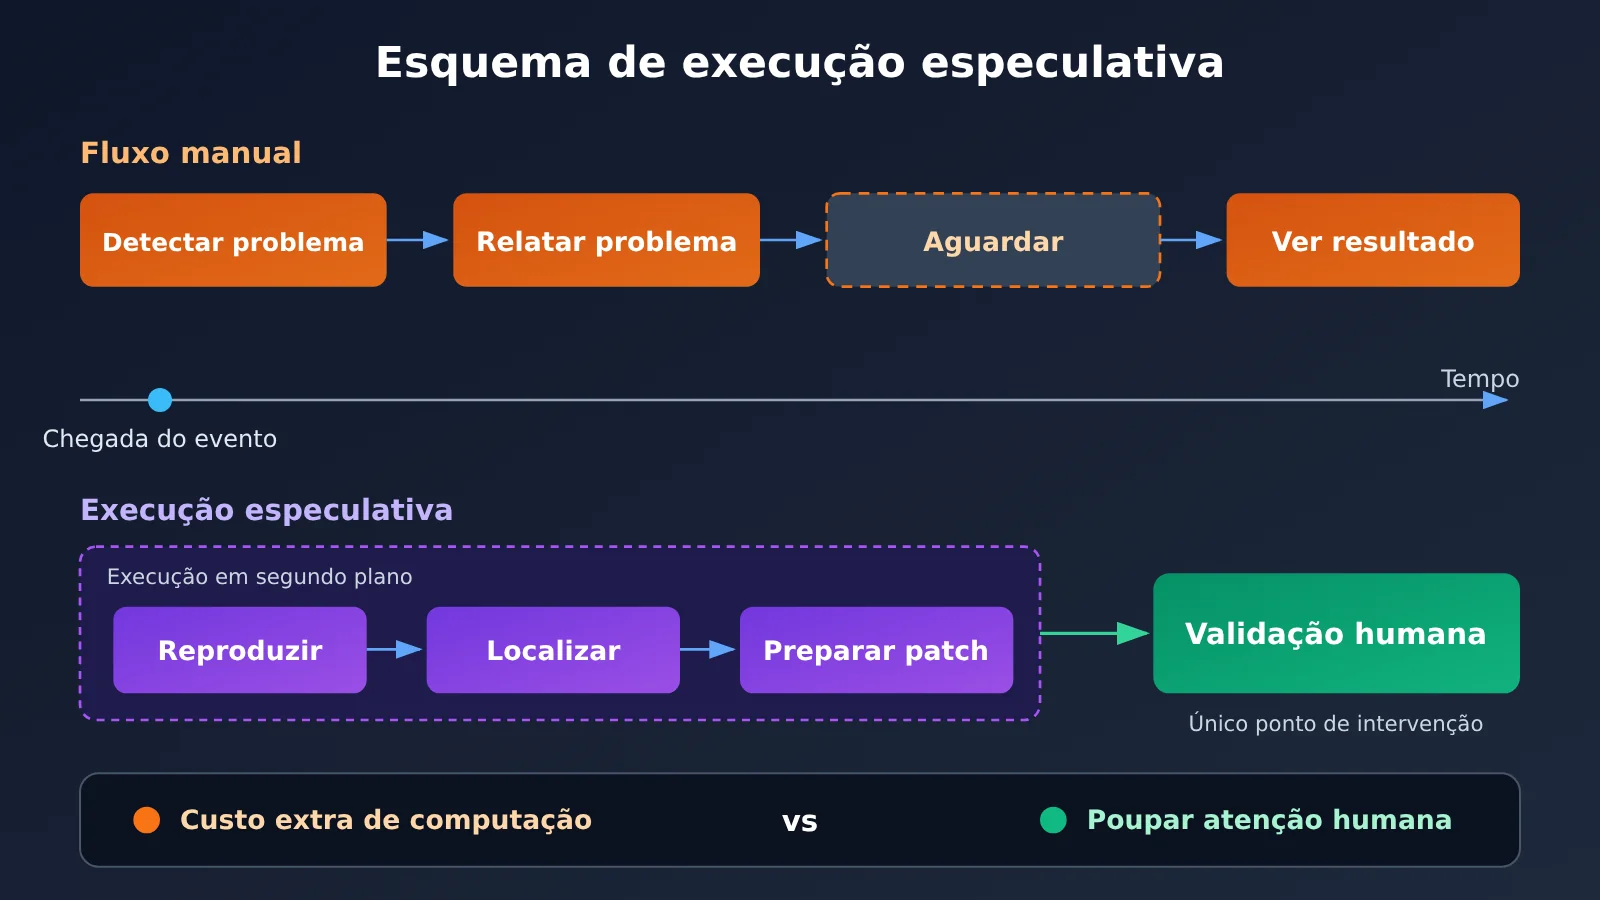
A DeepSeek aproveita o conceito de Speculative Execution, ou execução especulativa, da arquitetura de computadores: começar antecipadamente preparativos de baixo risco, mesmo sem saber se o resultado será aproveitado.
- Cenário de assistente pessoal: ao receber um convite para uma reunião, o Agent pode verificar a agenda, reunir informações sobre a reunião, identificar conflitos de horário e rascunhar uma resposta. O envio do e-mail, porém, ainda pode depender da confirmação do usuário.
- Cenário de desenvolvimento: enquanto a equipe discute um Bug, o Agent pode verificar logs, tentar reproduzi-lo, localizar o código e preparar um patch candidato, para só então entregar o resultado, respeitando as regras de autorização.
O custo desse mecanismo é a possibilidade de gastar recursos computacionais em um trabalho que não será aproveitado. Na avaliação da DeepSeek, a execução especulativa só vale a pena quando a economia no tempo de espera e no esforço das pessoas supera o gasto computacional adicional. É uma decisão de engenharia: nem toda tarefa merece ser executada antecipadamente.
ReAct Loop assíncrono: tarefas em segundo plano sem bloquear a interação
Na execução síncrona tradicional, depois que o Agent inicia um comando demorado, ele precisa esperar o retorno da ferramenta para processar novas mensagens. Na arquitetura assíncrona proposta pela DeepSeek, o sistema retorna imediatamente o status Started após iniciar a tarefa. A execução em segundo plano não bloqueia as interações seguintes, e o resultado volta ao sistema como um novo evento. Enquanto a tarefa roda, o usuário pode fazer outras perguntas, e o sistema também pode interromper trabalhos em segundo plano que não sejam mais necessários.
É importante observar o limite: segundo a DeepSeek, esse mecanismo de tarefas assíncronas já foi implementado no DeepSeek Harness, mas ainda não está ativado por padrão. O protótipo público tem seu próprio mecanismo de Workers em segundo plano, mas a arquitetura assíncrona completa não deve ser tratada como uma funcionalidade padrão.
Menos interrupções: proatividade não é chamar atenção
O documento de filosofia de produto da DeepSeek propõe reduzir ao máximo o consumo de atenção humana, gerando o máximo possível de valor. Na prática, isso significa não relatar cada chamada de ferramenta, não inundar conversas em grupo com mensagens, não expor todos os raciocínios intermediários e priorizar a comunicação quando for necessário tomar uma decisão ou validar uma entrega. Mensagens de pouco valor devem ser evitadas.
Os canais de saída também são tratados de forma diferente. Mensageiros instantâneos recebem notificações concisas, enquanto GitHub, e-mail e documentos recebem entregas estruturadas, com contexto do problema, descrição das alterações e resultados da verificação. Do ponto de vista do produto, proatividade e frequência de notificações são indicadores distintos: um Agent que informa tudo o tempo todo não é necessariamente um Agent útil.
Evidências reais do Super-agent: caso interno e teste da comunidade
Ao avaliar uma nova arquitetura, é importante separar o “potencial” do “estado atual”. Hoje, há dois tipos de evidência, com níveis de confiabilidade e significados diferentes.
O caso interno da DeepSeek mostra o potencial da arquitetura. No chat interno do DeepSeek Harness, quando alguém relata um problema, o agente recebe a mensagem, avalia se vale a pena investigá-lo e tenta reproduzi-lo e encontrar uma correção em segundo plano. Se confirmar o problema e encontrar uma solução simples, prepara ou envia um PR; se não chegar a um resultado relevante, não interrompe a equipe. Esse é o funcionamento interno divulgado oficialmente, não uma validação independente feita por terceiros do protótipo público em sua configuração padrão.
O teste da comunidade no GitHub mostra o estado atual do protótipo. Em 1º de novembro de 2026, um usuário relatou que implantou o protótipo de código aberto em um ambiente Ubuntu, seguindo o SETUP.md. Ele conseguiu fazer uma solicitação de Issue entrar no fluxo de processamento e, ao final, gerar um Pull Request. No entanto, também enfrentou problemas: notificações do GitHub que não chegavam, ausência de solicitações de trabalho mesmo com o status do sistema indicando que estava tudo normal, necessidade de ajustar as configurações de monitoramento de Issues e comentários da Source e incompatibilidades relacionadas ao idioma do sistema e à configuração da conta do GitHub.
Esse relato comprova que o fluxo de trabalho “do evento à tarefa” realmente pode funcionar, mas não permite concluir que o projeto já consiga descobrir bugs automaticamente, de forma confiável e ininterrupta. Gerar um PR também não significa que as alterações tenham sido revisadas por uma pessoa e incorporadas ao projeto.
Construindo a camada de decisão de um agente orientado a eventos com uma API de modelo
Se você quer aproveitar a ideia do Super-agent, o ponto mais fácil de implementar é a camada de “Gate programático + avaliação por LLM”. O exemplo abaixo demonstra apenas a lógica de avaliação de eventos: não representa a implementação oficial do Super-agent nem é um produto de agente completo.
Exemplo mínimo
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI
)

event = "登录页面在 Safari 上又打不开了"
resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Consulte a lista de modelos da plataforma para confirmar o nome
    messages=[{"role": "user", "content": f"判断以下消息是否为故障线索,只回答 yes 或 no:{event}"}]
)
print(resp.choices[0].message.content)
Ver o código completo da implementação (Gate + avaliação + modo de aceitação de tarefas)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Configuração do Gate programático: regras determinísticas, sem invocar o LLM
ALLOWED_SOURCES = {"github", "feishu"}
ALLOWED_USERS = {"alice", "bob"}
WATCHED_CHANNELS = {"repo/web-frontend", "group/dev-team"}
MODE = "observe"  # off / observe / auto

def gate(event: dict) -> bool:
    """Primeiro nível: filtragem por regras de baixo custo"""
    return (
        event["source"] in ALLOWED_SOURCES
        and event["user"] in ALLOWED_USERS
        and event["channel"] in WATCHED_CHANNELS
    )

def assess(event: dict) -> dict:
    """Segundo nível: avaliação semântica pelo modelo, distinguindo explicit de inferred"""
    prompt = (
        "你是事件分类器。请判断消息是否包含值得处理的工作,"
        "并区分 explicit(明确请求)或 inferred(推断任务)。"
        '仅输出 JSON:{"actionable": bool, "kind": "explicit|inferred|none", "reason": "..."}\n'
        f"消息:{event['text']}"
    )
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
        max_tokens=200
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return {"actionable": False, "kind": "none", "reason": "parse_error"}

def handle(event: dict) -> str:
    if not gate(event):
        return "dropped_by_gate"
    result = assess(event)
    if not result["actionable"]:
        return "ignored"
    if result["kind"] == "explicit":
        return "create_task_with_mandate"   # Ainda é necessário verificar o escopo da autorização
    # Trata tarefas inferidas conforme o modo de aceitação
    if MODE == "off":
        return "ignored"
    if MODE == "observe":
        return f"logged_for_review: {result['reason']}"
    return "auto_accept_if_policy_allows"

print(handle({
    "source": "feishu", "user": "alice",
    "channel": "group/dev-team",
    "text": "最近构建有时会失败"
}))
🚀 Dica para começar: ao validar a camada de decisão de eventos, você pode obter créditos gratuitos para testes na APIYI, em apiyi.com. Use o mesmo código com modelos diferentes, compare a precisão da classificação e o consumo de tokens e então decida a configuração de modelos para cada camada.
Estratégia de orquestração de modelos em camadas
A estrutura do Super-agent pode ser resumida assim: evento externo → filtragem por programa → avaliação semântica pelo modelo → decisão de autorização → execução pelo Agent → entrega do resultado. Cada camada pode usar um modelo diferente:
| Camada | Natureza da tarefa | Critério de escolha do modelo |
|---|---|---|
| Gate programático | Correspondência de origem, usuário e escopo | Não usa LLM |
| Classificação de eventos | Alta frequência, textos curtos e saída estruturada | Modelos de baixo custo e baixa latência |
| Execução complexa | Reprodução e correção de problemas em código, raciocínio com contexto longo | Modelos mais capazes |
| Resumo e notificação de resultados | Resumos e entregas estruturadas | Pode ser configurado separadamente |
💡 Recomendação: é preciso verificar com logs reais e testes de negócio se a orquestração em camadas realmente economiza dinheiro. Não dá para presumir que usar vários modelos sempre reduzirá os custos. Com a interface unificada da APIYI apiyi.com, é possível trocar rapidamente os modelos de cada camada e fazer comparações A/B sem alterar o código da aplicação.
Análise dos impactos da arquitetura orientada a eventos do Super-agent
Impacto para desenvolvedores de software e automação
- A entrada deixa de ser a janela de chat e passa a ser o fluxo de trabalho: issues, comentários em PRs, resultados de CI e mensagens em grupos se tornam entradas naturais para o Agent. Por isso, os desenvolvedores precisam projetar a integração e a filtragem de eventos, não apenas escrever comandos.
- O desenho das autorizações se torna essencial: a distinção entre Explicit e Inferred, o modo de aceitar tarefas e o escopo do Mandate determinam se o Agent será aceito por equipes reais.
- A forma de avaliação precisa mudar: para avaliar um Agent proativo, não basta contar quantas ações ele executou. É ainda mais importante observar a qualidade da identificação de tarefas, a proporção de retrabalho e a quantidade de notificações sem valor.
Impacto para equipes de aplicações de IA nas empresas
Agents proativos têm potencial para colaboração no desenvolvimento, diagnóstico de falhas e automação de processos empresariais, mas a estrutura de custos muda. A avaliação de eventos consome tokens continuamente, a execução especulativa pode gerar trabalho que não será aproveitado e tarefas complexas ainda exigem revisão humana. O quadro abaixo foi elaborado com base na arquitetura oficial e não representa métricas de desempenho oficiais divulgadas pela DeepSeek:
| Dimensão de avaliação | Indicadores recomendados |
|---|---|
| Qualidade da identificação de tarefas | Taxa de identificação de eventos relevantes, taxa de acionamentos indevidos e taxa de tarefas duplicadas |
| Qualidade da execução | Proporção de tarefas concluídas, proporção de retrabalho humano e proporção de entregas aprovadas na revisão |
| Experiência do usuário | Número de intervenções humanas por tarefa válida, quantidade de notificações sem valor e tempo entre o surgimento do problema e uma entrega pronta para aprovação |
| Custo operacional | Consumo de tokens por avaliação de evento, custo dos modelos por tarefa concluída com sucesso e custo de tarefas especulativas não aproveitadas |
| Governança de segurança | Proporção de tarefas não autorizadas bloqueadas, funcionamento das aprovações em etapas críticas e uso de informações sensíveis dentro do escopo autorizado |
Riscos que não podem ser ignorados
Entre os riscos de Agents proativos estão acionamentos indevidos, tempestades de tarefas, extrapolação de permissões, Prompt Injection, desperdício de recursos e vazamento de informações. Em seu artigo técnico, a DeepSeek também reconhece que o isolamento de contexto, a memória de longo prazo, a comunicação segura e a privacidade em organizações complexas ainda são problemas a resolver. Para Agents com acesso a repositórios privados e credenciais locais, a prevenção da entrada de informações sensíveis no contexto do modelo ou em canais externos precisa fazer parte do projeto antes da implantação.
Perguntas frequentes (FAQ)
Q1: O que é a arquitetura orientada a eventos do DeepSeek Super-agent?
É uma arquitetura que permite ao Agent receber continuamente eventos do ambiente externo (Triggers). Depois de uma filtragem programática e de uma avaliação pelo modelo, ele pode criar tarefas dentro do escopo autorizado, executá-las em segundo plano e notificar pessoas no momento adequado. O ponto de partida deixa de ser uma “instrução do usuário” e passa a ser um “evento do ambiente”, mas a autorização e a aprovação continuam sob controle humano.
Q2: Inferir tarefas de forma proativa significa que o usuário perde o controle?
Não. As tarefas inferidas (Inferred) precisam seguir regras de admissão, limites de execução e requisitos de aprovação. O protótipo público usa, por padrão, o modo `observe`, que apenas registra tarefas potenciais, sem aceitá-las automaticamente. O usuário pode escolher `off` para desativar completamente a inferência de tarefas ou ativar `auto` depois de revisar os registros. O mecanismo Mandate também garante que mensagens como comentários não ampliem diretamente o escopo de autorização.
Q3: O que o protótipo de código aberto já consegue fazer?
O protótipo público oferece principalmente integração com o GitHub e, opcionalmente, com o Feishu. Ele já conta com três modos de aceitação de tarefas e com o mecanismo de autorização Mandate. Há relatos na comunidade de fluxos completos de Issue → PR, mas também existem problemas de implantação, como notificações que não chegam e incompatibilidades de configuração. Fontes de eventos como e-mail e calendário, assim como uma arquitetura assíncrona completa ativada por padrão, ainda fazem parte de uma visão mais ampla ou de implementações internas.
Q4: Como controlar o custo de tokens de um Agent proativo?
A chave é usar dois níveis de filtragem: primeiro, um Gate programático que não invoca um LLM bloqueia a maioria dos eventos irrelevantes, encaminhando apenas alguns candidatos para avaliação pelo modelo. Depois, a execução especulativa deve ser usada com cautela, preparando antecipadamente apenas tarefas cujo benefício seja evidente. No desenvolvimento, é possível usar as estatísticas de consumo da APIYI apiyi.com para observar o custo do modelo por evento avaliado e por tarefa concluída com sucesso, ajustando as regras de filtragem e a configuração do modelo com base nesses dados.
Q5: Como criar uma camada semelhante de avaliação de eventos usando uma API de modelo?
Você pode seguir o exemplo deste artigo: o Gate programático filtra os eventos por regras, o LLM Assessment produz uma avaliação estruturada e, em seguida, as tarefas inferidas são tratadas de acordo com o modo de aceitação. Para a invocação do modelo, basta usar uma interface compatível com a OpenAI. Após se cadastrar na APIYI apiyi.com, obtenha uma chave API e créditos de teste e mantenha o `base_url` do exemplo com o endereço indicado neste artigo para executá-lo. Vale esclarecer que essa abordagem apenas se inspira na arquitetura: a APIYI oferece acesso a APIs de modelos, não um serviço Super-agent pronto.
Q6: Quais são as limitações conhecidas do Super-agent atualmente?
As principais são: o protótipo público tem poucas fontes de eventos e apresenta problemas de compatibilidade na configuração de implantação; os casos internos de “correção silenciosa” ainda não foram verificados por terceiros independentes; “executar em segundo plano” não garante operação confiável 24 horas por dia; os PRs gerados ainda precisam de revisão humana; e a própria equipe reconhece que o isolamento de contexto dentro das organizações, a memória de longo prazo e a privacidade ainda precisam ser resolvidos.
Principais pontos sobre o DeepSeek Super-agent
- Mudança central: o trabalho do agente passa a ser iniciado por eventos do ambiente, não apenas por instruções do usuário. A janela de chat deixa de ser o único ponto de entrada.
- Filtragem em dois níveis: o Gate programático bloqueia ruídos a baixo custo, enquanto o LLM Assessment faz a avaliação semântica, equilibrando custo e precisão.
- Autorização em primeiro lugar: Explicit e Inferred são tratados separadamente, com
observecomo padrão. O Mandate impede que mensagens alterem a autorização concedida. - Execução proativa: a execução especulativa e as tarefas assíncronas reduzem o tempo de espera, mas é preciso avaliar o custo computacional e o benefício real.
- Entregas com poucas interrupções: o agente se comunica apenas quando é necessária uma decisão ou validação. Proatividade não é sinônimo de frequência de notificações.
- Olhar cauteloso sobre o estágio atual: casos internos mostram o potencial, e o protótipo de código aberto já consegue percorrer o fluxo Issue → PR, mas ainda tem maturidade limitada.
- Como aplicar essas ideias: comece usando APIs de modelos para criar uma camada de avaliação de eventos e compare a qualidade e o custo da classificação de diferentes modelos pela APIYI apiyi.com.
Resumo
A arquitetura orientada a eventos do DeepSeek Super-agent não responde à pergunta “a IA pode tomar decisões sozinha?”, mas sim a “como fazer um agente assumir trabalho de forma proativa dentro de regras e autorizações definidas?”. Seus mecanismos principais podem ser resumidos em três pontos:
- Percepção e filtragem: o Trigger transforma o ambiente de trabalho em fonte de entradas, enquanto a filtragem em dois níveis controla o ruído e o custo em tokens.
- Autorização e controle: a distinção entre Explicit e Inferred, os três modos de aceitação de tarefas e o escopo do Mandate garantem que ser proativo não signifique extrapolar a autorização.
- Execução e entrega: a execução especulativa, as tarefas assíncronas e as notificações pouco intrusivas mudam o papel das pessoas de “gerenciar tarefas” para “tomar decisões e validar entregas”.
O valor de um agente proativo não está na quantidade de ações que executa, mas em quanto trabalho de gerenciamento manual ele elimina e quantos resultados confiáveis entrega. O protótipo de código aberto ainda está em estágio inicial, então vale começar no modo observe, acumular registros das avaliações e construir confiança aos poucos. Se você está projetando um fluxo semelhante de avaliação de eventos e execução de tarefas, uma opção é usar a APIYI apiyi.com para testar rapidamente o desempenho de diferentes modelos em cada camada e, depois, fazer escolhas com base em dados reais do negócio.
📚 Referências
- Estudo da arquitetura do DeepSeek Super-agent: análise do design orientado a eventos e de agentes proativos
- Link:
blog2.eimoon.com/p/deepseek-super-agent-design/ -
Descrição: aborda Trigger, execução especulativa, tarefas assíncronas e casos internos
-
Documentação do mecanismo de autorização do DeepSeek: Explicit/Inferred, modos de aceitação de tarefas e Mandate
- Link:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
Descrição: fonte oficial para entender os três modos
off,observeeauto -
Filosofia de design de produto do DeepSeek: princípios de atenção e baixa interferência
- Link:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/000-philosophy.md -
Descrição: explica por que um agente proativo não deve chamar atenção com frequência
-
DeepSeek Domain Model: definições dos principais conceitos de domínio
- Link:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
Descrição: ideal para entender melhor a relação entre tarefas, Workers e eventos
-
Instruções de implantação do DeepSeek Setup: guia de instalação do protótipo de código aberto
- Link:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/SETUP.md -
Descrição: leitura essencial antes de começar a implantação
-
Relatos de uso da comunidade GitHub: testes de Issue → PR e problemas de implantação
- Link:
github.com/deepseek-ai/deepseek-harness/discussions/11706 - Descrição: ajuda a entender o estado atual de funcionamento do protótipo e suas limitações
Autor: equipe técnica da APIYI
Troca de experiências técnicas: entre em contato conosco pela página inicial do site da APIYI. Para mais materiais sobre integração de modelos, acesse o centro de documentação em docs.apiyi.com