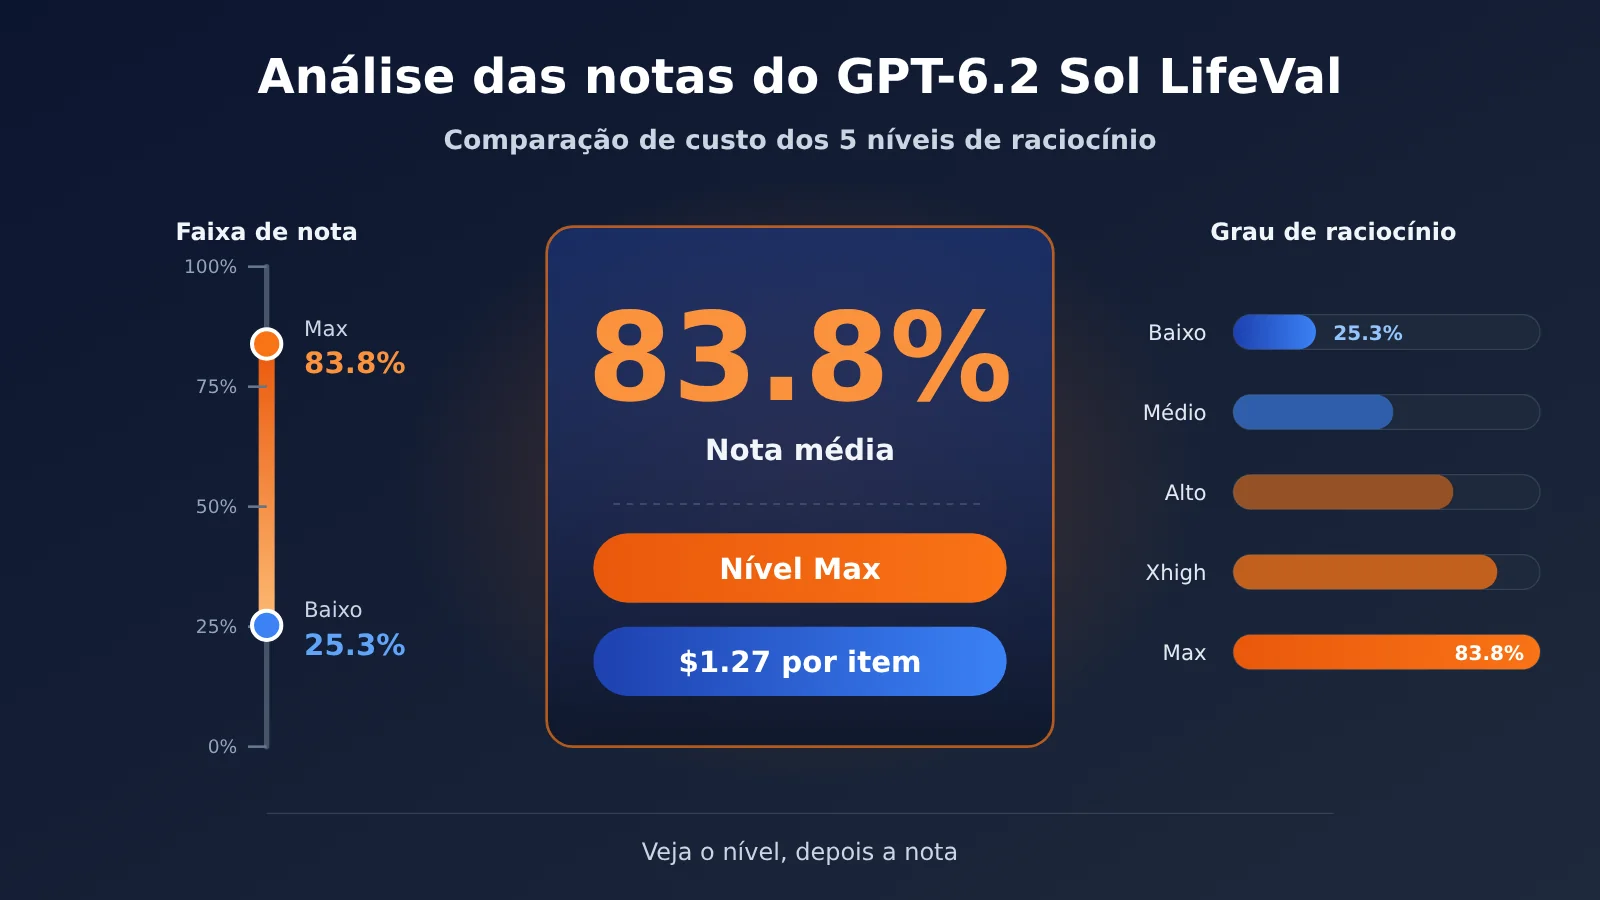
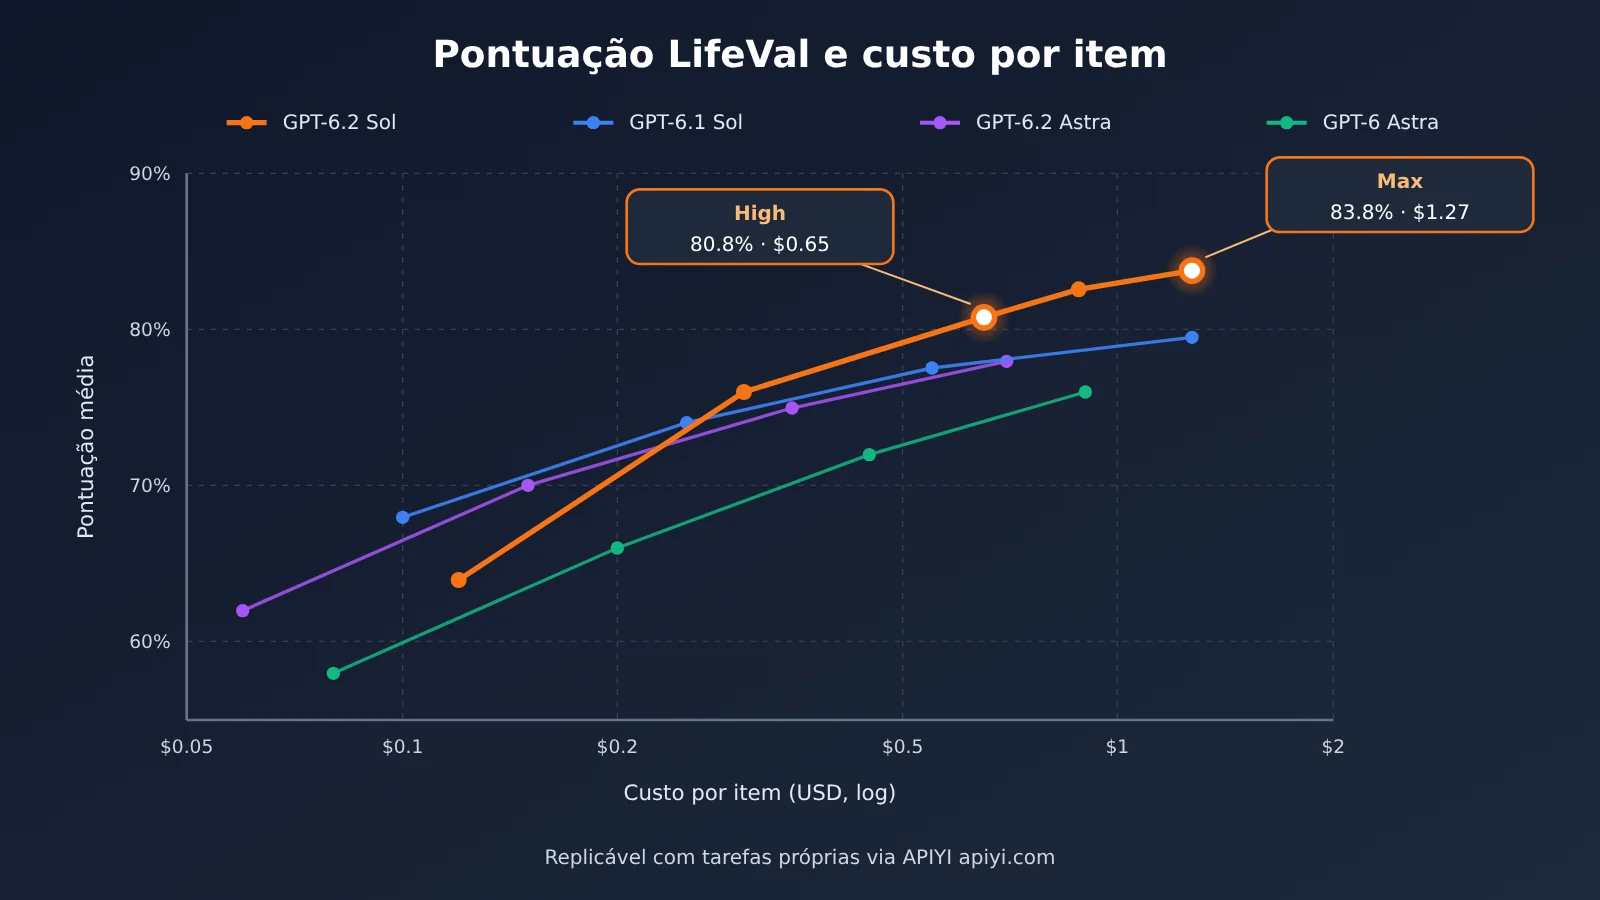
83.8% não significa “83.8% das tarefas foram totalmente concluídas”, mas sim a pontuação média do GPT-6.2 Sol no LifeVal no nível de raciocínio Max. Essa pontuação é a soma das notas atribuídas item a item conforme os critérios de avaliação de cada tarefa; o custo médio por tarefa correspondente é de $1.27. No mesmo modelo, ao passar para o nível Low, a pontuação média cai para apenas 25.3%; no nível High, a pontuação média é de 80.8%, com custo por tarefa de $0.65. Por isso, ao falar do desempenho do GPT-6.2 Sol no LifeVal, é indispensável deixar claro de qual nível estamos falando.
A conclusão é: o ranking oficial traz uma “combinação de pontuação e custo em tarefas e ambientes específicos”, não um ranking geral que você possa copiar diretamente para o seu produto. Neste conjunto de dados do LifeVal, o nível High é um ponto de partida que merece ser testado primeiro. A escolha final do nível ainda precisa ser validada com as suas próprias tarefas, pelos artefatos produzidos e pelo estado real.
O que você vai encontrar neste artigo?
- Que tarefas o LifeVal mede e como expressar 83.8% corretamente.
- As pontuações e os custos dos cinco níveis de raciocínio do GPT-6.2 Sol, além da comparação no mesmo nível com GPT-6.1 Sol, GPT-6 Astra e GPT-6.2 Astra.
- Por que a afirmação oficial de “custo de cerca de um sétimo” e a “queda acentuada no nível Low” podem ser verdadeiras ao mesmo tempo.
- Como usar o método de validação do LifeVal como referência para criar tarefas de avaliação repetíveis para o seu assistente de uso diário.
Índice: a tabela To Know explica primeiro os termos de avaliação que serão usados no restante do texto; a visão rápida dos impactos mostra o que usuários comuns e desenvolvedores devem observar, respectivamente. A seção de fatos objetivos apresenta, em ordem, a origem das tarefas do LifeVal e a forma de pontuação, além dos dados por nível no gráfico publicado em 17 de novembro. A seção de análise e julgamento primeiro decompõe os denominadores de alguns grupos de comparação, depois apresenta um exemplo de validação para um assistente de rotas e agenda que pode ser adaptado diretamente, e por fim explica os limites da transferência.
Para saber: conceitos-chave para entender a pontuação do GPT-6.2 Sol LifeVal
| Conceito | Explicação breve |
|---|---|
| LifeVal | Benchmark da OpenAI usado para medir o desempenho de assistentes de IA na conclusão de tarefas digitais cotidianas e personalizadas |
| Contexto personalizado | Informações como preferências do usuário, histórico e condições específicas da tarefa que alteram o que conta como “resposta aceitável” |
| Rubrica de avaliação | Divisão da conclusão de uma tarefa em uma série de requisitos que podem ser verificados individualmente |
| Ambiente controlado | Ambiente de avaliação com aplicativos, dados e estado inicial previamente configurados, para facilitar a verificação dos resultados das ações |
| Diferença de estado do backend | Registro das mudanças de estado dos aplicativos antes e depois do teste, usado para confirmar se as operações das ferramentas realmente surtiram efeito |
| Valor médio de recompensa | Métrica agregada das pontuações de cada tarefa conforme a rubrica de avaliação; as porcentagens mostradas no gráfico publicado correspondem a esse tipo de “pontuação média” |
| Intensidade de raciocínio | Nível que controla o esforço de raciocínio do modelo; neste artigo, comparamos Low, Medium, High, Xhigh e Max |
| Custo por item | Custo médio por tarefa no gráfico de avaliação, que varia conforme o uso do modelo e as tarifas aplicadas |
Visão rápida dos impactos do GPT-6.2 Sol LifeVal
- Usuários comuns: ao ver “83.8%”, entendam isso como “a pontuação média em um conjunto de tarefas cotidianas de usuários de inglês americano”, e não como taxa de sucesso. Além disso, é importante notar que o mesmo modelo apresenta diferenças grandes entre níveis de raciocínio; a experiência do produto depende do nível escolhido pelo desenvolvedor da aplicação.
- Gerentes de produto: o nível Low tem o menor preço, mas desta vez ficou bem atrás do nível Low da geração anterior do Sol no LifeVal. Se a atualização mantiver a configuração de níveis da versão antiga, pode acontecer de “trocar para um modelo novo e o resultado piorar”.
- Desenvolvedores de API: vale a pena tomar como referência o desenho de aceitação do LifeVal, que avalia separadamente as entregas, o estado do ambiente e as respostas. Comparar Low, Medium e High com um mesmo conjunto de tarefas próprias é mais confiável do que simplesmente citar os números do ranking.
Fato objetivo: com quais tarefas o LifeVal avalia o GPT-6.2 Sol
Origem e cronologia de publicação do LifeVal
O LifeVal é uma avaliação da OpenAI para medir tarefas personalizadas de agentes no dia a dia. A página de pesquisa da OpenAI tem data de 2 de novembro de 2026, e o artigo científico associado tem data de 3 de novembro. Em 17 de novembro, a OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol, e incluiu na página de lançamento um gráfico do LifeVal com as pontuações por faixa dos novos modelos (identificador do gráfico lifeval-v2).
A distribuição de tarefas do artigo vem de estudos de uso do tempo nos EUA e em vários países, e também considera uma pesquisa de disposição a pagar voltada ao público dos EUA; ao final, as atividades cotidianas foram organizadas em 148 categorias. Os experimentos do artigo usam 169 tarefas. Vale notar que os modelos avaliados no próprio artigo vão até o GPT-6 Astra; os números por faixa da série GPT-6.2 aparecem apenas no gráfico oficial de lançamento posterior.
Segundo o posicionamento oficial, o Sol é voltado a trabalhos diários de alta frequência, programação rotineira e agentes de múltiplas etapas escaláveis; o Astra é voltado a raciocínios mais difíceis e entregas profissionais. Esse posicionamento bate com as “tarefas de assistente cotidiano” medidas pelo LifeVal.
Design de tarefas do LifeVal: a mesma necessidade, respostas válidas diferentes para cada pessoa
O LifeVal se destaca pela personalização. Tomemos como exemplo a comparação de escolas depois de uma mudança de casa: para usuários com idades das crianças, trajetos de deslocamento e preferências por distrito escolar diferentes, as respostas válidas também serão diferentes. Outro exemplo: ao procurar imóvel equilibrando orçamento e tempo de deslocamento, o teto de orçamento e a duração aceitável do trajeto determinam diretamente quais imóveis contam como resultados válidos.
Conforme definido no artigo, cada tarefa inclui um comando, preferências do usuário, arquivos de referência, conversas e memórias relevantes, uma rubrica de avaliação e um ambiente controlado com estado predefinido. Após a execução, o avaliador pode verificar três tipos de coisas: os arquivos entregues pelo modelo, os estados anterior e posterior do ambiente manipulado pelas ferramentas e a resposta do modelo; em seguida, atribui notas separadamente a cada requisito da tarefa.
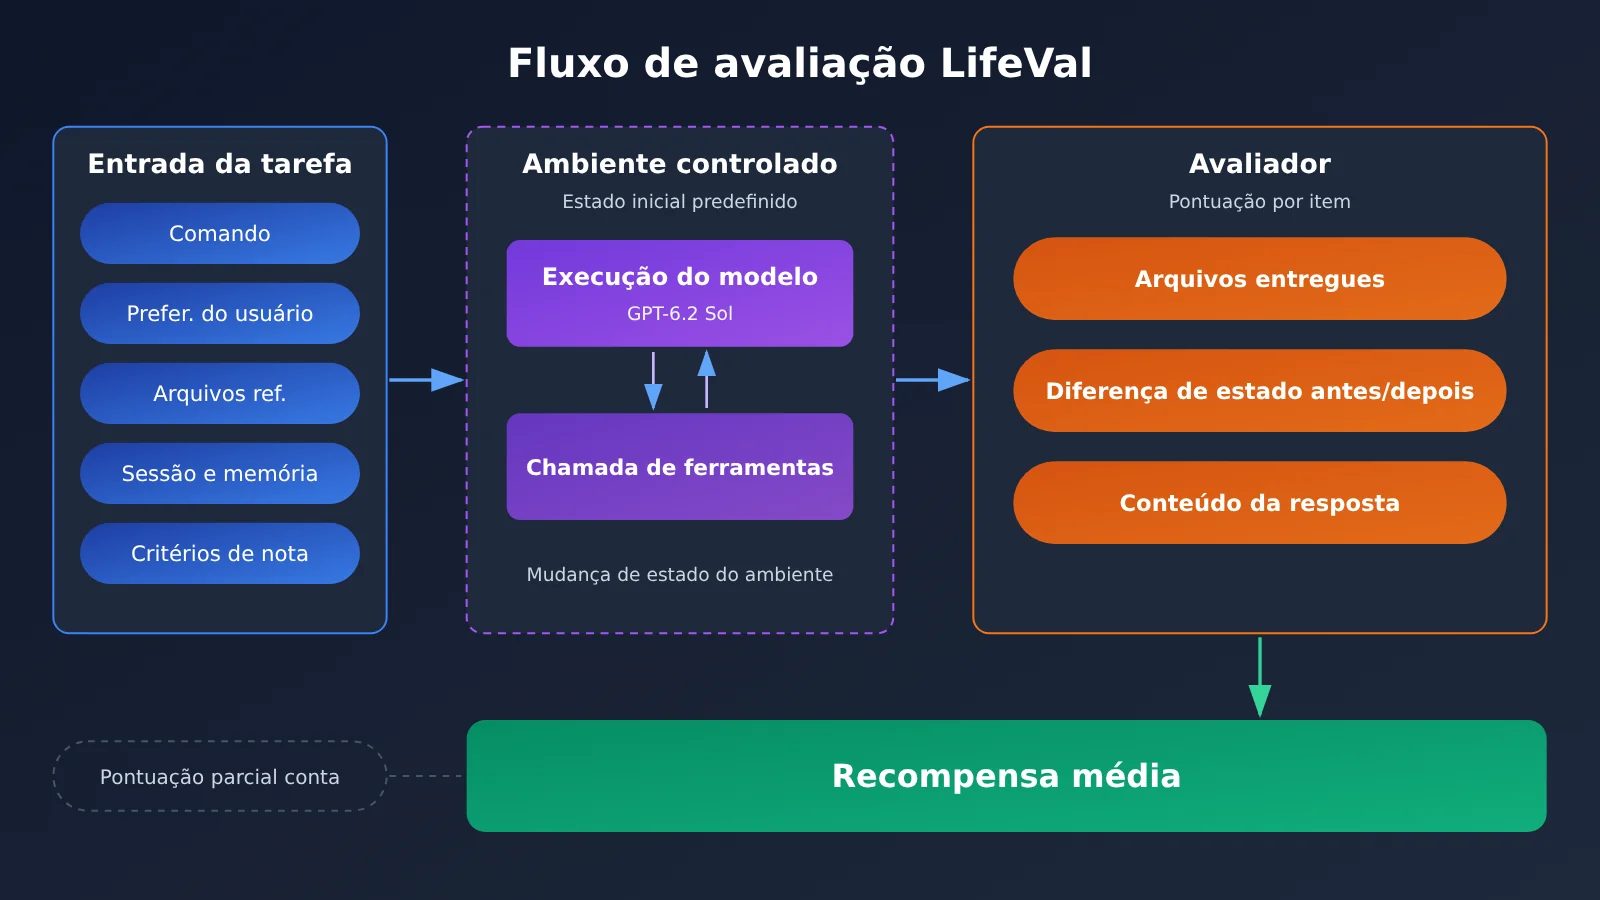
Por que 83.8% só pode ser chamado de “pontuação média”
O eixo vertical do gráfico de resultados do artigo é o valor médio de recompensa. Portanto, 83.8% deve ser descrito como “pontuação média”, e não como “83.8% das tarefas foram executadas com sucesso integral”. Mesmo que uma tarefa atenda apenas a parte dos itens da rubrica, ela ainda contribui com uma fração da pontuação.
O artigo também aponta algumas limitações: no ambiente offline e nas páginas web em cache, ainda há informações que mudam com o tempo; além disso, a amostra é composta principalmente por usuários nos Estados Unidos que falam inglês. Isso significa que a pontuação não pode ser generalizada diretamente para outras regiões, outros idiomas ou outros ecossistemas de aplicações.
Gráfico de lançamento do LifeVal do GPT-6.2 Sol: pontuações nas cinco faixas e custo por tarefa
A tabela abaixo foi extraída dos dados públicos do gráfico interativo LifeVal na página de lançamento da OpenAI de 17 de novembro de 2026. Cada célula traz “pontuação média / custo médio por tarefa (USD)”. São dados de avaliação públicos autorreportados pela OpenAI, não medições feitas por instituições independentes.
| Modelo | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|
| GPT-6.2 Sol | 25,3% / $0,089 | 70,3% / $0,38 | 80,8% / $0,65 | 82,6% / $0,88 | 83,8% / $1,27 |
| GPT-6.1 Sol | 66,8% / $0,52 | 75,5% / $0,73 | 77,1% / $0,88 | 77,8% / $0,96 | 79,5% / $1,27 |
| GPT-6.2 Astra | 46,3% / $0,59 | 78,9% / $1,56 | 83,1% / $2,41 | 83,7% / $2,94 | 86,1% / $4,23 |
| GPT-6 Astra | 67,5% / $3,51 | 74,3% / $5,30 | 76,0% / $6,52 | 77,5% / $6,94 | 79,8% / $9,04 |
O texto do comunicado de lançamento diz o seguinte: no LifeVal, o Sol pontua mais que o GPT-6 Astra, com custo de aproximadamente um sétimo do concorrente. O termo de comparação aqui é o GPT-6 Astra, o flagship da geração anterior, e não o GPT-6.2 Astra do mesmo período. A outra comparação do comunicado, no FrontierCode 2.0, é que usa o GPT-6.2 Astra: ao ler, não misture as conclusões dos dois grupos.
📌 Observação sobre o critério dos dados: o “custo por tarefa” da tabela é a média do gráfico oficial de avaliação e depende do comprimento de entrada, do comprimento de saída e do uso de ferramentas nessa avaliação. Para saber o custo das suas próprias tarefas, é preciso refazer o teste com requisições reais: dá para usar o APIYI apiyi.com com a mesma chave, rodando em sequência as diferentes faixas do Sol, e comparar as faturas diretamente.
Informações de acesso à API do GPT-6.2 Sol
O ID do modelo na API é gpt-6.2-sol, que pode ser invocado tanto via Responses quanto via Chat Completions. Chamadas de função e ferramentas internas seguem o caminho Responses. Nenhum dos dois endpoints aceita o nível de raciocínio none. O preço oficial de tabela na configuração Standard de contexto curto é de US$ 2,00 de entrada e US$ 10,00 de saída (USD / milhão de tokens, com os tokens de raciocínio já incluídos na saída), o mesmo do GPT-6.1 Sol.
Até 20 de novembro de 2026, tanto a tabela pública de modelos quanto a interface de preços da APIYI já listam o gpt-6.2-sol, com os pontos de entrada responses e chat marcados. A precificação do nível curto é idêntica à oficial; os grupos realmente disponíveis, o intervalo de parâmetros e o faturamento efetivo ficam sujeitos à configuração atual e à fatura do apiyi.com da APIYI.
Análise: como o “um sétimo do custo” e a queda do Low se sustentam ao mesmo tempo no GPT-6.2 Sol LifeVal
Primeiro, alinhe os objetos de comparação e os denominadores
A mesma imagem pode dar a impressão de “grande avanço” ou de “regressão evidente” — e a razão básica é que os objetos de comparação e as faixas são diferentes. As diferenças e proporções na tabela abaixo são calculadas com base nos valores divulgados oficialmente.
| Grupo de comparação | Valores das duas partes | Diferença de pontuação | Relação de custo |
|---|---|---|---|
| 6.2 Sol Max vs GPT-6 Astra Max, o carro-chefe da geração anterior | 83.8%/$1.27 vs 79.8%/$9.04 | +4.0 pontos percentuais | cerca de 14.0%, ou seja, “aproximadamente um sétimo” |
| 6.2 Sol Max vs 6.1 Sol Max | 83.8%/$1.27 vs 79.5%/$1.27 | +4.3 pontos percentuais | mesmo custo |
| 6.2 Sol Low vs 6.1 Sol Low | 25.3%/$0.089 vs 66.8%/$0.52 | −41.5 pontos percentuais | custo menor, mas a pontuação despencou |
| 6.2 Sol Medium vs 6.1 Sol Medium | 70.3%/$0.38 vs 75.5%/$0.73 | −5.2 pontos percentuais | custo de cerca de metade |
| 6.2 Sol High vs 6.1 Sol Max | 80.8%/$0.65 vs 79.5%/$1.27 | +1.3 pontos percentuais | cerca de metade |
| 6.2 Sol Max vs 6.2 Astra Max | 83.8%/$1.27 vs 86.1%/$4.23 | −2.3 pontos percentuais | cerca de 30% |
Nesses números, “pontos percentuais” descrevem a diferença entre as pontuações médias, e “proporção de custo” descreve a razão entre os custos médios por item; as duas não podem ser convertidas uma na outra. O “um sétimo” só vale no grupo “6.2 Sol Max vs GPT-6 Astra Max”. Se trocarmos para o GPT-6.2 Astra do mesmo período, o Sol na faixa Max fica, na verdade, 2.3 pontos percentuais abaixo.
💡 Dica de escolha: a diferença entre faixas de um mesmo modelo pode ser maior do que a diferença entre modelos distintos. Recomendamos primeiro rodar uma rodada de comparação por faixa no APIYI apiyi.com com um conjunto fixo de tarefas, e só então decidir a faixa padrão — não reaproveite simplesmente a configuração de faixa do modelo antigo.
O sinal do nível Low: a atualização não pode ser uma “substituição cega”
O nível Low do Sol 6.2 tem apenas 25.3% no LifeVal, 41.5 pontos percentuais abaixo do 6.1 Sol Low. Os materiais oficiais de lançamento mencionam que o Sol consome menos tokens de saída em várias tarefas, e o custo médio por item no nível Low é de apenas $0.089. Uma suposição razoável é que, em tarefas personalizadas de múltiplas etapas, o baixo investimento em raciocínio não basta para cobrir restrições de preferência e operações com ferramentas. Isso é apenas uma suposição; a divulgação oficial não explica a queda do nível Low.
Para equipes de produto, o impacto é direto. Se seu aplicativo usava o nível Low no 6.1 Sol para economizar, trocar diretamente o ID do modelo sem ajustar o nível pode reduzir visivelmente a qualidade em tarefas cotidianas complexas. Em contrapartida, no mesmo custo por item, o nível Max fica 4.3 pontos percentuais acima do Sol da geração anterior, o que indica que o teto do novo modelo realmente subiu.
Por que o High é o nível que vale a pena testar primeiro nesta avaliação
No 6.2 Sol, indo de High para Xhigh e depois para Max, os ganhos entre níveis adjacentes são de apenas 1.8 e 1.2 pontos percentuais, respectivamente, enquanto o custo médio por item sobe $0.23 e $0.39, na mesma ordem. O nível High, com $0.65, alcança 80.8% e já supera o nível Max do 6.1 Sol e o nível Max do GPT-6 Astra. Considerando apenas o LifeVal, o High é o ponto de partida de “equilíbrio razoável entre qualidade e custo”.
Porém, essa conclusão tem três premissas: a distribuição de tarefas próxima do LifeVal; o idioma e o ambiente de aplicação próximos do cenário de usuários de inglês americano; e a estrutura de custos próxima da proporção de entrada e saída dessa avaliação. Se qualquer uma delas não for atendida, a conclusão pode mudar. Na prática, a abordagem mais segura é começar pelo High e, com base na taxa de sucesso nas suas próprias tarefas, decidir se desce para Medium ou sobe para Xhigh ou Max.
Análise e julgamento: validar seu assistente GPT-6.2 Sol com a lógica do LifeVal
Criar uma tarefa de itinerário familiar de baixo risco
O que mais vale a pena aprender com o LifeVal não é a pontuação em si, mas o método de validação por produto e estado. Veja um exemplo de itinerário familiar: de antemão, dê ao assistente três restrições rígidas — local de partida e destino, condições de acessibilidade e teto de orçamento — e peça que ele entregue propostas candidatas com rotas verificáveis, além de um rascunho editável de agenda.
| Critério de avaliação | Como verificar | Pode ser automatizado |
|---|---|---|
| As restrições de local foram atendidas | Os pontos de partida e chegada na proposta coincidem com a entrada | Verificação automática possível |
| As condições de acessibilidade foram atendidas | A descrição da rota cobre explicitamente os requisitos de acessibilidade | Parcialmente automático; precisa de amostragem manual |
| O orçamento não foi ultrapassado | Analisar os valores na proposta e comparar com o teto | Verificação automática possível |
| Os links sustentam as informações | O link está acessível e o conteúdo coincide com a proposta | Requer inspeção manual |
| O arquivo de rascunho de agenda existe | Verificar o estado antes e depois do arquivo de saída ou do item de calendário | Verificação automática possível |
| Pergunta quando faltam informações críticas | Omitir de propósito informações como a data e ver se ele pergunta proativamente | Requer julgamento humano |
Esses critérios correspondem às três vias de validação do LifeVal: entregáveis (o rascunho de agenda), mudança de estado (se o arquivo ou o item realmente foi gravado) e qualidade da resposta (satisfação das restrições e perguntas proativas). Use o mesmo lote de tarefas para rodar Low, Medium e High separadamente, e então combine taxa de conformidade e custo para decidir o nível inicial.
Exemplo mínimo: chamar o GPT-6.2 Sol e registrar o consumo de raciocínio
O exemplo abaixo chama o gpt-6.2-sol pela interface Responses e também lê os tokens de saída e, dentro deles, os tokens de raciocínio. Assim fica mais fácil calcular o custo de cada item depois.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "high"},
    input="请为我规划周六的家庭出行:从家到市立博物馆,需全程无障碍,交通预算不超过 200 元,并给出日程草稿。"
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
Ver script de comparação por níveis (Low / Medium / High)
import re
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Com uma única chave, dá para comparar vários níveis
)

# Preço Standard para contexto curto, USD / milhão de tokens (a saída já inclui os tokens de raciocínio)
PRICE_IN, PRICE_OUT = 2.00, 10.00

TASKS = [
    {
        "prompt": "从家到市立博物馆,周六上午出发,全程无障碍,交通预算不超过 200 元。"
                  "请给出带路线说明的候选方案,并输出一份日程草稿。",
        "budget": 200,
        "must_include": ["无障碍", "博物馆"],
    },
    {
        # Falta a data de propósito, para verificar se o modelo pergunta de forma proativa
        "prompt": "帮我安排一次带老人去公园的出行,预算 100 元以内,需要无障碍路线。",
        "budget": 100,
        "must_include": ["无障碍"],
        "expect_question": True,
    },
]

def check(task, text):
    """Pontua item por item conforme os critérios de avaliação e retorna uma pontuação de 0 a 1"""
    items = []
    items += [kw in text for kw in task["must_include"]]
    amounts = [float(x) for x in re.findall(r"(\d+(?:\.\d+)?)\s*元", text)]
    items.append(bool(amounts) and max(amounts) <= task["budget"])
    if task.get("expect_question"):
        items.append("?" in text or "?" in text)
    return sum(items) / len(items)

for effort in ["low", "medium", "high"]:
    scores, cost = [], 0.0
    for task in TASKS:
        resp = client.responses.create(
            model="gpt-6.2-sol",
            reasoning={"effort": effort},
            input=task["prompt"],
        )
        u = resp.usage
        cost += u.input_tokens / 1e6 * PRICE_IN + u.output_tokens / 1e6 * PRICE_OUT
        scores.append(check(task, resp.output_text))
    print(f"{effort:>6}: 平均得分 {sum(scores)/len(scores):.1%}, "
          f"平均单项费用 ${cost/len(TASKS):.4f}")
As verificações automáticas do script cobrem apenas os critérios de avaliação que dá para conferir por máquina. A veracidade dos links e a qualidade das perguntas de esclarecimento ainda precisam de revisão manual. Os valores dos parâmetros dos níveis de raciocínio (especialmente as strings correspondentes a Xhigh e Max) devem seguir a documentação oficial atual e as instruções de parâmetros do canal que você estiver usando.
🚀 Comece rápido: cadastre-se na APIYI, em apiyi.com, e ganhe uma cota gratuita para testes. A plataforma oferece interface compatível com OpenAI; o script acima funciona bastando trocar a chave, então dá para fazer uma primeira rodada de validação com uma amostra pequena antes de escolher o nível definitivo.
Limites de transferência das conclusões do GPT-6.2 Sol LifeVal
Para levar as conclusões do LifeVal para o seu próprio produto, é preciso considerar pelo menos três diferenças. A primeira é idioma e região: a amostra do artigo é formada majoritariamente por usuários de inglês americano, e, em cenários em chinês, o ecossistema de aplicativos de mapas, pagamentos e calendário é totalmente diferente. A segunda é o ambiente: o LifeVal roda em ambiente controlado e em páginas web em cache, enquanto um produto real enfrenta oscilações de rede, falhas de autorização de ferramentas e diferenças no estado da conta. A terceira é a estrutura de custos: o custo oficial por item corresponde à proporção de entrada e saída daquela avaliação; solicitações de contexto longo que ultrapassam 272K de entrada passam inteiramente para uma faixa de preço mais alta, e o custo por item pode ficar bem distante do gráfico.
Por isso, uma forma de uso mais razoável é: tratar o gráfico oficial como base para “estreitar o conjunto de candidatos” e o seu próprio conjunto de tarefas como base para a “decisão final”. Para um assistente diário complexo, você pode primeiro estabelecer uma linha de base com o nível High e depois testar separadamente se Medium consegue preservar restrições rígidas importantes e se Xhigh ou Max reduzem claramente o retrabalho manual — deixando a taxa real de conformidade e a fatura falarem.
Quando o seu conjunto de tarefas, os critérios de pontuação e as verificações de ambiente estiverem prontos, a atualização do modelo deixa de ser “trocar de modelo olhando para o ranking” e passa a ser um processo de engenharia que pode ser retestado a cada vez. Quando for necessário comparar repetidamente vários modelos e níveis, você pode usar a interface unificada da APIYI apiyi.com para colocar GPT-6.2 Sol, GPT-6.2 Astra e outros no mesmo conjunto de scripts de aceitação.
Referências
-
Comunicado de lançamento do OpenAI GPT-6.2 Astra e Sol (incluindo os gráficos de faixas do LifeVal)
- Link:
openai.com/zh-Hans-CN/index/introducing-gpt-6-2-astra-sol - Descrição: publicado em 17/11/2026, é a fonte dos dados por faixa usados neste artigo
- Link:
-
Página de pesquisa e paper do LifeVal
- Link:
openai.com/index/lifeval,cdn.openai.com/pdf/lifeval.pdf - Descrição: origem das tarefas, método de pontuação e limitações (paper §3–§5)
- Link:
-
Model card e preço oficial do GPT-6.2 Sol
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol - Descrição: especificações da janela de contexto, regras de cobrança para contexto curto e longo e limites de uso
- Link:
-
Tabela geral de modelos da APIYI
- Link:
docs.apiyi.com/models.md - Descrição: modelos listados publicamente, endpoints e informações de preço
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Fique à vontade para falar com a gente pelo site oficial da APIYI, apiyi.com. Quem precisar de mais material de integração pode acessar o centro de documentação em docs.apiyi.com