Nota do autor: este artigo apresenta o contexto do Gemini 4 Neon, os quatro níveis de intensidade de pensamento e os preços, explica como configurar os dois pontos de entrada — nativo e compatível — na APIYI e mostra como localizar erros comuns de integração usando a mesma requisição mínima.
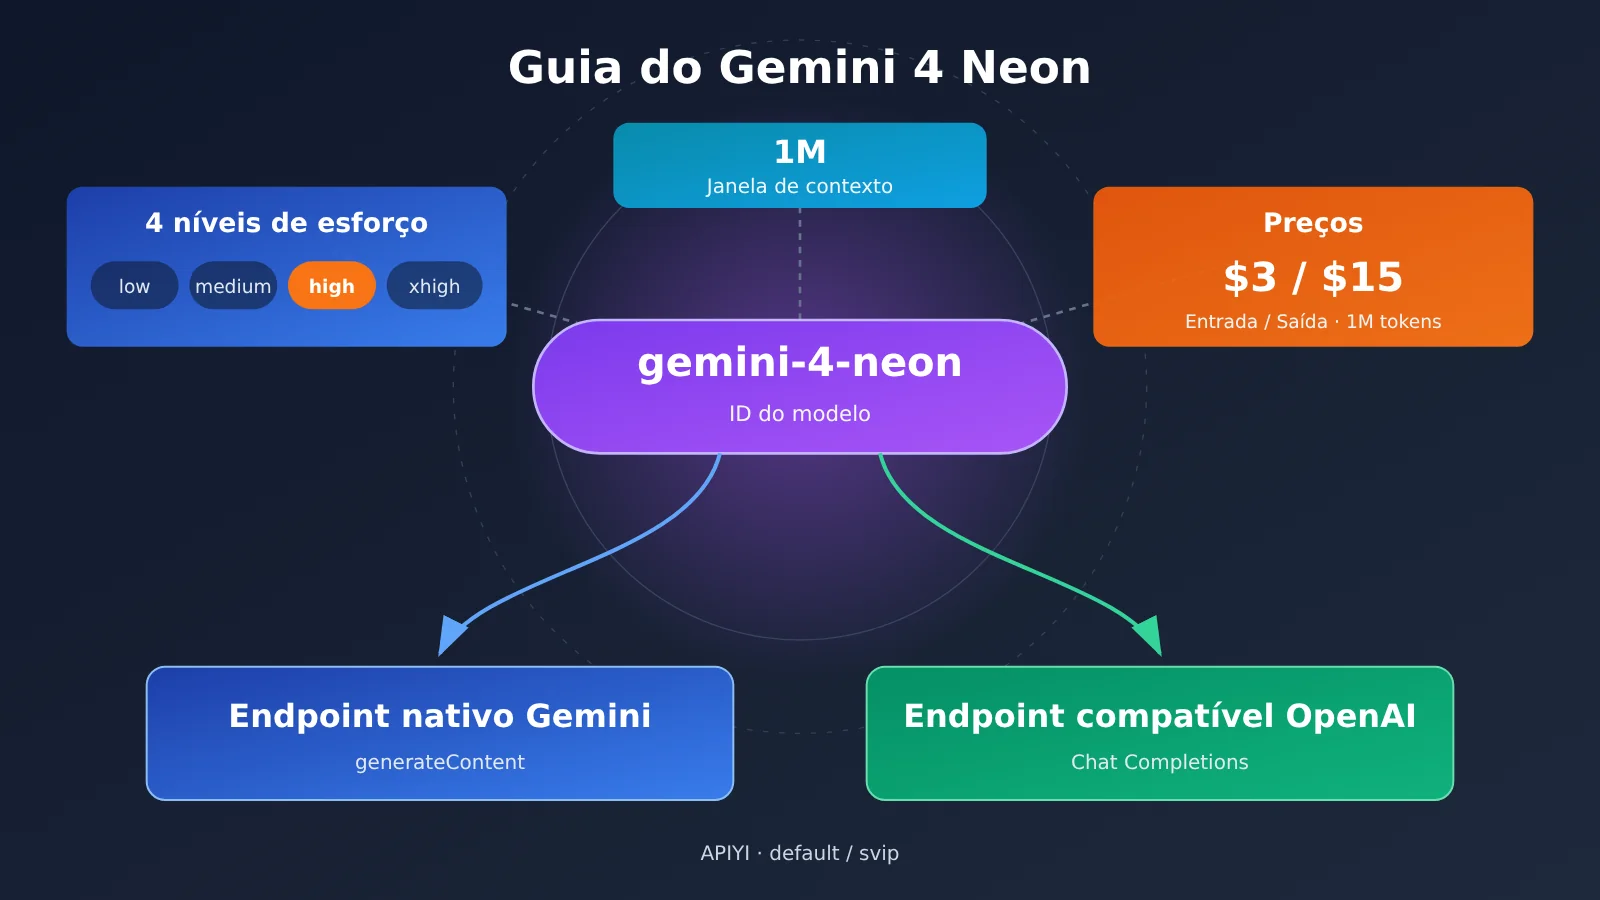
Em resumo: o Gemini 4 Neon foi lançado pelo Google em 18 de novembro de 2026 e foi disponibilizado pela APIYI em 20 de novembro nos grupos default/svip. O ID do modelo é gemini-4-neon, com preço de $3 por milhão de tokens de entrada, $15 de saída e $0.15 de leitura de cache.Se você precisa de controle nativo dos níveis de pensamento, prefira o endpoint nativo do Gemini; se for apenas trocar o modelo em um cliente OpenAI já existente, o endpoint compatível é mais prático. Mas, nos dois caminhos, primeiro faça a requisição mais curta funcionar e depois habilite, um a um, streaming, chamadas de ferramentas e níveis de pensamento mais altos.
Este não é um artigo de notícia que apenas reescreve o comunicado de imprensa. Os parâmetros, preços, benchmarks e caminhos de solução de problemas abaixo indicam suas fontes e condições de aplicação, e os exemplos de código são construídos conforme a documentação oficial. A nota de lançamento da APIYI informa que, antes da disponibilização, apenas a interface de preços foi verificada, sem chamadas reais; por isso, este artigo não vai descrever os dois endpoints ou as chamadas de ferramentas como “testados e funcionando de ponta a ponta”.
Valor central: depois de ler este artigo, você poderá confirmar as especificações e as regras de cobrança do Neon, escrever as duas requisições mínimas — nativa e compatível —, escolher o nível de pensamento com base nos resultados dos testes e localizar rapidamente problemas conforme os sintomas dos erros.
Termos que você precisa conhecer antes de integrar o Gemini 4 Neon
Os conceitos abaixo vão aparecer várias vezes ao longo do texto. Vamos padronizar a nomenclatura desde já — assim, na hora de depurar problemas, fica bem mais difícil se confundir.
- ID do modelo: a string completa que identifica o modelo na requisição; neste artigo, é
gemini-4-neon. Maiúsculas, minúsculas e hífens precisam ser copiados exatamente como estão, sem abreviar por conta própria. - Base URL: o endereço raiz que o cliente usa para montar o caminho da requisição. Se ela inclui ou não um prefixo de versão como
/v1depende do SDK que você está usando — e configurar isso errado é uma das causas mais comuns de 404. - Endpoint nativo do Gemini: aceita o protocolo
generateContente é indicado para cenários que precisam usar os parâmetros de raciocínio nativos. - Endpoint compatível com OpenAI: usa o formato Chat Completions; quem já tem um cliente OpenAI pode reutilizar a estrutura básica de mensagens.
- Nível de raciocínio: o valor enumerado que define a intensidade de inferência do modelo. O Neon suporta nativamente
low,medium,highexhigh; a APIYI marca dinamicamente o nível padrão comohigh. - Assinatura de raciocínio
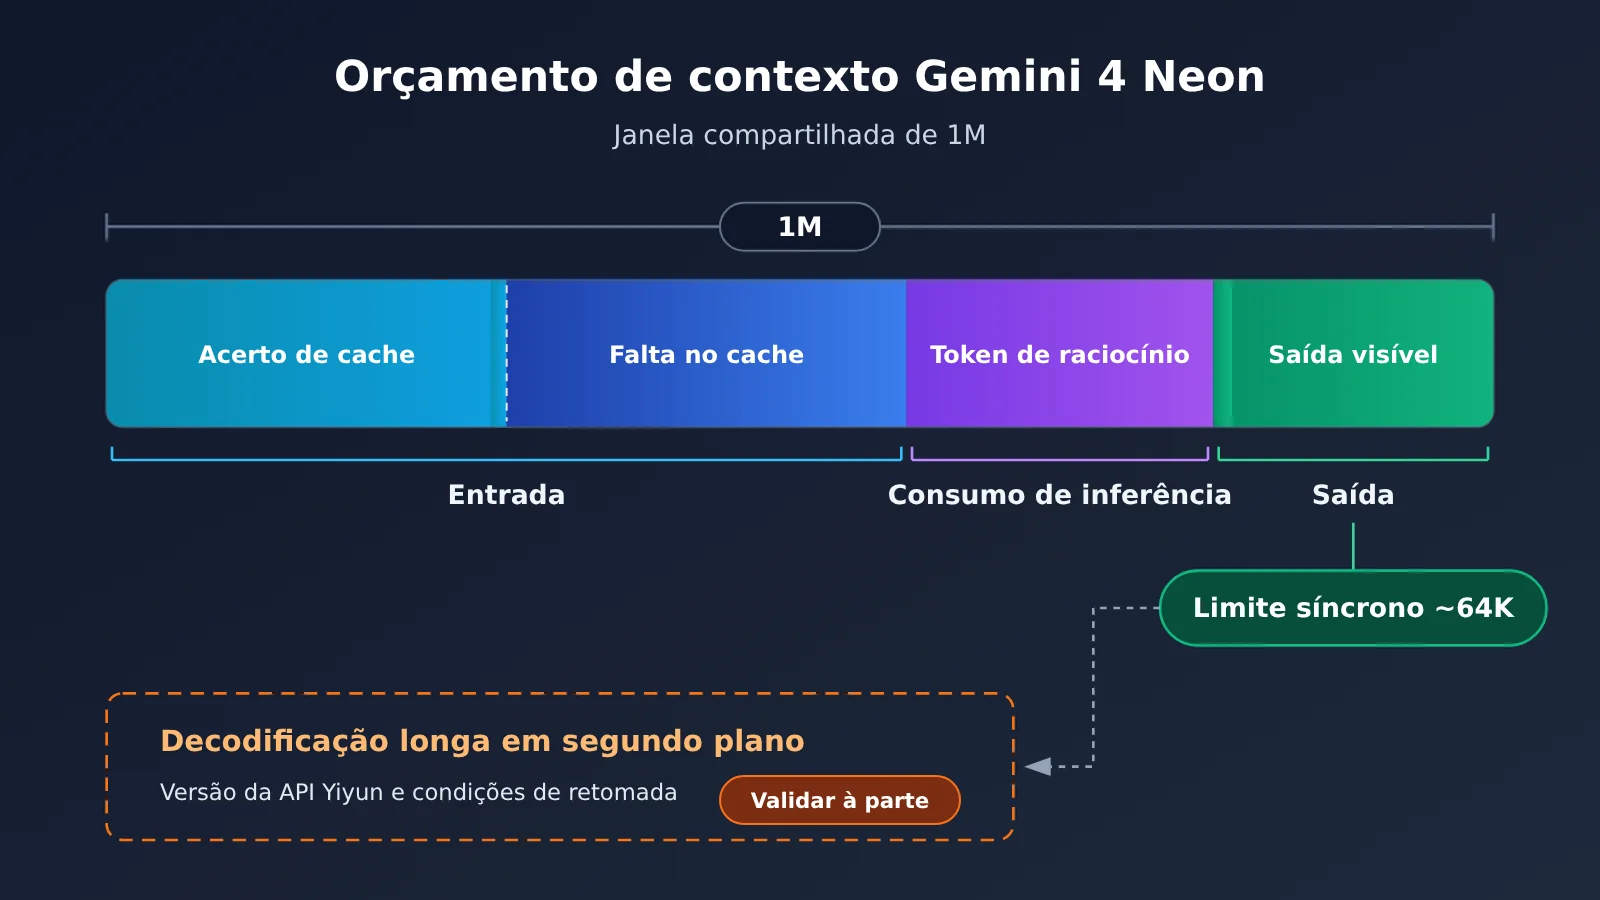
thoughtSignature: o marcador de contexto retornado pelo modelo. Em chamadas de ferramentas com múltiplas rodadas, ele deve ser preservado e devolvido conforme o protocolo original. - Janela de contexto: o orçamento total compartilhado entre entrada, raciocínio e saída. Quanto uma única geração síncrona consegue produzir precisa ser verificado separadamente no limite superior.
- Preço de leitura de cache: o preço unitário aplicável quando você reutiliza entradas existentes que atendem aos critérios — bem mais baixo que o preço padrão de entrada.
Gemini 4 Neon: pontos principais — parâmetros, preço e grupos
Segundo o anúncio de lançamento do APIYI, o Neon é a faixa intermediária da linha Gemini 4, posicionada entre o Carbon (para as tarefas mais difíceis) e o Hydrogen (para execução do dia a dia). O Google o lançou em 18 de novembro e o disponibilizou em GA no mesmo dia; o APIYI o integrou em 20 de novembro.
| Ponto | Conteúdo | Fonte e condição |
|---|---|---|
| ID do modelo | gemini-4-neon |
Registro de modelos do APIYI (gerado em 2026-11-20) |
| Grupos disponíveis | default, svip |
Anúncio de lançamento do APIYI (2026-11-20) |
| Endpoints de acesso | Gemini nativo + compatível com OpenAI | Anúncio de lançamento do APIYI; sem chamada real antes do lançamento |
| Janela de contexto | 1M, compartilhada entre entrada, raciocínio e saída | Tanto o anúncio do Google quanto o Artificial Analysis indicam 1M |
| Limite de geração síncrona | Aproximadamente 64K tokens | Documentação de lançamento do APIYI |
| Níveis de raciocínio | low/medium/high/xhigh, padrão high | Anúncio de lançamento do APIYI |
| Preço de tabela (por milhão de tokens) | Entrada $3, saída $15, leitura de cache $0.15 | Registro do APIYI; o anúncio afirma que os valores batem item a item com o site oficial e não têm data de expiração |
Relação entre a janela de contexto e o limite de saída do Gemini 4 Neon
O contexto de 1M costuma ser mal interpretado como “é possível gerar 1M de uma vez”. Na verdade, esses 1M são uma janela compartilhada por entrada, raciocínio e saída. De acordo com a documentação de lançamento do APIYI, o limite de geração em chamadas síncronas é de cerca de 64K tokens — ou seja, entradas longas não são problema, mas não espere que uma única requisição síncrona produza mais do que essa ordem de grandeza.
A documentação do Google Cloud menciona uma capacidade de decodificação longa em background, que pode chegar a 1M. Mas ela depende de uma versão específica da interface de nuvem e de condições de retomada, não sendo a mesma coisa que uma chamada síncrona comum. Para o endpoint Chat Completions compatível com o APIYI, atualmente não há resultados reais de chamadas de decodificação longa que possam ser verificados. Se o seu caso de uso exigir saídas muito longas, recomendo projetar a geração em segmentos primeiro e depois validar a decodificação longa separadamente.
Como estimar o preço do Gemini 4 Neon
Os exemplos abaixo são calculados com base no preço de tabela e não representam uma fatura real. Suponha uma requisição com 100K tokens de entrada e 5K tokens de saída visível: o custo de entrada fica em torno de $0.30, o de saída em torno de $0.075, totalizando cerca de $0.375. Se 80K da entrada vierem do cache, essa parte custa cerca de $0.012 a $0.15, e os 20K restantes custam cerca de $0.06 a $3 — o custo de entrada cai bastante.
A forma como os tokens do processo de raciocínio entram na conta e as condições em que o cache passa a valer devem ser sempre conferidas na fatura real. O anúncio de lançamento do APIYI também menciona que, a partir de 1º de dezembro, os preços promocionais do Carbon/Argon expiram e voltam para $4/$20; nesse momento, o preço de tabela do Neon fica 25% abaixo deles. Essa é uma comparação de preço do anúncio da plataforma e não envolve comparação de desempenho.
Primeiros passos com o Gemini 4 Neon: duas requisições mínimas, nativa e compatível
Vale a pena enviar uma requisição mínima por cada caminho para confirmar que o ID do modelo, o grupo e o roteamento estão corretos antes de adicionar outros recursos. Os exemplos abaixo seguem a documentação oficial do Google GenAI SDK e do OpenAI SDK; a chave é sempre um placeholder.
| Item de comparação | Endpoint nativo do Gemini | Endpoint compatível com OpenAI |
|---|---|---|
| SDK recomendado | Google GenAI SDK | OpenAI SDK |
| Formato do Base URL | Endereço raiz da plataforma, com api_version="v1beta" separado |
Endereço raiz com /v1 |
| Estrutura da requisição | contents[].parts[] |
messages[] |
| Nível de raciocínio | generationConfig.thinkingConfig.thinkingLevel |
O mapeamento de parâmetros entre endpoints exige validação separada |
| Cenários indicados | Controle refinado do raciocínio e chamadas de ferramentas em múltiplos turnos | Migração rápida de código OpenAI existente |
Exemplo do endpoint nativo do Gemini 4 Neon
O endpoint nativo usa o endereço raiz da plataforma; o prefixo de versão fica a cargo do api_version do SDK. Não escreva v1beta novamente no Base URL, senão o caminho fica duplicado.
from google import genai
from google.genai import types

client = genai.Client(
    api_key="YOUR_API_KEY",
    http_options=types.HttpOptions(
        base_url="https://api.apiyi.com",  # Endereço raiz da plataforma APIYI; a versão é definida por api_version
        api_version="v1beta",
    ),
)

resp = client.models.generate_content(
    model="gemini-4-neon",
    contents="用三句话解释什么是上下文窗口",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="medium")
    ),
)
print(resp.text)
Os nomes em snake_case do SDK acabam correspondendo aos campos em camelCase no corpo da requisição REST. Se você enviar a requisição HTTP diretamente, o corpo será mais ou menos assim; repare nos dois níveis:
{
  "contents": [
    { "role": "user", "parts": [ { "text": "用三句话解释什么是上下文窗口" } ] }
  ],
  "generationConfig": {
    "thinkingConfig": { "thinkingLevel": "medium" }
  }
}
Há dois pontos de atenção. Primeiro, os níveis antigos thinkingBudget e minimal não se aplicam ao Gemini 4; remova-os ao migrar o código. Segundo, a documentação do Google registra que o Gemini 4 ignora temperature e topP; portanto, não ver efeito ao ajustar esses dois parâmetros é o comportamento esperado.
Exemplos de endpoint compatível do Gemini 4 Neon
O endpoint compatível é ideal para projetos que já usam o OpenAI SDK. Abaixo usamos apenas o messages mais básico, para primeiro confirmar que a rota e o grupo estão funcionando.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Entrada compatível com OpenAI da APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-neon",
    messages=[{"role": "user", "content": "用三句话解释什么是上下文窗口"}],
)
print(resp.choices[0].message.content)
print(resp.choices[0].finish_reason)
Na resposta, além do conteúdo, vale a pena registrar também o finish_reason. Quando o conteúdo está vazio, ele é a primeira pista. No endpoint nativo, esses campos correspondem ao motivo de encerramento e à classificação de segurança dentro dos resultados candidatos — e também devem ser mantidos na investigação.
Ver o código encapsulado com informações de diagnóstico
import os
import time
import random
from openai import OpenAI, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url=os.environ["APIYI_BASE_URL"],  # Preencha o endereço do endpoint compatível acima
)

def ask_neon(prompt: str, max_retries: int = 3) -> str:
    """Chama o gemini-4-neon e imprime o motivo de encerramento e o uso, para facilitar o diagnóstico"""
    for attempt in range(max_retries + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-neon",
                messages=[{"role": "user", "content": prompt}],
            )
            choice = resp.choices[0]
            print("finish_reason:", choice.finish_reason)
            print("usage:", resp.usage)
            if not choice.message.content:
                print("正文为空:检查结束原因、安全状态与输出预算")
            return choice.message.content or ""
        except APIStatusError as e:
            print("status:", e.status_code, "body:", e.response.text)
            # Só repetir em caso de rate limit e indisponibilidade temporária; os demais erros devem ser lançados diretamente
            if e.status_code in (429, 503) and attempt < max_retries:
                delay = (2 ** attempt) + random.uniform(0, 1)
                time.sleep(delay)
                continue
            raise
    return ""

if __name__ == "__main__":
    print(ask_neon("列出三个适合用长上下文的任务"))
🚀 Início rápido: ao criar um token no console da APIYI apiyi.com, confirme se o grupo do token pertence a
defaultousvip. Usuários novos podem primeiro usar a cota gratuita de teste para executar cada uma das duas requisições mínimas acima. O endpoint nativo e o compatível compartilham a mesma chave; ao trocar de endpoint, basta ajustar a Base URL e a estrutura da requisição.
Como escolher o nível de pensamento do Gemini 4 Neon
Quanto mais alto o nível, mais completo fica o raciocínio, mas o tempo de execução e o custo também aumentam. O Artificial Analysis (AA) testou separadamente os quatro níveis do Neon no Intelligence Index v5.0.1, e os resultados estão abaixo.
| Nível de pensamento | Índice de inteligência AA | Tempo médio por tarefa | Descrição |
|---|---|---|---|
low |
44 | cerca de 3,7 minutos | Prioriza velocidade |
medium |
55 | cerca de 8,3 minutos | 11 pontos acima do low |
high (padrão) |
60 | cerca de 14,8 minutos | 5 pontos acima do medium |
xhigh |
61 | cerca de 21,5 minutos | Custo ponderado de cerca de US$ 6,44 por tarefa de avaliação |
Olhando para esses números, dá para ver que de medium para high ainda há um ganho claro, enquanto de high para xhigh são só 1 ponto a mais no índice, com cerca de 6,7 minutos extras por tarefa em média. Esses dados vêm do pipeline de avaliação da AA, e o custo por tarefa é calculado com os pesos dos nove testes. Já o tempo e a conta em cenários como leitura de documentos e perguntas e respostas interativas precisam ser medidos por você mesmo — e a latência de ponta a ponta, a taxa de sucesso e a fatura real do APIYI também exigem medição à parte.
Uma forma de decidir o nível é esta: para tarefas de perguntas e respostas sensíveis à latência, comece com low ou medium; quando precisar de raciocínio em várias etapas, mantenha o high padrão; e só vale a pena pagar o tempo e o custo extras do xhigh depois de confirmar, no seu próprio conjunto de testes fixo, que ele traz um ganho realmente significativo.
Gemini 4 Neon vs. modelos da mesma categoria
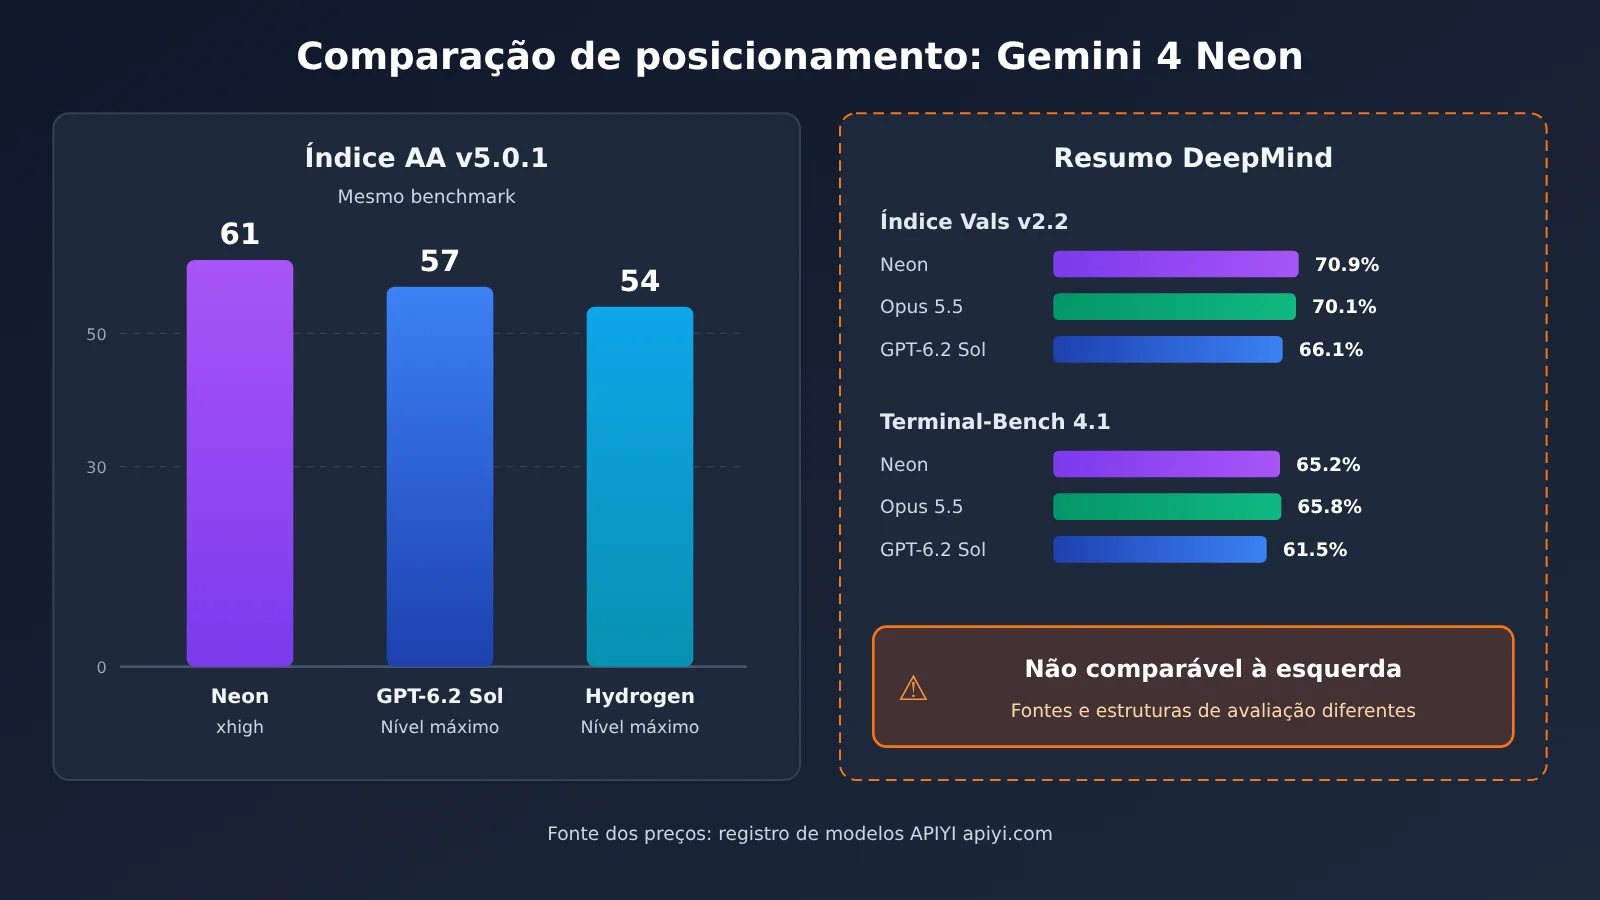
Para comparar modelos diferentes, o ideal é usar sempre o mesmo benchmark e níveis equivalentes. As duas primeiras colunas da tabela abaixo vêm da mesma versão do AA, e os preços vêm do registro do APIYI.
| Modelo | AA Index v5.0.1 (nível mais alto) | Entrada/saída padrão (por milhão de tokens) | Plataformas disponíveis |
|---|---|---|---|
| Gemini 4 Neon | 61 (xhigh) | $3 / $15 | APIYI apiyi.com e outros |
| GPT-6.2 Sol | 57 | $2 / $10 | APIYI e outros |
| Gemini 4 Hydrogen | 54 | conforme o registro | APIYI e outros |
O GPT-6.2 Sol tem preço menor: entrada e saída custam um terço a menos que o Neon. Mas, no mesmo benchmark do AA, o Neon em xhigh fica 4 pontos acima do nível mais alto do Sol. Vale lembrar que a diferença de pontuação não se converte diretamente em diferença de acurácia no seu negócio, e a latência e o consumo real de tokens de cada um também precisam ser medidos separadamente.
Outra referência é o compilado de avaliações publicado pelo Google DeepMind: no Vals Index v2.2, o Neon aparece com 70,9%, o Claude Opus 5.5 com 70,1% e o GPT-6.2 Sol com 66,1%; no Terminal-Bench 4.1, as acurácias ajustadas são, na ordem, 65,2%, 65,8% e 61,5%. Esse compilado usa claramente fontes de avaliação e frameworks de execução diferentes, e no Terminal-Bench o Opus 5.5 fica até um pouco acima do Neon. Dá para usar como indicação de tendência, mas a escolha deve se basear nas mesmas tarefas, rodadas na sua própria toolchain.
💡 Sugestão de escolha: separe de 20 a 50 questões fixas que representem o seu negócio real e, no APIYI apiyi.com, use a mesma chave API para chamar, em sequência, os diferentes níveis do Neon e os modelos candidatos. Registre acurácia, tempo de execução e custo antes de decidir.
Solução de erros comuns na integração do Gemini 4 Neon
Quando surgir um problema, volte primeiro àquela requisição mais curta mencionada acima para comparar, confirme que a cadeia básica está funcionando e só então investigue item por item as funcionalidades adicionadas.
| Sintoma | Verificação prioritária | Direção de correção |
|---|---|---|
| 404 / modelo indisponível | ID do modelo, grupo do token, roteamento, prefixo de versão | Copie literalmente gemini-4-neon; no SDK OpenAI, use a entrada compatível com /v1; no SDK GenAI, use o endereço raiz mais v1beta; evite concatenar o prefixo de versão repetidamente |
| 400 / comportamento diferente após trocar o nível | Parâmetros nativos de pensamento, campos do corpo da requisição compatível | No endpoint nativo, use thinkingLevel para confirmar se o nível está ativo; remova thinkingBudget e minimal; não misture campos dos dois protocolos |
| 200, mas corpo vazio | Motivo de término, status de segurança, orçamento de saída | Confirme se o orçamento de saída consegue acomodar ao mesmo tempo o pensamento e a saída visível; verifique as informações de filtro de segurança |
| Falha na segunda rodada da chamada de ferramenta | thoughtSignature, pareamento entre chamada de ferramenta e resposta |
Devolva a assinatura de pensamento exatamente como foi recebida e faça cada resposta de ferramenta corresponder à chamada correta |
| 429 / 503 temporário no upstream | Corpo do erro, limite de tokens, restrições de concorrência | Em caso de limitação de taxa por curto período ou indisponibilidade, use backoff exponencial com número limitado de tentativas e jitter; problemas de saldo ou de permissão exigem corrigir a configuração antes de reenviar |
Distinção entre 404 e 400 no Gemini 4 Neon
O 404 normalmente indica que a requisição não foi roteada para esse modelo, ou seja, o problema é “não encontrado”: ID digitado errado, grupo de tokens que não inclui o modelo, ou URL montada com caminhos duplicados como /v1/v1/... e /v1beta/v1beta/.... Já o 400 quer dizer que a requisição chegou, mas o corpo não está de acordo com o protocolo — o caso mais comum é incluir campos nativos em uma requisição compatível ou continuar usando parâmetros antigos da época do Gemini 2.x.
O mapeamento de parâmetros entre endpoints precisa ser validado separadamente. Se você tentar controlar a intensidade de raciocínio no endpoint compatível e não obtiver o efeito esperado, volte primeiro ao endpoint nativo para confirmar se o nível realmente está funcionando; só então decida se o problema é de parâmetro ou de mapeamento.
Corpo vazio e falha em chamadas de ferramentas no Gemini 4 Neon
Quando o HTTP 200 vem sem corpo, o primeiro passo é olhar o motivo de término. Se a truncagem foi por comprimento, isso indica que o processo de raciocínio já ocupou o orçamento de saída e não sobrou espaço para o texto visível; se foi por motivo de segurança, é preciso ajustar o conteúdo de entrada. Níveis de raciocínio mais altos tendem mais ao primeiro caso.
Falhas em chamadas de ferramentas em múltiplas rodadas normalmente têm a ver com o thoughtSignature. Segundo a documentação Thought signatures do Google, a assinatura retornada pelo modelo precisa ser enviada de volta exatamente como está nas rodadas seguintes, seguindo o protocolo original, e cada chamada de ferramenta precisa ter uma resposta de ferramenta correspondente. Ao investigar, você pode começar removendo as ferramentas e usando a requisição mais curta sem ferramentas como controle; depois, vá adicionando as ferramentas de volta aos poucos.
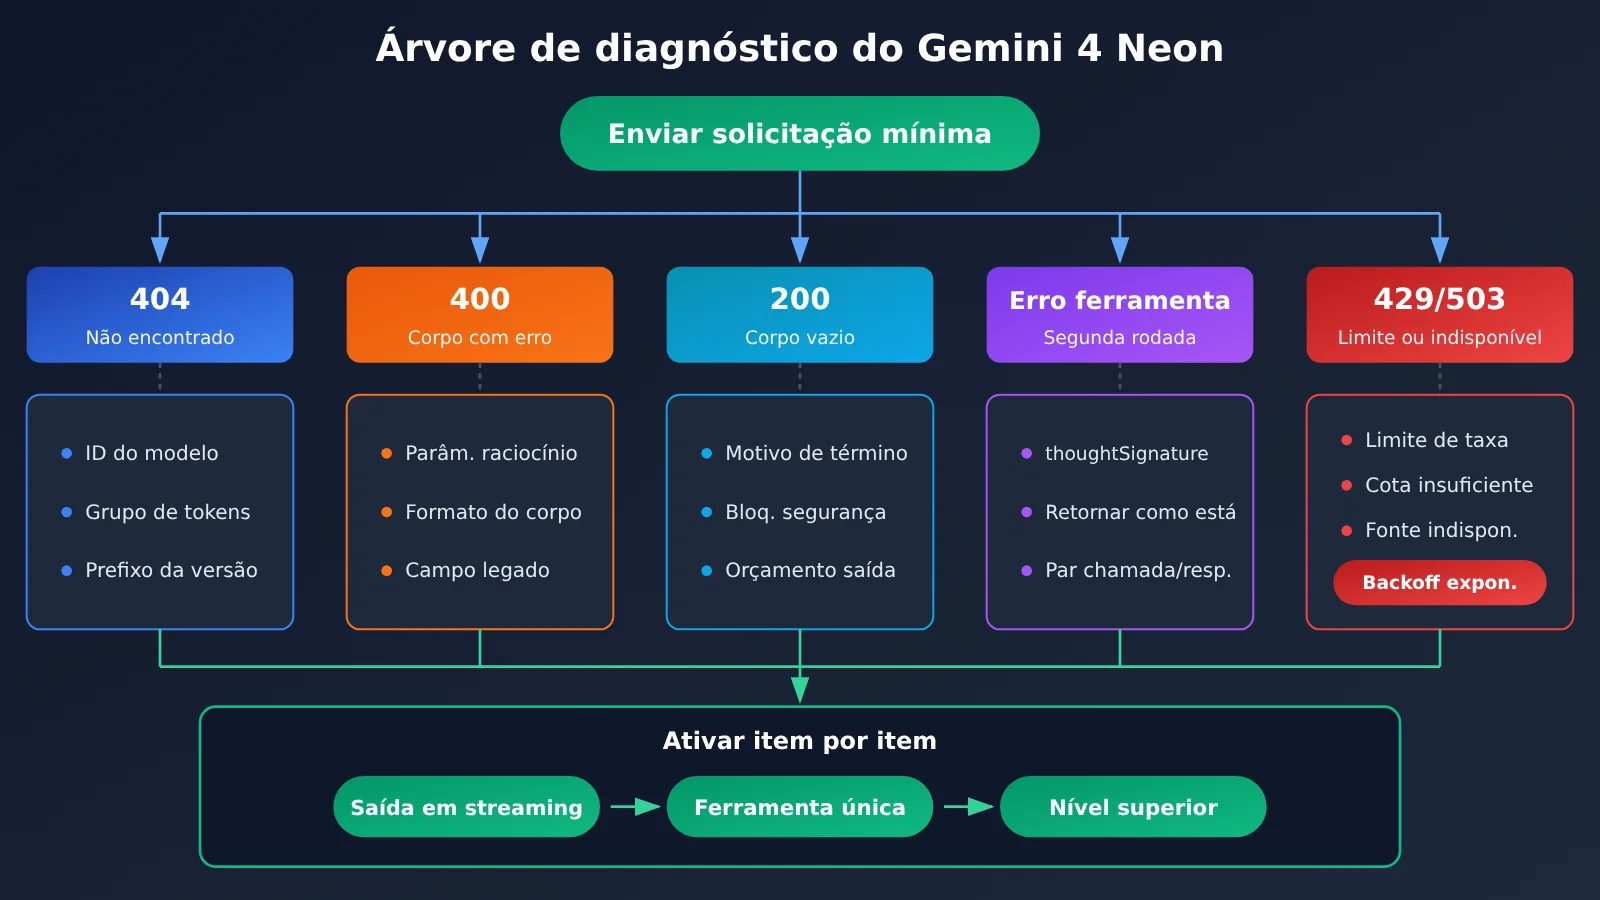
Ordem de validação recomendada do Gemini 4 Neon
Depois que a requisição mínima funcionar, recomendamos ativar os recursos um a um na ordem abaixo, confirmando o resultado de cada etapa separadamente:
- Faça uma requisição de texto puro, sem streaming, sem ferramentas e no nível padrão, para confirmar que o ID, o grupo e o roteamento estão funcionando corretamente.
- Ative a saída em streaming e confirme se a montagem dos chunks e a leitura do motivo de término estão corretas.
- Adicione uma única ferramenta, execute o ciclo completo de duas rodadas “chamada → retorno do resultado → resposta final” e verifique se
thoughtSignatureé preservado. - No endpoint nativo, alterne entre
low/medium/xhighe use um conjunto fixo de testes para comparar qualidade, tempo de execução e cobrança. - Por último, adicione otimizações relacionadas a custo, como entradas longas e reutilização de cache.
Perguntas frequentes (FAQ)
Q1: O que é o Gemini 4 Neon?
O Gemini 4 Neon é um modelo de nível intermediário do Gemini 4, lançado pelo Google em 18 de novembro de 2026 e disponibilizado em GA no mesmo dia. Ele fica posicionado entre Carbon e Hydrogen. Oferece 1M de contexto compartilhado e quatro níveis de intensidade de raciocínio, com ID de modelo `gemini-4-neon`.
Q2: Como escolher entre Gemini 4 Neon e GPT-6.2 Sol?
No mesmo benchmark do AA Intelligence Index v5.0.1, o Neon no nível `xhigh` tem 61 pontos, enquanto o Sol no nível mais alto tem 57 pontos. No entanto, o preço de tabela do Sol é US$ 2/US$ 10, mais baixo que os US$ 3/US$ 15 do Neon. Uma diferença de pontuação não equivale a uma diferença de acurácia no cenário real. Recomendamos comparar qualidade, latência e consumo real de tokens no seu próprio conjunto de testes antes de decidir.
Q3: Quando o Gemini 4 Neon estará disponível na APIYI?
A APIYI disponibilizou esse modelo em 20 de novembro de 2026, abrindo os grupos `default` e `svip`. Segundo o anúncio de lançamento, o preço padrão não tem data de validade.
Q4: Em quais cenários o Gemini 4 Neon é mais indicado?
– **Análise de documentos longos**: a janela de 1M permite inserir muitos materiais de uma vez, mas o limite de saída síncrona por chamada é de cerca de 64K.
– **Raciocínio em várias etapas e tarefas de agentes**: o nível `high` padrão equilibra qualidade e tempo de execução; para chamadas de ferramentas, recomendamos usar o endpoint nativo.
– **Processamento em lote com custo controlado**: use `low`/`medium` com reutilização de cache para reduzir o custo por chamada.
Q5: Como chamar o Gemini 4 Neon rapidamente pela API?
1. Cadastre-se na APIYI (apiyi.com) e receba a cota gratuita de testes.
2. Crie um token pertencente ao grupo `default` ou `svip`.
3. Se você já tem código OpenAI, use o endpoint compatível; se precisar controlar o nível de raciocínio, integre ao endpoint nativo usando o Google GenAI SDK.
Nos dois caminhos, recomendamos primeiro executar a requisição mínima deste artigo e confirmar que a integração está funcionando antes de adicionar recursos.
Q6: Quais são as limitações conhecidas do Gemini 4 Neon?
– **Limite de saída**: 1M é a janela compartilhada, e o limite de geração síncrona é de cerca de 64K; gerações longas dependem de interfaces de nuvem específicas e de condições de continuação.
– **Mudanças de parâmetros**: `thinkingBudget` e `minimal` não se aplicam mais; `temperature` e `topP` são ignorados.
– **Status de validação**: antes do lançamento na APIYI, apenas a interface de preços foi verificada; para os dois endpoints e chamadas de ferramentas, recomendamos validar primeiro com suas próprias requisições na APIYI (apiyi.com).
Principais pontos do Gemini 4 Neon
- Identidade do modelo:
gemini-4-neon, faixa intermediária do Gemini 4, lançado pelo Google em 18 de novembro. - Limites de especificação: contexto compartilhado de 1M, limite de geração síncrona de cerca de 64K; decodificação longa precisa ser validada separadamente.
- Preço de tabela: US$ 3 por milhão de tokens de entrada, US$ 15 de saída e US$ 0,15 de leitura de cache; o valor real deve ser conferido na fatura.
- Trade-off entre níveis: nos testes da AA, ir de
highparaxhighrende só 1 ponto a mais, mas cada tarefa leva cerca de 6,7 minutos adicionais. - Escolha do endpoint: para controlar o nível de raciocínio, use o endpoint nativo; para reaproveitar código existente, use o endpoint compatível.
- Ordem de troubleshooting: comece pela requisição mínima e depois ative streaming, ferramentas e níveis mais altos.
Resumo
Os pontos principais da integração do Gemini 4 Neon podem ser resumidos em três:
- Confira as especificações primeiro: 1M é uma janela compartilhada, a saída síncrona fica em cerca de 64K, o preço de tabela é US$ 3/US$ 15 e a leitura de cache custa US$ 0,15.
- Execute uma vez em cada endpoint: o endpoint nativo usa o endereço raiz com
v1beta; o endpoint compatível usa o endereço com/v1; não misture os campos. - Escolha o nível com base em dados: a pontuação da AA é apenas referência; no fim, valem o desempenho, o tempo e a fatura no seu próprio conjunto fixo de testes.
Depois de confirmar a forma de integração, recomendo comparar no APIYI apiyi.com, usando a mesma chave API, os diferentes níveis do Neon e outros modelos candidatos, para só então decidir a configuração padrão do ambiente de produção.
📚 Referências
-
APIYI Gemini 4 Neon: novidades do lançamento — grupos, endpoints, preços e limite de saída
- Link:
docs.apiyi.com/live/2026-11/gemini-4-neon-launch - Descrição: publicado em 2026-11-20, traz informações sobre os quatro níveis de raciocínio e o nível padrão
- Link:
-
Anúncio oficial do Google Gemini 4 Neon — informações oficiais do lançamento
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/ - Descrição: publicado em 2026-11-18, inclui detalhes sobre a janela de contexto e o posicionamento do modelo
- Link:
-
Página do modelo Gemini 4 Neon no Artificial Analysis — avaliações independentes dos quatro níveis
- Link:
artificialanalysis.ai/models/gemini-4-neon - Descrição: pontuações e tempos do Intelligence Index v5.0.1, com métricas atualizadas dinamicamente
- Link:
-
Google Gemini API Troubleshooting e Thought signatures — documentação de solução de problemas e assinaturas de pensamento
- Links:
aistudio.google.com/docs/troubleshooting,aistudio.google.com/docs/thought-signatures - Descrição: significado dos códigos de erro e regras de retorno das assinaturas em chamadas de ferramentas com múltiplos turnos
- Links:
-
Gemini 4 Neon Model Evaluation — resumo das avaliações do DeepMind
- Link:
storage.googleapis.com/deepmind-media/gemini/gemini_4_neon_model_evaluation.pdf - Descrição: resultados de avaliação de várias fontes e frameworks; ao citar, indique a configuração utilizada
- Link:
Autor: equipe técnica da APIYI
Suporte técnico: se você encontrar problemas durante a integração, fale com a gente pelo site oficial da APIYI. Para mais detalhes sobre as interfaces, consulte o centro de documentação em docs.apiyi.com