Nota do autor: em novembro de 2026, novos modelos foram lançados em ritmo acelerado. Este artigo mostra como trocar de modelo usando uma única entrada, integrar por endpoint e separar a cobrança de cada canal.
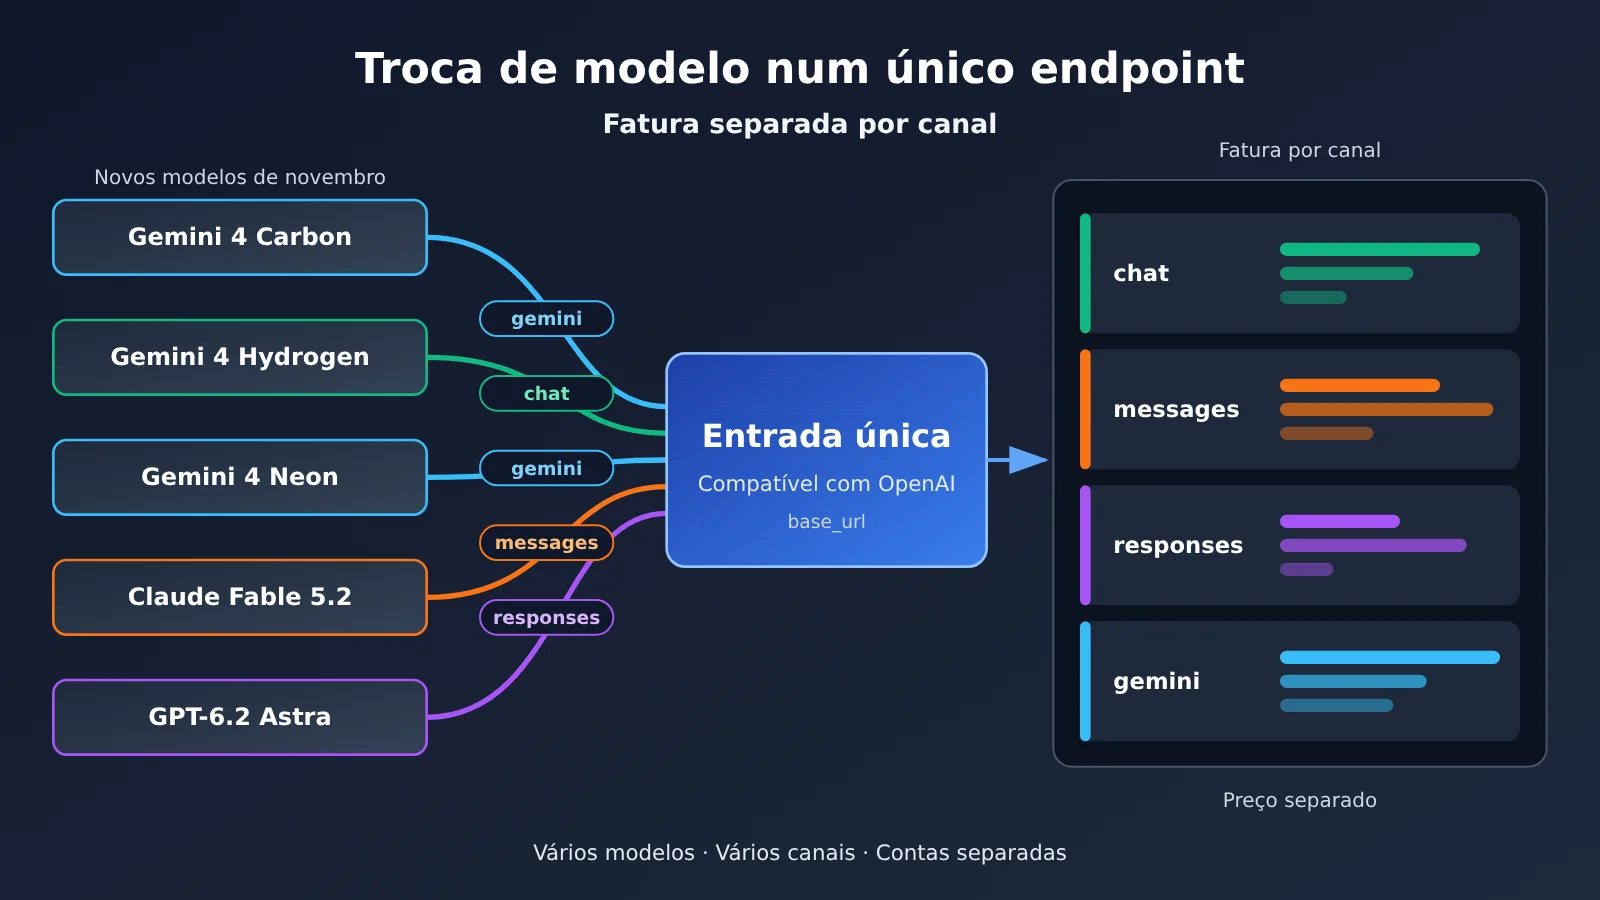
Passadas apenas três semanas de novembro, o Google já lançou três modelos Gemini 4: Carbon em 10 de novembro, Hydrogen em 12 de novembro e Neon em 18 de novembro. Nas áreas de imagem, código e outras, novos modelos também foram aparecendo nas notícias aos poucos. Para quem quer testar modelos novos, a dificuldade não está em escrever o código de chamada, mas em cada fornecedor ter seu próprio SDK, seu próprio esquema de autenticação e sua própria forma de cobrança. Este artigo apresenta uma abordagem mais prática: uma única entrada para trocar de modelo, e a fatura separada por canal.
Isto não é uma lista promocional de “pacote completo de novos modelos”. Os modelos que aparecem nas notícias e os modelos que já podem ser chamados na plataforma serão tratados separadamente neste artigo. Por exemplo, o MAI Image 2.7 das notícias ainda não está disponível na prateleira da APIYI, então não será tratado aqui como um modelo que pode ser chamado.
Valor central: depois de ler este artigo, você saberá onde consultar primeiro a lista de modelos, como decidir qual ID de modelo trocar, qual endpoint cada tipo de modelo deve usar e como evitar estimar a fatura inteira com o preço unitário de um único fornecedor. Os modelos e preços mencionados abaixo têm como base a lista de modelos e a interface de preços da APIYI apiyi.com em 2026-11-20.
Pontos essenciais para integração de novos modelos em novembro
Quando novos modelos chegam em massa, os erros mais comuns se concentram em três lugares: tratar o nome divulgado na notícia como um modelo já disponível na plataforma, usar o endpoint errado e estimar todos os custos com um único preço unitário. A tabela abaixo reúne esses três pontos e o que fazer em cada caso.
| Ponto | Descrição | Valor |
|---|---|---|
| Conferir primeiro a lista de modelos | Use a tabela geral da plataforma e a API de preços como referência, e anote separadamente os modelos divulgados na imprensa e os que realmente podem ser chamados | Evita chamar direto o nome do modelo do evento de lançamento e receber erro |
| Trocar de modelo = trocar o ID do modelo + verificar o endpoint | Basta alterar o parâmetro model sob o mesmo base_url e confirmar se a chamada vai por chat, messages, responses ou gemini |
Não é preciso escrever um SDK para cada fabricante |
| Ver a fatura por canal | Registre separadamente tokens de entrada, de saída e de leitura de cache por modelo e por endpoint | Modelos cujos preços unitários diferem em várias vezes não acabam misturados numa média, e o custo fica rastreável |
| Preço de lançamento tem data limite | Alguns modelos novos têm preço introdutório por tempo limitado, e depois do prazo o preço oficial padrão muda | Dá para estimar o orçamento do mês seguinte com antecedência e não ser pego de surpresa por reajustes |
Detalhes do novo modelo: modelo de notícia ≠ modelo na prateleira
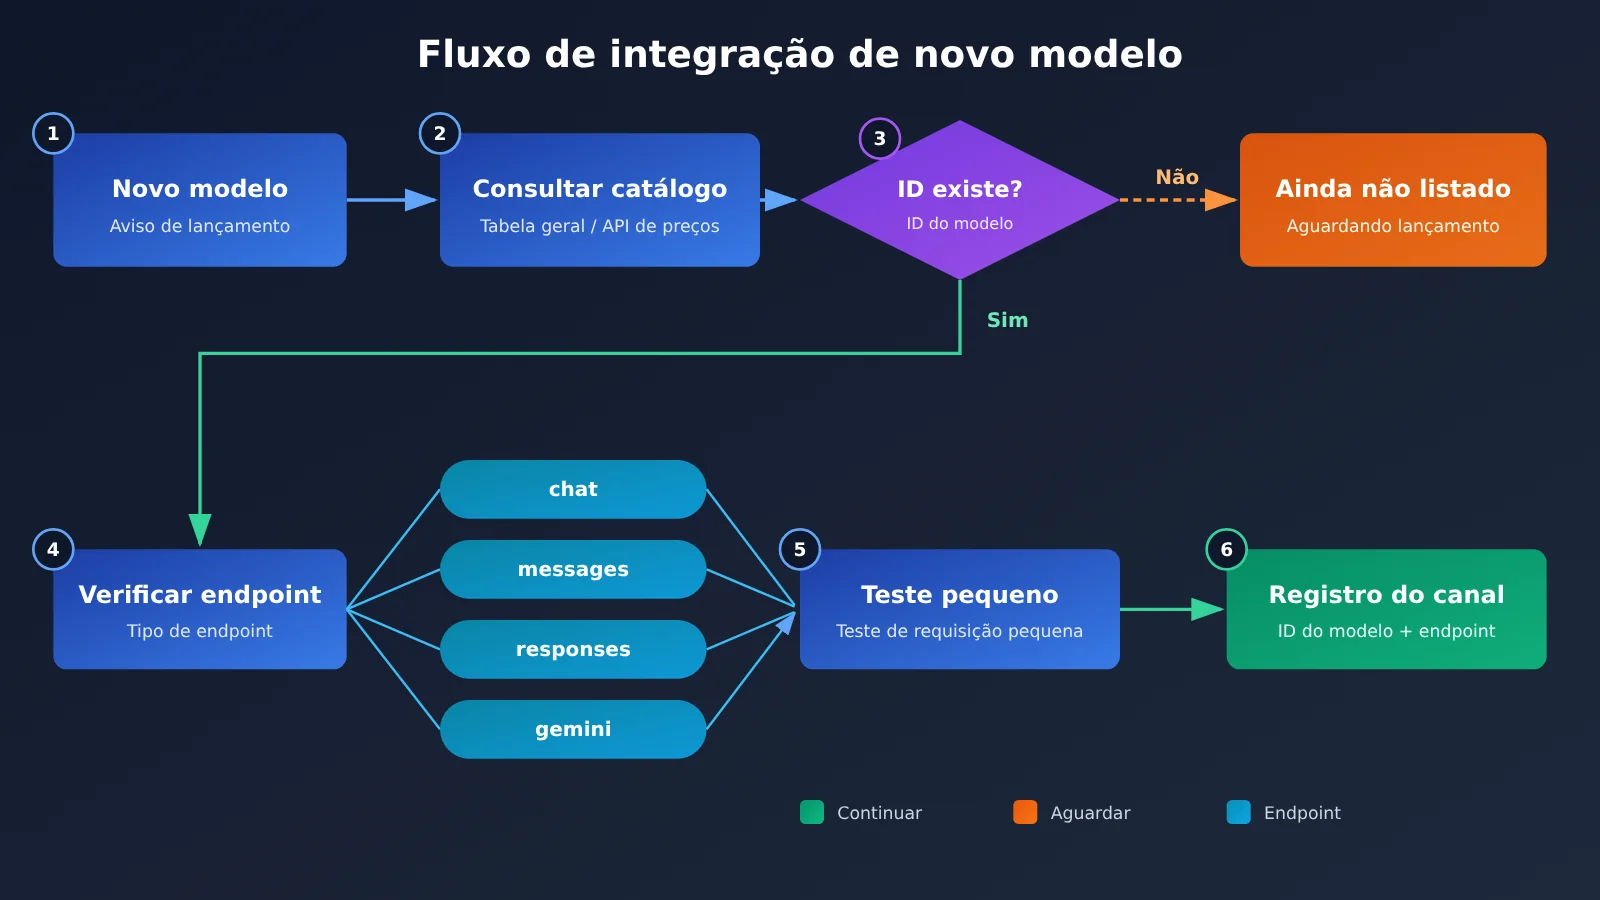
O primeiro passo da integração é consultar a prateleira, não escrever código. O endereço da tabela geral de modelos da APIYI é docs.apiyi.com/models.md, e a versão usada como referência neste artigo foi atualizada em 2026-11-19 10:59 (UTC+8). Há também uma API de preços legível por máquina, https://api.apiyi.com/api/pricing, com identificador de versão shell-api-modelmak-v1. As duas podem se atualizar em ritmos diferentes — por exemplo, gemini-4-neon ainda não aparece nessa versão da tabela geral, mas a API de preços já traz todos os campos de preço. Por isso, para decidir “se dá para chamar”, vale consultar os dois: se qualquer um deles tiver o registro, confirme com uma requisição pequena.
O caso inverso também merece atenção. O MAI Image 2.7 é um modelo de imagem que apareceu nas notícias recentes, mas a tabela geral e a API de preços da APIYI têm hoje apenas MAI-Image-2.6 e MAI-Image-2.6-Flash, sem o 2.7. Ou seja, o MAI Image 2.7 ainda não está disponível na plataforma; vamos disponibilizá-lo assim que possível, e aí o nome e o preço serão os da lista de modelos da plataforma. Além disso, Kling, Muse e gemini-4-flash-lite não aparecem nem na tabela geral nem na API de preços no momento, então não os inclua no planejamento.
Comparativo entre os novos modelos de novembro e o status na plataforma
A tabela abaixo relaciona, um a um, os modelos mencionados nas notícias de novembro com o status na plataforma em 2026-11-20. A tabela traz apenas informações verificáveis nos materiais; o que não foi confirmado não é especulado.
| Modelo | Informação da notícia | Status na APIYI (2026-11-20) | ID do modelo |
|---|---|---|---|
| Gemini 4 Carbon | Lançado em 2026-11-10, voltado a tarefas longas e difíceis | Consultável na tabela geral e na interface de preços | gemini-4-carbon |
| Gemini 4 Hydrogen | Lançado em 2026-11-12, versão cotidiana e rápida | Consultável na tabela geral e na interface de preços | gemini-4-hydrogen |
| Gemini 4 Neon | Lançado em 2026-11-18, capacidade intermediária | Já consta na interface de preços, mas não está listado na tabela geral desta versão | gemini-4-neon |
| Gemini 4 Argon | — | Consultável na tabela geral | gemini-4-argon |
| MAI Image 2.7 | Modelo de imagem mencionado nas notícias | Ainda não disponível, será disponibilizado o quanto antes | Conforme a lista da plataforma |
| MAI Image 2.6 / 2.6 Flash | — | Consultável, cobrança por uso | MAI-Image-2.6 / MAI-Image-2.6-Flash |
O posicionamento das três versões do Gemini 4 pode ser entendido de forma simples: o Carbon é voltado a tarefas com cadeias longas e alto grau de dificuldade, o Hydrogen prioriza velocidade e é adequado a chamadas cotidianas de alta frequência, e o Neon fica entre os dois. Na hora de escolher, primeiro selecione a versão conforme a dificuldade da tarefa e depois olhe o preço; assim é mais seguro do que simplesmente pegar o mais barato.
Novos modelos de novembro: comece rápido trocando o modelo em um único ponto de entrada
Exemplo minimalista: mude dois parâmetros e troque de modelo
A APIYI oferece uma interface compatível com OpenAI. Ao integrar novos modelos, a maioria das mudanças se resume a dois lugares: base_url e model. Usando o SDK oficial Python da OpenAI como exemplo, os passos mínimos são:
- Instale o SDK:
pip install openai - Crie o cliente:
client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Inicie a conversa:
client.chat.completions.create(model="gemini-4-hydrogen", messages=[{"role": "user", "content": "Hello!"}]) - Leia o resultado:
response.choices[0].message.content
Para trocar de Hydrogen para Carbon, basta mudar model="gemini-4-hydrogen" para model="gemini-4-carbon"; o cliente, a autenticação e a estrutura das mensagens não precisam mudar. É esse o significado de “trocar o modelo em um único ponto de entrada”: trocar de modelo geralmente é trocar o ID do modelo e conferir o endpoint, sem precisar escrever um SDK separado para cada fornecedor.
Ver a abordagem completa de integração (incluindo troca de endpoint e contabilização por canal)
Em um projeto completo, recomenda-se colocar o mapeamento “ID do modelo → endpoint” em uma configuração, em vez de espalhá-lo pelo código:
1. Defina o item de configuração `MODEL_ROUTES`, em que cada registro contém três campos: `model`, `endpoint` e `price_key`. Por exemplo, `gemini-4-neon` corresponde a `chat`, `claude-fable-5-2` corresponde a `messages` e `gpt-6.2-astra` corresponde a `responses`.
2. Encapsule a função `call_model(model, prompt)`: de acordo com o `endpoint`, chame `client.chat.completions.create`, `client.responses.create`, ou faça a requisição no formato Messages usando o SDK da Anthropic (base_url igual ao acima).
3. Após cada requisição, leia os tokens de entrada, de saída e de cache do campo `usage` da resposta e grave no livro-razão local usando `model + endpoint` como chave de canal.
4. Todos os dias, faça uma requisição agendada à interface de preços; converta o preço unitário com base em `model_ratio`, `completion_ratio` e `cache_ratio`, depois multiplique pela quantidade de tokens no livro-razão para obter o custo estimado de cada canal.
5. Quando uma chamada falhar, registre o `model` e a mensagem de erro. Se a mensagem indicar que o modelo não existe, volte e confira a lista de modelos antes de tentar novamente às cegas.
Assim, quando um novo modelo for lançado, basta adicionar uma linha de configuração em `MODEL_ROUTES` e o código de negócio não precisa ser alterado.
🚀 Dica para começar rápido: primeiro se registre em APIYI apiyi.com e resgate o crédito gratuito de teste para novos usuários; use um modelo do dia a dia como o Hydrogen para validar o fluxo de ponta a ponta e depois troque para Neon e Carbon para comparar os resultados. Todo o processo precisa apenas de uma única chave API.
Comparação de endpoints dos novos modelos: não coloque todos os modelos no chat
“Um ponto de entrada único” não significa “um endpoint único”. Os modelos de texto que já podem ser invocados têm endpoints diferentes; ao trocar de modelo, é obrigatório verificar esta etapa:
| Série de modelos | Exemplo de ID de modelo | Endpoints disponíveis | Observação |
|---|---|---|---|
| Série Gemini 4 | gemini-4-carbon / gemini-4-neon / gemini-4-hydrogen |
chat ou gemini | chat é o /v1/chat/completions compatível com OpenAI; gemini é o formato nativo do Gemini, e o caminho específico segue a documentação da plataforma |
| Claude Fable 5.2 | claude-fable-5-2 / claude-fable-5-2-thinking |
chat ou messages | messages é o /v1/messages no estilo Anthropic |
| GPT-6.2 Astra | gpt-6.2-astra |
recomendado: responses | recomenda-se usar /v1/responses |
| MAI Image 2.6 | MAI-Image-2.6 / MAI-Image-2.6-Flash |
geração de imagens | cobrança por chamada; a forma de invocação segue a documentação da plataforma |
Na prática, se a equipe já tiver muito código baseado no formato chat, Gemini e Claude podem continuar usando o endpoint chat por enquanto, com o menor custo de migração. Quando precisar usar as capacidades nativas do provedor, aí sim mude para os endpoints gemini ou messages. Já o GPT-6.2 Astra é recomendável integrar diretamente pelo endpoint responses; não force o chat só por hábito.
Faturamento dos novos modelos de novembro: analisando por canal
Primeiro, aprenda a ler a interface de preços
A interface de preços da APIYI expressa o preço em multiplicadores, e a conversão funciona assim:
- Preço unitário de entrada =
model_ratio × 2(unidade: dólares por milhão de tokens; quandomodel_ratioé 1, equivale a$2 / 1M) - Preço unitário de saída = preço de entrada ×
completion_ratio - Preço unitário de leitura de cache = preço de entrada ×
cache_ratio
Pegue o gemini-4-neon como exemplo: a interface de preços informa model_ratio 1.5, completion_ratio 5 e cache_ratio 0.05. Depois da conversão, a entrada fica em $3 / 1M, a saída em $15 / 1M e a leitura de cache em $0.15 / 1M, batendo com a tabela de preços do Google. Uma vez que você domina esse método de conversão, assim que um novo modelo entra no catálogo já consegue calcular o preço unitário sozinho a partir de https://api.apiyi.com/api/pricing, sem precisar esperar pela atualização do artigo.
Comparativo de preços por canal (verificado em 2026-11-20)
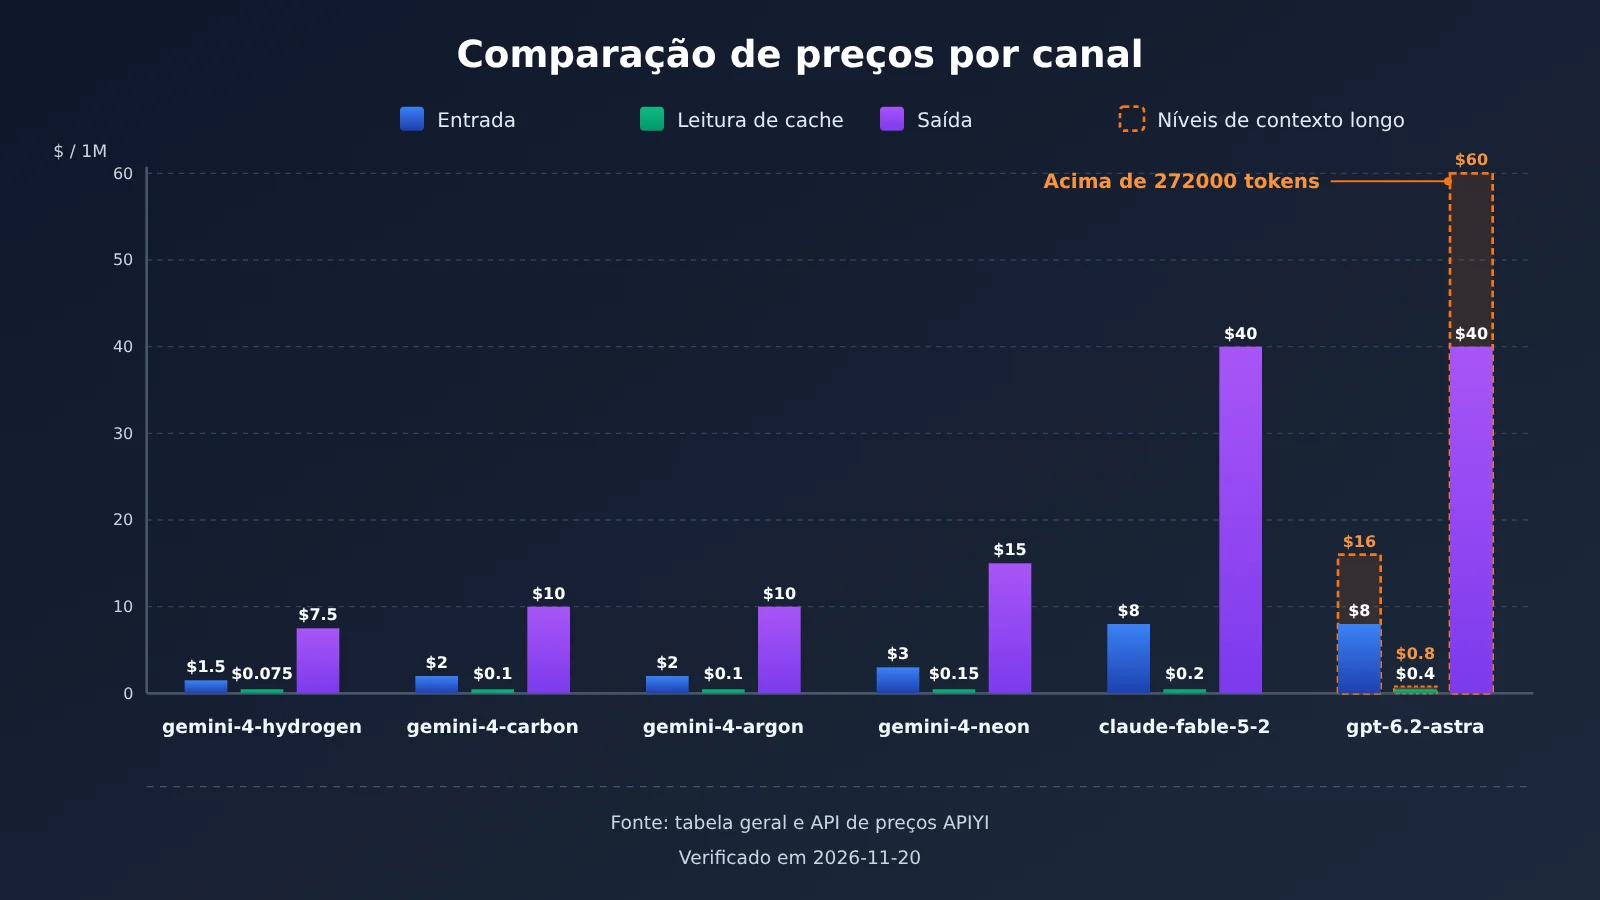
📊 Observação sobre a fonte dos dados: os preços do gráfico acima e da tabela abaixo vêm da tabela geral de modelos e da interface de preços do APIYI apiyi.com, com data de verificação em 2026-11-20. Ajustes posteriores devem seguir a lista em tempo real da plataforma.
| Canal (ID do modelo) | Entrada | Leitura de cache | Saída | Observações |
|---|---|---|---|---|
gemini-4-hydrogen |
$1.5 / 1M |
$0.075 / 1M |
$7.5 / 1M |
Faixa rápida do dia a dia |
gemini-4-carbon |
$2 / 1M |
$0.1 / 1M |
$10 / 1M |
Corresponde ao preço promocional do Google válido até 2026-11-30 |
gemini-4-argon |
$2 / 1M |
$0.1 / 1M |
$10 / 1M |
Retirado da tabela geral |
gemini-4-neon |
$3 / 1M |
$0.15 / 1M |
$15 / 1M |
Retirado da interface de preços |
claude-fable-5-2 / -thinking |
$8 / 1M |
$0.2 / 1M |
$40 / 1M |
Os dois IDs têm o mesmo preço |
gpt-6.2-astra (primeira faixa) |
$8 / 1M |
$0.4 / 1M |
$40 / 1M |
Acima de 272000 tokens, veja abaixo |
MAI-Image-2.6 |
Por chamada $0.12 |
— | — | Imagem |
MAI-Image-2.6-Flash |
Por chamada $0.06 |
— | — | Imagem |
Há dois pontos na tabela que precisam de explicação separada.
O primeiro é a faixa de contexto longo do GPT-6.2 Astra. A tabela geral informa que, acima de 272000 tokens, a entrada passa para $16 / 1M; já a interface de preços detalha ainda que, acima de 272000 tokens, a saída é calculada a $60 / 1M e a leitura de cache a $0.8 / 1M. Se o seu negócio costuma trabalhar com contextos muito longos, é essencial estimar por faixas separadas — não use o preço da primeira faixa para todos os requests.
O segundo é o preço promocional do Gemini 4 Carbon. O preço atual corresponde à introdução do Google válida até 2026-11-30; a partir de 1º de dezembro, o preço padrão do Google passa a ser $4 / 1M na entrada e $20 / 1M na saída. Os preços futuros da plataforma devem seguir a lista de modelos do APIYI, e para o orçamento de dezembro vale reservar essa diferença.
Por que não dá para resumir tudo com o preço unitário de um único fornecedor
Como dá para ver na tabela acima, para a mesma saída de um milhão de tokens, o Hydrogen custa $7.5, enquanto o Claude Fable 5.2 e o GPT-6.2 Astra, na primeira faixa, custam $40 — uma diferença de mais de cinco vezes. Se a equipe roda três ou quatro modelos ao mesmo tempo, olhar só para um “preço médio por unidade” ou para o preço de um único fornecedor leva facilmente a subestimar ou superestimar bastante o custo. A abordagem mais segura é usar “ID do modelo + endpoint” como chave de canal, registrar separadamente, por canal, os tokens de entrada, de saída e de leitura de cache, multiplicar cada um pelo seu respectivo preço unitário e só então somar tudo.
Vale notar também que um ponto de entrada unificado resolve o custo de integração — o que não significa que todo modelo saia necessariamente mais barato. Na tabela acima, vários modelos Gemini 4 têm preço igual ao preço de tabela do Google. Se vale a pena ou não deve ser avaliado canal por canal, comparando com o seu uso real, em vez de generalizar.
💰 Dica de custo: ao fazer a comparação de seleção, você pode usar a APIYI apiyi.com para chamar Hydrogen, Neon e Carbon com o mesmo conjunto de amostras de teste, anotar o consumo de tokens por canal, calcular o custo real por chamada de cada canal e então decidir o modelo principal.
Perguntas frequentes (FAQ)
P1: O que significa “um único ponto de entrada para trocar de modelo”?
Significa que todos os modelos compartilham o mesmo `base_url` e a mesma chave API. Para trocar de modelo, basta alterar o ID do modelo no parâmetro `model` e verificar se o endpoint usado é suportado por esse modelo — não é preciso se cadastrar separadamente em cada fornecedor nem integrar um SDK diferente para cada um.
P2: Os modelos recém-anunciados nas notícias podem ser chamados diretamente?
Não necessariamente. Ser anunciado não significa estar disponível na plataforma. Tomando como exemplo 20/11/2026, o MAI Image 2.7 apareceu apenas nas notícias; no catálogo do APIYI havia somente `MAI-Image-2.6` e `MAI-Image-2.6-Flash`, e o 2.7 ainda não estava disponível — mas será disponibilizado em breve. Antes de chamar, consulte a tabela geral e a interface de preços para confirmar se o ID do modelo existe antes de integrar.
P3: Como escolher entre Carbon, Hydrogen e Neon do Gemini 4?
Escolha o nível conforme a dificuldade da tarefa: para tarefas longas e de alta complexidade, use Carbon; para chamadas diárias de alta frequência em que a velocidade é prioridade, use Hydrogen; para casos intermediários entre os dois, use Neon. Os três foram lançados em 10, 12 e 18 de novembro, respectivamente, e os preços também são diferentes. Recomenda-se comparar com o mesmo conjunto de amostras antes de definir qual será o principal.
P4: Não encontro o gemini-4-neon na tabela geral — isso significa que ainda não posso usá-lo?
Não dá para confiar apenas na tabela geral. Na versão da tabela geral de 19/11/2026 não havia `gemini-4-neon`, mas a interface de preços já fornecia o multiplicador completo, que convertido resulta em entrada de `$3 / 1M`, saída de `$15 / 1M` e leitura de cache de `$0.15 / 1M`. Há uma defasagem temporal entre as duas fontes de informação; considere como referência a interface de preços e o resultado de um pequeno teste real.
P5: Como chamar rapidamente esses novos modelos de novembro via API?
Sugiro seguir os passos abaixo:
1. Cadastre-se no APIYI (apiyi.com) para obter uma chave API e a cota gratuita de teste para novos usuários
2. Consulte a tabela geral de modelos e a interface de preços para confirmar o ID do modelo desejado
3. Defina o `base_url` como o endereço compatível com OpenAI da plataforma e escolha chat, messages, responses ou gemini conforme a tabela de correspondência de endpoints acima
4. Envie primeiro uma requisição curta para confirmar que está funcionando e só depois integre ao seu negócio
P6: O mesmo Claude Fable 5.2 custa diferente se chamado via chat e via messages?
Nos materiais de referência, `claude-fable-5-2` e `claude-fable-5-2-thinking` têm o mesmo preço: entrada de `$8 / 1M`, leitura de cache de `$0.2 / 1M` e saída de `$40 / 1M`. Os materiais não diferenciam o preço por endpoint. Ainda assim, na contabilidade recomendo incluir o endpoint como parte da chave de canal, para facilitar a identificação de problemas e a verificação posterior.
P7: O ponto de entrada unificado é necessariamente mais barato do que conectar-se diretamente ao oficial?
Não dá para concluir isso. O principal valor do ponto de entrada unificado é precisar de menos integrações de interface e ter autenticação e cobrança centralizadas. O preço deve ser verificado canal por canal — por exemplo, o preço do `gemini-4-neon` é igual ao preço oficial do Google. Economizar ou não depende da combinação de modelos e do volume de uso; é preciso fazer a conta por canal.
P8: Quais são as limitações conhecidas que exigem planejamento antecipado?
Há três pontos principais. Primeiro, alguns modelos novos ainda não estão no catálogo — por exemplo, MAI Image 2.7, Kling, Muse e `gemini-4-flash-lite` não aparecem na consulta no momento. Segundo, o preço introdutório tem prazo: o preço introdutório do Google para o Gemini 4 Carbon vai até 30 de novembro. Terceiro, o GPT-6.2 Astra passa a ser cobrado por faixas escalonadas depois de 272000 tokens. Nesses casos, ajuste primeiro o plano conforme a lista da plataforma e só depois volte para alterar o código.
Principais pontos da integração de novos modelos em novembro
- Consulte o catálogo antes de escrever código: use a tabela geral de modelos e a interface de preços como referência; registre separadamente os modelos anunciados na imprensa e os modelos disponíveis para chamada
- Para trocar de modelo, altere apenas dois pontos: no mesmo
base_url, mude o ID do modelo e depois confira o tipo de endpoint - Cada endpoint tem seu lugar: Gemini usa
chatougemini; Claude usachatoumessages; para o GPT-6.2 Astra, a recomendação éresponses - Sabendo ler os multiplicadores, você calcula o preço:
model_ratio × 2é o preço unitário de entrada; depois multiplique pelos multiplicadores de saída e de cache - Separe a fatura por canal: use “ID do modelo + endpoint” como chave para registrar cada item separadamente; não aplique o preço unitário de um único provedor a tudo
- Atenção aos prazos e às faixas: o preço introdutório do Carbon e a faixa de 272000 tokens do Astra afetam o orçamento
- Caminho para começar: na APIYI, use uma chave API para resgatar a cota gratuita, comece pelo cenário de uso diário e depois compare os modelos lado a lado
Resumo: modelos novos se acumulam em novembro — troque de modelo com um único endpoint e veja a fatura separada por canal
Quando os modelos novos se acumulam em novembro, a chave da integração não é correr atrás de cada notícia, mas estabelecer um processo fixo:
- Confira a lista de modelos: verifique tanto a tabela geral quanto a interface de preços. O MAI Image 2.7 citado nas notícias ainda não está disponível na prateleira — não o coloque no plano de lançamento.
- Troque o ID do modelo e confira o endpoint: um único
base_urlresolve vários modelos; consulte a tabela de correspondência de endpoints para escolher entrechat,messages,responsesougemini. - Analise a fatura por canal: calcule tokens e custos separadamente para cada modelo e cada endpoint, e fique de olho na data limite do preço de introdução e no escalonamento por janela de contexto longa.
Uma vez fixado o processo, na próxima vez que surgir um modelo novo você só precisa adicionar uma linha com o ID do modelo na configuração e consultar a interface de preços uma vez para concluir a integração e a avaliação de custos. A recomendação é usar o crédito gratuito para novos usuários no APIYI apiyi.com para colocar um canal em funcionamento primeiro e, depois, ir adicionando Gemini 4, Claude Fable 5.2 e GPT-6.2 Astra à comparação.
📚 Referências
-
Blog oficial do Google — anúncio do Gemini 4 Neon: apresentação dos modelos da série Gemini 4
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Descrição: entenda o posicionamento e as datas de lançamento de Carbon, Hydrogen e Neon
- Link:
-
Tabela geral de modelos e interface de preços do APIYI: fontes para conferir modelos e preços
- Link: veja a seção “Modelo da notícia ≠ modelo na prateleira” no corpo do texto
- Descrição: a versão da tabela geral e a da interface de preços podem não estar sincronizadas; recomenda-se consultar as duas
Autor: equipe técnica do APIYI
Contato técnico: fale conosco pela página inicial do site APIYI; há mais documentação de integração no centro de documentação docs.apiyi.com