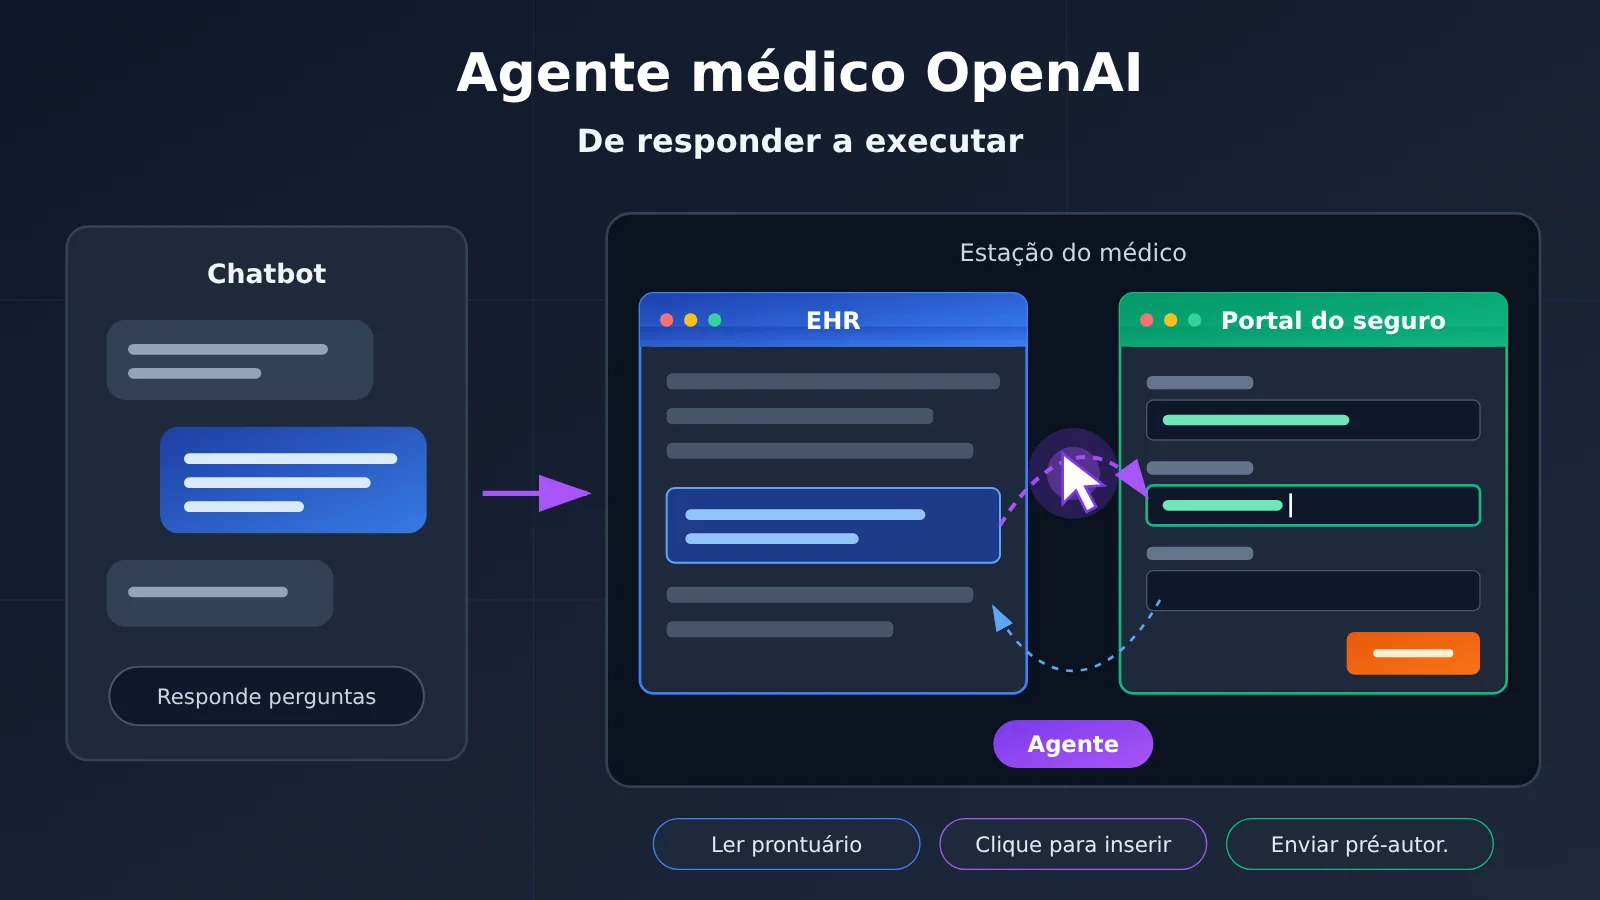
O avanço decisivo do Agente de uso de computador (Computer-use Agent) da OpenAI na área médica é que ele consegue entrar nos sistemas de software que as instituições de saúde já usam, ler as informações longitudinais do prontuário do paciente e, com base nisso, preparar registros médicos, rascunhos de prescrições, respostas a pacientes e materiais de autorização prévia de seguro. O valor da IA está migrando da resposta a perguntas especializadas para a execução de processos de negócio reais. O foco da concorrência em IA médica também muda: não se limita mais a perguntas e respostas sobre conhecimento médico e passa a alcançar os próprios fluxos de trabalho clínicos e administrativos. Vale destacar que, tanto nas demonstrações quanto nos casos públicos, esses materiais passam por revisão de médicos ou funcionários; a IA não tem, por si só, poder de prescrever nem de tomar decisões médicas.
O que você vai aprender ao ler este artigo?
- Na demonstração de MRI, a cadeia completa de operações do Agente, desde a leitura do prontuário até a preparação do pedido de autorização prévia.
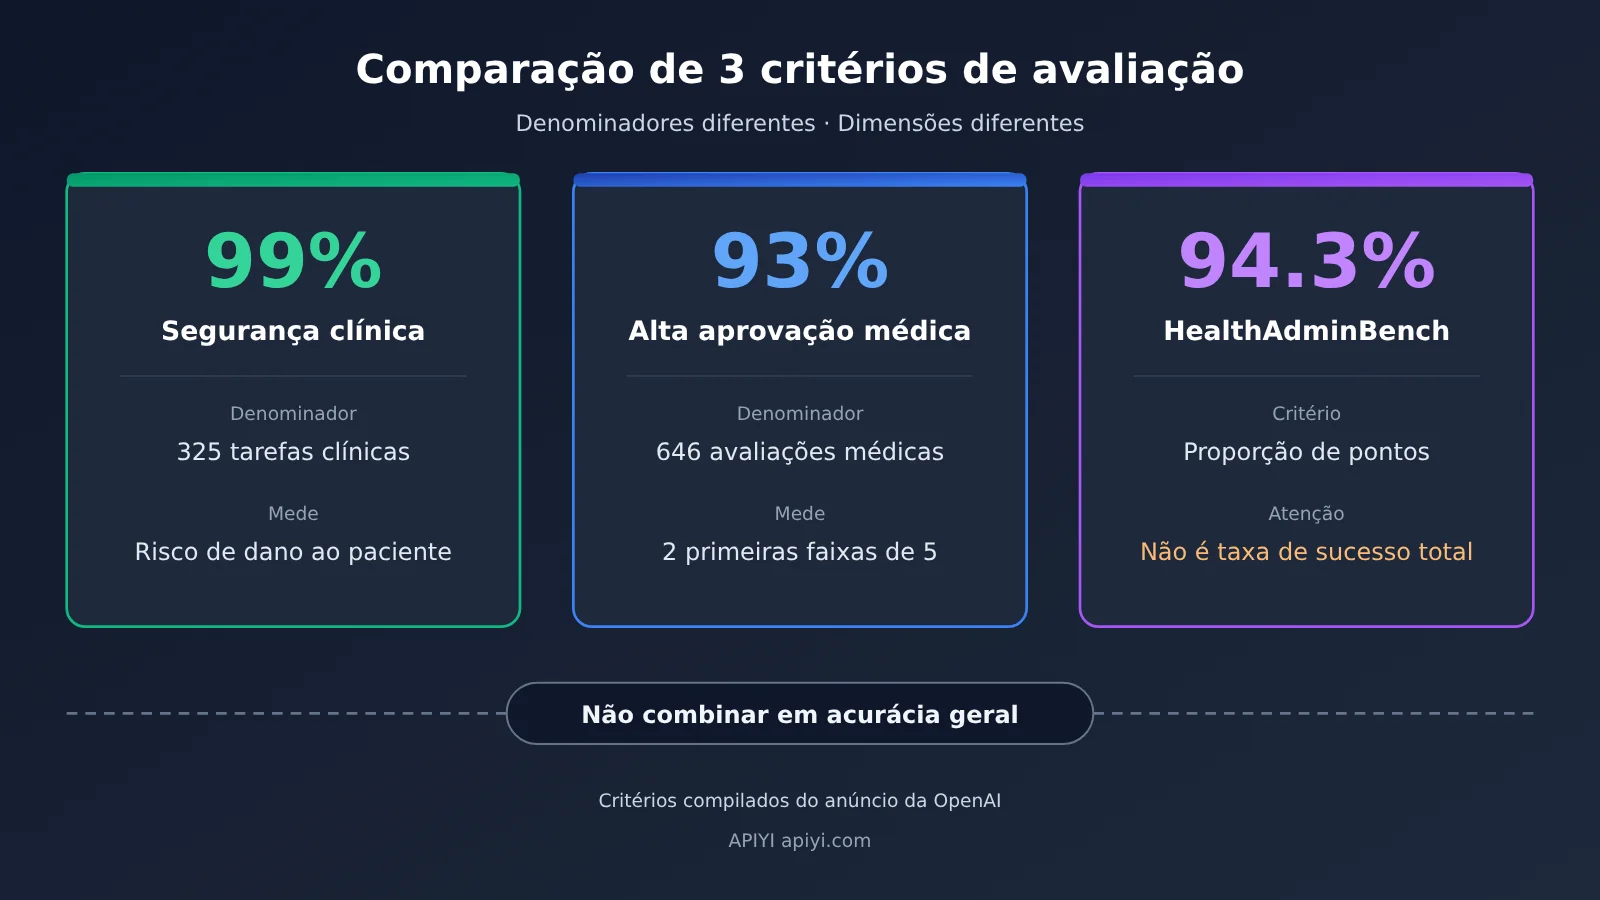
- O que cada um dos três conjuntos de dados significa — 99% de segurança, 93% de alta aceitação pelos médicos e 94,3% de pontos de rubrica (rubric points) — e como eles se diferenciam dos resultados do artigo Stanford HealthAdminBench.
- Em que estágio estão CVS Health, Cigna, Abridge e Ambience: demonstração sintética, implantação em produção ou desenvolvimento.
- Como separar o poder de aprovação clínica do poder de execução do Agente, e como desenvolvedores devem calcular o custo total do Agente.
Índice
A seção de fatos objetivos segue esta ordem: primeiro, reconstruir o que a OpenAI fez a IA fazer desta vez; depois, comparar as diferenças entre Chatbot e Agente de uso de computador; em seguida, destrinchar o significado dos resultados de avaliação; depois, mapear como CVS, Cigna, Abridge, Ambience e outras empresas estão implementando; por fim, apresentar os mecanismos de controle de risco do Agente médico. A seção de análise e opinião discute por que o setor de saúde precisa tanto dessa capacidade, como desenvolvedores e instituições de saúde devem fazer seus trade-offs, e o que Computer Use significa para toda a indústria de aplicações de IA.
Para saber: consulta rápida de conceitos relacionados a Agentes médicos
| Conceito | Explicação breve |
|---|---|
| Computer Use | Capacidade de concluir tarefas observando e operando interfaces de software (capturas de tela, cliques, entrada de texto) |
| EHR | Sistema de registro eletrônico de saúde, o software central onde os hospitais armazenam informações como consultas, medicamentos e imagens dos pacientes |
| Payer Portal | Portal do pagador de seguro, onde as instituições de saúde enviam autorizações prévias e verificam a elegibilidade do seguro |
| Prior Authorization | Autorização prévia: alguns exames ou tratamentos precisam da aprovação da seguradora antes de serem realizados |
| MCP | Protocolo padrão usado para descobrir e invocar ferramentas externas |
| RPA | Forma de automação que executa processos repetitivos por meio de regras ou scripts previamente configurados |
| Rubric points | Pontos de pontuação divididos conforme as regras de avaliação, medindo o cumprimento de requisitos parciais |
| Taxa de sucesso ponta a ponta | Proporção de tarefas completas que atendem a todas as condições de sucesso |
| Trace | Evidência de trajetória que registra o processo de execução, as ações operacionais e os estados da interface |
| BAA | Acordo de parceiro comercial, que define a responsabilidade do provedor de serviços no tratamento de informações de saúde protegidas (PHI) |
| RBAC | Controle de acesso baseado em funções, que distribui por cargo os dados e as operações acessíveis |
Visão geral do impacto do Agente Médico
- Desenvolvedores e líderes técnicos: O foco já não é se o modelo consegue responder corretamente a perguntas médicas, mas sim validar, conforme a tarefa específica, o mecanismo de execução, a taxa de conclusão ponta a ponta e o custo total. Capturas de tela são entrada de imagem, e chamadas de múltiplos turnos, ferramentas e ambiente de execução entram na cobrança; não adianta olhar apenas para o preço unitário do Token de texto.
- Instituições médicas e responsáveis por fluxos de trabalho: É preciso distinguir o que é demonstração com dados sintéticos, avaliação de fornecedores, piloto empresarial e caso de produção. Ao entrar em produção, ainda é necessário implementar aprovação humana, configuração de permissões e logs de auditoria — não se pode tratar o efeito de uma demonstração diretamente como base de compra.
- Profissionais clínicos: No curto prazo, o mais provável é sentir a redução da carga administrativa, por exemplo, na preparação de materiais de pré-autorização e na busca de informações entre sistemas. O julgamento clínico e a responsabilidade pela assinatura continuam nas mãos do médico.
Fatos objetivos: o que o Agente Médico da OpenAI lançou desta vez
O que o agente de saúde da OpenAI fez com a IA desta vez?
Em 16 de novembro de 2026, a OpenAI apresentou novos avanços de um agente que opera computadores para equipes de saúde, além de divulgar resultados de avaliação de fluxos de trabalho clínicos e administrativos e práticas de colaboração com empresas como CVS Health, Abridge, Ambience e Cigna Healthcare. Durante o HLTH 2026, Karan Singhal, líder de Health AI da OpenAI, também apresentou os avanços relacionados.
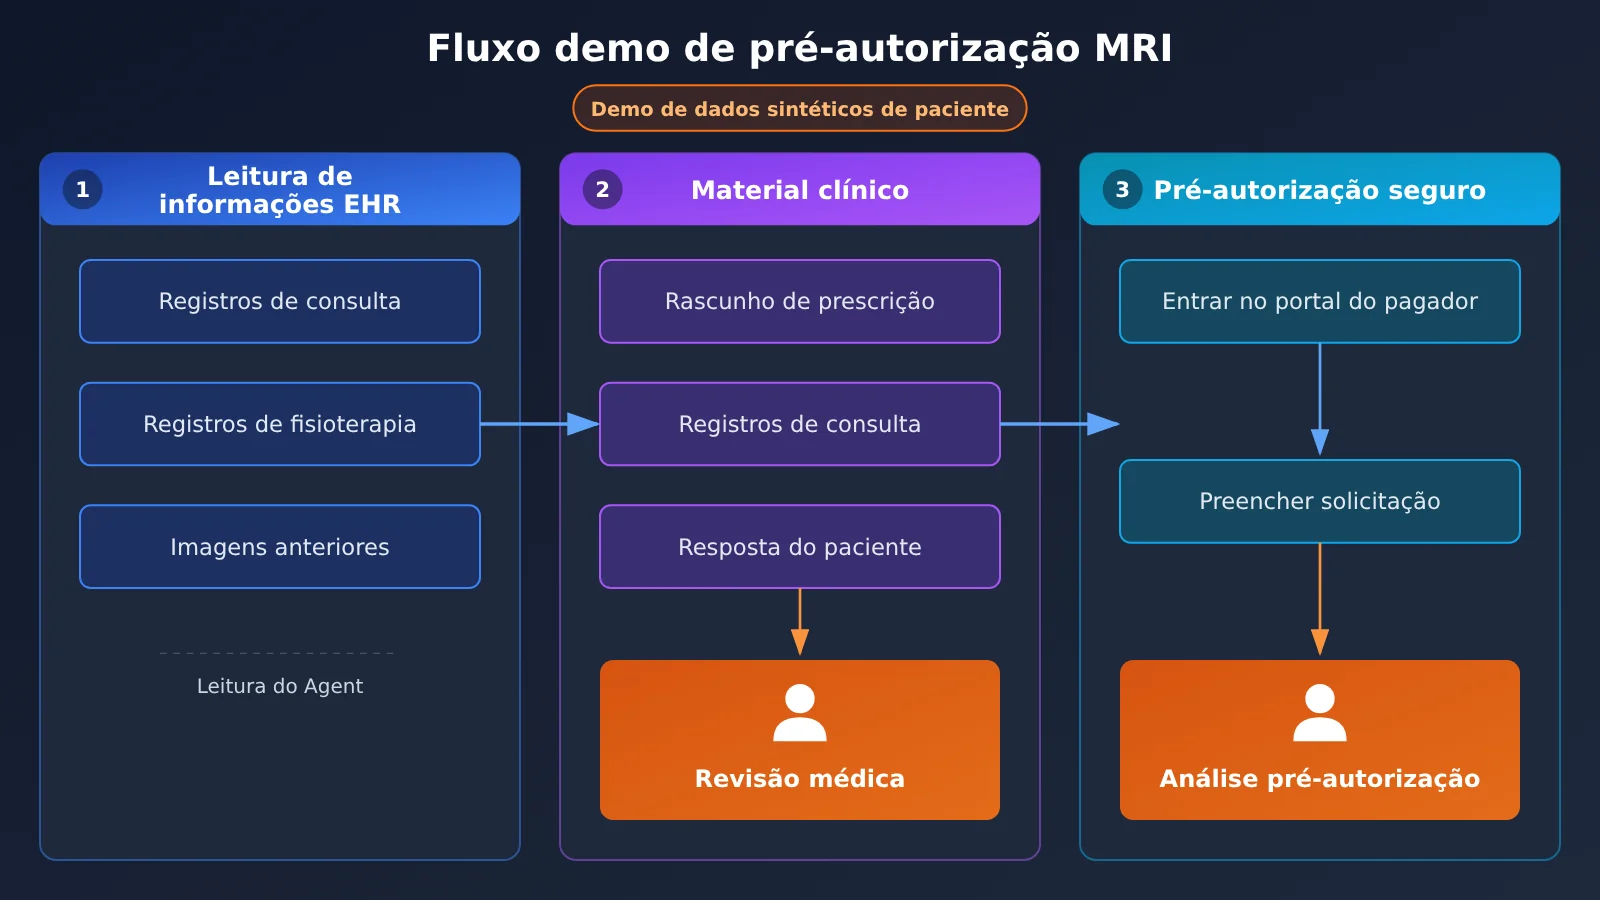
O que melhor ilustra essa mudança é o fluxo de trabalho de MRI apresentado oficialmente. Um paciente com dor lombar envia uma mensagem ao médico, que considera solicitar uma ressonância magnética (MRI). Em seguida, o agente realiza três etapas entre o EHR e o portal do seguro:
- Leitura de informações do EHR: consulta registros de atendimento do paciente, registros de fisioterapia e exames de imagem anteriores.
- Preparação de materiais clínicos: redige a solicitação de MRI, o registro desta consulta e a resposta ao paciente, deixando tudo para revisão médica.
- Pré-autorização do seguro: usando o mesmo registro do paciente, entra no portal da operadora do seguro para preparar a solicitação de pré-autorização da MRI, que fica para revisão da equipe de pré-autorização.
Vale esclarecer que esta demonstração usa dados sintéticos de pacientes (Synthetic Patient Data), e não uma operação de produção com pacientes reais. Ela mostra a cadeia de capacidades, mas não significa que algum hospital já esteja tratando casos reais seguindo esse fluxo.
A OpenAI também apresentou um caso de consulta sobre medicação após uma fratura em uma criança. Um familiar pergunta sobre a dosagem de ibuprofeno infantil; o agente consulta registros de atendimento e exames de imagem, lê no prontuário o peso registrado e a dose administrada na clínica e, com base nisso, redige orientações sobre o medicamento, cuidados com o gesso e sinais de alerta que exigem atendimento médico de emergência. Ele salva o registro médico como não assinado e a resposta ao familiar como rascunho não enviado, com aprovação final do médico. PSA elevado e renovação de digoxina (Digoxin refill) também foram listados como tipos de tarefa na EHR Inbox, mas a OpenAI não divulgou o registro completo de operação nem a pontuação independente dessas duas tarefas.
De Chatbot a Agente Médico Computer-use: onde está a mudança?
A resposta a perguntas médicas tradicional fornece conhecimento geral; a geração de documentos médicos consegue produzir rascunhos, mas o conteúdo ainda depende de alguém copiá-lo manualmente para o sistema. A diferença do Computer-use Agent está no seu ciclo de “observar a captura de tela → planejar → clicar ou digitar → verificar com nova captura de tela”, que o leva diretamente aos softwares já existentes, executando tarefas de várias etapas entre aplicativos e potencialmente alterando o estado de negócio dentro do software.
| Forma de capacidade | Saída principal | Toca no sistema de negócio | Cenário médico típico | Principais pontos de risco |
|---|---|---|---|---|
| Chatbot de perguntas e respostas médicas | Resposta em texto | Não | Consulta de conhecimento médico, busca de evidências | Precisão do conteúdo |
| Geração de documentos médicos | Rascunhos de registros e cartas | Indireto, requer entrada manual | Instruções de alta, cartas de pré-autorização | Conteúdo inconsistente com o prontuário |
| Computer-use Agent | Operações de interface e mudança de estado do sistema | Sim, opera diretamente o EHR e os portais | Preenchimento de pré-autorização, atualização de status de encaminhamento, extração de dados entre sistemas | Cliques errados, confusão de pacientes, propagação de erros |
Na OpenAI API, o Computer Use é implementado principalmente por meio da Responses API, com suporte a ações como click, type, scroll, keypress, drag e screenshot. A documentação oficial apresenta dois caminhos: um é o Computer Tool, em que o modelo retorna ações estruturadas de mouse e teclado que a aplicação executa; o outro é o Code Execution, em que o modelo gera código que chama ferramentas como Playwright, PyAutoGUI e outras. Para o GPT-6 Astra, a documentação atualmente recomenda o modo Code Execution. A documentação também faz uma ressalva importante: o fato de o modelo gerar instruções de operação não significa que a operação já tenha sido concluída com sucesso — a aplicação precisa executar as ações e depois confirmar o resultado por meio de uma nova captura de tela ou outros meios.
O que os resultados de avaliação do Agent médico da OpenAI realmente mostram?
A OpenAI divulgou três conjuntos de dados centrais. Cada um tem um denominador e uma dimensão de avaliação diferentes, não podem ser combinados em uma “taxa de acerto abrangente” e nenhum deles é uma taxa de acerto de diagnóstico médico.
| Métrica | Valor | Objeto avaliado | Denominador / critério | Não deve ser interpretado como |
|---|---|---|---|---|
| Segurança em tarefas clínicas | 99% | GPT-6 Astra | 325 tarefas revisadas, avaliando se erros, omissões ou ações podem causar dano ao paciente | Taxa de acerto de diagnóstico, zero erros |
| Alta aprovação médica | 93% | GPT-6 Astra | 646 avaliações, proporção combinada de Very / Extremely Helpful na escala de cinco pontos | Taxa de sucesso de tarefas, 646 médicos |
| HealthAdminBench | 94.3% | GPT-6 Astra | Proporção de rubric points, maximum reasoning effort | Taxa de sucesso de tarefas completas |
| HealthAdminBench | 91.8% | GPT-6 Luna | Proporção de rubric points, maximum reasoning effort | Taxa de sucesso de tarefas completas |
| Custo por tarefa | $0.085 | GPT-6 Luna | Condição de avaliação específica, 98% menor que Astra | Preço de implantação em produção |
A revisão clínica não olha apenas para o texto final gerado; ela também verifica as ações que o Agent realmente executou, os registros médicos produzidos, as prescrições e as mensagens aos pacientes. Ou seja, a avaliação cobre tanto a qualidade do conteúdo quanto o processo de operação do software. No entanto, a OpenAI não divulgou o número de médicos independentes correspondentes às 646 avaliações, e o texto do anúncio também não fornece intervalos de confiança, resultados por tarefa nem casos completos de falha.
O HealthAdminBench é um benchmark de Agents administrativos médicos proposto pelo Shah Lab da Universidade Stanford. De acordo com o artigo 2604.09937v1, o benchmark contém 135 tarefas e 1698 subtarefas, das quais 1177 subtarefas usam julgamento determinístico e 521 usam modelo-juiz; no artigo, o maior taxa de sucesso de tarefas completas é do Claude Opus 4.6 CUA, com 36.3%, e a maior taxa de sucesso de subtarefas é do GPT-5.4 CUA, com 82.8%. A versão anterior na página web do Shah Lab tinha 70 tarefas e 947 pontos de pontuação, e na época a maior taxa de sucesso de tarefas completas reportada era de 22.9%, o que serve como referência histórica.
Esses números pertencem a versões diferentes, modelos diferentes, datas diferentes, condições de execução diferentes e métricas diferentes, não podem ser alinhados em uma única tabela de classificação. Os 94.3% da OpenAI usam o critério de rubric points, enquanto os 36.3% do artigo representam a taxa de sucesso ponta a ponta de tarefas completas. A própria diferença entre os dois já sugere: “acertar etapas locais” e “concluir a tarefa inteira” em Agents médicos podem estar muito distantes um do outro.
Como CVS, Cigna, Abridge e Ambience implementam agentes de IA na área da saúde?
A maturidade dos casos empresariais varia bastante. A seguir, eles são classificados pelo status divulgado publicamente. Esses números vêm principalmente de divulgações das empresas e da OpenAI; a cobertura da mídia serve como confirmação cruzada, mas não equivale a uma auditoria independente.
| Empresa | Cenário | Status de divulgação | Fatos-chave |
|---|---|---|---|
| CVS Health | Envio de documentos, encaminhamentos e consultas com especialistas entre sistemas clínicos | Fluxo de trabalho em produção | Limpou em um fim de semana um acúmulo de documentos que se arrastava por vários meses; outro agente processa dezenas de milhares de etapas de operação de sistemas relacionadas a consultas todos os dias |
| Cigna Healthcare | Integração de informações entre sistemas antes da gestão de cuidados | Implantado | A equipe de enfermagem precisava consultar mais de 10 sistemas; da concepção à implantação, menos de 8 semanas |
| Abridge | Coordenação de barreiras à alta hospitalar | Em desenvolvimento | Médicos usam o Abridge Assistant para solicitar que o agente coordene em paralelo a obtenção de medicamentos e os cuidados domiciliares |
| Ambience Healthcare | Solicitações de pré-autorização de seguro | Apresentação de plano de governança | Quando o prontuário é ambíguo, ele para e pergunta ao médico; só envia após a aprovação |
| Assort | Ciclo completo de encaminhamento | Caso oficial | A API grava as informações do encaminhamento e o Computer Use completa a atualização de status na interface do Athena |
As “dezenas de milhares de vezes” da CVS referem-se ao volume de trabalho envolvido nas etapas de operação do sistema, e não a dezenas de milhares de decisões clínicas tomadas de forma independente pela IA. A CVS também tornou open source o CUA Agent Kit (licença Apache-2.0), com arquitetura em duas fases: primeiro, o Computer-use Agent explora o fluxo de trabalho a partir de linguagem natural e registra evidências de Trace, como capturas de tela, ações e posições de destino; depois, o Codex Skill transforma a trajetória bem-sucedida em código determinístico, que, após revisão dos engenheiros, é executado repetidamente. De acordo com o README, a fase de execução determinística não exige chave API do modelo.
O caso da Assort ilustra o posicionamento do Computer Use: a Assort já consegue gravar as informações do encaminhamento no prontuário por meio da API do Athena, mas o ciclo completo ainda depende de uma etapa de operação na interface. O agente seleciona diretamente o médico de encaminhamento na interface do Athena, preenche os detalhes e atualiza o status para Visit Scheduled; esse encaminhamento é então removido da lista de acompanhamento da equipe. A API cuida das operações estruturadas, e o Computer Use cobre as partes que a API não atende.
Como um Agente médico controla riscos?
As capacidades de governança divulgadas pela OpenAI incluem RBAC, logs de auditoria, configuração do escopo de acesso dos aplicativos, aprovação humana antes de operações críticas e mecanismos de controle que restringem o Agente a fluxos de trabalho específicos. As instituições de saúde podem pausar o Agente a qualquer momento e consultar o log passo a passo das operações.
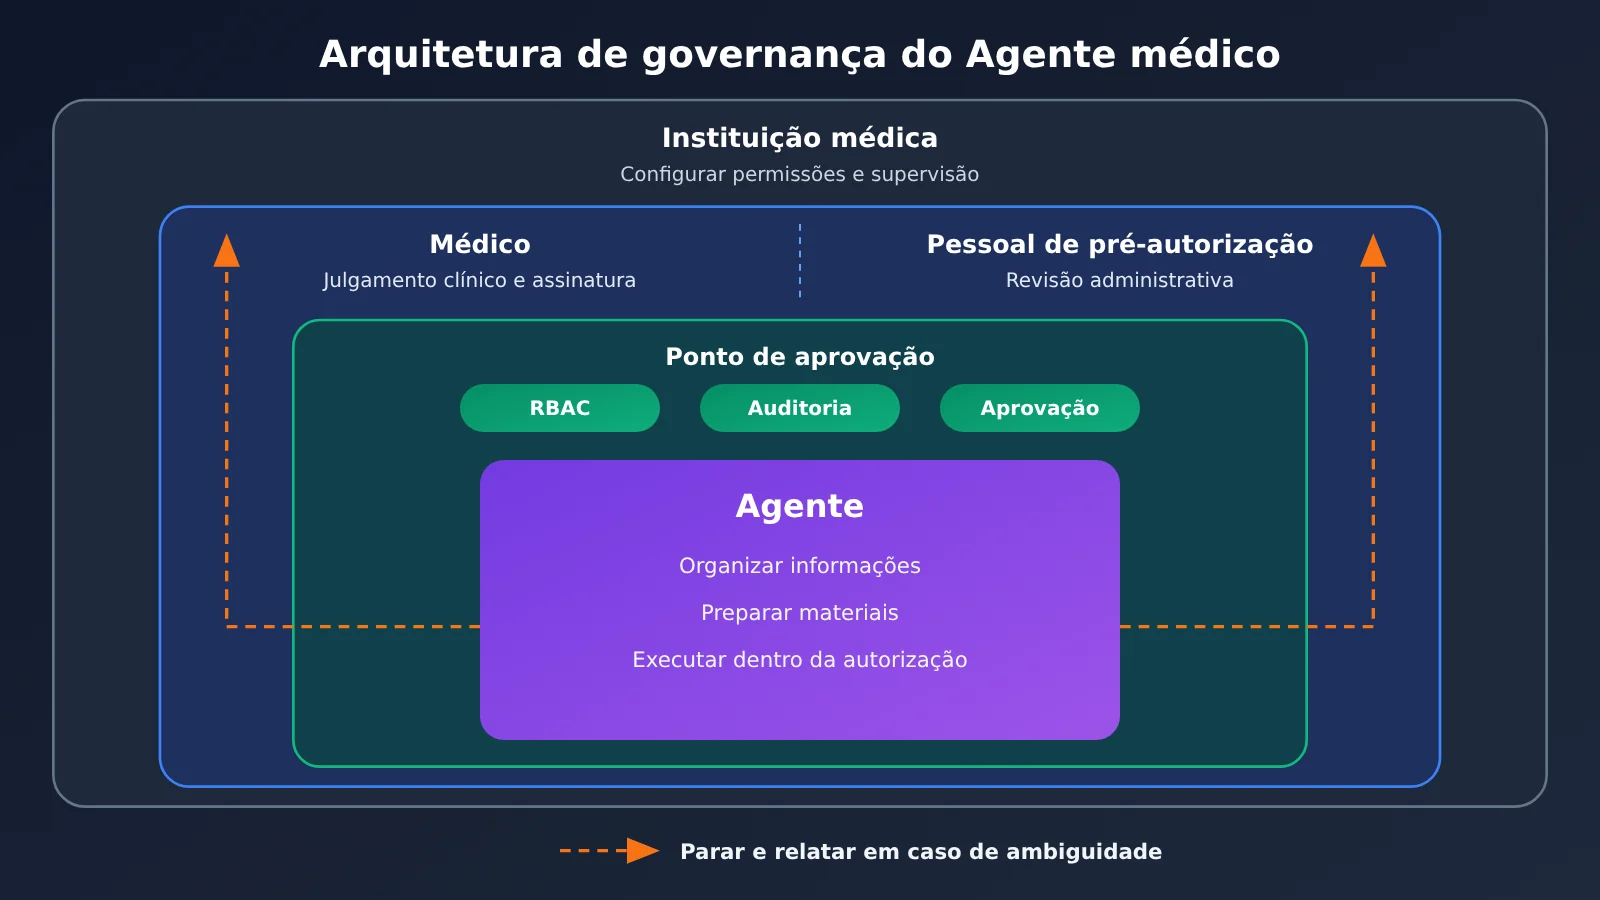
Na prática, trata-se de um design de separação de poderes: a IA fica responsável por organizar informações, preparar materiais e executar operações dentro do escopo autorizado; o médico, pelo julgamento clínico; a equipe de pré-autorização, pela revisão administrativa; e a instituição de saúde, pela configuração de permissões e pela supervisão dos processos. As permissões do Agente precisam estar alinhadas aos limites da responsabilidade clínica.
No campo da conformidade de dados, a OpenAI afirma que os dados organizacionais do ChatGPT for Healthcare não são usados para treinar modelos de base, e a CVS também declara que os dados de produção relevantes permanecem em sua própria infraestrutura. Porém, para dar suporte a fluxos de trabalho em conformidade com a HIPAA que envolvem PHI, as organizações de saúde precisam usar serviços elegíveis, garantir que o serviço esteja coberto por um BAA assinado com a OpenAI, configurar ajustes de segurança e políticas de retenção de dados e, por meio de permissões organizacionais, limitar os registros e as operações que o Agente pode acessar. Portanto, “dar suporte a fluxos de trabalho HIPAA” não é o mesmo que “todas as chamadas da API OpenAI são automaticamente conformes”.
Em relação aos canais disponíveis, os recursos podem ser usados via OpenAI API, ChatGPT for Healthcare, ChatGPT for Clinicians, ChatGPT Work e Codex. Profissionais clínicos dos EUA que atendem aos critérios podem solicitar o ChatGPT for Clinicians gratuitamente, mas essa política de gratuidade tem restrições geográficas e de elegibilidade. O ChatGPT for Healthcare não possui um preço de assinatura fixo e unificado divulgado publicamente.
Análise crítica: os trade-offs dos agentes médicos e seu significado para o setor
Por que o setor de saúde precisa tanto de agentes do tipo Computer Use?
A fragmentação de informações na área da saúde é algo muito típico. Uma única consulta pode envolver ao mesmo tempo o EHR (prontuário eletrônico), sistemas de imagem, sistemas de prescrição, portais de seguro, sistemas de encaminhamento e plataformas de gestão de alta hospitalar — e esses sistemas geralmente vêm de fornecedores diferentes, com interfaces incompletas. A pré-autorização de ressonância magnética (MRI) é um bom exemplo disso: o médico faz apenas um julgamento clínico, mas a equipe administrativa precisa alternar repetidamente entre prontuários, registros de fisioterapia, materiais de imagem e portais de seguro, copiando e enviando arquivos sem parar.
Sob essa ótica, o Computer Use não resolve a questão de “se a IA entende ou não de medicina”, mas sim a de “se a informação consegue fluir entre os sistemas”. Minha avaliação é que a automação administrativa na área médica provavelmente atingirá escala comercial antes da automação do diagnóstico clínico. A razão é que as tarefas administrativas têm grande volume, alta repetibilidade e fronteiras bem definidas; o resultado pode ser verificado por meio de formulários e do estado do sistema, e o risco de responsabilidade é relativamente controlável. O caso da Cigna, que reduziu a busca de informações em mais de 10 sistemas para poucos segundos, ilustra bem esse caminho de “primeiro aliviar a carga, sem substituir”.
No entanto, o benchmark de Stanford também revelou o verdadeiro ponto difícil. Pesquisas iniciais apontaram que a transferência de dados entre aplicativos e o processamento de documentos são importantes fontes de falha dos agentes. Mesmo quando o agente compreende as informações do paciente, ele ainda pode errar ao enviar arquivos, preencher campos ou atualizar status. Em cenários médicos, um erro em um sistema também pode ser replicado para vários sistemas downstream — e é exatamente por isso que a aprovação manual e a verificação do estado após a operação não podem ser dispensadas.
Como desenvolvedores podem avaliar o custo e a viabilidade de um Agent médico?
Para quem desenvolve, o primeiro passo não precisa ser sair direto para o Computer Use. Uma abordagem mais segura é primeiro dividir o fluxo de trabalho: etapas puramente textuais, como extração de informações e redação de documentos, podem ser validadas em qualidade com uma interface de modelo comum; já a parte de operação de interface deve ter a taxa de sucesso avaliada separadamente. O exemplo a seguir usa materiais sintéticos para validar a etapa textual de “extração dos campos exigidos na pré-autorização”. É apenas uma demonstração técnica e não constitui qualquer recomendação de diagnóstico ou tratamento:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Consulte a lista de modelos realmente disponíveis na plataforma
    messages=[{"role": "user", "content": "从以下合成病历中列出影像检查预授权需要核对的字段清单:……"}]
)
print(resp.choices[0].message.content)
Ver o código completo com estatísticas de custo em Token
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Preço unitário: dólares / milhão de tokens; preencha conforme o modelo que você usa de fato
PRICE = {"input": 0.10, "output": 0.50, "cached_input": 0.01}

def run_step(prompt: str, model: str = "gpt-4o-mini") -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "你只做字段抽取,不给出任何诊疗建议,信息不明确时输出 NEED_HUMAN。"},
            {"role": "user", "content": prompt},
        ],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    cost = ((u.prompt_tokens - cached) * PRICE["input"]
            + cached * PRICE["cached_input"]
            + u.completion_tokens * PRICE["output"]) / 1_000_000
    return {"text": resp.choices[0].message.content, "cost_usd": round(cost, 6)}

steps = ["合成病历片段 A ……", "合成病历片段 B ……"]
total = 0.0
for s in steps:
    r = run_step(s)
    total += r["cost_usd"]
    print(r["text"])
print("模型 Token 成本合计(不含工具、环境与维护):", round(total, 6))
🚀 Sugestão de validação rápida: antes de integrar de verdade a um sistema médico, você pode usar uma única chave API na APIYI apiyi.com para comparar o desempenho de vários modelos em etapas textuais como extração de campos e redação de documentos. Novos usuários têm cota gratuita de teste, o que cai bem para primeiro fazer o script de avaliação rodar de ponta a ponta e acumular dados por tarefa.
Em termos de custo, os preços Standard de contexto curto consultados em 17 de novembro de 2026 (dólares/milhão de tokens) são: GPT-6 Astra entrada 10, saída 50, entrada em cache 1; GPT-6 Luna entrada 0,10, saída 0,50, entrada em cache 0,01. Velocidade de processamento, comprimento de contexto e região afetam o faturamento real. Fazendo o cálculo inverso a partir de 0,085 dólar por tarefa do Luna e da proporção “98% mais baixo”, o Astra fica em cerca de 4,25 dólares por tarefa — mas isso é uma estimativa e representa apenas o custo em condições de referência, não serve como cotação de produção.
Uma contabilização completa deve registrar separadamente, em cada rodada, as entradas visuais e textuais e as saídas cobradas, além de somar as chamadas de ferramentas, o ambiente de execução e a manutenção de engenharia. Se os tokens gerados por novas tentativas já tiverem sido incluídos no total, não os adicione outra vez. A diferença de preço de quase 50 vezes entre as duas faixas de modelos também sugere uma abordagem em camadas: raciocínios complexos ficam com modelos de alta capacidade, etapas estruturadas e de alta frequência ficam com modelos de baixo custo, e os fluxos já explorados e estabilizados podem ser consolidados em código determinístico, como no CVS.
💰 Dica de otimização de custos: ao fazer a divisão em camadas de modelos, você pode primeiro usar o mesmo conjunto de código compatível com OpenAI no APIYI (apiyi.com) para alternar entre modelos de faixas de preço diferentes, medir a qualidade e o consumo de tokens de cada tipo de subtarefa e só então decidir quais etapas merecem um modelo de alta capacidade.
| Etapa de validação | Perguntas a responder | Evidências sugeridas | Ferramentas de referência |
|---|---|---|---|
| Etapa de texto | A qualidade de extração e redação é estável? | Comparação com anotação humana, taxa de disparo de NEED_HUMAN | Comparação de vários modelos no APIYI (apiyi.com) |
| Operação de interface | Qual é a taxa de conclusão ponta a ponta? | Capturas de tela e Trace, verificação do estado após a operação | Documentação do OpenAI Computer Use e ambiente sandbox |
| Consolidação do fluxo | Quais etapas podem ser convertidas em código determinístico? | Taxa de reprodução de trajetórias bem-sucedidas | Arquitetura de duas etapas no estilo CUA Agent Kit |
| Governança de lançamento | Permissões e aprovações cobrem as ações críticas? | Configuração de RBAC, auditoria por amostragem de logs | Sistema próprio de permissões e conformidade da organização |
Agentes de IA na área da saúde e RPA: substituição ou fusão?
O RPA tradicional depende de regras fixas e de localizadores de interface; se a interface mudar, o script pode falhar. O Computer-use Agent consegue entender linguagem natural, observar a interface atual e se adaptar a mudanças, mas cada nova rodada de raciocínio traz custo e variabilidade nos resultados. Em um estudo que comparou os dois tipos de tecnologia (DOI: 10.1080/23311975.2026.2724760), nos fluxos P2 e P3, cada tecnologia foi executada 10 vezes. No fluxo P1, o agente teve apenas um registro de falha, que não foi incluído nas estatísticas posteriores; por isso, não dá para afirmar de forma genérica que todas as tarefas foram executadas 10 vezes. O estudo usou uma configuração de ferramentas de 2025 e não representa diretamente o desempenho dos modelos em 2026.
Na visão do autor, a abordagem do CVS — “exploração por IA, consolidação em código e execução repetida” — tem mais chance de se tornar o formato de engenharia predominante: o agente descobre e entende processos desconhecidos, o código determinístico repete de forma estável os processos já conhecidos, a API continua responsável pelas interações de alta frequência e estruturadas, e a aprovação humana protege os pontos críticos. Combinar API, Computer Use, código determinístico e aprovação humana é mais realista do que apostar tudo em uma única tecnologia.
O que um agente médico significa para todo o setor de IA?
A saúde é apenas um campo de testes de alto limiar de entrada. A fragmentação de seus sistemas, as exigências de conformidade e os limites de responsabilidade são mais rígidos do que em empresas comuns. Se agentes de execução conseguirem estabelecer aqui um modo de operação auditável, que possa ser pausado e com permissões alinhadas, essa abordagem pode ser migrada para setores como seguros, finanças e governo, que também dependem de sistemas legados.
Isso também significa que a dimensão da competição no setor está mudando. Antes, a comparação girava em torno de o modelo conseguir escrever bom conteúdo; daqui para frente, o que mais conta é se ele consegue concluir tarefas em sistemas reais, se consegue parar a tempo quando há erro e se cada etapa deixa rastro rastreável. Para os fornecedores de software, o Computer Use permite que empresas de IA participem de fluxos de trabalho sem controlar totalmente o software subjacente, o que reduz a barreira de integração e também pressiona o modelo antigo de “esperar o fornecedor abrir as interfaces”. Mas interações de alta confiabilidade e alta frequência continuam se adequando melhor às APIs; o Computer Use é mais um complemento do que um substituto.
Vale acompanhar alguns pontos a seguir: se a OpenAI vai divulgar os dados de avaliação por tarefa e a configuração experimental completa; se a versão em paper do HealthAdminBench vai se tornar o critério comum de comparação entre os players; se a solução de coordenação de alta hospitalar da Abridge vai sair do desenvolvimento e chegar à implantação; e se os dados de produção de mais hospitais vão comprovar que a taxa de conclusão ponta a ponta é realmente utilizável. Enquanto essas evidências não aparecerem, demonstrações e pontuações são apenas o ponto de partida, não a conclusão.
O agente médico já provou que sabe “meter a mão na massa”, mas se ele realmente consegue aliviar a carga clínica e administrativa ainda depende da sua taxa de conclusão ponta a ponta em fluxos de trabalho reais, da capacidade de parar quando algo dá errado e do custo a longo prazo. Como diz o provérbio inglês: The proof of the pudding is in the eating. (O resultado de verdade se comprova na prática.)
Referências
- Anúncio oficial da OpenAI: Advancing computer-use agents for healthcare teams
- Link:
openai.com/index/advancing-computer-use-for-healthcare-teams
- Link:
- Documentação de ajuda do ChatGPT for Healthcare: capacidades do produto, BAA e descrição de plugins
- Link:
help.openai.com/en/articles/20001046-chatgpt-for-healthcare
- Link:
- Documentação de desenvolvimento do OpenAI Computer Use: Computer Tool e o caminho de Code Execution
- Link:
developers.openai.com/api/docs/guides/tools-computer-use
- Link:
- Artigo HealthAdminBench: tarefas e métricas da versão 2604.09937v1
- Link:
arxiv.org/html/2604.09937v1
- Link:
- CVS Health CUA Agent Kit: arquitetura de duas fases (exploração e consolidação)
- Link:
github.com/cvs-health/cua-agent-kit
- Link:
- Reportagem da Fierce Healthcare: parceiros e cenários de aplicação no HLTH26
- Link:
fiercehealthcare.com/ai-and-machine-learning/hlth26-cvs-health-cigna-and-ambience-collaborating-openai-test-computer-use
- Link:
- Cambridge Dictionary: verificação do texto original do provérbio
- Link:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Se você quiser comparar o desempenho de vários Modelos de Linguagem Grande na parte textual de um Agent, acesse APIYI apiyi.com para obter créditos de teste. Mais instruções de integração estão disponíveis no centro de documentação em docs.apiyi.com