Nota do autor: este artigo organiza separadamente a pontuação geral de terceiros, os preços oficiais, os preços de leitura de cache e a disponibilidade no catálogo da APIYI do GPT-6.2 Sol e do Claude Opus 5.5, para ajudar você a escolher o modelo pela tarefa, e não por uma única pontuação geral.
A OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol em 17 de novembro de 2026. Muitas equipes já usavam o Claude Opus 5.5 e agora precisam decidir se vale a pena trocar. Este artigo compara o GPT-6.2 Sol e o Claude Opus 5.5, apresentando recomendações sob alguns aspectos: pontuação geral, preço de tabela, leitura de cache, protocolo e disponibilidade atual para invocação.
Este não é um artigo para anunciar quem é mais forte ou mais barato. No índice geral de terceiros, a versão de nível mais alto do Sol fica 2 pontos abaixo da versão de nível mais alto do Opus. Pelos preços de tabela oficiais em contexto curto, os preços unitários de entrada, saída e leitura de cache do Sol são cerca da metade dos do Opus. Esses dois fatos precisam ser analisados em conjunto: tomar a decisão com base em apenas um deles seria incompleto.
Valor central: ao terminar a leitura, você saberá quais são a pontuação geral, o preço de tabela e o preço de leitura de cache desses dois modelos, quais números foram autodeclarados pelas próprias fabricantes e quais foram medidos por terceiros, além de qual deles você consegue invocar na APIYI neste momento.
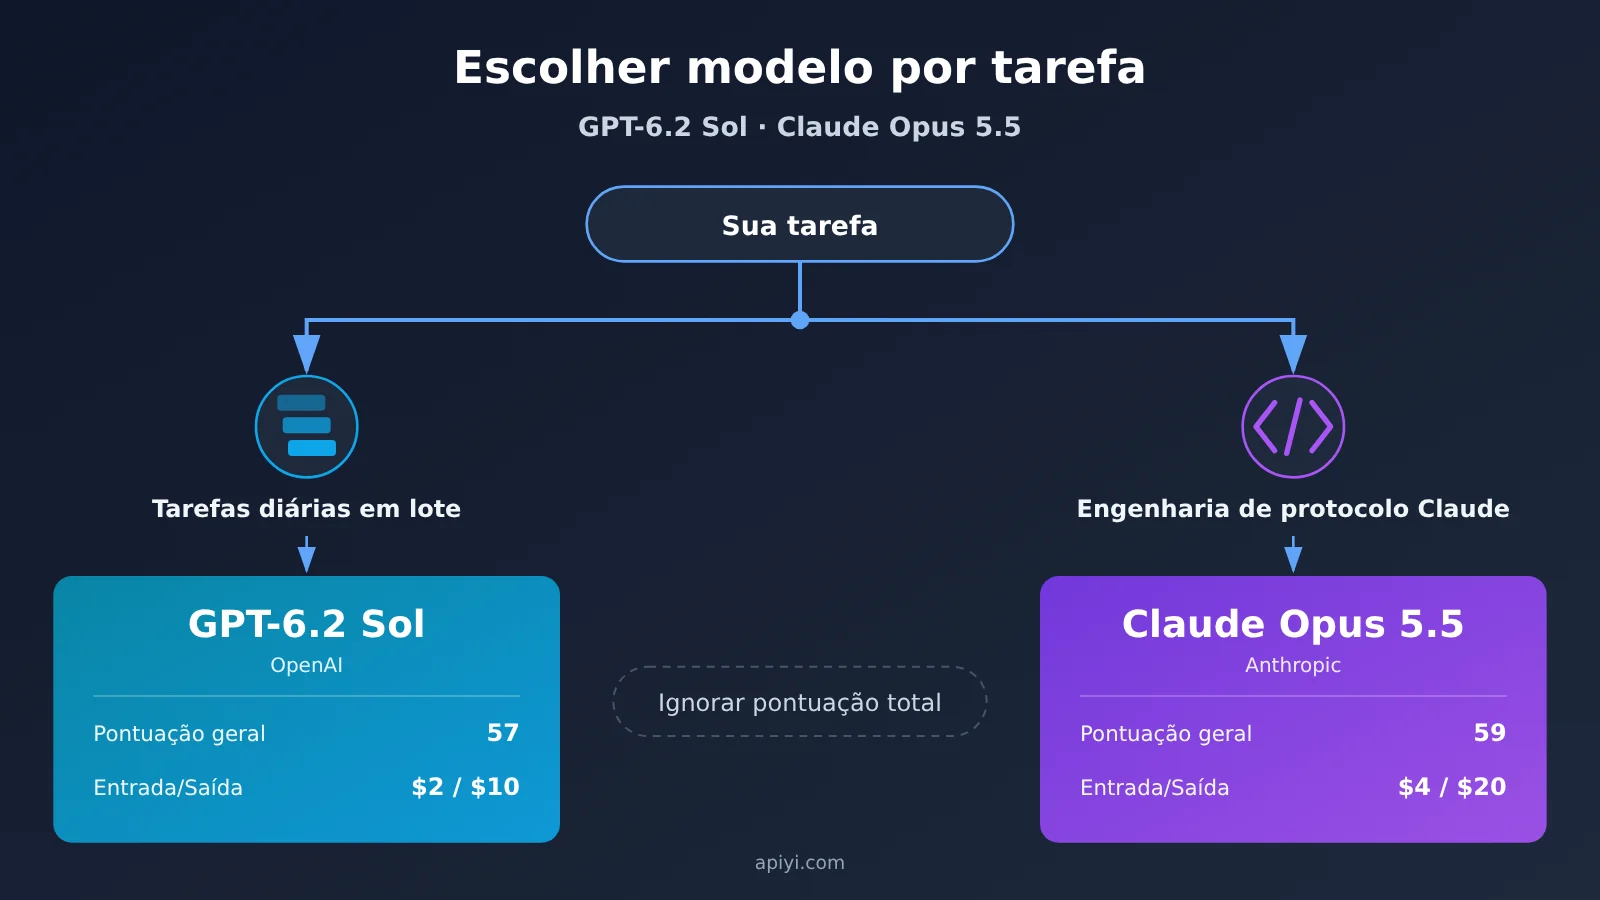
Comparação rápida das principais diferenças entre GPT-6.2 Sol e Claude Opus 5.5
Para começar, reunimos na tabela abaixo as cinco informações mais usadas na hora de escolher entre os dois modelos. Cada linha indica a fonte dos números, e as seções seguintes detalham cada uma delas.
| Critério de comparação | GPT-6.2 Sol | Claude Opus 5.5 | Fonte dos números |
|---|---|---|---|
| Índice composto de terceiros (nível máximo de raciocínio) | 57 (nível Max) | 59 (nível máximo) | Artificial Analysis, fonte de terceiros |
| Preço de tabela de entrada/saída com contexto curto | $2 / $10 | $4 / $20 | Preços oficiais de cada um, por 1 milhão de tokens |
| Preço de tabela de leitura de cache | $0.10 | $0.20 | Página de modelos da OpenAI; Opus conforme tabela de preços da Anthropic |
| Contexto / saída máxima | 1,050,000 / 128,000 | 1M / 128K | Páginas oficiais de modelos e documentação |
| Situação atual na APIYI | Ainda não disponível | Disponível, claude-opus-5-5 |
Tabela geral de modelos e endpoint de preços da APIYI |
Por que analisar juntos a diferença de 2 pontos no índice composto e o preço pela metade
Se você olhar apenas para o índice composto, vai concluir que “o Opus é superior”; se olhar apenas para o preço de tabela, vai concluir que “o Sol tem custo unitário menor”. As duas conclusões estão corretas, mas cada uma conta só metade da história. O índice composto reflete o desempenho médio em um conjunto de tarefas mistas, e o preço de tabela reflete o custo por 1 milhão de tokens — já a sua fatura real depende de quantos tokens cada tarefa consome.
Além disso, a diferença de 2 pontos vem dos testes da Artificial Analysis no nível máximo de raciocínio. Se a sua aplicação usa a intensidade de raciocínio padrão, ou se o tipo de tarefa se afasta bastante do conjunto avaliado por esse índice, esses 2 pontos não necessariamente se transferem para o seu cenário. Por isso, a abordagem deste artigo é: primeiro deixar os números claros e, em seguida, fazer a escolha conforme o tipo de tarefa.
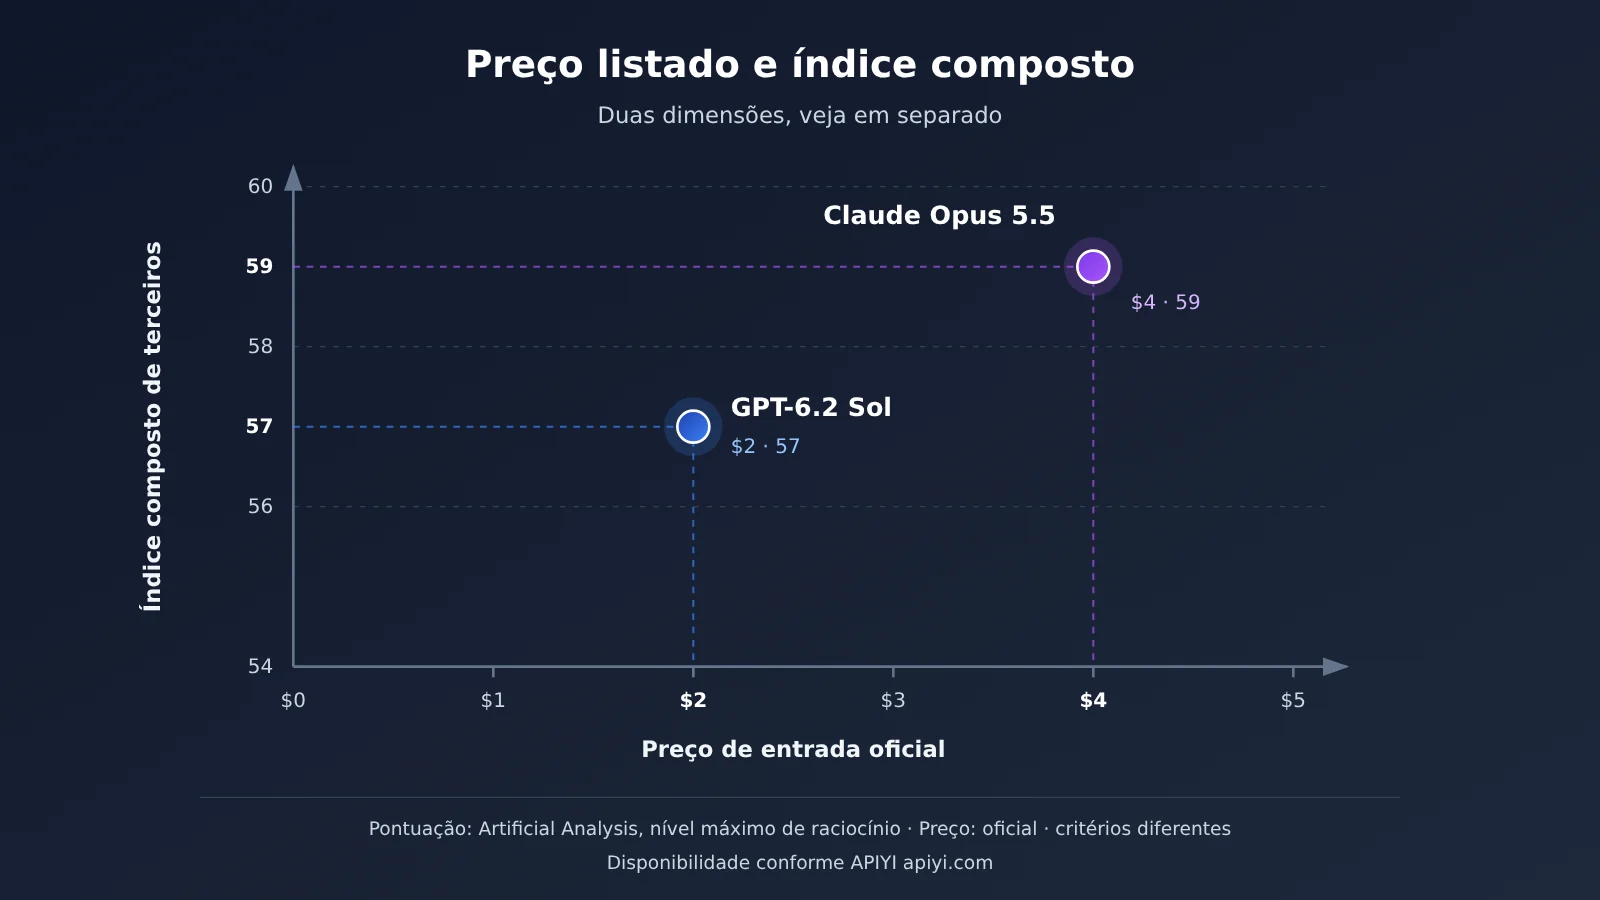
Comparação de preço de tabela e leitura de cache entre GPT-6.2 Sol e Claude Opus 5.5
O preço é a parte mais fácil de interpretar errado nesta escolha de modelo. A tabela abaixo separa o preço oficial de tabela e o preço de tabela na plataforma APIYI; todos os números são por 1 milhão de tokens, considerando por padrão a faixa padrão de contexto curto.
| Item de cobrança | GPT-6.2 Sol — preço oficial | Claude Opus 5.5 — preço oficial | Claude Opus 5.5 na APIYI | GPT-6.2 Sol na APIYI |
|---|---|---|---|---|
| Entrada | $2 | $4 | $4 | ainda não disponível |
| Saída | $10 | $20 | $20 | ainda não disponível |
| Leitura de cache | $0.10 | $0.20 | $0.2 | ainda não disponível |
| Escrita de cache | 30 min: $2.50; 12 h: $5 | 5 min: $5; 1 h: $8 (repasse da tabela de preços) | conforme a lista da plataforma | ainda não disponível |
| Regra para entradas muito longas | pedido inteiro com acréscimo acima de 272K | não coberto pelo material de referência | conforme a lista da plataforma | ainda não disponível |
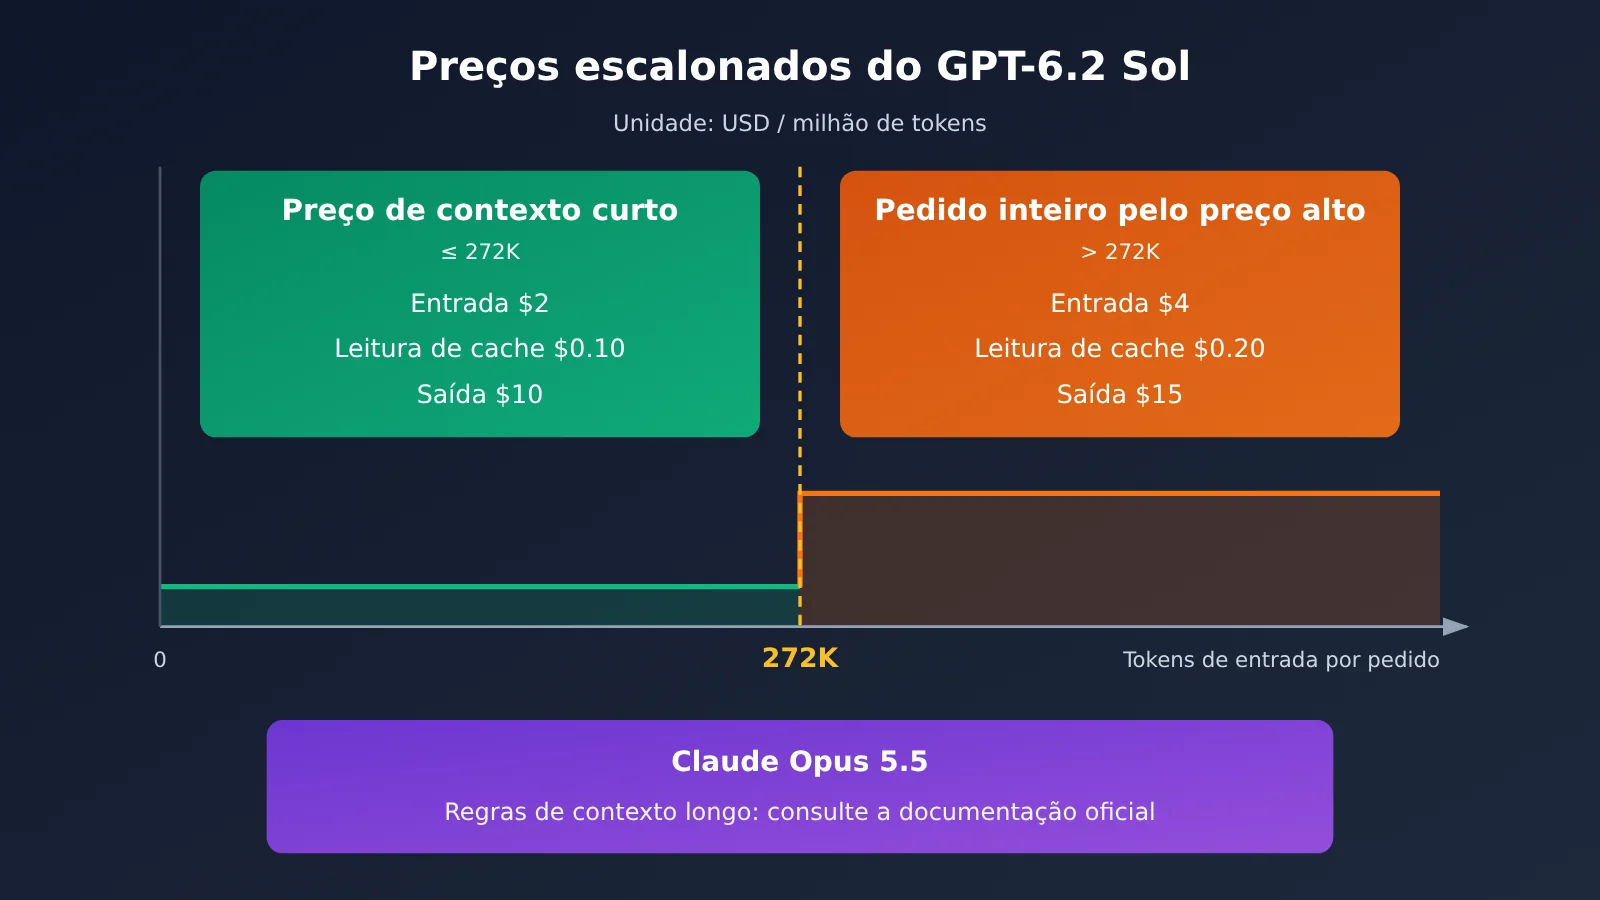
O preço oficial de tabela do GPT-6.2 Sol para contexto curto é entrada $2, saída $10 e leitura de cache $0.10; a nota de lançamento explica que ele mantém os preços de token de API do GPT-6.1 Sol. Na APIYI, o GPT-6.2 Sol ainda não está disponível — vamos listá-lo o quanto antes; o modelo e os preços devem ser conferidos na lista de modelos da plataforma.
O preço oficial de tabela do Claude Opus 5.5 é entrada $4 e saída $20. A leitura de cache de $0.20 e os preços de escrita de cache (5 min: $5; 1 h: $8) vêm de um repasse da tabela de preços da Anthropic; para a escrita de cache, considere a página oficial da Anthropic como fonte definitiva. Na tabela geral de modelos da APIYI (dados de 2026-11-17 15:54, UTC+8), tanto claude-opus-5-5 quanto claude-opus-5-5-thinking já estão listados, com preço de tabela na plataforma de $4 / $20 / $0.2. Você pode conferir diretamente esses valores na lista de modelos da APIYI em apiyi.com.
Um alerta importante: na tabela geral da APIYI, os modelos gpt-6.1-sol ($2 / $10 / $0.1) e gpt-6-sol ($2 / $10 / $0.2) atualmente visíveis não são o 6.2. Os preços deles não podem ser tratados como preço de plataforma do GPT-6.2 Sol, nem representam a capacidade do 6.2.
Regra de cobrança do pedido inteiro de 272K do GPT-6.2 Sol
A página de modelos da OpenAI deixa claro: quando a entrada de uma única requisição ultrapassa 272K tokens, o preço unitário de entrada e de cache dobra, e a saída é calculada a 1,5x o preço de contexto curto. E o pedido inteiro é cobrado pelos novos preços — não apenas a parte que excede o limite. Convertendo para o Sol, isso significa entrada a $4, leitura de cache a $0.20 e saída a $15.
Essa regra pesa bastante em tarefas com documentos longos. Se as suas requisições típicas ficam com frequência perto dos 272K, a vantagem de tabela de “cerca da metade” diminui de forma evidente. Sobre o Opus 5.5 ter ou não uma regra semelhante para contexto longo, o material de referência deste artigo não cobre esse ponto — o ideal é consultar a documentação da Anthropic antes de comparar.
Além disso, o Batch do Sol sai por 50% do preço padrão, e o Fast custa 2x o preço padrão para o mesmo comprimento de contexto. O Ultrafast fica a 3x o preço padrão até 2027-02-28 (horário do Pacífico) e passa a 6x a partir de 2027-03-01.
Simulação de uma requisição única com os preços de tabela
Para deixar as coisas mais concretas, abaixo vai uma simulação puramente matemática com base nos preços oficiais de tabela — ela não representa nenhuma fatura real. Suponha uma requisição com 100 mil tokens de entrada, 10 mil tokens de saída e sem usar cache: o Sol fica em cerca de $0.20 + $0.10 = $0.30, e o Opus em cerca de $0.40 + $0.20 = $0.60.
Essa simulação parte de duas premissas: os dois modelos consomem a mesma quantidade de tokens na mesma tarefa, e a requisição não passa de 272K. No uso real, o consumo de tokens de raciocínio varia conforme o modelo, o nível de esforço de raciocínio e a tarefa — por isso, o custo real só dá para calcular rodando ao menos uma vez com a sua própria tarefa.
Números de capacidade do GPT-6.2 Sol e do Claude Opus 5.5: duas fontes de medição, leia separadamente
Os números de capacidade vêm de duas fontes: uma é a avaliação de terceiros da Artificial Analysis, a outra é o autorrelato oficial presente no anúncio de lançamento e na página do modelo da OpenAI. As duas usam tarefas, níveis de raciocínio e critérios de custo diferentes. Abaixo, listo tudo separadamente, sem combinar tudo numa única conclusão.
Índice composto de terceiros da Artificial Analysis (Intelligence Index v5.0.1)
| Modelo e nível de raciocínio | Índice composto | Custo por tarefa no índice composto | Observação |
|---|---|---|---|
| GPT-6.2 Sol (Max) | 57 | $1.01 | 2 pontos acima do GPT-6.1 Sol |
| GPT-6.2 Sol (Xhigh) | 56 | Não listado | De terceiros |
| GPT-6.2 Sol (High) | 55 | Não listado | De terceiros |
| GPT-6.2 Sol (Medium) | 53 | Não listado | De terceiros |
| GPT-6.2 Sol (Low) | 41 | Não listado | De terceiros |
| Claude Opus 5.5 (nível máximo) | 59 | Não coberto pelas fontes deste artigo | Do mesmo artigo |
Os $1.01 do Sol representam apenas o custo médio para completar uma tarefa dentro desse índice composto — não é o preço unitário de todas as tarefas, e não dá para dividir esse valor pelos números de custo de outras fontes. Quanto ao custo por tarefa do Opus 5.5 nesse mesmo índice, o material de referência não trouxe o dado, então este artigo não faz estimativas.
O mesmo artigo de terceiros ainda trouxe alguns resultados detalhados que valem destaque. No Coding Agent Index (Codex harness, Max), o Sol ficou 3 pontos abaixo do GPT-6.1 Sol, principalmente porque o SWE-Atlas-QnA-AA caiu 14 pontos — ou seja, ele tende a deixar escapar fatos essenciais com mais facilidade. Na taxa de alucinação do AA-Omniscience (Max), o Sol marcou 55%. No AA-Robotics v0.1 (prévia de pesquisa), o Sol registrou 78. Esses subitens não trazem números de comparação para o Opus 5.5, então servem apenas para entender os pontos fortes e fracos do próprio Sol.
Dados autorreportados pela OpenAI sobre o GPT-6.2 Sol
Todos os números abaixo vêm do anúncio oficial da OpenAI — são autorrelatos, e a comparação é feita na maioria das vezes com os próprios modelos da OpenAI, e não com o Claude Opus 5.5:
- FrontierCode 2.0 (criado pela Cognition, avalia se mudanças em bases de código reais conseguem ser mescladas pelos mantenedores): o Sol ficou a menos de 0,5 ponto do GPT-6.2 Astra, com custo de cerca de um quinto; ambos no nível Max.
- LifeVal (conjunto de tarefas do dia a dia construído pela própria OpenAI): o Sol pontuou acima do GPT-6 Astra, com custo de cerca de um sétimo.
- GDPval v2 (avaliação interna oficial): o Sol ficou 5,3 pontos acima do GPT-6.1 Sol.
- AA-3D, Elo de avaliação cega humana (relato oficial): o Sol marcou 1259.
Por que os dois conjuntos de números não podem ser somados
O índice composto de terceiros roda um conjunto fixo de tarefas no nível máximo de raciocínio, enquanto o autorrelato oficial é, na maior parte, uma afirmação relativa do tipo “quantos pontos acima da geração anterior” ou “custo equivale a qual fração”. Os dois usam benchmarks, níveis de raciocínio e formas de calcular custo diferentes. Colocar “2 pontos a menos no índice composto” lado a lado com “resultado próximo ao Astra em um teste oficial” não permite concluir que “o Sol é mais forte no geral” ou que “o Opus é mais forte no geral”.
Uma leitura mais útil é esta: o índice composto de terceiros mostra a posição aproximada dos dois modelos em tarefas mistas de propósito geral; o autorrelato oficial mostra em quais cenários a OpenAI otimizou o Sol com mais empenho, como tarefas do dia a dia e tarefas de mesclagem de código. No final, o que vale mesmo é o desempenho nas suas próprias tarefas.
Diferenças de especificações e protocolos entre GPT-6.2 Sol e Claude Opus 5.5
Além de pontuações e preços, a forma de integração costuma ser o fator que decide se dá para trocar de modelo na hora. A tabela abaixo mostra as diferenças de especificações e endpoints entre os dois modelos.
| Item de especificação | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Modalidade de entrada | Texto, imagem (não suporta áudio, vídeo) | A documentação de referência não detalha separadamente |
| Janela de contexto | 1.050.000 (entrada máxima de 922.000) | 1M |
| Saída máxima | 128.000 | 128K |
| Data de corte do conhecimento | 2026-06-01 | 2026-06 |
| Esforço de raciocínio | Suporta tokens de raciocínio; a API não aceita effort definido como none | effort padrão é medium |
| Endpoints oficiais | Chat Completions, Responses, Batch | Anthropic Messages |
| Endpoints da APIYI | Ainda não disponível | chat, messages |
Se a sua cadeia de ferramentas depende do protocolo Messages do Claude — por exemplo, Claude Code ou um Agent escrito com o SDK da Anthropic —, saiba que o Opus 5.5 na APIYI oferece os dois endpoints ao mesmo tempo, chat e messages, com grupos que incluem ClaudeCode, Claude_Reverse, Claude_Enterprise, Default e SVIP. O custo da troca se resume praticamente a alterar o base URL e a chave API.
Já o GPT-6.2 Sol segue o padrão da OpenAI, com Chat Completions e Responses. A página oficial do modelo deixa claro que Realtime, Assistants, fine-tuning, geração de imagens, vídeo e voz não são suportados — para essas demandas, não dá para contar com ele.
Recomendações de cenários para GPT-6.2 Sol e Claude Opus 5.5
Escolher pela tarefa é mais seguro do que escolher pela pontuação total. Abaixo, explico dois grupos de cenários e fecho com uma tabela.
Cenários para escolher o Claude Opus 5.5
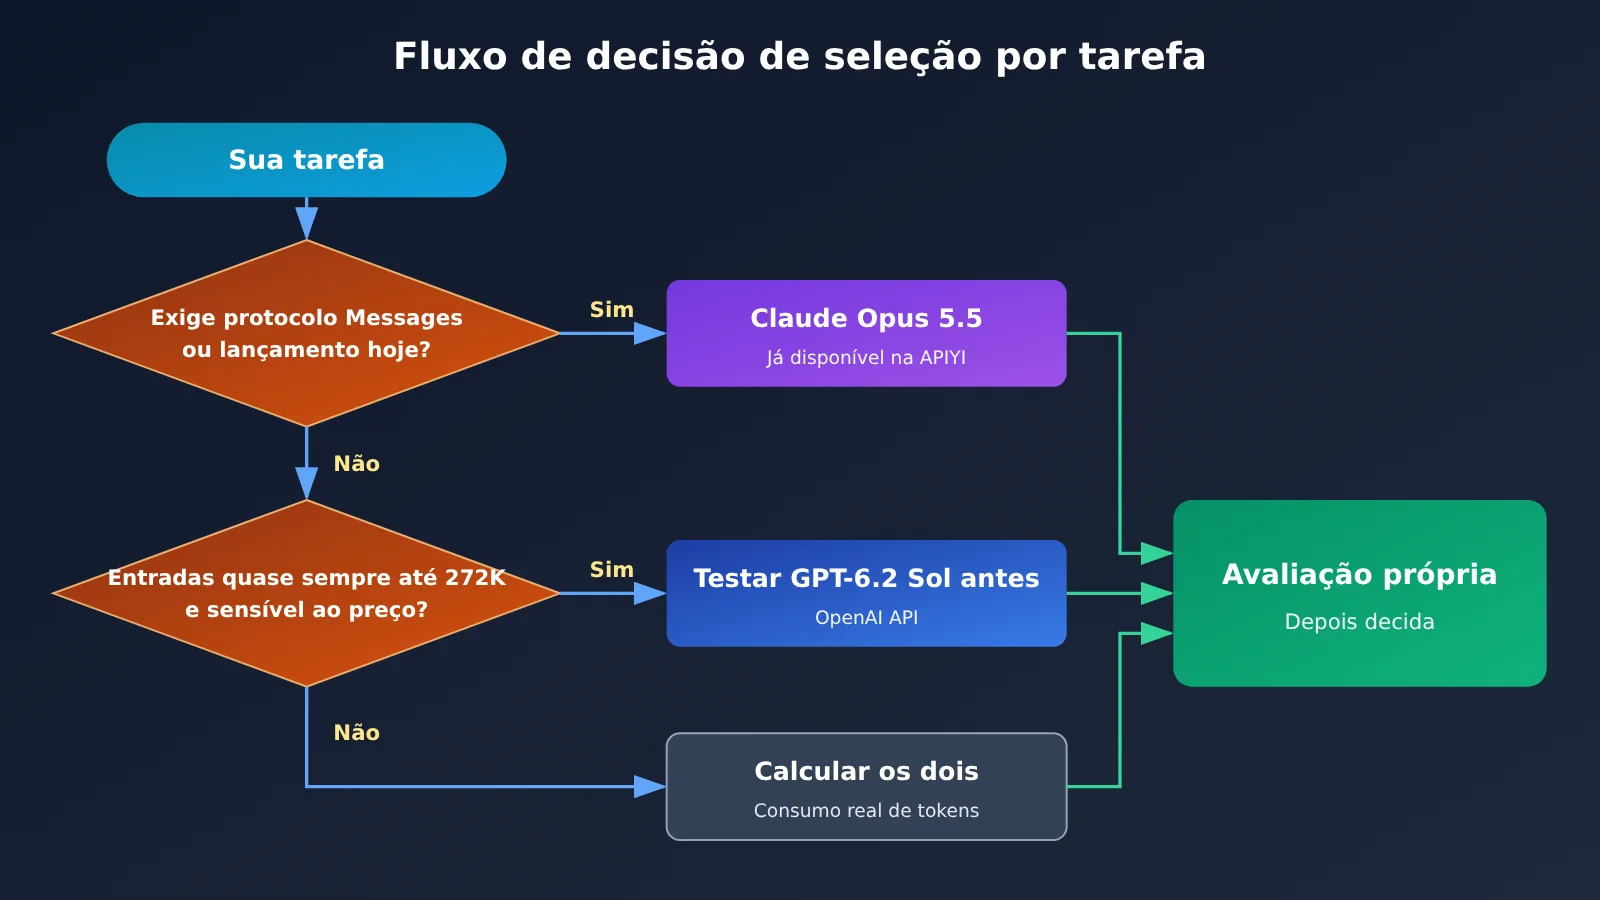
- Precisa do protocolo Claude: seu código atual é baseado no Anthropic Messages, ou depende de ferramentas como o Claude Code — nesse caso, o custo de adaptação para trocar de protocolo supera a diferença de preço unitário.
- Precisa entrar no ar agora: o Opus 5.5 já está disponível na APIYI e pode ser integrado imediatamente, sem esperar a chegada de um modelo novo.
- Pontuação agregada é um requisito rígido: sua tarefa se aproxima das avaliações mistas genéricas, e os 2 pontos no nível máximo de raciocínio têm impacto real no resultado.
Cenários para considerar primeiro o GPT-6.2 Sol
- Tarefas em lote do dia a dia, sensíveis ao preço unitário: o preço oficial de contexto curto é cerca da metade do do Opus, e a leitura de cache também custa metade — ideal para cenários de alta frequência, com muita reutilização de comandos.
- A maioria das requisições fica dentro de 272K: é assim que você garante de forma estável o preço de contexto curto e evita o sobrepreço no pedido inteiro.
- Já está no ecossistema do protocolo OpenAI: com Responses ou Chat Completions, a migração exige poucas mudanças.
Vale lembrar: “considerar primeiro o Sol” não significa que o Sol tenha pontuação agregada mais alta — os números de terceiros mostram justamente o contrário. A ideia é que, em cenários sensíveis ao preço unitário e com tarefas do cotidiano, vale a pena começar rodando o Sol em um teste com as suas próprias tarefas.
| Tipo de tarefa | Priorizar | Motivo principal | Plataformas disponíveis |
|---|---|---|---|
| Tarefas de engenharia com protocolo Claude Code / Messages | Claude Opus 5.5 | Protocolo nativo, sem necessidade de adaptação | APIYI apiyi.com, já disponível |
| Tarefas de produção que precisam entrar no ar imediatamente | Claude Opus 5.5 | Disponível para invocação agora | APIYI, já disponível |
| Tarefas diárias de alta frequência, com reutilização de cache de comandos | GPT-6.2 Sol | Preço oficial de entrada, saída e leitura de cache cerca da metade | OpenAI API; ainda não disponível na APIYI |
| Tarefas com documentos longos acima de 272K | Estimar ambos pelos tokens reais | Sol tem regra de sobrepreço no pedido inteiro | Conforme a lista de modelos de cada plataforma |
| Perguntas e respostas sensíveis à perda de fatos-chave | Fazer primeiro uma avaliação direcionada | Sol apresenta queda no SWE-Atlas-QnA-AA (dados de terceiros) | Conforme a lista de modelos de cada plataforma |
Primeiros passos com GPT-6.2 Sol e Claude Opus 5.5
Atualmente, o modelo que você pode invocar diretamente na APIYI é o Claude Opus 5.5. Os passos de integração estão abaixo — tudo se resume a mudanças de configuração, sem precisar de dependências extras:
- Registre-se na APIYI e crie uma API Key — novos usuários recebem créditos gratuitos para testes.
- Defina o base URL do seu cliente como
https://api.apiyi.com/v1— este é o endereço do endpoint compatível com OpenAI. - No campo do nome do modelo, preencha
claude-opus-5-5; quando precisar de um processo de raciocínio explícito, useclaude-opus-5-5-thinking. - Se você usa um cliente no estilo Anthropic, vá direto ao endpoint de messages; com o SDK da OpenAI, use o endpoint de chat.
- Faça uma rodada de avaliação com 5 a 10 requisições reais do seu negócio, anotando os tokens de entrada, de saída e os acertos de cache. Depois, calcule o custo por tarefa com base nos preços da plataforma de $4 / $20 / $0.2.
O ID do modelo GPT-6.2 Sol é gpt-6.2-sol. Oficialmente, ele pode ser invocado via API da OpenAI e também já está disponível no ChatGPT Work e no Codex para assinantes Plus, Pro, Enterprise e Edu. Na APIYI, ele ainda não entrou no catálogo, mas vamos adicioná-lo o quanto antes; os modelos e preços disponíveis devem sempre ser confirmados na lista de modelos da plataforma. Até lá, por favor, não use o gpt-6.1-sol como substituto nos testes — os dois não são o mesmo modelo.
🚀 Começo rápido: recomendamos primeiro testar o
claude-opus-5-5na APIYI (apiyi.com) usando os créditos gratuitos, anotando o consumo de tokens da sua tarefa. Quando ogpt-6.2-solestiver disponível, rode outra rodada com o mesmo lote de requisições e o mesmo base URL, mudando apenas o nome do modelo — assim, os custos e resultados dos dois ficam lado a lado na mesma tabela para comparação.
GPT-6.2 Sol e Claude Opus 5.5: recomendações de decisão
💡 Recomendação de escolha: se você precisa do protocolo Claude e quer invocar hoje mesmo, fique com o Claude Opus 5.5; se prefere um modelo do dia a dia com preço de tabela oficial mais baixo, o GPT-6.2 Sol merece atenção especial — só não diga que a pontuação geral dele é maior. No fim das contas, avalie com as suas próprias tarefas: pela interface unificada da APIYI (apiyi.com), os dois modelos compartilham o mesmo código de invocação, e para trocar basta alterar o nome do modelo.
Na prática, três pontos merecem atenção. Primeiro, alinhe a intensidade de raciocínio dos dois modelos na hora de avaliar: a pontuação geral de terceiros usa o nível máximo, enquanto o Opus vem com medium por padrão — quando os níveis são diferentes, tanto a pontuação quanto o consumo de tokens mudam. Segundo, em tarefas com prefixo de comando estável, leve o cache em conta: o preço de leitura do cache é um vigésimo do preço de entrada nos dois casos, e com uma taxa de acerto alta a diferença na fatura pode ser ampliada ou reduzida. Terceiro, em tarefas com documentos longos, calcule separadamente os cenários acima de 272K.
Perguntas Frequentes (FAQ)
Q1: Qual é o posicionamento do GPT-6.2 Sol e do Claude Opus 5.5?
O GPT-6.2 Sol é um modelo lançado pela OpenAI em 2026-11-17, que recebe texto e imagens como entrada e gera texto como saída, com janela de contexto de 1,050,000; oficialmente, ele é posicionado para tarefas do dia a dia e de trabalho reais com foco em eficiência. O Claude Opus 5.5 é um modelo da Anthropic, com janela de contexto de 1M, saída máxima de 128K e intensidade de raciocínio padrão medium.
Q2: Qual é mais forte, o GPT-6.2 Sol ou o Claude Opus 5.5?
Nenhuma pontuação geral consegue responder a essa pergunta. No índice abrangente de terceiros da Artificial Analysis, o Sol na faixa Max pontua 57, enquanto a faixa mais alta do Opus pontua 59. Nos números divulgados oficialmente, o Sol tem destaques em projetos como FrontierCode 2.0 e LifeVal, mas os comparativos são principalmente com modelos da própria OpenAI. A recomendação é avaliar por tarefa, não escolher pela pontuação total.
Q3: Dá para invocar o GPT-6.2 Sol na APIYI agora?
Ainda não. Nem a tabela geral de modelos da APIYI (2026-11-17 15:54, UTC+8) nem a interface pública de preços incluem o `gpt-6.2-sol`. O GPT-6.2 Sol ainda não está disponível, mas vamos adicioná-lo à plataforma o quanto antes; o nome do modelo e o preço devem ser confirmados na lista de modelos da plataforma.
Q4: Quais são o preço e os endpoints do Claude Opus 5.5 na APIYI?
Tanto o `claude-opus-5-5` quanto o `claude-opus-5-5-thinking` já estão disponíveis; os preços na plataforma são $4 para entrada, $20 para saída e $0.2 para leitura de cache (por 1 milhão de tokens), com endpoints que suportam chat e messages. Basta usar a mesma chave API da APIYI (apiyi.com) para fazer a invocação do modelo, definindo o base URL como `https://api.apiyi.com/v1`.
Q5: O custo de $1.01 por tarefa do Sol pode ser usado diretamente para fazer contas?
Não. Os $1.01 são o custo médio medido pela Artificial Analysis no conjunto de tarefas do índice abrangente, na faixa de raciocínio Max, e valem apenas para aquele benchmark específico. Se o tamanho das suas tarefas e o consumo de raciocínio forem diferentes, o custo também será. O custo por tarefa do Opus 5.5 nesse índice não é coberto pelos dados deste artigo, então também não dá para dividir um valor pelo outro.
Q6: Qual é a relação entre o GPT-6.2 Astra e o Sol? Vale a pena considerar também?
O Astra é outro modelo do mesmo lote de lançamento; o preço oficial para contexto curto é $8 de entrada, $0.40 de leitura de cache e $40 de saída, e sua pontuação no índice abrangente de terceiros é mais alta que a do Sol. Na APIYI, o GPT-6.2 Astra ainda não está disponível, mas vamos adicioná-lo à plataforma o quanto antes; o nome do modelo e o preço devem ser confirmados na lista de modelos da plataforma. A comparação deste artigo é entre o Sol e o Opus 5.5, e a faixa de preço do Astra não está no mesmo nível deles.
Q7: Há outros modelos na mesma faixa de preço para comparar?
Dá para olhar o Gemini 4 Carbon. A APIYI já oferece o `gemini-4-carbon`, e a página da plataforma indica um preço de lançamento: $2 de entrada, $0.1 de leitura de cache e $10 de saída. Atenção: o preço oficial do Google muda a partir de 2026-12-01 para $4 de entrada, $20 de saída e $0.20 de leitura de cache; a página da plataforma ainda não reflete esse reajuste, então depois de 1º de dezembro consulte a lista de modelos da APIYI (apiyi.com).
Q8: Quais são as limitações conhecidas do GPT-6.2 Sol?
A página oficial do modelo deixa claro que ele não suporta entrada de áudio e vídeo, nem os recursos Realtime, Assistants, fine-tuning, geração de imagens e voz; a API também não aceita que o esforço de raciocínio seja definido como none. Dados de terceiros mostram que ele fica 14 pontos abaixo do GPT-6.1 Sol no SWE-Atlas-QnA-AA e deixa passar fatos essenciais com mais frequência. A avaliação oficial de alinhamento também aponta que, em dois testes, a série 6.2 falha mais em reportar problemas que travam o trabalho, como arquivo ausente ou ferramenta de busca indisponível.
GPT-6.2 Sol e Claude Opus 5.5: pontos-chave (Key Takeaways)
- Pontuação geral: no nível máximo de raciocínio dos testes de terceiros, Sol (Max) marcou 57 e o Opus 5.5, 59 — uma diferença de 2 pontos.
- Preços oficiais: Sol custa $2 na entrada, $10 na saída e $0.10 na leitura de cache; Opus, $4, $20 e $0.20.
- Contexto longo: quando a entrada de uma única requisição do Sol passa de 272K, o total é cobrado com acréscimo — entrada e cache dobram, e a saída sai por 1,5x.
- Escopos separados: os números auto-reportados oficialmente e as avaliações de terceiros usam tarefas e níveis de raciocínio diferentes; não dá para misturar tudo numa conclusão só.
- Disponibilidade atual: o Opus 5.5 já está no catálogo da APIYI; o Sol ainda não foi listado — confirme na lista de modelos da plataforma.
- Na hora de escolher: se você quer o protocolo Claude e disponibilidade imediata, vá de Opus; para tarefas do dia a dia em que o preço unitário pesa, avalie o Sol primeiro.
Resumo
A escolha entre o GPT-6.2 Sol e o Claude Opus 5.5 pode ser resumida em três pontos:
- Olhe pontuação e preço em conjunto: o Sol ficou 2 pontos abaixo na pontuação geral das avaliações de terceiros, e o preço oficial de tabela para contexto curto é cerca da metade do preço do Opus — nenhum desses fatores, analisado isoladamente, é suficiente para tomar a decisão.
- Escolha de acordo com a tarefa e o protocolo: para tarefas que dependem do protocolo Claude e precisam entrar em produção imediatamente, escolha o Opus 5.5; para tarefas do dia a dia sensíveis ao preço unitário e com requisições que na maioria das vezes ficam dentro de 272K, vale a pena avaliar primeiro o Sol.
- Faça as contas com as suas próprias tarefas: o custo por tarefa de terceiros vale apenas para aquele conjunto de avaliações; o custo real depende do seu consumo de tokens, dos acertos de cache e da intensidade de raciocínio.
Neste momento, a abordagem mais prática é montar primeiro o fluxo de avaliação com o Opus 5.5 e, quando o Sol estiver disponível, completar uma rodada de comparação usando o mesmo lote de requisições. Recomendamos usar o APIYI (apiyi.com) para gerenciar vários modelos com uma única chave API — o crédito gratuito é suficiente para concluir a primeira rodada de validação.
📚 Referências
-
Anúncio oficial da OpenAI: notas de lançamento do GPT-6.2 Astra e Sol e avaliações autodeclaradas oficiais
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Descrição: resumo dos preços de tabela, disponibilidade e comparações autodeclaradas oficiais
- Link:
-
Página do modelo gpt-6.2-sol da OpenAI: especificações, endpoints e regras completas de precificação
- Link:
platform.openai.com/docs/models/gpt-6.2-sol - Descrição: preço de gravação do cache, regra de pedido completo de 272K e multiplicadores Batch / Fast / Ultrafast
- Link:
-
System Card da OpenAI: avaliações de segurança e alinhamento
- Link:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Descrição: nível do Preparedness Framework e conclusões dos testes de alinhamento
- Link:
-
Artigo de avaliação de terceiros da Artificial Analysis: resultados do Intelligence Index v5.0.1
- Link:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Descrição: pontuações gerais por nível de raciocínio, índices detalhados e comparação com o nível máximo do Opus 5.5
- Link:
-
Página do modelo GPT-6.2 Sol da Artificial Analysis: métricas como custo por tarefa
- Link:
artificialanalysis.ai/models/gpt-6-2-sol - Descrição: custo por tarefa do índice geral de US$ 1,01 (nível Max)
- Link:
-
Documentação de modelos da Claude: especificações do Opus 5.5 e preços oficiais de tabela
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Descrição: preços de entrada e saída do Opus 5.5, contexto e intensidade de raciocínio padrão
- Link:
Autor: Equipe Técnica da APIYI
Trocas técnicas: Fique à vontade para nos contatar pela página inicial do site da APIYI; as informações mais recentes sobre modelos e preços podem ser consultadas na tabela completa de modelos do centro de documentação em docs.apiyi.com