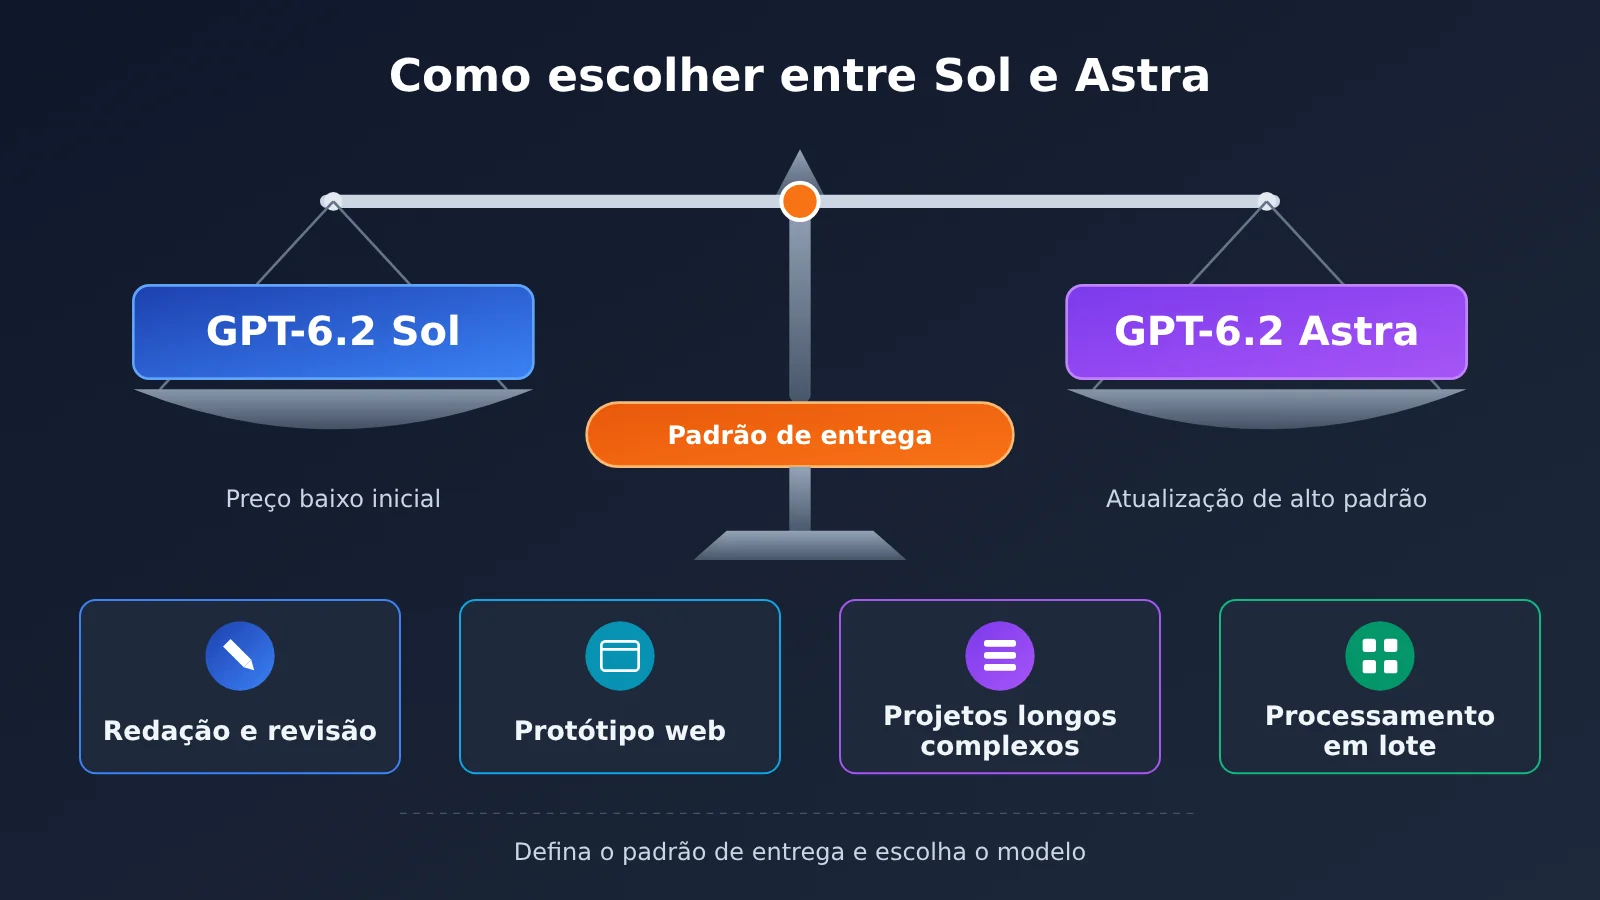
Resposta direta: na maioria das tarefas de escrita cotidiana, protótipos web e processamento em lote, a recomendação é começar com o GPT-6.2 Sol; só migre para o GPT-6.2 Astra quando a saída do Sol não atingir os critérios de entrega definidos de antemão ou quando o custo de retrabalho já superar a diferença de preço. O preço oficial de tabela das APIs dos dois tem uma diferença de 4 vezes. As avaliações oficiais mostram que, em algumas tarefas, a diferença entre eles não é grande, mas esses resultados valem apenas para avaliações específicas e não devem ser tomados diretamente como conclusão geral. Portanto, o ponto central dessa escolha não é qual modelo é mais forte, mas qual nível de critérios de entrega a sua tarefa exige.
As recomendações acima são sugestões editoriais, não uma orientação oficial da OpenAI para seleção de modelos, nem uma conclusão de nossos próprios testes. Os dados de avaliação citados no texto vêm todos de relatórios oficiais da OpenAI.
O que você vai encontrar neste artigo?
- Datas de lançamento, escopo de disponibilidade, capacidades de entrada e saída e preço oficial de tabela da API do GPT-6.2 Sol e do Astra.
- Quais números das avaliações oficiais ajudam a entender o desempenho e quais não podem ser extrapolados.
- Em cada um dos 4 tipos de cenário — escrita e revisão cotidiana, protótipos web, projetos longos e complexos e processamento em lote sensível a orçamento —, por qual modelo começar, quando faz sentido migrar para o Astra e quais etapas exigem verificação humana.
- Uma planilha de registro de testes A/B pronta para copiar e usar, para comparar precisão factual, usabilidade, número de rodadas de retrabalho e custo total.
Índice: comece pela tabela de conceitos “To Know” e pelo resumo de impactos para entender rapidamente os termos e o que este lançamento significa para diferentes públicos. A Parte 1 reúne os fatos objetivos, incluindo informações de lançamento, avaliações oficiais e regras de preço. A Parte 2 traz a análise e o julgamento editorial, com uma tabela de decisão por cenário, um método de estimativa de custos e um fluxo de teste A/B, além de links das fontes no final.
Para saber: GPT-6.2 Sol e conceitos relacionados ao Astra
| Conceito | Explicação breve |
|---|---|
| GPT-6.2 Astra | Modelo da série GPT-6.2 lançado pela OpenAI em 17 de novembro de 2026, com posicionamento e preço mais altos |
| GPT-6.2 Sol | Outro modelo lançado no mesmo dia; o preço oficial da API é cerca de um quarto do Astra |
| GDPval v2 | Uma das avaliações usadas no relatório oficial da OpenAI; este artigo cita apenas o ganho informado oficialmente |
| ALE (Agents’ Last Exam) | Avalia fluxos de trabalho profissionais com múltiplas etapas; aqui, o ganho usa o GPT-6 Astra como linha de base e não deve ser confundido com o GDPval v2 |
| FrontierCode 2.0 | Avaliação de programação no relatório oficial; a comparação de custos citada neste artigo só vale para esse teste |
| Nível de raciocínio max | O nível mais alto nas configurações de intensidade de raciocínio do modelo, normalmente implicando mais pensamento e custo maior |
| Ponto percentual | A diferença entre duas porcentagens; por exemplo, ir de 50% para 56,2% é um ganho de 6,2 pontos percentuais |
| Leitura de cache | Quando o conteúdo de entrada reutilizado tem correspondência no cache, ele é cobrado a um preço unitário menor |
| Gravação em cache | Custo gerado ao gravar conteúdo no cache; a documentação oficial informa que há cobrança separada |
| Limite de 272K | Quando a entrada de uma única requisição ultrapassa cerca de 272 mil tokens, a requisição inteira passa a ser cobrada a uma taxa multiplicadora mais alta |
| Critério de entrega | Premissa de seleção proposta pela editoria: deixar claro de antemão “até que ponto o resultado pode ser considerado utilizável” |
Visão rápida do impacto do GPT-6.2 Sol e Astra
- Usuários comuns do ChatGPT: a documentação oficial de ajuda mostra que esta rodada está sendo liberada gradualmente para o ChatGPT Work e o Codex, e o Chat comum não está no escopo desta leva — ou seja, no curto prazo você provavelmente não vai sentir mudanças.
- Desenvolvedores e pequenas equipes: os dois modelos serão disponibilizados gradualmente via API. Como a diferença de preço unitário é de 4x, a estratégia de roteamento de modelos afeta diretamente a conta e vale a pena ser planejada com antecedência.
- Criadores de conteúdo: a entrada dos dois modelos é texto e imagem, e a saída é texto. Eles não têm capacidade nativa de geração de vídeo, portanto não substituem ferramentas de geração de vídeo.
- Usuários de processamento em lote com orçamento apertado: a regra de multiplicação aplicada a entradas longas acima de 272K tem grande impacto no custo de processar grandes volumes de documentos longos — mais importante do que simplesmente comparar o preço unitário.
1. Fatos objetivos sobre GPT-6.2 Sol e Astra
Esta seção reúne apenas as informações públicas oficiais da OpenAI, sem julgamentos editoriais. A data de verificação é 18 de novembro de 2026.
1.1 Lançamento e escopo de disponibilização do GPT-6.2 Sol e Astra
A OpenAI lançou simultaneamente, em 17 de novembro de 2026, o GPT-6.2 Astra e o GPT-6.2 Sol. Segundo a documentação oficial, os dois modelos serão liberados gradualmente para o ChatGPT Work, o Codex e a API — o Chat comum não entra no escopo desta rodada. “Liberação gradual” significa que contas diferentes podem receber acesso em momentos diferentes; o documento de ajuda oficial é a referência para isso.
Em termos de formato de capacidade, os dois modelos aceitam entrada de texto e imagem, e a saída é texto. O material oficial não menciona capacidade nativa de geração de vídeo. Se a sua necessidade é gerar vídeo, este lançamento não resolve diretamente.
1.2 Dados oficiais de avaliação do GPT-6.2 Sol e Astra
A tabela abaixo resume as conclusões de avaliação do relatório oficial. Atenção: cada linha é uma avaliação independente, e a linha de base de comparação também é diferente — não dá para comparar os números de linhas diferentes lado a lado.
| Avaliação | Objeto | Resultado no relatório oficial | Restrição de uso |
|---|---|---|---|
| GDPval v2 | GPT-6.2 Astra | Ganho de 6,2 pontos percentuais sobre o GPT-6 Astra, com 22% menos tokens de saída | A linha de base é a geração anterior, o Astra |
| GDPval v2 | GPT-6.2 Sol | Ganho de 5,3 pontos percentuais sobre o GPT-6.1 Sol | A linha de base é o GPT-6.1 Sol, diferente da linha de base do Astra |
| ALE | GPT-6.2 Astra | Ganho de 5,2 pontos sobre o GPT-6 Astra | A unidade é “pontos”, não pode ser misturada com os “pontos percentuais” do GDPval |
| FrontierCode 2.0 | Sol comparado ao Astra | Com ambos no nível de raciocínio max, a diferença entre Sol e Astra fica dentro de 0,5 ponto, e o custo da tarefa é cerca de 1/5 do Astra | Vale apenas para esse teste e esse nível de raciocínio — não é uma conclusão geral de custo |
Todos os dados acima são do relatório oficial da OpenAI, não são resultados de testes do nosso time. Sobre a redução de 22% nos tokens de saída do Astra: esse número é dado no contexto do GDPval v2, e se ele se estende para a sua tarefa específica você precisa verificar por conta própria.
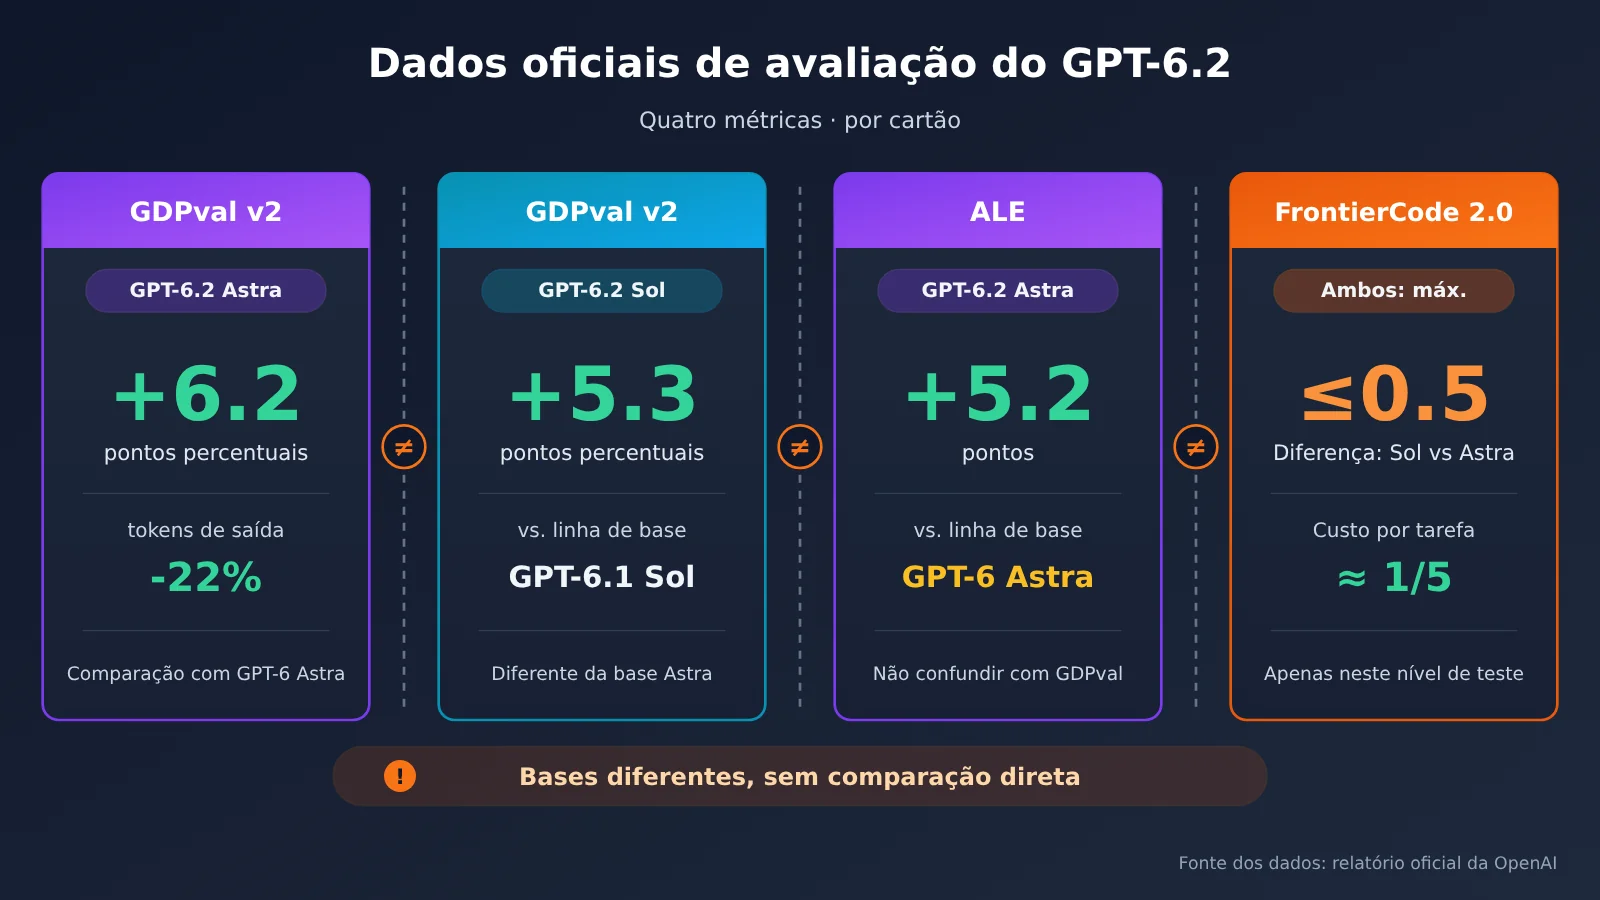
A imagem acima divide as 4 avaliações em cartões independentes, para evitar que o leitor coloque lado a lado números de linhas de base diferentes. Se você quiser fazer um comparativo com os dados do seu próprio negócio, pode registrar os resultados seguindo o modelo da seção 2.4 e depois alternar entre os modelos no mesmo conjunto de código usando uma interface compatível com OpenAI, como o APIYI apiyi.com.
1.3 Regras oficiais de preços da API do GPT-6.2 Sol e Astra
A seguir estão os preços padrão da API oficial, em dólares por milhão de tokens:
| Item de cobrança | GPT-6.2 Astra | GPT-6.2 Sol | Descrição |
|---|---|---|---|
| Entrada sem cache | $8 | $2 | Sol equivale a 1/4 da Astra |
| Leitura de cache | $0.4 | $0.1 | Preço unitário da entrada após acerto no cache |
| Saída | $40 | $10 | Sol equivale a 1/4 da Astra |
| Gravação de cache | Cobrado à parte | Cobrado à parte | Consulte a página oficial do modelo para detalhes |
| Entrada acima de 272K | Taxas de entrada e de cache para toda a solicitação ×2, saída ×1.5 | O mesmo | Calculado sobre a solicitação inteira, não apenas sobre a parte excedente |
É preciso prestar atenção especial à última linha. Após ultrapassar o limite de 272K, o multiplicador se aplica à solicitação inteira, e não apenas aos tokens que excedem o limite. Para tarefas que precisam incluir muitos documentos longos, essa regra deve ser considerada separadamente no orçamento, em vez de olhar apenas para o preço base.
💡 Observação sobre preços: A tabela acima traz os preços padrão da API oficial da OpenAI. Os preços e a disponibilidade em plataformas de terceiros precisam ser verificados à parte. Este artigo não verificou se esses dois modelos estão disponíveis no APIYI apiyi.com; consulte a lista de modelos da plataforma.
2. Como escolher entre GPT-6.2 Sol e Astra: análise do editor
O conteúdo a seguir é uma inferência e recomendação do editor com base nos fatos da Parte 1; não representa a opinião oficial da OpenAI e também não foi verificado por nossos testes práticos.
2.1 Defina primeiro o critério de entrega, depois escolha entre GPT-6.2 Sol e Astra
Muitas pessoas, ao escolher um modelo, têm como primeira reação perguntar “qual é o mais poderoso”. Mas os dados oficiais do FrontierCode 2.0 sugerem outro ângulo: nesse teste, quando ambos estão na configuração de raciocínio max, a diferença entre Sol e Astra fica dentro de 0,5 ponto, enquanto o custo da tarefa equivale a apenas cerca de 1/5. Mesmo que essa conclusão não possa ser extrapolada, ela já basta para mostrar que o ganho de “mais poderoso” pode ser pequeno, e a diferença de custo pode ser grande.
Por isso, o editor sugere responder a três perguntas antes de escolher o modelo: quem vai usar esse resultado? qual é o custo de um erro? quantas rodadas de retrabalho no máximo são aceitáveis? Quanto mais claras forem as respostas, mais fácil será julgar se o Sol já é suficiente. Se o critério de entrega não estiver bem escrito, trocar para o Astra será apenas repetir tentativa e erro de uma forma mais cara.
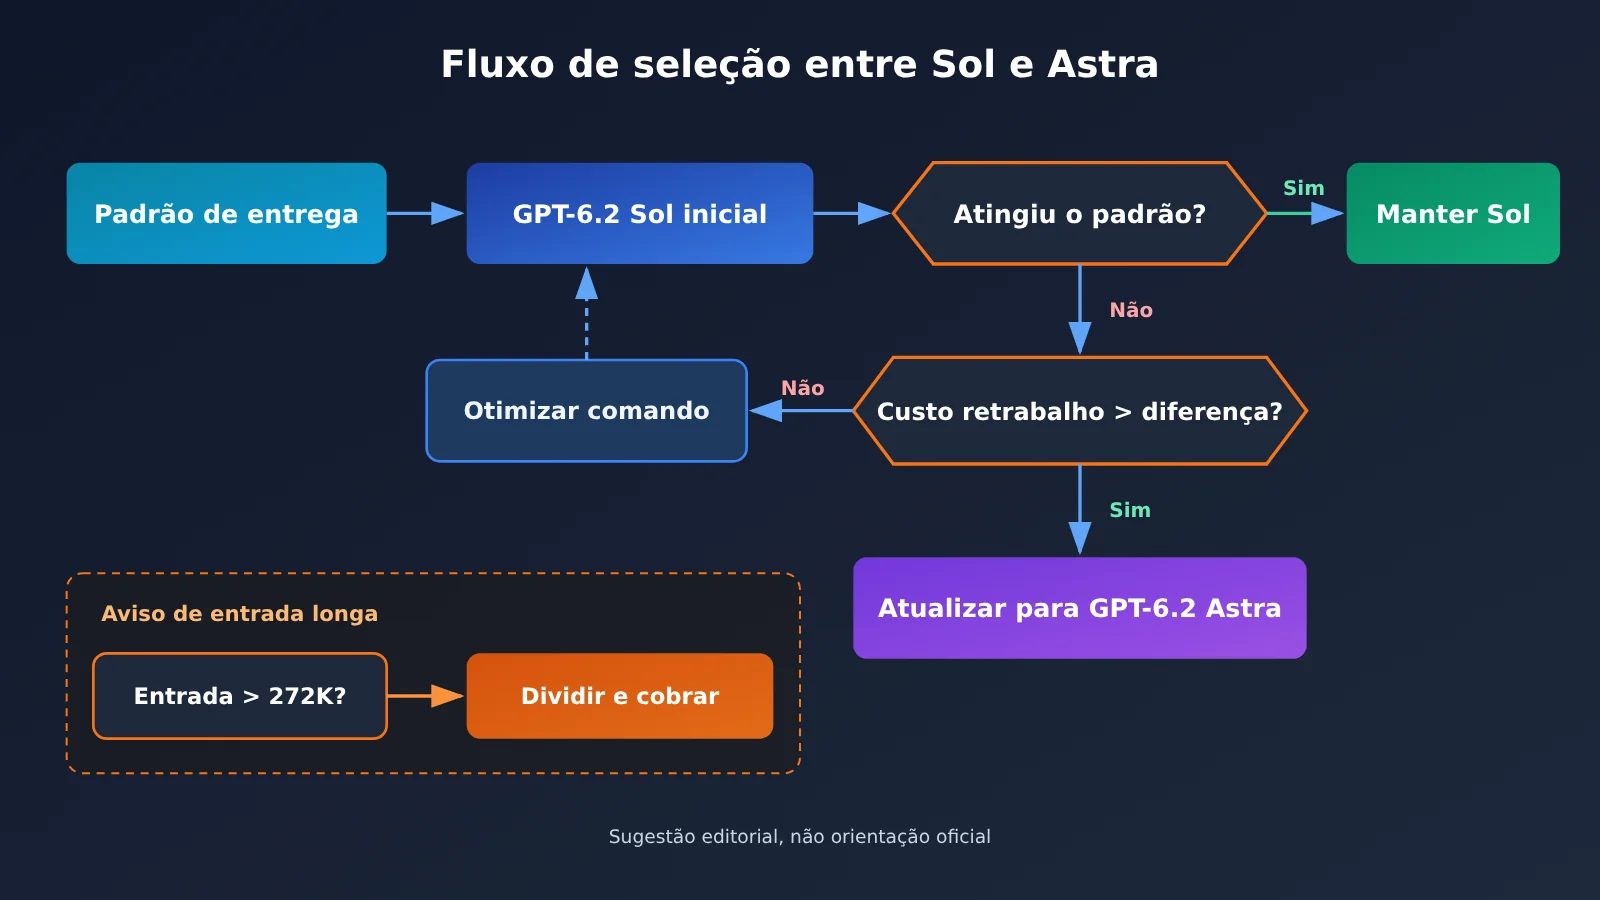
2.2 Tabela de decisão para 4 tipos de cenários com GPT-6.2 Sol e Astra
A tabela abaixo é uma sugestão editorial, não uma diretriz oficial. “Condições de gatilho para upgrade” significa que, quando essas situações ocorrem, vale a pena tentar o Astra; já os “pontos de verificação manual” são etapas que não podem ser omitidas, independentemente do modelo usado.
| Cenário | Modelo inicial | Condições de gatilho para upgrade para o Astra | Pontos que exigem verificação manual |
|---|---|---|---|
| Revisão e edição de textos do dia a dia | GPT-6.2 Sol | Após 2 a 3 rodadas consecutivas ainda não atende aos requisitos de tom ou estrutura; é preciso lidar com textos longos que exigem argumentação rigorosa | Fatos, dados, citações e nomes de pessoas; se houve alteração não autorizada do significado original |
| Protótipo de página web | GPT-6.2 Sol | A lógica de interação abrange várias páginas e o código gerado pelo Sol apresenta erros de estado repetidamente; é necessário reproduzir com alta fidelidade com base nas imagens do design | Executar de fato no navegador; validação de formulários, adaptação para dispositivos móveis; se os pacotes de dependência realmente existem |
| Projetos longos e complexos | Depende do padrão de entrega, pode-se tentar o Astra diretamente | Cadeia de tarefas longa, muitas dependências de contexto, um erro em um ponto pode causar grande retrabalho a jusante | Pontos-chave de decisão, consistência entre arquivos, cobertura de testes |
| Processamento em lote sensível a orçamento | GPT-6.2 Sol | A taxa de erro na amostragem excede o limite que você definiu e o custo de correção no pós-processamento é maior | Verificação por amostragem proporcional; se uma única entrada ultrapassa 272K; taxa de acerto de cache |
No cenário de revisão e edição de textos do dia a dia, a dificuldade geralmente é a precisão factual e a aderência ao estilo, não a profundidade de raciocínio. Começar com o Sol é mais econômico, mas, independentemente do modelo usado, dados e citações devem ser verificados manualmente.
No cenário de protótipo de página web, “conseguir rodar” é um critério rígido e pode ser julgado objetivamente. Para determinar se o Sol é suficiente, é preciso executar de fato e verificar as interações centrais, os estados de erro e a adaptação para dispositivos móveis; não se pode decidir sobre o upgrade apenas com base em um único sucesso de execução.
Projetos longos e complexos são o cenário com mais motivos para considerar o Astra diretamente. O relatório oficial indica uma redução de 22% nos tokens de saída no GDPval v2, usando o antigo GPT-6 Astra como linha de base de comparação, e não se pode estimar a partir disso a economia em relação ao GPT-6.2 Sol. O custo total da tarefa dos dois novos modelos ainda precisa ser verificado por conta própria sob o mesmo padrão de entrega. Já no processamento em lote sensível a orçamento, deve-se priorizar o controle do comprimento de cada entrada individual, evitando acionar o multiplicador de 272K.
2.3 Método de estimativa de custos do GPT-6.2 Sol e Astra
A seguir, faço um cálculo ilustrativo com os preços oficiais padrão, apenas para mostrar o impacto das regras de cobrança; ele não representa o consumo de nenhuma tarefa real. Suponha uma requisição única com 50K tokens de entrada (sem cache) e 5K tokens de saída:
- Sol: 0,05 × $2 + 0,005 × $10 = $0,15
- Astra: 0,05 × $8 + 0,005 × $40 = $0,60
Se aumentarmos a entrada para 300K tokens e a saída para 10K tokens, o multiplicador de 272K entra em ação:
- Sol: 0,3 × $4 + 0,01 × $15 = $1,35
- Astra: 0,3 × $16 + 0,01 × $60 = $5,40
Desse exemplo saem duas conclusões. Primeira: com o mesmo consumo de tokens, a diferença de preço entre os dois fica estável em torno de 4 vezes. Segunda: ao ultrapassar 272K, o custo de uma única requisição sobe bastante. Em tarefas de processamento em lote, dividir documentos longos abaixo do limite pode reduzir a taxa adicional de contexto longo, mas a economia líquida depende de contexto repetido, requisições extras e perda de qualidade — não dá para assumir de antemão que isso economiza mais do que trocar de modelo.
O custo real também depende do comprimento efetivo da saída e do número de rodadas de retrabalho. Se o Sol precisar, em média, de 3 rodadas para atingir o padrão e o Astra resolver em 1, a diferença na fatura final diminui — e é justamente por isso que a seção 2.4 recomenda registrar o “número de rodadas de retrabalho”.
O código abaixo é apenas um exemplo de integração e não foi testado neste artigo. O script de A/B imprime uma estimativa equivalente ao preço oficial padrão para requisições sem cache e com entrada abaixo de 272K, não a fatura real de um terceiro; os custos de terceiros devem ser calculados conforme as tarifas efetivas de cada um.
O código de exemplo abaixo serve para alternar modelos dentro do mesmo código. Os IDs de modelo seguem a nomenclatura da página oficial de modelos; vale sempre conferir a lista real da plataforma que você usa:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI do APIYI; a disponibilidade dos modelos depende da lista da plataforma
)

response = client.chat.completions.create(
    model="gpt-6.2-sol",  # Troque para "gpt-6.2-astra" quando precisar fazer upgrade
    messages=[{"role": "user", "content": "按以下交付标准改写这段文案:……"}]
)
print(response.choices[0].message.content)
print(response.usage)  # Registra o uso de tokens para calcular o custo total
Ver o script de comparação A/B (rodar dois modelos na mesma tarefa e registrar o uso)
import openai

PRICES = {  # Estimativa equivalente ao preço oficial padrão, não é a fatura real de terceiros; aplica-se apenas a requisições ≤272K e sem cache
    "gpt-6.2-sol":   {"input": 2.0, "output": 10.0},
    "gpt-6.2-astra": {"input": 8.0, "output": 40.0},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Alternar entre modelos pela interface unificada do APIYI
)

def run_once(model: str, prompt: str) -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    if u.prompt_tokens > 272000 or cached:
        raise ValueError("Esta estimativa simplificada só se aplica a requisições com entrada ≤272K e sem cache")
    p = PRICES[model]
    cost = u.prompt_tokens / 1e6 * p["input"] + u.completion_tokens / 1e6 * p["output"]
    return {
        "model": model,
        "output": resp.choices[0].message.content,
        "input_tokens": u.prompt_tokens,
        "output_tokens": u.completion_tokens,
        "official_standard_equivalent_usd": round(cost, 4),
    }

task = "Coloque aqui o comando completo da mesma tarefa e os critérios de entrega"
for m in PRICES:
    r = run_once(m, task)
    print(r["model"], r["input_tokens"], r["output_tokens"], r["official_standard_equivalent_usd"])
🚀 Dica para começar: o ponto-chave do teste A/B é “mesma tarefa, mesmo comando, mesmos critérios de entrega”. Ao usar uma interface compatível com OpenAI como a APIYI apiyi.com, basta alterar o parâmetro
modelpara trocar de modelo, o que facilita controlar as variáveis. Antes de ir para produção, confirme se o modelo desejado já aparece na lista de modelos da plataforma.
2.4 Modelo de registro de testes A/B entre GPT-6.2 Sol e Astra
Abaixo está um modelo em branco — preencha com os seus próprios resultados. A recomendação é escolher de 3 a 5 tarefas representativas por cenário e registrar cada uma separadamente; não tire conclusões com base em um único resultado.
| Dimensão de verificação | Como registrar | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|---|
| Precisão factual | Conferir dado por dado, citações e nomes, anotando o número de erros | ||
| Utilidade | Atingiu ou não o padrão de entrega definido previamente (sim / não / parcial) | ||
| Número de rodadas de retrabalho | Quantas rodadas foram necessárias, da primeira geração até atingir o padrão | ||
| Tokens de entrada / saída | Acumulado de todas as rodadas, observando se passou de 272K | ||
| Custo total | Calculado com base no acumulado de tokens de cada rodada, incluindo as rodadas de retrabalho | ||
| Tempo humano gasto | Quantos minutos foram dedicados a revisar e corrigir | ||
| Conclusão | Qual modelo passa a ser o padrão para essa tarefa daqui em diante |
Ao preencher, vale olhar “custo total” e “tempo humano gasto” em conjunto. Se o tempo humano economizado com o Astra valer mais do que a diferença de custo da API, a mudança faz sentido; caso contrário, é melhor continuar com o Sol e concentrar os esforços em otimizar os comandos e os critérios de entrega.
2.5 Como pequenas equipes podem projetar o roteamento para GPT-6.2 Sol e Astra
Para equipes pequenas, a sugestão editorial é adotar um roteamento do tipo “Sol como padrão, escala para Astra conforme as condições”. Na prática, dá para incluir as condições de acionamento da tabela da seção 2.2 dentro do fluxo de trabalho: por exemplo, se determinado tipo de tarefa precisar ser refeito mais vezes seguidas do que o número de rodadas definido, o sistema troca automaticamente para o Astra para gerar de novo e registra o motivo no log. Depois de acumular um tempo de dados, você terá uma base de escolha construída sobre o seu próprio cenário de negócio — bem mais confiável do que qualquer avaliação genérica.
Esse tipo de roteamento exige uma camada de acesso que permita trocar de modelo com facilidade. A APIYI apiyi.com oferece uma interface compatível com OpenAI, em que uma única chave API já permite invocar diversos modelos mainstream, o que a torna adequada para montar esse tipo de roteamento. Só que, antes de a linha GPT-6.2 aparecer oficialmente na lista de modelos da plataforma, é melhor primeiro rodar o fluxo de ponta a ponta com os modelos que você já tem.
Há ainda um ponto que merece atenção contínua: os dois modelos estão em fase de liberação gradual, e tanto os preços oficiais quanto o escopo de disponibilidade e as informações da página do modelo podem mudar. As considerações a seguir são projeções: conforme mais avaliações de terceiros forem surgindo, a diferença entre Sol e Astra em tarefas específicas vai se mostrar bem mais granular do que os relatórios oficiais sugerem. Nessa hora, a sua própria tabela de registros A/B valerá mais como referência do que qualquer pontuação de benchmark isolada.
Referências
- Página oficial de lançamento da OpenAI: notas de lançamento e avaliações oficiais do GPT-6.2 Astra e Sol
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol/ - Descrição: os dados de GDPval v2, ALE e FrontierCode 2.0 deste artigo vêm todos desta página
- Link:
- Central de Ajuda da OpenAI: explicações de disponibilidade do ChatGPT Work e Codex
- Link:
help.openai.com/en/articles/20001275-chatgpt-work-and-codex - Descrição: escopo de lançamento e informações sobre liberação gradual
- Link:
- Materiais do modelo GPT-6.2 Astra: página oficial do modelo na API
- Link:
developers.openai.com/api/docs/models/gpt-6.2-astra - Descrição: regras de preço, cache e cobrança de contexto longo
- Link:
- Materiais do modelo GPT-6.2 Sol: página oficial do modelo na API
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol - Descrição: regras de preço, cache e cobrança de contexto longo
- Link:
Os modelos continuam evoluindo, então a abordagem mais confiável é primeiro deixar os critérios de entrega bem definidos e depois comparar usando a mesma tarefa. Se você quiser comparar vários modelos em uma mesma base de código, pode se conectar via APIYI apiyi.com e registrar os resultados seguindo o template deste artigo.
Em tudo, o sucesso vem da preparação prévia; a falta dela leva ao fracasso. —— Livro dos Ritos, Zhongyong
Autor: Equipe Técnica da APIYI
Contato técnico: fale conosco pela página inicial da APIYI apiyi.com; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com