結論から言うと、日常的な文章作成、Webプロトタイプ、バッチ処理のほとんどでは、まず GPT-6.2 Sol から始めるのがおすすめです。Sol の成果物が事前に定めた納品基準を満たさない場合、または手戻りコストが価格差を上回った場合にのみ、GPT-6.2 Astra に切り替えてください。 両者の公式 API 定価には4倍の差があります。OpenAI の公式評価では、一部のタスクで両者の差は小さいものの、その結果は特定の評価にのみ当てはまり、一般的な結論としてそのまま外挿することはできません。つまり、選ぶ際のポイントはどちらのモデルがより強力かではなく、あなたのタスクがどの程度高い納品基準を必要とするかです。
以上の推奨は編集部による提案であり、OpenAI 公式のモデル選定ガイドでも、当社の実測結果でもありません。記事中で引用する評価データはすべて OpenAI の公式レポートに基づいています。
この記事を読むと、次のことがわかります。
- GPT-6.2 Sol と Astra のリリース日、提供範囲、入出力能力、公式 API の定価。
- 公式評価のどの数値が判断材料になり、どの数値は外挿できないのか。
- 日常的な文章作成・推敲、Webプロトタイプ、複雑で長期的なプロジェクト、予算に敏感なバッチ処理という4つのシーンについて、それぞれどのモデルから始めるべきか、どのような場合に Astra へアップグレードすべきか、どの工程で必ず人手による確認が必要か。
- 事実の正確性、実用性、手戻りの回数、総コストを比較するために、そのままコピーして使える A/B テスト記録表。
索引: まず「To Know」の概念表と影響サマリーに目を通し、用語と今回のリリースがユーザー層ごとに何を意味するのかをざっと把握してください。第1部では、リリース情報、公式評価、価格ルールといった客観的事実を整理します。第2部では編集部による分析と判断として、シーン別の判断表、コスト見積もり方法、A/B テストの手順を示し、最後に情報源へのリンクを掲載します。
知っておきたいこと:GPT-6.2 Sol と Astra の関連概念
| 概念 | 简要な説明 |
|---|---|
| GPT-6.2 Astra | OpenAIが2026年11月17日にリリースしたGPT-6.2シリーズのうち、より上位に位置づけられ、価格も高いモデル |
| GPT-6.2 Sol | 同日にリリースされたもう1つのモデル。公式APIの定価はAstraの約4分の1 |
| GDPval v2 | OpenAIの公式レポートで用いられている評価の一つ。本記事では公式が示した向上幅のみを引用する |
| ALE(Agents’ Last Exam) | 多段階の専門的ワークフローを評価する。本記事で示す向上幅はGPT-6 Astraをベースラインとし、GDPval v2とは混同しない |
| FrontierCode 2.0 | 公式レポートにおけるプログラミング系の評価。本記事で引用するコスト比較は、このテスト内でのみ成立する |
| max推論レベル | モデルの推論強度設定における最高レベル。通常、より多くの思考と高いコストを意味する |
| パーセントポイント | 2つのパーセント値の差。たとえば50%から56.2%への変化は6.2パーセントポイントの向上 |
| キャッシュ読み取り | 繰り返し使われる入力内容がキャッシュにヒットすると、より低い単価で課金される |
| キャッシュ書き込み | 内容をキャッシュに書き込むときに発生する費用。公式の説明では別途課金が必要 |
| 272Kしきい値 | 1回のリクエストの入力が約27.2万トークンを超えると、リクエスト全体がより高い倍率で課金される |
| 成果物の受入基準 | 編集者が提示した選定の前提条件。あらかじめ「成果物がどの水準に達すれば使えると判断できるか」を明記すること |
GPT-6.2 Sol と Astra の影響をひと目で
- 一般の ChatGPT ユーザー:公式ヘルプドキュメントによると、今回の対象は ChatGPT Work と Codex に段階的に開放されるもので、通常の Chat は今回の提供範囲に含まれていません。そのため、短期的には変化を感じにくいかもしれません。
- 開発者と小規模チーム:両モデルとも API を通じて段階的に開放されます。単価が 4 倍異なるため、モデルルーティングの戦略がそのまま請求額に直結します。事前に設計しておく価値は十分にあります。
- コンテンツクリエイター:両モデルの入力はテキストと画像、出力はテキストであり、ネイティブな動画生成機能は備えていません。動画生成ツールの代替にはなりません。
- コストに敏感なバッチ処理ユーザー:長い入力が 272K を超えた後の倍率ルールは、大量の長文ドキュメント処理のコストに大きく影響します。単価の比較だけよりも、こちらのほうが重要です。
1. GPT-6.2 Sol と Astra の客観的事実
本セクションでは、OpenAI が公式に公開している情報のみを整理します。編集上の判断は含みません。確認日は 2026 年 11 月 18 日です。
1.1 GPT-6.2 Sol と Astra のリリースと提供範囲
OpenAI は2026年11月17日に、GPT-6.2 Astra と GPT-6.2 Sol を同時にリリースしました。公式説明によると、両モデルは ChatGPT Work、Codex、API 向けに段階的に提供され、通常の Chat は今回の提供対象外です。「段階的に提供」とは、アカウントによってアクセス権が付与される時期が異なる可能性があるという意味です。詳細は公式ヘルプドキュメントをご確認ください。
機能面では、両モデルともテキストと画像の入力に対応し、出力はテキストです。公式資料では、ネイティブ動画生成機能について言及されていません。動画生成が目的の場合、今回のリリースでは直接解決できません。
1.2 GPT-6.2 Sol と Astra の公式評価データ
下表は、公式レポートにおける評価結果をまとめたものです。各行は独立した評価であり、比較基準も異なるため、異なる行の数値を横並びで比較しないでください。
| 評価 | 対象 | 公式レポートの結果 | 利用上の制約 |
|---|---|---|---|
| GDPval v2 | GPT-6.2 Astra | GPT-6 Astra 比で6.2ポイント向上、出力トークンは22%削減 | 比較基準は前世代の Astra |
| GDPval v2 | GPT-6.2 Sol | GPT-6.1 Sol 比で5.3ポイント向上 | 比較基準は GPT-6.1 Sol で、Astra の基準とは異なる |
| ALE | GPT-6.2 Astra | GPT-6 Astra 比で5.2点向上 | 単位は「点」で、GDPval の「ポイント」とは混用できません |
| FrontierCode 2.0 | Sol 対 Astra | 両方とも max 推論設定の場合、Sol と Astra の差は0.5点以内、タスクコストは Astra の約1/5 | このテストかつこの推論設定に限り成立し、汎用的なコスト結論ではありません |
以上はすべて OpenAI 公式レポートのデータであり、本チームによる実測結果ではありません。Astra の出力トークンが22%削減されるという点は GDPval v2 の文脈で示されたものであり、あなたの具体的なタスクに一般化できるかどうかはご自身で検証する必要があります。
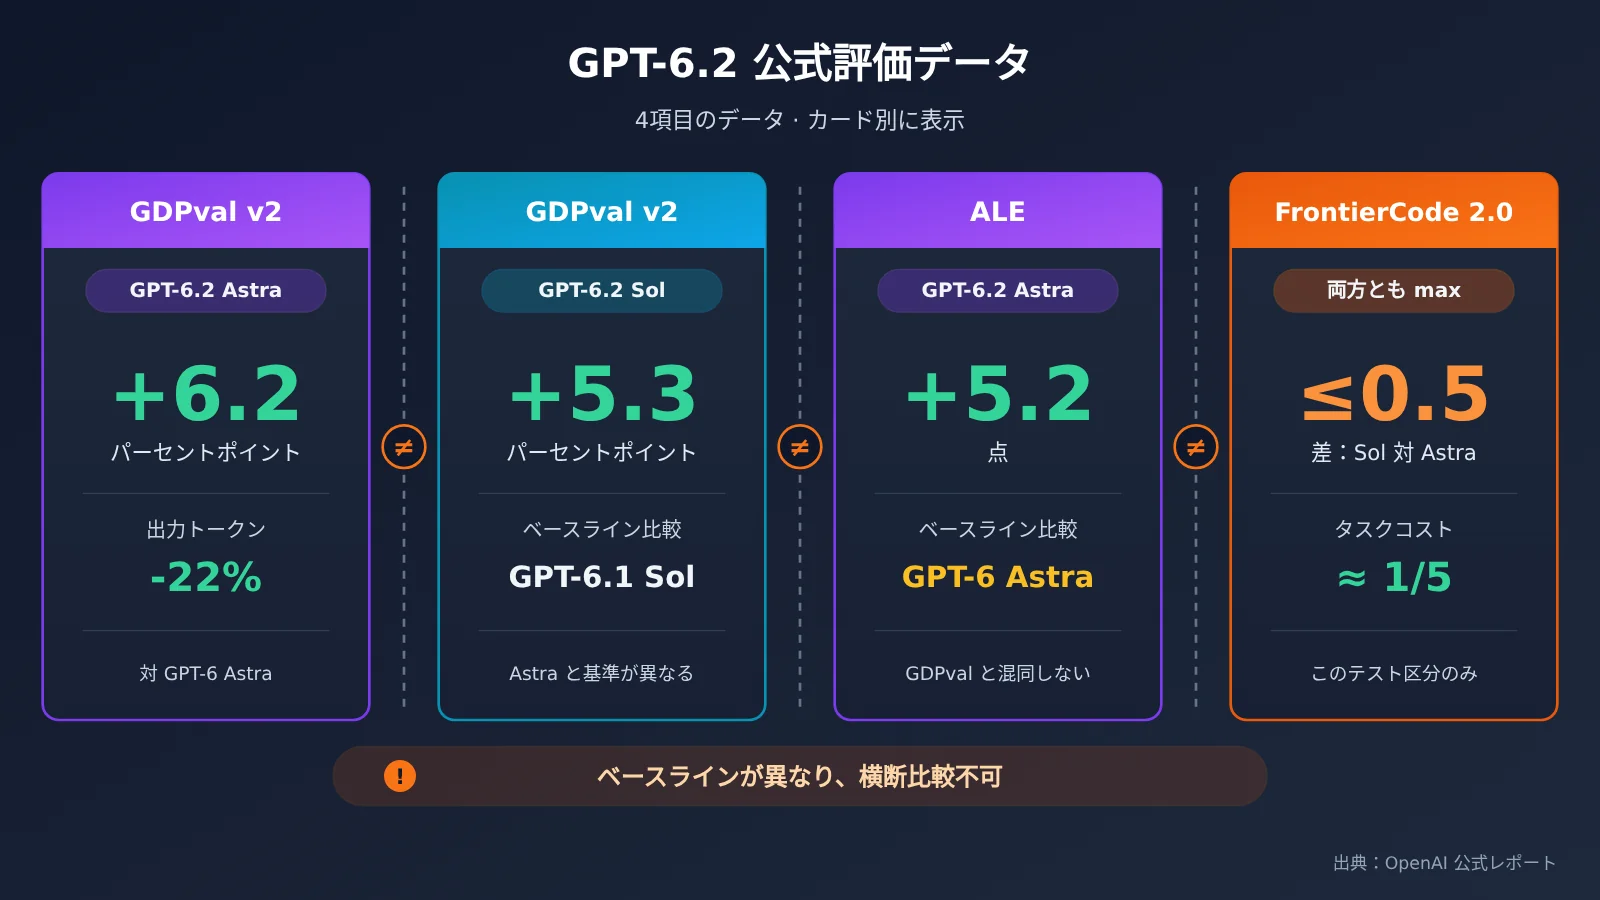
上の図では4つの評価を独立したカードに分け、異なる基準の数値を誤って並べて比較しないようにしています。自社の業務データで比較したい場合は、2.4節のテンプレートに沿って結果を記録し、APIYI apiyi.com のような OpenAI 互換インターフェースを通じて、同じコード内でモデルを切り替えられます。
1.3 GPT-6.2 Sol と Astra の公式 API 価格ルール
以下は公式 API の標準価格です。単位は米ドル / 100万トークンです:
| 課金項目 | GPT-6.2 Astra | GPT-6.2 Sol | 説明 |
|---|---|---|---|
| 非キャッシュ入力 | $8 | $2 | Sol は Astra の 1/4 |
| キャッシュ読み取り | $0.4 | $0.1 | キャッシュヒット後の入力単価 |
| 出力 | $40 | $10 | Sol は Astra の 1/4 |
| キャッシュ書き込み | 別途課金 | 別途課金 | 詳細は公式モデルページを参照 |
| 入力が 272K を超える場合 | リクエスト全体の入力・キャッシュ料率 ×2、出力 ×1.5 | 同左 | リクエスト全体で計算され、超過分だけが対象ではない |
最後の行には特に注意が必要です。272K のしきい値を超えると、倍率はリクエスト全体に適用され、しきい値を超えた部分のトークンだけが対象ではありません。大量の長文ドキュメントを詰め込む必要があるタスクでは、このルールを個別に予算へ計上すべきであり、基本単価だけで判断してはいけません。
💡 価格について:上表は OpenAI 公式 API の標準価格です。サードパーティプラットフォームの価格や可用性は別途確認が必要です。本記事では、これら2つのモデルが APIYI apiyi.com で提供されているかどうかを確認していません。プラットフォームのモデル一覧を基準にしてください。
2. GPT-6.2 Sol と Astra の選び方:編集部による分析と判断
以下は、第 1 部で示した事実に基づいて編集部が行った推測と提案です。OpenAI の公式見解を表すものではなく、当方での実測検証も経ていません。
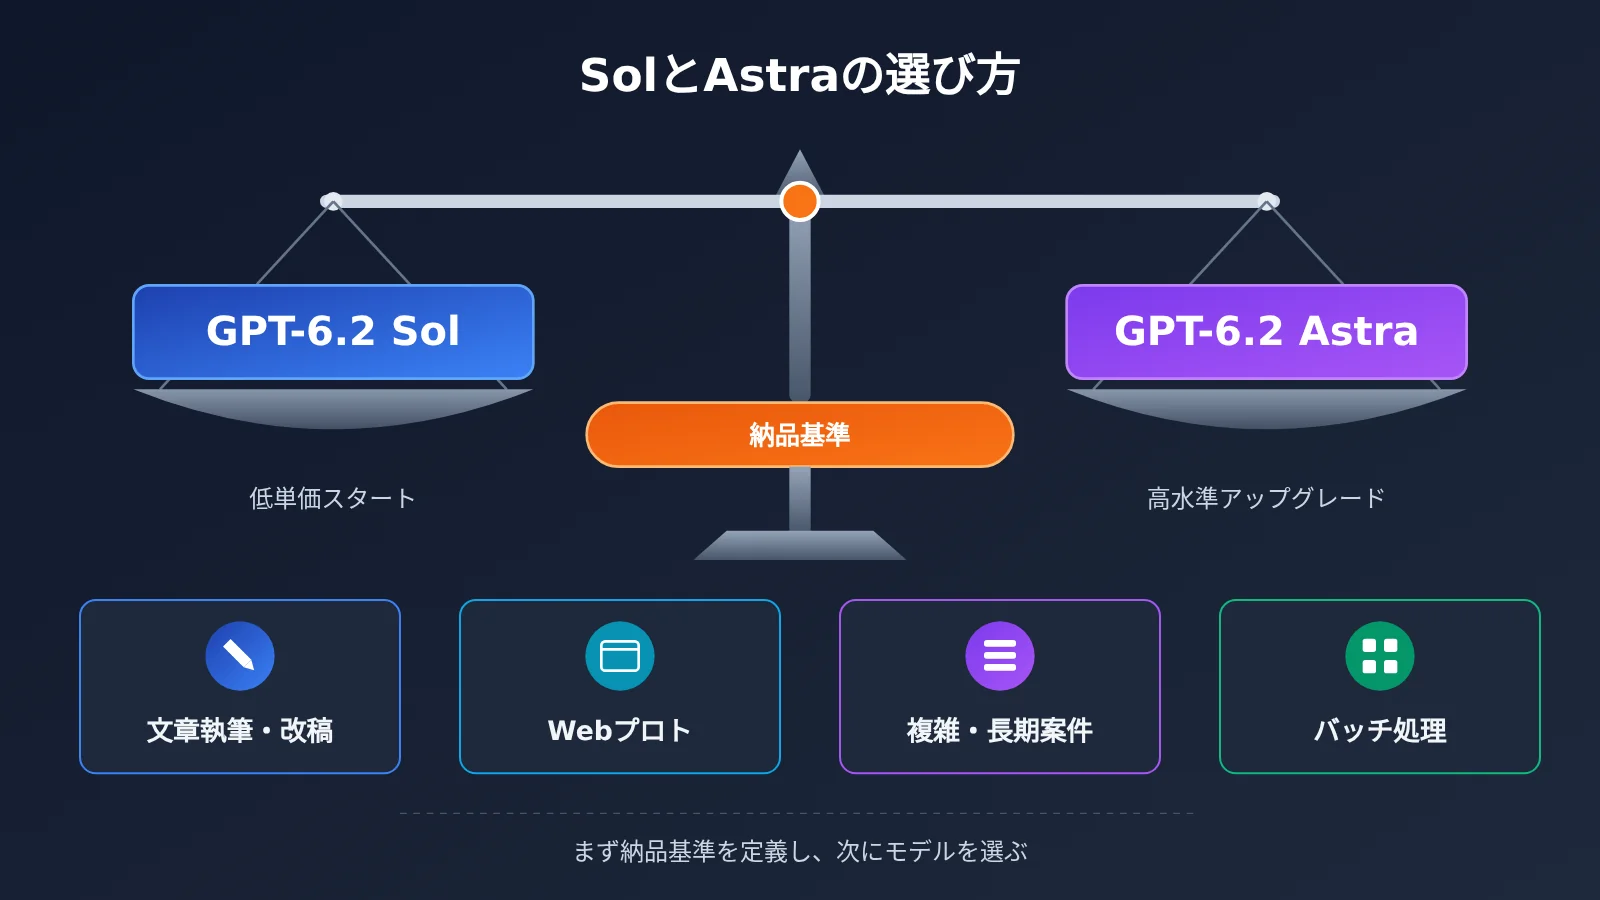
2.1 まず成果物の合格基準を決めてから、GPT-6.2 Sol か Astra を選ぶ
モデルを選ぶとき、多くの人はまず「どちらがより高性能か」と尋ねます。しかし FrontierCode 2.0 の公式データは、別の視点を示唆しています。このテストでは、両者とも max 推論設定の場合、Sol と Astra の差は 0.5 点以内にとどまり、タスクコストは約 5 分の 1 に収まります。この結論を他のタスクに外挿できないとしても、「より高性能」であることの利得は小さく、コスト差は大きい可能性があることを十分に示しています。
そこで編集部は、モデルを選ぶ前に次の三つの問いに答えることをおすすめします。この成果物は誰が使うのか。誤りのコストはどれほど大きいのか。何回までのやり直しなら許容できるのか。答えが明確になるほど、Sol で十分かどうかを判断しやすくなります。合格基準をうまく書き下せないのであれば、Astra に変えても、より高コストな方法で試行錯誤を繰り返すだけです。
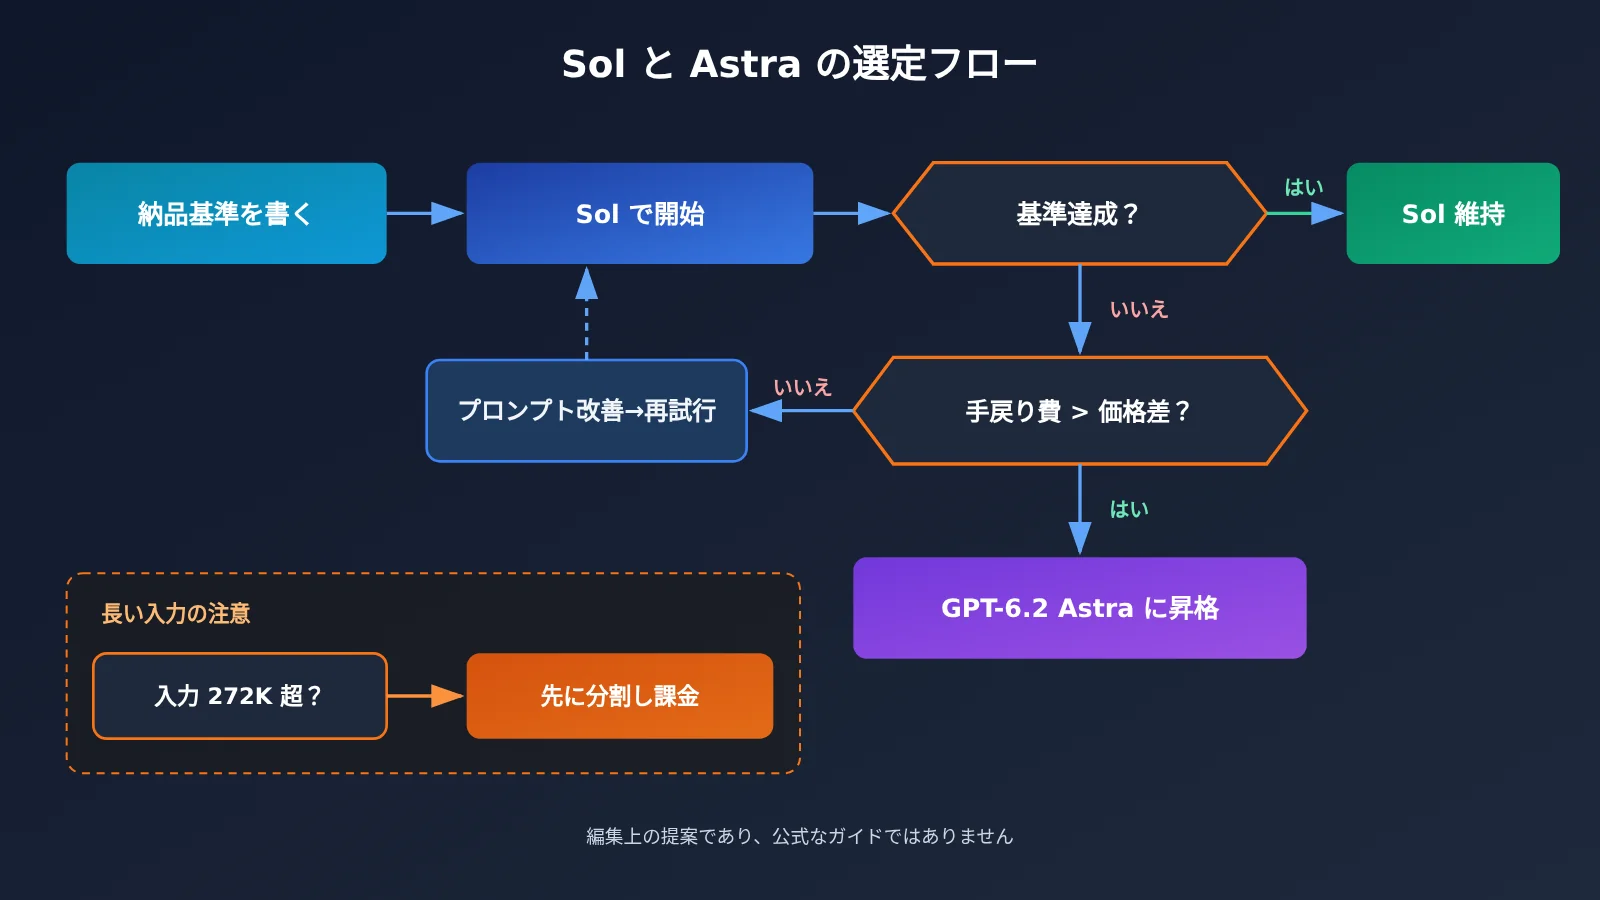
2.2 GPT-6.2 Sol と Astra の4つのシーン別判断表
以下の表は編集部の提案であり、公式ガイドラインではありません。「アップグレードのトリガー条件」は、こうした状況が出たときにAstraを試す価値があるという目安です。「人間によるチェックポイント」は、どちらのモデルを使っても省略できない工程です。
| シーン | まず使うモデル | Astraへアップグレードするトリガー条件 | 必ず人間が確認するポイント |
|---|---|---|---|
| 日常的な文章の推敲・修正 | GPT-6.2 Sol | 2〜3回繰り返してもトーンや構成の要件を満たさない;論証が緻密な長文を扱う場合 | 事実、データ、引用、人名;意図せず原文の意味を変えていないか |
| ウェブプロトタイプ | GPT-6.2 Sol | インタラクションロジックが複数ページにまたがり、Solが生成したコードで状態管理のエラーが繰り返し発生する;デザイン稿の画像をもとに忠実に再現する必要がある場合 | ブラウザでの実動作;フォームバリデーション、モバイル対応;依存パッケージが実在するか |
| 複雑で長期のプロジェクト | 納品基準次第だが、最初からAstraを試すことも可能 | タスクチェーンが長く、コンテキスト依存が多いため、1か所の誤りが下流で大規模な手戻りを引き起こす場合 | 重要な意思決定ポイント、ファイル間の一貫性、テストカバレッジ |
| 予算を重視するバッチ処理 | GPT-6.2 Sol | サンプリングでのエラー率が自分で設定した閾値を超え、かつ後処理での修正コストのほうが高い場合 | 比例サンプリングによる点検;単一入力が272Kを超えていないか;キャッシュヒット率 |
日常的な文章の推敲・修正のシーンでは、難しさは通常、推論の深さではなく事実の正確さとスタイルへの適合にあります。Solから始めるほうがコスト効率が良く、どちらのモデルを使う場合でもデータと引用は必ず人間が確認してください。
ウェブプロトタイプのシーンでは、「動作する」ことが必須基準となり、客観的に判断できます。Solで足りるかどうかを判断するには実際に動かし、主要なインタラクション、エラー状態、モバイル対応を確認する必要があり、1回の実行が成功しただけでアップグレードを決めるわけにはいきません。
複雑で長期のプロジェクトは、最初からAstraを検討する最も大きな理由があるシーンです。公式レポートにあるGDPval v2の出力トークン22%削減は、旧型GPT-6 Astraを比較基準とするものであり、これを根拠にGPT-6.2 Solに対する削減量を見積もることはできません。2つの新モデルのタスク総コストは、同じ納品基準のもとで自分で検証する必要があります。予算を重視するバッチ処理では、単一入力の長さを優先的に抑え、272Kの倍率が適用されるのを避けるべきです。
2.3 GPT-6.2 Sol と Astra のコスト見積もり方法
以下では公式の標準価格に基づいて概算計算を行い、課金ルールが与える影響を説明します。実際のタスクでの消費量を示すものではありません。1回のリクエストで入力 50K token(キャッシュを除く)、出力 5K token と仮定します。
- Sol:0.05 × $2 + 0.005 × $10 = $0.15
- Astra:0.05 × $8 + 0.005 × $40 = $0.60
入力が 300K token、出力が 10K token に増えると、272K の倍率が適用されます。
- Sol:0.3 × $4 + 0.01 × $15 = $1.35
- Astra:0.3 × $16 + 0.01 × $60 = $5.40
この概算から2つのポイントが見えます。1つ目は、同じ token 使用量であれば両者の価格差は約4倍で安定していることです。2つ目は、272K を超えると1回のリクエストあたりのコストが大幅に上昇することです。バッチ処理のタスクでは、長いドキュメントをしきい値以下に分割することで長コンテキストの追加料金を削減できる可能性があります。ただし、純粋な節約効果はコンテキストの重複、追加リクエスト、品質の低下に左右されます。「モデルを変えるほうが安い」と決め打ちはできません。
実際のコストは、出力の長さや手戻りの回数によっても変わります。Sol が目標達成まで平均3回必要で、Astra なら1回で完了する場合、最終的な請求額の差は縮まります。だからこそセクション 2.4 では「手戻り回数」の記録を推奨しています。
以下のコードは接続例であり、本記事では実測していません。A/B スクリプトが出力するのは、キャッシュなし・入力が 272K 以下における公式標準価格の等価概算であり、第三者による実際の請求額ではありません。第三者の費用はその実際の料金率で計算してください。
次のサンプルコードは、同じコード内でモデルを切り替えるためのものです。モデル ID は公式モデルページの命名を参考にしています。実際に利用するプラットフォームのモデル一覧を必ず確認してください。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース。モデルの可用性はプラットフォームの一覧をご確認ください
)

response = client.chat.completions.create(
    model="gpt-6.2-sol",  # アップグレードが必要な場合は "gpt-6.2-astra" に変更
    messages=[{"role": "user", "content": "按以下交付标准改写这段文案:……"}]
)
print(response.choices[0].message.content)
print(response.usage)  # token 使用量を記録し、総コストの計算に使用
A/B 比較スクリプトを表示(同じタスクで2つのモデルを実行し、使用量を記録)
import openai

PRICES = {  # 公式標準価格の等価推定値であり、第三者の実際の請求額ではありません。≤272K かつキャッシュなしのリクエストにのみ適用されます
    "gpt-6.2-sol":   {"input": 2.0, "output": 10.0},
    "gpt-6.2-astra": {"input": 8.0, "output": 40.0},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース経由でモデルを切り替え
)

def run_once(model: str, prompt: str) -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    if u.prompt_tokens > 272000 or cached:
        raise ValueError("此简化估算仅适用于输入≤272K且无缓存的请求")
    p = PRICES[model]
    cost = u.prompt_tokens / 1e6 * p["input"] + u.completion_tokens / 1e6 * p["output"]
    return {
        "model": model,
        "output": resp.choices[0].message.content,
        "input_tokens": u.prompt_tokens,
        "output_tokens": u.completion_tokens,
        "official_standard_equivalent_usd": round(cost, 4),
    }

task = "在这里放同一个任务的完整提示词和交付标准"
for m in PRICES:
    r = run_once(m, task)
    print(r["model"], r["input_tokens"], r["output_tokens"], r["official_standard_equivalent_usd"])
🚀 導入のヒント:A/B テストで押さえるべきポイントは「同じタスク、同じプロンプト、同じ納品基準」です。APIYI apiyi.com のような OpenAI 互換インターフェースを使えば、
modelパラメータを書き換えるだけでモデルを切り替えられるため、変数の管理がぐっと楽になります。リリース前に、対象のモデルがプラットフォームのモデル一覧に載っているかどうかを必ず確認してください。
2.4 GPT-6.2 Sol と Astra の A/B テスト記録テンプレート
以下は空のテンプレートです。ご自身のテスト結果を記入してください。各シナリオにつき、代表性のあるタスクを少なくとも3~5件選び、それぞれ個別に記録することをおすすめします。1回の結果だけで結論を出さないようにしましょう。
| 確認項目 | 記録方法 | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|---|
| 事実の正確性 | データ、引用、名称を1件ずつ照合し、誤りの数を記録 | ||
| 実用性 | 事前に定めた納品基準を満たしているか(はい / いいえ / 一部) | ||
| 手戻り回数 | 初回生成から基準達成までに何ラウンドかかったか | ||
| 入力 / 出力トークン | 各ラウンドの累計。272Kを超えていないか注意 | ||
| 総コスト | 各ラウンドのトークン累計で計算し、手戻りラウンドも含める | ||
| 人間の作業時間 | 確認と修正に費やした分数 | ||
| 結論 | このタスクで今後デフォルトで使うモデル |
記入する際は、「総コスト」と「人間の作業時間」を併せて見ることをおすすめします。Astraが節約した人手時間の価値が、追加で支払うAPI費用を上回るなら、アップグレードは妥当です。逆に、Solを使い続け、プロンプトと納品基準の最適化に力を注ぐべきです。
2.5 小規模チームが GPT-6.2 Sol と Astra のルーティングを設計する方法
小規模チームの場合、編集部は「デフォルトは Sol、条件に応じて Astra にアップグレードする」というルーティング方式を推奨しています。具体的には、2.2節の表にあるトリガー条件をワークフローに組み込みます。たとえば、ある種のタスクで手戻りが設定した回数を超えたら、自動的に Astra に切り替えて再生成し、ログにその理由を記録します。しばらく運用してデータを蓄積すると、自社の業務データに基づくモデル選定の根拠が得られます。これはどんな一般的なベンチマークよりも信頼できるでしょう。
このルーティングには、モデルを簡単に切り替えられる接続層が必要です。APIYI(apiyi.com)は OpenAI 互換インターフェースを提供しており、1つの APIキーで複数の主要モデルを呼び出せるため、こうしたルーティングの構築に適しています。ただし、GPT-6.2 シリーズがプラットフォームのモデル一覧に正式に登場するまでは、まず既存モデルでフローを一通り動作させてください。
もう1つ継続して注目すべき点があります。2つのモデルは段階的に開放されている段階にあり、公式価格、提供範囲、モデルページの情報が更新される可能性があります。以下の判断は予測です。より多くの第三者評価が登場するにつれて、Sol と Astra の具体的なタスクにおける差は、公式レポートが示すよりも細分化されて見えるようになるでしょう。その時点では、自社の A/B 記録表のほうが、どの単一のベンチマークスコアよりも参考価値が高くなります。
参考資料
- OpenAI 公式発表ページ:GPT-6.2 Astra と Sol のリリースノートおよび公式評価
- リンク:
openai.com/index/introducing-gpt-6-2-astra-sol/ - 内容:本記事の GDPval v2、ALE、FrontierCode 2.0 のデータはすべてこのページに由来します
- リンク:
- OpenAI ヘルプセンター:ChatGPT Work と Codex の公開に関する説明
- リンク:
help.openai.com/en/articles/20001275-chatgpt-work-and-codex - 内容:提供範囲と段階的な公開に関する情報
- リンク:
- GPT-6.2 Astra モデル資料:公式 API モデルページ
- リンク:
developers.openai.com/api/docs/models/gpt-6.2-astra - 内容:価格、キャッシュ、長いコンテキストの課金ルール
- リンク:
- GPT-6.2 Sol モデル資料:公式 API モデルページ
- リンク:
developers.openai.com/api/docs/models/gpt-6.2-sol - 内容:価格、キャッシュ、長いコンテキストの課金ルール
- リンク:
モデルは継続的に進化していきます。より確実な方法は、まず納品基準を明確に書き、同じタスクで比較することです。1つのコードベース内で複数のモデルを比較したい場合は、APIYI apiyi.com を通じて接続したうえで、本記事のテンプレートに沿って結果を記録してください。
凡事預則立、不預則廃(何事も事前に準備すれば成り立ち、準備しなければ倒れる)。——『礼記・中庸』
著者:APIYI 技術チーム
技術交流:APIYI apiyi.com のトップページからお問い合わせください。接続に関する詳細資料は docs.apiyi.com ドキュメントセンターをご覧ください