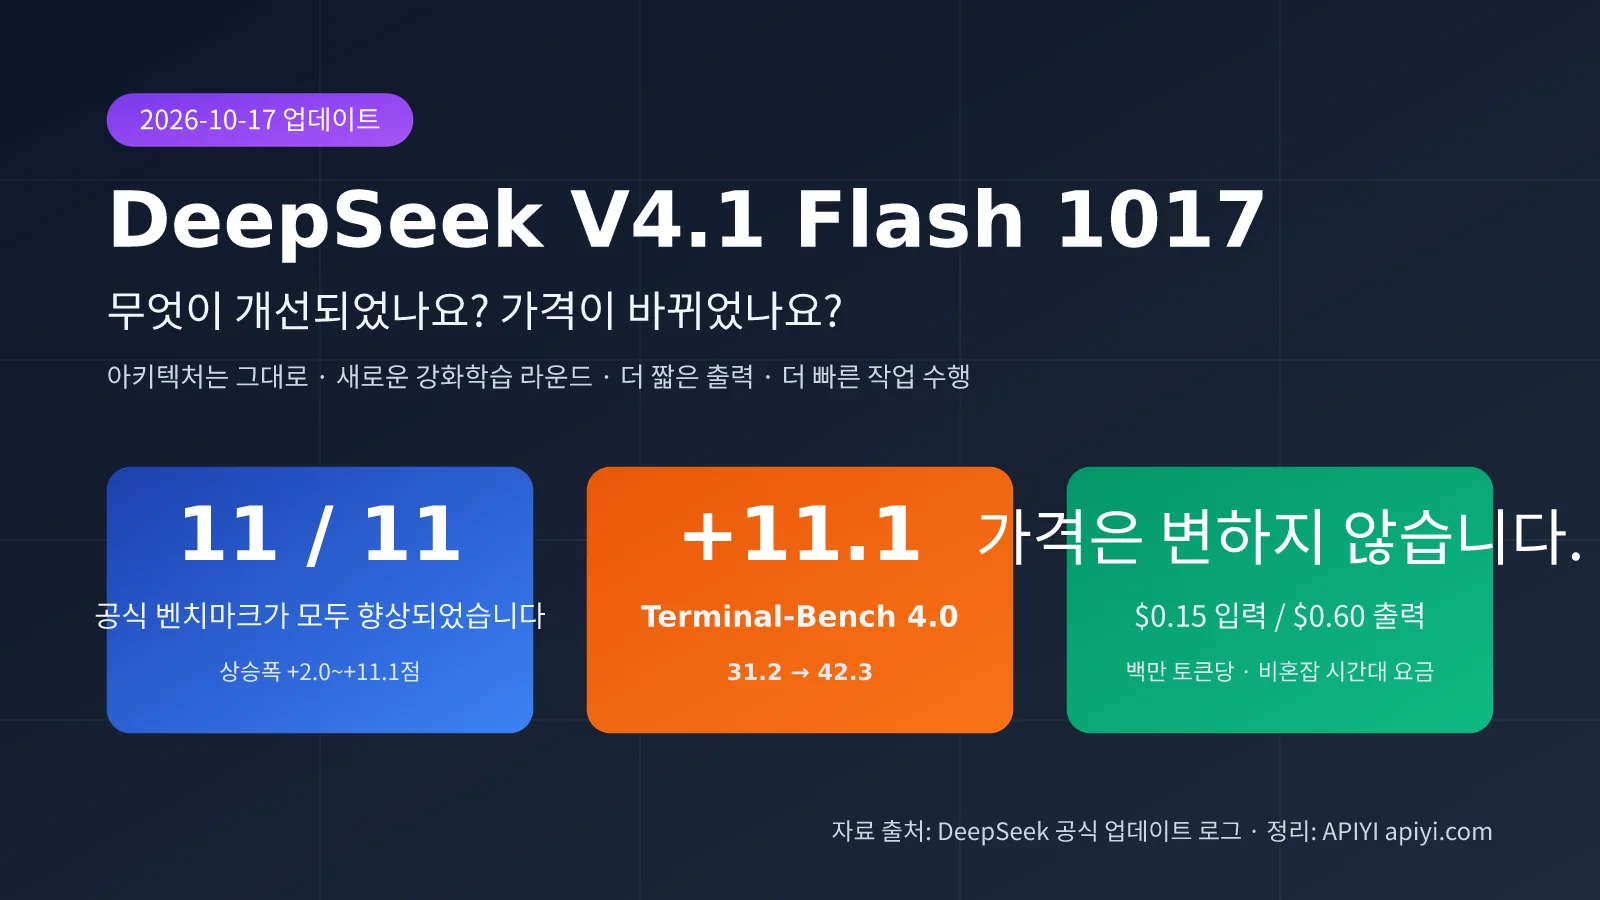
2026년 10월 17일, DeepSeek은 V4.1 Flash를 DeepSeek-V4.1-Flash-1017로 조용히 업그레이드했어요. 공식적으로는 소규모 업데이트라고 소개했지만, 공개된 데이터를 보면 공식 발표에 포함된 11개 벤치마크가 모두 상승했고, Terminal-Bench 4.0은 한 번에 11.1점이나 올랐어요. 이 정도면 단순한 ‘소폭 수정’이라고 보기 어렵죠.
개발자들이 가장 궁금해하는 건 사실 두 가지예요. DeepSeek V4.1 Flash 1017은 정확히 무엇이 개선됐을까요? 가격은 달라졌을까요? 이 글에서는 DeepSeek 공식 업데이트 로그와 가격 페이지, Hugging Face 모델 카드의 데이터만으로 답해 볼게요. 제3자 의견은 별도로 표시할게요.
핵심 내용: 이 글을 읽으면 1017 버전의 실제 성능 향상 폭과 ‘가격은 그대로’인데도 실질적으로 더 저렴해지는 이유, 그리고 한산한 시간대를 활용해 DeepSeek API 비용을 절반 더 줄이는 방법을 알 수 있어요.
DeepSeek V4.1 Flash 1017이란? 아키텍처는 그대로인 소규모 업데이트
DeepSeek V4.1 Flash는 2026년 9월 10일 공개된 새로운 아키텍처 제품군 중 가장 작은 모델로, 이미지 이해를 기본 지원해요. 1017은 출시 약 한 달 뒤에 나온 첫 번째 업데이트 버전이에요. 공식 업데이트 로그는 모델을 DeepSeek-V4.1-Flash-1017로 업그레이드했고 웹 버전과 앱도 함께 업데이트했으며, API 호출 방식과 가격은 그대로라고 간단히 설명해요.
Hugging Face에 공개된 기술 정보를 보면 1017은 기존 아키텍처를 그대로 이어받았어요. 주 모델 파라미터는 552B이고, 프리필 단계에서는 토큰당 약 8B, 디코딩 단계에서는 약 16B가 활성화돼요. 여기에 196B 규모의 Engram 조건부 메모리가 추가돼요. 영어권 커뮤니티에서는 이번 변경이 새로운 강화학습 후학습에서 비롯됐다는 분석이 대체로 많아요. 구성 파일과 토크나이저, 프롬프트 인코딩은 바뀌지 않았기 때문에 기존 코드를 수정할 필요는 없어요.
| 항목 | DeepSeek V4.1 Flash 1017 | 설명 |
|---|---|---|
| 출시일 | 2026-10-17 | 9월 10일 첫 출시 버전의 첫 번째 업데이트 |
| API 모델명 | deepseek-flash |
별칭이 최신 버전을 자동으로 가리킴 |
| 이전 모델명 | deepseek-v4-flash 등 |
계속 호출할 수 있으며 1017로 라우팅되고 Flash 요금이 적용됨 |
| 아키텍처 | MoE, 주 모델 파라미터 552B, 활성 파라미터 8B/16B | 첫 출시 버전과 동일 |
| 컨텍스트 / 최대 출력 | 1M / 384K | 공식 가격 페이지 기준 |
| 사고 모드 | 사고 모드(기본값) 및 비사고 모드 | 두 모드 모두 사용 가능 |
| 멀티모달 | 이미지 입력 지원 | Pro 버전은 아직 비전 기능 미지원 |
| 오픈소스 라이선스 | MIT | 가중치는 Hugging Face와 ModelScope에 공개 |
| 동시 실행 한도 | 2,500 | Pro 버전은 500 |
공식 발표에서 눈여겨볼 점도 있어요. 1017은 DeepSeek Harness, 텐센트 CodeBuddy, WorkBuddy에 맞춰 최적화됐으며, DeepSeek Harness 0.2.1-rc.1 이상 버전 사용을 권장해요. 이번 학습이 에이전트 코딩 작업에 초점을 맞췄다는 뜻이에요. 따라서 자체 에이전트 루프를 사용한다면 실제 성능 향상 폭이 공식 수치보다 작을 수도 있어요.
🎯 기술 팁: 모델 별칭은 최신 버전을 자동으로 가리켜요. 운영 트래픽을 전환하기 전에 자체 업무 샘플로 회귀 테스트를 진행하는 것이 좋아요. APIYI apiyi.com에서는 하나의 API 키로 DeepSeek을 비롯한 주요 모델을 함께 호출할 수 있어, 같은 평가 스크립트로 성능을 비교하기 편리해요.
DeepSeek V4.1 Flash 1017은 무엇이 개선됐을까: 11개 벤치마크 항목별 비교
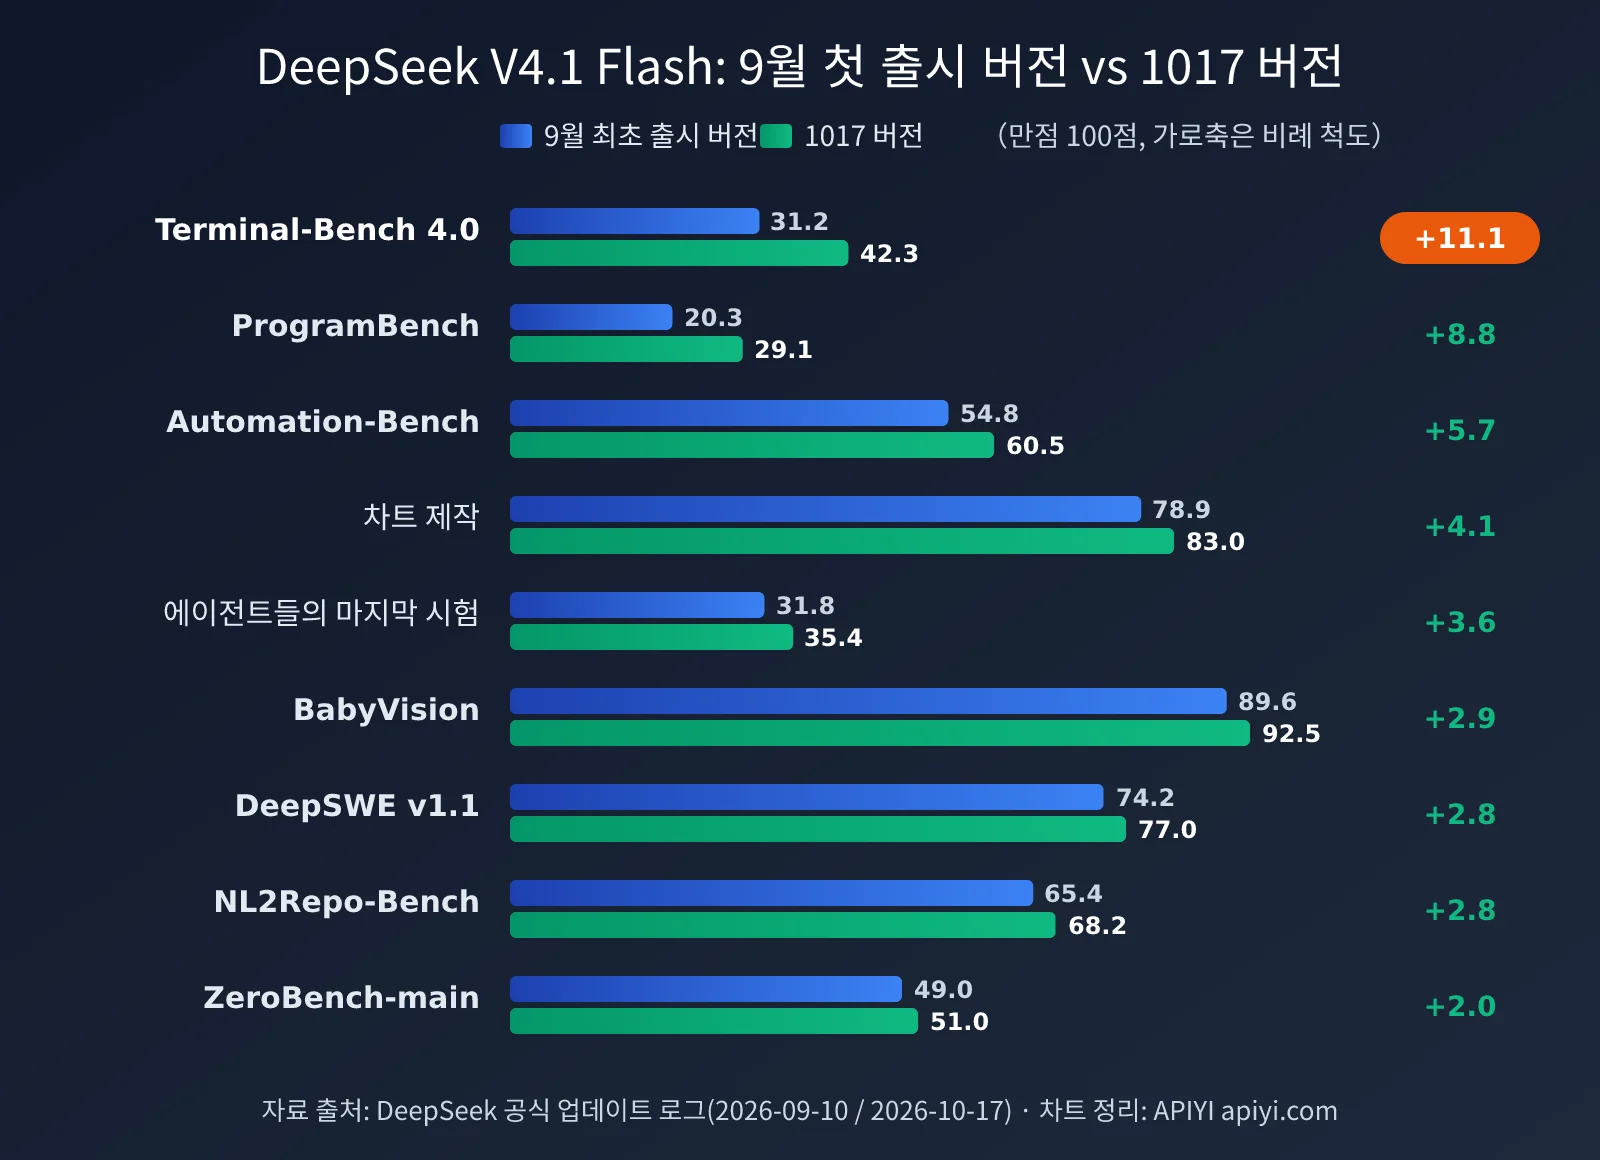
‘무엇이 개선됐는지’를 가장 직접적으로 확인하려면 공식 9월 출시 버전과 10월 1017 버전의 점수를 비교하면 돼요. 아래 표의 데이터는 모두 DeepSeek 공식 업데이트 로그에서 가져왔어요. Apex Bench의 이전 점수는 공식 로그에 공개되지 않아 영문 커뮤니티에서 정리한 값을 인용했으며, 참고용으로만 봐주세요.
| 벤치마크 | 평가 영역 | 9월 출시 버전 | 1017 버전 | 향상 폭 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 터미널 에이전트 작업 | 31.2 | 42.3 | +11.1 |
| ProgramBench | 프로그램 생성 | 20.3 | 29.1 | +8.8 |
| Apex Bench v1.1 | 종합 추론(이전 점수는 제3자 자료) | 64.6 | 72.1 | +7.5 |
| HLE(도구 미사용) | 고난도 지식 추론 | 36.8 | 42.6 | +5.8 |
| Automation-Bench | 자동화 워크플로 | 54.8 | 60.5 | +5.7 |
| Chartography(도구 사용) | 차트 이해 | 78.9 | 83.0 | +4.1 |
| Agents’ Last Exam | 범용 에이전트 | 31.8 | 35.4 | +3.6 |
| BabyVision(도구 사용) | 시각 이해 | 89.6 | 92.5 | +2.9 |
| DeepSWE v1.1 | 소프트웨어 엔지니어링 | 74.2 | 77.0 | +2.8 |
| NL2Repo-Bench | 자연어 기반 저장소 생성 | 65.4 | 68.2 | +2.8 |
| ZeroBench-main(도구 사용) | 시각 추론 | 49.0 | 51.0 | +2.0 |
이 표에서는 세 가지 흐름을 읽을 수 있어요. 첫째, 가장 큰 폭으로 향상된 항목은 모두 에이전트와 프로그래밍 관련 작업이에요. Terminal-Bench 4.0과 ProgramBench의 상대적 상승률은 모두 35%를 넘어섰는데, 이는 ‘Harness와 CodeBuddy에 맞춰 최적화했다’는 공식 설명과 일치해요. 둘째, 시각 관련 벤치마크도 2~4점씩 꾸준히 향상됐어요. 이번 후학습 과정에서 멀티모달 역량을 희생하지 않았다는 뜻이죠. 셋째, 일부 벤치마크는 버전별 테스트 조건이 완전히 같지 않아요. 예를 들어 Automation-Bench의 새 버전에는 v1.0.6이라고 표시돼 있고, HLE의 출시 버전은 도구 사용 여부를 명시하지 않았어요. 따라서 개별 점수 하나만 보고 해석하지 않는 게 좋아요.
DeepSeek V4.1 Flash 1017의 효율 개선: 출력은 짧아지고 작업은 빨라졌어요
점수 외에도 공식 발표에서 강조한 변화가 하나 있어요. 쉽게 지나칠 수 있지만, 1017 버전은 작업을 더 짧은 시간 안에 완료하고 출력 길이도 줄였어요. 토큰 단위로 요금을 부과하는 API에서는 점수만큼 중요한 부분이에요. 같은 작업에서 출력 토큰을 조금만 줄여도 비용이 바로 낮아지니까요.
다만 DeepSeek은 구체적으로 몇 퍼센트 줄었는지 공개하지 않았고, 영문 커뮤니티에서도 신뢰할 만한 버전 간 비교 측정 자료는 아직 없어요. 가장 확실한 방법은 자체 업무 샘플에서 usage.completion_tokens의 변화를 집계해 실제 비용이 얼마나 줄었는지 확인하는 거예요.
영문 커뮤니티에서는 이번 학습 방식을 ‘소망 주도 프로그래밍(Wish-Driven Programming)’이라고 요약했어요. 모델이 먼저 프로젝트를 처음부터 끝까지 완성한 뒤, 목표에 비춰 스스로 점수를 매기고 반복해서 개선하는 방식이에요. 공식적으로 소개된 사례로는 3D 자금성 복원, 브라우저 레이싱 게임, Godot으로 Portal 2 재현하기 등이 있어요. 이런 장기 프로젝트는 Terminal-Bench와 ProgramBench 같은 벤치마크와 직접 맞닿아 있어요. 에이전트 관련 점수가 가장 크게 오른 이유도 여기서 찾을 수 있죠.
DeepSeek V4.1 Flash 1017 가격이 달라졌을까요? 비혼잡·혼잡 시간대 요금 안내
먼저 결론부터 말씀드리면 DeepSeek V4.1 Flash 1017의 API 가격은 변하지 않았어요. 9월 출시 버전과 완전히 같습니다. 다만 ‘변하지 않았다’는 말은 두 가지 배경을 함께 살펴봐야 해요. 9월 출시 당시 이미 한 차례 가격을 인하했고, 현재 DeepSeek은 비혼잡 시간대와 혼잡 시간대에 서로 다른 요금을 적용하고 있어요. 시간대별 실제 단가는 두 배 차이가 납니다.
| 과금 항목(토큰 100만 개당) | Flash 비혼잡 시간대 | Flash 혼잡 시간대 | V4 Pro 비혼잡 시간대 | V4 Pro 혼잡 시간대 |
|---|---|---|---|---|
| 입력(캐시 적중) | $0.003 | $0.006 | $0.022 | $0.044 |
| 입력(캐시 미적중) | $0.15 | $0.30 | $0.66 | $1.32 |
| 출력 | $0.60 | $1.20 | $1.98 | $3.96 |
공식적으로 혼잡 시간대는 월요일부터 금요일까지 UTC 01:00~04:00, 06:00~10:00예요. 베이징 시간으로 환산하면 평일 09:00~12:00, 14:00~18:00입니다. 중국 법정 공휴일은 혼잡 시간대에서 제외돼요. 이외의 시간대, 즉 야간과 점심시간, 주말과 공휴일은 하루 종일 비혼잡 요금이 적용됩니다. 비혼잡 요금은 혼잡 요금의 절반이에요.
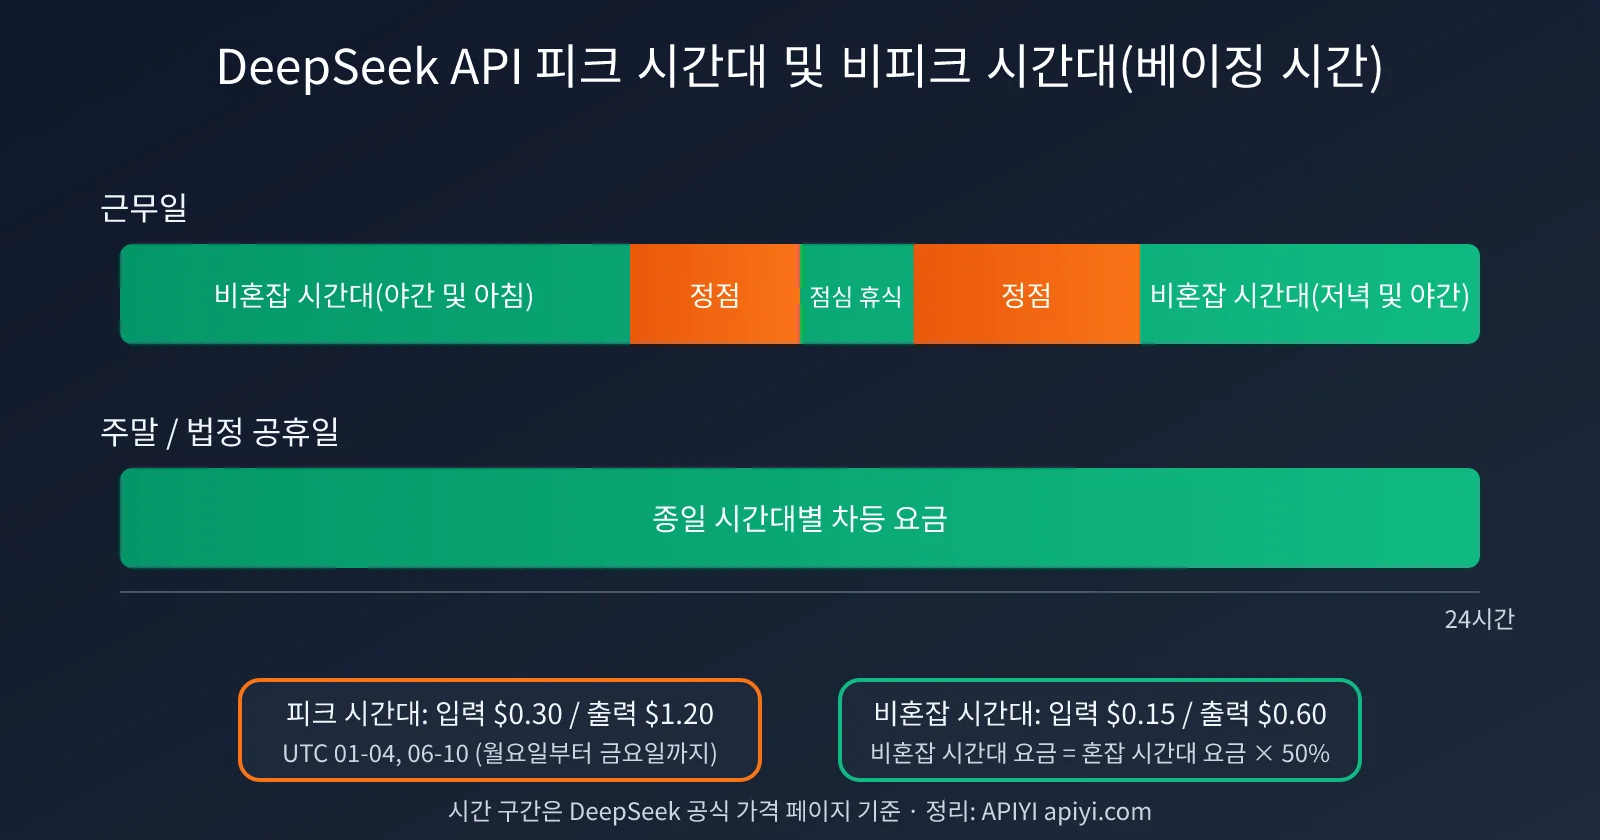
이 시간대 설정은 중국 내 팀에 직접적인 영향을 줘요. 혼잡 시간대가 사실상 중국의 근무 시간과 거의 겹치기 때문이죠. 대량 번역, 오프라인 데이터 라벨링, 코드 저장소 스캔처럼 실시간 응답이 필요 없는 작업이라면 오후 6시 이후나 주말에 실행해 보세요. 단가가 바로 절반으로 줄어들어, 프롬프트를 최적화하는 것보다 직접적인 비용 절감 효과를 얻을 수 있어요.
DeepSeek V4.1 Flash 가격 변동 타임라인
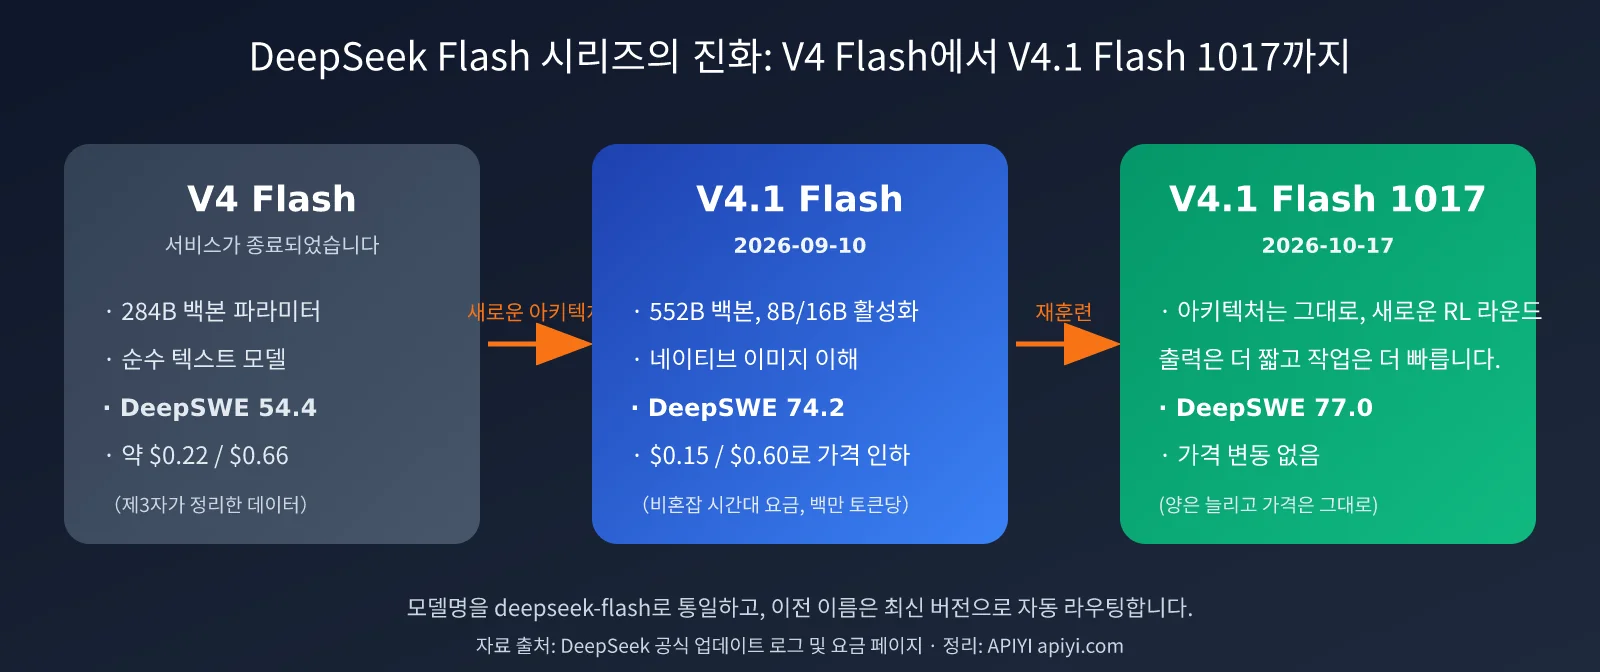
전체 흐름을 살펴보면 Flash 시리즈는 두 달 동안 ‘가격 인하 후, 가격은 그대로 두고 성능을 높이는’ 과정을 거쳤어요. V4 Flash 시절 가격은 영어권 커뮤니티에서 정리한 자료로 참고용이며, 9월과 10월 버전의 데이터는 공식 자료입니다.
| 버전 | 출시일 | 입력(캐시 미적중) | 입력(캐시 적중) | 출력 | 변경 사항 |
|---|---|---|---|---|---|
| V4 Flash | 2026년 9월 이전 | 약 $0.22 | 약 $0.007 | 약 $0.66 | 서비스 종료 |
| V4.1 Flash | 2026-09-10 | $0.15 | $0.003 | $0.60 | 공식 가격 인하 |
| V4.1 Flash 1017 | 2026-10-17 | $0.15 | $0.003 | $0.60 | 가격은 그대로, 성능 향상 |
표의 V4.1 시리즈 가격은 비혼잡 시간대 기준이며, 혼잡 시간대에는 두 배로 올라갑니다.
‘가격 유지’가 사실상 가격 인하인 이유
단가는 그대로지만 작업 하나의 총비용은 ‘단가 × 토큰 수’로 결정돼요. 1017 버전은 공식적으로 출력이 더 짧아졌다고 밝혔어요. 즉, 같은 작업을 수행할 때 출력 토큰을 덜 사용한다는 뜻이죠. 출력 단가는 입력의 4배이므로, 입력보다 출력을 줄였을 때 절약되는 비용이 더 큽니다.
간단한 예를 들어 볼게요. 한 에이전트 작업이 비혼잡 시간대에 캐시 미적중 입력 토큰 100만 개와 출력 토큰 20만 개를 사용한다면 비용은 약 $0.15 + $0.12 = $0.27입니다. 출력량이 20% 줄어든다고 가정하면(예시일 뿐이며, 실제 값은 직접 측정해야 합니다) 출력 비용은 $0.12에서 약 $0.096으로 내려가요. 여기에 긴 컨텍스트를 재사용해 캐시 적중 요금인 $0.003을 적용하면 실제 비용은 더 낮아질 수 있습니다.
💰 비용 최적화: 대량 호출이나 예산에 민감한 프로젝트라면 실시간 응답이 필요 없는 작업을 비혼잡 시간대에 배치하고, 고정된 시스템 프롬프트를 재사용해 캐시 적중률을 높여 보세요. APIYI apiyi.com 플랫폼을 통해 호출하면 여러 모델의 사용량 내역을 한곳에서 확인할 수 있어 작업별 실제 비용을 계산하기도 편리합니다.
Search 및 Fetch API: 1017 버전과 함께 공개된 신규 과금 항목
1017 버전 출시와 함께 또 다른 변화가 있었어요. DeepSeek이 자체 Search(웹 검색)와 Fetch(웹 페이지 가져오기) 기능을 외부 개발자에게 개방한 것입니다. 이 두 기능은 모델 토큰 요금과 별도로 요청 횟수에 따라 과금되며, 성공한 요청 1,000건당 각각 $0.75입니다.
공식 요금 페이지에는 과도기 요금도 안내돼 있어요. 현재 DeepSeek Harness, Claude Code 또는 Codex를 통해 요청하면 무료지만, 베이징 시간으로 2026년 11월 1일 0시부터 요청 건별로 과금됩니다. 에이전트 워크플로에서 웹 검색을 많이 활용한다면 11월 전에 호출 횟수를 집계하고, 추가되는 비용을 미리 확인해 두는 것이 좋습니다.
DeepSeek V4.1 Flash 1017 빠른 시작: API 호출 예제
1017은 deepseek-flash라는 모델명을 그대로 사용하므로 기존 코드를 수정하지 않아도 새 버전을 자동으로 사용할 수 있어요. 다음은 OpenAI SDK와 호환되는 최소 호출 예제예요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

resp = client.chat.completions.create(
    model="deepseek-flash",  # 实际可用模型名以平台模型列表为准
    messages=[{"role": "user", "content": "用 Python 写一个读取 CSV 并按列求和的函数"}],
)
print(resp.choices[0].message.content)
print(resp.usage)  # 记录 Token 用量,便于对比新旧版本输出长度
전체 코드 보기: 이전 버전과 새 버전의 출력 길이 비교 스크립트
import time
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,一个 Key 调用多个模型
)

PROMPTS = [
    "解释 Python 中生成器和迭代器的区别,并给出示例",
    "写一个带重试和指数退避的 HTTP 请求函数",
    "把下面的 SQL 改写成 pandas 代码:SELECT city, AVG(price) FROM orders GROUP BY city",
]

def run(model: str, prompts: list[str]) -> dict:
    out_tokens, latency = [], []
    for p in prompts:
        start = time.time()
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": p}],
        )
        latency.append(time.time() - start)
        out_tokens.append(resp.usage.completion_tokens)
    return {
        "model": model,
        "avg_output_tokens": statistics.mean(out_tokens),
        "avg_latency_s": round(statistics.mean(latency), 2),
    }

if __name__ == "__main__":
    # 将历史记录中的 completion_tokens 与本次结果对比,即可估算 1017 的输出缩短幅度
    print(run("deepseek-flash", PROMPTS))
더 빠르게 시작하는 데 도움이 되는 실전 팁을 소개할게요.
- 추론 모드:
deepseek-flash는 기본적으로 추론 모드가 켜져 있어요. 간단한 질의응답이나 형식 변환 작업에서는 추론 모드를 끄면 출력 Token을 더 절약할 수 있어요. 구체적인 매개변수 설정 방법은 공식 문서를 확인하세요. - 샘플링 매개변수: Hugging Face 모델 카드에서는
temperature=1.0,top_p=0.95를 권장해요. 이전 버전에 맞춰 temperature를 조정했다면 다시 테스트해 보는 게 좋아요. - 이전 모델명:
deepseek-v4-flash로도 계속 호출할 수 있지만, 현재는 1017로 연결돼요. 나중에 별칭이 중단될 때 문제가 생기지 않도록deepseek-flash로 통일하는 것을 권장해요. - 회귀 테스트: 출력이 짧아지면 고정된 형식이나 길이에 의존하는 후속 파서에 영향을 줄 수 있어요. 전환하기 전에 실제 샘플로 테스트해 보세요.
🚀 빠른 시작: APIYI apiyi.com 플랫폼으로 프로토타입을 빠르게 만들어 보세요. OpenAI 호환 인터페이스를 별도 설정 없이 바로 사용할 수 있어 몇 분 안에 DeepSeek V4.1 Flash 1017을 기존 프로젝트에 연결하고 다른 모델과 A/B 비교를 진행할 수 있어요.
DeepSeek V4.1 Flash 1017은 어떤 작업에 적합할까요? V4 Pro와 비교해 보기
1017 업데이트 후에는 더 비싼 V4 Pro를 계속 써야 할지 고민될 수 있어요. 공식 가격표를 보면 Flash는 가격, 동시 요청 수, 비전 기능에서 앞서고, Pro는 여전히 DeepSeek이 외부에 제공하는 더 큰 모델이에요.
| 비교 항목 | deepseek-flash(V4.1 Flash 1017) | deepseek-v4-pro(V4 Pro 0813) | 권장 사항 |
|---|---|---|---|
| 출력 가격(비혼잡 시간대) | $0.60 / 백만 Token | $1.98 / 백만 Token | Flash는 Pro 가격의 약 30% |
| 컨텍스트 / 최대 출력 | 1M / 384K | 1M / 384K | 동일 |
| 시각 이해 | 지원 | 미지원 | 이미지 입력이 있으면 Flash 선택 |
| 동시 요청 상한 | 2,500 | 500 | 대규모 동시 배치 작업에는 Flash 선택 |
| Agent 프로그래밍 최적화 | Harness, CodeBuddy에 맞춰 집중 최적화 | 범용 | 프로그래밍 Agent에는 Flash 우선 검토 |
| 사용 가능 플랫폼 | DeepSeek 공식, APIYI apiyi.com 등 | 동일 | 통합 인터페이스로 간편하게 전환 가능 |
위 정보를 바탕으로 작업별 모델 선택 기준을 정리해 볼게요.
- 프로그래밍 Agent와 터미널 자동화: 이번에 성능 향상이 가장 두드러진 분야인 만큼 Flash 1017을 우선 선택해 보세요. 가격도 Pro의 약 3분의 1이에요.
- 차트, 스크린샷, 문서 이해: Pro는 현재 시각 입력을 지원하지 않으므로 Flash를 선택해야 해요.
- 대규모 오프라인 작업: Flash의 동시 요청 상한 2,500과 비혼잡 시간대 가격을 함께 고려하면 가장 비용 효율적인 조합이에요.
- 한 번의 응답에서 매우 높은 품질이 필요한 복잡한 추론: 벤치마크 점수만 보지 말고, 동일한 샘플로 Flash와 Pro를 비교한 뒤 결정하는 것을 권장해요.
💡 선택 팁: 적합한 모델은 작업 유형과 품질 요구사항에 따라 달라져요. APIYI apiyi.com 플랫폼에서 동일한 실제 샘플로 Flash와 Pro를 함께 테스트해 보세요. 통합 인터페이스에서는 모델명만 바꾸면 되므로 빠르게 결과를 비교할 수 있어요.
자주 묻는 질문
Q1: DeepSeek V4.1 Flash 1017을 사용하려면 코드를 수정해야 하나요?
아니요. 공식 발표에 따르면 API 호출 방식은 그대로예요. deepseek-flash는 자동으로 1017 버전을 가리키며, 기존 이름인 deepseek-v4-flash도 새 버전으로 연결돼요. 다만 출력이 짧아진 뒤에도 후속 파싱이 정상적으로 작동하는지 회귀 테스트를 해보는 것이 좋아요. APIYI apiyi.com 플랫폼에서 테스트용 크레딧을 받아 새 버전이 실제 비즈니스에 어떻게 작동하는지 빠르게 확인할 수 있어요.
Q2: DeepSeek V4.1 Flash 1017의 가격은 실제로 바뀌었나요?
단가는 바뀌지 않았어요. 비혼잡 시간대에는 캐시 미적중 입력이 $0.15, 캐시 적중 입력이 $0.003, 출력이 $0.60이며, 모두 100만 토큰 기준이에요. 혼잡 시간대에는 요금이 두 배로 올라요. 하지만 1017 버전은 출력이 더 짧아 같은 작업을 수행할 때 총비용은 대체로 줄어들어요. 새로 추가된 Search와 Fetch API 요금은 성공한 요청 1,000건당 각각 $0.75예요.
Q3: 혼잡 시간대는 한국 시간으로 몇 시인가요?
중국 베이징 시간 기준으로 평일 09:00~12:00, 14:00~18:00이며, UTC 기준으로는 01:00~04:00, 06:00~10:00예요. 중국 법정 공휴일은 혼잡 시간대에서 제외돼요. 그 외 시간에는 혼잡 시간대 요금의 절반인 비혼잡 시간대 요금이 적용돼요.
Q4: 1017 버전의 벤치마크 성능 향상은 믿을 만한가요?
점수는 DeepSeek가 공식 발표한 결과이며, 제3자에 의한 독립 재현은 아직 진행 중이에요. 일부 벤치마크는 특정 프레임워크에 의존해요. 예를 들어 Terminal-Bench 4.0은 Claude Code 프레임워크를, DeepSWE는 Mini-SWE-V2 프레임워크를 사용해요. 자체 Agent 루프를 사용하면 결과가 다를 수 있어요. 가장 확실한 방법은 직접 보유한 샘플과 프레임워크로 테스트한 뒤 전환 여부를 결정하는 거예요.
Q5: DeepSeek V4.1 Flash 1017을 로컬에 배포할 수 있나요?
네. 가중치는 MIT 라이선스로 Hugging Face와 ModelScope에 공개돼 있으며, vLLM, SGLang, Transformers 등의 추론 프레임워크를 지원해요. 다만 552B의 주력 파라미터를 구동하려면 높은 VRAM 사양이 필요하므로, 중소 규모 팀은 대체로 API를 직접 호출하는 편이 더 경제적이에요.
핵심 요약
- 개선 사항: 아키텍처는 그대로 유지하면서 새로운 강화 학습을 적용했어요. 공식 벤치마크 11개 항목에서 모두 성능이 향상됐고, Terminal-Bench 4.0 점수는 31.2에서 42.3으로 올랐어요.
- 효율 변화: 작업을 더 빠르게 완료하고 출력도 짧아져, 토큰 기준으로 요금을 내는 경우 작업당 비용이 직접 줄어들어요.
- 가격 변경 여부: 단가는 그대로예요. 비혼잡 시간대에는 입력 $0.15 / 출력 $0.60이고, 혼잡 시간대에는 두 배예요. 혼잡 시간대는 중국 베이징 시간 기준 평일 09~12시와 14~18시예요.
- 신규 요금: Search와 Fetch API는 각각 1,000건당 $0.75예요. 11월 1일부터 Harness, Claude Code, Codex를 통한 호출에 요금이 부과돼요.
- 연동 방식: 기존
deepseek-flash를 그대로 사용하면 돼요. 코드 수정은 필요 없으며, 전환 전에 회귀 테스트를 한 번 진행하면 돼요.
요약
제목에서 던진 두 가지 질문에 대한 답은 세 가지로 정리할 수 있어요.
- 무엇이 개선됐나요? DeepSeek V4.1 Flash 1017은 같은 아키텍처를 기반으로 재학습한 모델이에요. 에이전트 코딩 능력이 가장 크게 향상됐고, 시각적 이해력도 안정적으로 개선됐어요. 출력은 더 짧아지고 속도는 더 빨라졌어요.
- 가격이 바뀌었나요? 아니요. 9월 가격 인하 이후의 수준을 그대로 유지해요. 출력이 짧아져 실제 비용은 더 낮아지고, 한산한 시간대에는 비용을 절반으로 줄일 수 있어요.
- 무엇을 해야 하나요? 코드를 수정할 필요는 없지만, 회귀 테스트를 한 번 진행하고 11월부터 Search/Fetch에 요청별 과금이 적용되면 에이전트 워크플로에 어떤 영향을 주는지 확인해 보세요.
DeepSeek를 사용 중이거나 프로그래밍 에이전트, 대량 처리, 차트 이해에 도입하려는 팀이라면 1017은 ‘성능은 높이고 가격은 그대로’인 업데이트예요. 가능한 한 빨리 전환해 검증해 볼 만해요. APIYI apiyi.com을 통해 효과를 빠르게 확인해 보세요. 통합 인터페이스에서 DeepSeek V4.1 Flash 1017과 다른 주요 모델을 같은 샘플로 비교한 뒤, 운영 트래픽을 어떻게 배분할지 결정할 수 있어요.
더 읽어볼 글
DeepSeek 시리즈 모델에 관심이 있다면 다음 글도 읽어 보세요.
- 📘 DeepSeek V4.1 Flash 첫 공개 분석: 새로운 아키텍처와 네이티브 멀티모달 – 9월 첫 공개 버전의 아키텍처 변화를 살펴봐요.
- 📊 DeepSeek API 비용 최적화 가이드: 캐시 적중과 한산한 시간대 예약 – 토큰 비용을 줄이는 실용적인 방법을 알아봐요.
- 🚀 프로그래밍 에이전트 모델 선택 가이드: Flash, Pro와 주요 폐쇄형 모델 비교 – 다양한 상황에 맞는 최적의 조합을 살펴봐요.
참고 자료
- DeepSeek API 업데이트 로그: V4.1 Flash 및 1017 버전의 공식 출시 안내와 벤치마크 데이터
- 링크:
api-docs.deepseek.com/updates -
설명: 본문에 나온 벤치마크 점수와 버전 정보의 주요 출처예요.
-
DeepSeek 모델 및 가격: 공식 가격, 피크 시간대, Search/Fetch 요금 규칙
- 링크:
api-docs.deepseek.com/quick_start/pricing -
설명: 가격은 공식 페이지의 최신 정보를 기준으로 해요.
-
Hugging Face 모델 카드: DeepSeek-V4.1-Flash의 아키텍처, 파라미터, 권장 샘플링 설정
- 링크:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash -
설명: 로컬 배포와 파라미터 설정을 참고할 수 있어요.
-
Regolo 비교 글: V4 Flash와 V4.1 Flash의 가격 및 벤치마크 비교
- 링크:
regolo.ai - 설명: 본문에서 인용한 기존 V4 Flash 가격은 이 서드파티 자료를 참고했어요.
작성자: APIYI 기술팀
기술 관련 문의: 댓글로 자유롭게 의견을 나눠 주세요. 더 많은 자료는 APIYI docs.apiyi.com 문서 센터에서 확인할 수 있어요.