
GPT, Claude, Kimi 글쓰기 테스트 요약: 먼저 결론부터
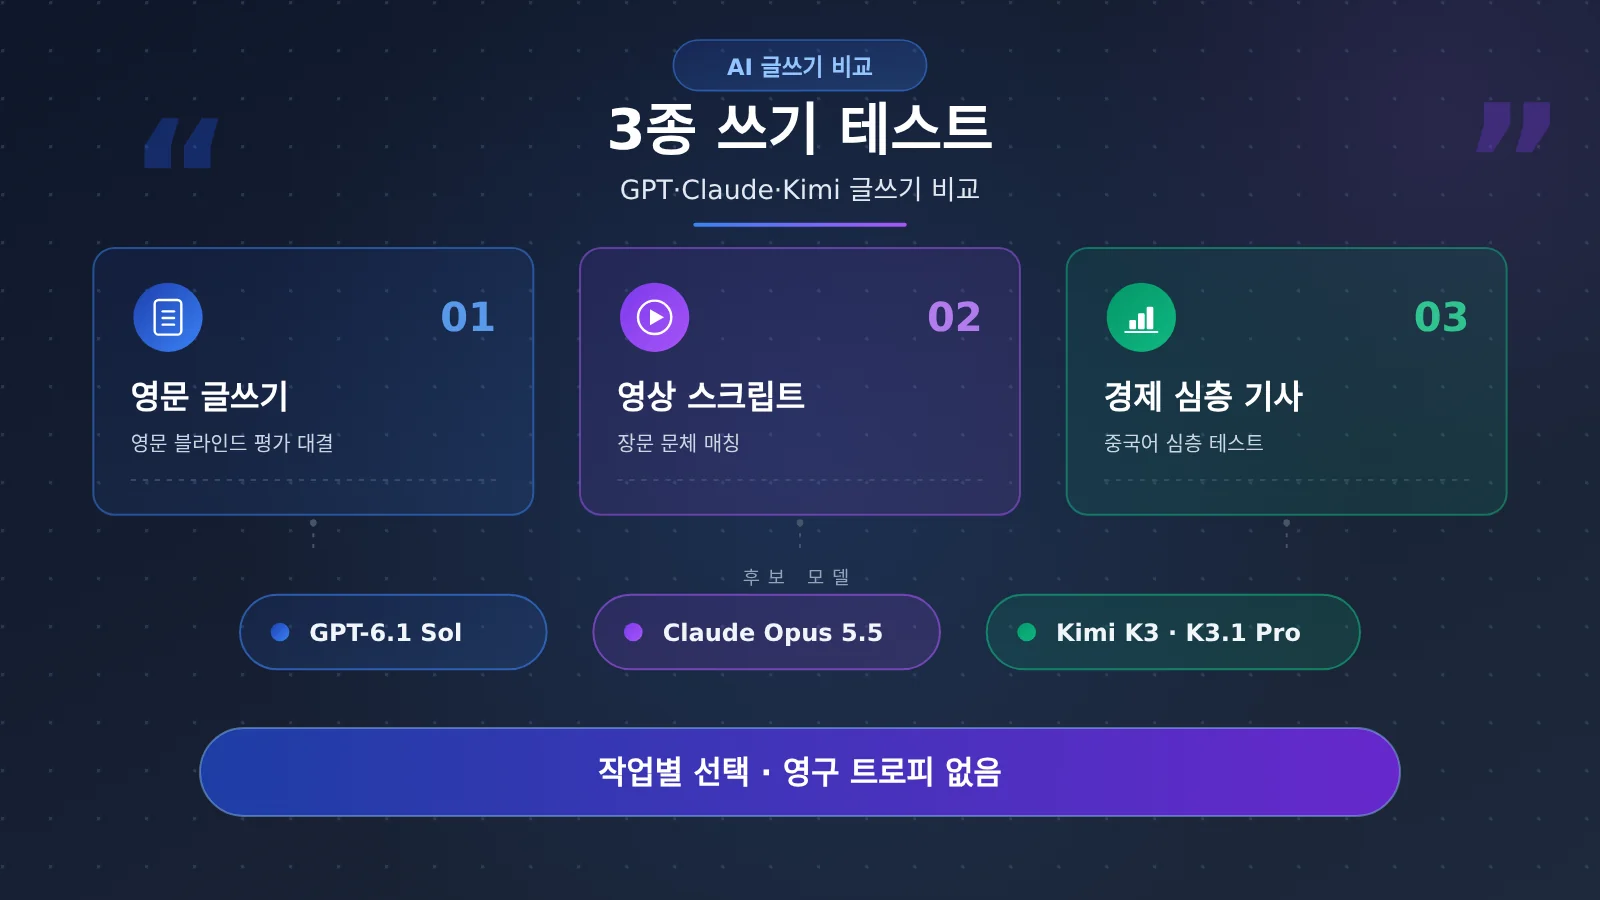
영문 기사는 GPT-6.1 Sol을 먼저 시험해보고, 문체가 중요한 장문은 Claude Opus 5.5를 우선 시험해보세요. 설명형 과학 대중화 글에는 Kimi K3를 추가해볼 만해요. Kimi K3.1 Pro의 영문 종합 성능도 매우 강력해서 ToneBench에서 GPT와 비슷한 수준이에요.
세 가지 테스트는 다루는 작업, 언어, 평가 방법이 각각 달라요. 가장 실용적인 결론은 후보 명단을 만들고 자신의 원고로 검증하는 것이지, 세 모델 패밀리에 영구 트로피를 수여하는 게 아니에요.
시작 팁: APIYI apiyi.com의 통합 인터페이스를 통해 후보 모델을 호출하고, 동일한 자료 패키지로 초안을 비교해볼 수 있어요. 신규 사용자 무료 테스트 한도는 플랫폼의 현재 규칙을 기준으로 해요.
GPT, Claude, Kimi 글쓰기 테스트: 이어지는 내용은 무엇일까?
이 글은 영어 글쓰기 순위, 스타일화 영상 장문 원고 테스트, 중국어 금융 심층 기사 실측을 차례로 분석해요. 마지막에는 시나리오 선택, 블라인드 테스트 절차, 호출 예시를 제시하며, 글의 품질과 사람의 편집 비용을 중점적으로 살펴봐요.
먼저 두 가지 용어를 정리할게요. 글쓰기 벤치마크는 정해진 과업에 따라 출력을 평가하는 테스트이고, 블라인드 평가는 모델 신원을 숨긴 채 텍스트를 비교하는 방식이에요. 블라인드 평가는 사람 또는 모델이 수행할 수 있으며, 결과를 읽을 때는 평가자가 누구인지 분명히 해야 해요.
GPT, Claude, Kimi 글쓰기 테스트 1: 영어 글은 GPT를 보세요
AI Writing Benchmark는 Johannes Eva가 관리하는 영어 글쓰기 프로젝트로, 모델 제공업체의 유료 후원을 받지 않았다고 밝혔어요. 이 글은 2026년 11월 11일에 업데이트되고 11월 12일에 조회된 결과를 사용해요.
이 프로젝트는 115개 모델을 다루며 131,507회의 공개 블라인드 평가 대결을 기록했어요. 익명 텍스트 비교로 글쓰기를 평가하고, AI 평가자 순위와 사람 투표 순위를 각각 보여줘요.
| 모델 | 영어 종합 점수 | 결과 기준 |
|---|---|---|
| GPT-6.1 Sol | 95.3 | 종합 순위 1위 |
| Claude Opus 5.5 | 92.9 | 종합 순위 2위 |
| Kimi K3.1 Pro | 91.9 | 종합 순위 3위 |
종합 점수는 여러 유형의 과업을 합산하고, 과업 분류 점수는 특정 유형의 문제만 반영해요. GPT-6.1 Sol은 기사, 블로그, 편집 콘텐츠에서 분류 점수 98.5를 기록했으며, 종합 점수 95.3과는 따로 기록해야 해요.
이 점수들은 벤치마크 내부의 상대 점수예요. 이 프로젝트는 50을 해당 언어와 카테고리의 평균 모델을 이길 추정 확률이 2분의 1인 수준으로 정의하므로, 독자는 점수를 바로 게시 가능한 콘텐츠 비율로 보지 말고 경쟁 위치에 주목해야 해요.
솔직히 말하면, 과업이 영어 블로그나 편집형 기사라면 GPT-6.1 Sol이 1차 테스트에 들어갈 충분한 이유가 있어요. 중국어 기사는 별도의 중국어 근거를 찾아야 하고요.
또 하나 주목할 결과는 Kimi K3가 설명 및 과학 대중화 카테고리에서 94.9로 선두를 달렸다는 점이에요. 여기서 승리한 것은 K3이고, 종합 순위 3위는 K3.1 Pro이므로 버전명을 성적과 함께 저장해야 해요.
GPT, Claude, Kimi 글쓰기 테스트 2: 장문 문체로 본 Claude
ToneBench는 모델이 크리에이티브 브리프, 리서치 자료 패키지, 스타일 가이드를 읽고 완전한 YouTube 스크립트를 생성하도록 합니다. 모델은 원작자의 완성 원고를 볼 수 없고, 인터넷에 접속하거나 외부 도구를 호출할 수도 없어요.
이 글은 2026년 11월 10일에 업데이트된 자료를 사용했어요. 과제는 특정 크리에이터의 영상 장문 원고이고, 주어진 자료에 전체 과제 언어가 명시되어 있지 않아서 여기서는 스크립트 시나리오 기준으로 해석했어요.
테스트에는 87개 모델, 151개 구성이 포함되어 있고, 구성마다 10개 과제를 수행하며 과제별로 5회씩 독립 생성해요. 총 7,550편의 원고를 생성했고, 네 명의 AI 심사위원이 30,200회 평가를 완료했어요.
특히 주목하는 항목은 스타일 매칭, 즉 어조와 리듬, 표현 방식이 목표 크리에이터와 얼마나 가까운지예요. 문체 매칭 가중치는 19%, 콘텐츠 깊이·정확성·가치는 15%이고, 일관성과 분량 조절도 평가해요.
아래 표는 각 모델의 최적 구성 기준 Writing Score와 자료에 나온 모델 순위를 정리한 거예요. Claude는 xhigh 구성이고, 자료에 나머지 두 모델의 구체적 추론 구성명은 없어서, 재측정 시에는 이 부분을 채워야 해요.
| 모델 | 모델 순위 | Writing Score | 테스트 추정 편당 비용 |
|---|---|---|---|
| Claude Opus 5.5 | 1 | 85.8 | $1.003 |
| GPT-6.1 Sol | 8 | 82.4 | $0.239 |
| Kimi K3.1 Pro | 9 | 82.5 | $0.251 |
Writing Score는 이 테스트의 글쓰기 성과를 종합한 지표이고, 순위는 Elo 기준이에요. 그래서 Kimi가 점수는 0.1 높은데 순위가 한 단계 낮은 것은 두 모델의 성과가 비슷하다고 이해하면 돼요.
이 결과에서 Claude가 앞서고, 테스트 추정 비용은 GPT의 약 4.2배예요. ToneBench의 비용 추정치이며, 다른 플랫폼의 글 단가로 그대로 적용할 수는 없어요.
순위를 이해하려면 과제와 심사 방식도 같은 그림에 놓고 보는 게 좋아요. APIYI apiyi.com으로 재측정할 때는 구성 기록을 남기고, 원래 리더보드로 돌아가 비교 기준을 확인해 보세요.
ToneBench의 1위와 2위는 신뢰구간이 겹치고, 참조 스크립트를 어느 하나만 제거해도 선두가 바뀌어요. 연구에서는 심사위원에게 어느 정도 벤더 편향이 있다는 점도 발견했지만, 단위 심사를 제외한 뒤에도 Claude가 여전히 1위를 지켰어요.
핵심 판단은 이래요. 자료를 흡수하면서 크리에이터의 목소리를 유지해야 하는 장문 원고라면 Claude를 우선 시험해 볼 가치가 있어요. 이 결과는 후보 선택을 이끄는 데 적합하고, 우위 폭은 직접 쓴 원고로 검증해야 해요.
한 가지 더 유의할 점은, GPT-6 Sol의 Least Slop 단일 항목 성적은 다른 버전, 다른 지표에 속하므로 GPT-6.1 Sol의 Writing Score를 대체하는 데 쓸 수 없어요.
GPT, Claude, Kimi 글쓰기 테스트 3: 중국어 심층 기사에서는 무엇을 볼까?
OmniTools의 테스트는 2026년 10월 26일부터 11월 3일까지 진행됐고, 대상은 PANews의 중국어 재테크 심층 기사였어요. 10개 모델, 26개 기사를 비교했죠.
| 모델 | AI 블라인드 평가 점수 | 테스트 기사 수 | 자연스러움 점수 |
|---|---|---|---|
| Claude Opus 5.5 | 8.25 | 7 | 8.3 |
| GPT-6.1 Sol | 6.33 | 3 | 5.5 |
이번 테스트에서는 Claude의 전체 점수와 자연스러움 점수가 더 높았어요. 중국어 재테크 심층 기사라면 Claude Opus 5.5를 먼저 시도해볼 만한 후보예요.
다만 표본이 적고 모델별 기사 수가 고르지 않으며, Kimi는 참여하지 않았어요. 그래서 이 자료는 GPT와 Claude의 중국어 사용 사례 근거를 보완하는 수준에 그치고, 세 모델의 완전한 중국어 순위를 내놓지는 못해요.
평가는 Claude Opus 5.5와 DeepSeek V4 Pro가 맡았고, 자기 모델은 평가하지 않는 규칙을 세웠어요. 발행 측이 API 라우팅 서비스라는 상업적 배경을 갖고 있으니, 읽을 때 이 출처 정보는 함께 염두에 두는 게 좋아요.
편집 평가는 별도의 기록이에요. Claude의 100% 편집 채택률은 1/1회차에 해당하는 수치일 뿐이라 사례 수준으로 관찰하는 게 적절하고, 장기적인 채택 여부는 더 많은 원고가 뒷받침돼야 알 수 있어요.
한 줄 요약: Claude가 중국어 재테크 장문을 쓴다는 긍정적인 신호는 여기서 확인되지만, 근거의 범위는 이 사용 사례에 한정돼요.
GPT, Claude, Kimi 글쓰기 테스트: 시나리오별 후보 선택
세 결과를 한데 모으면 점수를 더하는 대신 하나의 모델 선택표를 만들어야 해요. 글의 언어, 작업, 목표 문체에 따라 어떤 근거가 나와 관련 있는지가 달라져요.
| 글쓰기 시나리오 | 우선 후보 | 선택 근거 |
|---|---|---|
| 영어 블로그, 편집형 글 | GPT-6.1 Sol | 영어 글 분류에서 앞서요 |
| 크리에이터 스타일 영상 장문 원고 | Claude Opus 5.5 | ToneBench 현재 선두 |
| 중국어 금융 심층 원고 | Claude Opus 5.5 | 중국어 소표본 실측 선두 |
| 영어 설명, 과학 대중화 | Kimi K3 | 설명 및 과학 대중화 분류 선두 |
| 자료 패키지 기반 장문 콘텐츠 | 세 모델 공동 블라인드 테스트 | GPT와 Kimi가 ToneBench에서 근접 |
| 호출 검증 플랫폼 | APIYI apiyi.com | 통합 인터페이스로 모델 전환 용이 |
중국어 기술 튜토리얼, 제품 소개 같은 시나리오는 현재 세 가지 근거로 완전히 커버되지 않아요. 더 안전한 방법은 후보들을 동시에 테스트해 누가 기술을 명확히 설명하고 사실을 정확히 쓰는지 보는 거예요.
GPT, Claude, Kimi 글쓰기 테스트: 직접 대조 실험은 어떻게 할까요?
실제 주제를 골라 각 모델에 완전히 같은 자료, 기획, 분량, 도구 권한을 주는 걸 권해요. 각 모델이 최소 세 번씩 독립적으로 생성하고 모델명을 가린 뒤 편집자가 평가하게 하세요.
평가는 다섯 항목으로 시작할 수 있어요: 사실 정확성, 기획 실행, 표현 자연스러움, 구조 명확성, 콘텐츠 가치. 가중치는 팀 과제에 따라 정하고, 이것이 자체 제작한 규칙임을 명시하세요.
그리고 인간 편집 비용도 기록하세요: 발행 가능한 상태로 만들기 위해 필요한 작업량이에요. 수정 시간, 다시 쓴 문단, 사실 오류, 최종 채택 여부를 함께 기록하면 좋아요.
설정 제안: APIYI apiyi.com에서 하나의 API 키로 모델을 전환하면 반복적인 연동 작업을 줄일 수 있어요. 테스트할 때 모델 버전, 파라미터, 실제 Token 사용량을 남겨 두면 재현하기 쉬워요.
아래는 최소 호출 예시예요. 동일한 실제 자료 패키지를 brief에 넣고 모델명만 바꾸면 대조 초안을 생성할 수 있어요. 키는 실행 환경에서 안전하게 제공해야 해요.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

brief = """请依据以下资料和策划生成文章。
只使用资料支持的事实,遵守目标篇幅与文风。
这里替换为各模型共同使用的实际资料包和策划。
"""

for model in [
    "gpt-6.1-sol",
    "claude-opus-5-5",
    "kimi-k3.1-pro",
]:
    result = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": brief}],
    )
    print(model, result.choices[0].message.content)
이 코드는 시작점으로 쓰는 거예요. 정식 블라인드 테스트에서는 반복 생성, 익명 제시, 설정 기록도 해야 해요. 설명 분류에서 앞서는 모델을 검증하려면 Kimi K3를 추가로 넣어야 해요.
GPT, Claude, Kimi 작문 테스트 FAQ
GPT, Claude, Kimi 작문 테스트에서 Kimi는 어느 버전을 테스트해야 하나요?
설명·교양 콘텐츠에는 Kimi K3를 우선 추가하고, 본문의 종합 순위와 ToneBench 결과를 비교할 때는 K3.1 Pro를 사용하세요. APIYI apiyi.com을 통해 호출하기 전에 모델 목록과 구체적인 모델명을 확인해 버전이 뒤섞이는 일을 피해야 해요.
GPT, Claude, Kimi 작문 테스트에서 실제 비용은 어떻게 비교하나요?
“한 편당 합격 비용”을 비교하세요. 누적 호출 비용에 편집 작업량을 더한 값이에요. APIYI apiyi.com에서 테스트할 때는 실제 사용량과 재시도 횟수를 기록한 뒤 당시 가격으로 계산하는 편이 초안 비용만 들여다보는 것보다 실제 생산 환경에 더 가깝습니다.
GPT, Claude, Kimi 작문 테스트 마무리: 편집이 덜 드는 모델 선택하기
영문 글은 먼저 GPT를 시도하고, 스타일화된 장문과 중국어 금융 심층 기사는 먼저 Claude를 시도하며, 설명·교양 콘텐츠에는 Kimi를 더하세요. 이는 특정 작업에서의 우선순위일 뿐, 모델 패밀리 전체의 영구적인 순위가 아니에요.
APIYI apiyi.com을 통해 동일한 자료 패키지로 효과를 검증해 보시길 권합니다. 최종적으로 누구를 선택할지는 누가 기획을 더 정확하게 완수하고, 쓸 만한 단락을 더 많이 남겨 편집자가 야근을 한 번이라도 덜 하게 하는지에 달려 있어요.
GPT, Claude, Kimi 작문 테스트 참고 자료
-
AI Writing Benchmark: aiwritingbenchmark.com
영문 종합 순위와 분류별 순위를 제공하며, 2026년 11월 11일 업데이트 기준을 따릅니다. -
Towards AI ToneBench: benchmark.towardsai.com/models/
영상 스크립트 테스트, 모델 순위, 구성 및 비용 추정을 다루며, 2026년 11월 10일 자료를 기준으로 합니다. -
OmniTools 심층 장문 작문 실측: omnitools.ai/evals/longform-writing
PANews 중문 경제 심층 기사 테스트로, 테스트 기간은 2026년 10월 26일부터 11월 3일까지예요.
작성자: APIYI 기술 콘텐츠 팀. APIYI apiyi.com을 통해 모델 구성, 블라인드 테스트 방법, 편집 노하우를 함께 나누고 있어요.


