노트북 한 대가 켜지고, 화면에는 Windows도 특정 Linux 배포판도 아닌, AI가 빈 폴더에서부터 구축한 시스템이 나타나요. 2026년 11월 9일, Anthropic은 Claude Fable 5.2를 발표하면서 이 내부 실험을 공개했어요. Fable 5.2는 1,000개가 넘는 하위 에이전트를 조율해 8일 동안 쉬지 않고 작업했고, 실제 노트북에서 부팅할 수 있는 운영체제 프로토타입을 만들었어요.
핵심 가치: 이 글에서는 운영체제 실험을 중심으로 Claude Fable 5.2의 진정한 돌파구가 무엇인지, 1,000개가 넘는 AI 에이전트를 어떻게 이해해야 하는지, 이 프로토타입이 완성된 제품에 이르려면 얼마나 더 가야 하는지 살펴봐요. 마지막으로 개발자 관점에서 장기간 실행되는 에이전트 워크플로가 API 인프라에 어떤 요구를 하는지도 알아볼게요.
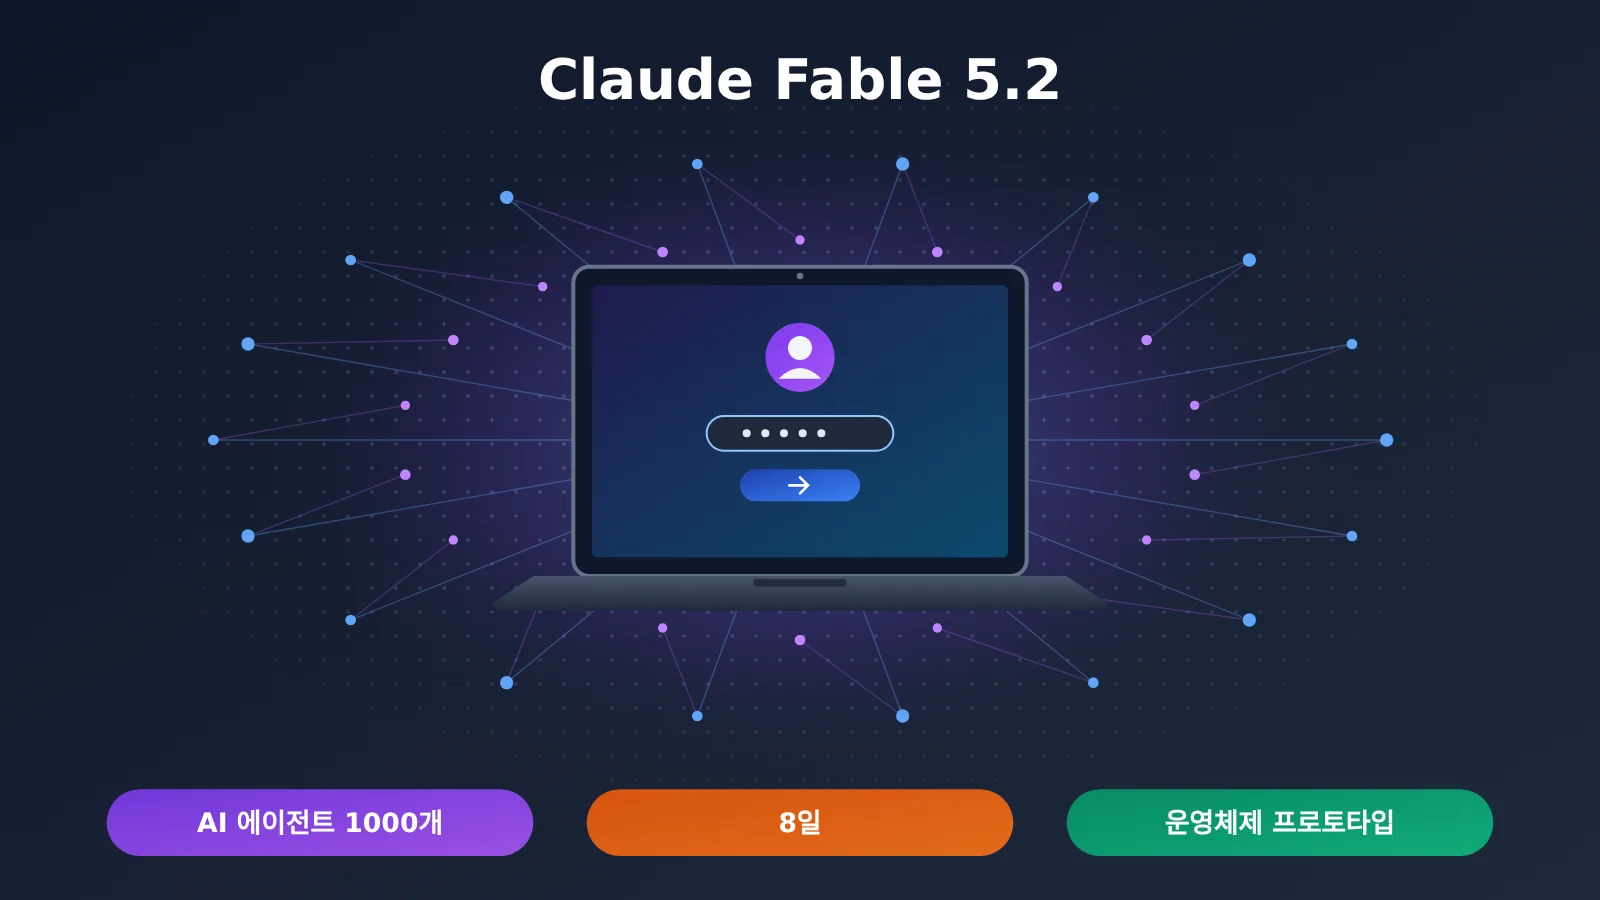
Claude Fable 5.2 운영체제 실험의 핵심 정보
먼저 공식적으로 공개된 사실을 살펴볼게요. 아래 표에는 Anthropic의 발표에서 확인된 내용만 담았어요.
| 항목 | 세부 정보 |
|---|---|
| 공개일 | 2026년 11월 9일, Claude Fable 5.2 발표와 함께 공개 |
| 발표 주체 | Anthropic(내부 엔지니어링 실험) |
| 작업 시작점 | 한 엔지니어가 빈 폴더에서 시작해 프로토타입 운영체제를 설계하고 구현하라는 과제를 제시 |
| 실행 규모 | 1,000개가 넘는 하위 에이전트가 8일 동안 24시간 연속 작업 |
| 주요 활동 | 코드 작성, 구성 요소 테스트, 코드 검토, 문제 수정 |
| 최종 기능 | 커널, 디스크·키보드·네트워크 드라이버, 영구 파일 저장, 윈도 시스템, 로그인 인터페이스, 설치 프로그램, 내장 Claude 기능 |
| 핵심 검증 | 실제 노트북 한 대에서 부팅 가능 |
| 아직 공개되지 않은 정보 | 소스 코드와 빌드 절차, 아키텍처 문서, 코드 줄 수, 에이전트 통신 아키텍처, 토큰 사용량, 실험 비용, 다양한 하드웨어 호환성 테스트, 제3자 보안 감사 |
AI 에이전트 1,000개가 만든 운영체제에는 어떤 모듈이 있을까?
주요 모듈의 역할은 다음과 같아요. 커널은 하드웨어와 시스템 리소스를 관리하는 핵심 소프트웨어로, 프로세스 스케줄링과 메모리 할당, 인터럽트 처리를 담당해요. 드라이버는 운영체제가 디스크, 키보드, 네트워크 카드 같은 하드웨어와 통신하도록 해요. 드라이버가 없으면 커널은 주변 장치를 인식하지 못해요.
영구 파일 저장 기능은 재부팅한 뒤에도 데이터를 보존할 수 있다는 뜻이에요. 메모리에서 한 번 실행해 보는 데모가 아니라, 실제 파일 시스템을 갖춰야 하죠.
윈도 시스템과 로그인 인터페이스, 설치 프로그램은 사용자가 직접 볼 수 있는 부분이에요. 특히 설치 프로그램에 주목할 만해요. 이 기능이 있다는 건 적어도 ‘디스크에 기록한 뒤, 디스크에서 다시 부팅하는’ 전체 과정이 구현됐다는 뜻이니까요.
이 모듈들을 함께 살펴보면 ‘노트북에서 부팅할 수 있다’는 결과가 왜 의미 있는지 이해할 수 있어요. 여러 하위 시스템이 실제로 서로 연결되어 작동해야 하거든요. 각 모듈이 그럴듯해 보이는 코드 몇 줄씩만 작성하는 것으로는 충분하지 않아요.
그러면 이 글의 핵심 질문으로 이어져요. 1,000개가 넘는 에이전트는 어떻게 협력해 하나의 완성된 엔지니어링 프로젝트를 수행했을까요?
Claude Fable 5.2의 도약: AI가 엔지니어링을 조직하기 시작하다
Fable 5.2는 프로그래밍 벤치마크에서 확실한 성과를 거뒀어요. Anthropic이 공개한 FrontierCode 2.0 점수는 49.1%로, 이전 버전인 Fable 5.1의 32.4%보다 높아요. FrontierSWE v2 점수도 69.9%로, 이전 버전의 56.3%를 넘어섰어요.
하지만 이 점수는 일반 프로그래밍 벤치마크의 결과일 뿐, 운영체제 실험 자체를 평가한 성적은 아니에요. 이번 실험에서 더 주목할 점은 코드를 얼마나 잘 작성했느냐가 아니라, 엔지니어링을 조직하는 방식이 달라졌다는 거예요.
기존 AI 코딩 도우미와 장기 에이전트 엔지니어링의 차이
기존 AI 코딩 도우미는 ‘질문과 답변’을 반복하는 협업 방식이에요. 사용자가 요구사항을 제시하면 AI가 코드를 작성하고, 사용자가 검토한 뒤 수정 사항을 요청하는 식이죠. 이 방식에서는 사람이 작업을 나누고 진행 상황을 관리하며 전체 결과를 통합해요. AI는 효율적인 실행자 역할을 할 뿐이에요.
장기 에이전트 엔지니어링에서는 모델에 더 많은 역할을 맡겨요. 아래 표에서 두 방식의 차이를 비교해 볼게요.
| 차원 | 기존 AI 코딩 도우미 | 장기 에이전트 엔지니어링 |
|---|---|---|
| 작업 단위 | 개별 함수, 파일 또는 기능 | 전체 프로젝트를 다루며, 하위 작업을 직접 나눠야 함 |
| 실행 시간 | 한 번의 대화, 몇 분에서 몇 시간 | 몇 시간에서 며칠 동안 연속 실행 |
| 실행 방식 | 단일 스레드로 실행하고 사람의 피드백을 기다림 | 여러 하위 에이전트가 서로 다른 모듈을 병렬 처리 |
| 품질 보장 | 주로 사람이 검사 | 자동 테스트와 교차 검토를 수행하고, 문제를 발견하면 수정 작업을 배정 |
| 통합 작업 | 사람이 수행 | 조정자가 결과를 취합하고 모듈 간 호환성을 확인 |
| 사람의 역할 | 단계별로 지시 | 목표를 설정하고 과정을 감독한 뒤 최종 승인 |
운영체제 같은 프로젝트에서는 오른쪽 열에 해당하는 부분이 진짜 어려워요. 커널, 드라이버, 파일 시스템 사이에는 수많은 인터페이스 규약이 있고, 한 모듈을 수정하면 다른 모듈의 테스트가 실패할 수도 있어요.
8일 동안 문제를 찾아내고, 수정을 배정하고, 미완료 작업을 계속 진행할 수 있었다는 점은 단순한 ‘코딩’ 능력이 아니라 ‘프로젝트 관리’ 능력을 보여줘요.
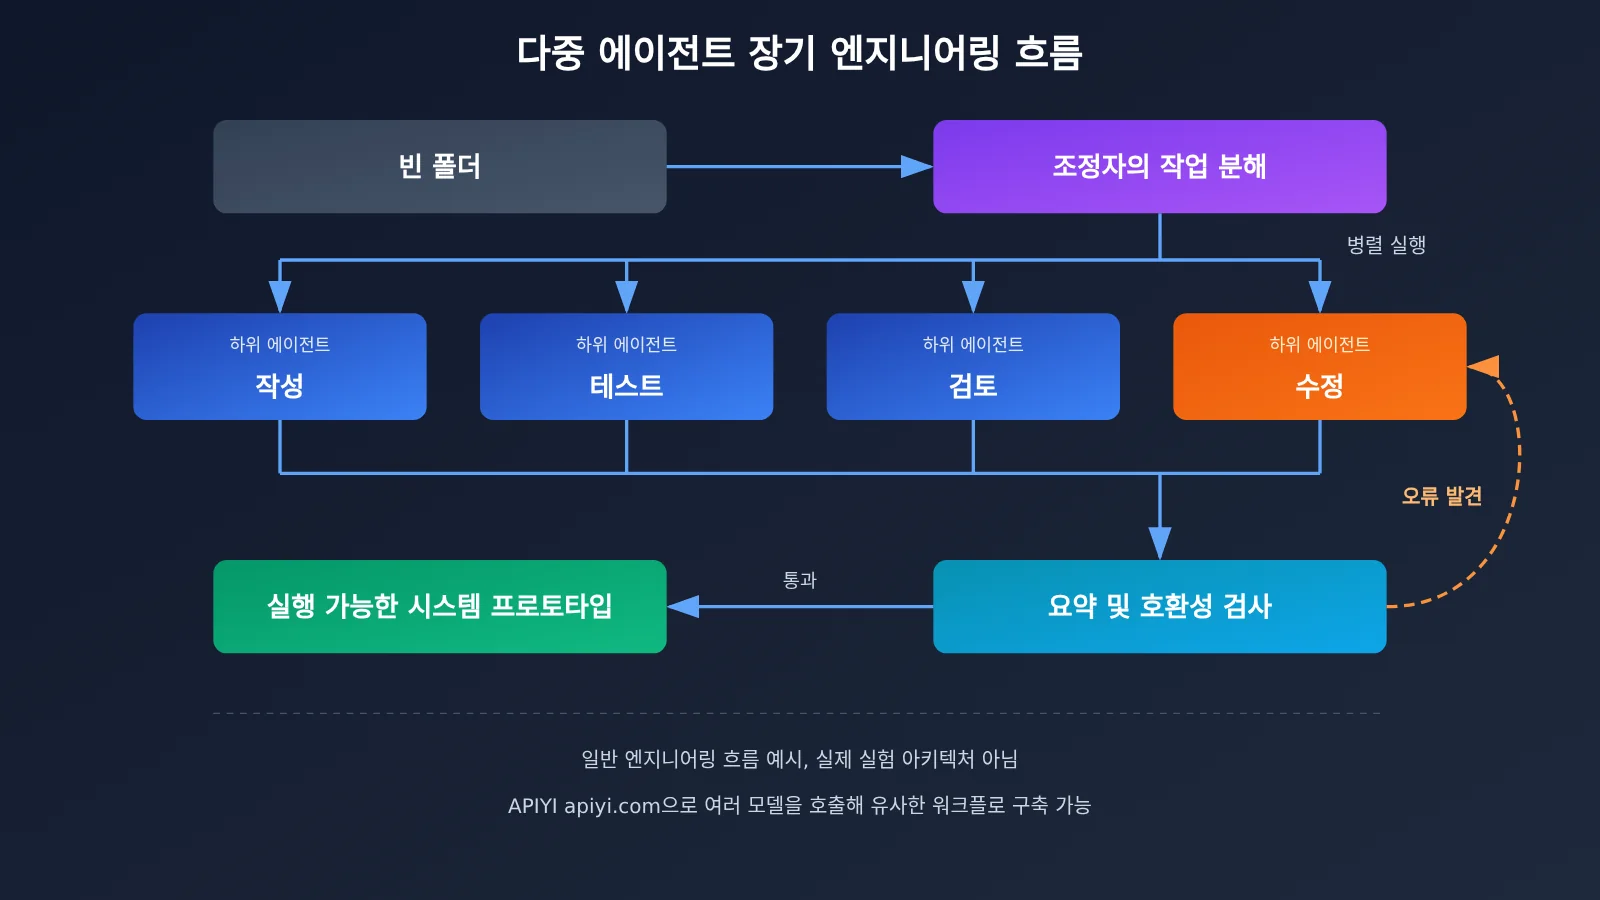
위 그림은 대규모 엔지니어링의 일반적인 절차를 분석한 내용이라는 점에 유의해야 해요. Anthropic은 운영체제 실험의 구체적인 역할 분담 구조, Harness, 통신 프로토콜 또는 프로그래밍 언어를 공개하지 않았어요.
같은 시기에 공개된 페르마의 마지막 정리 실험에서는 ‘Lead 1명 + Helper 999명’과 같은 아키텍처 세부 정보가 공개됐어요. 하지만 이 실험은 별개의 프로젝트이므로 운영체제 프로젝트에 그대로 적용해서는 안 돼요.
기업 초기 테스트 참여자가 본 ‘조정자’ 역할
Anthropic은 출시 당시 초기 테스트 파트너 몇 곳의 피드백을 공개했어요. 기업 엔지니어들이 실제로 사용한 경험으로, 독립적인 블라인드 테스트 결과는 아니지만 모두 같은 흐름을 보여 줍니다. 모델이 계획 수립과 조정 업무를 맡기 시작했다는 점이에요.
- Vercel: 기술 직원인 Joe Haddad는 다른 모델로는 몇 주 동안 진행해야 했던 프로젝트를 Fable 5.2를 사용해 며칠 만에 끝내고 팀 검토까지 통과했다고 밝혔어요. 코드 리뷰에서 수정 의견도 더 적게 나왔다고 해요.
- Shopify: Staff Engineer인 Tom Pritchard는 모델이 폭넓은 아이디어를 받아 몇 차례 대화를 거쳐 계획을 세우고, 이후 작업을 자율적으로 완료할 수 있다고 평가했어요. 다른 Staff급 엔지니어와 협업하는 것에 가까운 경험이었다고 합니다.
- Datadog: Senior Staff Engineer인 Matt Lee는 모델을 사고 지휘관(Incident Commander)에 비유했어요. 낯선 시스템을 마주했을 때 더 빠른 모델을 호출해 정보를 수집하고, 여러 작업을 조율해 사람이 직접 처리해야 할 조정 업무를 덜어 준다는 설명이에요.
- Uber: Agentic Systems 담당 Staff Engineer인 Andrew Mager는 10—12시간 연속으로 진행한 보안 감사를 공개했어요. 모델은 약 170개의 감사 에이전트를 배정했고, 최종적으로 감사 보고서와 수정용 Pull Request, 정책 권고안을 제출했어요. 그는 모델이 그럴듯한 중간 결과를 내놓고 멈추는 대신, 작업이 실제로 끝날 때까지 계속 수행한다는 점을 특히 강조했어요.
Uber의 사례는 형식 면에서 운영체제 실험과 가장 비슷해요. 두 사례 모두 하나의 모델이 많은 하위 에이전트를 배정해 장시간 작업을 수행하지만, 서로 완전히 독립적인 프로젝트입니다.
Claude Fable 5.2, 실제 프로덕션 환경에 투입되다
운영체제 실험만 공개됐다면 사람들은 이를 잘 준비된 시연 정도로 여겼을 수도 있어요. 하지만 Anthropic이 함께 공개한 두 가지 내부 데이터는 이러한 엔지니어링 역량이 일상적인 소프트웨어 개발에 이미 활용되고 있음을 보여줘요.
첫 번째는 코드 작성 비율이에요. Anthropic에 따르면 핵심 코드베이스에서 최종적으로 병합된 코드 변경 사항의 90% 이상을 Claude가 작성했으며, 이 과정에는 사람의 지도가 있었어요. 이 수치는 병합된 변경 사항 가운데 Claude가 작성한 비율을 의미해요. 개발 작업의 90%가 사람의 개입 없이 이루어졌다는 뜻도, 해당 코드가 모두 Fable 5.2에서 나왔다는 뜻도 아니에요.
두 번째는 프로덕션 서비스 마이그레이션이에요. 초기 버전의 Fable 5.2를 사용한 에이전트 팀이 핵심 프로덕션 서비스 하나를 Python에서 Rust로 마이그레이션했어요. 마이그레이션 후 서비스 효율성과 안정성이 모두 개선됐고, 시작 속도는 약 26배 빨라졌어요. 언어 마이그레이션은 전형적인 ‘장기간 진행되며 반복적인 검증이 필요한’ 작업이에요. 동작의 일관성을 유지하려면 번역 자체보다 테스트와 수정에 더 많은 노력이 드는 경우가 많아요.
각 사례의 성격은 서로 달라요. 아래 표에서 구분해 볼게요.
| 사례 | 성격 | 근거 출처 | 보여주는 점 | 보여주지 않는 점 |
|---|---|---|---|---|
| 운영체제 프로토타입 | Anthropic 내부 실험 | 공식 발표 및 시연 | 모델이 여러 모듈로 구성된 대규모 장기 엔지니어링 작업을 수행할 수 있음 | 상용 운영체제 수준에 도달했다는 점, 제3자가 재현했다는 점 |
| Claude가 작성한 병합 코드 90% | 내부 프로덕션 데이터 | 공식 발표 | AI가 일상적인 코드 작성에 깊이 관여하고 있음 | 코드에 사람의 검토가 필요 없다는 점 |
| Python → Rust 마이그레이션 | 내부 프로덕션 사례 | 공식 발표 | 에이전트 엔지니어링을 실제 인프라 최적화에 활용할 수 있음 | 운영체제 실험과 같은 방법을 사용했다는 점 |
| Vercel / Shopify / Datadog / Uber의 피드백 | 초기 테스터의 경험 | 공식 발표에 인용된 내용 | 기업 엔지니어들이 실제 업무에서 조율 능력을 경험함 | 독립적인 벤치마크를 대체할 수 있다는 점 |
이 사례들을 함께 보면, 공통적으로 드러나는 것은 ‘엔지니어링 실행 능력의 확장’이에요. 그렇다고 모든 엔지니어링 작업을 사람의 감독 없이 진행할 수 있다는 뜻은 아니에요.
AI 에이전트 1000개는 대체 무엇을 의미할까요?
‘에이전트 1000개’는 이번 실험에서 가장 눈길을 끄는 숫자이자, 가장 오해하기 쉬운 숫자예요.
에이전트 총수가 동시에 실행되는 수는 아니에요
먼저 Anthropic이 공개한 내용은 ‘1000개가 넘는 하위 에이전트가 참여했다’는 것뿐이에요. 이들이 동시에 실행됐는지는 밝히지 않았어요. 8일 동안 하위 에이전트가 순차적으로 생성되고, 작업을 마치면 종료된 뒤 새로운 에이전트가 이어받았을 가능성이 커요.
또한 에이전트 1000개가 능력이 똑같고 완전히 독립적인 엔지니어 1000명을 뜻하는 것도 아니에요. 실제 효율은 작업을 얼마나 병렬로 처리할 수 있는지, 조율에 드는 비용은 얼마인지, 상태를 어떻게 공유하는지, 코드 충돌이 얼마나 발생하는지, 테스트 범위가 충분한지, 호출 비용은 어느 정도인지에 따라 달라져요.
직관적인 예를 들어 볼게요. 커널의 메모리 관리가 확정되지 않으면 파일 시스템과 드라이버 작업도 본격적으로 진행하기 어려워요. 이런 의존 관계 때문에 대규모 프로젝트를 무한정 병렬 작업으로 나눌 수는 없어요.
공개된 Managed Agents의 두 가지 오케스트레이션 방식
Anthropic의 개발자용 Managed Agents 문서는 제품화된 멀티 에이전트 시스템을 살펴볼 수 있는 창구예요. 여기에는 두 가지 오케스트레이션 방식이 소개돼 있어요.
Subagent 방식: 메인 에이전트가 하위 에이전트를 생성할 수 있어요. 각 하위 에이전트는 독립된 세션 스레드와 컨텍스트 기록을 가지며, 메인 에이전트는 이후에도 추가 작업을 보낼 수 있어요. 단일 세션에는 직접 하위 스레드를 최대 25개까지 동시에 둘 수 있고, 직접 위임은 한 단계만 지원해요.
Dynamic Workflow 방식: 더 큰 규모의 작업을 위한 방식이에요. 메인 에이전트가 먼저 워크플로 프로그램을 작성하면, 워크플로가 여러 에이전트를 생성해 병렬로 실행하고 각 단계의 결과를 취합해요. 이후 이전 단계의 결과를 바탕으로 다음 단계를 결정해요. 실패한 에이전트는 보통 서버가 새 스레드에서 한 번 재시도해요. 공식 문서에 명시된 제한은 다음과 같아요.
| 지표 | 공식 제한 |
|---|---|
| 단일 워크플로에서 동시에 실행되는 스레드 수 | 64개(제품 상한 설정이며, 공식적으로 이 수치에 도달한다고 보장하지는 않음) |
| 워크플로 수명 동안 시작되는 에이전트 수 | 1000개 |
| 기본 워크플로 수명 | 24시간 |
| 단일 세션에서 기본적으로 동시에 열 수 있는 워크플로 수 | 10개 |
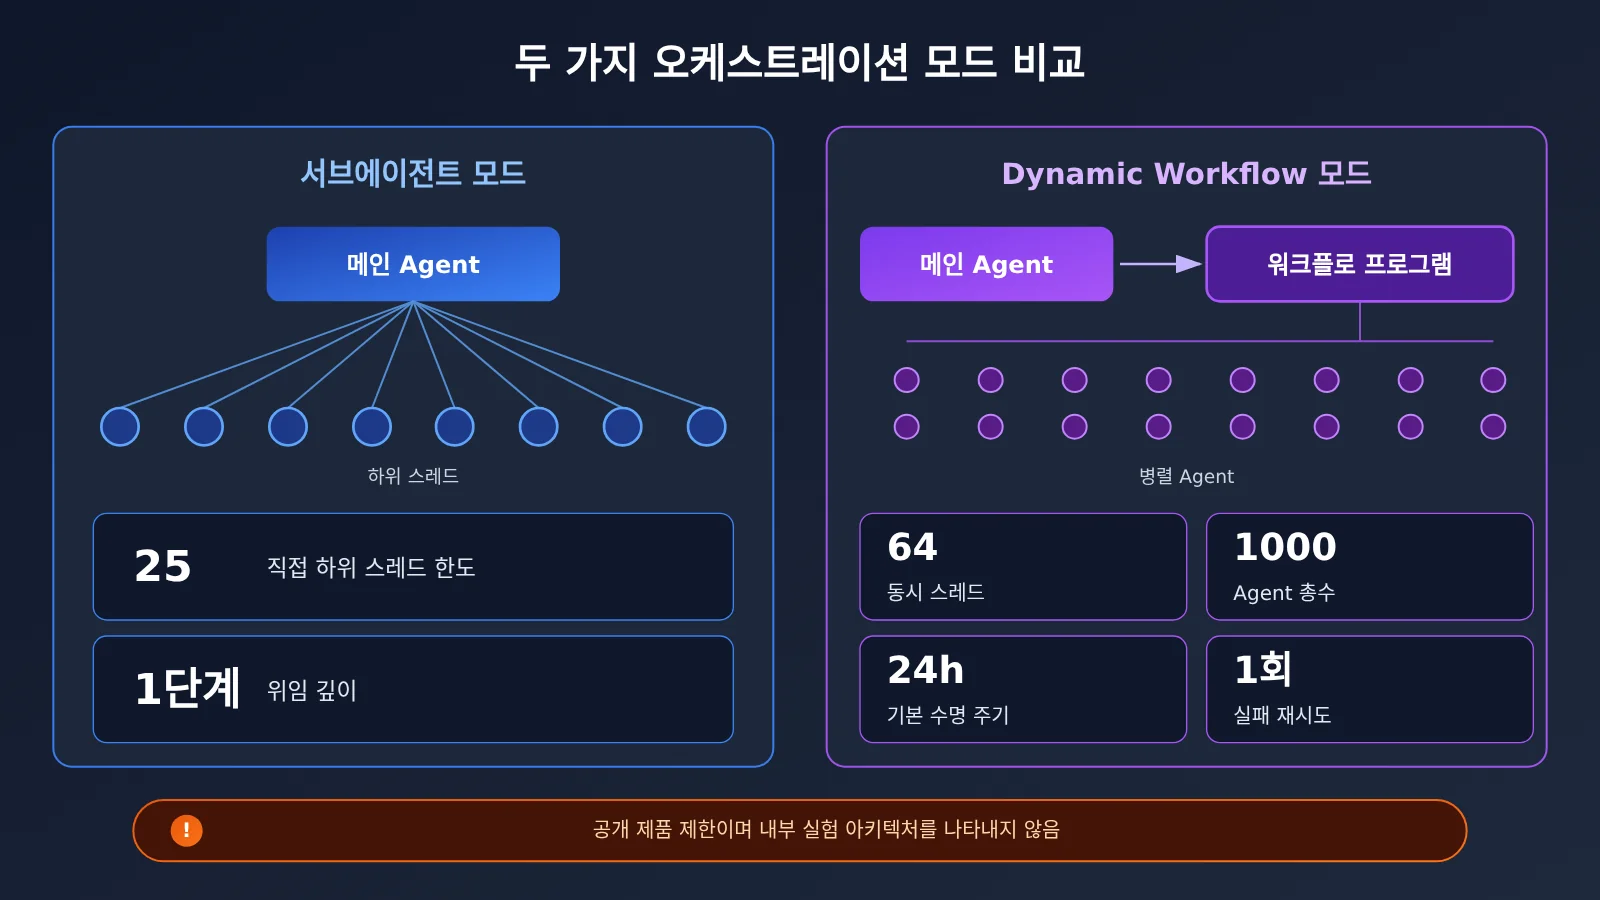
강조할 점은 운영체제 실험이 Anthropic의 내부 엔지니어링 실험인 반면, 공개된 Managed Agents는 제품화된 서비스라는 거예요. 이를 근거로 실험이 Managed Agents를 통해 진행됐다고 단정할 수 없고, 64개 스레드라는 동시 실행 상한을 실험에 적용해서도 안 돼요. 다만 이 수치에서 한 가지를 알 수 있어요. 대규모 에이전트 오케스트레이션에는 모델 자체뿐 아니라 스케줄러, 작업 상태 관리, 동시 실행 제어, 재시도 메커니즘, 예산 관리 시스템도 필요해요. ‘1000’이라는 숫자 뒤에서는 인프라 역시 모델만큼 중요한 역할을 맡고 있어요.
Claude Fable 5.2 운영체제 프로토타입의 한계
“부팅된다”는 의미 있는 이정표지만, “실제 환경에서 사용할 수 있다”는 것과는 거리가 멀어요. Windows, Linux, macOS 같은 성숙한 운영체제는 수십 년간 하드웨어 호환성을 확보하고, 보안을 강화하고, 커뮤니티의 유지보수를 거쳐 왔어요.
| 엔지니어링 요구사항 | 부팅 가능한 프로토타입(현재까지 공개된 내용) | 성숙한 상용 운영체제 |
|---|---|---|
| 하드웨어 호환성 | 실제 노트북 한 대에서 부팅 | 다양한 칩, 주변기기, 펌웨어 조합 지원 |
| 보안 | 독립적인 제3자 보안 감사 여부가 확인되지 않음 | 지속적인 취약점 대응, 권한 격리, 패치 체계 |
| 장기적인 안정성 | 장시간 실행 테스트 결과가 공개되지 않음 | 수많은 사용자의 장기간 사용을 통해 검증 |
| 시스템 유지보수 | 소스 코드와 빌드 절차가 공개되지 않음 | 버전 관리, 릴리스 주기, 장기 지원 체계 |
| 코드 감사 | 코드 줄 수와 아키텍처 문서가 공개되지 않음 | 코드를 검토할 수 있고, 아키텍처 문서가 잘 갖춰져 있음 |
| 재현 가능성 | 제3자가 독립적으로 재현한 사례가 아직 없음 | 빌드 절차가 공개되어 있고 반복 재현 가능 |
이 표는 실험의 가치를 깎아내리려는 것이 아니라, 실험이 무엇을 입증했는지 분명히 하려는 거예요. 이번 실험은 모델이 비교적 긴 기간에 걸쳐 여러 모듈로 구성된 소프트웨어 프로젝트를 조율하고, 각 하위 시스템이 실제로 연동되는 결과물을 완성할 수 있음을 보여줬어요. 하지만 AI가 작성한 운영체제가 기존 제품을 곧바로 대체할 수 있다는 점까지 입증한 것은 아니에요.
이런 프로젝트에서도 인간 엔지니어는 여전히 핵심적인 역할을 해요. 목표 설정, 아키텍처 선택, 보안 경계 설정, 최종 검수는 여전히 사람이 책임져야 하는 부분이에요. Anthropic도 “병합된 코드의 90%를 Claude가 작성했지만, 인간의 지도가 있었다”고 신중하게 설명했어요.
가장 균형 잡힌 결론은 이렇습니다. AI는 복잡한 소프트웨어 프로젝트를 조율하는 능력을 보여줬지만, 그렇다고 성숙한 소프트웨어 엔지니어링 팀에 더 이상 사람이 필요 없다는 뜻은 아니에요.
Claude Fable 5.2가 개발자에게 미치는 영향
단일 호출에서 장기 실행 에이전트 워크플로로
대부분의 개발자는 단기간에 운영체제를 직접 만들지는 않을 거예요. 하지만 이번 실험에서 드러난 작업 방식은 일괄 코드 리뷰, 저장소 단위 리팩터링, 언어 마이그레이션, 보안 감사처럼 일상적인 프로젝트에 점차 적용될 거예요.
이런 상황에서 개발자가 주목하는 부분은 “이번 호출의 답변이 얼마나 좋은가”에서 다음과 같은 엔지니어링 문제로 옮겨가요.
- 작업 관리: 작업을 어떻게 나누고 각 하위 작업의 상태를 기록할지, 실패했을 때 중단 지점부터 다시 실행할 수 있는지 살펴봐야 해요.
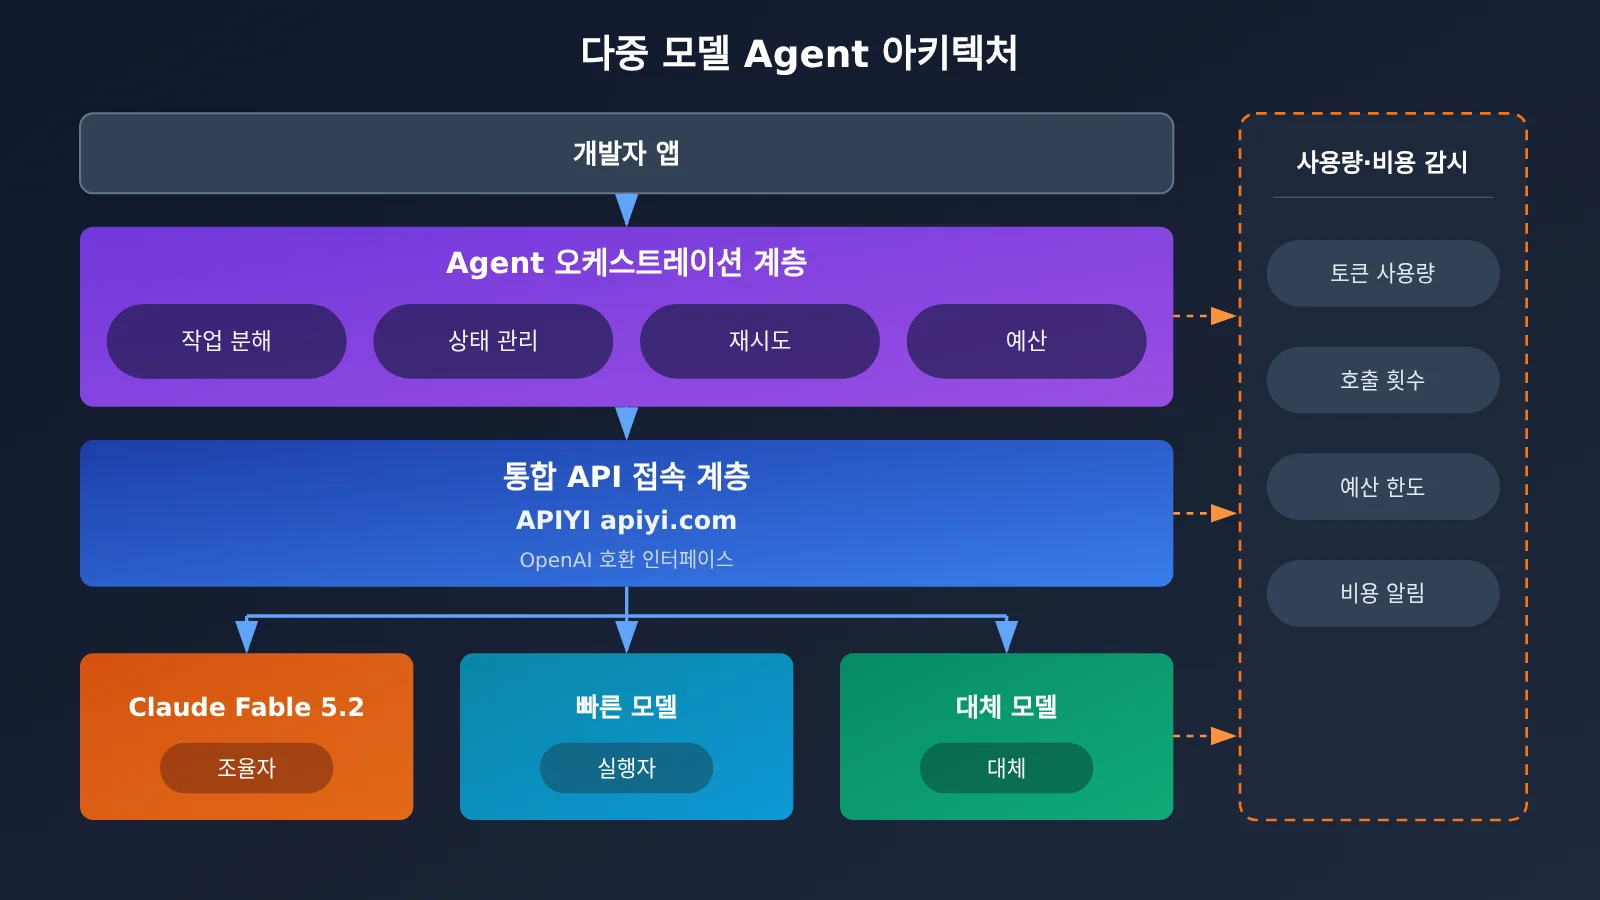
- 다중 모델 분업: Datadog 사례에서 Fable 5.2는 정보를 수집하기 위해 “더 빠른 모델”을 호출해요. 조정자 역할은 성능이 뛰어난 모델이 맡고, 실행은 더 빠르거나 저렴한 모델이 담당하는 방식은 흔히 볼 수 있는 비용 구조예요.
- 호출 안정성: 워크플로 하나에 수백, 수천 번의 호출이 포함될 수 있어요. 개별 호출의 실패율이 낮더라도 누적되면 작업이 자주 중단될 수 있으므로 재시도와 장애 조치가 필요해요.
- 예산 관리: Fable 5.2의 공개 API 가격은 입력 토큰 100만 개당 8달러, 출력 토큰 100만 개당 40달러예요. Fast Mode는 가격이 두 배예요. Anthropic은 운영체제 실험에 실제로 얼마가 들었는지 공개하지 않았지만, 장기간 실행되는 다중 에이전트 작업의 비용을 계속 모니터링해야 한다는 점은 분명해요.
- 작업 모니터링: 각 에이전트가 무슨 일을 하는지, 비용을 얼마나 쓰는지, 어디에서 멈춰 있는지 파악할 수 있어야 해요.
Vercel은 같은 날 AI Gateway에서 Fable 5.2를 지원한다고 발표했어요. 여기에는 공급자 장애 조치, 대체 모델, 사용량 및 비용 통계, 예산 설정, 재시도 규칙이 포함돼요. 이는 복잡한 에이전트 애플리케이션을 위한 모델 호출 인프라가 자리를 잡아 가고 있음을 보여줘요.
OpenAI 호환 인터페이스로 Claude Fable 5.2 호출하기
Fable 5.2의 공식 API Model ID는 claude-fable-5-2이며, 1M 토큰 컨텍스트와 최대 128K 토큰 출력을 지원해요. OpenAI 호환 인터페이스로 호출하는 가장 간단한 방법은 다음과 같아요. 모델 이름은 플랫폼 콘솔의 모델 목록을 기준으로 확인하세요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "把这个 Python 模块的迁移计划拆成可并行的子任务"}]
)
print(resp.choices[0].message.content)
전체 예제 보기: 조정자 + 병렬 실행자 + 재시도 및 예산 제어
다음은 조정자가 작업을 나누고 실행자가 병렬로 처리하는 간단한 예제예요. 실패 시 재시도하고 대략적인 토큰 예산을 제어하는 방식도 포함했어요. 일반적인 엔지니어링 접근법을 설명하기 위한 예제이며, Anthropic 운영체제 실험의 실제 구현은 아니에요.
import json
import openai
from concurrent.futures import ThreadPoolExecutor, as_completed

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스, 여러 모델 제공업체로 전환 가능
)

PLANNER_MODEL = "claude-fable-5-2"   # 조정자: 작업 분해 및 결과 취합 담당
WORKER_MODEL = "gpt-4o-mini"         # 실행자: 실제 사용하는 빠른 모델로 교체
TOKEN_BUDGET = 200_000               # 전체 워크플로의 토큰 예산
MAX_WORKERS = 8                      # 동시 실행 상한, 필요에 따라 조정
used_tokens = 0


def chat(model, prompt, max_tokens=2000):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,停止派发新任务")
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    used_tokens += resp.usage.total_tokens
    return resp.choices[0].message.content


def plan(goal):
    prompt = (
        f"目标:{goal}\n"
        "请拆成 3-6 个可以独立完成的子任务,"
        '只输出 JSON 数组,格式为 [{"id": 1, "task": "..."}]'
    )
    return json.loads(chat(PLANNER_MODEL, prompt))


def run_task(item, retries=1):
    for attempt in range(retries + 1):
        try:
            return item["id"], chat(WORKER_MODEL, item["task"])
        except Exception as e:
            if attempt == retries:
                return item["id"], f"失败:{e}"


def workflow(goal):
    tasks = plan(goal)
    results = {}
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = [pool.submit(run_task, t) for t in tasks]
        for f in as_completed(futures):
            tid, out = f.result()
            results[tid] = out
    summary_prompt = "汇总以下子任务结果,检查相互之间是否冲突:\n" + json.dumps(
        results, ensure_ascii=False
    )
    return chat(PLANNER_MODEL, summary_prompt, max_tokens=4000)


if __name__ == "__main__":
    print(workflow("为一个小型 Web 服务设计从 Python 迁移到 Rust 的方案"))
    print(f"累计消耗 Token:{used_tokens}")
🚀 빠른 시작 팁: 여러 모델을 사용하는 에이전트 워크플로를 구축할 때 조정자와 실행자는 서로 다른 업체의 모델을 사용하는 경우가 많아요. APIYI apiyi.com을 이용하면 하나의 API 키로 Claude, OpenAI, Gemini 등 주요 모델을 호출할 수 있어요. 사용량에 따라 요금이 부과되고 신규 사용자에게는 무료 테스트 크레딧이 제공되므로, 소규모 작업으로 먼저 워크플로 구성과 비용을 검증하기 좋아요.
자주 묻는 질문 FAQ
Q1: Claude Fable 5.2의 운영체제 실험은 실제로 어떤 성과를 냈나요?
Anthropic의 공개 내용에 따르면, Fable 5.2는 빈 폴더에서 시작해 1,000개가 넘는 하위 에이전트를 조율하며 8일간 연속으로 작업해 실제 노트북에서 부팅할 수 있는 운영체제 프로토타입을 만들었어요. 여기에는 커널, 디스크·키보드·네트워크 드라이버, 영구 파일 저장소, 윈도 시스템, 로그인 화면, 설치 프로그램, 내장 Claude 기능이 포함돼요.
Q2: AI 에이전트 1,000개가 동시에 실행된 건가요?
공식적으로 공개된 내용은 없어요. ‘1,000개가 넘는 하위 에이전트가 참여했다’는 말이 에이전트 1,000개가 내내 동시에 실행됐거나, 독립된 엔지니어 1,000명이 참여했다는 뜻은 아니에요. 공개된 Managed Agents의 단일 워크플로 동시 실행 한도는 스레드 64개이며, 수명 주기 동안 최대 1,000개의 에이전트를 시작할 수 있어요. 하지만 이는 제품의 제한 사항이므로 내부 실험에 그대로 적용할 수는 없어요.
Q3: AI가 만든 이 운영체제가 Windows나 Linux를 대체할 수 있나요?
아니요. 공식적으로는 ‘작동하는 프로토타입’으로 소개됐어요. 현재 소스 코드와 아키텍처 문서, 다양한 하드웨어 호환성 테스트, 제3자 보안 감사 결과가 공개되지 않았고, 독립적인 재현도 이뤄지지 않았어요. 이 실험이 입증한 것은 복잡한 엔지니어링 작업을 AI가 조직하는 능력이지, 제품이 성숙했다는 점은 아니에요.
Q4: Claude Fable 5.2의 API 가격과 사양은 어떻게 되나요?
공개된 가격은 입력 100만 토큰당 8달러, 출력 100만 토큰당 40달러예요. Fable 5.1 일반 모드보다 20% 저렴해요. Fast Mode는 가격이 두 배이며, 출력 속도는 일반 모드보다 최대 2.5배 빨라요. 컨텍스트 윈도우는 100만 토큰, 최대 출력 길이는 12만 8,000토큰이에요. Batch API를 사용하면 입력과 출력 모두 50% 할인돼요. 위 가격은 공개된 요금이며, 운영체제 실험에 실제로 든 비용은 아니에요.
Q5: 개발자가 Claude Fable 5.2를 빠르게 호출해 에이전트 실험을 하려면 어떻게 해야 하나요?
먼저 소규모 작업으로 오케스트레이션 로직을 검증해 보세요.
1. APIYI apiyi.com에 가입해 API 키와 무료 테스트 크레딧을 받으세요.
2. 이 글의 예시에서 `base_url`을 `https://api.apiyi.com/v1`로 설정하고, 모델 이름은 콘솔 목록을 확인하세요.
3. 먼저 ‘작업 분할 → 병렬 실행 → 결과 취합’의 최소 흐름을 구현한 뒤, 재시도와 예산 제어를 차례로 추가하세요.
Q6: 장기간 실행되는 멀티 에이전트 워크플로에서 가장 문제가 되기 쉬운 부분은 무엇인가요?
문제는 주로 세 가지예요. 첫째, 비용이 통제되지 않을 수 있어요. 에이전트 수가 늘면 호출 횟수도 증가하므로 예산 상한을 설정해야 해요. 둘째, 실패가 누적될 수 있어요. 단일 호출에서 가끔 발생하는 오류도 긴 작업 흐름에서는 영향이 커지므로 재시도와 대체 모델이 필요해요. 셋째, 조율 비용이 발생할 수 있어요. 작업 간 의존 관계를 명확히 정리하지 않으면 병렬 실행이 오히려 코드 충돌을 일으킬 수 있어요. APIYI apiyi.com을 통해 여러 모델을 한곳에서 연동하면 대체 모델을 더 편리하게 설정하고 사용량을 한곳에서 확인할 수 있어요.
Claude Fable 5.2와 AI 에이전트 1,000개의 핵심 요점
- 실험에서 확인된 사실: 하위 에이전트 1,000개 이상이 8일 동안 작업해 빈 폴더에서 실행 가능한 운영체제 프로토타입을 만들었어요.
- 진정한 돌파구: 모델이 작업 분해, 병렬 실행, 지속적인 오류 수정, 결과 통합까지 맡기 시작했어요.
- 실제 개발 현장의 신호: Anthropic에서는 병합된 코드의 90% 이상을 Claude가 작성했고, Rust로 마이그레이션한 뒤 시작 속도가 약 26배 빨라졌어요.
- 수치 해석의 한계: 에이전트 1,000개가 각각 독립적인 엔지니어처럼 작업 전체를 병렬로 수행했다는 뜻은 아니에요.
- 프로토타입의 한계: 제3자 감사와 재현이 이뤄지지 않은 만큼, 성숙한 상용 운영체제와는 아직 거리가 멀어요.
- 개발자가 주목할 점: 스케줄링, 재시도, 예산 관리, 모니터링은 모델 성능만큼 중요해요. APIYI apiyi.com을 활용하면 여러 모델을 한곳에서 연결할 수 있어요.
요약
AI 에이전트 1,000개가 8일 만에 운영체제를 만들었다는 소식에서 기억해야 할 점은 숫자 자체가 아니라 다음 세 가지예요.
- 능력의 형태가 달라졌어요: Claude Fable 5.2는 코드 생성뿐 아니라 엔지니어링 작업을 조직하는 능력도 보여줬어요.
- 증거는 나눠서 살펴봐야 해요: 운영체제 실험, 내부 개발 데이터, 기업의 초기 피드백은 서로 성격이 다른 증거이므로 각각 따로 평가해야 해요.
- 마지막 단계에는 여전히 사람이 필요해요: 프로토타입을 실행할 수는 있지만, 아키텍처 결정과 보안, 검수는 여전히 인간 엔지니어의 책임이에요.
개발자라면 이제 ‘한 번 호출하기’에서 ‘장기적인 워크플로’로 관점을 넓히고, 여러 모델의 역할 분담과 호출 안정성, 비용 관리 방안을 미리 고민해야 해요. APIYI apiyi.com에서 API 키 하나로 주요 모델을 연결하고, 소규모 에이전트 작업부터 검증해 보세요.
📚 참고 자료
- Anthropic 공식 발표: Claude Fable 5.2 and Mythos 5.2(2026-11-09)
- 링크:
anthropic.com/claude-fable-and-mythos-5-2 -
설명: 운영체제 실험, 내부 프로덕션 데이터, 기업 피드백을 확인할 수 있는 1차 자료
-
Claude Platform 모델 사양 문서: Fable 5.2 Overview
- 링크:
platform.claude.com/docs/en/models/fable-5-2/overview -
설명: 컨텍스트 윈도우, 최대 출력 길이, Model ID 등 사양 정보
-
Managed Agents 멀티 에이전트 오케스트레이션 문서: Subagent 및 Dynamic Workflow
- 링크:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
설명: 공개 제품의 동시 스레드, 에이전트 수, 수명 주기 제한
-
Vercel AI Gateway 연동 발표: Claude Fable 5.2 now available on AI Gateway
- 링크:
vercel.com/changelog/claude-fable-5-2-now-available-on-ai-gateway -
설명: 타사 API 게이트웨이의 장애 전환, 예산 설정, 재시도 기능
-
The Verge 보도: Anthropic launches new Claude Fable and Mythos 5.2 models
- 링크:
theverge.com/ai-artificial-intelligence/1030005/anthropic-claude-fable-mythos-5-2 - 설명: 이번 발표를 다룬 타사 매체의 보도
작성자: APIYI 기술팀
기술 문의: APIYI 공식 홈페이지에서 문의해 주세요. 추가 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.