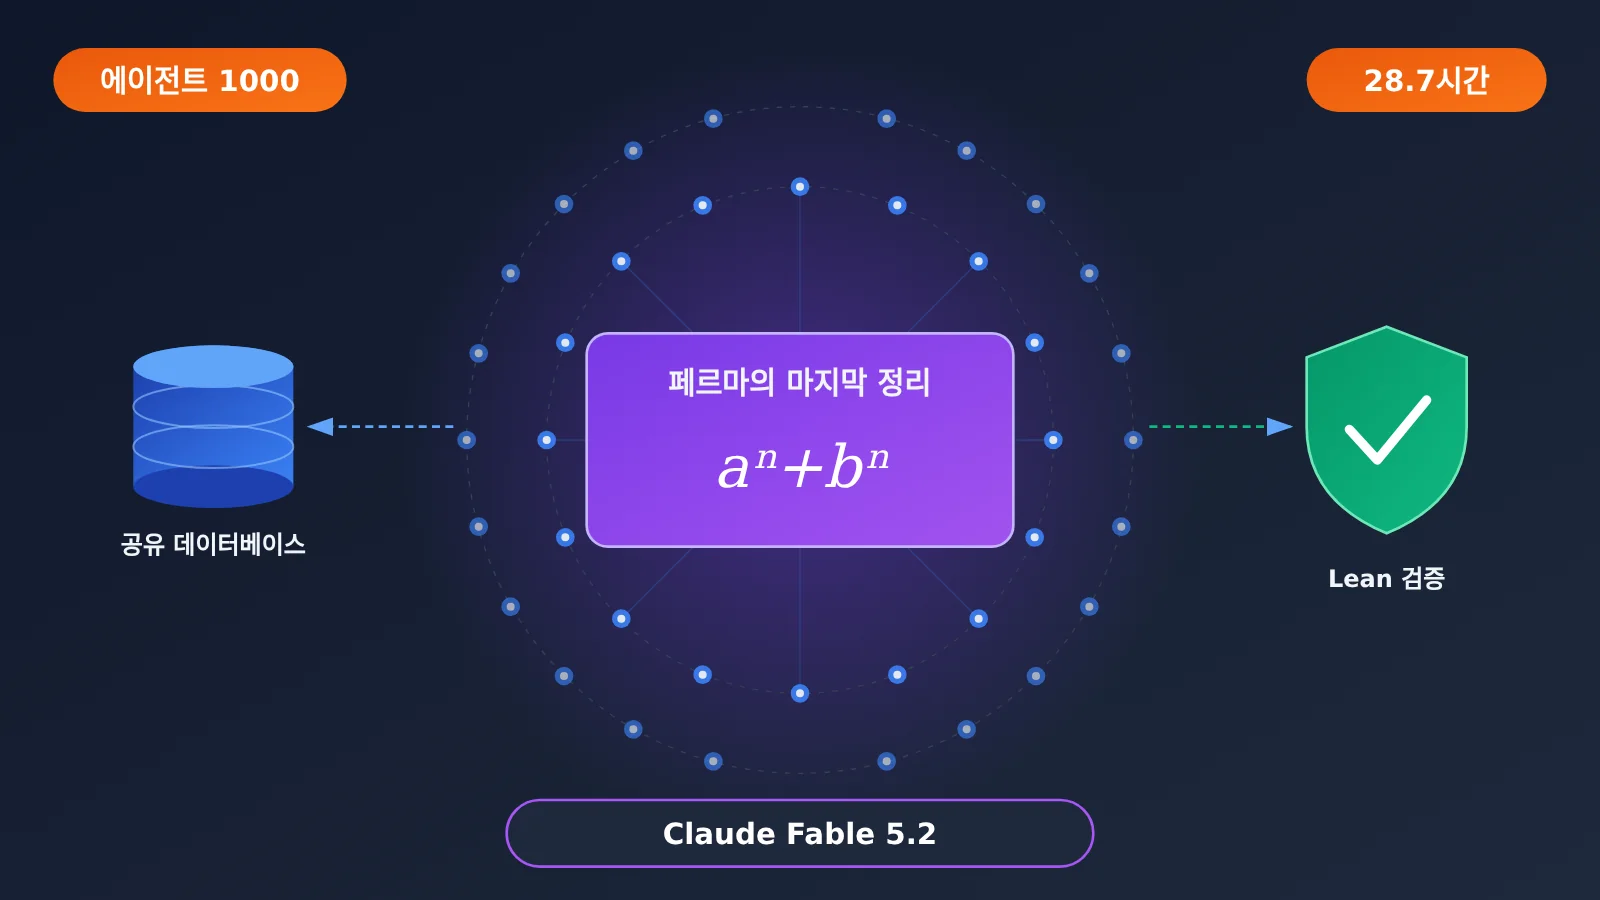
2026년 11월 9일, Anthropic은 공식 엔지니어링 블로그에서 멀티 에이전트 실험 결과를 공개했어요. Claude Fable 5.2 에이전트 1,000개가 협력해 28.7시간 만에 페르마의 마지막 정리를 컴퓨터로 형식화했고, 최종 증명은 Lean 공식 커널 검증을 통과했어요. 두 달 전 첫 형식화 실험은 에이전트 수십 개가 11일 동안 진행했어요.
이것은 “AI가 30시간 만에 페르마의 마지막 정리를 증명했다”는 이야기가 아니에요. 이 정리는 이미 1990년대에 Andrew Wiles와 Richard Taylor가 증명했어요. 이번 실험은 기존 증명 경로를 컴퓨터가 단계별로 검증할 수 있는 형식 증명으로 옮긴 작업이에요. 따라서 이 글에서 답하려는 진짜 질문은 이거예요. AI 에이전트 1,000개는 어떻게 30시간도 안 되는 시간에 이렇게 복잡한 작업을 함께 완수했을까요?
핵심 가치: 이 글을 읽으면 페르마의 마지막 정리 형식화 실험의 주요 수치와 에이전트 1,000개의 운영 방식, 검증 메커니즘을 알 수 있어요. 또한 이 실험이 기업용 에이전트 시스템에 주는 시사점과 한계도 살펴볼게요.
페르마의 마지막 정리 형식화 실험 핵심 정보 한눈에 보기
먼저 표를 통해 이번 Claude Fable 5.2 실험의 기본 정보를 살펴볼게요. 혼동하기 쉬운 점도 몇 가지 짚고 넘어가야 해요. 사용된 모델은 초기 버전이고, 실험에는 사전에 정해진 입력이 제공됐으며, 공식 발표에서도 이를 toy experiment(실험적 시연)로 규정했어요.
| 항목 | 상세 내용 |
|---|---|
| 발표 시점 | 2026년 11월 9일, Anthropic 공식 엔지니어링 블로그 |
| 사용 모델 | Claude Fable 5.2 초기 버전(정식 출시 전 정렬 평가가 완료되지 않은 상태) |
| 팀 규모 | Lead Agent 1명 + Helper Agent 999명 |
| 완료 시간 | 28.7시간째, 최종 정리가 Lean 공식 커널 검사를 통과함(공식 발표에서는 반올림해 30시간으로 표기) |
| 사전 입력 | 명제 60개, 고전적 증명 경로를 한 문장으로 요약한 내용, 관련 정의, 이전 형식화 실험에서 이미 증명한 보조정리 47개 |
| 도구 환경 | Lean 툴체인, Mathlib, Git, 공유 PostgreSQL 데이터베이스, 독립 가상 머신 샌드박스 |
| 공식 규정 | toy experiment이며, 페르마의 마지막 정리를 처음 증명한 사례는 아님 |
페르마의 마지막 정리 형식화: 실험의 전제를 먼저 짚어볼게요
연구진은 단순히 “페르마의 마지막 정리를 증명해 달라”고 한 뒤 에이전트에게 모두 맡긴 게 아니에요. 에이전트는 명제 60개(최종 정리와 중간 단계 59개 포함), 증명 경로의 개요, 정의, 이전 실험에서 이미 증명한 보조정리 47개를 받았어요. Lead와 Helper의 역할도 연구진이 미리 정했죠.
따라서 이번 실험이 검증한 능력은 조금 달라요. 수학적 기초와 도구가 주어졌을 때 대규모 에이전트 팀이 스스로 협력 체계를 꾸리고, 이미 알려진 증명 경로를 기계가 검증할 수 있는 증명으로 완성할 수 있는지를 살펴본 거예요. 이는 “AI가 수학을 할 수 있을까?”라는 질문보다 엔지니어링 문제에 더 가까워요.
페르마의 마지막 정리를 형식화하기 어려운 이유
페르마의 마지막 정리는 간단합니다. 정수 (n)이 2보다 클 때, (a^n + b^n = c^n)을 만족하는 양의 정수 (a), (b), (c)는 존재하지 않는다는 내용이에요. 이 정리는 17세기 피에르 드 페르마가 제기한 뒤 350년 넘게 미해결 상태로 남아 있었습니다. 와일스는 1993년에 증명을 발표했고, 1994년 테일러와 함께 핵심 오류를 수정한 뒤 1995년에 정식으로 논문을 발표했어요. 원래 증명은 약 129쪽에 달하며, 현대 정수론과 대수기하학의 여러 성과에 크게 의존합니다.
수학자는 증명을 작성할 때 “앞선 결론에서 자명하게 알 수 있다”고 쓸 수 있고, 독자는 중간 단계를 스스로 보충합니다. 하지만 컴퓨터는 이런 암묵적인 약속을 이해하지 못해요. 각 단계에서 어떤 정의와 정리, 추론 규칙을 사용했는지 알아야 합니다. 바로 이것이 형식화가 어려운 이유예요. 사람이 보기엔 ‘자명한’ 한 단계가 코드로는 수백, 수천 줄에 이를 수도 있습니다.
Lean, Mathlib, 수학 형식화
이번 실험을 이해하려면 먼저 세 가지 개념을 구분해야 합니다.
- Lean: 증명이 형식 논리 규칙을 엄격히 따르는지 검사하는 대화형 정리 증명기예요.
- Mathlib: 이미 형식화된 정의와 정리가 다수 수록된 Lean의 수학 라이브러리예요. 바로 가져다 쓸 수 있는 ‘표준 라이브러리’와 비슷합니다.
- 수학 형식화: 사람이 읽을 수 있는 수학 증명을 컴퓨터가 완전히 검증할 수 있는 논리 구조로 변환하는 과정이에요.
가장 중요한 점은 AI가 증명을 구성하고, Lean 커널이 이를 검사한다는 것입니다. 모델이 “증명했다”고 말하는 것과 Lean이 실제로 그 증명을 받아들이는 것은 전혀 다른 일이에요. 이번 실험을 신뢰할 수 있는 이유는 최종 결과가 모델의 자체 판단에 의존하지 않고 독립적인 기계 검사를 통과했기 때문입니다.
AI 에이전트 1000개는 어떻게 협업할까: AI가 운영하는 프로젝트 관리 시스템
Claude Fable 5.2 실험에서 가장 살펴볼 만한 부분이에요. 에이전트 1000개가 각자 문제를 푸는 데만 몰두한 게 아니라, 작업 관리와 리소스 배분, 상황에 따른 조정 기능을 갖춘 협업 시스템을 구축했어요.
Claude Fable 5.2 팀의 조직 구조
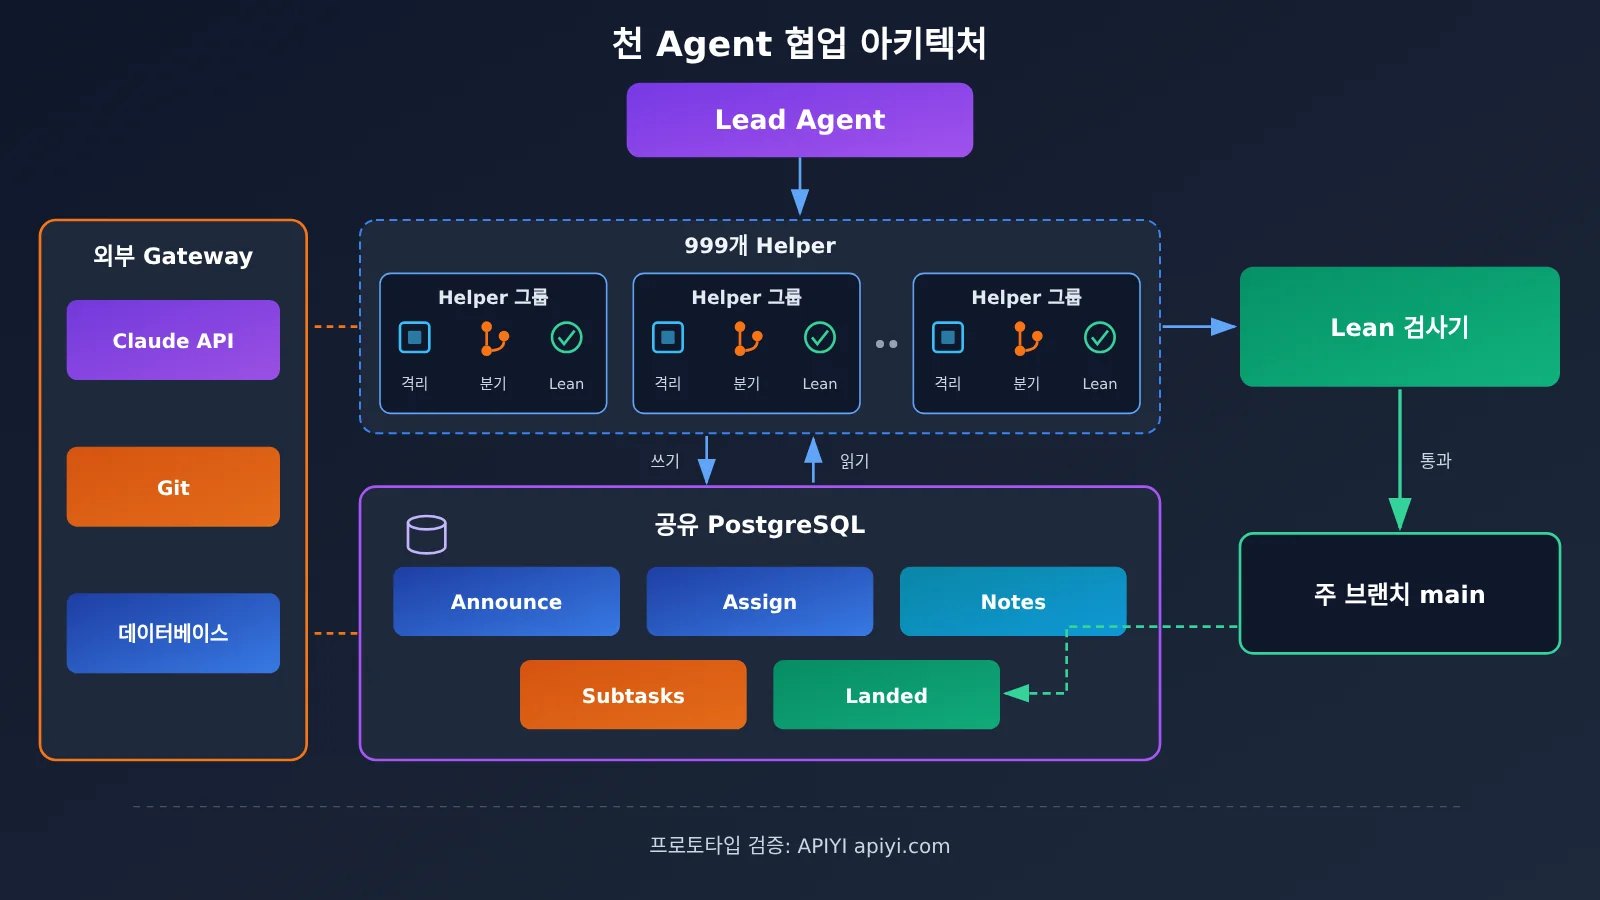
팀은 단순한 계층 구조로 운영돼요. Lead Agent 1개가 전체 계획 수립, 작업 분할, 진행 상황 관리를 맡고, Helper Agent 999개가 구체적인 증명을 담당해요. 각 에이전트는 가벼운 가상 머신 샌드박스를 갖추고 있어요. 또한 Shell, 파일 편집기, Lean 툴체인, Mathlib을 사용할 수 있고, 각자의 Git 브랜치에서 작업한 뒤 메인 브랜치에 Merge Request를 보낼 수 있어요.
모든 에이전트는 인터넷에 직접 접속할 수 없어요. Claude API, Git, 데이터베이스와의 통신은 모두 외부 Gateway를 거쳐야 해요. 샌드박스와 브랜치를 분리해 두면 에이전트 1000개가 동시에 코드를 수정해도 서로의 파일을 덮어쓰지 않아요.
공유 PostgreSQL: AI Agent의 협업 허브
Agent 1,000개가 서로 일대일로 메시지를 주고받으며 협업하면 통신량이 빠르게 감당하기 어려워져요. Lead Agent는 실험을 시작한 뒤 10분 안에 공유 데이터베이스 테이블 5개를 만들고, 소통 방식을 “하나의 보드를 함께 읽고 쓰는 것”으로 바꿨어요.
| 테이블 이름 | 역할 | 협업에서의 기능 |
|---|---|---|
| Announce | 팀 지침 게시 | 전체 공지. 프로젝트 게시판과 비슷해요 |
| Assign | 작업과 담당자 지정 | “누가 무엇을 하는지” 명확히 해 중복 작업을 방지해요 |
| Notes | 진행 상황, 문제, 작업 계획 기록 | 맥락을 공유해 정보가 고립되는 일을 줄여요 |
| Subtasks | 세부 작업 관리 및 Agent의 작업 선택 지원 | 자율적인 작업 선택을 뒷받침하는 작업 풀이에요 |
| Landed | 완료 후 검사를 통과한 작업 기록 | 검증된 내용만 담는 신뢰할 수 있는 성과 목록이에요 |
이 방식의 장점은 Agent가 다른 999개 Agent에 일일이 연락할 필요가 없다는 거예요. 데이터베이스만 확인하면 어떤 작업이 있는지, 무엇이 완료됐는지, 어떤 의존성이 있는지 알 수 있어요. 성과물은 Git을 통해 병합해 메인 브랜치에 반영해요. 공식 공개 자료에 따르면 전체 과정에서 데이터베이스 쓰기는 약 36,612회, 읽기는 311,734회 발생했어요. 이 가운데 Notes 쓰기는 약 20,600회, Subtasks 쓰기는 약 14,800회였어요. 대부분의 스크립트 호출은 통계에 포함되지 않았어요. 읽기가 쓰기보다 훨씬 많다는 점은 Agent가 대부분의 시간을 “전체 상태 확인”에 쓴다는 사실도 보여줘요.
동적 작업 할당: 고정 배정에서 자율적인 작업 가져오기로
이번 실험의 작업 배분 과정은 처음부터 끝까지 똑같지 않았어요. 아래 타임라인을 보면 운영 방식이 어떻게 단계적으로 바뀌었는지 알 수 있어요.
| 시점 | 주요 사건 |
|---|---|
| 10분 | Lead가 공유 데이터베이스 테이블 5개를 생성 |
| 약 27분 | 명제 3개 증명 완료 |
| 이후 | Lead가 제한된 시간 안에 해결하기 어렵다고 판단한 명제 47개를 잠시 보류하고, 나머지 명제 10개에 인력을 집중 |
| 약 70분 | 이 명제 10개를 모두 해결한 뒤, Lead가 더 어려운 명제를 처리하도록 Agent를 재배치 |
| 약 3시간 | Lead가 유휴 Agent에 할당을 기다리지 않고 스스로 작업을 가져가도록 허용 |
| 5.6시간 | Helper 73개가 작업 756개를 생성 |
| 약 18시간 | 마지막 저장 상태에서 실행을 복구해 12시간 더 진행 |
| 28.4시간 | Langlands–Tunnell 관련 명제 해결 |
| 28.7시간 | 페르마의 마지막 정리 증명 완료 및 공식 커널 검사 통과 |
두 가지 세부 사항에 주목할 만해요. 첫째, Lead가 작업을 배정하는 방식에서 Agent가 자율적으로 작업을 가져가는 방식으로 바뀌면서 팀 운영이 중앙 집중식 조정에서 작업 풀 방식으로 전환됐어요. 그 결과 Lead가 병목이 될 위험이 줄었죠. 둘째, 실험은 약 18시간 시점에 저장 상태에서 복구됐어요. 따라서 28.7시간이라는 기록은 모든 Agent가 중단 없이 처음부터 끝까지 실행됐다는 뜻은 아니에요.
또한 잠시 보류된 명제 47개와 사전 입력에 포함된 보조정리 47개는 서로 다른 항목이에요. 공식 자료를 읽을 때 혼동하지 않도록 주의하세요.
Langlands–Tunnell: 750개 에이전트가 집중해 페르마의 마지막 정리 형식화의 가장 어려운 난관을 돌파하다
마지막 단계에 가까워지자 팀은 가장 어려운 부분인 Langlands–Tunnell 관련 명제에 부딪혔어요. 이 명제는 와일스 증명 경로에서 중요한 수학적 결과예요. 초기에 이 작업을 맡은 에이전트는 Lean 코드가 70만~100만 줄 필요할 것으로 예상했고, 남은 시간 안에 완수할 가능성은 1% 미만이라고 판단했어요.
이후 Lead는 약 750개의 Helper를 이 작업에 집중시켰어요. 에이전트는 스스로 여러 단계로 이루어진 작업 트리를 만들었어요.
- 10개의 주요 영역으로 분할
- 하위 작업 총 2,418개 생성
- 작업 트리의 깊이는 최대 10단계
- 수백 개의 에이전트가 서로 다른 하위 작업을 동시에 처리
그 결과 Langlands–Tunnell은 28.4시간 만에 완료됐고, 0.3시간 뒤에는 페르마의 마지막 정리도 완성됐어요. 이 사례는 대규모 병렬화의 가치가 단순히 “인원이 많으면 계산이 빠르다”는 데 있지 않다는 점을 보여줘요. 더 중요한 건 바로 착수하기 어려운 큰 문제를 독립적으로 진행하고 개별 검증한 뒤, 마지막에 합칠 수 있는 작은 작업들로 나누는 일이에요. 분할이 잘못되면 750개의 에이전트가 서로 기다리거나 같은 일을 반복하게 될 뿐이에요.
페르마의 마지막 정리 형식화가 성공한 이유: Lean 검증과 안전장치
엔지니어링 신뢰성 측면에서 이번 실험은 세 겹의 안전장치에 의존했어요.
첫 번째는 결과 검증이에요. 각 하위 명제는 Lean 검사를 통과해야 메인 브랜치에 반영될 수 있었고, Landed 표에는 검사를 통과한 작업만 기록됐어요. 최종 정리는 공식 커널 검사기가 검증했어요. Lead 에이전트는 “페르마의 마지막 정리가 메인에 반영됐고, 공식 검사기의 커널 검증도 완료됐다”고 기록했어요.
두 번째는 협업 격리예요. 각자 독립된 샌드박스와 Git 브랜치를 사용해 에이전트 간 파일 충돌과 상호 간섭을 최소화했어요.
세 번째는 안전 경계예요. 실험에는 정식 출시 전 정렬 평가가 완료되지 않은 초기 모델이 사용됐기 때문에, Anthropic은 여러 단계의 제한을 적용했어요.
- 인터넷 접속과 다른 에이전트 샌드박스에 대한 직접 접근 금지
- 권한이 제한된 계정으로 명령 실행
- 외부 Gateway를 통해 API, Git, 데이터베이스 통신 관리
- 실시간 분류기가 셸 명령과 파일 변경을 검사하고, 오프라인 모니터가 작업 기록을 재검토
실험 중 도구 호출은 총 100만 회가 넘었지만, 차단이 필요한 수준에 이른 경우는 한 번도 없었어요. Anthropic은 실험 이후 병렬 사고 과정 모니터링도 추가했다고 밝혔어요. 여기서 얻을 수 있는 결론은 신뢰할 수 있는 에이전트 시스템을 평가할 때 모델이 작업을 완수할 수 있는지만 봐서는 안 된다는 거예요. 독립적인 검증, 권한 경계, 추적 가능한 실행 환경도 반드시 갖춰야 해요.
11일에서 28.7시간으로: Claude Fable 5.2 두 차례 실험 비교
두 차례의 페르마의 마지막 정리 형식화 실험은 기준이 서로 달라 따로 살펴봐야 해요.
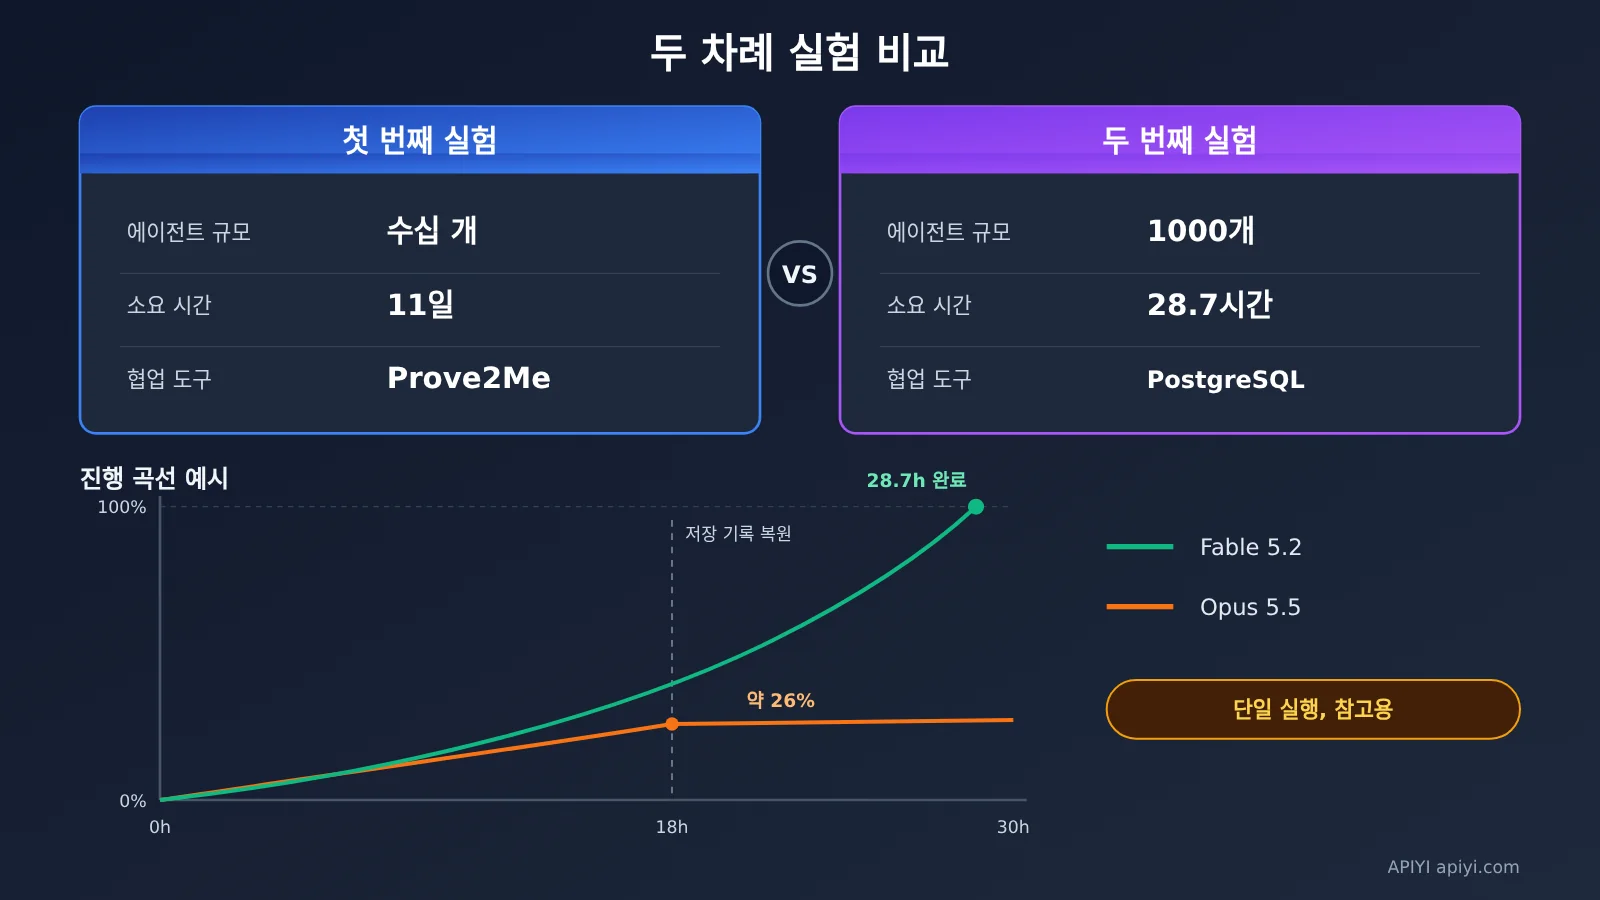
| 지표 | 첫 번째 실험(2026년 9월 공개) | 두 번째 실험(2026년 11월 9일 공개) |
|---|---|---|
| 모델 | 내부 연구 모델(Fable 5.1과 대략 비슷한 수준) | 초기 Fable 5.2 |
| 에이전트 수 | 수십 개 | 1000개 |
| 실행 시간 | 11일 | 28.7시간 |
| 출력 토큰 | 약 60억 | 공식 발표에 따르면 첫 번째 실험의 약 3분의 1로 감소 |
| 증명 길이 | 기준(Lean 코드 약 1300만 줄) | 첫 번째 실험의 약 1/7 |
| 협업 플랫폼 | Prove2Me + Claude Code 멀티 에이전트 하네스 | 범용 도구 + PostgreSQL |
| 사람의 개입 | 연구원 Tianyi Peng이 소량의 상위 수준 지침 제공 | 수학적 진행 과정에 지속적으로 개입하지 않음 |
60억 토큰, 코드 1300만 줄, 정리 약 30,300개라는 수치는 모두 첫 번째 실험의 결과라는 점을 짚고 넘어갈게요. 두 번째 실험의 정확한 토큰 수와 총비용, 코드 줄 수는 공식적으로 공개되지 않았어요.
첫 번째 실험도 초반에는 시행착오를 겪었어요. 에이전트들은 전체 진행 상황을 파악하거나 다른 에이전트가 무엇을 완료했는지 알기 어려워했고, 같은 작업을 반복하기도 했어요. 이후 도입된 Prove2Me 플랫폼은 DAG로 정리 간 의존성을 관리하고, 작업 상태 확인과 정리 검색, 컴파일 가속 기능을 제공했어요. 두 번째 실험에서는 이 전용 플랫폼을 사용하지 않고, 에이전트들이 범용 데이터베이스와 Git을 이용해 직접 협업 구조를 만들었어요. 다섯 개의 테이블이 앞서 언급한 플랫폼과 유사한 역할을 맡았죠.
Anthropic은 에이전트 1000개를 사용하는 동일한 조건으로 비교 실험도 진행했어요. Opus 5.5는 18시간 동안 약 26%를 완료한 뒤, 30시간이 될 때까지 거의 진전을 보이지 않았어요. 반면 Fable 5.2는 28.7시간 만에 최종 정리를 완성했어요. 두 실험 모두 약 18시간 시점에 저장된 상태에서 복구해 이어서 진행했어요. 다만 각 모델을 한 번씩만 실행했으므로, 모든 복잡한 작업에서 두 모델 간 차이가 일반적으로 이렇다고 단정할 수는 없어요.
AI Agent 1,000개 실험이 기업에 미치는 영향 분석
개발자를 위한 멀티 에이전트 시스템의 핵심 역량 4가지
수학적 배경을 걷어내고 보면, 이번 실험에서 도출한 역량은 흔히 볼 수 있는 기업 환경에 다음과 같이 적용할 수 있어요.
| 역량 | 실험에서의 구현 방식 | 기업 환경에 적용하면 |
|---|---|---|
| 복잡한 작업 분해 | 하위 작업 2,418개, 최대 10단계 깊이의 작업 트리 | 대규모 코드 리팩터링, 복잡한 조사 보고서 |
| 동적 리소스 할당 | 어려운 문제는 보류하고 Helper 750개를 집중 투입 | 우선순위에 따라 Agent와 컴퓨팅 리소스를 재할당 |
| 공유 상태 관리 | PostgreSQL 테이블 5개 + Git 병합 | 통합 작업 보드로 중복 작업 줄이기 |
| 결과 독립 검증 | Lean 커널이 모든 제출물을 검사 | 단위 테스트, 데이터 검증, 사람의 검토 |
개발자에게 가장 직접적인 시사점은 처음부터 복잡한 전용 플랫폼을 구축할 필요가 없다는 거예요. 잘 설계된 공유 데이터베이스와 버전 관리만으로도 상당한 규모의 협업을 지원할 수 있어요. 아래는 모델을 호출하는 아주 간단한 예시예요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스
)

response = client.chat.completions.create(
    model="claude-fable-5-2",  # 모델명은 플랫폼의 모델 목록을 기준으로 합니다
    messages=[{"role": "user", "content": "把这个任务拆成可独立验证的子任务"}]
)
print(response.choices[0].message.content)
Lead / Helper 작업 풀 예시 코드 보기
import sqlite3
import openai

# 실험에서 사용한 Subtasks / Landed 테이블을 로컬에서 SQLite로 모의 구현합니다(실험에서는 PostgreSQL을 사용했습니다)
db = sqlite3.connect("board.db")
db.execute("CREATE TABLE IF NOT EXISTS subtasks (id INTEGER PRIMARY KEY, goal TEXT, status TEXT, owner TEXT)")
db.execute("CREATE TABLE IF NOT EXISTS landed (task_id INTEGER, result TEXT)")

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def lead_plan(goal: str):
    """Lead: 작업을 분해해 작업 풀에 등록합니다."""
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": f"将目标拆为3-5个子任务,每行一个:{goal}"}]
    )
    for line in resp.choices[0].message.content.splitlines():
        if line.strip():
            db.execute("INSERT INTO subtasks (goal, status) VALUES (?, 'open')", (line.strip(),))
    db.commit()

def verify(result: str) -> bool:
    """독립 검증기: 실제 환경에서는 테스트, 검증 스크립트 또는 Lean 검사로 대체해야 합니다."""
    return len(result) > 0

def helper_claim(name: str):
    """Helper: 작업을 직접 맡고, 검증을 통과한 경우에만 landed에 기록합니다."""
    row = db.execute("SELECT id, goal FROM subtasks WHERE status='open' LIMIT 1").fetchone()
    if not row:
        return
    task_id, goal = row
    db.execute("UPDATE subtasks SET status='doing', owner=? WHERE id=?", (name, task_id))
    db.commit()
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": goal}]
    )
    result = resp.choices[0].message.content
    if verify(result):
        db.execute("INSERT INTO landed VALUES (?, ?)", (task_id, result))
        db.execute("UPDATE subtasks SET status='done' WHERE id=?", (task_id,))
    else:
        db.execute("UPDATE subtasks SET status='open', owner=NULL WHERE id=?", (task_id,))
    db.commit()

lead_plan("为一个开源库补全单元测试")
for i in range(3):
    helper_claim(f"helper-{i}")
🚀 빠른 시작 팁: ‘Lead의 작업 분해 + Helper의 작업 선택 + 독립 검증’으로 구성된 소규모 프로토타입을 재현해 보고 싶다면, 먼저 APIYI apiyi.com에서 무료 테스트 크레딧을 받아보세요. OpenAI 호환 인터페이스를 제공해 API 키 하나로 Claude, GPT, Gemini 등 여러 모델을 전환할 수 있으므로 Lead 역할을 맡은 모델별로 작업 분해 품질을 비교하기 편해요.
업계에서는 숫자보다 경계가 더 중요해요
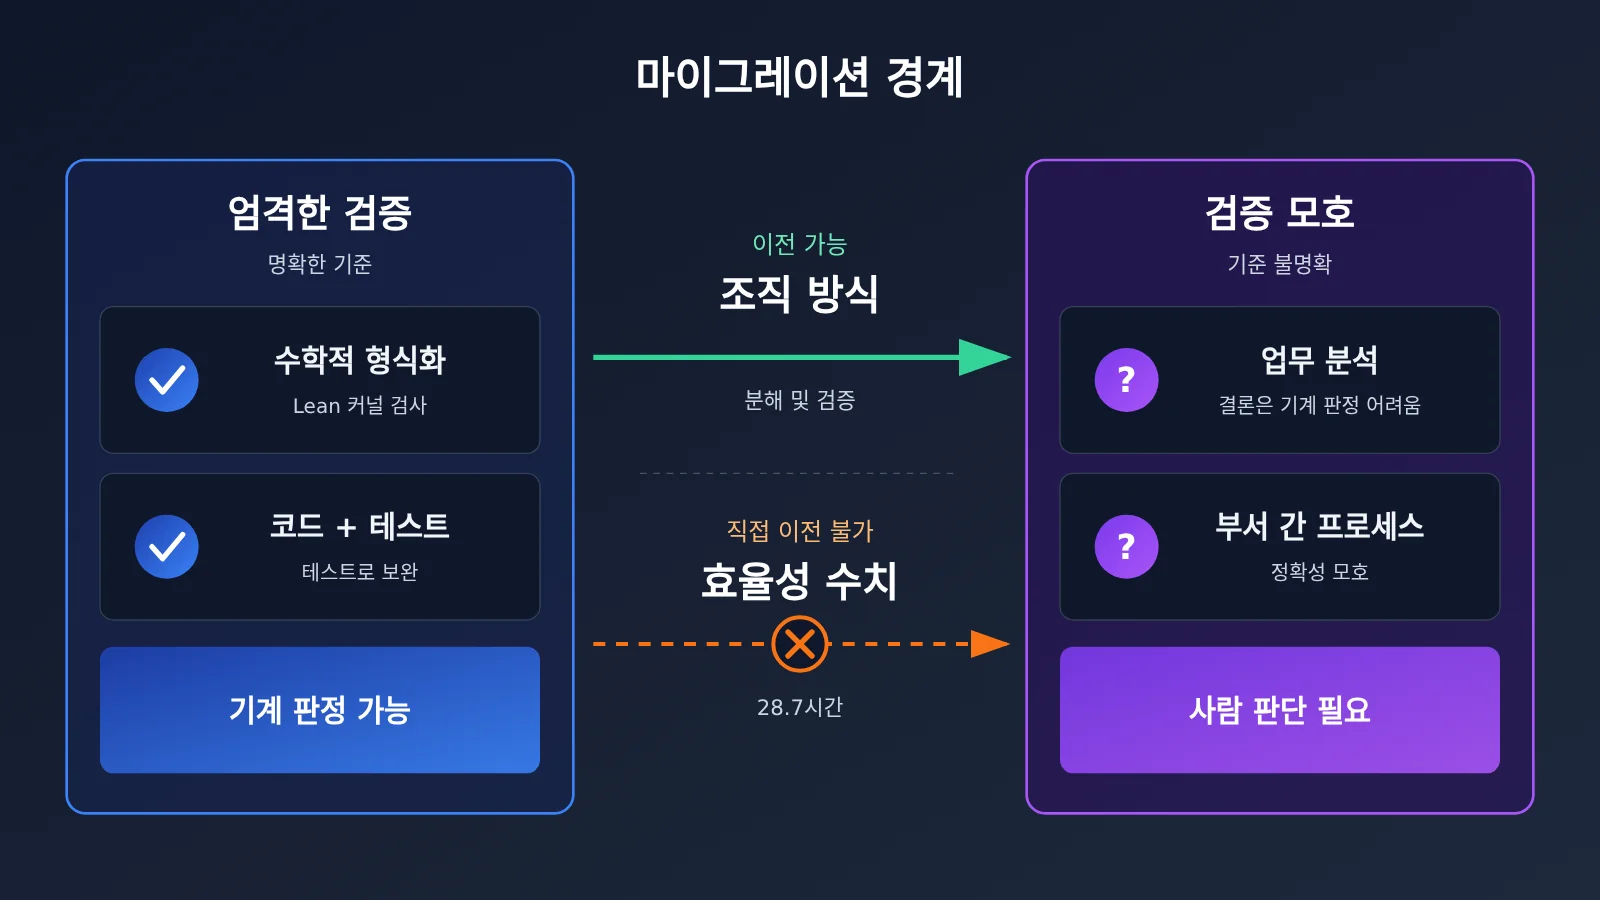
냉정하게 바라봐야 할 점이 있어요. 수학적 형식화에는 Lean처럼 엄격하고 객관적인 검증기가 있지만, 대부분의 기업 업무에는 그만큼 명확한 정답 기준이 없어요. 코드는 테스트로 보완할 수 있지만, 시장 분석이나 부서 간 업무 프로세스에서 무엇이 ‘정답’인지는 기계가 판단하기 어려운 경우가 많아요. 따라서 28.7시간과 이번 실험의 성공률을 기업 Agent 시스템에 그대로 적용할 수는 없어요.
Anthropic도 한계를 언급했어요. Agent는 작업을 완료할 수 없다고 너무 일찍 판단하는 경향이 있어요. 초기에 보류된 명제 47개도 나중에는 대부분 증명되었어요. 어려운 단계에서는 사람이 방향을 제시하는 것이 여전히 도움이 되고, Prove2Me 같은 도메인 전용 도구로 컴파일, 검색, 협업 효율을 더 높일 수도 있어요. 이번 실험만으로 Agent를 많이 투입할수록 좋다거나, 인간 전문가와 전용 Harness가 더는 필요하지 않다고 볼 수는 없어요.
💡 엔지니어링 제안: 기업에서 멀티 Agent 방식을 시범 도입할 때는 먼저 검증 기준이 명확한 작업(예: 테스트 주도 코드 수정)을 선택한 뒤, 적용 범위를 점차 넓혀 보세요. APIYI apiyi.com의 사용량 기반 과금으로 소규모 Agent를 운영하며 작업 분해와 검증 단계를 평가한 다음, 투자 규모를 늘릴지 결정할 수 있어요.
자주 묻는 질문 FAQ
Q1: 이번 실험에서 AI가 페르마의 마지막 정리를 증명했나요?
아니요. 페르마의 마지막 정리는 Wiles가 1995년에 정식으로 증명을 발표했습니다(핵심 문제를 수정하는 과정에서 Taylor와 협력했습니다). 이번 실험은 명제 60개와 증명 경로 개요, 정의, 이미 증명된 보조정리 47개를 제공받아 기존 증명 경로를 Lean에서 검사할 수 있는 형식 증명으로 옮긴 것입니다.
Q2: 명제 60개 중 증명 완료로 표시된 것은 왜 54개뿐인가요?
30시간 시점의 통계에서 대체 명제 5개는 더 이상 필요하지 않은 것으로 확인됐고, 명제 1개는 포기됐습니다. 최종 정리는 이미 28.7시간 시점에 검사를 통과했으므로 처음 나열한 명제 60개를 모두 완료할 필요는 없었습니다.
Q3: Claude Fable 5.2 API 가격은 얼마인가요?
공식 가격은 입력 토큰 100만 개당 8달러, 출력 토큰 100만 개당 40달러입니다. Fast Mode는 각각 16달러와 80달러이며, 캐시 읽기는 토큰 100만 개당 0.20달러입니다. Batch API는 50% 할인되고, 컨텍스트 윈도우는 100만 토큰, 최대 출력은 12만 8,000토큰입니다. 두 번째 실험의 총비용은 공식적으로 공개되지 않았으므로, 첫 번째 실험에서 사용한 60억 토큰에 단가를 곱해 추정할 수는 없습니다.
Q4: API로 Claude Fable 5.2를 빠르게 사용해 보려면 어떻게 해야 하나요?
APIYI apiyi.com에 가입해 API 키를 발급받은 다음, `base_url`을 `https://api.apiyi.com/v1`로 설정하면 이 글의 예제 코드를 바로 사용할 수 있습니다. 신규 사용자는 무료 테스트 크레딧을 받을 수 있어 소규모 멀티 에이전트 프로토타입을 먼저 만들어 보기에 좋습니다.
Q5: 멀티 에이전트 시스템에 PostgreSQL이 꼭 필요한가요?
그렇지 않습니다. 중요한 것은 모든 에이전트가 읽고 쓸 수 있는 공유 상태 저장소를 마련하고, 버전 관리와 독립적인 검증을 갖추는 것입니다. 소규모 프로토타입이라면 SQLite나 Redis만으로도 충분합니다. APIYI apiyi.com을 통해 모델을 호출하더라도 상태 저장은 자체 시스템에서 담당하므로, 두 요소를 자유롭게 조합할 수 있습니다.
Q6: 이번 실험의 알려진 한계는 무엇인가요?
공식적으로도 이번 실험은 개념 검증 수준의 실험(toy experiment)이라고 설명했습니다. Fable과 Opus의 비교는 각각 한 번만 진행됐고, 사용한 모델은 초기 버전이라 여러 단계의 안전장치가 필요했습니다. 에이전트가 작업을 너무 일찍 포기한 사례도 있었으며, 사람의 지침과 분야별 전용 도구도 여전히 유용합니다.
AI Agent 1,000개로 페르마의 마지막 정리 형식화: 핵심 요점
- 실험의 본질: 기존 증명을 Lean이 검사할 수 있는 코드로 형식화한 것이며, 페르마의 마지막 정리를 처음 증명한 것은 아니에요.
- 핵심 수치: 초기 버전 Fable 5.2 Agent 1,000개가 28.7시간 만에 작업을 완료했고, Lean 공식 커널의 검증을 통과했어요.
- 조직의 핵심: Lead 1개와 Helper 999개가 다섯 개의 공유 데이터베이스 테이블과 Git을 활용해 협업했어요.
- 난제 해결 방식: Agent 약 750개가 Langlands–Tunnell 정리를 하위 작업 2,418개로 나눴고, 분해 깊이는 최대 10단계였어요.
- 신뢰성의 근거: Lean의 독립 검증과 샌드박스 격리를 적용해 도구를 100만 회 넘게 호출하면서도 차단할 필요가 없었어요.
- 적용 범위: 기업의 실제 업무에는 Lean 같은 검증기가 없는 경우가 많으므로, 이 효율 수치를 그대로 일반화할 수는 없어요.
- 시작하는 방법: APIYI apiyi.com의 통합 인터페이스를 이용하면 Lead/Helper 협업 프로토타입을 소규모로 재현해 볼 수 있어요.
요약
Claude Fable 5.2를 활용한 이번 Agent 1,000개 실험의 핵심은 다음과 같아요.
- 시스템이 단일 요소보다 중요해요: 모델 성능, 작업 분해, 공유 상태, 병렬 실행, 기계 검증이 함께 작동해 28.7시간 만에 결과를 낼 수 있었어요.
- 검증이 신뢰의 기반이에요: Lean 커널 검사를 통해 ‘모델이 완료했다고 주장하는 것’과 ‘실제로 완료한 것’을 엄격하게 구분할 수 있었어요.
- 적용 범위를 분명히 해야 해요: 입력이 미리 정해져 있고, 초기 모델을 사용했으며, 단일 비교 실험이자 토이 실험이라는 점을 고려하면 결과를 과대해석해서는 안 돼요.
이번 실험은 업계에 생각해 볼 만한 질문을 던져요. 앞으로 AI 시스템의 경쟁력은 단일 모델의 성능에서 복잡한 작업을 수행하도록 다수의 에이전트를 조직하고 조율하는 시스템 역량으로 옮겨갈까요? 개발자라면 독립적인 검증 기능을 갖춘 작은 멀티에이전트 프로토타입부터 직접 만들어 볼 수 있어요. 무료 테스트 크레딧과 여러 모델을 위한 통합 인터페이스를 제공하는 APIYI apiyi.com에서 빠르게 효과를 확인해 보세요.
📚 참고 자료
- Anthropic 엔지니어링 블로그: Safely scaling multi-agent teams with Claude Fable 5.2
- 링크:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2 -
설명: 두 번째 실험의 조직 구조, 데이터베이스 협업, 안전 메커니즘 및 Opus와의 비교
-
Anthropic 연구 글: Formalizing Fermat’s Last Theorem
- 링크:
anthropic.com/research/formalizing-fermats-last-theorem -
설명: 첫 번째 형식화 실험의 데이터와 Prove2Me의 협업 방식
-
Anthropic 공식 Lean 증명 저장소: 첫 번째 형식화 증명
- 링크:
github.com/anthropics/fermats-last-theorem -
설명: 공개된 9월 버전의 증명 코드입니다. README의 데이터는 11월 실험 통계와 다릅니다.
-
Lean 공식 사례: Formalizing Fermat’s Last Theorem
- 링크:
lean-lang.org/use-cases/flt -
설명: Lean과 형식화 수학의 배경을 알아볼 수 있습니다.
-
Fable 5.2 모델 문서: 모델 사양 및 API 마이그레이션
- 링크:
platform.claude.com/docs/en/models/fable-5-2/overview - 설명: 컨텍스트 윈도우, 출력 한도 및 가격 정보
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 홈에서 문의해 주세요. 더 많은 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있습니다.