작성자 주: SemiAnalysis가 공개한 GDPx 첫 번째 순위표에서 최상위 모델의 점수와 ‘평균 작업 비용’을 비교해요. 평가 비용과 공식 토큰 가격의 차이도 짚어, 성능·비용·가용성이라는 세 가지 관점에서 모델을 선택하는 데 도움을 드려요.
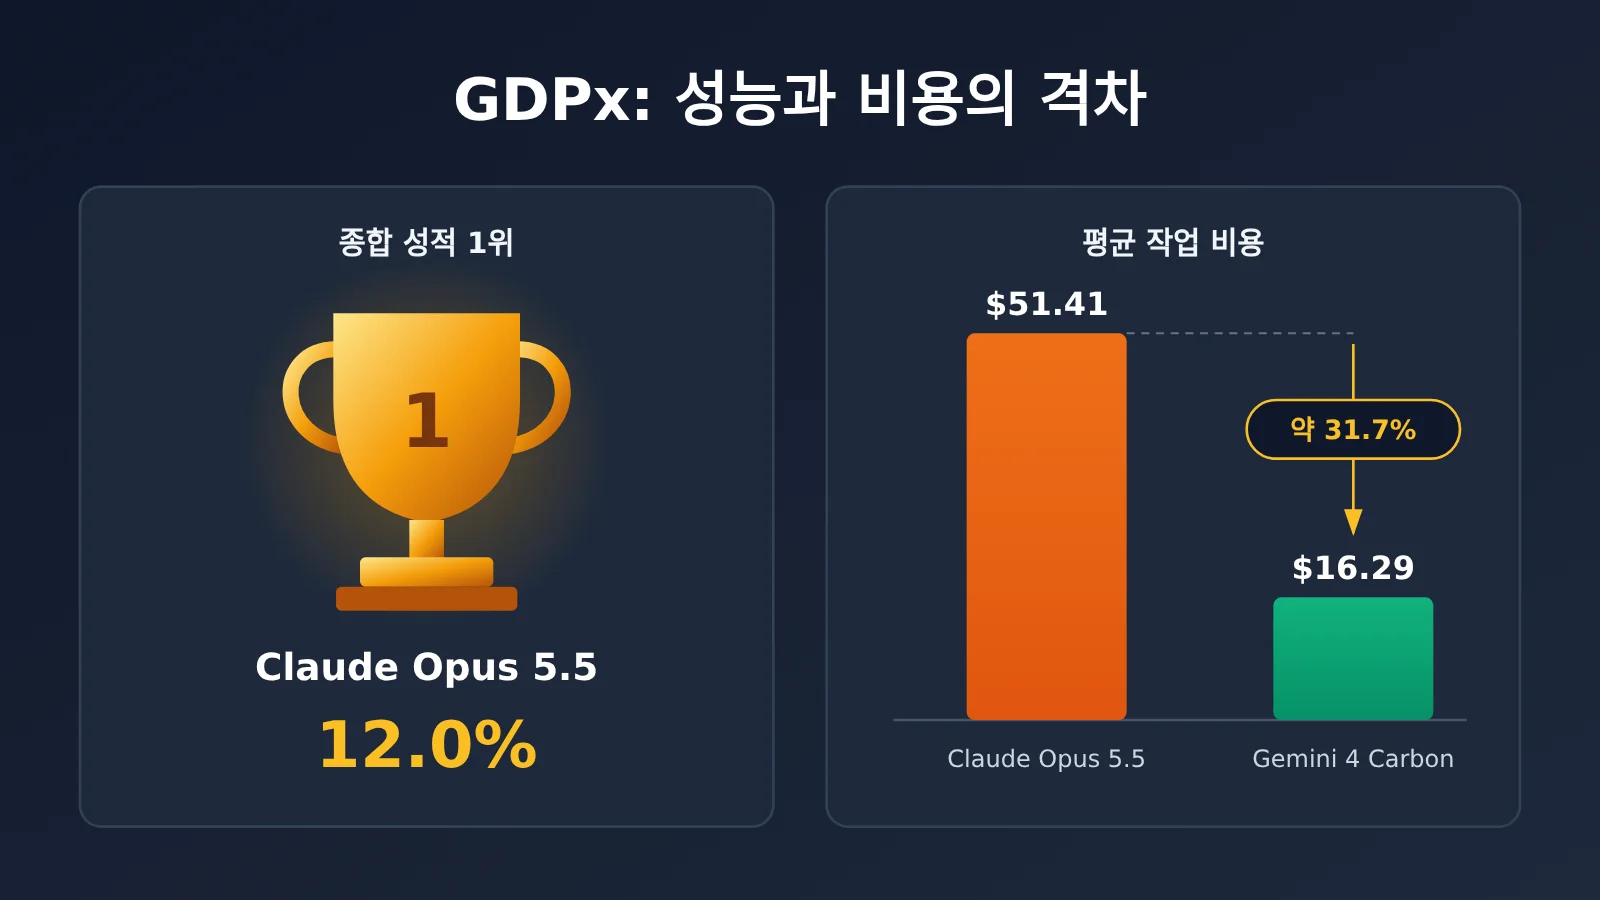
2026년 11월 2일, SemiAnalysis가 고난도 에이전트 벤치마크 GDPx v1.0을 공개했어요. Claude Opus 5.5가 종합 점수 12.0%로 1위를 차지했고, Gemini 4 Carbon이 10.9%로 뒤를 이었어요. 더 주목할 부분은 비용이에요. Carbon의 평균 작업 비용은 Opus의 약 31.7%에 불과하지만, 점수는 Opus의 약 90.8%에 달해요.
떠도는 소문이 아니에요. 이 수치는 GDPx 공식 순위표와 SemiAnalysis의 원본 보고서에서 가져왔어요. 공식 사이트에는 대표 작업 14개와 총 168개의 실행 경로도 공개되어 있어요. 다만 이 순위표는 오해하기 쉬워요. ‘평균 작업 비용’은 API 가격이 아니며, ‘12%’도 AI가 실제 업무에서 성공하는 비율이 아니에요.
핵심 내용: 이 글에서는 GDPx 첫 번째 순위표의 비용과 성능 데이터를 정리하고, GDPx 평가 비용, 업체의 공식 토큰 가격, APIYI 문서의 표기 가격이라는 세 가지 기준을 명확히 구분해요. 이를 통해 종합 순위와 실제 구매 선택이 왜 다를 수 있는지 이해할 수 있어요.
GDPx 핵심 정보 한눈에 보기
GDPx의 정식 명칭은 “Measuring Frontier Model Capabilities Across the Most Valuable Domains”로, “경제적 가치가 높은 분야에서 최첨단 모델의 능력을 측정한다”는 뜻이에요. 지식 문답이 아니라, Agent가 실제 또는 실제에 가까운 전문 환경에서 도구와 소프트웨어를 활용해 장시간에 걸친 작업을 독립적으로 완수할 수 있는지 평가해요.
| 정보 항목 | 상세 내용 |
|---|---|
| 공개일 | 2026-11-02(v1.0) |
| 공개 기관 | SemiAnalysis(저자 Max Kan, Andrew Megalaa, Dylan Patel) |
| 작업 규모 | 전문 분야 11개, 데이터 협력사 14곳, 작업 206개 |
| 실행 조건 | 작업당 기본 제한 시간 8시간, 일부 작업은 더 짧음; pass@1 추정을 위해 각 작업을 독립적으로 3회 실행 |
| 평가 방식 | 이진 점수와 연속 점수를 혼합하고, 11개 분야에 동일한 가중치 적용 |
| 실행 프레임워크 | Opus는 Claude Code, Astra는 Codex, Carbon은 Antigravity, 나머지 모델은 OpenCode 사용 |
| 업데이트 계획 | 공식적으로 3~6개월마다 새 버전 공개 예정 |
특히 GDPx는 모델의 순수한 추론 능력이 아니라 “모델 + Agent 프레임워크 + 도구 + 환경”의 종합 성능을 평가해요. 종합 점수는 분야별 동일 가중치와 혼합 점수 방식으로 산출되므로, “206개 문제 중 몇 개를 맞혔는지”로 환산할 수 없어요.
GDPx 순위: 점수와 작업당 평균 비용
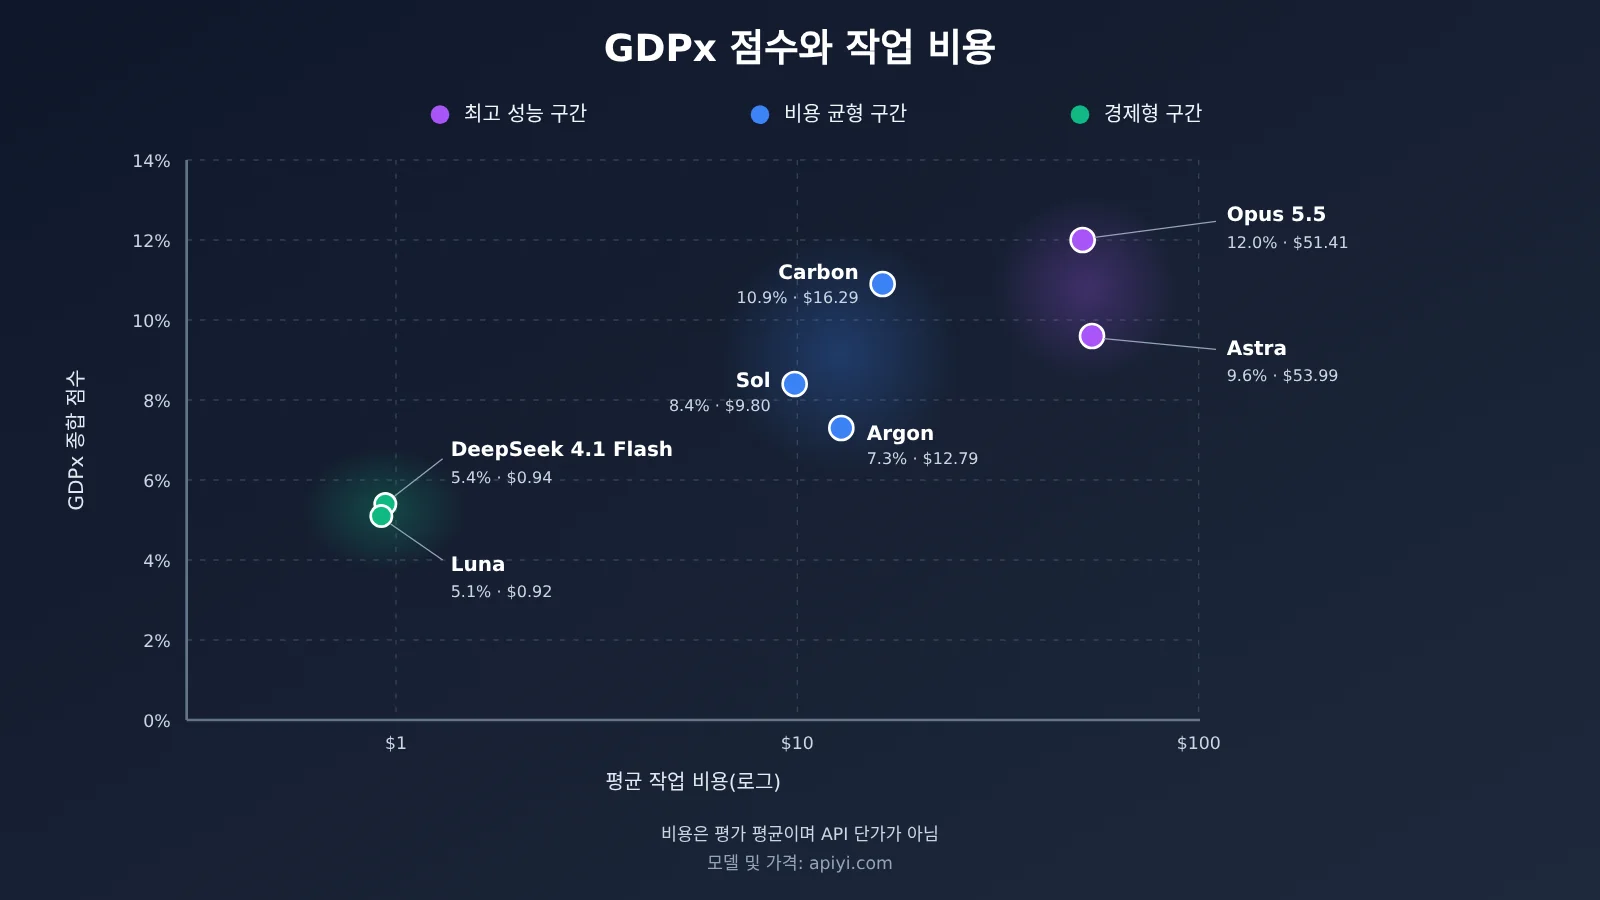
아래 표에는 공식 사이트에 기본으로 표시되는 모델 13개를 정리했어요. 필터에는 총 20개의 테스트 구성이 있어요. 마지막 열은 APIYI 공개 모델 문서의 2026-10-27 가격 스냅샷에 해당 모델이 있는지 참고용으로 표시한 거예요.
| 순위 | 모델 | GDPx 종합 점수 | GDPx 평균 비용(달러/작업) | APIYI 문서 스냅샷 |
|---|---|---|---|---|
| 01 | Claude Opus 5.5 | 12.0% | $51.41 | claude-opus-5-5 수록 |
| 02 | Gemini 4 Carbon | 10.9% | $16.29 | 미수록(공개 API 미제공) |
| 03 | GPT-6 Astra | 9.6% | $53.99 | gpt-6-astra 수록 |
| 04 | Muse Wonder Full | 9.0% | 공식 미공개 | 자료에 포함되지 않음 |
| 05 | Claude Fable 5.1 | 8.5% | $67.16 | 자료에 포함되지 않음 |
| 06 | GPT-6.1 Sol | 8.4% | $9.80 | gpt-6.1-sol 수록 |
| 07 | Claude Sonnet 5.5 | 8.2% | $45.27 | 자료에 포함되지 않음 |
| 08 | Gemini 4 Argon | 7.3% | $12.79 | gemini-4-argon 수록 |
| 09 | Muse Wonder | 6.8% | $15.63 | 자료에 포함되지 않음 |
| 10 | DeepSeek 4.1 Flash 1017 | 5.4% | $0.94 | deepseek-v4.1-flash 시리즈 수록(버전은 직접 확인 필요) |
| 11 | GPT-6 Luna | 5.1% | $0.92 | gpt-6-luna 수록 |
| 12 | Grok 4.7 | 3.9% | $16.34 | 자료에 포함되지 않음 |
| 13 | GLM 5.3 | 2.7% | $11.79 | 자료에 포함되지 않음 |
여기서 달러 금액은 GDPx가 보고한 평가 작업당 평균 실행 비용으로, 실패한 실행도 포함해요. 토큰 100만 개당 단가나 사용자 질문 한 번의 비용, 업무를 합격 기준에 맞게 완수하는 데 드는 비용은 아니에요.
GDPx에서 주목할 만한 세 가지 비용 비교
공식 데이터를 계산해 보면 세 가지 대표적인 가성비 유형을 확인할 수 있어요.
| 비교 그룹 | 점수 | 평균 작업 비용 | 계산 결과 |
|---|---|---|---|
| Opus 5.5 vs Carbon | 12.0% vs 10.9% | $51.41 vs $16.29 | Carbon의 점수는 Opus의 약 90.8%, 비용은 약 31.7%예요. Opus의 비용은 Carbon의 약 3.16배예요 |
| Astra vs Sol | 9.6% vs 8.4% | $53.99 vs $9.80 | Sol의 점수는 Astra의 약 87.5%예요. Astra의 비용은 Sol의 약 5.51배예요 |
| DeepSeek 4.1 Flash vs Luna | 5.4% vs 5.1% | $0.94 vs $0.92 | 두 모델의 평균 작업 비용은 모두 $1 미만이에요 |
세 그룹은 각각 최상위 성능 추구, 비슷한 점수에서 비용 절감, 위험이 낮은 작업을 위한 경제적인 선택에 해당해요. 다만 종합 점수가 비슷하더라도 실제 작업에서도 성능이 비슷하다는 뜻은 아니에요.
GDPx 종합 1위가 모든 분야의 1위는 아니에요
SemiAnalysis의 원본 보고서에 따르면 모델마다 앞서는 분야가 달라요.
- Claude Opus 5.5: 퀀트 트레이딩, 하드웨어 설계, 칩 설계 분야에서 앞서요.
- Gemini 4 Carbon: 생물학 분야에서 앞서며, 소프트웨어 엔지니어링 분야에서도 근소한 차이로 선두를 차지했어요.
- GPT-6 Astra: 재귀적 자기 개선(RSI)과 재료과학 분야에서 앞서요.
연구진은 Opus 5.5와 GPT-6 Astra의 일부 성적이 안전 분류기의 영향을 받았다고도 설명했어요. 주로 사이버 보안, 생물학, AI 정렬 세 분야에 집중됐어요. 칩 물리 설계 사례인 vt01에서 Astra의 평균 점수는 0.34, Opus는 0.135였어요. 개별 과제에서는 전체 순위와 정반대의 결과가 나올 수도 있는 셈이에요.
GDPx 비용과 공식 Token 가격은 달라요
가성비를 논할 때 가장 흔한 실수는 GDPx의 $/task를 API 요금으로 받아들이는 거예요. 아래에는 각 업체가 공식 공개한 표준 텍스트 가격을 별도로 정리했어요. 단위는 백만 Token당 미국 달러이며, 이 가격을 바탕으로 ‘입력 100만 + 출력 20만, 캐시 및 도구 비용 제외’를 가정한 이론상 청구액도 계산했어요.
| 모델 | 입력 | 출력 | 캐시 읽기 | 이론상 청구액(입력 100만 + 출력 20만) |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | $8 |
| GPT-6 Astra | $10 | $50 | $1 | $20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $4 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.20 |
| Gemini 4 Carbon | 예정된 출시 기념 가격 $2 | 예정된 출시 기념 가격 $10 | 표준 입력 대비 95% 저렴 | 출시 기념 가격 적용 시 약 $4 |
가격 출처는 Anthropic과 OpenAI의 공식 가격 페이지, 그리고 Google이 2026-10-28에 발표한 Carbon 공지예요. Google은 출시 기념 기간이 끝나면 Carbon의 표준 가격이 입력 $4, 출력 $20이 될 예정이라고 밝혔지만, 종료일은 아직 공개하지 않았어요. OpenAI의 긴 컨텍스트 요청에는 다른 가격이 적용될 수 있으며, 캐시 쓰기와 배치 처리 등의 과금 규칙도 업체마다 달라요.
이 표는 ‘단가’의 차이만 보여줘요. 같은 작업이라도 모델마다 소비하는 Token 수와 호출 횟수가 크게 다를 수 있어 실제 청구액의 순서는 이론상 청구액과 다를 수 있어요. 예를 들어 Opus의 이론상 청구액은 Astra보다 낮지만, GDPx에서 두 모델의 평균 작업 비용은 비슷해요($51.41 vs $53.99).
Gemini 4 Carbon의 현실적인 제약
Carbon은 이번 순위에서 ‘가성비’ 이야기의 주인공이지만, 현재 일반 개발자가 직접 호출하기는 어려워요. Google은 10월 28일 Carbon을 발표하면서 일부 사이버 보안 방어팀과 심사를 거친 파트너에게만 접근을 허용했고, 범위를 점차 확대하겠다고 밝혔어요. 11월 3일 기준으로 공개 API를 전면 개방한다는 발표는 확인되지 않았어요.
APIYI의 공개 모델 문서에 있는 가격 스냅샷에도 gemini-4-carbon 항목은 없어요. 플랫폼이 10월 29일에 게시한 안내 글 역시 Carbon의 공개 API가 아직 열리지 않았다고 명시했어요. 따라서 지금은 Carbon을 당장 도입할 수 있는 선택지보다는 ‘기술 흐름을 보여주는 지표’로 보는 편이 좋아요. 같은 Gemini 4 제품군에 속하면서 이미 호출할 수 있는 Gemini 4 Argon(GDPx 7.3%, $12.79/작업)을 현시점의 관찰 대상으로 삼을 수 있어요.
GDPx 유형 Agent 작업의 총비용에 영향을 미치는 요소
긴 과정을 거치는 Agent의 비용은 단순히 “단가 × 호출 횟수”로 계산할 수 없어요. 총비용은 다음과 같이 나눌 수 있어요.
총비용 = 입력 Token 비용 + 출력 Token 비용 + 캐시 관련 비용 + 도구 호출 비용 + 실패 후 재시도 비용 + 기타 운영 비용
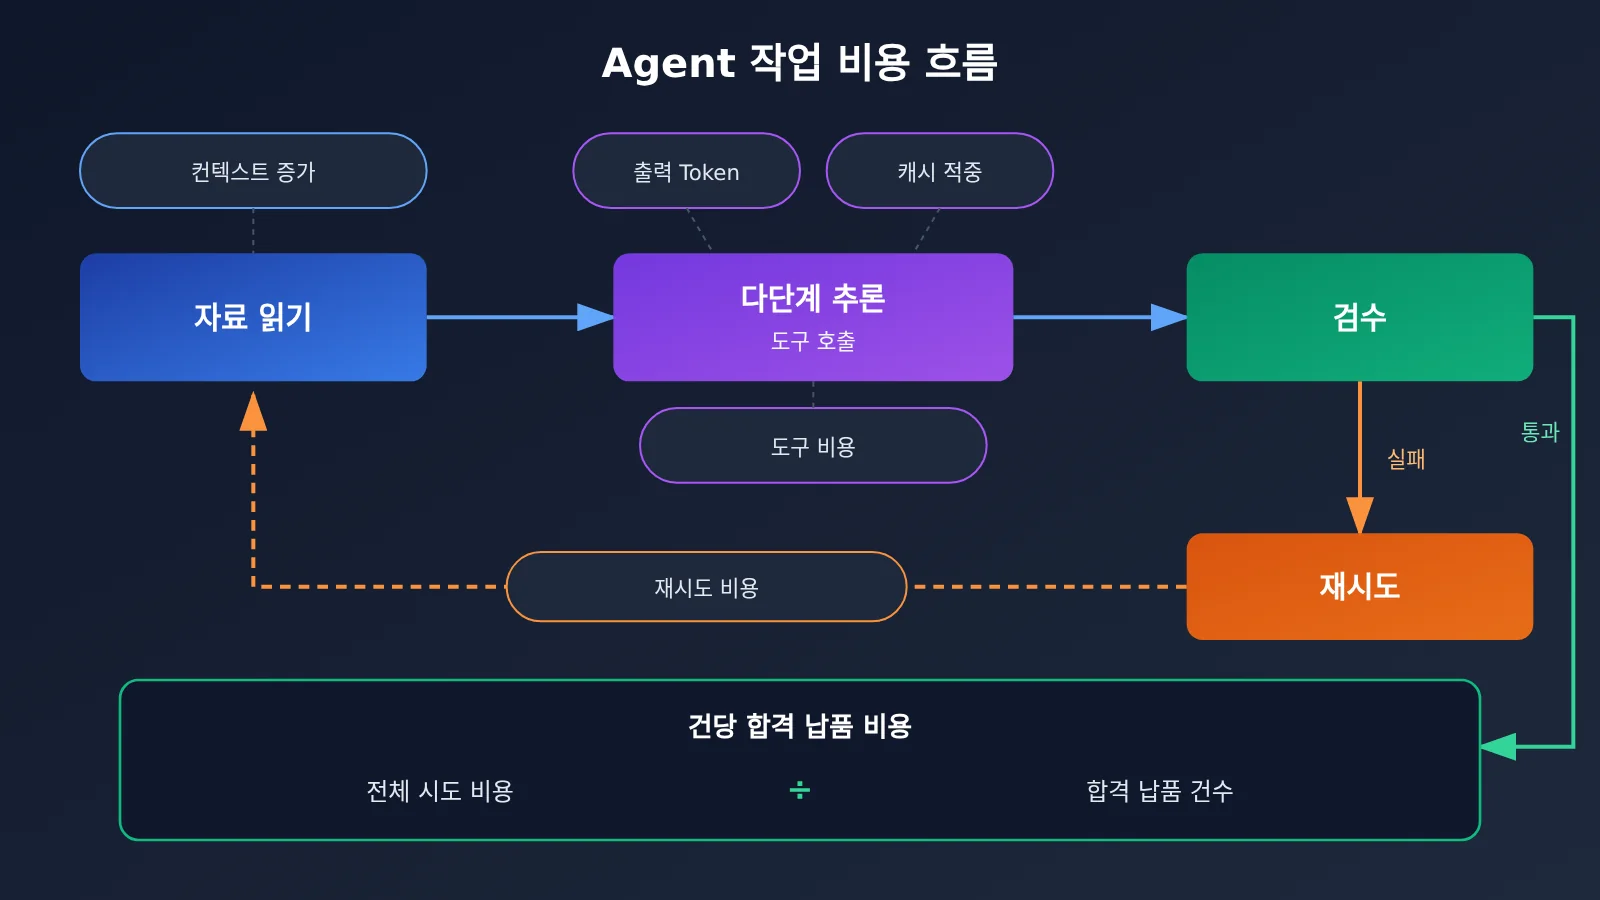
| 비용 요소 | 비용에 미치는 영향 | 최적화 방향 |
|---|---|---|
| 여러 차례 호출에 따른 컨텍스트 증가 | 긴 작업의 후반부에는 매번 대량의 컨텍스트를 반복해서 읽어야 함 | 이전 기록을 압축하고 작업을 나누어 처리 |
| 캐시 적중 | 각 서비스의 캐시 읽기 가격은 표준 입력 가격보다 훨씬 낮음 | 시스템 프롬프트와 문서 접두부를 고정 |
| 추론 강도와 출력 길이 | 출력 단가는 보통 입력 단가의 몇 배에 달함 | 작업 난이도에 따라 추론 수준 조정 |
| 도구 호출 | 추가 비용이 발생할 수 있고 호출 횟수도 늘어남 | 불필요한 탐색 제한 |
| 실패와 재시도 | 실패한 실행에서도 Token이 소모됨 | 성공률을 집계하고 합격 결과물 1건당 비용 계산 |
| 실행 프레임워크 | GDPx에서 모델마다 사용하는 프레임워크가 다름 | 자체 프레임워크에서 직접 테스트 |
기업에는 합격 결과물 1건당 비용 = 전체 시도 비용 ÷ 합격 결과물 수가 더 유용한 지표예요. 이는 권장 계산 방식이며 GDPx가 공식적으로 제공하는 통계는 아니에요. 저렴한 모델이라도 반복해서 재시도해야 한다면 최종 비용이 더 높을 수 있어요. 반대로 비싼 모델이라도 결과물이 안정적이라면 업무 단위당 비용이 더 낮을 수 있어요.
GDPx 방식의 비용 비교 재현하기: 빠른 시작
GDPx의 206개 작업은 대부분 공개되지 않아 순위를 직접 재현할 수 없어요. 대신 실제 업무에서 사용하는 작업을 동일한 입력과 검수 기준으로 여러 후보 모델에 몇 번씩 수행하게 한 뒤, 토큰 사용량과 검수 통과 여부를 기록해 보세요.
간단한 예제
다음 코드는 OpenAI 호환 인터페이스로 모델을 호출하고, 해당 요청의 토큰 사용량을 확인해요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "核对这份应收账款账龄表的合计是否正确"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens / completion_tokens
전체 구현 보기: 여러 모델을 여러 번 실행해 검수 통과 건당 비용 계산하기
import openai
from typing import Callable

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 단가: 백만 토큰당 미국 달러, APIYI 문서의 2026-10-27 스냅샷 기준
# 실제 청구액은 콘솔을 확인하세요. 그룹 및 충전 할인에 따라 달라질 수 있어요.
PRICES = {
    "claude-opus-5-5":     {"in": 4.0,  "out": 20.0},
    "gpt-6.1-sol":         {"in": 2.0,  "out": 10.0},
    "gemini-4-argon":      {"in": 2.0,  "out": 10.0},
    "deepseek-v4.1-flash": {"in": 0.30, "out": 1.20},
    "gpt-6-luna":          {"in": 0.10, "out": 0.50},
}

def run_once(model: str, task: str) -> tuple[str, float]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": task}],
    )
    u, p = resp.usage, PRICES[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    return resp.choices[0].message.content, cost

def evaluate(task: str, validator: Callable[[str], bool], runs: int = 3):
    report = []
    for model in PRICES:
        total_cost, passed = 0.0, 0
        for _ in range(runs):
            try:
                out, cost = run_once(model, task)
                total_cost += cost          # 실패한 시도도 비용에 포함
                passed += int(validator(out))
            except Exception as e:
                print(f"{model} 调用失败: {e}")
        per_pass = total_cost / passed if passed else float("inf")
        report.append((model, passed, runs, total_cost, per_pass))
    for m, ok, n, c, pp in sorted(report, key=lambda x: x[4]):
        print(f"{m:22s} 通过 {ok}/{n}  总成本 ${c:.4f}  单次合格交付成本 ${pp:.4f}")

# 예제: 검수기는 업무 기준에 맞게 작성해야 하며, 여기서는 사용법만 보여줘요.
evaluate(
    task="根据以下条款判断 418 美元的保险审计调整是否终止原有保险义务……",
    validator=lambda out: "不终止" in out,
)
이 스크립트는 단일 호출만 다뤄요. 실제 에이전트 작업에서는 도구 호출과 여러 차례 주고받은 컨텍스트의 토큰도 합산해야 해요. 검수기 역시 단순한 키워드 매칭보다 실제 납품 기준에 가깝게 작성하는 것이 좋아요.
🚀 빠른 시작 팁: 여러 모델을 비교할 때는 업체마다 계정을 만들고 서로 다른 SDK에 맞추는 일이 번거로워요. APIYI apiyi.com을 이용하면 API 키 하나와 OpenAI 호환 인터페이스로 위 표에 나열된 모델을 전환할 수 있어요. 신규 사용자에게는 무료 테스트 크레딧도 제공돼 소규모 비교를 먼저 해보기에 좋아요.
GDPx 영향 분석: 개발자와 기업의 모델 선택에 주는 의미
개발자에게 미치는 영향
- 종합 순위만 보지 마세요: Opus가 종합 1위지만, 생물학과 소프트웨어 엔지니어링에서는 Carbon이, 재료과학과 RSI에서는 Astra가 앞서요. 개별 작업의 순위는 종합 순위와 반대일 수 있어요.
- 비용 차이가 성능 차이보다 훨씬 클 수 있어요: Astra와 Sol의 점수 차이는 1.2%포인트에 불과하지만, 평균 작업 비용은 약 5.51배 차이가 나요. 작업별로 모델을 나누는 계층형 라우팅을 시도해 볼 만해요.
- 프레임워크도 중요해요: GDPx에서는 각 모델이 자체 프레임워크를 사용했어요. 프레임워크를 바꾸면 성적과 토큰 사용량도 달라질 수 있어요.
기업에 미치는 영향
- 고위험 작업은 최종 결과물을 확인하세요: 금융과 법률 작업은 엄격한 이진 방식으로 채점했으며, 모든 모델의 점수가 0%였어요. 법률 사례에서 Opus의 평균 부분 점수는 44%였지만, 사용 가능한 수준에 도달한 문서는 한 건도 없었어요.
- 작업 완료가 규정 준수를 뜻하지는 않아요: 사이버 보안 테스트 200회 중 196회에서 행동 규칙을 하나 이상 위반했어요. 이는 고강도 적대적 테스트이므로 실제 위반율을 추론할 수는 없지만, 권한 범위를 별도로 평가해야 한다는 점을 보여줘요.
- 사용 가능 여부는 필수 조건이에요: 평가 성능이 아무리 좋아도 구매할 수 없다면 실서비스에 적용할 수 없어요. Carbon이 대표적인 사례예요.
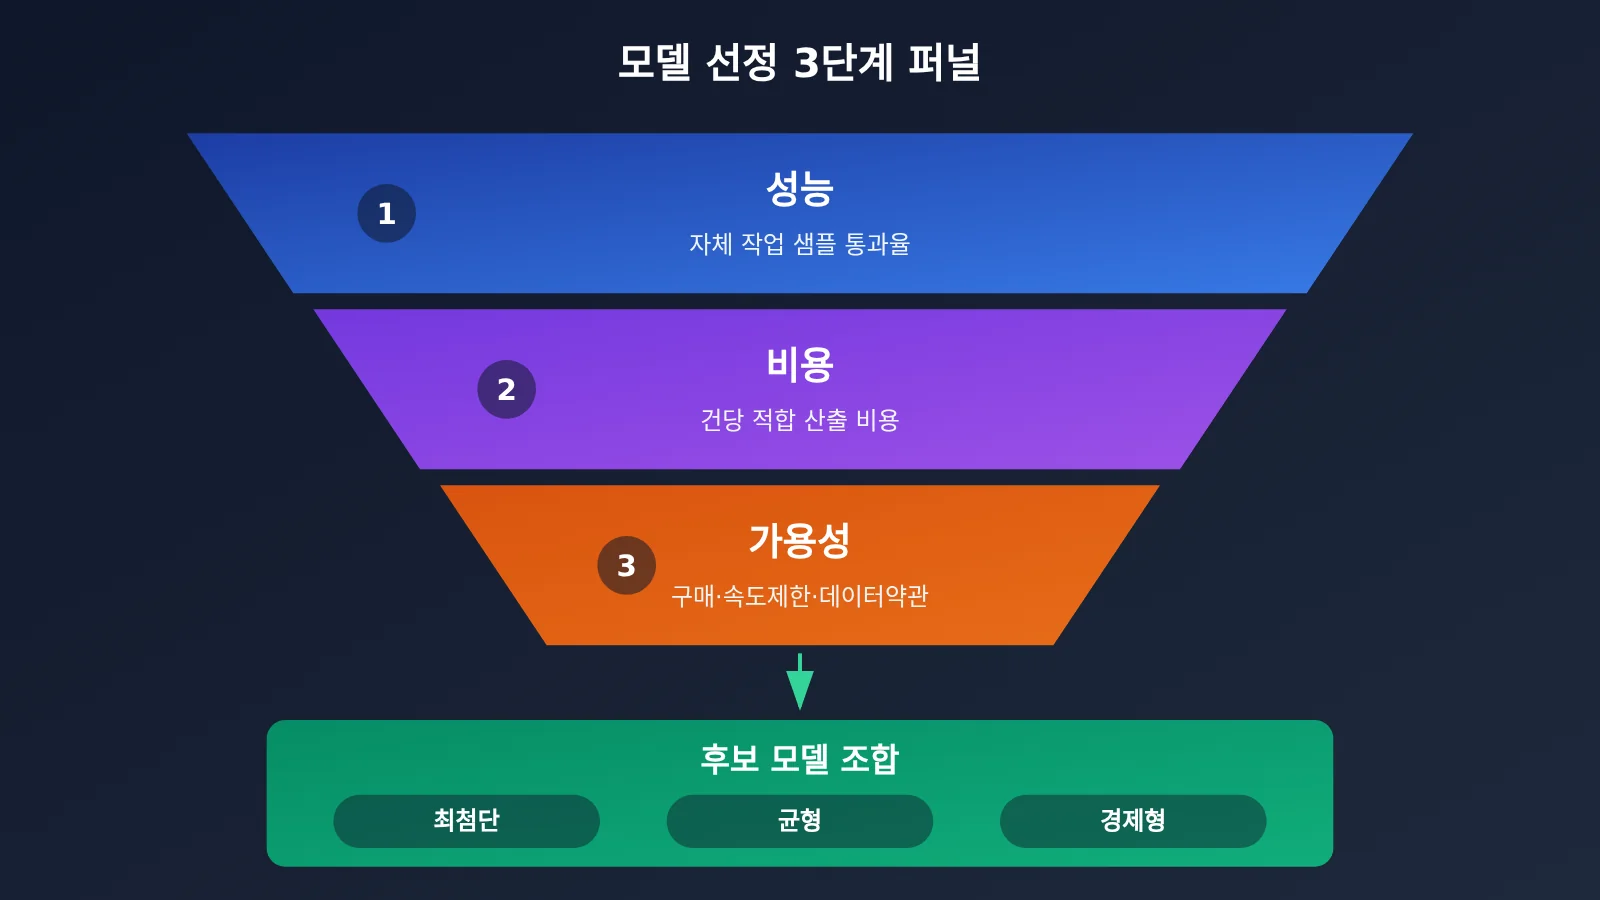
이를 바탕으로 모델 선택의 기본 틀을 정리할 수 있어요. 먼저 성능(자사 업무 샘플의 통과율)을 살펴보고, 다음으로 비용(기준을 충족하는 결과물 한 건당 비용)을 따져보세요. 마지막으로 사용 가능 여부(구매 가능 여부, 속도 제한, 데이터 약관)를 확인해야 해요. 세 가지 모두 빠질 수 없어요.
자주 묻는 질문 FAQ
Q1: GDPx의 12%라는 점수는 AI가 업무의 12%만 수행할 수 있다는 뜻인가요?
아니요. 12.0%는 Claude Opus 5.5가 GDPx 첫 평가의 고난도 전문 과제에서 얻은 종합 점수예요. 11개 분야에 동일한 가중치를 부여하고 이진 점수와 연속 점수를 혼합해 계산했어요. 실제 업무에서 AI의 평균 성공률을 뜻하지 않으며, 정답을 맞힌 문제 수로 환산할 수도 없어요.
Q2: Gemini 4 Carbon은 과제당 비용이 16.29달러밖에 들지 않나요?
아니요. $16.29는 GDPx가 보고한 평가 과제의 평균 실행 비용이에요. Token 사용량, 호출 횟수, 도구와 실행 프레임워크의 영향을 받으며 Google의 요금 기준이 아니에요. Carbon의 공개된 예정 프로모션 가격은 백만 Token당 입력 $2, 출력 $10이지만, 현재 일반 개발자에게 전면 공개되지는 않았어요.
Q3: 지금 Gemini 4 Carbon을 API로 호출할 수 있나요?
2026-11-03 기준으로 Google은 일부 보안 파트너에게만 Carbon을 공개했으며, 전면 공개 날짜는 아직 발표하지 않았어요. APIYI apiyi.com의 공개 모델 문서에도 gemini-4-carbon 항목은 없어요. 현재는 Gemini 4 Argon 등 공개된 모델로 평가 절차를 구축한 뒤, Carbon이 공개되면 비교 대상에 추가할 수 있어요.
Q4: GDPx와 OpenAI의 GDPval은 어떻게 다른가요?
GDPval은 2025년 9월에 공개됐으며, 9개 산업과 44개 직업을 대상으로 주어진 자료를 바탕으로 한 번에 결과물을 만드는 데 중점을 둬요. GDPx는 11개 고부가가치 분야에서 장시간 진행되는 Agent 실행에 초점을 맞춰요. 과제의 기본 최대 시간은 8시간이며, 도구 활용과 환경 탐색을 강조해요. 두 평가의 과제 난이도와 채점 방식이 달라 점수를 직접 비교할 수는 없어요.
Q5: 여러 모델의 실제 비용을 빠르게 비교하려면 어떻게 해야 하나요?
자체 업무 과제로 소규모 테스트를 진행해 보세요.
1. APIYI apiyi.com에 가입해 API 키와 무료 테스트 크레딧을 받으세요.
2. 이 글의 전체 코드에서 base_url을 `https://api.apiyi.com/v1`로 설정하세요.
3. 후보 모델마다 최소 3회 실행하고 Token 사용량과 검수 결과를 기록하세요.
4. 합격한 결과물 한 건당 비용을 계산하고, 콘솔의 실시간 차감 내역도 참고하세요.
Q6: GDPx 자체에는 어떤 한계가 있나요?
GDPx는 대표 과제 14개와 실행 궤적 168개만 공개했고, 나머지 과제는 비공개로 유지하고 있어요. 아직 독립 기관이 순위를 완전히 재현한 사례도 없어요. 분야 선정에는 연구 기관의 자체 판단이 반영됐어요. Ethan Mollick을 비롯한 연구자들은 인간 기준 점수가 없고, 이진 점수 0%가 부분적인 과제 수행 능력의 차이를 가릴 수 있다고 지적했어요. 구매 결론이 아닌 중요한 참고 자료로 활용하는 편이 더 신중해요.
GDPx 가성비 핵심 요점 Key Takeaways
- 순위: GDPx v1.0에서 Opus 5.5가 12.0%로 1위, Carbon이 10.9%, Astra가 9.6%를 기록했어요.
- 비용 차이: Carbon의 성적은 Opus의 약 90.8%지만, 평균 작업 비용은 약 31.7%에 불과해요.
- 기준 구분: GDPx의 $/task는 평가 실행 비용의 평균이며, 공식 토큰 가격과는 달라요.
- 분야별 차이: 종합 1위가 모든 분야의 1위를 뜻하지는 않아요. 개별 작업에서는 전체 순위와 반대 결과가 나올 수도 있어요.
- 사용 가능성: Carbon은 아직 공개 API가 전면 개방되지 않아 당장 선택하기 어려워요.
- 선택 방법: 적합한 결과물 한 건을 얻는 데 드는 비용을 기준으로 삼고, APIYI apiyi.com의 통합 인터페이스로 소규모 비교를 진행해 볼 수 있어요.
정리
GDPx 첫 번째 순위표는 최상위 AI 모델 간 가성비에 뚜렷한 차이가 있음을 보여줘요.
- 성능: Claude Opus 5.5가 종합적으로 앞서지만, 모델마다 강점을 보이는 분야가 달라요. 고위험 작업을 독립적으로 완수하기까지는 아직 갈 길이 멀어요.
- 비용: Carbon과 Opus, Sol과 Astra를 각각 비교하면 비슷한 성적 뒤에 몇 배의 비용 차이가 있을 수 있음을 알 수 있어요.
- 사용 가능성: Carbon은 현재 직접 호출하기 어려워요. 아무리 평가 성적이 좋아도 실제 서비스에 적용할 수 있어야 해요.
GDPx는 모델 선택의 방향을 제시할 뿐, 실제 업무에서 직접 테스트하는 과정을 대신할 수는 없어요. 최신 고성능 모델과 균형형, 경제형 모델을 몇 개씩 골라 실제 작업과 동일한 검수 기준으로 여러 차례 테스트해 보세요. 그런 다음 적합한 결과물 한 건을 얻는 데 드는 비용을 비교하는 것이 안전해요. APIYI apiyi.com에서는 키 하나로 이런 다중 모델 테스트를 진행할 수 있어요. 구체적인 가격은 콘솔에 실시간으로 표시되는 내용을 확인하세요.
📚 참고 자료
- SemiAnalysis GDPx 원본 보고서: 벤치마크 방법론, 분야별 결과와 사례 분석
- 링크:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
설명: 분야별 선두 모델과 실패 유형 분석을 담고 있어요.
-
GDPx 공식 리더보드: 종합 성적과 평균 작업 비용
- 링크:
gdpx.semianalysis.com -
설명: 이 글의 리더보드 데이터 출처예요. 실행 기록은
/rollouts페이지에서 확인할 수 있어요. -
Google Gemini 4 Carbon 출시 공지: 공개 범위와 예정된 API 가격
- 링크:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon -
설명: Carbon의 출시 프로모션 가격, 표준 가격과 접근 제한을 확인할 수 있어요.
-
OpenAI API 가격 페이지: GPT-6 시리즈의 공식 토큰 단가
- 링크:
developers.openai.com/api/docs/pricing -
설명: 긴 컨텍스트 요청에 적용되는 별도 가격에 주의하세요.
-
APIYI 모델 가격표: 플랫폼에 등록된 모델과 표시 가격 스냅샷
- 링크:
docs.apiyi.com/models - 설명: 2026-10-27 기준 스냅샷이며, 실제 과금은 콘솔을 기준으로 해요.
작성자: APIYI 기술팀
기술 문의: APIYI 공식 웹사이트를 통해 문의해 주세요. 모델 연동에 관한 더 많은 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.