著者注:LongCat 2.5の新モデル解説です。パラメータとアーキテクチャ、公式のデモ8例、公式が実施した25項目のベンチマークでの位置づけ、期間限定割引の料金、Claude CodeとClineへの接続方法を整理します。
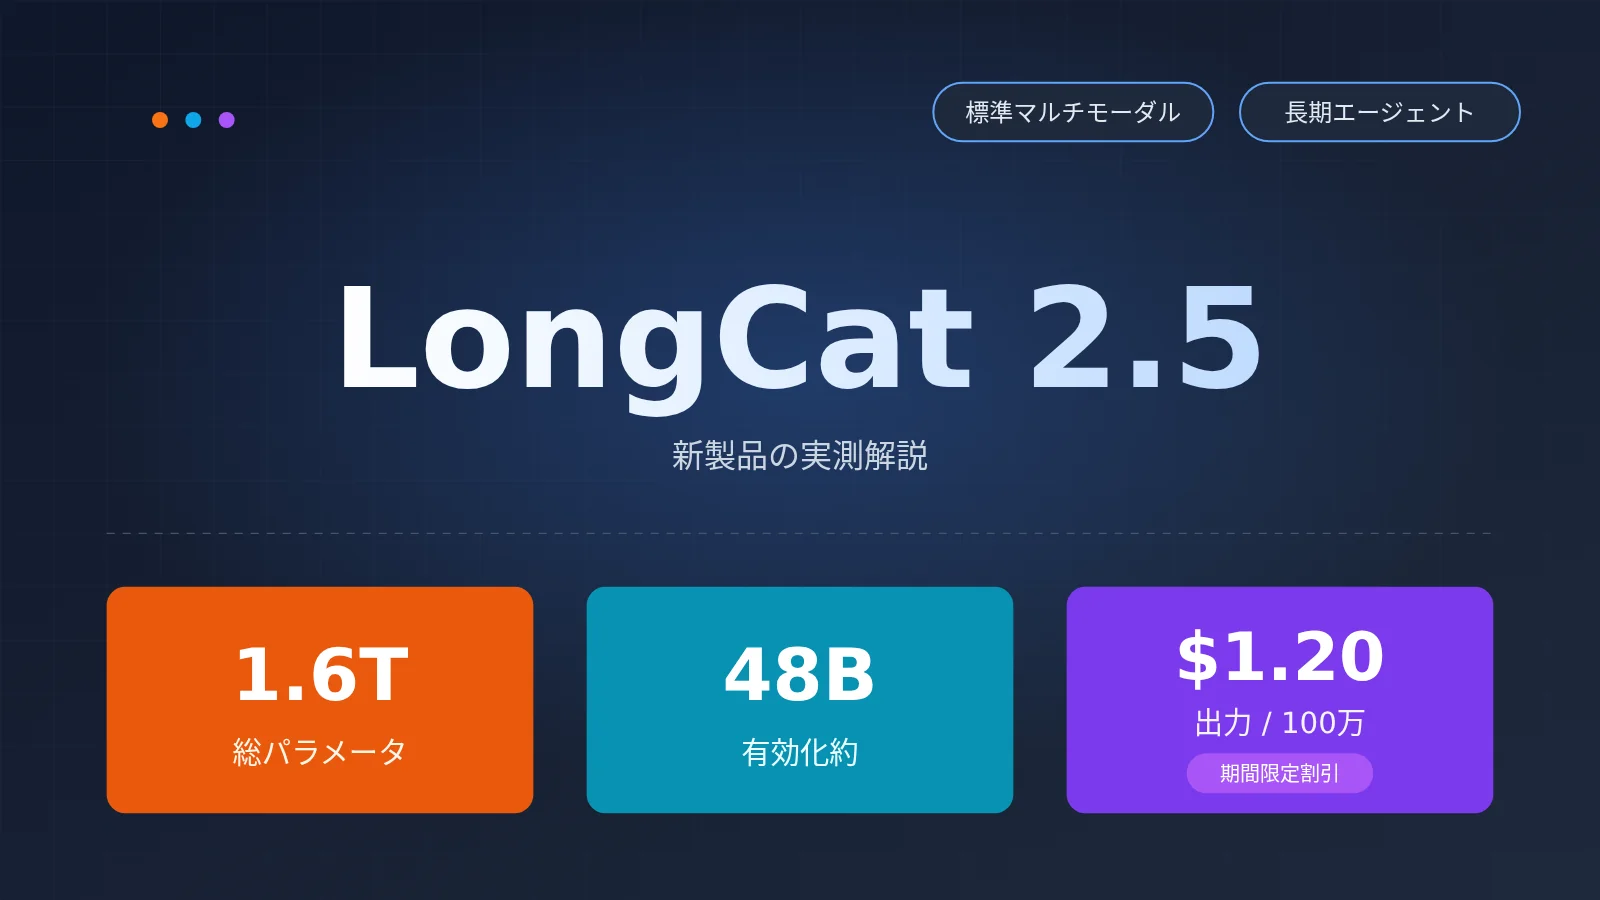
美団のLongCatチーム(コミュニティでの通称)は11月1日、LongCat-2.5をリリースしました。総パラメータ数は1.6Tで、トークンごとに約48Bが活性化されます。長期的なエージェントタスクを対象とした、ネイティブなマルチモーダルモデルです。2.0と比べて、主にネイティブな画像理解とエージェントによるプログラミングの2つが強化されました。期間限定の割引価格は、100万トークンあたり出力が$1.20、キャッシュにヒットしなかった入力が$0.30、キャッシュにヒットした入力が$0.006です。
この記事はモデル選定のための対決記事ではありません。以下では、それが何なのか、どんな作業が得意なのか、使うといくらかかるのかの3点だけを解説します。ベンチマークは比較の参考にとどめ、どのモデルがどれに取って代わるかという結論は出しません。
この記事のポイント:読み終えると、能力の全体像、費用の見積もり、最短で使い始めるための手順がわかります。
LongCat 2.5の主要情報まとめ
| 項目 | 詳細 |
|---|---|
| リリース日 | 2026年11月1日(公式ブログ) |
| 位置づけ | 長期にわたるエージェントタスク向けのネイティブマルチモーダルモデル |
| 規模 | 総パラメータ数1.6T、トークンごとの活性化パラメータ数は約48B |
| 2.0からの進化 | ネイティブな視覚理解、エージェントによるプログラミング |
| コンテキスト / 最大出力 | 1Mトークン / 128Kトークン |
| インターフェース | OpenAI形式とAnthropic形式の両プロトコルに対応 |
| 料金(期間限定割引) | 入力 $0.30(キャッシュ未ヒット)/ $0.006(キャッシュヒット)、出力 $1.20。いずれも100万トークンあたり |
| 重み | GitHubとHuggingFaceの両方で「近日公開」とされており、まだ公開されていない |
活性化パラメータ数には、間違えやすい点があります。リリース当日、コミュニティの投稿には440Bと記載されたものもありましたが、公式ブログではトークンごとに約480億、つまり48Bとされています。この記事では、すべて48Bに統一して記載します。
LongCat 2.5とは:パラメータ、アーキテクチャ、ネイティブマルチモーダル機能
LongCat 2.5 の規模と学習方針
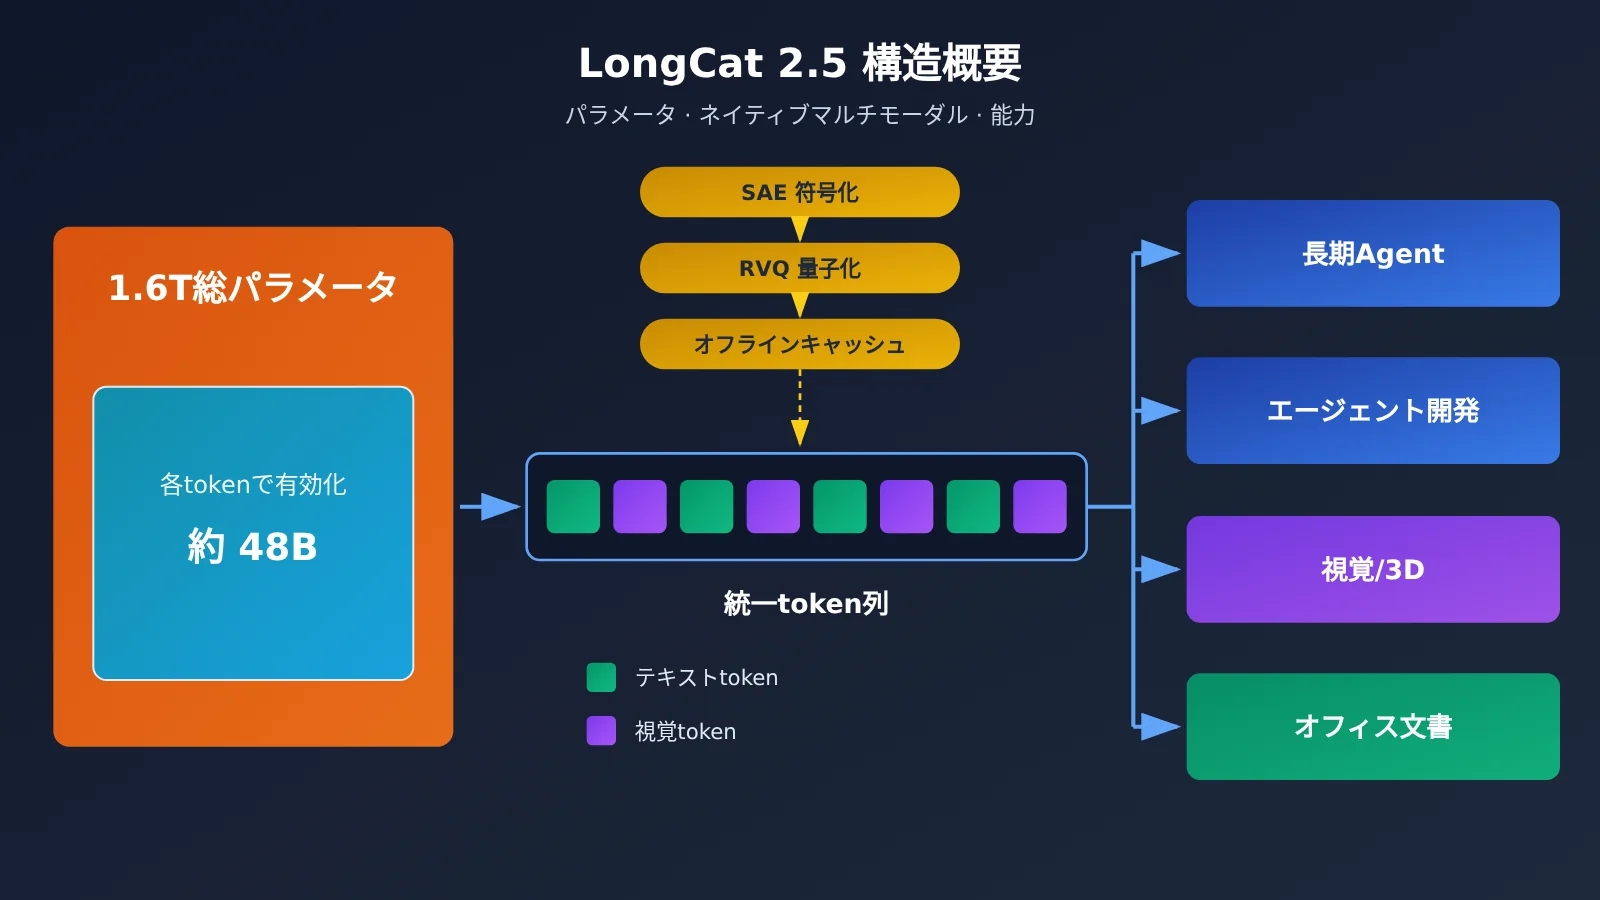
総パラメータ数は 1.6T(1.6兆)、活性化パラメータ数は約 48B(480億)です。つまり、全体の規模は大きいものの、1回の推論で使うのはその一部だけという、スパース活性化型の大規模言語モデルです。この構造により、知識を保持する容量と推論コストを両立しやすくなっています。後述する低価格を実現する前提の一つでもあります。
学習方針について、公式は「長期タスク」に直接関わる取り組みをいくつか挙げています。
- 長期軌跡データの拡充:長いシーケンスの学習に、より多くの長期軌跡を加え、大規模な長期強化学習を実施。「複雑なコードベースの開発」や「プロジェクト全体の構築」といった、エンドツーエンドのエンジニアリングタスクを訓練します。
- 実際の失敗軌跡を学習課題に変換:データ合成、環境構築、複数の Harness を横断した混合学習を並行して拡充し、実際の Agent の失敗軌跡を、再現・検証可能なタスクに変換します。
- 「考えすぎ」と「繰り返し呼び出し」を抑制:同じ思考やツール呼び出しの繰り返しに追加のペナルティを与えます。また、過度な思考や出力長が急速に伸びるケースに対して、正例への報酬(Reward)を再配分します。
3つ目は、Agent を使う場面で特に実用的です。長期タスクでは、モデルが同じツールを何度も呼び出して堂々巡りすることが、コスト増の大きな原因になりがちです。学習段階でこれを抑えれば、トークンの節約に直結します。
LongCat 2.5 のネイティブマルチモーダルはどう実現されているか
ここでいう「ネイティブマルチモーダル」には、具体的な意味があります。視覚信号を複数階層の離散トークンとして表現し、基幹モデルが視覚情報とテキストを統一されたトークン形式で処理します。「外付けの視覚エンコーダーを使い、後から特徴を組み込む」という方式ではありません。
公式は、この仕組みを3つの段階に分けて説明しています。
- ネイティブ解像度での視覚情報の離散化:意味的に整合させたエンコーダー(SAE)と残差ベクトル量子化(RVQ)を使い、画像を離散トークンに変換します。
- 視覚トークンのオフライン前処理:トークナイザーを固定した後、視覚トークンIDをオフラインで事前計算し、キャッシュできます。
- 共同学習:視覚埋め込みを基幹モデルと一緒に学習します。
公式によると、この設計により、モデルはVisual Codingで優れた性能を発揮し、クリエイティブデザインや3Dなどのタスクにも対応できるとしています。後のベンチマーク表にある3DCodeBenchとVision2Webは、こうした能力を測るものです。
LongCat 2.5 はなぜこの価格を実現できたのか
公式ブログでは、エンジニアリングの効率化に多くの紙幅を割いています。この部分を読むと、価格の理由が見えてきます。学習には中国国産の計算基盤を使用し、GPU 1枚あたりのメモリ容量が80GB未満という制約に対して、チームは二重シャーディングFSDP、混合語彙並列、動的エキスパート複製などの手法でメモリ使用量を抑えました。このFSDP構成では、長いシーケンスを扱うSFTタスクにおいて、GPU 1枚あたりのスループットがDDPベースラインを86%上回っています。
推論時にはW4A4を使い、エキスパートの重みと活性値をともに4bitへ量子化しています。公式のオンライン負荷テストでは、W8A8 INT8ベースラインと比べて、prefillスループットが43.3%向上、decodeスループットが42.77%向上、最初のトークンが生成されるまでの遅延(TTFT)が15.91%減少、トークンあたりの遅延(TPOT)が19.72%減少しました。スループットが4割以上向上すれば、トークンあたりのコストも自然と下がります。
LongCat 2.5 の強み:長期タスクをこなすエージェント能力と8つの公式事例
LongCat 2.0 から 2.5 への進化
まずは、前世代との比較を見てみましょう。以下の数値はLongCat公式による自己評価です。星印付きの比較項目は公開リーダーボードから引用されていますが、ここではLongCatの2世代のスコアのみを取り上げます。
- Terminal Bench v4.0:2.0は3.0、2.5は38.5。
- DeepSWE v1.1:2.0は9.7、2.5は64.6。
- Program Bench Almost Resolved:2.0は2.5、2.5は25.5。
- AutomationBench v1.0.6:2.0は15.8、2.5は51.8。
これらはいずれも、複数ステップにわたるターミナル操作、リポジトリ全体に及ぶ修正、自動化ワークフローといった長い工程を伴うタスクです。2.0のスコアはほぼゼロに近い水準でしたが、2.5では他モデルと比較できる水準まで伸びており、「エージェントによるプログラミング」能力が着実に向上したことがわかります。公式によると、LongCat-2.5の結果はすべて、thinkingを有効にし、temperature=1.0、top_p=0.95の条件で取得されています。
LongCat 2.5 の8つの公式デモ事例
公式は、エンドツーエンドで生成した8つの事例を2つのグループに分けて公開しています。なお、これらは公式デモであり、筆者が個別に再実行して検証したものではありません。
| カテゴリ | 事例 | 求められる能力 |
|---|---|---|
| ソフトウェア開発 | リアルタイム流体シミュレーション | 物理計算+フロントエンドでのリアルタイム描画 |
| ソフトウェア開発 | 文化財のインタラクティブな3D展示 | 3Dシーンの構築とインタラクションのロジック |
| ソフトウェア開発 | 都市ジオラマ | 大量のオブジェクトの配置と整理 |
| ソフトウェア開発 | ミニチュアシーンのアセット | 3Dアセット生成における細部の制御 |
| ビジネス業務 | 事業分析 | データの読み取り、指標の分解、結論の文章化 |
| ビジネス業務 | 顧客フィードバックの分析レポート | 非構造化テキストの分類と集計 |
| ビジネス業務 | 中国風の色彩美を表現したページ | 視覚的な美しさとWebページのレイアウト |
| ビジネス業務 | イベント招待状ジェネレーター | フォームのインタラクション+レイアウト設計 |
ソフトウェア開発グループの4事例のうち3つは3Dに直接関係しており、ネイティブな視覚能力とVisual Codingの方向性に対応しています。一方、ビジネス業務グループは「資料を読み、成果物を作る」作業が中心で、ベンチマークにおけるJobBenchやGDPValのようなタスクと方向性が一致しています。
LongCat 2.5のベンチマークスコアはどの位置にある?
公式の評価表には25項目以上があり、Code Agent、General Agent、Visualの3カテゴリに分かれています。ここでは9項目を選び、5つのモデルを比較します。
| Benchmark | LongCat-2.5 | Claude Opus 5 | GPT-5.6-Sol | GLM-5.3 | Kimi K3 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 89.1* | 88.8* | 88.2* | 88.3* |
| Terminal Bench v4.0 | 38.5 | 53.9* | 37.3* | 41.8* | 12.6* |
| DeepSWE v1.1 | 64.6 | 68.8* | 72.7* | 66.9* | 67.5* |
| BrowseComp | 91.9 | 90.8* | 90.4* | 81.0 | 91.2* |
| HLE w/tools | 63.1 | 64.7* | 58.0* | 62.5* | 56.0* |
| JobBench | 65.4 | 66.7* | 45.4* | 61.4* | 52.9* |
| MCP Atlas | 83.1 | 85.8* | 81.8* | 84.2* | 84.2* |
| 3DCodeBench Text to 3D | 55.4 | 54.3 | 52.3 | 53.4 | 49.3 |
| Vision2Web | 78.6 | 80.2* | 73.5* | 77.8* | 79.0* |
*付きのスコアは、公式が公開リーダーボードまたは技術レポートから引用したものです。それ以外はLongCatによる独自測定であり、比較の参考としてご覧ください。
数字からは、次のことが読み取れます。
- 検索系:BrowseCompは91.9で、5モデル中トップです。公式の測定では独自開発の軽量ハーネスを使用し、searchとbrowse_with_goalの2つのツールのみを有効にして、最大1024ターン実行しています。
- 3D生成:3DCodeBench Text to 3Dは55.4で、5モデル中トップです。ただし、この項目の5つのスコアにはいずれも星印がなく、すべてLongCatによる独自測定です。
- ターミナルタスク:Terminal Bench v2.1では、5モデルが88.2〜89.1の間に集中しています。一方、より難しいv4.0ではLongCat-2.5が38.5、Claude Opus 5が53.9で、15.4ポイントの差があります。
- リポジトリ単位の修正:DeepSWE v1.1は64.6で、5モデル中最も低いスコアです。GPT-5.6-Solは72.7でした。
- ツール呼び出しとオフィスワーク:MCP Atlasは83.1、JobBenchは65.4で、Opus 5との差はそれぞれ2.7ポイント、1.3ポイントです。
ハーネスにも注意が必要です。Terminal Benchの2バージョンではClaude Codeのハーネスを使用し、max_seq_lengthは512Kです。DeepSWEではmini-swe-agentを使用し、シーケンス長は1Mです。異なるハーネスで測定したスコアを、項目間で直接比較するのは適切ではありません。
LongCat 2.5 の料金は?他モデルとの比較と100万トークンの請求額
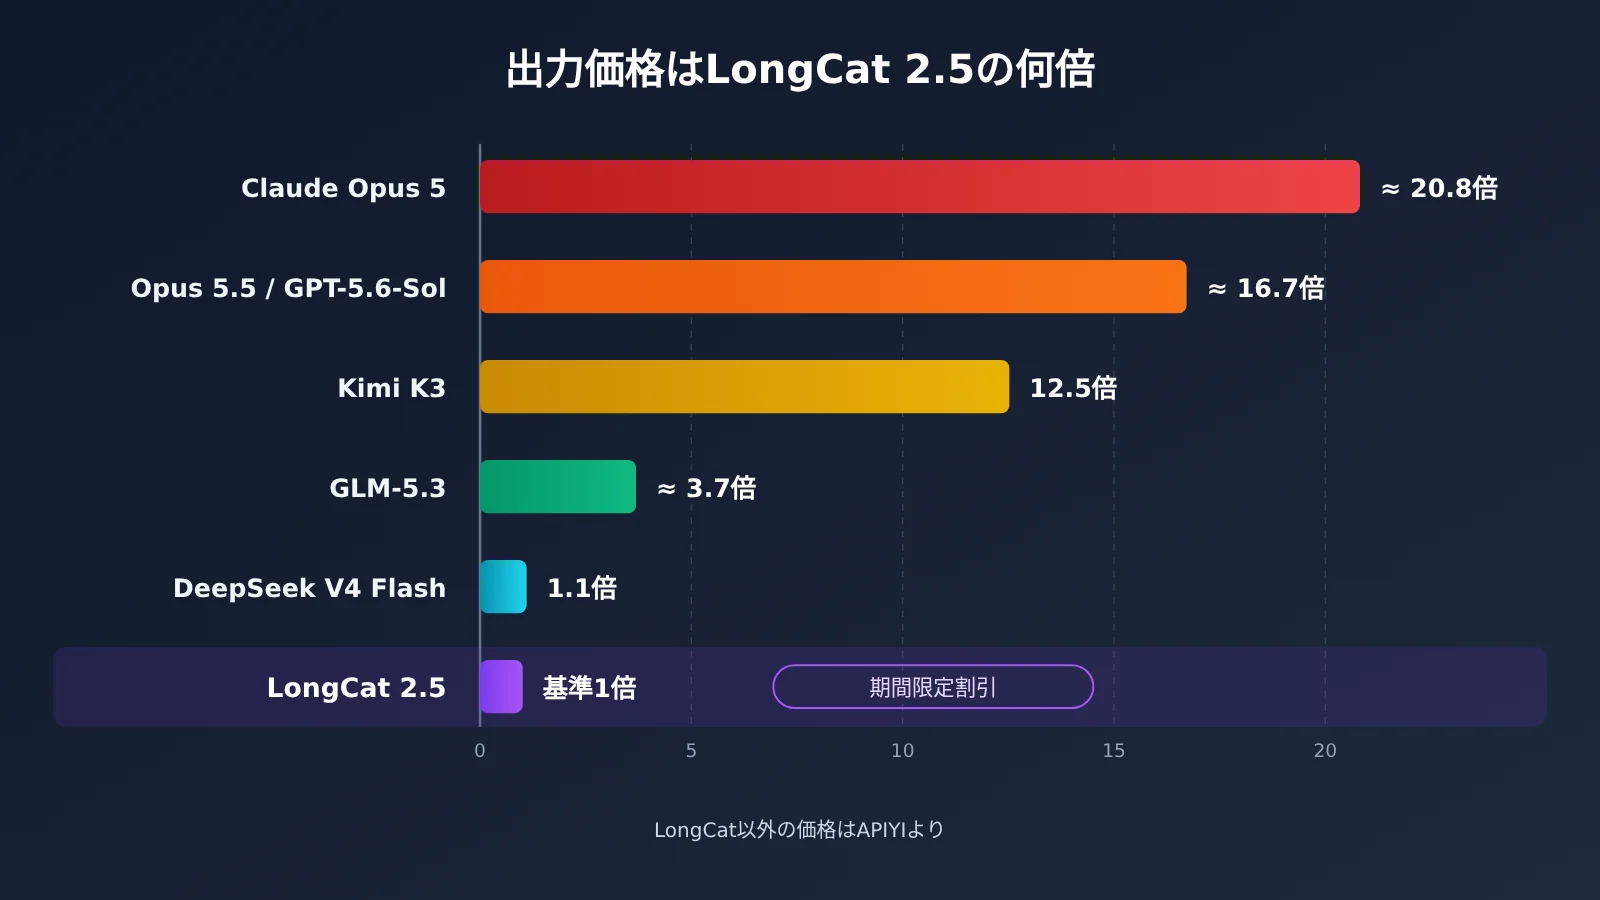
図注:LongCat-2.5 は公式 API プラットフォームの期間限定割引価格です。その他のモデルの料金は APIYI apiyi.com のモデル一覧を参照しています。
| モデル | 入力(100万トークンあたり) | 出力(100万トークンあたり) | 出力料金は LongCat の何倍 |
|---|---|---|---|
| LongCat-2.5(期間限定割引、公式プラットフォーム) | $0.30(キャッシュヒット時 $0.006) | $1.20 | 1 |
| Claude Opus 5 | $5 | $25 | 約20.8 |
| Claude Opus 5.5 | $4 | $20 | 約16.7 |
| GPT-5.6-Sol | $4 | $20 | 約16.7 |
| Kimi K3 | $3 | $15 | 12.5 |
| GLM-5.3 | $1.4 | $4.396 | 約3.7 |
| DeepSeek V4 Flash | $0.44 | $1.32 | 約1.1 |
APIYI apiyi.com の料金は2026年11月2日に確認したもので、当日のモデル一覧に表示された価格に基づきます。LongCat-2.5 の料金は LongCat API プラットフォームのもので、公式は価格が変更される可能性があると明記しています。
100万トークンの料金を計算
バッチ処理のタスクで合計100万トークンを使うと仮定します。内訳は入力80万、出力20万で、キャッシュは考慮しません。
- LongCat-2.5(期間限定割引):0.8 × $0.30 + 0.2 × $1.20 = $0.48
- DeepSeek V4 Flash:$0.352 + $0.264 = $0.616
- GLM-5.3:$1.12 + $0.879 ≈ $2.00
- Kimi K3:$2.40 + $3.00 = $5.40
- GPT-5.6-Sol または Claude Opus 5.5:$3.20 + $4.00 = $7.20
- Claude Opus 5:$4.00 + $5.00 = $9.00
同じタスクでも、Opus 5 の料金は LongCat-2.5 の約18.75倍です。キャッシュがヒットすれば、差はさらに広がります。公式の例では、入力100万トークン(キャッシュヒット40万、非ヒット60万)と出力50万トークンを使った場合、請求額は $0.18 + $0.0024 + $0.6 = $0.7824 です。キャッシュヒット時の入力料金は $0.006 で、非ヒット時の50分の1です。
料金に関しては、ほかにも2つ覚えておきたい点があります。課金されるのは HTTP 200 が返された場合のみで、401、403、429、500 などの失敗したリクエストには課金されません。また、残高は前払い式で有効期限はなく、無料クレジットがある場合はそちらから先に消費されます。
複数のモデルを手軽に比較するには
実際のところ、Agent プロジェクトで使うモデルが1つだけというケースはあまりありません。同じプロンプトを使って、LongCat-2.5 と Claude、GPT、GLM の出力の違いを比べたいこともあるでしょう。そんなとき、APIYI apiyi.com なら1つのアカウントと1つの APIキーでモデルを切り替えられます。各社で個別にアカウントを作成したり、入金したりする必要はありません。
📌 補足:モデルと料金は APIYI apiyi.com のモデル一覧をご確認ください。APIYI では現在 LongCat-2.5 を提供していませんが、近日中に提供予定です。
LongCat 2.5の始め方:公式サイトでの体験とAPI接続
ステップ1:まずはWeb版で試す
公式のオンライン体験サイトは longcat.ai/chat です。コミュニティの投稿によると、リリース期間中は新規ユーザーに10Mトークン、既存ユーザーに5Mトークンが自動付与され、キャッシュヒット分は付与された利用枠を消費しません。また、9.9元の期間限定特典パックも「近日公開」と案内されています。まずはベンチマークで上位に入った検索と画像理解のタスクを試してみるのがおすすめです。
ステップ2:API接続で押さえたい4項目
- OpenAI形式のエンドポイント:
https://api.longcat.ai/openai - Anthropic形式のエンドポイント:
https://api.longcat.ai/anthropic - modelフィールド:
LongCat-2.5 - コンテキストと出力:コンテキストウィンドウは1M、最大出力は128Kトークン
レート制限について、公式が明記しているのは、上限を超えるとHTTP 429が返され、エラーコードが rate_limit_exceeded、retry_after が60になることです。クライアント側では指数バックオフによるリトライが推奨されています。具体的なRPM、TPMは公開されていません。
すでにOpenAI SDKで別のモデルを呼び出している場合は、切り替え時にbase_url、api_key、modelの3か所を変更するだけです。たとえば、普段APIYIを利用している場合、base_urlは https://api.apiyi.com/v1 ですが、LongCat公式に切り替える際は https://api.longcat.ai/openai に変更し、modelを LongCat-2.5 にすればOKです。
ステップ3:Claude Codeに接続する
- Claude Codeの
~/.claude/settings.jsonのenvセクション:ANTHROPIC_AUTH_TOKENにLongCatのAPIキーを設定 - 同じファイルのenvセクション:
ANTHROPIC_BASE_URLにhttps://api.longcat.ai/anthropicを設定 - 同じファイルのenvセクション:
ANTHROPIC_MODELにLongCat-2.5を設定 - 同じファイルのenvセクション:
CLAUDE_CODE_MAX_OUTPUT_TOKENSに131072を設定 - 同じファイルのenvセクション(一緒に変更することを推奨):
ANTHROPIC_SMALL_FAST_MODEL、ANTHROPIC_DEFAULT_SONNET_MODEL、ANTHROPIC_DEFAULT_OPUS_MODELをすべてLongCat-2.5に設定
最後の3つの変数を変更しないと、Claude Code内部のサブタスクがデフォルトのモデルにリクエストを送り、エラーや意図しない課金につながる可能性があります。
ステップ4:Clineに接続する
- ClineのVS Codeサイドバーにある設定パネル:API ProviderでOpenAI互換のオプションを選択
- 同じパネル:Base URLに
https://api.longcat.ai/openaiを入力 - 同じパネル:API KeyにLongCatのAPIキー、Model IDに
LongCat-2.5を入力
LongCatの公式ドキュメントには、Cline専用の接続ページが用意されています。フィールド名は公式ページを確認してください。このほか、Codex、OpenCode、Kilo Code、Cherry Studio、Chatbox、CC Switchなど、10種類以上のツール向けの接続ページもあります。
🚀 スムーズに始めるコツ:まずは公式の付与枠を使ってタスクを一通り動かし、継続して利用するかを判断しましょう。Claude、GPT、Geminiも呼び出して比較したい場合は、APIYI(apiyi.com)のOpenAI互換インターフェースでまとめて管理できます。今後LongCat-2.5が提供開始されれば、同じアカウント内で直接切り替えられます。
LongCat 2.5 が向いている作業
| LongCat 2.5 に任せたい作業 | まずは慎重に検討したい作業 |
|---|---|
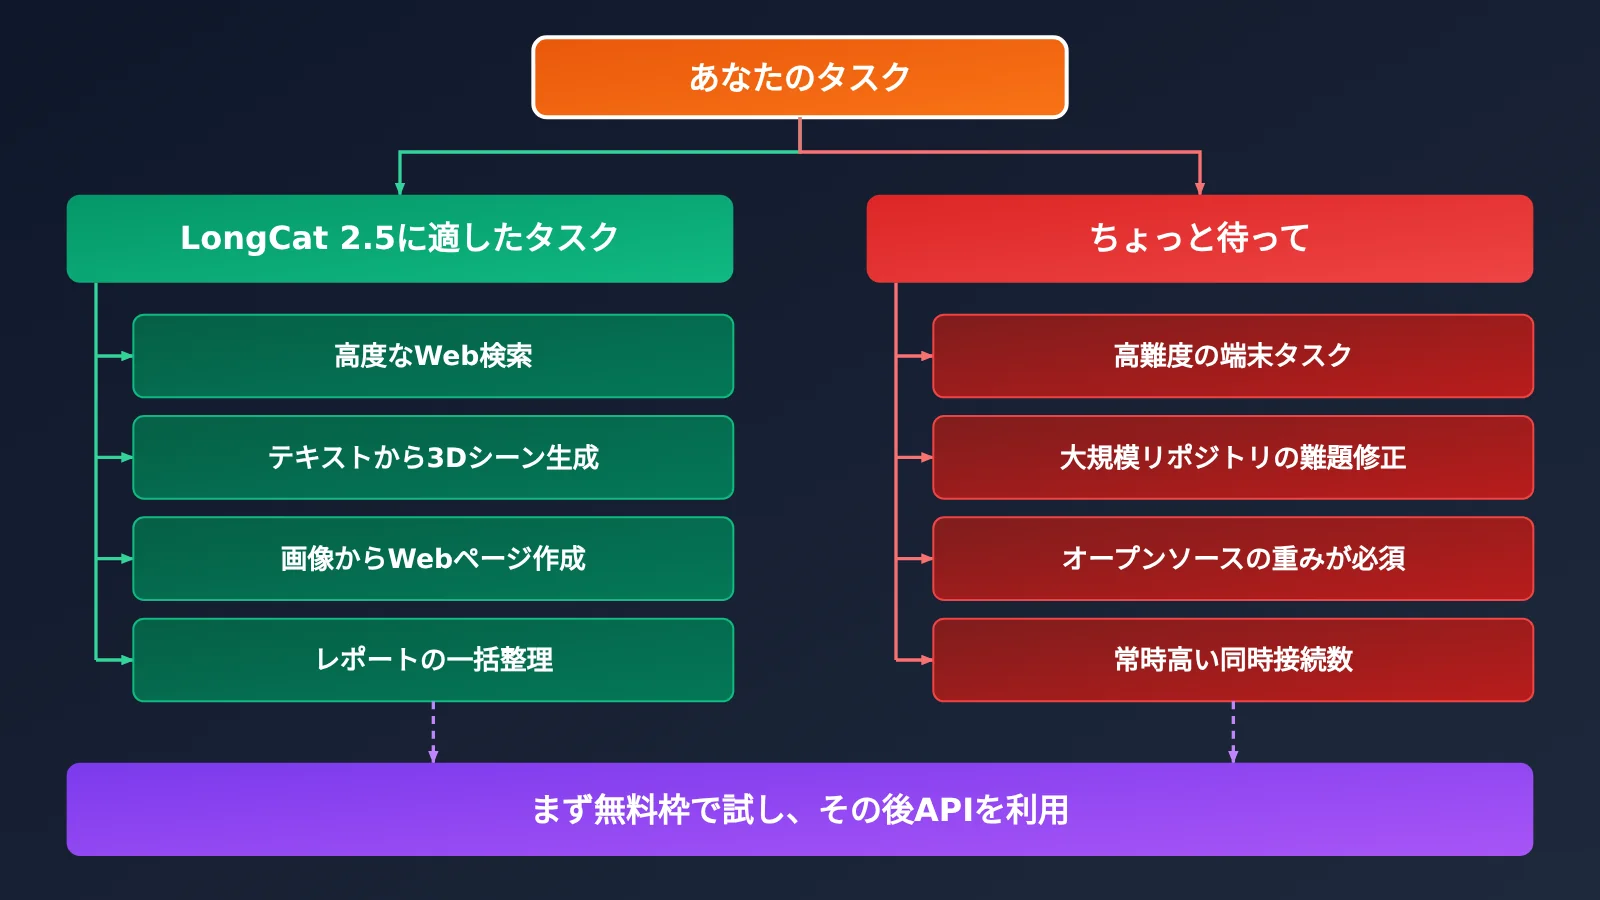
| 複数回にわたるWeb検索と資料のまとめ(BrowseComp 91.9) | 難度の高い複数ステップのターミナル運用作業(Terminal Bench v4.0 は 38.5、Opus 5 は 53.9) |
| テキストで説明して Three.js などの3Dシーンを生成(3DCodeBench 55.4) | 大規模リポジトリの難しいバグ修正(DeepSWE v1.1 は 64.6 で、5列中最低) |
| デザイン案やスクリーンショットに合わせたWebページの作成(Vision2Web 78.6) | プライベート環境へのデプロイが必須で、ローカルで使える重みが必要なプロジェクト(重みはまだ公開されていない) |
| 顧客からのフィードバックや経営データをまとめて文章化(JobBench 65.4、出力は期間限定割引で100万トークンあたり $1.20) | 固定の高い並列処理枠が必要な本番サービス(公式は RPM/TPM を公開していない) |
左列に共通するのは、作業が長く、トークン量が多く、単価が重要になることです。LongCat-2.5 はスコアと価格の両面で有力な選択肢です。右列の作業は、できないというわけではありません。ただ、スコアに明らかな差があるか、デプロイや利用枠の条件がまだ明確でないため、まずは小規模に試すのがおすすめです。
LongCat 2.5 よくある質問(FAQ)
Q1:LongCat 2.5 のベンチマークスコアは第三者が測定したものですか?
いいえ。表に記載された LongCat-2.5 自体のスコアは、すべて LongCat 公式による測定結果です。比較対象モデルのうち、星印付きのスコアは公開レポートや公式ランキングから引用され、星印のないものは LongCat による測定結果です。モデル間の比較の目安としてご覧ください。
Q2:100万トークンあたり $1.20 は長期的な価格ですか?
いいえ。公式では期間限定の割引価格とされており、価格が変更される可能性もあると説明されています。LongCat API プラットフォームのページと請求内容をご確認ください。長期的な予算を立てる際は、代替モデルも用意し、APIYI apiyi.com のような集約プラットフォームを通じて切り替えられるようにしておくとよいでしょう。
Q3:LongCat 2.5 はオープンソースですか?
まだ公開されていません。公式ブログの GitHub と HuggingFace のボタンには、どちらも「近日公開」と表示されています。現在利用できるのはオンラインでの体験と API 接続のみで、公式はオープンソース化の予定時期を明らかにしていません。
Q4:APIYI で LongCat 2.5 を呼び出せますか?
現時点では利用できませんが、APIYI はできるだけ早くこのモデルを提供する予定です。現在は LongCat の公式 API を直接利用できます。Claude、GPT、GLM の比較テストを行う場合は、APIYI apiyi.com で1つの APIキーを使って他のモデルを試せます。利用可能なモデルと価格は、プラットフォームのモデル一覧をご確認ください。
Q5:429 エラーが出た場合はどうすればよいですか?
レート制限に達したことを示しています。レスポンスには `retry_after` の値として 60 が返されます。公式はクライアント側で指数バックオフによる再試行を行うことを推奨しています。また、429 が返されたリクエストは課金対象にならないため、追加料金は発生しません。
まとめ:LongCat 2.5 を導入する価値はある?
LongCat 2.5 の主なポイント:
- 位置づけ:総パラメータ数 1.6T、トークンごとの活性化パラメータ数が約 48B のネイティブマルチモーダルモデル。長時間にわたるエージェントタスクを得意とします。
- 進化:2.0 と比べ、Terminal Bench v4.0 は 3.0 から 38.5 に、DeepSWE v1.1 は 9.7 から 64.6 に向上しました。
- 強み:BrowseComp で 91.9、3DCodeBench で 55.4 を記録。この記事で比較した 5 モデルの中で最高です(公式発表値)。
- 課題:Terminal Bench v4.0 と DeepSWE v1.1 では、まだ目に見える差があります。
- 料金:期間限定割引では出力が 100 万トークンあたり $1.20。入力 80 万トークンと出力 20 万トークンの料金は約 $0.48 です。
- 導入:OpenAI と Anthropic の両プロトコルに対応。Claude Code は 4 つの変数を変更するだけで利用できます。
結論として、まずは longcat.ai/chat で提供される 10M の無料枠を使い、検索や画像理解のタスクを試してみましょう。問題なく動作することを確認してから API を利用するのがおすすめです。長期的に複数のモデルを切り替えて使うなら、APIYI(apiyi.com)でまとめて管理できます。
📚 参考資料
- LongCat 公式ブログ:LongCat-2.5 のリリース記事。アーキテクチャ、学習、評価表を掲載
- リンク:
longcat.ai/blog/longcat-2.5 -
内容:パラメータ規模、8 件のデモ事例、ベンチマーク結果の一次情報
-
LongCat API プラットフォームドキュメント:インターフェース、料金、ツール連携
- リンク:
longcat.ai/platform/docs -
内容:両プロトコルのエンドポイント、期間限定割引価格、Claude Code と Cline の連携ページ
-
APIYI モデル一覧:各モデルのプラットフォーム価格
- リンク:
docs.apiyi.com/models - 内容:この記事で比較した価格の出典。価格は当日の表示をご確認ください
著者:APIYI 技術チーム
技術交流:APIYI のサイトトップページからお気軽にお問い合わせください。その他の資料は docs.apiyi.com のドキュメントセンターをご覧ください。