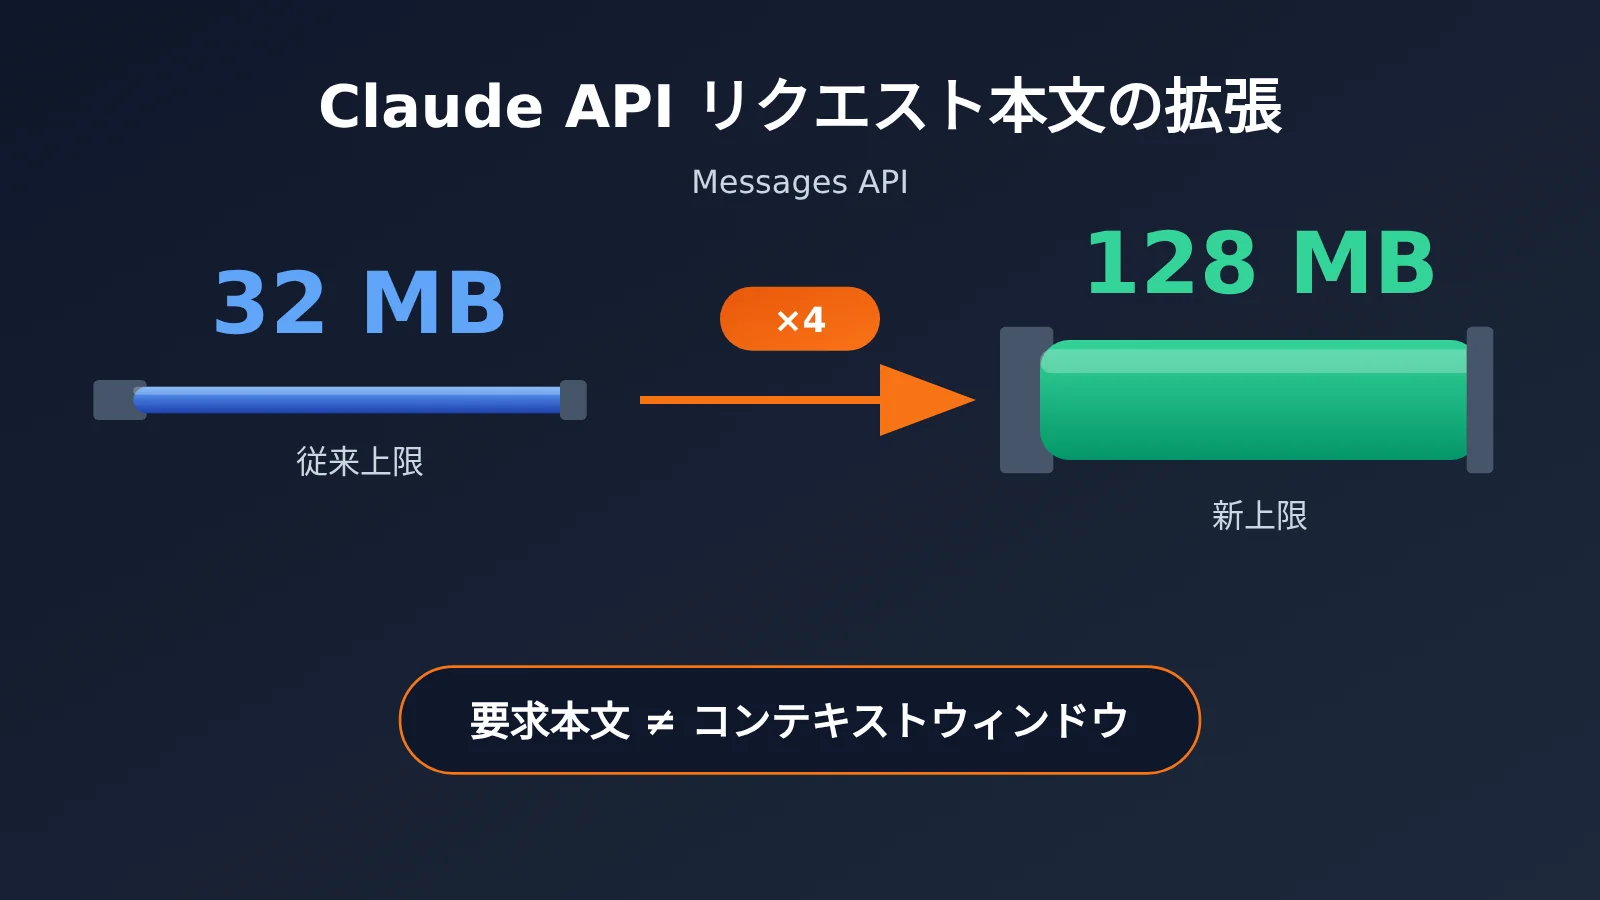
2026年10月28日、Anthropicは公式リリースログで、第一者提供のClaude APIにおけるMessages APIとToken Counting APIの最大リクエストボディサイズを、32 MBから128 MBに引き上げたと発表しました。上限は従来の4倍です。この発表を受け、多くの企業の技術責任者が、ある実務上の疑問を抱いています。32 MBの制限を回避するために設計した大容量ファイルの分割、アップロード、前処理のフローを、今こそ見直すべきなのでしょうか?
これは「モデルの性能が上がった」アップデートではありません。変更されたのはHTTPレベルのリクエストボディサイズの上限であり、モデルのコンテキストウィンドウや出力長とは関係ありません。128 MBを128Kトークンや1Mトークンと混同することが、誤解の原因になっています。
この記事のポイント:まず、Claude APIのリクエストボディ拡張によって、どの制限が変わったのかを整理します。そのうえで、業務シーンに応じたA・B・Cの3つの判断パターンを示し、最後に低コストで実行できる検証計画とチェックリストを紹介します。本文中のアーキテクチャに関する提案は、公式情報に基づく技術的な分析であり、Anthropicが公開した公式の移行手順ではありません。
Claude APIのリクエストボディ拡大:重要ポイント
まずは今回のClaude APIのリクエストボディに関する変更点を表にまとめます。以降の解説は、この情報を前提としています。
| 項目 | 詳細 | 出典 |
|---|---|---|
| 発表日 | 2026年10月28日 | 公式リリースログ(S1) |
| 発表元 | Anthropic | 公式リリースログ(S1) |
| 対象エンドポイント | Anthropic公式Claude APIのMessages API、Token Counting API | S1、S2 |
| 主な変更 | リクエストボディの最大サイズを32 MBから128 MBに引き上げ | S1、S2 |
| 変更されない点 | モデルのコンテキストウィンドウ、出力長は拡大されない | S2、S5 |
| 上限超過時の動作 | HTTP 413 request_too_large エラーを返す |
S2 |
| 課金方式 | 引き続きトークン使用量に応じた課金。リクエストボディが大きくなっても、ファイル処理が無料になるわけではない | S6 |
Claude APIのリクエストボディ上限はエンドポイントごとに異なる
特に注意したいのは、Anthropic公式Claude APIのリクエストサイズの上限が、エンドポイントごとに異なることです。今回変更されたのはMessagesとToken Countingの2つのエンドポイントだけで、その他はそれぞれ従来の制限が維持されています。企業がアーキテクチャを検討する際は、1つの数字だけを見て判断することはできません。
| エンドポイント | 現在のリクエストサイズ上限 | 説明 |
|---|---|---|
| Messages API | 128 MB | 今回32 MBから引き上げ |
| Token Counting API | 128 MB | 今回32 MBから引き上げ。Messagesと同じ上限 |
| Batch API | 256 MB | バッチによる非同期処理向け |
| Files API | 500 MB | ファイル単位の保存上限は500 MB |
| Sessions / Agents / Environments | 32 MB | 従来の制限を維持 |
出典は公式API概要ドキュメント(S2)です。MessagesとAgents系のエンドポイントを併用する場合は、それぞれのサイズ上限を考慮して別々に設計する必要があります。どちらも一律に128 MBとして扱うことはできません。
Claude APIのリクエストボディ拡張で変わる制限とは
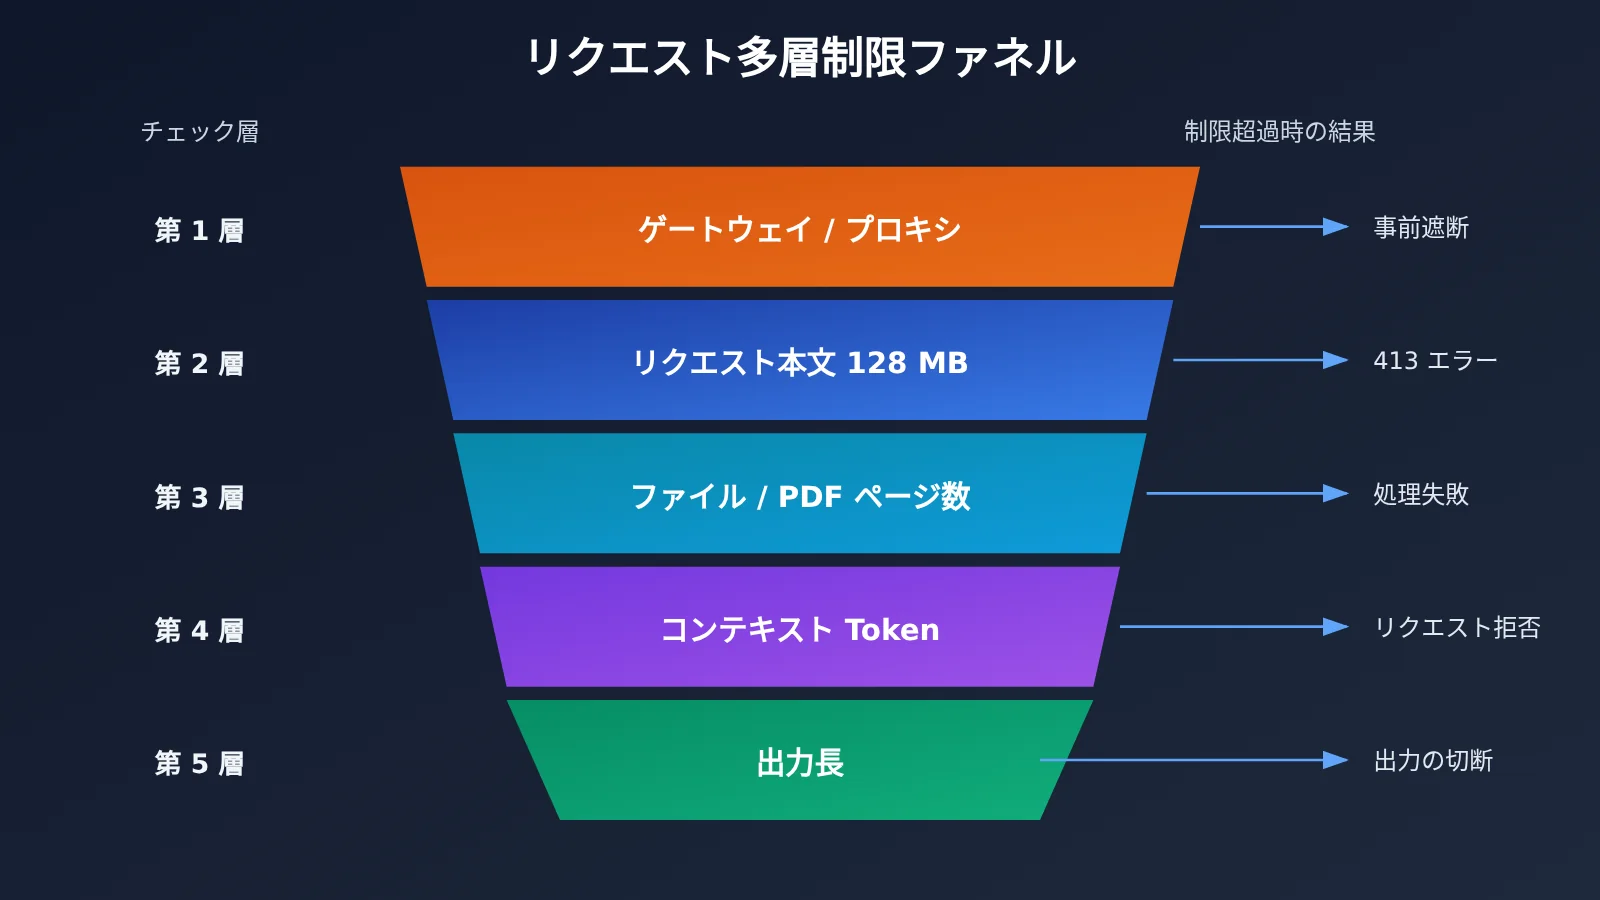
Claude APIへのリクエストは、実際にはいくつもの「関門」を通過します。リクエストボディのサイズは、その最も外側にある制限にすぎません。アーキテクチャの変更が必要かどうかを判断するには、それぞれの制限を区別することが大切です。
| 制限の種類 | 単位 | 今回の変更 | 超過した場合 |
|---|---|---|---|
| HTTPリクエストボディのサイズ | バイト(MB) | あり。Messages / Token Countingは128 MBに拡張 | HTTP 413 request_too_large |
| モデルのコンテキストウィンドウ | トークン | なし | リクエストが拒否される、または切り詰めが必要になる |
| ファイルとPDFの制限 | ファイルサイズ、ページ数 | PDFのリクエストボディは128 MBに制限。ページ数にも別途制限あり | ファイル全体を処理できない |
| 出力長 | トークン | なし | 出力が切り詰められる |
リクエストボディが128 MBでも、モデルが128 MBを「理解できる」とは限らない
リクエストボディのサイズはネットワークで転送するバイト数を表し、コンテキストウィンドウはモデルが一度に処理できるトークン数を表します。高解像度の画像は数MBを占めても、トークンに換算するとそれほど多くない場合があります。一方、数百KBのテキストでも、トークン数がコンテキストの上限に迫ることがあります。つまり、「より多くのバイトを送れること」と「モデルがより多くの内容を理解できること」は別の話です。
また、画像やPDFなどのバイナリデータは、JSONリクエスト内では通常base64でエンコードする必要があり、エンコード後のサイズは元の約4/3に膨らみます。そのため、128 MBのリクエストボディに収められる元のバイナリファイルは、128 MBよりもかなり小さくなります。サイズを見積もる際は、このオーバーヘッドも考慮しましょう。
Claude APIのリクエストボディとPDFのページ数制限の関係
公式のPDFドキュメント(S3)によると、ファーストパーティのインターフェースでPDFを処理する場合、リクエストボディの制限は128 MBですが、ページ数にも別途制限があり、具体的な上限は使用するモデルのコンテキストウィンドウによって異なります。つまり、100 MBのスキャン済み契約書がHTTP層を問題なく通過できても、ページ数やトークン数がコンテキストの上限を超えると、全体を処理できない可能性があります。
Claude APIのリクエストボディ拡張で恩恵を受ける可能性のある企業向けアプリケーション
以下の分析は、従来の32 MBというリクエストボディの上限が、実際に業務上のボトルネックになっていた場合を前提とした推測です。この前提に当てはまる場合でも、分割処理が不要になるとは限りません。
- 大容量PDFや契約書の分析:法務や監査の業務では、スキャンした契約書や複数の添付ファイルを含む報告書を送信することがあります。スキャン文書はファイルサイズが大きい一方、文字数は比較的少なめです。これまでの主な障害が32 MBを超えるファイルサイズだった場合、上限の拡張によって一度に送信できる可能性があります。ただし、ページ数やコンテキストのトークン数が障害だった場合、改善は限定的です。
- 複数の画像やページを含む資料の送信:保険金の請求や品質検査・巡回点検などでは、1回のリクエストに多数の現場写真を添付することがあります。画像が増えると従来の上限を超えやすくなりますが、上限の拡張によって413エラーが発生する可能性を減らせます。ただし、画像の枚数自体は引き続きモデルやコンテキストの制約を受けます。
- 長い構造化データを含むAIアプリケーション:大量のJSON、ログ、表データをリクエストに直接含めるシステムもあります。バイト数の上限には余裕が生まれますが、こうしたデータはトークン密度が高いことが多く、128 MBに達する前にコンテキストウィンドウの上限に達しやすい傾向があります。
- 32 MBの上限を理由に入力を分割していた業務:最も直接的に恩恵を受けるケースです。リクエストボディの制限を回避することだけが分割の理由だったなら、分割が必要かどうかを改めて検討する価値があります。
🎯 技術的なアドバイス:これらのケースを評価する際は、まず実際のサンプルで「バイト数」と「トークン数」を測定し、どこがボトルネックになっているかを判断しましょう。APIYI(apiyi.com)では、同じAPIキーを使ってClaudeやその他の主要モデルを呼び出し、比較テストができます。ただし、サードパーティのプラットフォームでは、リクエストボディの上限が公式APIと異なる場合があります。本番環境に導入する前に、現在サポートされている上限を確認してください。
Claude APIのリクエストボディ上限拡大後、既存アーキテクチャの変更は必要? A・B・Cの3パターンで判断
この記事で最も重要な判断の枠組みです。アーキテクチャを調整する必要があるかどうかは、「公式の上限が大きくなった」ことではなく、「もともとの設計が何を解決するためのものだったか」によって決まります。
| ケース | 典型的な特徴 | 推奨する対応 | 優先度 |
|---|---|---|---|
| A. 32 MBに近づいたことがない | リクエストボディは通常数MBで、ログに413エラーがない | 現状を維持し、今回の変更を記録する | 低 |
| B. リクエストボディが原因で頻繁に413エラーが発生する | 監視データで413 request_too_large の割合が目立つ |
アップロード経路をテスト・最適化し、分割を減らせるか検討する | 高 |
| C. コンテキスト、精度、性能、費用のために分割している | 検索精度の向上、コスト管理、遅延の低減を目的に分割している | 分割、検索、キャッシュの設計を維持する | 変更なし |
ケースA:32 MBに近づいたことがないシステム
純粋なテキスト対話、カスタマーサポートのQ&A、コーディング支援などのアプリケーションでは、1回のリクエストボディは通常32 MBを大きく下回ります。こうしたシステムを積極的に変更する理由はなく、無理に改修すれば新たなリスクが生じるだけです。今後のトラブルシューティングに備えて、技術ドキュメントのエンドポイント上限情報を更新しておけば十分です。
ケースB:リクエストボディの制限により頻繁に413エラーが発生するシステム
監視データで413エラーが集中して発生しており、その原因がMessagesエンドポイントのリクエストボディ上限超過だと確認できた場合は、今回の更新をテストする価値があります。分割処理の一部を1回の送信にまとめたり、Files APIの file_id を使った参照方式に切り替えたりして、重複するデータ転送を減らせるか検討しましょう。
ケースC:品質、コスト、性能のために分割しているシステム
多くのRAGシステムがデータを分割するのは、リクエストが大きすぎて送信できないからではありません。検索精度を高め、呼び出しごとのトークン数を抑え、応答を速くするためです。リクエストボディの上限が拡大しても、これらの目的は変わりません。この場合、分割をやめるとかえってコストが上がり、回答の品質が下がる可能性があります。必要な分割、検索、キャッシュの設計は維持しましょう。
Claude APIのリクエストボディ拡大前に確認したい5つのポイント
ケースBに該当する場合も、以下の順番で各レイヤーを確認することをおすすめします。公式の上限が引き上げられた後もエラーが発生する場合、その原因は中間経路にあることが少なくありません。
- Anthropicの対象エンドポイントの公式上限を確認する:Messagesは128 MBですが、Sessions / Agents / Environmentsは引き続き32 MB、Batchは256 MB、Filesは500 MBです(S2)。
- APIゲートウェイとリバースプロキシのリクエスト制限を確認する:企業が自社運用するゲートウェイ、Nginx、ロードバランサー、WAFには、それぞれデフォルトの上限が設定されていることがあります。128 MBを大きく下回る場合もあるため、一つずつ確認しましょう。
- クライアント、SDK、転送方式を確認する:HTTPクライアントのタイムアウト、メモリバッファ、アップロード方式は、サイズの大きなリクエストを送信できるかどうかに影響します。base64エンコードによるデータサイズの増加も考慮しましょう。
- トークン、コンテキスト、ファイルにそれぞれ適用される制約を確認する:Token Counting APIでトークン数を見積もり、PDFのページ数やコンテキストウィンドウの制限内に収まるか確認します(S3、S5)。
- レイテンシ、タイムアウト、コスト、エラー処理を評価する:大きなリクエストはアップロードに時間がかかり、失敗時の再試行コストも高くなります。料金は引き続きトークン数に基づいて計算されるため(S6)、タイムアウトと再試行の戦略を見直す必要があります。
Claude APIのリクエストボディ以外の選択肢
大きなファイルをリクエストボディに直接含める方法のほかにも、検討したい選択肢があります。
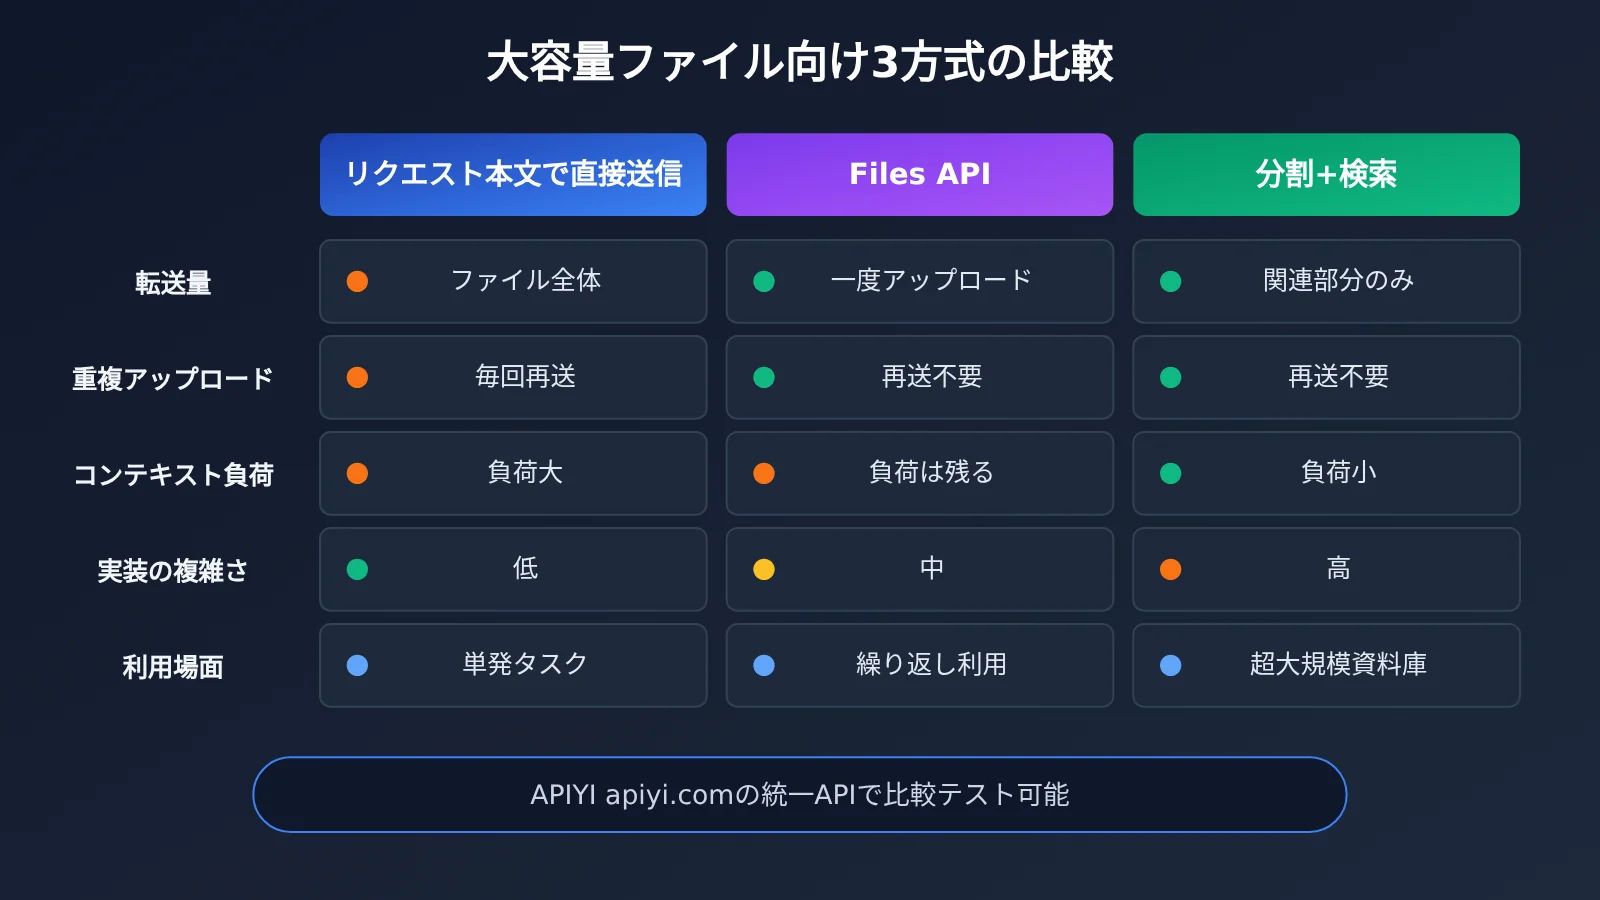
- Files APIと
file_idによる参照:ファイルを先にアップロードし、メッセージ内でfile_idを使って参照します。これにより、同じファイルを複数のリクエストで繰り返し転送せずに済みます(S4)。保存できるファイルの上限は1ファイルあたり500 MBですが、モデルが処理する際には引き続きコンテキスト容量などの制限を受けます。 - プロンプトキャッシュ:繰り返し利用する長文ドキュメントのプレフィックスでキャッシュを有効にすると、入力の重複によるコストを抑えられる可能性があります。具体的な課金ルールは公式の料金ページ(S6)を確認してください。
- 分割+検索の活用:非常に大きな資料群では、検索して関連する部分だけを送る方法が、品質とコストのバランスを取りやすい選択肢です。
マルチテナント環境でのファイル分離リスクも見逃せません。Files APIではファイルがAPIアカウント単位で保存されます。複数の顧客が同じアカウントを共有する場合は、アプリケーション層でfile_idへのアクセス権限を厳格に分離し、テナントAのリクエストがテナントBのファイルを参照しないようにする必要があります。
Claude API のリクエストボディ上限引き上げによる効果を低コストで検証するには
現時点では、上限の引き上げによって処理速度が向上した、あるいはコストが下がったことを示す、公開可能な実測データはありません。そのため、自社の業務サンプルで一度テストするのが最も確実です。以下はテスト結果ではなく、テスト計画です。
| テスト段階 | リクエストボディのサイズ | 確認ポイント |
|---|---|---|
| 段階 1 | 32 MB を大きく下回る | ベースラインとして通常の処理時間と Token 数を記録 |
| 段階 2 | 32 MB に近い | 従来の上限付近で通信経路が安定しているか確認 |
| 段階 3 | 32 MB を超える | ゲートウェイや SDK がリクエストを通すか、413 エラーが発生するか確認 |
| 段階 4 | 128 MB に近い | タイムアウト、メモリ使用量、失敗時の再試行コストを確認 |
各段階のデータは、モデルとファイルに適用される制限の範囲内で用意し、HTTP リクエストのサイズ、Token 数、ステータスコード、処理時間、費用、結果の品質を記録します。そのうえで、同じサンプル群を使って「直接送信」「Files API 参照」「分割処理」の3つの方法をそれぞれ試し、データに基づいて既存のフローを変更する必要があるか判断します。
Claude API のリクエストボディを測定するシンプルな例
以下のコードは、送信前にリクエストボディのバイト数を測定し、413 エラーを捕捉することで、テストデータを記録しやすくします。
import json, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "user", "content": "请总结这份长文档的要点:" + open("doc.txt").read()}]
body_mb = len(json.dumps({"messages": messages}).encode("utf-8")) / 1024 / 1024
print(f"请求体约 {body_mb:.2f} MB")

resp = client.chat.completions.create(model="YOUR_CLAUDE_MODEL", messages=messages)
print(resp.usage)  # 记录 Token 用量
テスト記録用の完全なスクリプトを見る
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 通过 APIYI 统一接口调用
)

MODEL = "YOUR_CLAUDE_MODEL"  # 替换为平台模型列表中的 Claude 模型名

def run_case(case_name: str, messages: list) -> dict:
    """记录单次请求的体积、Token、状态、耗时,用于方案对比"""
    body = json.dumps({"model": MODEL, "messages": messages}).encode("utf-8")
    record = {
        "case": case_name,
        "body_mb": round(len(body) / 1024 / 1024, 2),
        "status": None,
        "latency_s": None,
        "prompt_tokens": None,
        "completion_tokens": None,
    }
    start = time.time()
    try:
        resp = client.chat.completions.create(model=MODEL, messages=messages)
        record["status"] = 200
        record["prompt_tokens"] = resp.usage.prompt_tokens
        record["completion_tokens"] = resp.usage.completion_tokens
    except openai.APIStatusError as e:
        record["status"] = e.status_code  # 413 即请求体超限
    except Exception as e:
        record["status"] = f"error: {e}"
    record["latency_s"] = round(time.time() - start, 2)
    return record

if __name__ == "__main__":
    text = open("doc.txt", encoding="utf-8").read()
    cases = {
        "baseline": [{"role": "user", "content": "总结要点:" + text[:20000]}],
        "full_direct": [{"role": "user", "content": "总结要点:" + text}],
    }
    results = [run_case(name, msgs) for name, msgs in cases.items()]
    for r in results:
        print(r)
🚀 クイックスタート:まずはチームでテストの流れを試したい場合、APIYI の apiyi.com に登録してテスト用の利用枠を取得し、上記のスクリプトで各段階のデータを記録できます。なお、サードパーティのプラットフォームを経由する場合、そのゲートウェイのリクエストボディ上限は、公式の 128 MB より低い可能性があります。大容量のテストを行う前に、プラットフォームのドキュメントを確認してください。
よくある質問 FAQ
Q1: Claude APIのリクエストボディが128 MBに拡張されたとは、具体的にどういうことですか?
公式のClaude APIにおいて、Messages APIとToken Counting APIの1回のHTTPリクエストの最大サイズが、32 MBから128 MBに引き上げられたということです(S1、S2)。コンテキストウィンドウや出力長の拡張ではありません。
Q2: 128 MBのリクエストボディと、128K Token・1M Tokenのコンテキストにはどのような違いがありますか?
前者はネットワークで転送するデータ量をバイト単位で測り、後者はモデルが処理できる容量をToken単位で測るもので、単位がまったく異なります。リクエストボディを送信できても、すべての内容がコンテキストウィンドウに収まるとは限りません。Token量は引き続き、Token Counting APIで別途見積もる必要があります。
Q3: 拡張によって処理速度は上がり、コストは下がりますか?
それを裏付ける公式データや公開された実測結果はありません。料金は引き続きTokenの使用量に応じて計算されます(S6)。また、リクエストボディが大きくなると、アップロードにかかる時間が長くなる可能性もあります。メリットがあるかどうかは、実際の業務データでテストして判断する必要があります。
Q4: Claude APIのリクエストボディの変更が業務に与える影響を、APIですばやく検証するにはどうすればよいですか?
本記事の4段階のテスト計画に沿って実施できます。APIYI(apiyi.com)に登録してAPIキーを取得したら、base_urlを `https://api.apiyi.com/v1` に設定し、テストスクリプトでサイズ、Token数、ステータスコード、所要時間を記録します。プラットフォームの制限は公式とは異なる場合があるため、大容量のテストを行う前に、プラットフォームがサポートする上限を確認してください。
Q5: すでに構築したRAGのチャンク分割システムは撤去する必要がありますか?
通常は必要ありません。検索精度の向上、Tokenコストの管理、レイテンシの低減を目的としてチャンク分割を行っている場合、リクエストボディの拡張後もその必要性は変わりません。32 MBの制限を回避することだけが分割の理由だった場合は、見直しを検討する価値があります。
Q6: Claude APIのリクエストボディ拡張には、どのような制限がありますか?
主に3点あります。Sessions / Agents / Environmentsのエンドポイントは引き続き32 MBに制限されています。PDFのページ数とコンテキストウィンドウにも別途制約があります。また、企業のゲートウェイやプロキシ、サードパーティのプラットフォームでは、上限がさらに低く設定されている場合があります。大容量の文書を扱う際の複数モデルの性能を比較したい場合は、APIYI(apiyi.com)の統一インターフェースを利用できますが、プラットフォームが実際にサポートする上限を確認してください。
Claude APIのリクエストボディ拡張:重要なポイント
- 変更の本質:MessagesとToken Countingのリクエストボディ上限が32 MBから128 MBに引き上げられました。これはHTTP層の変更です。
- 変わらないもの:コンテキストウィンドウ、出力長、トークンの課金方式に変更はありません。
- エンドポイントごとの差:Batchは256 MB、Filesは500 MB、Agents系のエンドポイントは引き続き32 MBです。
- 判断のポイント:既存の分割処理がサイズ制限を回避するためなのか、品質・コスト・性能のためなのかを確認しましょう。
- 通信経路の確認:ゲートウェイ、プロキシ、SDKの制限は、公式の上限より先に適用されることがよくあります。
- 検証方法:4つのサイズ帯で、直接送信・ファイル参照・分割の3方式を比較します。APIYI apiyi.comの統一インターフェースを使ってテストすることもできます。
まとめ:Claude APIのリクエストボディが大きくなっても、既存システムを作り直す必要はありません
今回のClaude APIのリクエストボディ拡張で押さえておきたい点は、次の3つです。
- 入口が大きくなった:公式のMessages APIで一度に送信できるバイト数が増え、これまで413エラーに悩まされていた用途にも余裕が生まれました。
- ほかの制限は変わらない:コンテキストウィンドウ、PDFのページ数、トークン課金、ほかのエンドポイントの制限は、それぞれ確認する必要があります。
- 変更の要否はボトルネック次第:アーキテクチャの変更は、このニュースだけを理由にするのではなく、実際の業務上のボトルネック、結果の品質、コスト、セキュリティ要件に基づいて判断しましょう。
多くの企業にとっては、まずログを確認し、次にサンプルでテストして、最後に変更範囲を決めるのが堅実な進め方です。以下は、そのまま使えるチェックリストです。
- [ ] 直近の413
request_too_largeエラーの発生頻度と発生元のエンドポイントを集計する - [ ] 業務で使用するエンドポイントと、その公式上限を確認する(Messages / Batch / Files / Agents)
- [ ] 自社のゲートウェイ、リバースプロキシ、WAF、ロードバランサーのリクエストボディ上限を確認する
- [ ] SDKとHTTPクライアントのタイムアウト・バッファ設定を確認し、base64によるサイズ増加も考慮する
- [ ] Token Counting APIで大きなリクエストのトークン数とコンテキストの余裕を見積もる
- [ ] 4つのサイズ帯で、直接送信・Files APIによる参照・分割の3方式を比較する
- [ ] マルチテナント環境での
file_idの分離とデータセキュリティ方針を評価する - [ ] データに基づいて変更の要否を決め、社内の技術文書も更新する
APIYI apiyi.comを使えば、比較テストの環境をすばやく構築できます。1つのAPIキーで複数の主要モデルを呼び出せるため、実際のサンプルを使って各方式の得失を検証するのに便利です。
📚 参考資料
- Anthropic 公式リリースノート:2026年10月28日のリクエストボディ上限変更に関する告知
- リンク:
platform.claude.com/docs/en/release-notes/overview -
説明:今回の32 MBから128 MBへの引き上げに関する一次情報(S1)
-
Claude API の概要とエンドポイントの制限:各エンドポイントのリクエストサイズ上限と413エラーの説明
- リンク:
platform.claude.com/docs/en/api/overview -
説明:Messages、Batch、Files、Agents などのエンドポイントの上限比較(S2)
-
PDF サポートドキュメント:PDF のリクエストボディとページ数の制限
- リンク:
platform.claude.com/docs/en/build-with-claude/pdf-support -
説明:大きな PDF を処理する前に確認しておきたい資料(S3)
-
Files API ドキュメント:ファイルのアップロード、
file_idによる参照、ストレージと権限 - リンク:
platform.claude.com/docs/en/build-with-claude/files -
説明:ファイル参照方式とマルチテナント環境での分離を検討する際の資料(S4)
-
コンテキストウィンドウのドキュメント:モデルのトークン容量に関する説明
- リンク:
platform.claude.com/docs/en/build-with-claude/context-windows -
説明:バイト数の制限とトークン数の制限を区別するための資料(S5)
-
公式料金とキャッシュの説明:トークン課金とプロンプトキャッシュ
- リンク:
platform.claude.com/docs/en/about-claude/pricing - 説明:コストへの影響を評価するための資料(S6)
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI のウェブサイト apiyi.com のトップページからお気軽にお問い合わせください。API 接続に関する資料は、ドキュメントセンター docs.apiyi.com でもご覧いただけます。