著者注:Codex の入力欄にコンテキストの使用量が表示されない? 確認するには /status を使います。この記事では、APIYI の呼び出しログから Codex の各ターンのトークン消費量と金額を5ステップで算出し、「圧縮すべきか、新しく開くべきか」の判断表も紹介します。
Codex を APIYI に接続して、ひとつの会話で何時間も作業を続けているとします。入力欄の下には権限モードとモデルしか表示されず、コンテキストをどれくらい使ったのか見えません。新しいウィンドウを開くべきかどうかも判断しづらいですよね。
先に結論を言うと、Codex でコンテキスト使用量が見られないわけではありません。確認する場所が /status に移動しただけです。料金の計算に必要なデータは APIYI / apiyi.com の呼び出しログにあります。この記事では、APIYI の呼び出しログで Codex の各ターンのトークン消費量を確認する方法を中心に、何を見て、どう合計し、いつ圧縮や新規開始を判断するのかを5ステップで解説します。
単なる概念の解説記事ではありません。各ステップで、画面に何が表示され、どこをクリックすればよいかを示し、確認の目安も添えています。
Codex で各ターンの token 消費量が見えないのはなぜ?
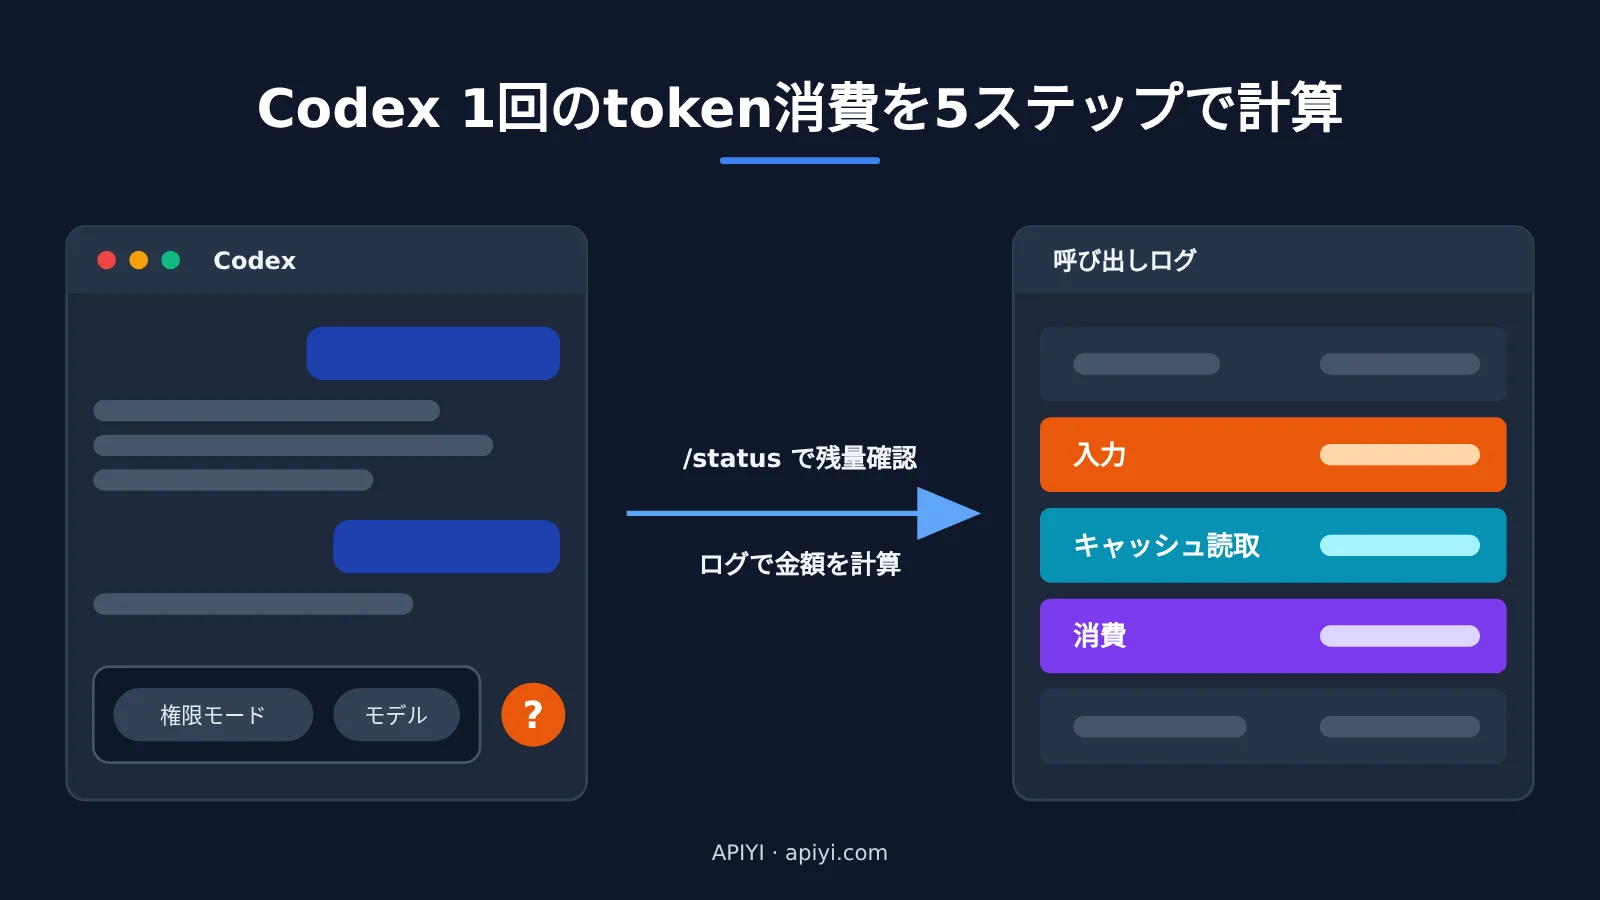
Codex ではコンテキストの表示がなくなったと思われがちですが、実際には関連情報が3つの場所に分かれており、それぞれ確認できる内容が異なります。
- デスクトップクライアント / IDE プラグイン:入力欄には権限モードとモデルだけが表示されます。
/statusを入力すると、chat ID、context usage(コンテキストの使用率)、rate limits(レート制限の残量)を確認できます。 - CLI:
/statusで現在のモデル、承認ポリシー、書き込み可能なディレクトリ、現在の token 使用量を確認できます。CLI のフッターにはもともとコンテキストの情報が表示されています。/statuslineを使えば、context stats(コンテキストの統計)と token counters(token のカウント)をフッターに追加できます。選択した内容はconfig.tomlのtui.status_lineに書き込まれます。 codex exec --json:非対話モードで実行すると、Codex は状態が変化するたびに JSON イベントを1行ずつ出力します。このうちturn.completedイベントにはusageが含まれ、input_tokens、cached_input_tokens、cache_write_input_tokens、output_tokens、reasoning_output_tokensの5つのフィールドがあります。
また、/usage で確認できるのはアカウント単位の token 利用状況のみで、公式アカウントでログインしている必要があります。サードパーティのキーを使っている場合は、このコマンドを利用できません。
Codex の token 消費量を確認する3つの方法
| 確認方法 | 対象 | 確認できること | 確認できないこと |
|---|---|---|---|
| APIYI 呼び出しログ | デスクトップ、IDE、CLI のすべて | リクエストごとの入力、出力、キャッシュの読み書き、金額 | 会話の内容。1行は1リクエストに対応するため、1ターン分は自分で合計する必要あり |
Codex /status |
デスクトップと CLI の対話画面 | コンテキスト使用量、レート制限の残量、現在の token 使用量 | 金額 |
codex exec --json |
非対話モードのみ | ターンごとの入力、キャッシュ読み取り、キャッシュ書き込み、出力、思考 token | 対話型 TUI とデスクトップ版のデータ |
この3つのうち、金額を確認できるのはログだけです。ただし、利用している経路自体がログと使用量の明細を提供している必要があります。公式サブスクリプションでは、リクエストごとの明細を確認できません。
ステップ1:Codexのトークン消費量を数える単位を決める
集計を始める前に、まず押さえておきたいのは、1回のリクエストは、1ターンの会話と同じではないということです。
リクエストとは、Codexがモデルを1回呼び出すことです。一方、ターンとは、あなたがメッセージを送り、Codexが作業を終えて返信するまでの一連の流れを指します。1ターンの中で、Codexはファイルを読み、コマンドを実行し、コードを変更します。ツール呼び出しが終わるたびに、その結果を会話履歴全体と一緒にモデルへ再送します。そのため、ログでは通常、1ターンが複数行に対応し、複雑なタスクでは数十行になることもあります。
また、モデル自体は、それまでの会話を覚えているわけではありません。第Nターンの入力は、おおむね「前のN-1ターンの全内容+今回の追加内容」です。これが、会話が長くなるほどコストが増える根本的な理由です。
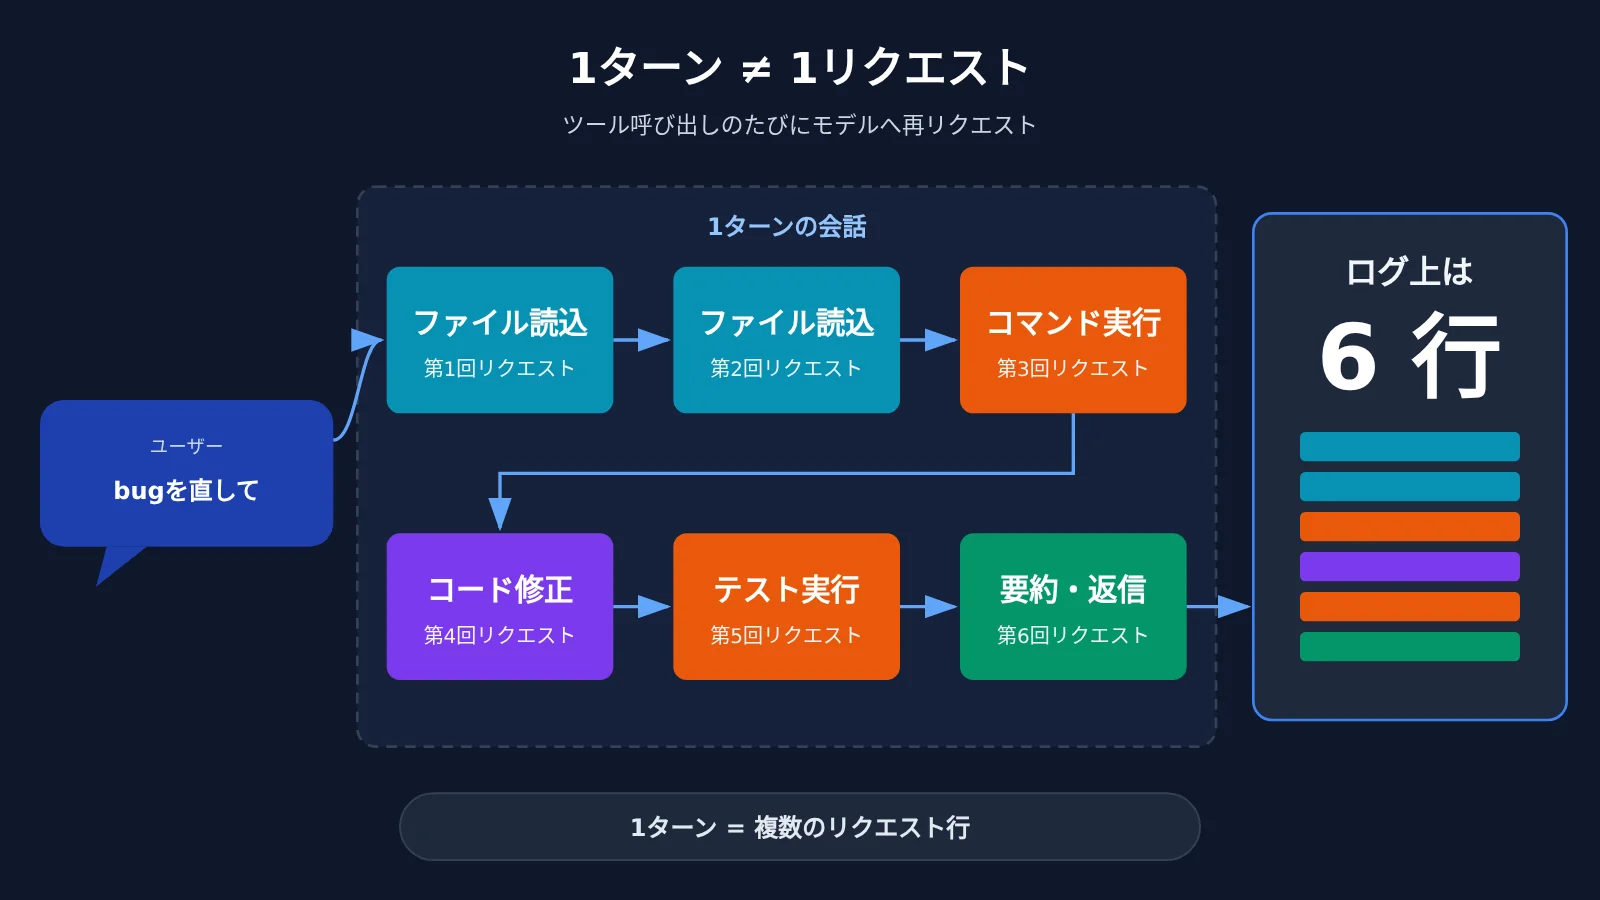
確認ポイント:ログに複数行のリクエストが表示されていても、それらが同じターンに属すると判断でき、1行を1ターンとして数えずに済みます。
ステップ2:Codex専用のトークンを作る
集計するには、Codexのリクエストだけをログから絞り込める必要があります。Codexとスクリプト、その他のツールで同じキーを使っていると、トークン単位で分けられません。
- APIYIコンソールのトークンページを開き、「トークンを追加」をクリックします。名前は「codex」を含めるなど、自分で見分けられるものにします。
- Codexの
config.tomlを開き、model_providersの下にプロバイダーを追加します。base_url = "https://api.apiyi.com/v1"を設定し、env_keyでこのトークンを読み込む環境変数を指定します。 model_providerにこのプロバイダーを指定します。デスクトップ、IDE、CLIは同じ設定ファイルを読み込むため、変更は一度で済みます。- その他のツールには別のキーを使い、このトークンを使い回さないようにします。
🎯 技術的なアドバイス:専用トークンの作成、トークンによるログの絞り込み、エクスポートの3つは、APIYI / apiyi.comのコンソールで利用できる集計手段です。公式サブスクリプションではリクエストごとの明細を確認できませんが、専用トークンを使えばCodexの利用分を個別に集計できます。
確認:ログページで「展開」をクリックし、詳細フィルターの「トークン」でこのキーを選択します。リストにCodexからのリクエストだけが残ればOKです。
ステップ3:呼び出しログで個々のリクエストを読み解く
api.apiyi.com/log、つまり左側のメニューにある「ログ」を開きます。リストの各行が1回のAPIリクエストに対応しています。
画面上部では、デフォルトで期間、種類、モデル、キャッシュ状態を指定して絞り込めます。キャッシュ状態の説明には「ヒット=キャッシュ読み取り、未ヒット=キャッシュ作成」とあります。「展開」をクリックすると、トークン、ストリーミング、プロンプト・補完の範囲、最初のバイトが届くまでの時間などの条件でも絞り込めます。
ログの各列の意味
| 列名 | 表示される内容 | 見方 |
|---|---|---|
| 時間 | リクエストの完了時刻 | デフォルトはUTC+0で、北京時間より8時間遅い |
| モデル | 例:gpt-5.6-terra | モデルが変わるとキャッシュは共有されない |
| 情報 | ストリーミング/非ストリーミング、最初のバイトが届くまでの時間、プロンプト/補完トークン数、金額 | この欄でリクエストの概要をまとめて確認できる |
| プロンプト / 補完 | 2つの数字 | プロンプト=入力トークン数、補完=出力トークン数。思考トークンは通常、補完に含まれる |
| 消費 | 米ドルでの金額 | 割引前の金額。グループ倍率は適用済み |
| 説明 | 各種倍率、キャッシュ書き込みトークン数、キャッシュ読み取りトークン数 | キャッシュのヒットと書き込みが個別に表示されるため、推測する必要がない |
キャッシュを使用したリクエストでは、「情報」列にヒットと書き込みの数値が両方表示されます。キャッシュの明細がない行には、「非ストリーミング 最初のバイト:N秒 プロンプト/補完 金額」のような組み合わせだけが表示されます。回数単位で課金される画像・動画モデルにもプロンプトと補完は表示されますが、金額はトークン単位で計算されないため、この記事の計算方法は当てはまりません。
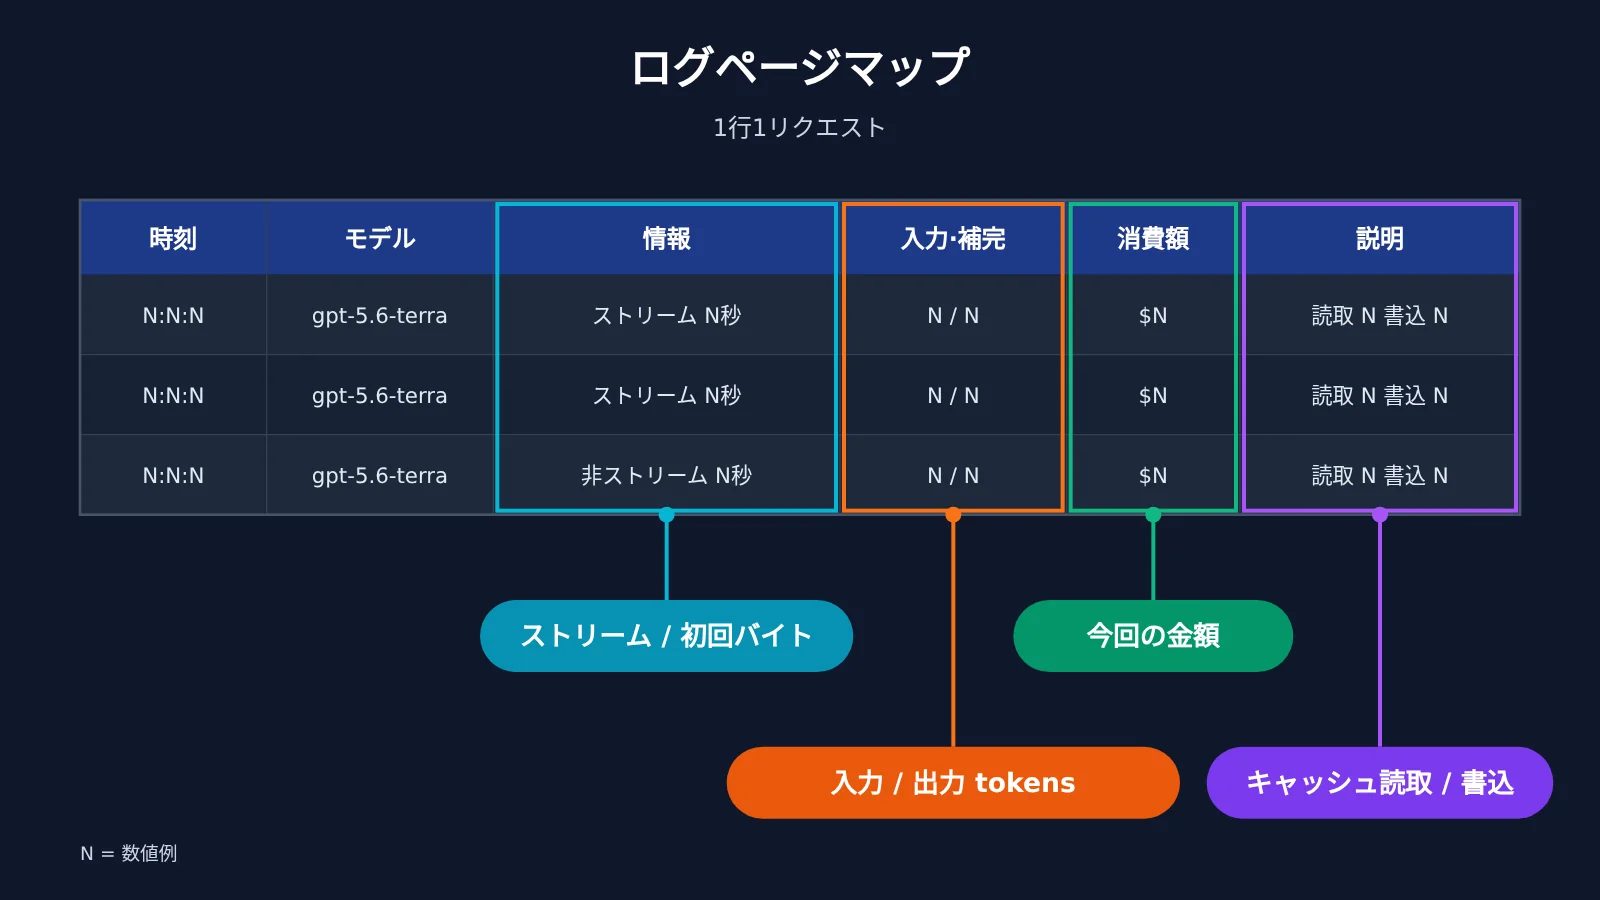
確認:任意の行を見て、そのリクエストの入力、出力、キャッシュヒット、費用を説明できればOKです。
ステップ4:複数のログ行をまとめて1ターンのCodexトークン消費量を求める
ログの1行は、1回のリクエストを表します。会話の1ターンあたりの消費量を確認するには、複数の行を合計する必要があります。
合計のルールは、同じトークン、同じモデルで、指示を送ってから約5分以内のリクエストをすべて足し合わせることです。時間の範囲は、実際の使い方に合わせて調整してください。
- 画面上で直接確認する:トークン、モデル、時間範囲で絞り込み、各行のプロンプトと補完を確認します。たまに調べる場合に向いています。
- エクスポートして再計算する:一覧の右上にある「エクスポート」をクリックし、ExcelまたはCSVを出力して、表計算ソフトで時間ごとにグループ化して合計します。
- ログ検索APIを使う:
GET /api/log/selfを呼び出します。認証には個人アクセストークン(nap_で始まるもの)を使用してください。sk_で始まるAPIキーでは401が返されます。パラメータにはtype=2(消費のみ)、token_name、start_timestamp、end_timestamp(Unix秒)を指定します。ページネーションのパラメータはキャメルケースのpageSizeです。page_sizeと書くと、エラーが出ずに無視されるので注意してください。 - 金額に換算する:APIが返す
quota ÷ 500,000 = 米ドルです。otherフィールドはJSON文字列なので、usageなどの詳細を取得するには、もう一度パースする必要があります。
検索APIを使うときは、必ず時間範囲を指定してください。範囲は1日以内を推奨します。指定しないと全履歴が検索対象になり、データ量の多いアカウントではタイムアウトエラーが起きやすくなります。ログの検索自体に利用枠は消費されません。
料金から1ターンのCodexの費用を計算する
| モデル | 入力 | キャッシュ読み取り | 出力 | コンテキスト | 計算例:1ターンの合計 |
|---|---|---|---|---|---|
| gpt-5.6-sol | $4 | $0.4 | $20 | 1,000,000 | 約 $0.214 |
| gpt-5.6-terra | $2 | $0.2 | $12 | 1,000,000 | 約 $0.107 |
| gpt-5.6-luna | $0.2 | $0.02 | $1.2 | 1,000,000 | 約 $0.011 |
単価はすべて100万トークンあたり、2026-10-28時点のものです。1回のリクエストの入力が272,000トークンを超えると、入力単価は2倍になります。
💰 料金について:モデルと料金は、APIYI / apiyi.comのモデル一覧をご確認ください。表の計算例は、1ターンの累計入力120,000トークンのうち96,000トークンがキャッシュにヒットし、出力が4,000トークンだった場合です。solの場合、キャッシュ非ヒット分24,000 × $4 + ヒット分96,000 × $0.4 + 出力4,000 × $20を100万で割ると、合計は約 $0.214です。
この数字からは、2つのことがわかります。1つ目は、キャッシュにヒットした96,000トークンの費用は約 $0.038にとどまることです。長い会話のコストを抑えるうえで、キャッシュは重要です。2つ目は、同じターンのタスクをlunaに切り替えると、費用がsolの約20分の1になることです。ただし、lunaの公式ページには、256Kを超える超長文コンテキストでは性能が低下すると記載されています。
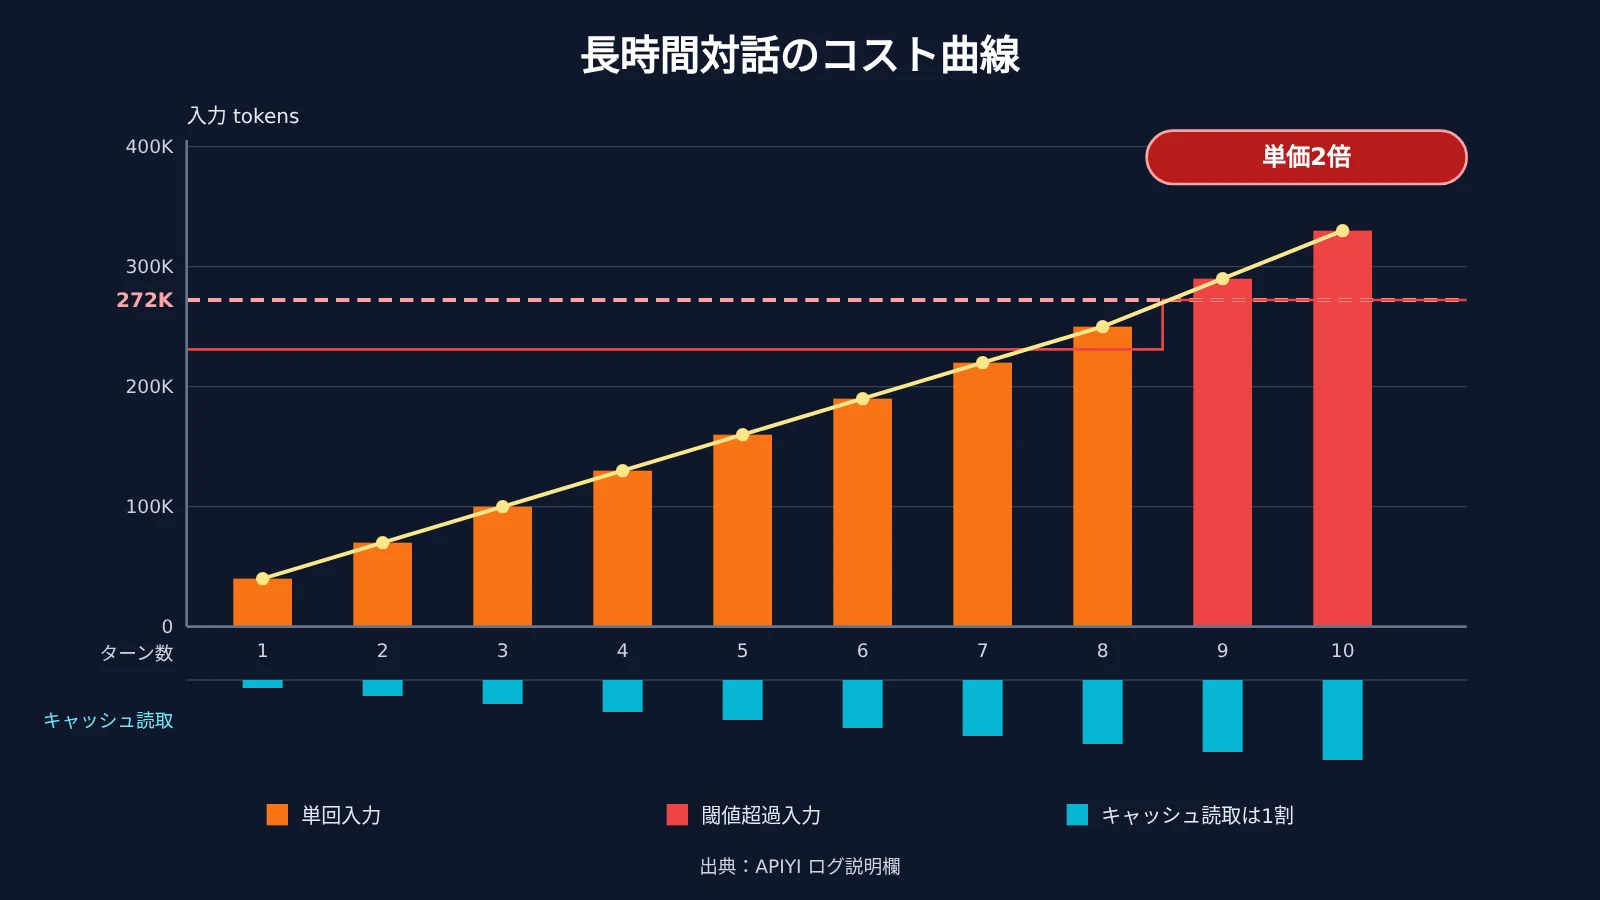
確認ポイント:「今回のターンの入力トークンが前回よりどれだけ増えたか」を計算し、増えた分のうちいくつがキャッシュにヒットしたかを説明できますか?
ステップ5:Codexのトークンデータを見て、圧縮するか新しく始めるかを決める
各ターンのデータがそろえば、数字に基づいて判断できます。注目したいのは、次の3つのサインです。
- 入力の増加ペース:ターンごとの入力増加量が大きくなっている場合、ツール出力と履歴が急速に蓄積しています。
- キャッシュ読み取りの割合:説明欄で、入力に占めるキャッシュ読み取りの割合が明らかに下がっている場合、プレフィックスが変わり、新しい入力の大部分に通常料金が適用されています。
- 1回あたりの入力:272,000に近づくと、次のリクエストで料金の段階を超える可能性があります。
圧縮するか、新しいウィンドウを開くかの判断表
| ログで確認できる状況 | 推奨する対応 | 理由 |
|---|---|---|
| 1回あたりの入力が272,000に近く、タスクがまだ終わっていない | まず手動で /compact を実行する |
料金の段階を超え、入力料金が2倍になるのを避けるため |
| 1回あたりの入力が272,000に近く、タスクが一段落している | 新しいウィンドウを開く | 圧縮するより、きれいな状態で再開できるため |
| キャッシュ読み取りの割合が数ターン続けて下がっている | 新しいウィンドウを開き、話題を切り替える | キャッシュが効かなくなっており、会話を続けても大部分に通常料金がかかるため |
| ターンごとの入力増加量が急に大きくなった | ツール出力を確認し、必要に応じて tool_output_token_limit を下げる |
大量のコマンド出力が履歴に書き込まれているため |
| 入力が安定しており、キャッシュ読み取りの割合が高い | 現在の会話を続ける | この状態なら、長い会話でもコストパフォーマンスが最も高いため |
| 一度圧縮したばかりなのに、また上限に近づいている | 新しいウィンドウを開く | 圧縮を繰り返すと、要約の内容がどんどん粗くなるため |
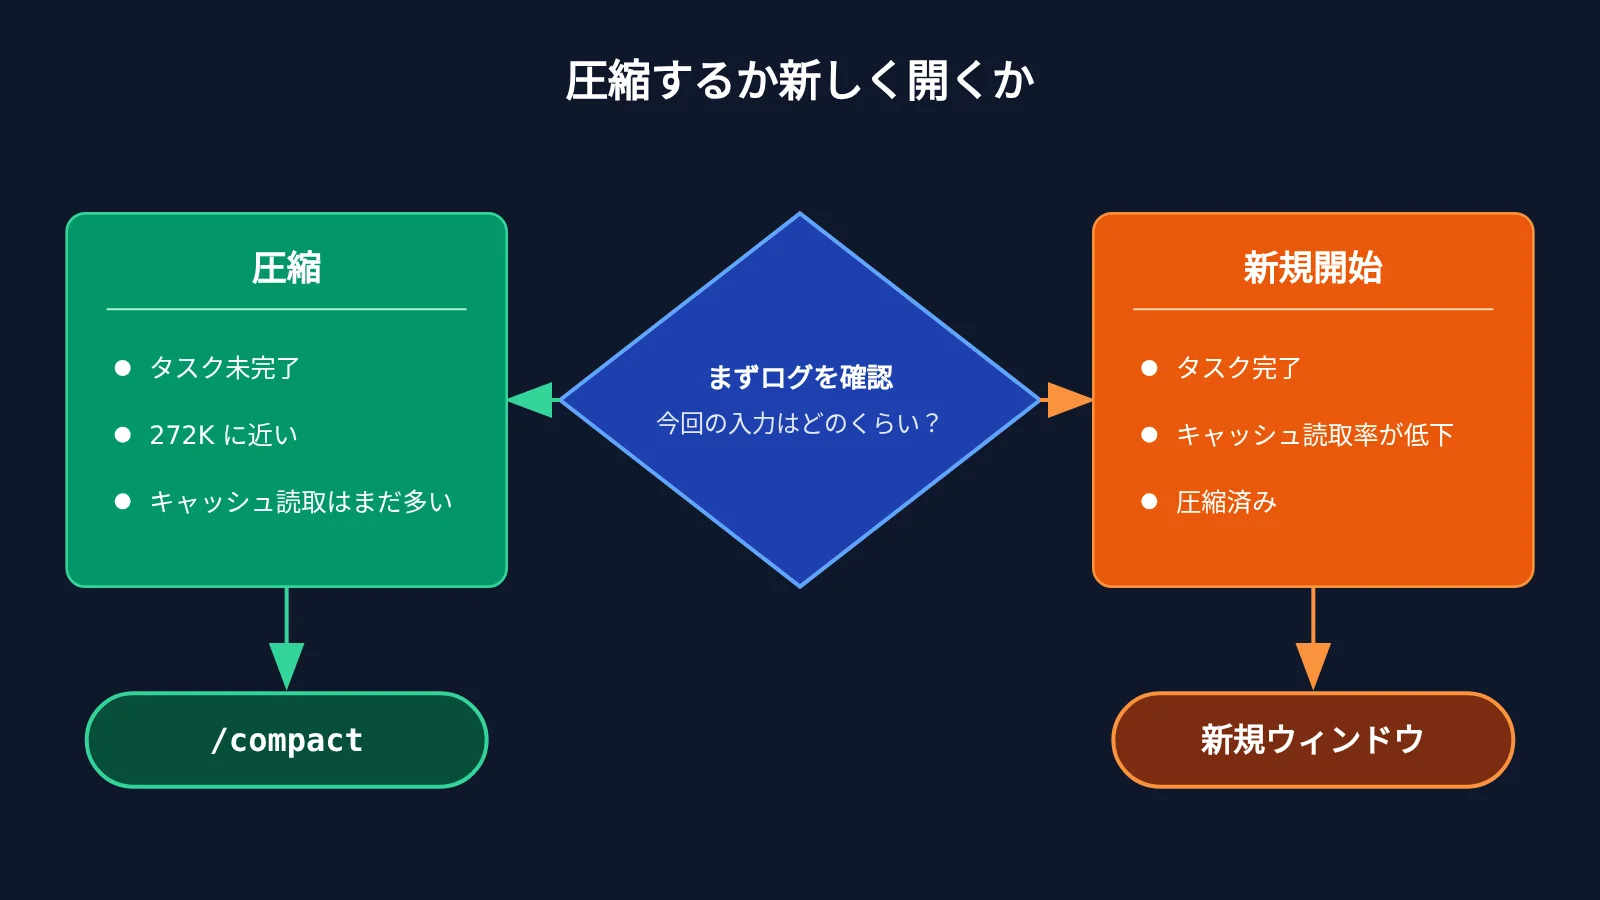
Codexのコンテキスト圧縮を設定する方法
圧縮とは、過去の会話を簡潔な要約に置き換え、コンテキストの空きを確保することです。Codexでは、手動と自動の2つの方法が使えます。
- 手動圧縮:デスクトップ版とCLIのどちらでも、
/compactと入力できます。 - 自動圧縮:
model_auto_compact_token_limitで実行のしきい値を設定します。未設定の場合は、モデルのデフォルト値が使われます。 - しきい値の計算範囲:
model_auto_compact_token_limit_scopeでは、total(現在のコンテキスト全体を対象にする)またはbody_after_prefix(引き継がれたプレフィックス以降に追加された部分だけを対象にする)を選べます。 - サードパーティのbase_urlを使う場合:モデル名がCodexの組み込みリストにないため、
model_context_windowと自動圧縮のしきい値を手動で設定することをおすすめします。料金が次の段階に上がる前に圧縮したい場合は、しきい値を272,000未満に設定できます。 remote_compactionはむやみに有効化しない:v2に設定する場合、接続先がResponses側の圧縮プロトコルに対応している必要があります。unsupportedのままにして、ローカル圧縮を使うほうが無難です。
圧縮にかかるコスト
圧縮は無料ではありません。過去のプレフィックスが書き換えられることでキャッシュが無効になり、圧縮後のリクエストの入力にはほぼ通常料金がかかります。そのため、圧縮後は以前のタスクを繰り返すより、そのまま新しい話題に進むのがおすすめです。また、圧縮すると詳細が失われることもあり、要約にすべての情報が残るとは限りません。
よくある質問 FAQ
Q1:ログに特定のリクエストが見つかりません。記録漏れですか?
ログに記録されるのは、課金が確定した呼び出しだけです。ネットワーク、認証、パラメータ検証などの段階で失敗したリクエストは、上流に届かないため、課金されず、ログにも表示されません。逆に、ログに記録があれば、そのリクエストで実際に料金が発生しています。また、トークンのフィルターと時間範囲が正しく選択されているかも確認してください。
Q2:金額が token 数から見積もった額より安いのはなぜですか?
最もよくある原因はキャッシュです。OpenAI のチャネルでは自動プレフィックスキャッシュが使われ、プレフィックスが 1024 tokens 以上で安定している場合にキャッシュがヒットします。ヒットした部分は入力料金の 10%で課金されます。APIYI / apiyi.com のログの説明欄では、キャッシュから読み取られた token 数を確認できます。また、ログに表示されるのは割引前の金額で、実際のコストは「ログの金額 ÷(1 + ボーナス付与率)」がおおよその目安です。
Q3:ログの時刻と操作した時刻が一致しません
ログはデフォルトで UTC+0 で表示されます。北京時間は UTC+8 のため、8時間の差があります。北京時間を基準に「午後3時のやり取り」を絞り込むと、データの一部が欠けているように見えることがあります。絞り込む前に時刻を換算してください。
Q4:ログはどのくらいの期間保存されますか?
「直近約30日分を確認できる」ことを目安にしてください。実際の保存期間はそれより長い場合もありますが、プラットフォームは保証しておらず、削除ポリシーも変更される可能性があります。長期的な照合が必要な場合は、「エクスポート」またはログ照会 API を使って定期的に保存してください。
Q5:Codex がどのファイルを読み、どんな内容を送信したかをログで確認できますか?
確認できません。ログには token 数、金額、倍率など、課金に必要な基本情報だけが保存され、入出力の内容は記録されません。各やり取りで何が行われたかを知りたい場合は、Codex の会話自体を確認してください。
Q6:各やり取りの使用量を自動で記録する、もっと簡単な方法はありますか?
スクリプトで実行する場合は、`codex exec –json` を使い、`turn.completed` イベント内の usage を読み取れます。対話形式で使う場合は、ログ照会 API を通じて、専用トークンと時間範囲を指定し、定期的にデータを取得・集計できます。新規ユーザーは、まず APIYI / apiyi.com で無料テスト枠を受け取り、一連の流れを試せます。
Codex の1ターンあたりのトークン消費:重要ポイント
- 確認機能はなくなっていません:コンテキストの使用量は
/statusで確認できます。CLI では/statuslineを使ってフッターにも表示できます。 - リクエストとターンは別物:1ターンの会話には複数のツール呼び出しが含まれ、ログでは複数行に分かれます。時間帯を指定して合計しましょう。
- 専用のAPIキーを用意:Codex 専用のキーを作ると、ログを絞り込みやすくなります。
- 説明欄を確認:キャッシュの読み書きは別々に記載され、キャッシュヒットした分は通常料金の10%で課金されます。
- 272K の料金区分:1回の入力が272,000トークンを超えると、入力料金が2倍になります。
- 圧縮にもコストがかかる:圧縮後はキャッシュが無効になるため、そのリクエストの入力はほぼ全額課金されます。圧縮後は新しい話題に切り替えるのがおすすめです。
まとめ
Codex でコンテキストの使用量が見つからないのは、機能が削除されたからではなく、確認する場所が変わったためです。/status ではコンテキストの残量を、呼び出しログでは各ターンの費用を確認できます。両方を組み合わせれば、「新しいウィンドウを開くべきか」を数字に基づいて判断できます。
さっそく Codex 専用のAPIキーを作り、APIYI / apiyi.com のログページを開いてみましょう。直近の1ターンを選び、対応する複数のリクエストを合計してみてください。
📚 参考資料
- OpenAI Codex 公式リポジトリ:CLI のソースコードとイベント定義
- リンク:
github.com/openai/codex -
説明:
codex-rs/exec/src/exec_events.rsにturn.completedの usage フィールドが定義されています -
Codex 公式ドキュメント:スラッシュコマンドと設定リファレンス
- リンク:
developers.openai.com/codex -
説明:
/status、/compact、/statuslineおよび圧縮に関する設定項目を確認できます -
APIYI ヘルプドキュメント:呼び出しログ、キャッシュの課金、ログ検索 API
- リンク:
docs.apiyi.com - 説明:ログフィールドの定義、キャッシュ料金が通常の1割になるルール、
quotaの換算方法を確認できます
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI 公式サイトのトップページからお気軽にご連絡ください。詳しい設定方法はドキュメントセンターをご覧ください。