著者注:この記事では、原理・実測方法・レイテンシ指標・ビジネスシーンの4つの角度から GPT-6 Luna Decisions API を評価し、「意思決定型呼び出し」が通常のモデル呼び出しより速く、あなたのビジネスにより適しているかどうかを判断できるようにします。
GPT-6 Luna の Decisions API が正式リリースされて以来、開発者の間で最も多く議論されているのは、「通常のモデル呼び出しよりどれだけ速いのか」「どのビジネスなら切り替える価値があるのか」という点です。本記事では、実際の導入という視点から、GPT-6 Luna Decisions API の主要機能、高速化の原理、テスト方法、適用シーンを評価します。
これは公式プロモーションの焼き直しではありません。 アカウント・地域・同時実行数・プロンプトによって、レイテンシの差は大きく変わる可能性があります。そのため本記事では、誤解を招きかねない「固定倍率」は示しません。代わりに、再現可能な評価スクリプトと判断基準を提供し、あなた自身のビジネスデータで真の結論を導き出せるようにします。
コアバリュー:本記事を読み終えれば、1本の Python スクリプトを使って GPT-6 Luna Decisions API と通常呼び出しのレイテンシ差を定量化し、分類・ルーティング・審査・リスク管理といった意思決定系ビジネスに適しているかどうかを判断できるようになります。
🎯 評価に関する注意:本記事のすべてのコードは OpenAI 互換インターフェースに基づいており、APIYI apiyi.com からそのまま実行できます。具体的なモデル ID、インターフェースパラメータ、課金については、公式ドキュメントおよびプラットフォームのコンソールを参照してください。
GPT-6 Luna Decisions API の主要機能
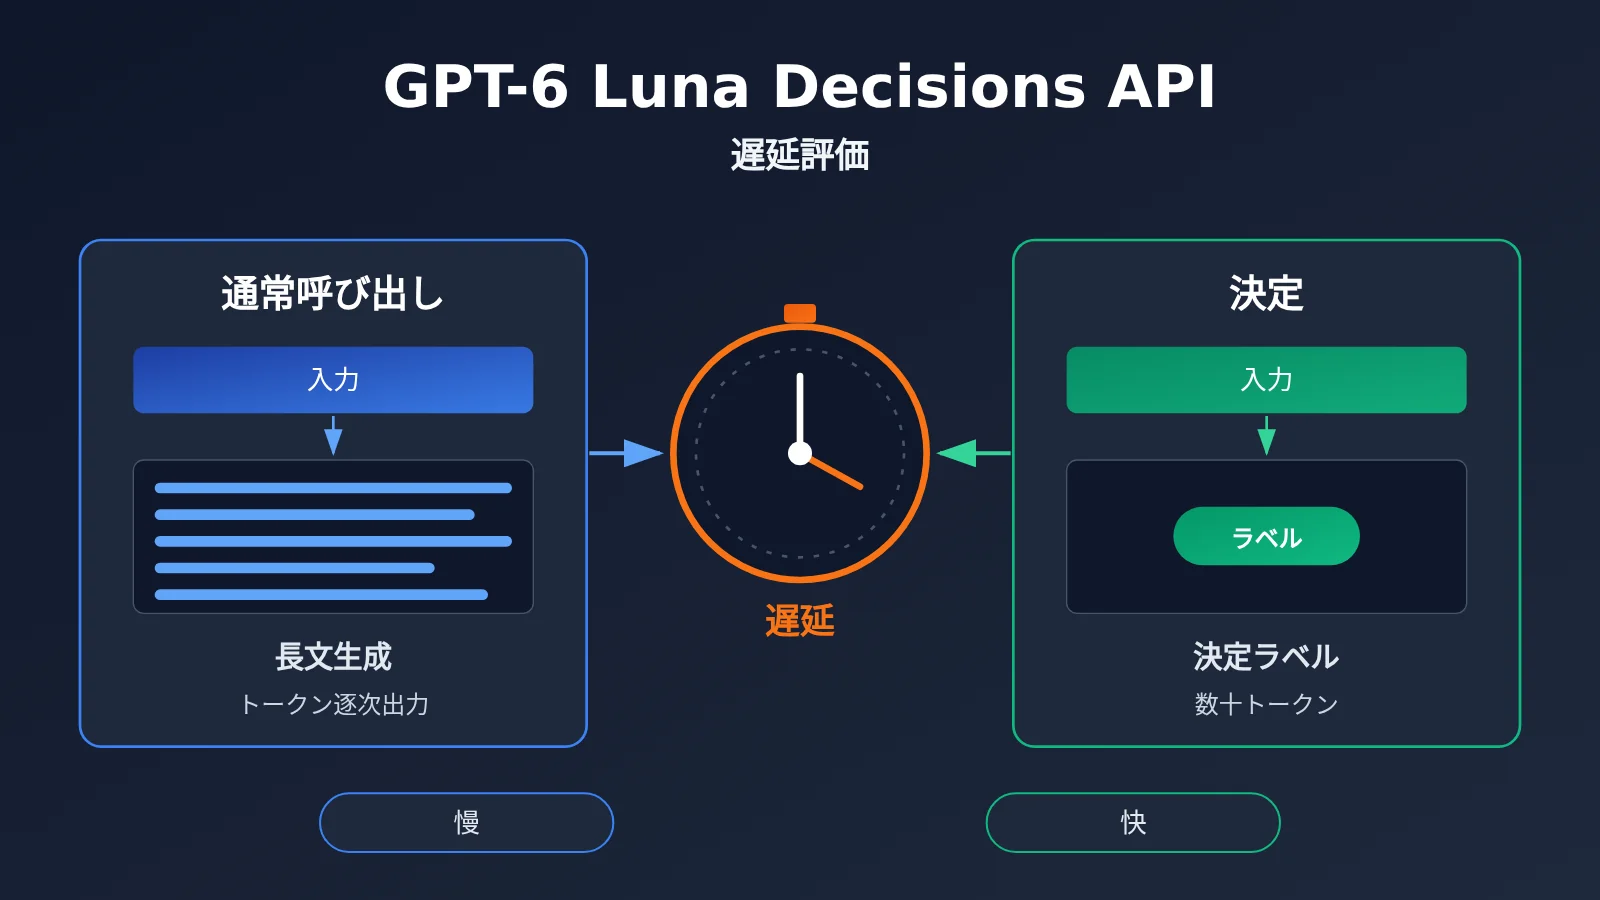
Decisions API を理解する前に、まず通常の対話呼び出しとの位置づけの違いを押さえておきましょう。通常の呼び出しは「ある程度の内容を生成すること」を目的とするのに対し、意思決定型の呼び出しは「限られた選択肢の中から判断を下すこと」を目的とします。この2種類のタスクでは、出力の長さ、フォーマットの制約、レイテンシの構成がまったく異なります。
| ポイント | 説明 | 開発者にとっての価値 |
|---|---|---|
| 意思決定型の出力 | 出力はラベル、選択肢、スコアといった構造化された結果に集中し、長文テキストにはなりません | 結果をプログラムがそのまま利用でき、再解析が不要 |
| 出力が短い | 典型的な意思決定の結果は数十トークン程度で、通常の生成タスクよりはるかに少ない | 総応答時間は主に最初のトークンと入力処理で決まる |
| フォーマットを制約できる | JSON Schema などの構造化出力の制約と組み合わせ可能 | フォーマットエラーの発生率を下げ、リトライを削減 |
| 高頻度呼び出しに適する | ルーティング、分類、審査といったリクエストは量が多く、1回あたりは単純なことが多い | レイテンシとコストの最適化効果が大きく現れる |
Decisions API と通常の呼び出しの違い
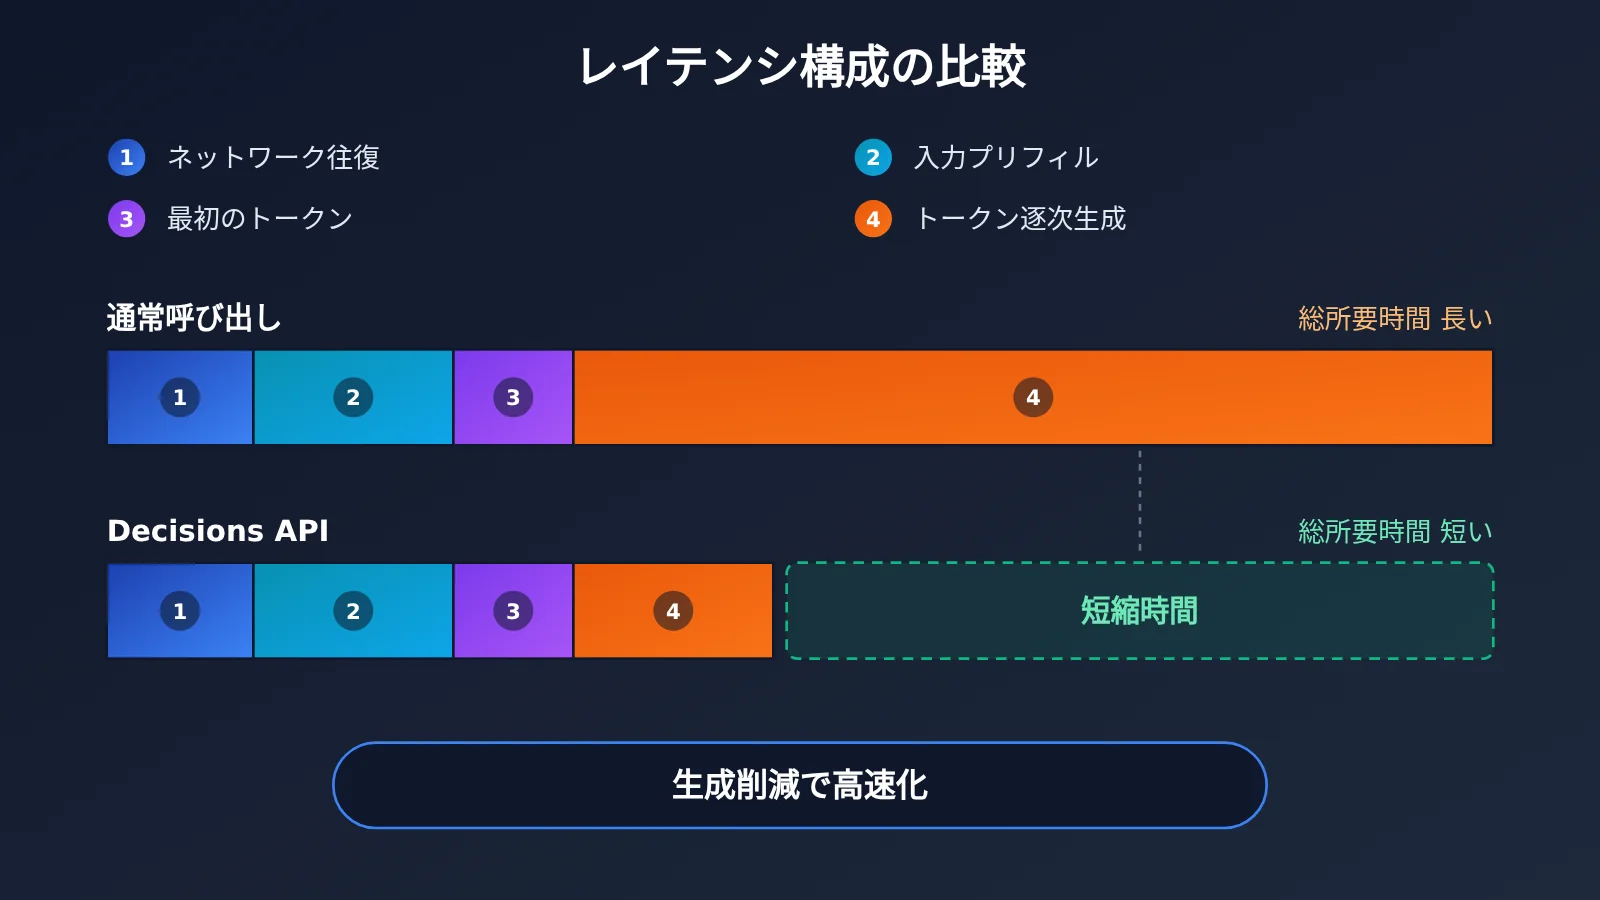
エンジニアリングの観点から見ると、通常のモデル呼び出しの総所要時間は大きく3つに分かれます。ネットワークの往復、入力処理(プリフィル)、トークンごとの生成です。生成型のタスクでは3つ目が大部分を占めることが多く、出力が長いほど遅くなります。
意思決定型の呼び出しでは、出力を構造化された結果1つに圧縮するため、生成段階の所要時間が大幅に短くなります。つまり GPT-6 Luna Decisions API の高速化は主に「生成量が少ない」ことによるもので、「生成が速くなった」からではありません。もし業務自体が長文を必要とするなら、このインターフェースはあなた向けではありません。
Decisions API の高速化の要因
意思決定型のインターフェースは、通常さらに2つの面で追加のメリットをもたらします。1つ目はフォーマットの確定です。プログラムが自然言語から正規表現で答えを抜き出す必要がなくなり、失敗してリトライする確率が下がります。2つ目は推論プロセスの制御です。モデルが推論の強度を調整できる場合、意思決定の場面では長々とした思考チェーンはたいてい不要で、待ち時間をさらに減らせます。
ここで強調しておきたいのは、これらはすべて仕組みのレベルでの分析だという点です。実際の高速化の幅は、もともとの出力の長さによって変わります。もともとモデルに一言だけ返させていたなら、切り替え後の効果はごく限定的です。もともとモデルに「まず説明してから結論を出す」ようにさせていたなら、効果は非常に大きく現れます。
GPT-6 Luna Decisions API クイックスタート
最小構成のサンプル
以下は、構造化出力を使って意思決定呼び出しを1回行うための最小サンプルです。モデル名は、プラットフォームのコンソールで確認できる GPT-6 Luna の実際のモデルIDに置き換えてください。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

resp = client.chat.completions.create(
    model="gpt-6-luna",  # コンソールのモデル一覧にある実際の名称に合わせてください
    messages=[{"role": "user", "content": "チケット内容:請求書の宛先が間違っています。担当部署を判定してください。"}],
    response_format={"type": "json_object"},
    max_tokens=50
)
print(resp.choices[0].message.content)
このコードのポイントは max_tokens と response_format です。前者は出力の上限を制限し、後者は結果がプログラムで解析できる形式であることを保証します。この2つのパラメータこそが、意思決定型呼び出しの高速化の核心です。
完全な検証スクリプトを見る(通常の呼び出しと意思決定呼び出しのレイテンシを比較)
import time
import json
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統合インターフェース経由で呼び出し
)

MODEL = "gpt-6-luna"  # コンソールの実際のモデルIDに合わせてください。専用の Decisions モデル/インターフェースがある場合はここを置き換えます

SAMPLES = [
    "請求書の宛先が間違っています。再発行できますか?",
    "アプリのログインでずっと認証コードエラーと表示される",
    "プランを月払いから年払いに変更したい",
    "注文は配達済みになっているが、まだ受け取っていない",
]

DECISION_SCHEMA = {
    "type": "json_schema",
    "json_schema": {
        "name": "route",
        "schema": {
            "type": "object",
            "properties": {
                "department": {"type": "string", "enum": ["finance", "tech", "sales", "logistics"]},
                "confidence": {"type": "number"}
            },
            "required": ["department", "confidence"]
        }
    }
}

def timed_call(prompt: str, mode: str) -> dict:
    """最初のトークンまでの時間、総所要時間、出力長を返す"""
    kwargs = dict(model=MODEL, stream=True)
    if mode == "generate":
        kwargs["messages"] = [{"role": "user", "content": f"次のチケットを分析し、どの部署が対応すべきかとその理由を説明してください:{prompt}"}]
    else:
        kwargs["messages"] = [{"role": "user", "content": f"チケット:{prompt}。部署の判定のみを出力してください。"}]
        kwargs["response_format"] = DECISION_SCHEMA
        kwargs["max_tokens"] = 60

    start = time.perf_counter()
    ttft, chunks = None, []
    for event in client.chat.completions.create(**kwargs):
        delta = event.choices[0].delta.content if event.choices else None
        if delta:
            if ttft is None:
                ttft = time.perf_counter() - start
            chunks.append(delta)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": len("".join(chunks))}

def bench(mode: str, rounds: int = 5) -> dict:
    results = [timed_call(p, mode) for _ in range(rounds) for p in SAMPLES]
    totals = sorted(r["total"] for r in results)
    return {
        "mode": mode,
        "ttft_avg": round(statistics.mean(r["ttft"] for r in results), 3),
        "total_p50": round(totals[len(totals) // 2], 3),
        "total_p95": round(totals[int(len(totals) * 0.95) - 1], 3),
        "avg_chars": round(statistics.mean(r["chars"] for r in results), 1),
    }

if __name__ == "__main__":
    for m in ("generate", "decision"):
        print(json.dumps(bench(m), ensure_ascii=False))
スクリプトはストリーミング出力を採用しているため、最初のトークンまでの時間(TTFT)と総所要時間の両方を取得できます。各モードを最低20回以上実行し、同じ時間帯に交互に実行することをおすすめします。ネットワークの変動による偏りを避けられます。
🚀 クイックスタート:公式に推奨されている方法は、まず APIYI apiyi.com で新規ユーザー向けの無料テスト枠を受け取り、上記のスクリプトで自分の実際のチケットサンプルを1ラウンド実行してみてから、GPT-6 Luna Decisions API を本番環境に導入するかどうかを判断するという流れです。
GPT-6 Luna Decisions API の実測データ
「通常の呼び出しよりどれだけ速いのか」に一律の答えはありません。そこで本節では、再現可能な評価フレームワークを紹介します。以下の環境と指標に沿って測定すれば、得られた数値が実際のビジネス判断に役立ちます。
テスト環境の設定
| 設定項目 | 推奨設定 | 説明 |
|---|---|---|
| 呼び出しエントリポイント | OpenAI 互換インターフェース(base_url は統合ゲートウェイを指定) | 2つのモードが同じネットワーク経路を通るようにする |
| サンプルデータ | 実際の業務リクエスト 20〜100 件 | 合成データで測ったレイテンシは楽観的な値になりがち |
| 呼び出し方式 | stream=True |
最初のトークンまでの時間を測るために必要 |
| 同時実行数 | まずは単一同時実行、その後ビジネスピークまで段階的に引き上げ | 高負荷時のレイテンシ変動を観察 |
| 時間帯 | 平日のピーク帯とオフピーク帯で各1回ずつ測定 | 時間帯による負荷の違いを排除 |
主要なレイテンシ指標
| 指標 | 意味 | 評価基準 |
|---|---|---|
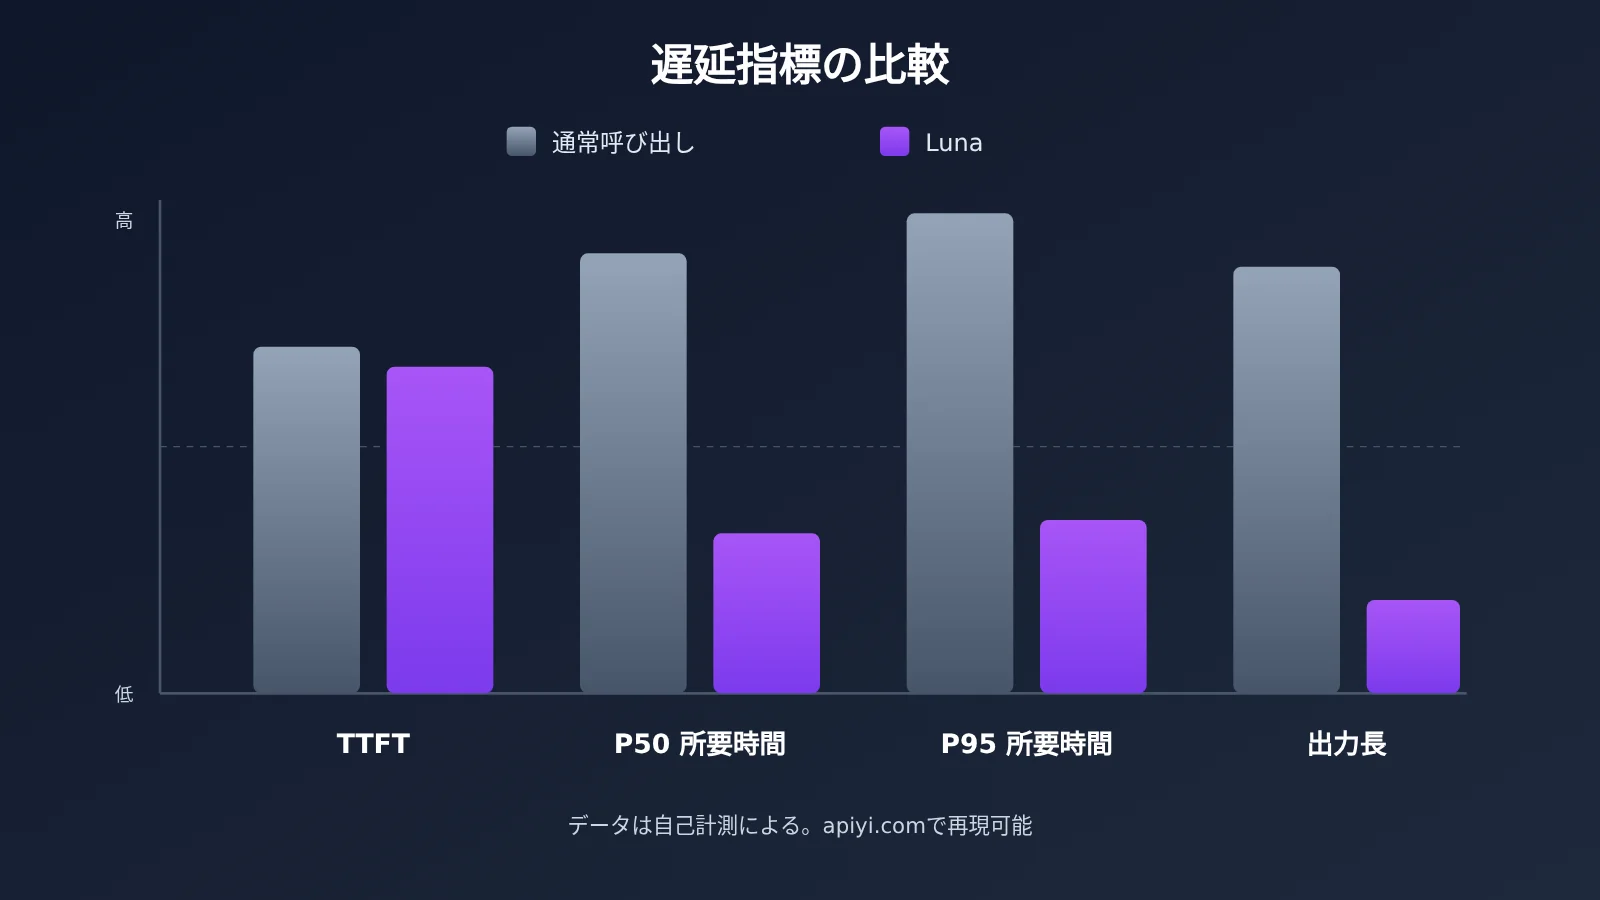
| TTFT 最初のトークンまでの時間 | リクエスト送信から最初の文字を受信するまで | 両モードでほぼ同じ値になり、主に入力長の影響を受ける |
| P50 総所要時間 | 半分のリクエストがどのくらいの時間で完了するか | デシジョンモードの核心的な優位性を示す指標。差が大きいほど切り替える価値がある |
| P95 総所要時間 | ロングテールリクエストの所要時間 | ユーザー体験の下限を決めるため、オンライン業務では必ず確認したい |
| 平均出力長 | 1回のレスポンスで返る文字数またはトークン数 | 高速化の理由を説明でき、コストにも直結する |
| フォーマット成功率 | 返却結果をそのままパースできる割合 | 失敗によるリトライが、節約した時間を食いつぶしてしまう |
Decisions API の評価結果をどう読み解くか
2つのモードで TTFT がほぼ同じなのに、P50 総所要時間に明らかな差がある場合は、高速化が確かに「生成量の削減」によるものだと言えます。これは最も想定どおりの結果です。このとき平均出力長も併せて比較すると、その差が大きいほど節約できる時間と出力コストが大きくなることがわかります。
P50 の差は小さいのに P95 の差が大きい場合は、通常呼び出しのロングテールが、たまたま発生した長文出力によるものである可能性が高いです。こうしたケースでは、平均値に目立った改善がなくても、GPT-6 Luna Decisions API に切り替えることでオンライン業務の安定性を大きく改善できます。
もうひとつ、2つのモードにほとんど差が見られないケースもあります。これは通常、既存のプロンプトがすでに十分に抑制されていることを意味します。この場合の切り替え価値は、速度よりもフォーマットの信頼性にあります。
💡 検証のヒント:同じサンプル群は、同じゲートウェイ上で交互にテストすることをおすすめします。APIYI apiyi.com の統合インターフェース経由で比較するのが手軽で、ネットワーク出口の違いによる結果の歪みも避けられます。
GPT-6 Luna Decisions API はどんな業務に向いているか
意思決定型インターフェースの価値は、1回の呼び出しが数百ミリ秒速くなることそのものではなく、高頻度でシンプル、かつプログラムが結果を消費する場面で、そのミリ秒が何千何万回ものリクエストで増幅される点にあります。以下の表は、5つの典型的な業務への適合度を整理したものです。
| 業務シーン | 典型的な出力 | 適合度 | 説明 |
|---|---|---|---|
| カスタマーサポートのチケットルーティング | 部門タグ + 信頼度 | 高 | リクエスト量が多く選択肢も固定なので、高速化とフォーマットの両面で効果が大きい |
| コンテンツ安全審査 | 通過 / 拒否 / 人手による再確認 | 高 | P95レイテンシに敏感で、結果がそのままフローを動かす必要がある |
| Agent のツール選択 | どのツールをどのパラメータで呼ぶか | 高 | マルチステップ Agent では各ステップの節約が積み重なり、全体の効果が大きくなる |
| リスク管理・不正検知の一次スクリーニング | リスクレベル | 中 | 一次フィルタには向くが、重要な判断はルールや人によるフォールバックが必要 |
| 長文執筆 / レポート生成 | 長い自然言語 | 低 | そもそも長い出力が必要で、意思決定型インターフェースの対象外 |
比較:Decisions API と他の意思決定アプローチ
意思決定系のタスクは、大規模言語モデルだけが選択肢ではありません。以下の表では、GPT-6 Luna Decisions API と一般的なアプローチを並べて比較します。
| アプローチ | 主な特徴 | 適用シーン | レイテンシ水準 | 利用可能なプラットフォーム |
|---|---|---|---|---|
| GPT-6 Luna Decisions API | 大規模言語モデルの理解力 + 構造化された短い出力 | セマンティクスが複雑で、選択肢が明確な意思決定 | 低(実測値ベース) | APIYI apiyi.com、公式 API |
| 通常の生成呼び出し | 柔軟で、理由の説明も付けられる | 理由の説明が必要な低頻度の意思決定 | 中〜高、出力が長くなるほど上昇 | 主要な大規模言語モデルプラットフォーム |
| 軽量な小型モデルによる分類 | 安価で高速だが、理解力は限定的 | セマンティクスが単純で、アノテーションが十分な分類 | 低 | 主要な大規模言語モデルプラットフォームまたは自前デプロイ |
| ルールエンジン | ミリ秒レベルで、完全に制御可能 | 条件が明確で、ほとんど変わらないルール | 極めて低い | 自社構築 |
ベンチマーク分析:ルールエンジンは速度と制御性の面で依然として優位ですが、口語的で表現の揺れが大きい入力に対しては、ルールの保守コストが急激に膨らみます。軽量な小型モデルはコスト面の優位性が明らかですが、曖昧なセマンティクスや長いコンテキストの理解は苦手です。これに対して GPT-6 Luna Decisions API は、「セマンティクスは複雑だが答えの空間は限られている」シーンに適しており、ルールと通常の大規模言語モデル呼び出しの中間に位置する折衷案と言えます。
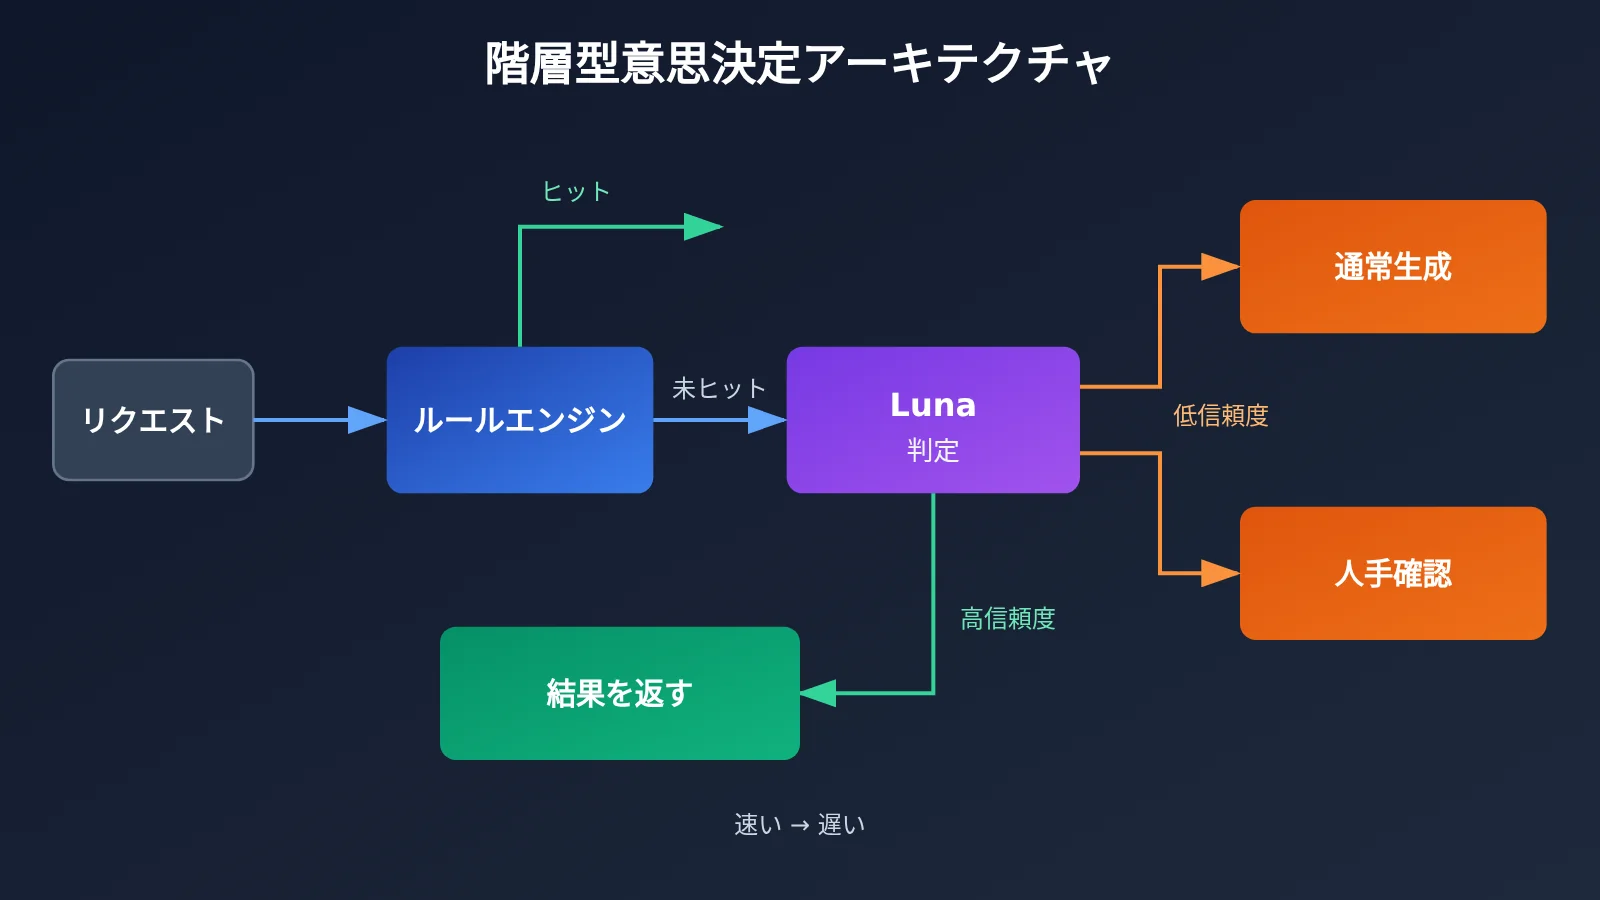
実務では、階層型アーキテクチャがより一般的です。ルールエンジンが明確な条件を処理し、GPT-6 Luna Decisions API が曖昧なリクエストを処理し、説明が必要な場合にのみ通常の生成呼び出しへフォールバックします。
GPT-6 Luna Decisions API のメリット・デメリット分析
メリット
- 総処理時間をコントロールしやすい:出力が構造化された結果に圧縮されるため、生成フェーズの所要時間が大幅に短縮され、テールレイテンシーもより安定します。
- 結果をそのまま利用できる:JSON Schema と組み合わせることで、戻り値をそのまま業務フローに組み込め、パース用のコードや失敗時のリトライを減らせます。
- コスト構造にやさしい:出力トークンが減れば出力コストも同時に下がるため、高頻度の利用シーンでは特に効果が顕著です。
- 導入ハードルが低い:OpenAI 互換プロトコルに基づいているため、既存コードは通常、モデル名と出力制約を調整するだけで切り替えられます。
制約
- 説明が苦手:判断結果そのものには理由が付きません。監査が必要な場合は、信頼度の低いサンプルに対して追加で通常の呼び出しを行い、説明を補うとよいでしょう。
- 高速化の幅はシーンによって異なる:既存の呼び出しがすでに1つのラベルだけを出力している場合、切り替えによるメリットは限定的です。まず評価スクリプトで定量的に測ってから移行することをおすすめします。
- 入力長は依然としてボトルネック:判断型インターフェースが最適化するのは出力側であり、超長いコンテキストのプリフィルにかかる時間がなくなるわけではありません。必要に応じて、入力のトリミングや検索による圧縮を先に行うべきです。
- 選択肢の設計品質に依存する:列挙値の定義が曖昧だと、モデルが似通った選択肢の間で揺らぐ原因になります。Schema 内で明確かつ相互排他的な選択肢を提示してください。
よくある質問 FAQ
Q1:GPT-6 Luna Decisions API とは何ですか?
これは意思決定系タスク向けの呼び出し方式で、モデルに長文を生成させるのではなく、与えられた選択肢の中から簡潔で構造化された判断結果を出力させるのが核心です。分類、ルーティング、審査、ツール選択などのシーンに適しています。具体的なパラメータは公式ドキュメントを参照してください。
Q2:Decisions API は通常のモデル呼び出しよりどれくらい速いですか?
統一された倍数はありません。高速化は主に出力長の短縮によるもので、元の出力が長いほど切り替え後のメリットが大きくなります。本記事の評価スクリプトを使い、実際のサンプルで P50 と P95 の総所要時間を比較して、あなたの業務に合った結論を出すことをおすすめします。
Q3:GPT-6 Luna Decisions API と、通常の呼び出しに JSON 出力を加えたものの違いは何ですか?
通常の呼び出しに JSON 制約を加えても似た効果は実現できます。両者の差は、公式が意思決定シーン向けに特別な最適化(推論強度、出力制約、サービススケジューリングなど)を行っているかどうかにかかっています。最も信頼できる判断方法は、やはり同一条件下での実測比較です。
Q4:どの業務を優先的に切り替えるのが最も適していますか?
リクエスト量が多く、回答の選択肢が固定されていて、レイテンシに敏感な業務を優先的に検討してください。たとえばカスタマーサポートのチケットルーティング、コンテンツ審査、Agent のツール選択などです。長文執筆やレポート生成のように、もともと長い出力が必要な業務には切り替えをおすすめしません。
Q5:API 経由で GPT-6 Luna Decisions API を素早く呼び出すには?
以下の手順での操作をおすすめします:
1. APIYI apiyi.com にアクセスしてアカウントを登録し、APIキーを取得
2. コンソールのモデル一覧で GPT-6 Luna の実際のモデル ID を確認
3. 本記事のコード内の base_url を `https://api.apiyi.com/v1` に設定し、モデル名を置き換えて実行
プラットフォームは OpenAI 互換インターフェースを採用しており、1つのキーで他の主要モデルも同時に呼び出して比較テストができます。
Q6:Decisions API の呼び出しコストを抑えるには?
意思決定型の出力はそれ自体が出力トークンを節約します。さらなる最適化は次の3つの側面から取り組めます:不要なコンテキストを削減する、ルールエンジンで明確なリクエストをインターセプトする、低信頼度のサンプルにのみ二次呼び出しを行う。APIYI apiyi.com のコンソールではモデルごとに利用明細を確認できるため、コストの大きい箇所を特定しやすくなります。
Q7:GPT-6 Luna Decisions API にはどのような既知の制限がありますか?
主な制限は、判断理由が提供されないこと、高速化が元の出力長に依存すること、超長入力のプリフィル(事前処理)にかかる時間はなくせないことです。金融や医療などリスクの高い意思決定については、補助的な判断として活用し、人によるレビューの工程を残すことをおすすめします。
GPT-6 Luna Decisions API の核心ポイント Key Takeaways
- 位置づけが明確:Decisions API が解決するのは「限られた選択肢の中で素早く判断する」ことであり、長文テキスト生成ではありません。
- 高速化の要因:主な要因は出力の短縮です。元の出力が長いほど、切り替えによるメリットがはっきりと現れます。
- 重要な指標:P50 と P95 の総処理時間に注目しましょう。TTFT は両モードで通常ほぼ同じです。
- 最適なユースケース:チケットルーティング、コンテンツ審査、Agent のツール選択など、高頻度の意思決定タスクです。
- 推奨アーキテクチャ:ルールエンジン + Decisions API + 通常呼び出しの階層的なフォールバック構成です。
- 導入の進め方:統一された OpenAI 互換インターフェースで比較スクリプトを実行し、自社の実測データを基準に移行を判断します。
まとめ
GPT-6 Luna Decisions API の核心ポイント:
- 速さの秘密は「生成量の少なさ」:その速度優位性は主に構造化された短い出力によるものであり、トークンあたりの生成速度が向上したわけではありません。
- 価値はユースケース次第:高頻度で選択肢が固定され、レイテンシに敏感な業務で最大の効果を発揮します。長文テキストのユースケースには向きません。
- 結論は実測から:プロンプトやサンプルによって高速化の幅は大きく異なります。必ず実際のデータで P50 と P95 を測定してください。
カスタマーサポートのルーティング、コンテンツ審査、Agent オーケストレーションに取り組んでいるなら、GPT-6 Luna Decisions API は真剣に評価する価値があります。まずは既存の呼び出しを対照群として残し、一部のトラフィックを段階的に切り替えて、レイテンシとフォーマット成功率に基づいて全面的な移行を判断することをおすすめします。
APIYI apiyi.com から無料クォータを受け取り、本記事のスクリプトを使って、あなたの業務シナリオにおける実際の高速化効果を素早く検証してみてください。
📚 参考資料
- OpenAI API 公式ドキュメント:モデル呼び出し、ストリーミング出力、構造化出力に関する説明
- リンク:
platform.openai.com/docs -
説明:GPT-6 Luna および Decisions 関連パラメータの権威ある情報源の確認
-
OpenAI Python SDK:公式 Python クライアント
- リンク:
github.com/openai/openai-python -
説明:本記事の評価スクリプトで使用した SDK。ストリーミング呼び出しの例も含まれています
-
JSON Schema 仕様:構造化出力の制約を定義する標準
- リンク:
json-schema.org - 説明:意思決定の選択肢や列挙値を設計する際の参考仕様
作者:APIYI 技術チーム
技術交流:APIYI ウェブサイトのトップページからお気軽にお問い合わせください。その他の接続資料は docs.apiyi.com ドキュメントセンターでご覧いただけます