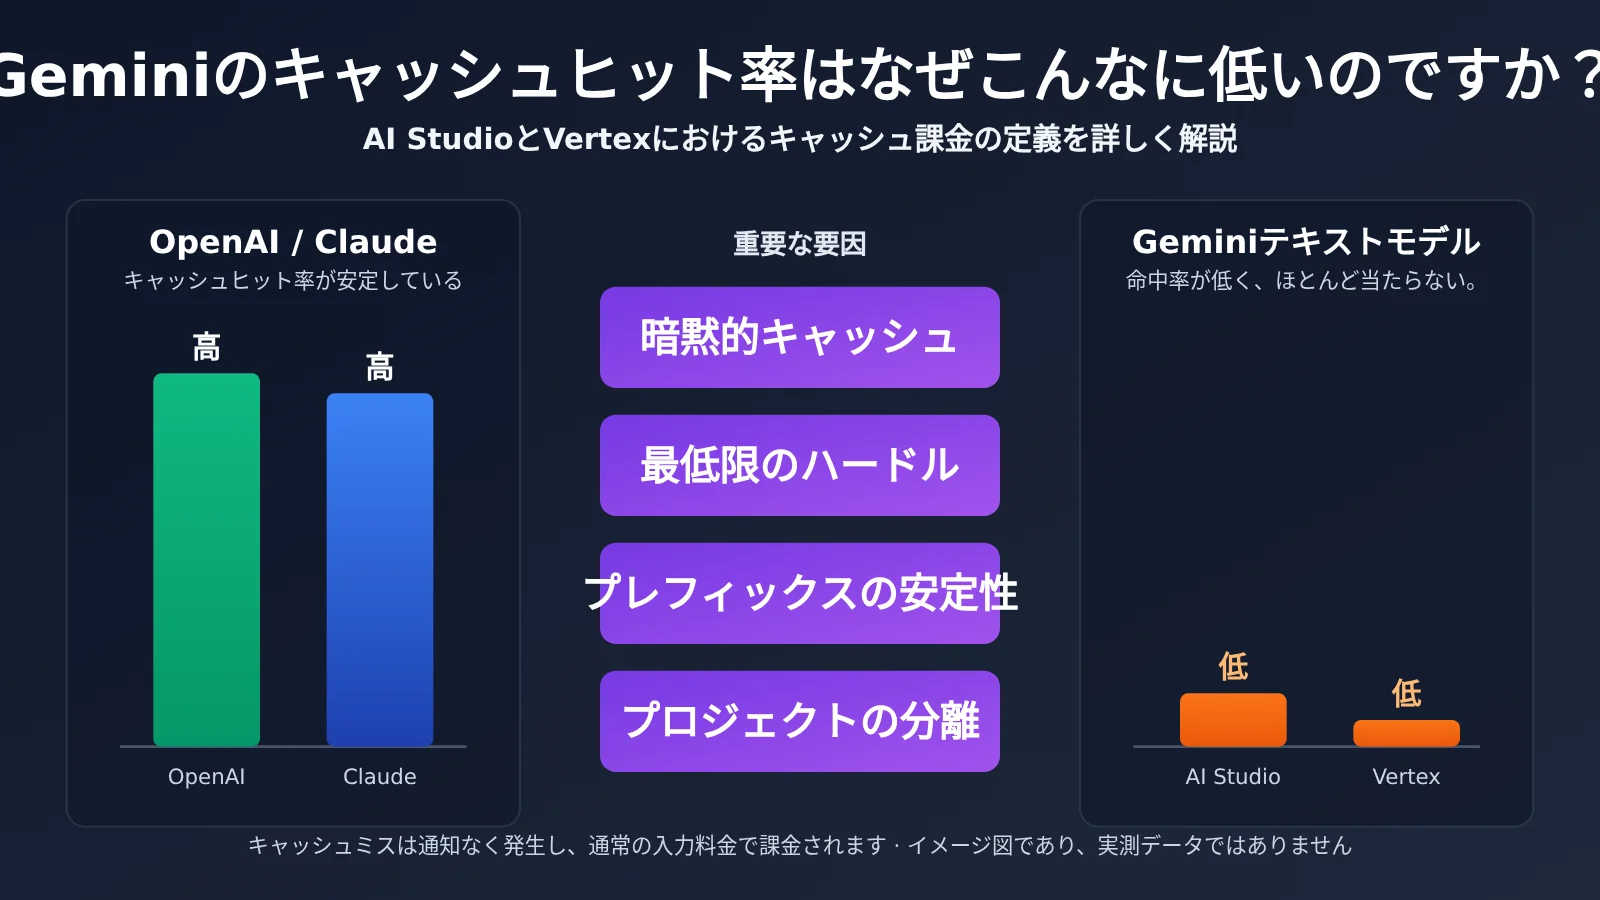
APIYI を実際に利用すると、OpenAI や Claude シリーズではキャッシュの書き込み・ヒットが正常に行われ、ヒット率も高くなります。一方、Gemini のテキストモデルでは様子が異なり、キャッシュヒット率が低く、ほとんどヒットしないことさえあります。これは請求書や利用明細で確認できる事実であり、請求を照合する際に多くの開発者が戸惑う点でもあります。
本記事では、Google の公式ドキュメント(2026 年 10 月 20 日時点)に基づき、Gemini のキャッシュヒット率が低くなる 5 つの原因を整理し、AI Studio(Gemini Developer API)と Vertex AI のキャッシュ課金の仕組みを解説します。
本記事は、誰かに責任を押しつけるための分析ではありません。Google の公式ルールに「API中継サービスを使うと Gemini のキャッシュヒット率が下がる」というものはありません。また、上流のリクエスト記録がない状態で、特定の原因が確実に当てはまると断言することもできません。本記事では、まず公式ルールを説明し、どのような条件でキャッシュが「機能しなくなる」のかを挙げたうえで、ご自身で実行できる調査・請求照合の方法を紹介します。
この記事でわかること:Gemini のキャッシュがヒットする条件とヒットしない条件を理解し、「入力全体にキャッシュ部分が含まれる」という課金上の重要なポイントを押さえ、公式レスポンスのフィールドを使って請求内容を独自に確認できるようになります。
Gemini のキャッシュヒット率を理解するためのポイント
まず結論から説明します。Gemini のキャッシュを理解するには、「暗黙的キャッシュ」と「明示的キャッシュ」の2種類を区別する必要があります。発動条件も課金方法も、まったく異なります。
| 種類 | 利用方法 | キャッシュによる割引を受ける方法 | 保存料金 |
|---|---|---|---|
| 暗黙的キャッシュ(Implicit caching) | 対応モデルで自動的に有効化され、キャッシュオブジェクトの作成は不要 | リクエストが実際にヒットした場合、該当部分にキャッシュ料金が適用されます。毎回ヒットするとは限りません | なし |
| 明示的キャッシュ(Explicit caching) | キャッシュオブジェクトを作成し、以降のリクエストでそのオブジェクトを参照 | 有効な参照によって利用されたキャッシュ入力に、キャッシュ料金が適用されます | あり |
Developer API の暗黙的キャッシュについて、公式ドキュメントには「コスト削減は保証されない」と明記されています。明示的キャッシュはより確実ですが、キャッシュオブジェクトの作成、有効期間の管理、後続リクエストでの参照など、追加の開発作業が必要です。
Gemini の利用感が OpenAI や Claude と異なる理由
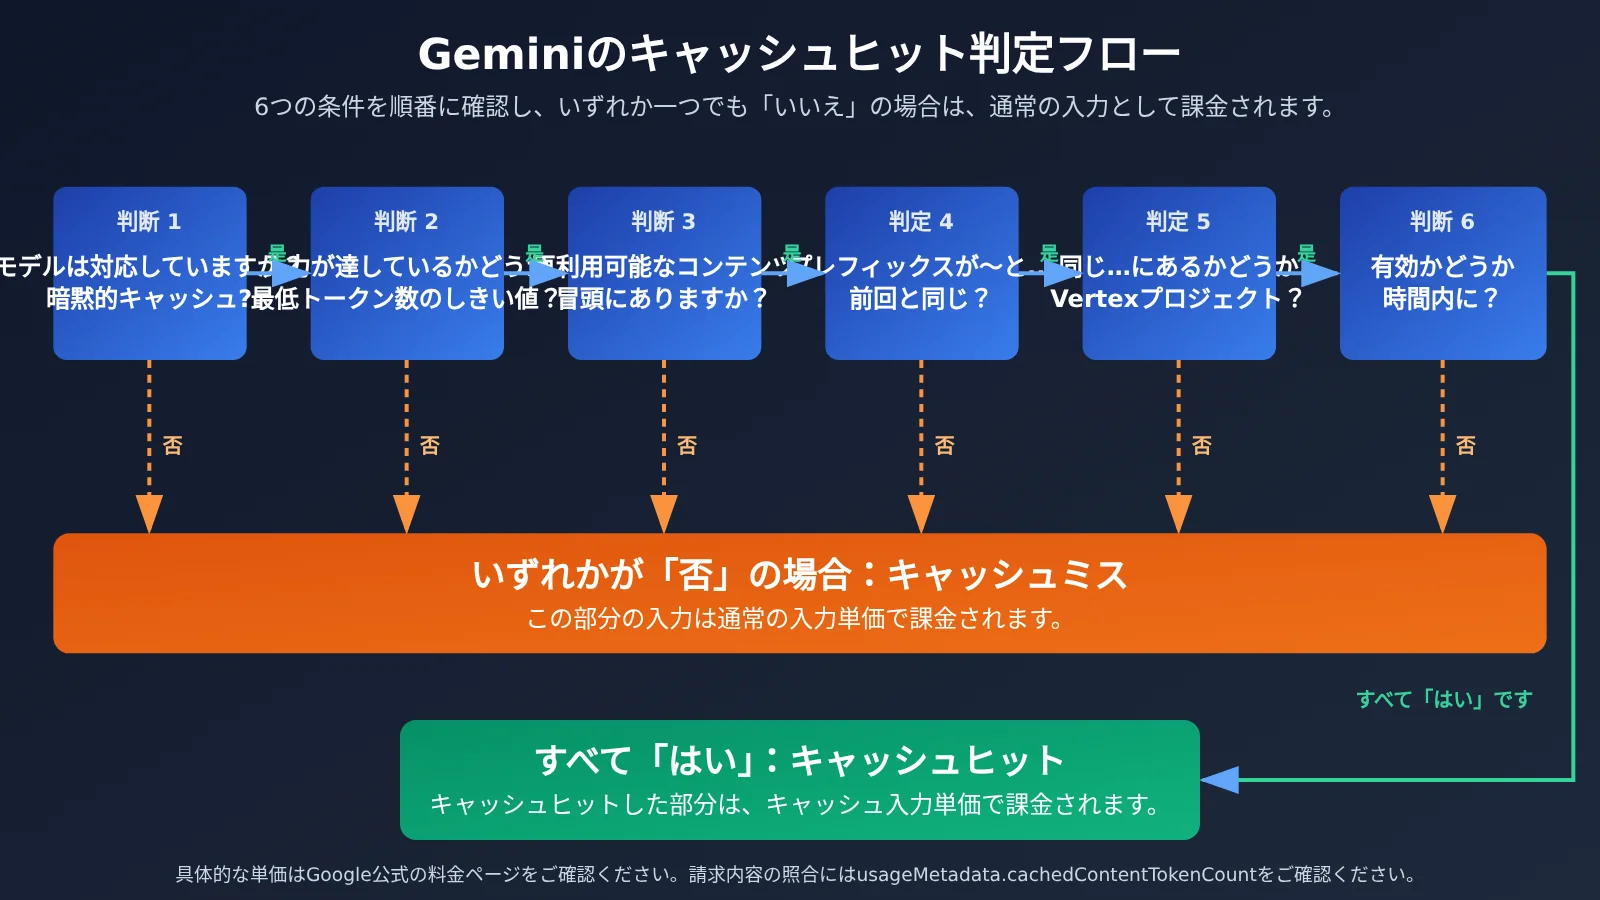
利用者の目線では、APIYI 上の OpenAI や Claude シリーズは「同じ長いプレフィックスを送れば、キャッシュの書き込みやヒットを安定して確認できる」ように見えます。一方、Gemini では、複数の条件を同時に満たす必要があります。モデルが暗黙的キャッシュに対応していること、リクエストがモデルごとの最低トークンしきい値に達していること、再利用する内容がプロンプトの先頭にあること、類似したリクエストが短い間隔で送信されること、さらに Vertex 側では同じ Google Cloud プロジェクト内であることが条件です。
条件をひとつでも満たさないと、リクエストは通常の入力料金で課金されます。エラーも表示されず、通知もありません。キャッシュの不発が気づかれにくく、「ヒット率が低い」と感じることが多いのはこのためです。
まず用語を整理:AI Studio とは
本記事でいう「AI Studio チャネル」は、Gemini Developer API を指します。つまり、AI Studio で作成した APIキーを使って呼び出す経路のことで、Google Cloud 上の Vertex AI と比較しています。両者のキャッシュの基本的な仕組みは共通していますが、最低しきい値の数値、分離の範囲、保存料金のルールには違いがあります。詳しくは後ほど項目ごとに説明します。
Geminiのキャッシュヒット率が低い5つの原因
以下の分析は2つの層に分けられます。最初の2つは公式ドキュメントに明記されたルールで、残りの3つは「中継やエンジニアリングの実務でルールが崩れる」場合に考えられる条件付きの説明です。「中継を使っている」という情報だけでは、どの原因に当てはまるか特定できません。特定には、上流側のプロジェクト情報とリクエスト記録が必要です。
原因1:リクエストがキャッシュの最低トークン数に達していない
暗黙的キャッシュには最低トークン数の条件があり、入力が短すぎるリクエストはキャッシュされません。また、Developer APIとVertexでは条件が完全には一致しません。以下は、現行ドキュメントに記載されているモデルの一部です。
| モデル | Developer APIの暗黙的キャッシュのしきい値 | Vertexの暗黙的キャッシュのしきい値 |
|---|---|---|
| Gemini 3.8 Flash | 4,096 | 6,144 |
| Gemini 3.1 Pro Preview | 4,096 | 6,144 |
| Gemini 2.5 Pro(旧世代・比較用) | 2,048 | 2,048 |
注意したい点は2つあります。1つ目は、Gemini 3.8 Flashのような新世代モデルは、2.5シリーズよりしきい値が高いことです。初期バージョンの2,048トークンを基準に見積もると、判断を誤る可能性があります。2つ目は、同じモデルでもVertexのしきい値のほうが高い場合があることです。たとえば、5,000トークンのリクエストはDeveloper APIでは条件を満たしますが、Vertexでは満たしません。
日常会話のリクエストは通常、数百から1、2千トークン程度です。そのため、しきい値を下回りやすく、チャット用途でGeminiのキャッシュヒット率が低くなる最も直接的な原因の1つとなっています。なお、しきい値に達することは必要条件にすぎず、キャッシュヒットが保証されるわけではありません。
原因2:再利用するコンテンツがプロンプトの先頭にない
GoogleはDeveloper APIとVertexの両方で、長く繰り返し使うコンテンツをプロンプトの先頭に置き、短い間隔で共通のプレフィックスを持つリクエストを送ることを推奨しています。キャッシュが依存するのは共通プレフィックスであり、「リクエストに同じドキュメントが含まれていること」ではありません。
つまり、2つのリクエストに同じドキュメントを含めても、それだけでキャッシュヒットが保証されるわけではありません。リクエスト内での位置や、その前にある内容が安定しているかどうかも重要です。次のような書き方では、プレフィックスが簡単に変わってしまいます。
# 反例:変化する内容を先頭に置く
[現在時刻:2026-10-20 10:31:07]
[リクエスト ID:a8f3...]
{system 指令}
{長文書}
{ユーザーの質問}
先頭の文字が1つでも異なると、その後に続く長いドキュメントは、前回のリクエストとの共通プレフィックスを形成できません。これは公式の推奨事項に基づく推測ですが、エンジニアリングの現場ではよく見られる問題です。
原因3:中継レイヤーがプレフィックスを変更している(条件付き)
中継レイヤーがプロンプトの先頭に変化する時刻、識別子、トレース情報などを挿入したり、複数ターンのコンテキストを並べ替えたり、圧縮・切り詰めたりすると、共通プレフィックスが変わり、キャッシュヒットの可能性が下がります。ただし、これは条件付きの分析であり、特定のサービスがそのような処理をしていると断定することはできません。
調査では、次の2つの観点を分けて確認しましょう。中継サービスに送るリクエストのプレフィックスが安定しているか、そして中継サービスからGoogleに送られるリクエストのプレフィックスが安定しているかです。前者は自分で制御できますが、後者を確認するには上流側のリクエスト記録が必要です。
原因4:リクエストが複数のVertexプロジェクトに分散している(条件付き)
Vertexでは、キャッシュはGoogle Cloudプロジェクトごとに分離され、プロジェクト間で共有されません。同じセッションの複数のリクエストが異なるVertexプロジェクトに振り分けられると、プロジェクトAで作成されたキャッシュをプロジェクトBから利用することはできません。
ただし、「キーを変更するとキャッシュが失われるかどうか」は、プロジェクトも同時に変更されるかによります。キーを変更するたびにキャッシュが失われると決めつけず、キーとプロジェクトの対応関係を確認する必要があります。
原因5:生成リクエストを転送するだけで、明示的キャッシュを使っていない
呼び出し経路がgenerateContentリクエストを転送するだけで、キャッシュオブジェクトを作成せず、後続のリクエストでそのオブジェクトを参照していない場合、経路全体が暗黙的キャッシュだけに依存することになります。暗黙的キャッシュには確実性がないため、明示的キャッシュのように「一度作成し、繰り返し参照する」ことで安定した効果を得ることはできません。
以下の表では、いくつかの中継のケースを公式ルールと対応づけています。
| 実際の動作 | 想定される影響 | 関連する公式ルール |
|---|---|---|
| 同じセッションのリクエストが複数のVertexプロジェクトに振り分けられる | 別プロジェクトにあるキャッシュを再利用できない | キャッシュはプロジェクトごとに分離 |
| 先頭に変化する時刻や識別子を挿入する、またはコンテキストを並べ替える | 共通プレフィックスが崩れ、ヒットの可能性が下がる | 長いコンテンツを先頭に置く、プレフィックスを似た状態にする |
| リクエストが短く、再利用できる固定コンテンツが不十分 | キャッシュのしきい値に達しない | 最低トークン数の条件 |
| 生成リクエストを転送するだけで、明示的キャッシュオブジェクトを作成・参照しない | 暗黙的キャッシュにしか依存できず、確実性がない | 明示的キャッシュにはオブジェクトの作成と参照が必要 |
🎯 技術的なアドバイス:Geminiのキャッシュに関する問題を調査する際は、まずAPIYI(apiyi.com)を通じて、同じ固定の長いプレフィックスを使ったリクエストを連続して複数回送信し、各レスポンスのキャッシュトークンのフィールドを比較することをおすすめします。条件を制御したリクエストで、まずプレフィックスとしきい値の問題を切り分けてから、リクエスト経路に原因があるか判断しましょう。
上流側のプロジェクト情報とリクエスト記録がなければ、「中継を使っている」という理由だけで原因を特定することはできません。また、Vertexのヒット率がDeveloper APIより必ず高いとする公式な根拠もありません。
AI StudioとVertexのキャッシュ課金の仕組み
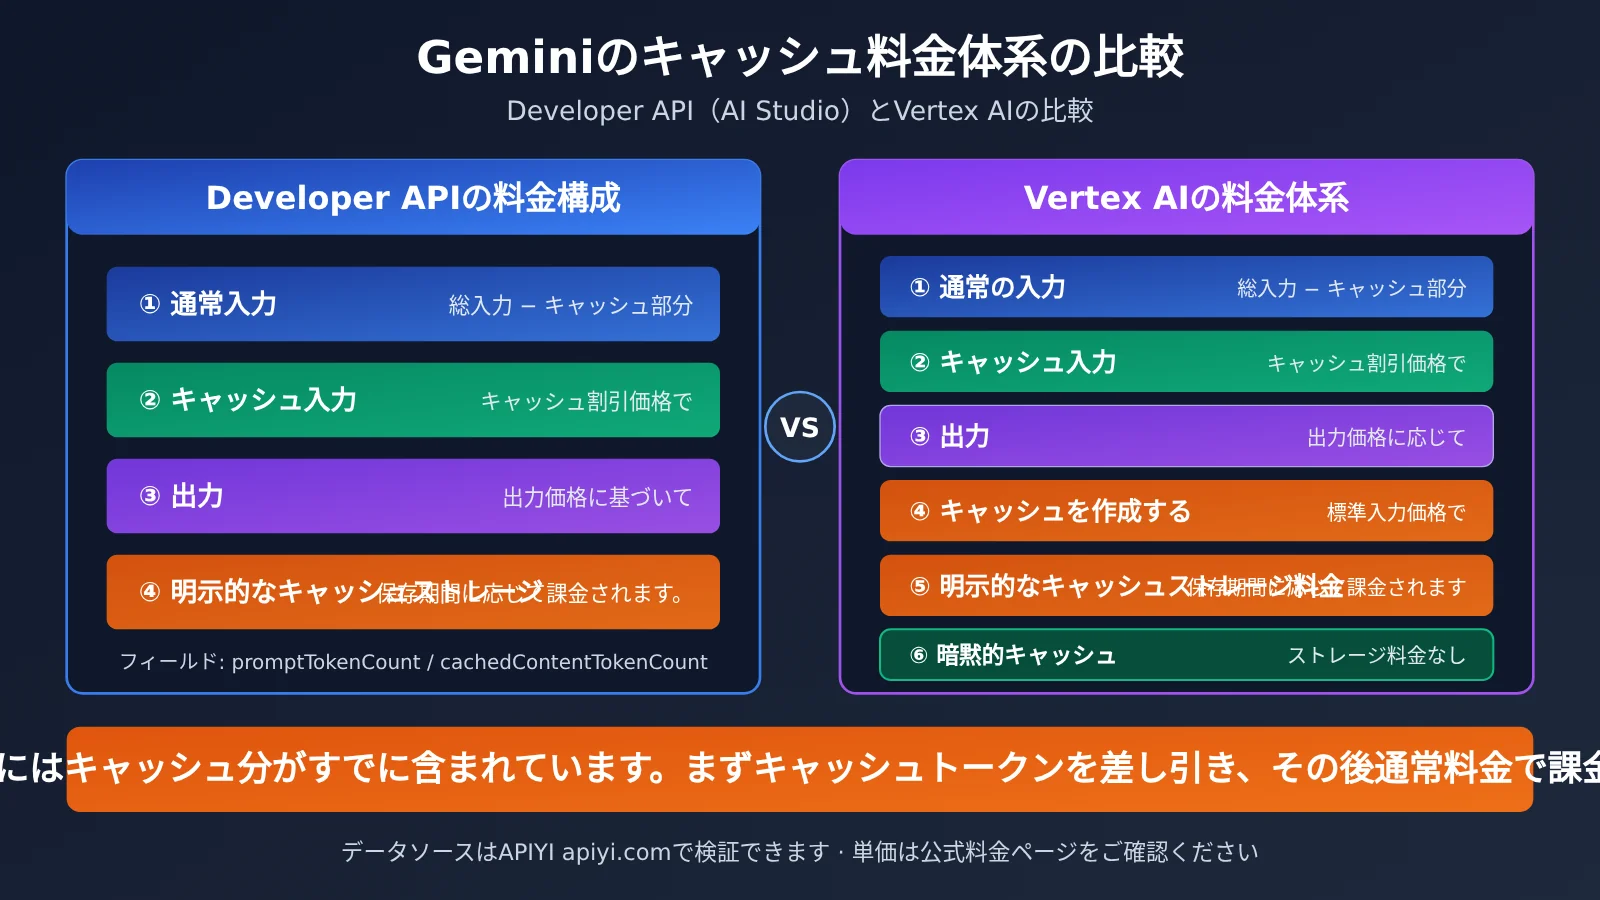
「キャッシュにヒットすれば無料になる」「リクエスト全体が一律に割引される」と考える人もいますが、これは正確ではありません。どちらのサービスでも、課金項目は通常の入力、キャッシュ入力、出力、明示的なキャッシュのストレージ料金の4つに分けて考える必要があります。
両サービスの課金ルールの比較
| 課金項目 | Developer API(AI Studio) | Vertex AI |
|---|---|---|
| 通常の入力(キャッシュにヒットしなかった部分) | 通常の入力単価で課金 | 通常の入力単価で課金 |
| キャッシュ入力(ヒットした部分) | キャッシュ入力単価で課金。料金ページに個別の価格が記載 | キャッシュ入力単価で課金。料金ページに個別の価格が記載 |
| 出力 | 別途課金 | 別途課金 |
| キャッシュ作成に使う入力 | キャッシュトークンの使用料に含まれる | 標準の入力料金で課金 |
| 暗黙的なキャッシュのストレージ料金 | なし | なし |
| 明示的なキャッシュのストレージ料金 | 保存期間に応じて課金 | ストレージ料金あり |
Developer APIのドキュメントでは、キャッシュトークンの使用料、保存期間、キャッシュされていない入力、出力が課金要素として挙げられています。一方、Vertexでは、キャッシュ作成に使う入力には標準の入力料金が適用されること、暗黙的なキャッシュにはストレージ料金がかからず、明示的なキャッシュにはストレージ料金がかかることが明記されています。具体的な単価は、各サービスの最新の公式料金ページをご確認ください。モデルやバージョンによって変わる場合があります。
入力料金の計算式
通常のテキスト生成リクエストでは、入力料金を次のように考えられます。
入力料金 =
(入力トークンの合計 − キャッシュヒットしたトークン数)× 通常の入力単価
+ キャッシュヒットしたトークン数 × キャッシュ入力単価
出力料金は別途計算し、明示的なキャッシュを使う場合はストレージ料金も加算します。たとえば、あるリクエストの入力が合計10,000トークンで、そのうち8,000トークンがキャッシュにヒットした場合、通常料金で課金されるのは2,000トークン、キャッシュ料金で課金されるのは8,000トークンです。
間違えやすいポイント:入力の合計にはキャッシュ分も含まれる
課金を照合するときは、中継サービスの管理画面に表示される「キャッシュヒット率」だけでなく、Googleからの元のレスポンスも確認しましょう。generateContentレスポンスのusageMetadataには、次の2つの重要なフィールドがあります。
| フィールド | 意味 | 照合時の注意点 |
|---|---|---|
usageMetadata.promptTokenCount |
入力トークンの合計 | キャッシュ分を含む |
usageMetadata.cachedContentTokenCount |
キャッシュされたトークン数 | キャッシュにヒットした数量 |
そのため、promptTokenCountの全量を通常料金で計算したうえで、キャッシュ入力料金を追加すると、二重計上になります。正しく計算するには、まず入力の合計からキャッシュ分を差し引き、通常料金で課金される分を求めます。新しいInteractions APIを利用している場合、公式が示すキャッシュ統計フィールドはusage.total_cached_tokensです。
分けて考えるべき2つのこと
Googleの上流で実際にキャッシュにヒットした量と、中継サービスがその割引分を請求にどう反映するかは、分けて考える必要があります。前者は公式フィールドで確認できますが、後者は中継サービス独自の課金ルールによるため、Googleの公式ドキュメントでは確認できません。請求を照合する際は、上流から返されたキャッシュ関連フィールドと、請求明細における課金基準の両方を確認しましょう。
💡 選び方のヒント:まずリクエスト単位のキャッシュトークンのフィールドを確認し、その後で請求の集計を確認しましょう。OpenAI、Claude、Geminiを同じ条件で比較したい場合は、APIYI apiyi.comを通じて同じプロンプトでそれぞれのモデルを呼び出すと、モデルをすばやく切り替えられます。
GeminiとClaude、OpenAIのキャッシュ課金の違い
3社ではキャッシュの仕組みが異なるため、請求の照合基準も異なります。次の表では「キャッシュの適用方法」と「課金方法」を比較しています。割引率や有効期間はモデルのバージョンによって変わるため、表の内容は執筆時点での大まかな目安です。具体的な数値は各社の公式料金ページをご確認ください。
| 比較項目 | Gemini | Claude | OpenAI |
|---|---|---|---|
| キャッシュの適用方法 | 暗黙的な自動キャッシュと、明示的なキャッシュオブジェクトの2つの仕組み | 明示的。リクエストでcache_controlを使ってキャッシュのブレークポイントを指定 |
自動。コードの変更は不要 |
| キャッシュ書き込み料金 | 暗黙的なキャッシュは無料。明示的なキャッシュは作成時に入力料金がかかり、別途ストレージ料金も発生 | あり。書き込み単価は通常の入力より高い(5分と1時間で有効期間ごとに単価が異なる) | 書き込み料金は別途かからない |
| キャッシュ読み込み(ヒット)料金 | 通常の入力より低い。割引率はモデルによって異なる | 通常の入力のおよそ10分の1 | 通常の入力より低い。割引率はモデルによって異なる |
| ストレージ料金 | 明示的なキャッシュのみ。保存期間に応じて課金 | なし。有効期間は書き込み時に選択 | なし |
| 最低条件 | モデルや利用経路によって異なる。VertexではDeveloper APIより高い場合がある | モデルによって異なり、一般的には1,024トークン以上 | 通常は1,024トークン以上 |
| キャッシュヒットの保証 | 暗黙的なキャッシュでは保証されない。明示的なキャッシュは比較的確実 | ブレークポイントを指定すると、有効期間内は通常安定してヒット | 自動のプレフィックスマッチング。保証はない |
| 使用量フィールド | cachedContentTokenCount(promptTokenCountに含まれる) |
cache_creation_input_tokens、cache_read_input_tokens。通常の入力トークンとは分けて表示 |
prompt_tokens_details.cached_tokens(prompt_tokensに含まれる) |
特に混同しやすい点は、次の3つです。
- 書き込み料金:Claudeではキャッシュの書き込みに追加料金がかかり、読み込みは安くなります。そのため、「書き込みが多く、読み込みが少ない」場合は、キャッシュを使わない場合より高くなることがあります。OpenAIには書き込み料金がなく、キャッシュにヒットしなくても追加料金は発生しません。Geminiの暗黙的なキャッシュにも書き込み料金はありませんが、明示的なキャッシュでは作成費用とストレージ料金が発生します。
- キャッシュを決めるのは誰か:Claudeではリクエスト側がブレークポイントを明示するため、キャッシュヒットの見通しが最も立てやすくなります。OpenAIとGeminiの暗黙的なキャッシュはプラットフォームが自動で判断するため、開発者はプレフィックスを安定させることでヒットの可能性を高められます。Geminiのキャッシュが不安定に感じられる理由の一つは、しきい値、プレフィックス、利用経路ごとの分離など、複数の要素の影響を受けることです。
- 入力の合計の扱い:GeminiとOpenAIでは、入力の合計にキャッシュ分が含まれるため、料金計算では先に差し引く必要があります。Claudeの
input_tokensにはキャッシュの読み書き分が含まれないため、3つの項目を個別に計算してから合算します。あるサービスの計算式を別のサービスに当てはめると、請求の計算を誤る可能性があります。APIYI apiyi.comを利用してモデル間の請求を照合する場合は、各サービスが返すフィールドの扱いを事前に確認してください。
Geminiのキャッシュヒット率を手早く確認:自分でテストしてみよう
理論を確認したら、実際に試してみるのがいちばん確実です。ここでは、最低条件を超える長さの固定プレフィックスを用意し、変化する質問を末尾に置いて数回連続でリクエストし、キャッシュトークンのフィールドがどう変化するかを確認します。
最小限のサンプル
以下のコードでは、OpenAI互換形式でAPIを呼び出し、返された使用量情報を表示します。フィールド名は実際のレスポンスに合わせてください。キャッシュ関連フィールドの名前は、接続方法によって異なる場合があります。
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

# 固定的な長いプレフィックス:対象モデルの最低キャッシュ条件を必ず超えること
LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800

for i in range(3):
    resp = client.chat.completions.create(
        model="gemini-3.8-flash",
        messages=[
            {"role": "system", "content": LONG_PREFIX},
            {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
        ],
    )
    print(i, resp.usage)
    time.sleep(2)
テストと費用確認のコード全体を見る
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800


def extract_cached_tokens(usage) -> int:
    """尝试从 usage 中读取缓存 token 数,字段名以实际返回为准"""
    details = getattr(usage, "prompt_tokens_details", None)
    if details is not None:
        cached = getattr(details, "cached_tokens", None)
        if cached is not None:
            return cached
    return 0


def estimate_input_cost(total_in: int, cached: int,
                        normal_price: float, cached_price: float) -> float:
    """
    按官方口径估算输入费用:
    总输入已包含缓存部分,所以普通部分 = 总输入 - 缓存部分
    单价请填入官方定价页当前数值(每百万 token)
    """
    normal_part = total_in - cached
    return (normal_part * normal_price + cached * cached_price) / 1_000_000


def run_test(model: str, rounds: int = 3):
    results = []
    for i in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": LONG_PREFIX},
                {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
            ],
        )
        usage = resp.usage
        cached = extract_cached_tokens(usage)
        results.append((i, usage.prompt_tokens, cached))
        print(f"第 {i} 次:总输入={usage.prompt_tokens},缓存命中={cached}")
        time.sleep(2)
    return results


if __name__ == "__main__":
    for m in ["gemini-3.8-flash"]:
        print("模型:", m)
        run_test(m)
🚀 すぐに試す:APIYI(apiyi.com)を使って比較テストを行うのがおすすめです。同じスクリプトで
modelの値を変えるだけで、Gemini、OpenAI、Claudeシリーズを順番にテストでき、モデルごとのキャッシュの違いを直感的に確認できます。
テスト時に管理する変数
テストを実行する際は、以下の項目を一つずつ確認しましょう。「自分の設定の問題」を「API接続経路の問題」と誤認するのを防げます。
| 確認項目 | 方法 | 目的 |
|---|---|---|
| プレフィックスの長さ | 対象モデルの現在の最低条件を超えていることを確認する | 最低条件を満たしていない可能性を排除する |
| プレフィックスの安定性 | 先頭にタイムスタンプやリクエストIDを置かない | プレフィックスが変わるのを防ぐ |
| 変更する内容の位置 | ユーザーの質問を末尾に置く | 共通するプレフィックスを最長にする |
| リクエスト間隔 | 短時間のうちに連続して送信する | 公式の推奨に沿う |
| 比較対象 | 同じプロンプトでOpenAIまたはClaudeもテストする | モデルの仕組みとAPI接続経路のどちらに原因があるか判断する |
テスト結果の見方
プレフィックスが十分に長く、構造が安定していて、リクエスト間隔も短いのに、Geminiでほとんどキャッシュにヒットしない一方、同じプロンプトがOpenAIやClaudeでは問題なくヒットする場合、違いの原因はGemini独自のキャッシュの仕組みや上流の接続条件にあると考えられます。プロンプトの書き方が原因ではありません。
その場合は、明示的キャッシュの利用を検討しましょう。再利用したい長い内容を固定し、キャッシュオブジェクトを作成して、リクエストから参照できます。
もともと短い会話が中心の業務であれば、ヒット率を追い求めるより、こうした用途ではGeminiのキャッシュによる効果が限られると受け止め、モデルの選定や出力の長さの調整にコスト削減の重点を置くのがおすすめです。
よくある質問
Q1: Geminiのキャッシュヒット率がOpenAIやClaudeより明らかに低いのはなぜですか?
Geminiの暗黙的キャッシュを利用するには、モデルが対応していること、最低トークン数の条件を満たしていること、プレフィックスが安定していること、リクエストの時間間隔が近いことなど、複数の条件を満たす必要があります。また、Vertexではプロジェクト単位の分離があり、公式もキャッシュへのヒットを保証していません。どれか一つでも条件を満たさなければ、通常の入力として課金されます。特定の接続経路で起きている原因を調べるには、上流のリクエスト記録を確認する必要があります。
Q2: Googleは公式に、API中継サービスの利用でキャッシュヒット率が下がると言っていますか?
いいえ。公式が示しているのは、再利用可能なプレフィックス、最低トークン数の条件、適用範囲など、キャッシュの利用に関する条件です。接続経路によってこれらの条件が変われば、ヒット率が下がる可能性があります。モデルごとのキャッシュの違いを比較したい場合は、APIYI(apiyi.com)を利用して、同じプロンプトで条件をそろえたテストを行えます。
Q3: キャッシュにヒットした部分は無料ですか?
いいえ。キャッシュにヒットした部分には、通常の入力より安いキャッシュ入力料金が適用されますが、無料ではありません。各社の料金ページには、通常入力とキャッシュ入力の料金がそれぞれ掲載されています。明示的キャッシュでは、別途ストレージ料金もかかります。
Q4: 請求書の入力トークンに、キャッシュ分を別途加算する必要はありますか?
必要ありません。`promptTokenCount`はキャッシュ分を含む入力トークンの合計です。合計から`cachedContentTokenCount`を差し引くと、通常料金で課金される部分を算出できます。キャッシュ分は別途計算してください。
Q5: AI StudioとVertexのキャッシュ条件は同じですか?
完全には同じではありません。現在のドキュメントによると、Gemini 3.1 Pro PreviewとGemini 3.8 Flashの最低条件は、Developer APIでは4,096トークン、Vertexでは6,144トークンです。旧世代のGemini 2.5 Proは、どちらも2,048トークンです。条件はモデルのバージョンに応じて変更されるため、最新の数値は公式ドキュメントで確認してください。
Q6: APIキーを変更すると、キャッシュは失われますか?
プロジェクトを変更するかどうかによります。VertexのキャッシュはGoogle Cloudプロジェクトごとに分離されており、プロジェクト間で共有されません。そのため、別のプロジェクトのAPIキーに切り替えるとキャッシュは引き継がれません。同じプロジェクト内の別のAPIキーであれば、キャッシュが失われるとは一概に言えません。
Q7: 暗黙的キャッシュと明示的キャッシュ、どちらを使うべきですか?
長い文書や長いシステム指示など、固定した内容を何度も参照する場合は、明示的キャッシュのほうが確実です。ただし、開発コストとストレージ料金がかかります。再利用がたまにしかない場合は、費用のかからない暗黙的キャッシュが手軽ですが、効果は予測できません。まずAPIYI(apiyi.com)を使って小規模な比較テストを行い、明示的キャッシュの開発に取り組むか判断するとよいでしょう。
Q8: API中継サービスの管理画面に表示されるヒット率を、そのまま請求額の確認に使えますか?
おすすめしません。公式のレスポンスに含まれるキャッシュ関連フィールドを基準にしてください。また、Googleの上流で実際にキャッシュにヒットしたかどうかと、API中継サービスがどのように請求額に反映するかは別の問題です。後者については、中継サービス独自の課金ルールを確認する必要があります。
キャッシュヒット率の要点
- 現象は確認されています:OpenAIとClaudeの各モデルではキャッシュが安定してヒットする一方、Geminiではヒット率が低く、ほとんどヒットしない場合もあります。個別に分析が必要です。
- 公式にはヒットが保証されていません:Geminiの暗黙的キャッシュでは、費用削減は保証されません。明示的キャッシュを使うには、キャッシュオブジェクトを自分で作成し、リクエストから参照する必要があります。
- しきい値はモデルによって異なります:新世代のモデルほどしきい値が高く、VertexとDeveloper APIでも数値が異なる場合があります。
- ヒットを左右するのはプレフィックスです:長い内容は先頭に置き、冒頭に時刻やIDなど変化する内容を挿入しないでください。共通プレフィックスが崩れる原因になります。
- Vertexのキャッシュはプロジェクトごとに分離されます:キャッシュはプロジェクト間で共有されないため、リクエストが複数のプロジェクトに分散するとキャッシュを利用できなくなります。
- 入力トークンの合計にはキャッシュ分も含まれます:
promptTokenCountにはキャッシュされた部分も含まれます。請求を照合する際は、まずキャッシュ分を差し引いてから、それぞれの料金を計算してください。 - フィールドを使って照合しましょう:公式レスポンスのキャッシュ関連フィールドを基準にし、APIYI(apiyi.com)を利用して、同じプロンプトで複数モデルを比較してください。
まとめ
Geminiのキャッシュヒット率が低いのは、暗黙的キャッシュでヒットが保証されないこと、モデルごとに異なる最低トークン数のしきい値、プレフィックスを一定に保つ必要があること、Vertexのキャッシュがプロジェクト単位で分離されること、明示的キャッシュを自分で作成する必要があることなど、複数の条件が重なるためです。特に後者の条件がリクエスト経路上で変わると、ヒット率が下がる可能性があります。ただし、具体的な原因を特定するには、上流側のプロジェクト設定とリクエスト記録の確認が必要です。
料金を確認する際は、次の3点を押さえておきましょう。キャッシュにヒットしても無料にはなりません。入力の合計にはキャッシュ分が含まれるため、二重に計上しないでください。また、明示的キャッシュには別途ストレージ料金がかかりますが、暗黙的キャッシュにはかかりません。照合の基準は公式レスポンスのフィールドとし、API中継サービスの料金体系も別途確認してください。
次のステップとして、この記事のテストスクリプトを使い、長いプレフィックスを固定した状態でGemini、OpenAI、Claudeを比較してから、明示的キャッシュの導入を検討しましょう。APIYI(apiyi.com)を利用すれば、複数のモデルで同じインターフェースを使って効果を手軽に検証でき、比較の手間も抑えられます。
参考資料
- Gemini API のキャッシュに関するドキュメント:暗黙的キャッシュと明示的キャッシュの公式説明
- リンク:
ai.google.dev/gemini-api/docs/caching -
内容:最低トークン数の条件と料金に関する要素を確認できます
-
Gemini API の料金ページ:通常の入力、キャッシュされた入力、出力、ストレージの料金
- リンク:
ai.google.dev/gemini-api/docs/pricing -
内容:最新の単価を確認する際の根拠となります
-
Vertex AI のコンテキストキャッシュ概要:キャッシュのプロジェクト分離と料金ルール
- リンク:
docs.cloud.google.com/vertex-ai/generative-ai/docs/context-cache/context-cache-overview -
内容:Vertex AI のキャッシュはプロジェクト間で共有されないことを説明しています
-
Gemini API の generateContent リファレンス:レスポンス内の
usageMetadataフィールド - リンク:
ai.google.dev/api/generate-content - 内容:利用料金の照合に使うキャッシュトークンのフィールドを確認できます
著者:APIYI Team
技術交流:コメント欄で Gemini のキャッシュに関するトラブルシューティングの経験をぜひ共有してください。詳しい情報は APIYI のドキュメントセンター(docs.apiyi.com)をご覧ください。