最近、多くの開発者から「直感に反する」使用感が報告されています。claude-opus-5-5 はまったく遅く感じられず、タスクによっては claude-sonnet-5-5 より早く完了することさえあります。フラッグシップモデルが高速かつ高性能なら、Sonnet のメリットは「半額であること」だけなのでしょうか? 答えはそれほど単純ではありません。本記事では、6組の公開データをもとに claude-sonnet-5-5 と claude-opus-5-5 の実際の違いを詳しく解説します。さらに、企業向けの長文入力・長文出力を扱うAgent環境で、両モデルをどのように役割分担・組み合わせればよいかという、より実践的な疑問にも答えます。
この記事で得られること: Opus が「速い」本当の理由、Sonnet が価格以外に持つ明確な強み、そしてそのまま導入できる Opus + Sonnet のデュアルモデルAgentアーキテクチャが分かります。
claude-sonnet-5-5 と claude-opus-5-5 の主要スペック早見表
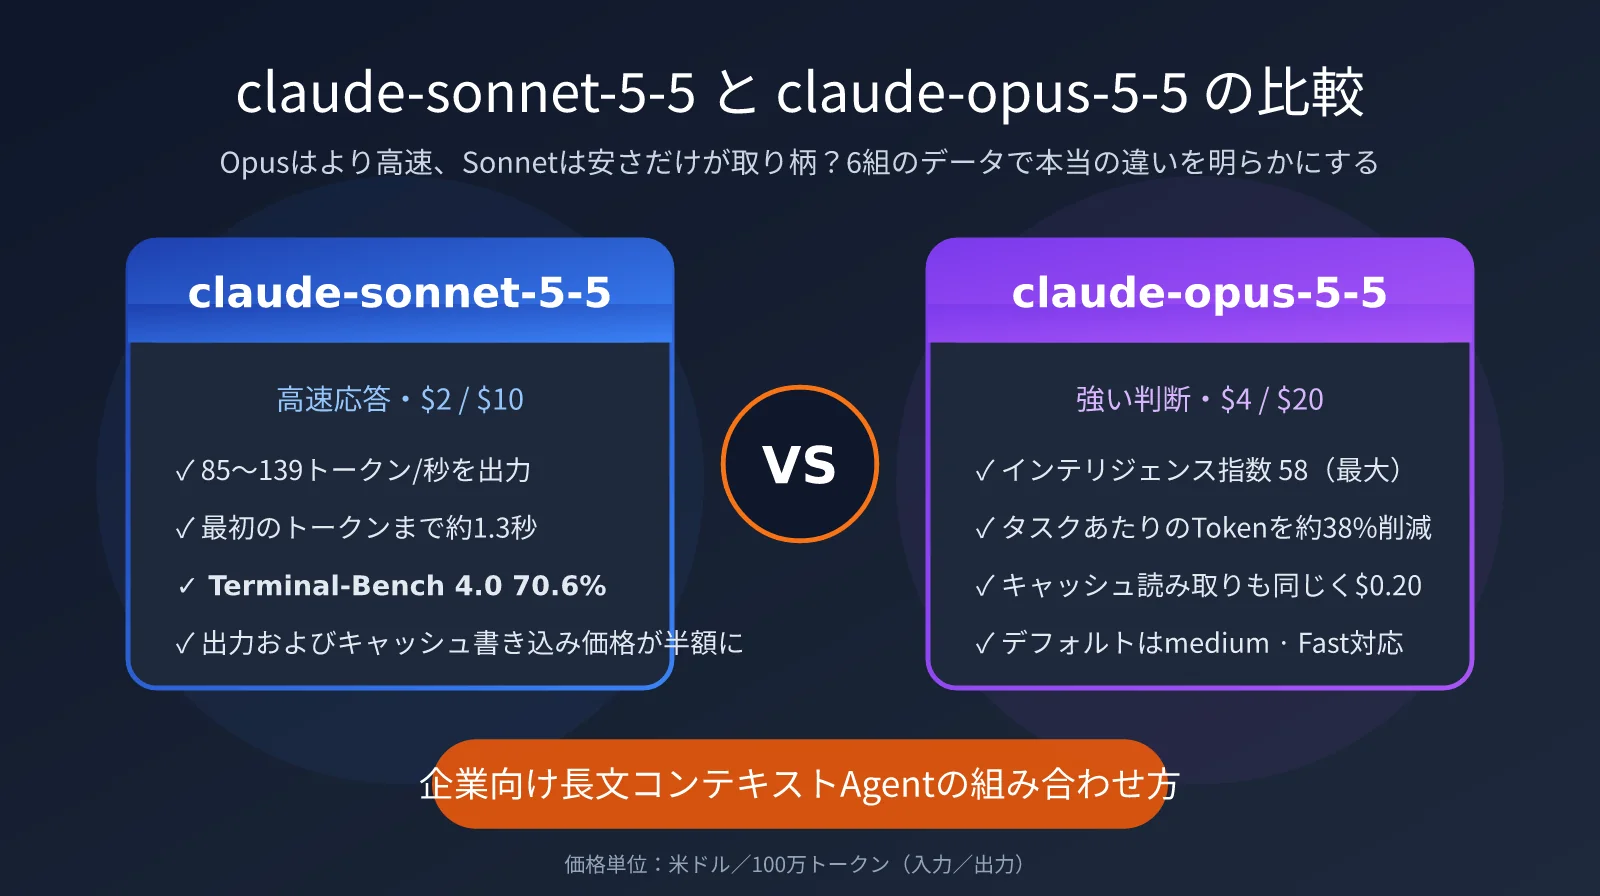
claude-opus-5-5 は2026年9月22日、claude-sonnet-5-5 は9月28日にリリースされ、いずれも Claude 5.5 ファミリーに属します。今回の世代で特に注目したいのは、Opus が値下げされたことです。標準価格は Opus 5 の $5/$25 から20%引き下げられ、$4/$20 になりました。キャッシュ読み取り料金は $0.50 から $0.20 へと大きく下がり、Sonnet と完全に同額です。一方、Sonnet 5.5 は $2/$10 の価格を維持しており、公式発表によれば、1タスクあたりのコストは前世代比で最大約30%低減されています。
| 項目 | claude-sonnet-5-5 | claude-opus-5-5 |
|---|---|---|
| リリース日 | 2026-09-28 | 2026-09-22 |
| 入力 / 出力料金 | $2 / $10 | $4 / $20 |
| キャッシュ読み取り | $0.20 | $0.20(基本入力料金の5%) |
| 5分間キャッシュ書き込み | $2.50 | $5 |
| Batch料金 | $1 / $5 | $2 / $10 |
| コンテキストウィンドウ | 100万トークン、長文コンテキストの追加料金なし | 100万トークン、長文コンテキストの追加料金なし |
| 最大出力 | 128K(Batchベータ版では300K) | 128K(Batchベータ版では300K) |
| APIのデフォルト推論レベル | high | medium |
| Fastモード | 非対応 | 対応、出力速度は約2.5倍、$8 / $40 |
| 利用可能なプラットフォーム | APIYI apiyi.com、Anthropic公式API | APIYI apiyi.com、Anthropic公式API |
この表には、使用感を直接左右する2つの重要なポイントが隠れています。1つ目は、両者でデフォルトの推論レベルが異なることです。Opus のデフォルトは medium であるのに対し、Sonnet のAPIデフォルトは high です。Opus のほうが速いと感じる最大の理由は、多くの場合ここにあります。2つ目は、キャッシュ読み取り料金が同額であることです。長いコンテキストを繰り返し利用するAgent環境では、両モデルの入力コスト差は大幅に小さくなります。
🎯 テストのポイント: 2つのモデルを比較する際は、必ず同じ推論レベルを明示的に指定してください。指定しなければ、結論が大きく歪む可能性があります。APIYI apiyi.com で同じAPIキーを使い、claude-sonnet-5-5 と claude-opus-5-5 をそれぞれ呼び出して、
modelとreasoning_effortの2つだけを切り替える比較テストをおすすめします。
claude-opus-5-5 が claude-sonnet-5-5 より速く感じられる理由
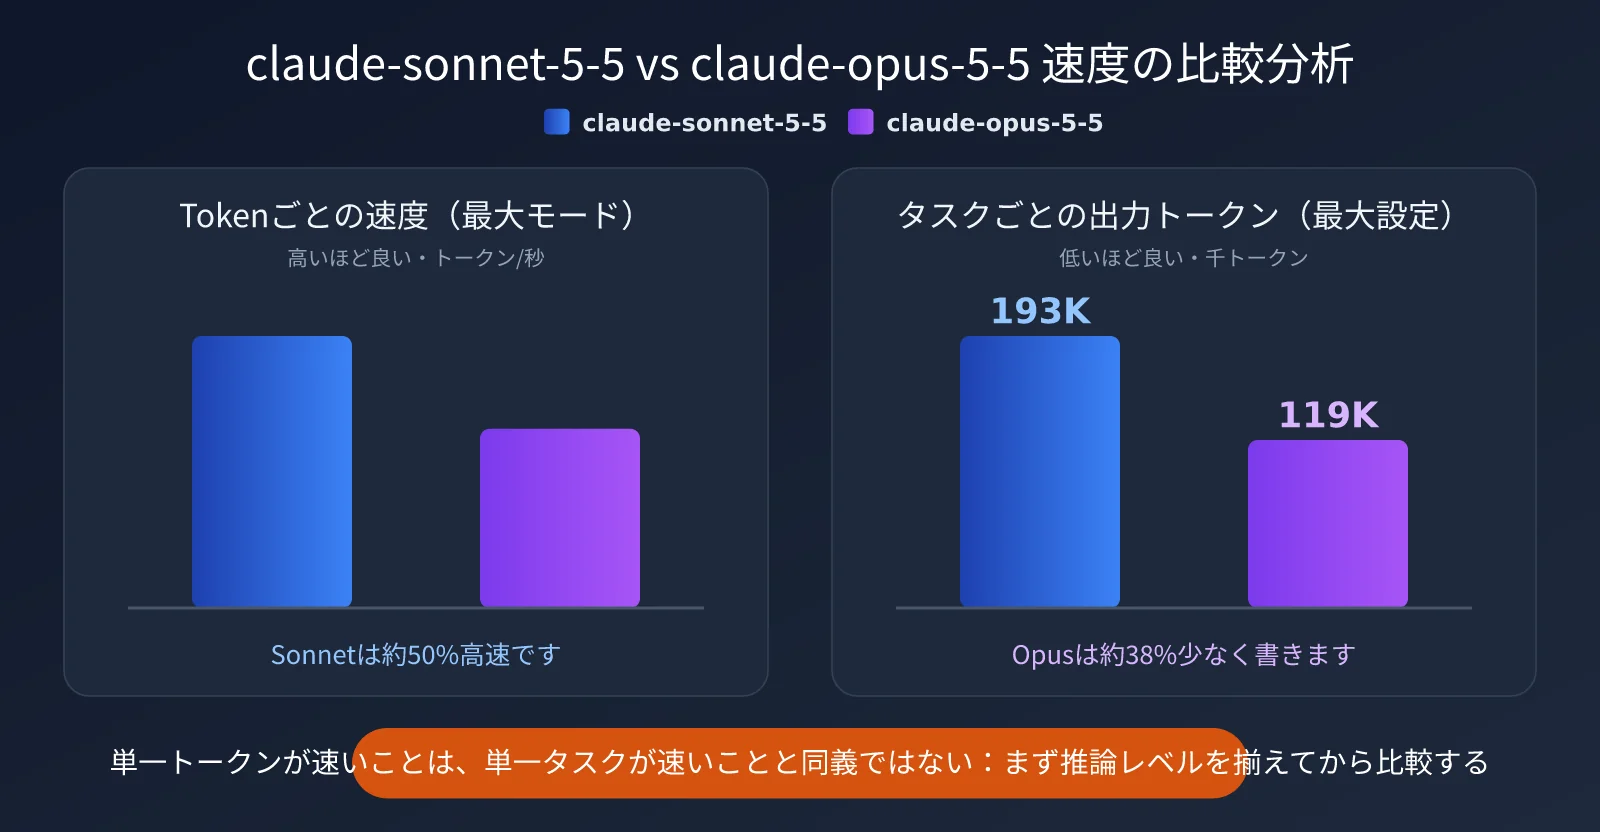
純粋な生成速度だけを見ると、claude-sonnet-5-5 のほうが明らかに高速です。Artificial Analysis の測定では、Sonnet 5.5 の出力速度は推論設定ごとに毎秒 85〜139トークン、Opus 5.5 は毎秒 74〜93トークンでした。Anthropic公式も、Sonnetのレイテンシー評価を「高速」、Opusを「中程度」としています。
では、「Opusのほうが速い」と感じるのはなぜでしょうか。主な理由は3つあります。
理由1:デフォルト設定が異なり、Sonnetは標準で1段階多く考える
Opus 5.5では、APIのデフォルト設定が前世代の high から medium に引き下げられました。公式によれば、medium設定でもOpus 5のhigh設定と同等、またはそれ以上の性能を実現しています。
一方、Sonnet 5.5のAPIデフォルトは引き続き high であり、思考モードを無効化することもできません。独立テストでは、Sonnetのhigh設定はmedium設定の約2倍の出力トークンを生成する一方、品質には明確な向上が見られませんでした。デフォルトパラメータのまま呼び出すと、Sonnetは実質的に「1段階多く考えている」ため、その分だけ時間がかかります。
理由2:Opusはトークン効率が高い
Artificial Analysisの知能指数テストでは、Sonnet 5.5はmax設定で1タスクあたり平均約19.3万トークンを出力しており、同機関の計測で最高値でした。対してOpus 5.5は、同じ設定で約11.9万トークンです。
1トークンあたりの生成が速くても、1タスク全体が速いとは限りません。Sonnetは毎秒およそ50%多くトークンを生成しても、60%多く出力する必要があれば、エンドツーエンドの所要時間はOpusと同程度、あるいはOpusを下回る可能性があります。
理由3:OpusだけがFastモードを利用できる
Opus 5.5は、Fastモード(研究プレビュー)に対応しています。同じモデルでも、より高速な推論構成を使うことで、出力速度を最大約2.5倍に高められます。料金は入力/出力で $8/$40 です。
コーディングツールでOpusのFastモードを有効にしている場合、「Opusは速い」という印象はさらに強くなるでしょう。ただし、Fastモードで向上するのは毎秒の出力トークン数のみで、最初のトークンが返るまでのレイテンシーは改善されません。また、標準速度の構成とはプロンプトキャッシュを共有しません。
| 速度指標 | claude-sonnet-5-5 | claude-opus-5-5 | 説明 |
|---|---|---|---|
| 出力速度(トークン/秒) | 85〜139 | 74〜93 | Sonnetは1トークンあたりの生成が速い |
| 1タスクあたりの出力トークン数(max設定) | 約19.3万 | 約11.9万 | Opusのほうがトークン効率に優れる |
| 最初のトークンまでのレイテンシー(低設定) | 約1.3秒(medium) | 約14.3秒(low) | Sonnetのほうが素早く応答を開始する |
| 公式レイテンシー評価 | 高速 | 中程度 | Anthropicのモデルページより |
| 実際のコーディングタスクの所要時間(第三者測定) | 29分27秒 | 44分50秒 | Sonnetは約1.5倍高速 |
結論として、デフォルトパラメータではOpusのほうが速く動作する場合があるものの、両者を適切な設定で比較すれば、応答速度では依然としてSonnetに明確な優位性があります。特に最初のトークンまでのレイテンシーは重要です。Sonnetはmedium設定で約1.3秒後には出力を開始できるため、ユーザー向けの対話型エージェントに適しています。
claude-sonnet-5-5 は価格だけが強みなのか?能力比較データ
まず、意外に思えるデータを紹介します。max設定では、Sonnetは必ずしもOpusより安価ではありません。Artificial Analysisが知能指数の全テストを実行した際、Sonnet 5.5(max)の費用は約$8,977、Opus 5.5(max)は約$8,708でした。Opusのほうがわずかに低コストで、スコアも高くなっています(58対56)。
理由は先ほど触れたトークン効率です。したがって、Sonnetをmax設定だけで使う場合、価格面の優位性さえ得られない可能性があります。
では、Sonnetの価値はどこにあるのでしょうか。以下の表は、推論設定別の知能指数スコアです。Sonnetを活かすための適切な使い方が見えてきます。
| 推論設定 | claude-sonnet-5-5 知能指数 | claude-opus-5-5 知能指数 |
|---|---|---|
| max | 56 | 58 |
| xhigh | 52 | 56 |
| high | 47 | 54 |
| medium | 41 | 51 |
| low | — | 42 |
総合的な知能性能では、同一設定のOpusがすべての設定で優位です。さらに、事実正確性(AA-Omniscience:66%対54%)、法務、金融、戦略といった専門領域の指標でも、Opusにはより明確な強みがあります。
ただしSonnetには、Opusで代替しにくい明確な優位性もあります。
- ターミナル型エージェントコーディング:Terminal-Bench 4.0では、Sonnet(max)は70.6%で、Opus(xhigh)の66.4%を上回りました。ただし同じxhigh設定では、Opusが66.4%対61.5%で優位です。Sonnetが逆転するには最高設定まで上げる必要があります。
- 応答レイテンシー:最初のトークンまでの時間と毎秒の出力速度は、どちらもSonnetが明確に優れています。リアルタイム対話やストリーミング出力を行うフロントエンドに適しています。
- キャッシュ未ヒットの入力とキャッシュ書き込み:いずれも単価がOpusの半額です。毎回新しい文書を扱う、単発の長文入力タスクと相性が良いでしょう。
- 長文出力とバッチ処理:出力単価は $10 対 $20、Batchでは $5 対 $10です。長大なレポートや文書を大規模に生成する場合、コスト優位性はそのまま2倍になります。
- 高並行実行:Anthropicの公式ポジショニングでは、SonnetはOpusを補完する、より高速かつ低コストなモデルです。明確に分割できるサブタスクを、多数のサブエージェントで並列実行する用途に向いています。
そのほかの公開ベンチマークでは、OpusはCursorBench 4.0(57.8%対55.5%)、FrontierCode 1.1(54.4%対52.1%)、OSWorld 2.1(81.8%対80.1%)で、いずれも約2ポイントSonnetを上回っています。第三者が集計した長大なコンテキストでのプログラム再構築テスト、ProgramBenchでは、Opusは91.2%、Sonnetは79.7%で、差が大きく広がりました。
これは、超長文のコンテキストを踏まえて正確な判断を行う必要があるほど、Opusの優位性が大きくなることを示しています。
💡 モデル選定のポイント:Sonnetはmediumからxhighの設定で使い、「実行役」として扱うのが適しています。Opusはmedium設定から始める「意思決定役」に向いています。自社業務での差を検証したい場合は、APIYI apiyi.comで同一の長文ドキュメントタスクをそれぞれ実行し、出力品質と実際の課金額を比較してみてください。
企業における長文コンテキスト Agent シナリオの実コスト
企業向け Agent の典型的な負荷は、入力側では数十万 Token に及ぶ契約書、コードベース、ナレッジベースを扱い、出力側では長文レポート、バッチリライト、複数ファイルのコード生成を行うというものです。どちらのモデルも 100 万コンテキストに対応し、長文コンテキストに対する追加料金がないため、実際にコストを左右するのはキャッシュヒット率と出力長です。以下では公式料金をもとに、代表的なシナリオを試算します(Sonnet は Opus の 1.6 倍の出力 Token を使用すると仮定。これは max 設定時の両モデルにおける Token 効率の差に対応します)。
| シナリオ | 負荷の構成 | claude-sonnet-5-5 | claude-opus-5-5 | コスト比 |
|---|---|---|---|---|
| 長文コンテキストでの複数回の追加質問 | 50 万コンテキスト、キャッシュヒット率 95%、新規書き込み 2.5 万 | 約 $0.28(出力 1.2 万) | 約 $0.37(出力 0.75 万) | 1 : 1.3 |
| 長文書の初回読み込み | 50 万 Token を 5 分間キャッシュへ書き込み + 1 万出力 | 約 $1.35 | 約 $2.70 | 1 : 2 |
| 長文レポートの生成 | 5 万入力 + 5 万出力(同一出力量) | 約 $0.60 | 約 $1.20 | 1 : 2 |
| オフラインでのバッチ生成 | Batch モード、入力・出力それぞれ 10 万 | 約 $0.60 | 約 $1.20 | 1 : 2 |
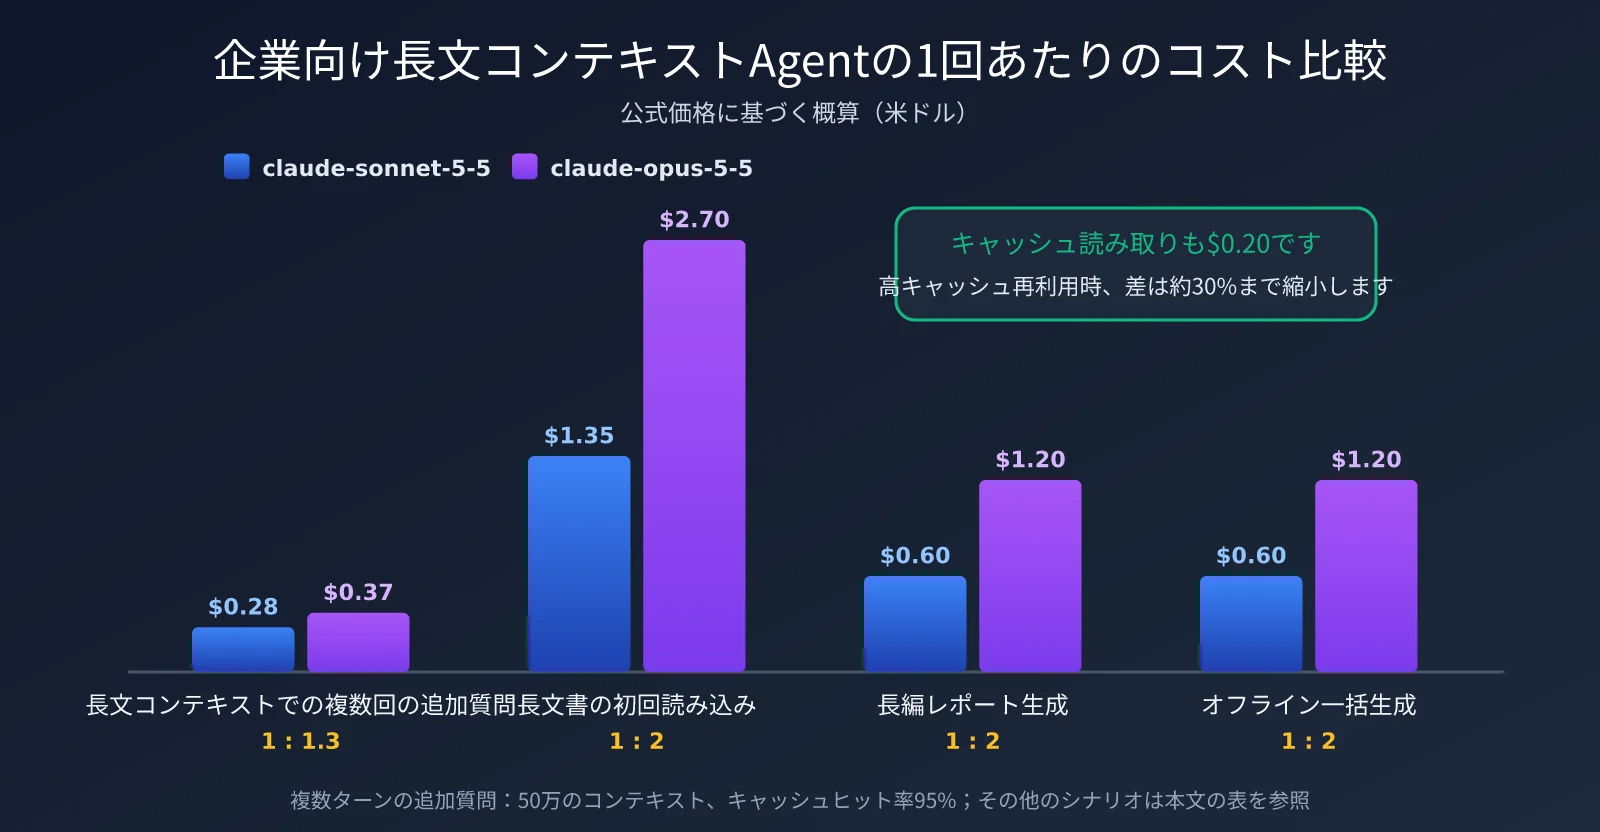
この表から、重要な傾向が見えてきます。「長い入力 + 高いキャッシュヒット率 + 短い出力」で複数回追加質問するケースでは、Opus は Sonnet より約 30% 高いだけです。大部分を占めるキャッシュ読み取りの料金が両モデルで同じであり、さらに Opus のほうが出力 Token を節約できるためです。
一方、「新規文書の初回読み込み」や「長文出力の生成」では、Sonnet のコスト優位性が本来の半額まで戻ります。言い換えると、Opus は「同じ長い資料を繰り返し読み込み、判断を行う」用途に適し、Sonnet は「新しい資料を一度に読み込む」または「大量のコンテンツを生成する」用途に向いています。
もう一つ注意したい点があります。プロンプトキャッシュはモデル間で共有できません。同じ 50 万 Token の文書を Opus が一度読み込み、その後 Sonnet でも読み込む場合、キャッシュ書き込み料金はそれぞれ発生します。そのため、2 モデル構成では、長文コンテキストをできるだけ一方のモデルだけに「常駐」させ、もう一方には要約済みのタスク情報だけを渡すことが重要です。
claude-sonnet-5-5 と claude-opus-5-5 を組み合わせる実践的な方法
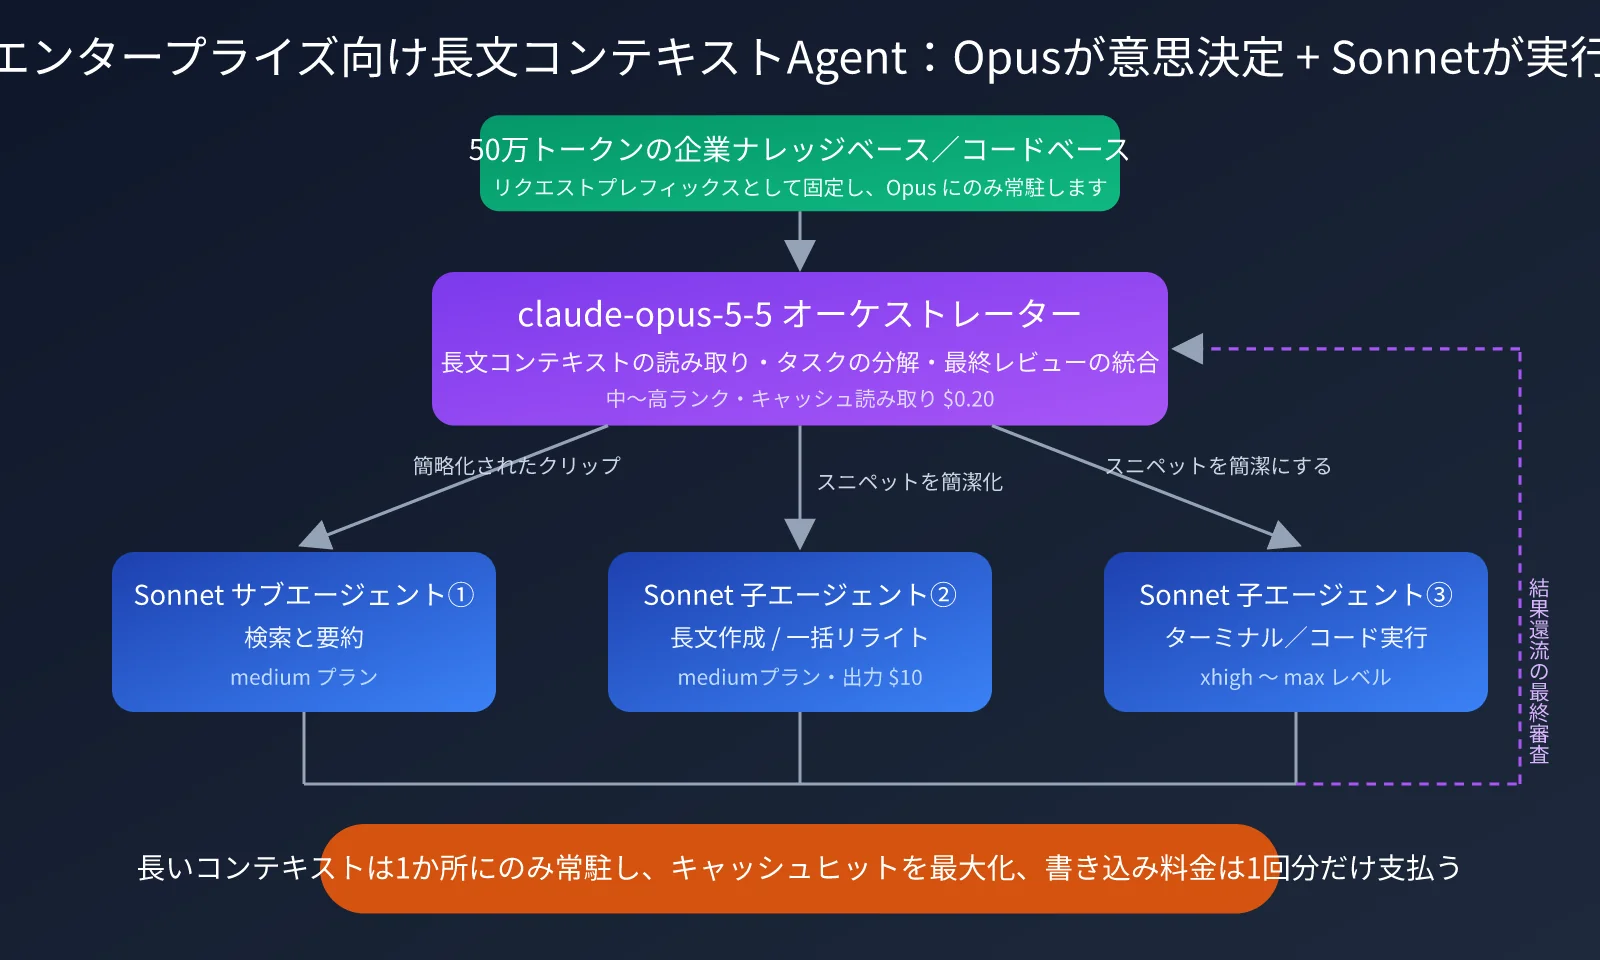
上記のデータを踏まえると、企業向け長文コンテンツ Agent には「Opus が意思決定し、Sonnet が実行する」階層型アーキテクチャをおすすめします。長文コンテキストをどちらが保持するかによって、大きく 2 つの運用パターンに分けられます。
パターン 1:Opus によるオーケストレーション + Sonnet の並列サブ Agent
長い資料をもとに複雑な判断が求められるケースに適しています。たとえば、契約書レビュー、複数リポジトリにまたがるコード移行、デューデリジェンスなどです。
Opus が完全な長文コンテキストを保持し、長期間にわたりキャッシュをヒットさせながら、全体の理解、タスク分解、複数の Sonnet サブ Agent への割り当てを担当します。各 Sonnet には、自身の担当範囲に必要な一部の資料と明確な指示だけを渡し、medium 設定で高速に並列実行させます。最後に Opus が結果を統合し、最終レビューを行います。
この構成では、高価な長文コンテキストのキャッシュ書き込みは 1 回だけで済みます。Sonnet は大量の文章を生成し、半額の出力単価というメリットを活かせます。
パターン 2:Sonnet をフロントに置き、Opus にエスカレーションする
インタラクティブでアクセス数の多いシナリオに適しています。たとえば、企業ナレッジベースの Q&A、カスタマーサポート Agent、社内 IT アシスタントなどです。
Sonnet が長文コンテキストを保持し、medium 設定でおよそ 1 秒台の初回 Token 応答を提供します。確信度が低い場合、コンプライアンス上の判断を含む場合、あるいはユーザーが明確に不満を示した場合には、問題を要約し、重要な抜粋とともに Opus へエスカレーションします。
大半のリクエストは Sonnet が低コストで処理し、難易度の高い一部のリクエストだけに Opus を使用します。
| Agent の役割 | 推奨モデル | 推奨設定 | 理由 |
|---|---|---|---|
| オーケストレーター / プランナー | claude-opus-5-5 | medium ~ high | 総合的な知能と事実の正確性が高く、Token 効率も優れています |
| 長文コンテキスト分析・最終レビュー | claude-opus-5-5 | high ~ xhigh | 長文コンテキストにおける精密な判断で明確な強みがあります |
| 長文執筆 / バッチリライト | claude-sonnet-5-5 | medium | 出力単価が半額で、毎秒の出力速度も速くなります |
| ターミナル / コード実行サブ Agent | claude-sonnet-5-5 | xhigh ~ max | Terminal-Bench では最大設定時のスコアが最も優れています |
| リアルタイム会話フロントエンド | claude-sonnet-5-5 | medium | 初回 Token のレイテンシは約 1.3 秒です |
| オフラインバッチ処理 | claude-sonnet-5-5 | medium | Batch は $1/$5 で、30 万 Token の長文出力に対応します |
同じインターフェースで Opus のオーケストレーションと Sonnet の実行を実現する
以下はパターン 1 の最小構成の例です。OpenAI 互換インターフェースを通じて呼び出し、2 つのモデルで 1 つの Key を共有します。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 統合インターフェース
)

def ask(model, prompt, effort="medium"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}])
    return r.choices[0].message.content

plan = ask("claude-opus-5-5", "阅读以下合同全文,拆成 3 个独立审查子任务,每行一个:\n" + contract_text)
drafts = [ask("claude-sonnet-5-5", f"完成子任务并输出审查意见:{t}") for t in plan.splitlines() if t.strip()]
report = ask("claude-opus-5-5", "汇总并终审以下意见,输出最终报告:\n" + "\n".join(drafts), effort="high")
展開して確認:並列サブ Agent + 固定長文コンテキストプレフィックスの完全な例
import asyncio
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 統合インターフェース
)

ORCHESTRATOR = "claude-opus-5-5"
WORKER = "claude-sonnet-5-5"

async def call(model, messages, effort="medium"):
    r = await client.chat.completions.create(
        model=model, reasoning_effort=effort, messages=messages)
    return r.choices[0].message.content, r.usage

async def run(long_doc: str, goal: str):
    # 1. 長文書を system プレフィックスに固定し、Opus のみに保持して複数ターンでのキャッシュヒットを促進
    base = [{"role": "system", "content": "你是企业文档分析编排者。以下是完整材料:\n" + long_doc}]
    plan, _ = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"目标:{goal}\n请拆成最多 5 个子任务,每个子任务附上所需的原文片段,用 --- 分隔。"}])

    # 2. Sonnet サブ Agent には要約済みの抜粋だけを渡し、並列実行
    tasks = [t.strip() for t in plan.split("---") if t.strip()]
    results = await asyncio.gather(*[
        call(WORKER, [{"role": "user", "content": f"独立完成以下子任务,输出结构化结论:\n{t}"}])
        for t in tasks])

    # 3. Opus に戻して最終レビューを行い、同じ長文コンテキストプレフィックスを再利用
    merged = "\n\n".join(r[0] for r in results)
    final, usage = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"核对以下子任务结论与原文是否一致,修正错误后输出最终报告:\n{merged}"}],
        effort="high")
    print("终审 Token 用量:", usage)
    return final

# asyncio.run(run(open("contract.md").read(), "识别合同中的付款、违约与知识产权风险"))
🚀 すぐに始めるには:Claude の公式アカウントは、登録地域や支払い方法に関する要件が比較的厳しく、企業チームでは利用開始の段階でつまずくことがあります。まずは APIYI apiyi.com に登録してテストクレジットを取得し、1 つの Key で claude-opus-5-5 と claude-sonnet-5-5 を同時に呼び出してみてください。上記の 2 モデル構成を実際に動かしてから、スケール時のコストを評価できます。
claude-sonnet-5-5 vs claude-opus-5-5:選定のポイント
ここまでの分析を、実行しやすい4つの原則にまとめます。
- まず設定レベルを決めてからモデルを比較する:Sonnet は medium〜xhigh、Opus は medium〜high を使いましょう。Sonnet のデフォルトである high による Token の無駄を避けられます。
- キャッシュ再利用率が高い長文コンテキストは Opus に任せる:キャッシュ読み取りは同一価格であり、Opus の価格差は約30%にとどまります。より高い精度と手戻りの削減を得られます。
- 新規資料の読み込みと長文出力は Sonnet に任せる:キャッシュ書き込みと出力の単価はいずれも Opus の半額です。オフラインタスクなら、さらに Batch による50%割引も利用できます。
- 長文コンテキストは1か所にだけ保持する:キャッシュはモデル間で共有できません。子 Agent には要約した断片だけを渡し、キャッシュ書き込み費用の重複を防ぎましょう。
Opus の Fast モードは、1回ごとの応答速度を極端に重視し、十分な予算があるケースに向いています。ただし価格は2倍になり、キャッシュも共有されません。多くの企業向け Agent では、リアルタイム対話を Sonnet の medium レベルに任せるほうが、Opus で Fast モードを有効にするより費用対効果に優れています。
よくある質問
Q1: claude-opus-5-5 はすでに高速ですが、それでも claude-sonnet-5-5 を使う必要はありますか?
はい、あります。Opus が「速い」と感じられる主な理由は、デフォルトの設定レベルが低めで、Token 効率も高いためです。一方、1秒あたりの出力速度と最初の Token までのレイテンシでは、Sonnet が依然として明確に優位です。出力単価も半額にとどまります。長文作成、リアルタイム対話、並列で動く子 Agent といった用途では、Sonnet がより適した実行役です。
Q2: claude-sonnet-5-5 を max レベルにすれば、Opus の代わりになりますか?
ターミナルでのプログラミングのような特定タスクでは可能です。Sonnet(max)は Terminal-Bench 4.0 で、Opus を上回るスコアを記録しています。
ただし、総合知能指数ではなお2ポイント低く、max レベルでは Sonnet の Token 消費量も増えます。その結果、総コストは Opus と同等、あるいはやや高くなることもあります。最高レベルの品質が必要なら、Opus を直接使うほうが通常は割安です。
Q3:企業向けの長文ドキュメント Agent では、2つのモデルのコストをどう抑えればよいですか?
重要なのは、キャッシュヒット率を高めることです。長文ドキュメントをリクエストの固定プレフィックスに配置し、完全なコンテキストを保持するモデルは1つだけにします。子 Agent には、要約した断片のみを渡してください。
APIYI apiyi.com 経由で呼び出し、返却されるキャッシュ Token 使用量を確認しながら、プレフィックス構造を段階的に調整することをおすすめします。一般的に、キャッシュヒット率の改善は最も効果的なコスト削減レバーです。
Q4:Sonnet 5 または Opus 5 から 5.5 へ移行する際の注意点は何ですか?
両方の 5.5 モデルには、インターフェースの互換性を損なう変更があります。思考モードは無効化できず、強制ツール呼び出し(tool_choice が any または tool)では 400 エラーが返されます。また、旧版のコンピューター操作ツールもアップグレードが必要です。
移行前には、まずテスト環境で回帰テストを完了させましょう。新旧モデルの出力差を並行して比較したうえで、本番トラフィックを切り替えることをおすすめします。
まとめ
claude-sonnet-5-5 と claude-opus-5-5 の比較は、単純に「高価なほうが優秀で、安価なほうが劣る」という話ではありません。Opus 5.5 は価格改定後、キャッシュ読み取りが Sonnet と同額になり、標準の medium 設定でも十分に効率的です。長大なコンテキストにおける正確な判断力や総合的な知能では、Opus が全体的に優位です。一方、Sonnet 5.5 は応答速度、出力コスト、ターミナルでのプログラミング、高並行実行において代替しにくい強みを持っています。つまり Sonnet の価値は価格だけではなく、適切な設定と役割で使うことで真価を発揮します。
企業向けの長文入力・出力を扱う Agent では、「Opus が意思決定し、Sonnet が実行する」という構成が最も合理的です。Opus に長大なコンテキストを保持させ、計画立案と最終レビューを担当させます。Sonnet は medium 設定で、文章作成や実行タスクを並列に処理します。オフラインで実行できる処理は Batch に任せます。実運用では、まず設定を固定して比較テストを行い、その後、本記事の役割分担表に沿って Agent を分割してください。さらに、キャッシュヒット率と出力 Token の2指標を継続的に確認することで、コストを最適化できます。
このデュアルモデル構成をすぐに検証したい場合は、APIYI apiyi.com を通じて claude-opus-5-5 と claude-sonnet-5-5 を統一的に呼び出す方法がおすすめです。プラットフォームのインターフェースは OpenAI 形式と互換性があり、1つの Key で2つのモデルを自由に切り替えられます。モデル選定テストや、本番環境におけるマルチモデルのオーケストレーションに適しています。
参考資料:
– Anthropic 料金ドキュメント: platform.claude.com/docs/en/about-claude/pricing
– Anthropic Fast モードのドキュメント: platform.claude.com/docs/en/build-with-claude/fast-mode
– Artificial Analysis による Sonnet 5.5 と Opus 5.5 の比較: artificialanalysis.ai
– Digital Applied による Opus 5.5 リリース解説: digitalapplied.com
– Kingy AI および Emergent による Sonnet 5.5 vs Opus 5.5 の比較: kingy.ai、emergent.sh
著者紹介: APIYI 技術チームは、AI 大規模言語モデル API の導入とエンジニアリング実践に注力しています。claude-opus-5-5 と claude-sonnet-5-5 の Agent オーケストレーションやコスト最適化に関する経験については、APIYI apiyi.com までお気軽にご相談ください。