著者注:Addy Osmani の「認知的降伏」と「理解の負債」という考え方を軸に、PR をマージする前のセルフチェックリストとプロンプトのテンプレートをまとめました。LobeHub の依存関係に関する受け入れレポートを使ったレビュー手法とも比較し、リスクに応じたレビューの強度を選べるようにします。
Claude Code、Cursor、Cline を使って日々コードを開発しているなら、こんな経験があるかもしれません。エージェントが数分で数百行の PR を提出。命名規則も守られ、構造も明快で、テストはすべて通過している。そこで「承認」を押したものの、数週間後に「なぜこのロジックをこう書いたのか」と聞かれても、答えられない。この記事では、「AI に問題を出してもらう」といった実践的なチェック方法を通じて、一行ずつレビューしなくても、自分が承認する変更に責任を持つ方法を紹介します。
この記事は、コードを手書きに戻そうと勧めるものではありません。Claude Code のエンジニアである Addy Osmani 自身、エンジニアにコードベース全体を覚えることは求められていないと明言しています。問題はすべての行を読むかどうかではなく、自分が何を理解し、何を理解していないかを把握しているかどうかです。
この記事で得られること:「認知的オフロード、判断の委譲、認知的降伏」と進む過程を理解し、そのままコピーして使えるマージ前の質問リストとプロンプトのテンプレートを手に入れられます。また、変更のリスクに応じてレビューの強度を選ぶ方法も学べます。
Agentに判を押すだけにならないために:理解負債の要点
量子位の報道(36氪による転載)によると、元Googleエンジニアで、現在はClaude Codeの開発に携わるAddy Osmani氏が、耳の痛い問題について記事を公開しました。AIの生成物が信頼できるようになるほど、人間はチェックをおろそかにしてしまうというものです。氏はこの過程をいくつかの段階に分け、2種類の新たな「負債」を提唱しています。なお、以下の概念はすべてメディアの報道に基づくため、正確な表現はAddy氏の原文をご確認ください。
| 概念 | 意味 | 典型的な例 |
|---|---|---|
| 認知の外部化 | 具体的な作業をAIに任せつつ、自分でもタスクを理解し、結果を判断できる状態 | Agentに定型コードを書かせるが、何をしているかは把握している |
| 判断の委譲 | AIの回答が、次の作業を進める際の前提になっていく状態 | 2回目はざっと目を通すだけで、Agentの言うとおりに進める |
| 認知の放棄 | 本来は自分ですべき判断まで委ねてしまう状態 | 「AIの言うことだから間違いない」と、テストがすべて通ればそのままマージする |
| 理解負債 | コードやシステムの複雑さが増す一方で、開発者の理解が追いついていない状態 | 機能を変更しようとしても、内部構造を把握している人がいない |
| 意図負債 | 要件で明確にされていない目標、制約、トレードオフをAIが代わりに決めてしまう状態 | 自分でも何が欲しいか整理できていないのに、Agentがもっともらしい成果物を仕上げる |
認知の放棄と理解負債が生じるまで
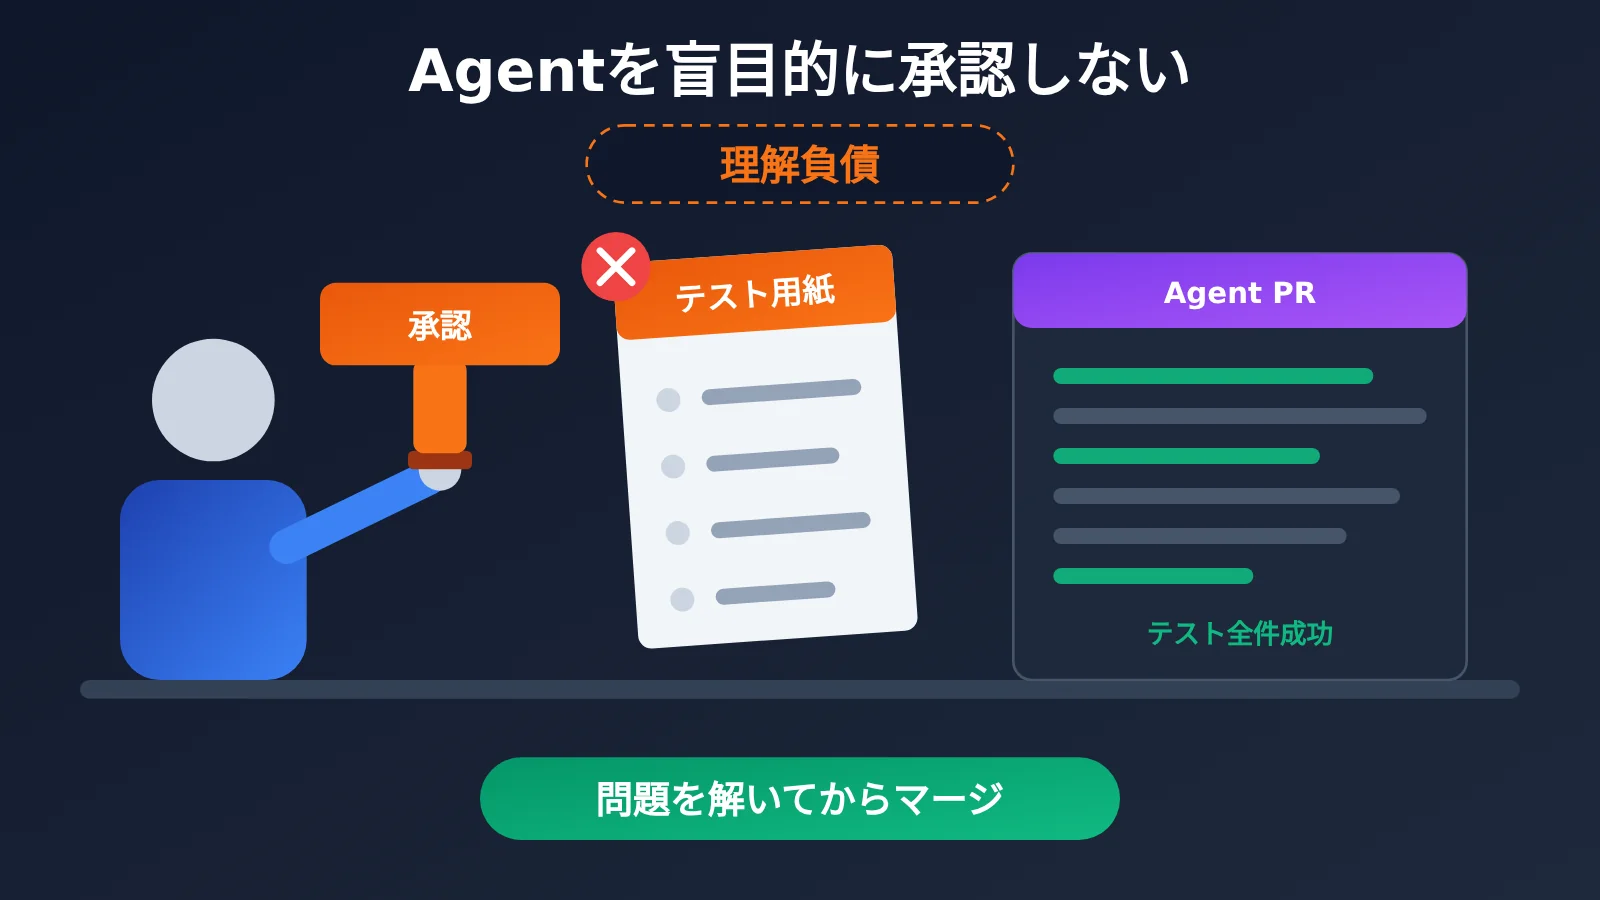
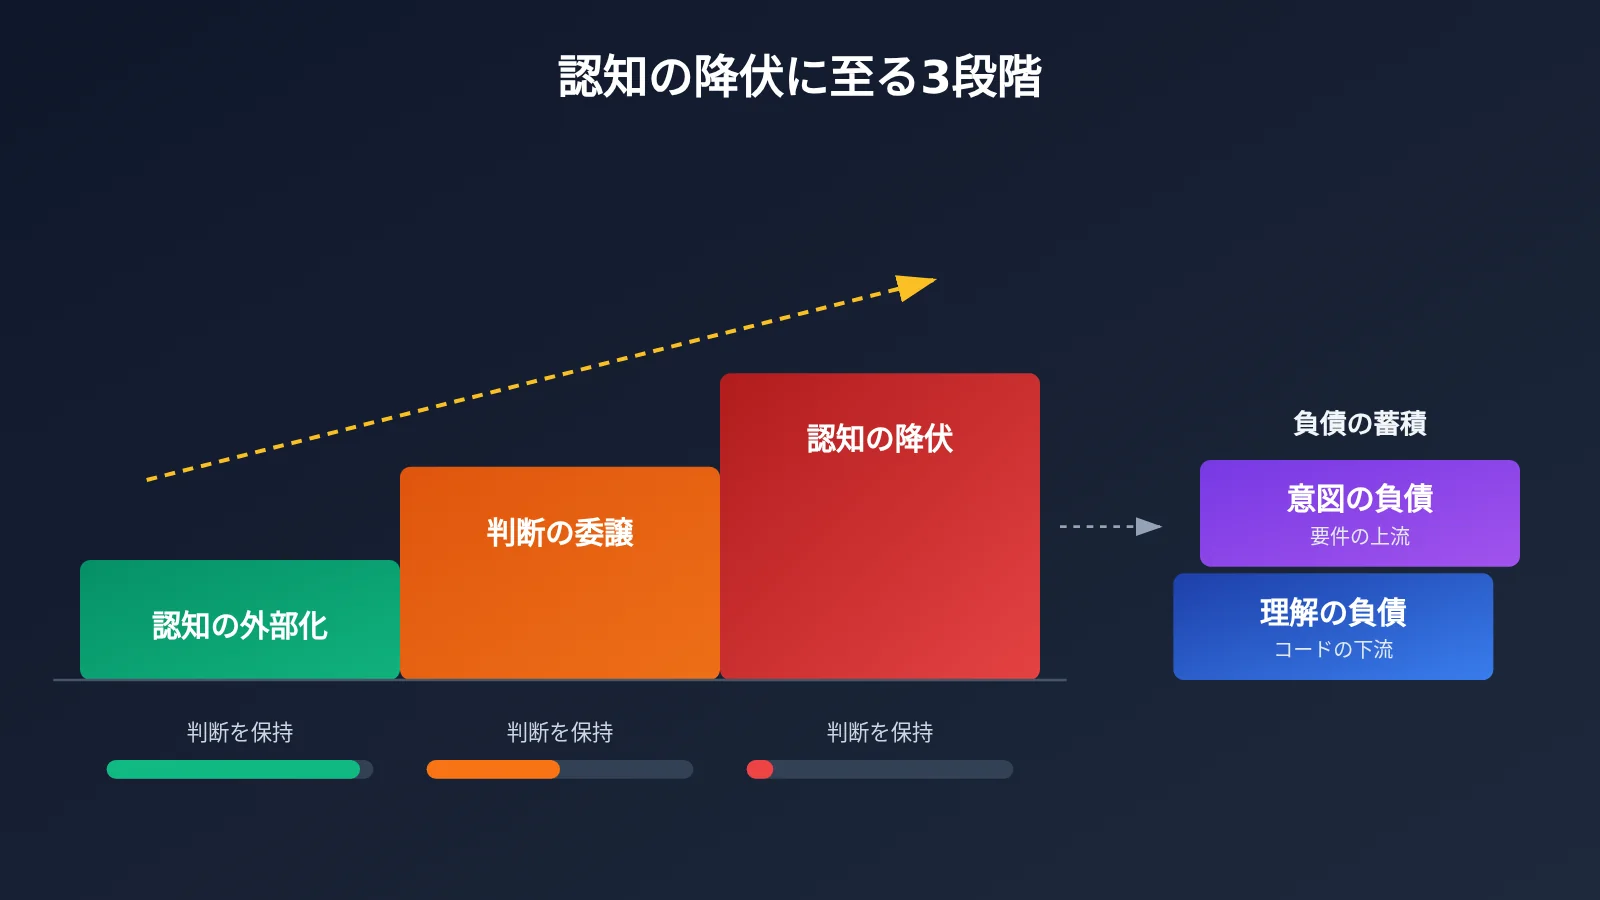
認知の放棄は一夜にして起きるものではありません。最初は単に具体的な作業を「外部化」するだけです。これは、アセンブリを手書きせずにコンパイラを使うのと同じで、それ自体に問題はありません。危険なのは第2段階です。Agentの出力が何度か続けて信頼できるものだと、その結論がいつの間にか自分の前提となり、検証を省くようになります。第3段階に至ると、「承認」ボタンは単なる判子となり、エンジニアは判を押すだけの存在になってしまいます。
Addy氏は、典型的な例を挙げています。Agentが一度に600行のコードを提出し、構造も明快でテストも通ったため、開発者は安心してマージしました。しかしAgentは、目立たない箇所でトランザクションの処理順序を変えたり、ある境界条件を調整したりしているかもしれません。こうした変更はその時点ではエラーにならず、実際にシステムで問題が起きて初めて、開発者はなぜコードがそのように動くのか説明できないことに気づきます。これが理解負債の「利息」です。それはいつも、最も都合の悪いときに支払うことになります。
一方、意図負債は、より上流で生じます。今のAgentは要件を補完するのが非常に得意で、こちらが十分に考えを整理できていなくても、もっともらしい成果物を仕上げられます。問題は、明確に伝えていなかった目標や範囲、トレードオフを、AIが知らないうちに代わりに決めていることです。意図負債と理解負債は、しばしば重なって発生します。当初自分が何を求めていたのかも、最終的にAgentが何をしたのかも、どちらも分からない状態です。
理解負債を返済する6つの方法
Addy は長文記事の中で、実践的なアドバイスを数多く紹介しています。ここではそれらを6つの方法に整理し、それぞれがどの負債に対応し、ワークフローのどの段階で使えるかをまとめました。
| 方法 | 使用するタイミング | 主に返済する負債 | 具体的なアクション |
|---|---|---|---|
| 1. Agent に問題を出してもらう | 大規模な変更が完了した後、マージする前 | 理解負債 | 変更内容と理由をまとめてもらい、問題に全問正解してからマージする |
| 2. 作業前に要件リストを書く | プロンプトを書く前 | 意図負債 | 対象者、解決する問題、やらないこと、完了基準を明確にする |
| 3. 許可していない判断を問いただす | 長時間のタスクが終わったとき | 理解負債、意図負債 | 許可なく下した判断や、前提とした仮定を尋ねる |
| 4. テストしていないことを尋ねる | テスト結果を確認するとき | 理解負債 | 実際に実行されたテストとその出力を確認してから、AI の要約を読む |
| 5. 元の資料を残す | 複数の Agent を並行して使うとき | 理解負債 | 重要なタスクでは元の資料と検証の根拠を残し、レビューが追いつかなければ並行数を減らす |
| 6. 定期的にオフラインで練習する | 毎週・毎月 | 能力の低下 | 週に一度は Agent に頼らずコーディングし、毎月、外部に任せたスキルを棚卸しする |
AI に問題を出してもらう:理解負債を確認するための最も重要なアクション
一連の方法の中でも、特に興味深いのがこの方法です。Agent が大規模な変更を終えたら、すぐに承認するのではなく、試験官の役を任せます。今回どこを変更し、なぜそう変更したのかをまとめてもらったうえで、変更内容に関する問題をいくつか出してもらい、全問正解した場合にのみマージするというルールを設けます。
この方法の価値は、「だいたい理解できた」という曖昧な感覚を、検証可能な結果に変えられることです。答えられなかった問題は、まさに理解負債がどこにあるかを示しています。
許可していない判断と、テストしていないことを尋ねる
長時間実行するタスクでは、Agent がデフォルトのパラメータを選んだり、実装範囲を調整したり、ときには要件が衝突した際に取捨選択したりします。こうした判断は「あまりに自然」なため、最後の要約に書かれるとは限りません。
そのため、「完了した?」と聞くよりも、次のように掘り下げるほうが効果的です。明示的に許可していない判断を何か行ったか? どの部分で独自の仮定に頼ったか? まだ検証していないことは何か? ほかの機能に影響する可能性のある変更はどれか?
テストについても同じです。Addy は、テストが緑色でも、テストでカバーした条件を通過したことしか証明されないと特に注意を促しています。境界ケースがテストに含まれていなければ、レポートは問題なく見えてしまいます。まず実際にどのテストが実行され、どんな結果が返されたかを確認し、その後で AI が生成した要約を読むのが正しい順序です。リスクの高い変更では、別の Agent に異なる観点から独立して問題を探してもらうこともできます。
マージ前のセルフチェック入門:Agentの成果をうのみにしない5ステップ
ここまでの方法を組み合わせると、各PRをマージする前に実行できるチェックフローになります。一行ずつレビューする必要はありませんが、各ステップで自分の頭で考えることが大切です。
- 作業前に期待を書き出す:要件と期待する結果を自分の言葉で書きます。プロンプトを2回調整しても満足できなければ、プロンプトを追加し続けるのではなく、要件を整理し直しましょう。
- 判断の説明を求める:タスクの終了後、明示的に許可していない判断、前提、未検証の項目をAgentに列挙させます。
- 実際のテストを確認する:実行されたテストコマンドと出力を確認し、カバーされていない境界条件を問いかけます。
- Agentに問題を出してもらう:今回のdiffに基づく問題で理解度を試し、間違えた部分はコードに戻って読み直します。
- 見落としを1つ探す:Agentが成果を提出した後、チェックし忘れた可能性のあることを自分で少なくとも1つ探します。
理解負債をチェックする最小限のプロンプト例
以下は、理解度を試すためによく使われるプロンプトです。Claude Code、Cursor、Clineの会話にそのまま貼り付けて使えます。
今回の変更をマージする前に、次の2つを行ってください。
1. 今回変更したファイルと、それぞれの変更理由を10項目以内でまとめてください。
2. 今回のdiffに基づいて、次の点を中心に5問出題してください。
   トランザクション/呼び出し順序、境界条件、エラー処理、他のモジュールへの影響。
   最初は問題だけを提示し、私の回答後に採点してください。
   間違えた箇所に対応するコードも示してください。
ルール:私が全問正解するまで、マージを勧めないでください。
マージ前の質問プロンプトテンプレート全文を見る
# フェーズ A:作業前(意図負債を返済するため、私が先に記入)
要件:
- 対象ユーザー:
- 解決したい問題:
- 明確に対象外とすること:
- 完了基準(どの状態になれば完了とするか):
- 私が想定する変更範囲と結果:

# フェーズ B:タスク終了後(Agentが各項目に回答)
1. 私が明示的に許可していない判断をしましたか?判断の内容と理由を列挙してください。
2. あなた自身の前提に依存している箇所はどこですか?前提が成立しない場合、何が起きますか?
3. まだ検証していないことは何ですか?
4. 他の機能やモジュールに影響する可能性のある変更はどれですか?
5. 実際に実行したテストコマンドは何ですか?要約ではなく、元の出力を貼ってください。
6. テストに含まれていない境界条件は何ですか?

# フェーズ C:出題による理解度チェック(理解負債を返済)
今回のdiffに基づいて5問出題し、最初は問題だけを提示してください。
私の回答後に採点し、間違えた問題については該当するコード行を示してください。
私が全問正解するまで、マージを勧めないでください。

# フェーズ D:高リスクな変更向けの追加チェック(別の独立したセッションに依頼可能)
独立したレビュアーとして、前のセッションの要約を参照せず、
元の要件とdiffだけを基に、問題が起きる可能性が最も高い箇所を3つ挙げてください。
🎯 使い方のポイント:フェーズ A はAgentに代筆させず、必ず作業前に自分で記入しましょう。フェーズ D は新しいセッションを開くのがおすすめです。独立したレビュアーが前のAgentの要約に引きずられるのを防げます。これは、複数のAgent間で情報を伝える際のロスについて、Addyが注意を促している点にも通じます。
マージ前に確認する質問リスト早見表
| 段階 | 必ず確認する質問 | 不合格のサイン |
|---|---|---|
| 着手前 | 要件と完了基準を自分の言葉で説明できるか? | 「やらないこと」を書き出せない |
| 納品後 | Agent は許可なくどのような判断をしたか? | 「ない」と答えたのに、diff が明らかに範囲を超えている |
| テスト | 実際にどのテストを実行したか?何をテストしていないか? | 要約しかなく、生の出力がない |
| 理解度チェック | 出題された問題に全問正解できるか? | トランザクションの順序や境界条件に関する問題を間違える |
| 最終確認 | Agent が見落とした点を一つ挙げられるか? | 一つも思いつかない |
AI に問題を出してもらう方法と、受け入れレポートによるレビューの比較
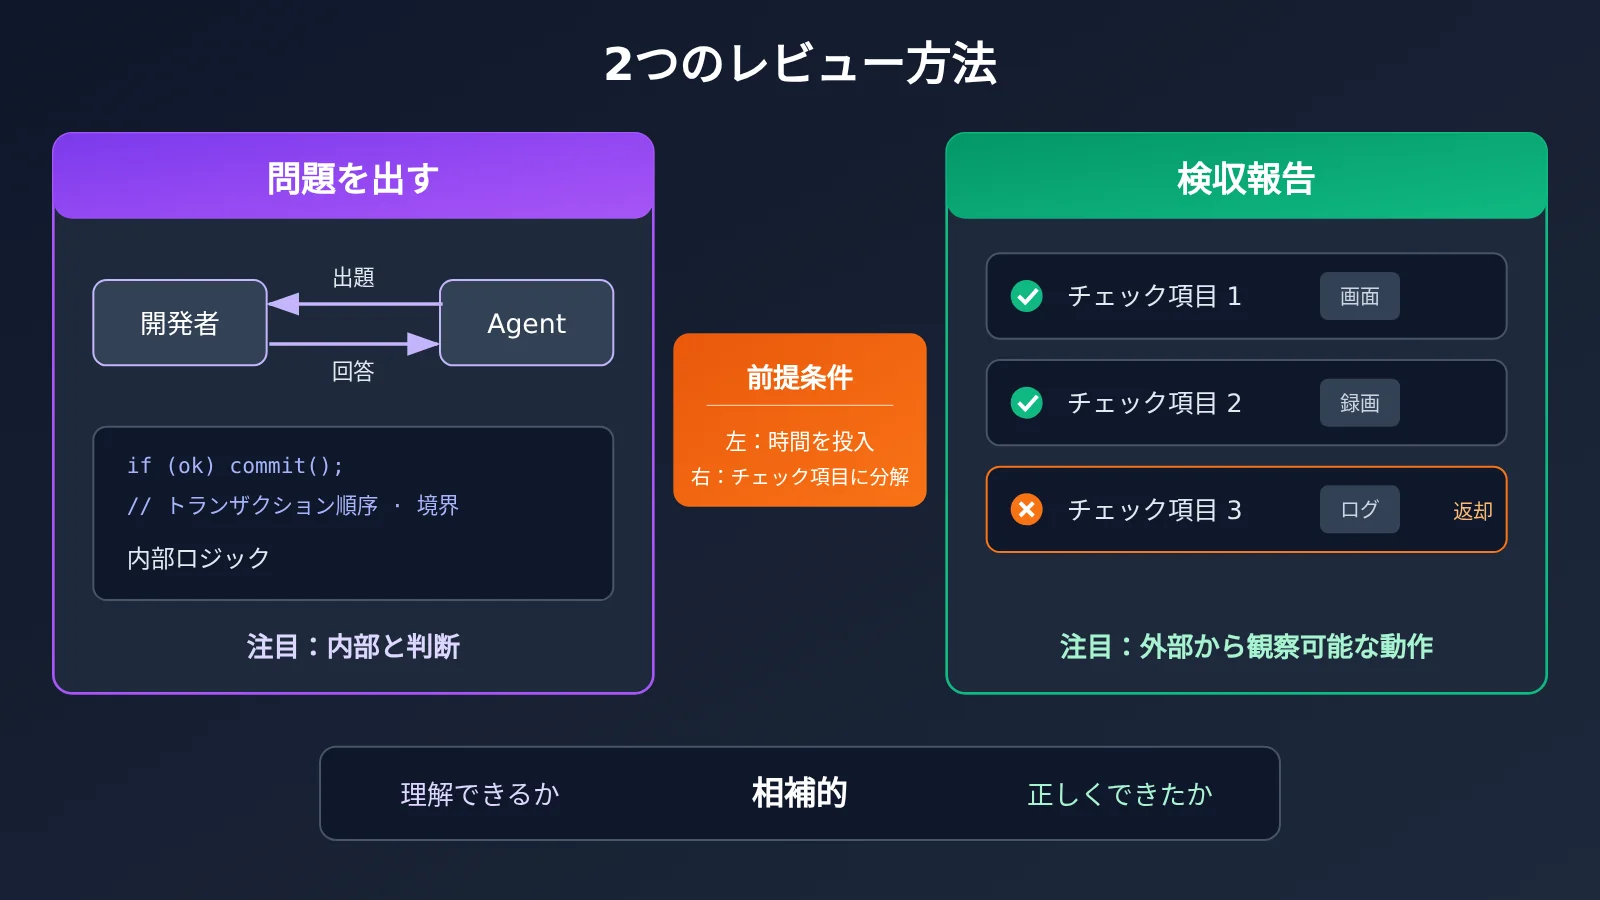
まったく異なるアプローチを取っているのが、オープンソースの Agent 協業プラットフォーム LobeHub(GitHub のスターは約8.4万)です。白鯨実験室の報道によると、同チームは「すでにコードはほとんど見ていない」と語り、主に Agent のマルチモーダルな受け入れレポートを確認しています。使用しているのは、自社開発し、今年9月にオープンソース化したツール「Acceptance」です。Agent は納品前に要件を直接観察できるチェック項目に分解し、実際のプロダクト上で一つずつ検証します。その結果をスクリーンショット、画面録画、ログとともにオンラインレポートにまとめます。人は全体を承認することも、特定の項目だけを差し戻すこともできます。
| 比較項目 | AI に問題を出してもらう | 受け入れレポートによるレビュー |
|---|---|---|
| 注目する対象 | コード内部のロジック、許可のない判断、前提 | プロダクトの外部から観察できる振る舞い |
| 証拠の形式 | 質疑応答、採点結果 | スクリーンショット、画面録画、ログ、コマンドの実行記録 |
| 発見できる問題 | トランザクションの順序、境界条件、暗黙のトレードオフ | 画面、操作、機能が要件に合っているか |
| 見落としやすい問題 | 出題を思いつかなかった問題 | 外から見えない内部ロジックやアーキテクチャ上の懸念 |
| 前提条件 | 開発者が理解に時間をかける意思があること | 要件を観察可能なチェック項目に分解でき、自動実行環境があること |
| 人の役割 | 具体的な変更を理解し、責任を持つ | 受け入れ基準を定義し、最終判断を下す |
2つのレビュー手法の比較分析
受け入れレポートによるレビューの分析:受け入れレポートは、観察可能な振る舞いを効率よく検証でき、チェック項目ごとに差し戻せます。報道された実例では、レビュアーが差し戻したのはダーク背景の項目だけで、Agent が修正したのも CSS の1行だけでした。ほかのファイルに変更はありません。ただし、この方法は要件を観察可能なチェック項目に分解できることが前提です。また同報道では、より複雑なタスクではセキュリティ、アーキテクチャ、最終的な品質について引き続き人の判断が必要であり、フィードバックの反映にも人手が必要な工程があると指摘しています。「コードはほとんど見ていない」というのはチーム自身の発言であり、第三者による検証はされていません。
問題を出してもらう方法の分析:出題による理解度チェックは、トランザクションの順序や境界条件といった「画面からは見えない」問題を明らかにするのが得意で、受け入れレポートの盲点を補えます。ただし、効果は問題の質に左右され、開発者が理解にしっかり時間をかける必要もあります。両者は排他的ではありません。受け入れレポートで「正しくできているか」を確認し、出題によるチェックで「なぜそのように実装したのかを自分が理解しているか」を確かめるのが、より合理的な使い方です。
変更リスクに応じて理解負債のレビュー強度を選ぶ
すべての PR に完全なプロセスを適用する必要はありません。Addy も、生成した内容が多すぎて責任を持てなくなった時点で、それはレビューではなく、問題がないことに賭けているだけだと指摘しています。以下はリスクに応じた目安です。具体的な基準はチームの実情に合わせて調整してください。
| リスクレベル | 典型的な変更 | 推奨するレビュー強度 |
|---|---|---|
| 低 | 文言、スタイル、独立したスクリプト、プロトタイプ | 受け入れ確認レポートまたは手動確認で十分。期待する結果を記録する |
| 中 | 一般的な業務機能、インターフェースの追加 | 許可なく下された判断を掘り下げて確認 + 実際のテスト出力を照合 |
| 高 | トランザクション、権限、決済、データ移行 | 5 ステップの完全なプロセス + 問題を出して理解度を確認 + 独立した Agent によるレビュー |
| 処理能力を超過 | 複数の Agent による並列作業で、レビューが追いつかない | 自動チェックを追加するか、並列作業の数を減らす |
💡 選び方のヒント:チームに十分成熟した自動受け入れテストがある場合は、問題を出して理解度を確認する方法を高リスクの変更に集中させてもよいでしょう。そうでない場合は、少なくともデータの整合性や権限に関わる PR では「正しく答えられてからマージする」を徹底しましょう。
よくある質問 FAQ
Q1: 理解負債とは何ですか?技術的負債とはどう違いますか?
理解負債とは、コードやシステムの複雑さが増しているのに、開発者の理解がそれに追いついていない状態を指します。技術的負債は通常、コード自体の品質に問題がある状態です。一方、理解負債はコードの品質が良くても発生し得ます。問題は「人が理解していない」ことにあり、変更が必要になったときに一気に表面化します。
Q2: AIに問題を出してもらうことと、直接コードを説明してもらうことにはどんな違いがありますか?
AIに説明してもらう場合、受け身で情報を受け取るため、「理解できた」という錯覚に陥りがちです。問題に答える場合は自分で考える必要があり、間違えた箇所を具体的なコードに結びつけられます。曖昧な理解を、検証可能な結果に変えられるのが違いです。
Q3: Agentの仕事に安易にお墨付きを与えないということは、AIが書いたコードを1行ずつレビューする必要があるということですか?
いいえ。報道によると、Claude Codeチームではエンジニアにコードベース全体を覚えることを求めていません。ある部分を変更する必要があるときに、Claudeを使って関連するロジックを理解し直しています。大切なのは、自分が何を理解し、何を理解していないかを把握し、リスクに応じてレビューの深さを決めることです。
Q4: この方法はどのような開発シーンに向いていますか?
主に次のようなシーンに適しています。
– **長時間実行するAgentのタスク**:許可されていない判断が生じやすいため、追加質問のチェックリストが役立ちます
– **トランザクションや境界条件に関わるバックエンドの変更**:問題を出して理解度を確認するのに適しています
– **複数のAgentによる並行開発**:元の資料を残し、並行数を管理するのに適しています
– **チームでのCode Review**:質問のチェックリストをPRテンプレートに組み込めます
Q5: Claude Code、Cursor、Clineで、この理解負債のセルフチェックをどう実践すればよいですか?
この方法は特定のツールに依存せず、プロンプトと手順が中心です。
1. 本文の完全なプロンプトテンプレートを、チームで再利用できるスニペットとして保存する
2. 作業前にフェーズAを手書きし、タスク終了後にフェーズBとCを貼り付ける
3. リスクの高い変更では、独立した新しいセッションを開いてフェーズDを実行する
「正解してからマージする」というルールを、チームのPRチェック基準に加えることもできます。
Q6: これらの方法にはどのような既知の限界がありますか?
次の点を客観的に捉える必要があります。
– **効果に関するデータ**:現時点では、これらの方法が欠陥率をどれだけ下げるか、効率をどれだけ高めるかを示す公開データはありません
– **時間コスト**:全工程を実施するとマージまでの時間が長くなるため、すべてのPRには適しません
– **問題の盲点**:Agentが自分では気づいていない問題を出題できない可能性があるため、「見落としたことを1つ探す」ステップは省けません
– **出典について**:Addyの見解はメディアの報道を通じて伝えられたものです。原文の表現は各自で確認してください
Q7: 毎週オフラインでコーディングを練習する必要は本当にありますか?
Addyが挙げる理由は、長期間使わないスキルは徐々に衰える可能性があるということです。ときどきAgentを使わずに独力でタスクを完了すれば、自分の実力を確かめられます。また、どのスキルをAIに任せ、どのスキルを引き続き自分で身につけておくべきかを毎月棚卸しするのも有効です。負担は大きくなく、気づかないうちに自分で考えることを放棄するのを防げます。
Agent の成果を鵜呑みにしない:理解負債の要点 Key Takeaways
- 認知の放棄は少しずつ進む:認知の外部委託から判断の委譲へ、そして判断をすべて任せる段階へと進む
- 理解負債の利息は後から発生する:コードを書く速度が上がるほど、理解していない部分の問題が変更時に一気に噴き出す
- 意図負債は上流で生じる:作業前に自分で要件リストを書き、2回プロンプトを出しても満足できなければ要件を整理し直す
- 問題を出してもらうことが中心的なアクション:Agent に変更内容を要約させて問題を出してもらい、全問正解してからマージする
- テストがすべて成功しても問題がないとは限らない:まず実行されたテストの出力を確認し、何がテストされていないかを問い直す
- 受け入れ報告と問題による確認は相互に補完する:前者は外部から見た振る舞いを検証し、後者は内部ロジックへの理解を確かめる
- リスクに応じてレビューする:レビューしきれないときは自動化を補強するか並行作業を減らし、運任せにしない
まとめ
Agent の成果を鵜呑みにしないための要点は次のとおりです。
- 段階を見極める:「AI に作業を任せる」から「AI に判断を任せる」へと移っていないか警戒する。理解負債と意図負債は、どちらもこの過程で生じる
- 具体的に行動する:作業前に期待する結果を書き出し、成果物の受け取り時には許可なく下した判断やテストされていない内容を問い、マージ前に AI に問題を出してもらう
- リスクに応じて判断する:低リスクの変更は受け入れ報告や重点的な確認で対応し、高リスクの変更は全工程を実施したうえで独立したレビューを加える
AI がコードを書く速度は今後も上がり続けるでしょう。それでも、変更に責任を持つのは、それを承認した人です。次に「承認」を押す前に、Agent に5問出してもらい、自分が何問答えられるか試してみてはいかがでしょうか。
📚 参考資料
- 量子位:Claude エンジニアによる Agent 活用の総合ガイド(36 氪による転載):認知的降伏、理解の負債、意図の負債に関する Addy Osmani の見解と実践方法を紹介
- リンク:
36kr.com/p/4056027738116995 -
説明: 本記事の方法論の主な出典であり、メディアによる紹介記事です
-
Addy Osmani の元の投稿:記事で引用されている原文の出典
- リンク:
x.com/addyosmani/status/2117512471930167377 -
説明: 具体的な表現は原文をご確認ください。リンクの確認は各自でお願いします
-
白鯨実験室:8 万 Star の AI 企業が、AI に自社の運営を任せると決めた(36 氪による転載):LobeHub の主管 Agent アーキテクチャと Acceptance 検収レポートの実践を紹介
- リンク:
36kr.com/p/4056040123945860 - 説明: 検収レポートを使ったレビューの対照となる出典です。「コードをほとんど見ない」はチーム自身の説明です
著者: APIYI 技術チーム