Примечание автора: в основе статьи — идеи Addy Osmani о «когнитивной капитуляции» и «долге понимания». Мы собрали список вопросов для самопроверки и шаблоны промптов перед слиянием PR, а также сравнили их с подходом LobeHub к ревью, основанным на отчётах о приёмке. Это поможет выбрать глубину проверки в зависимости от риска.
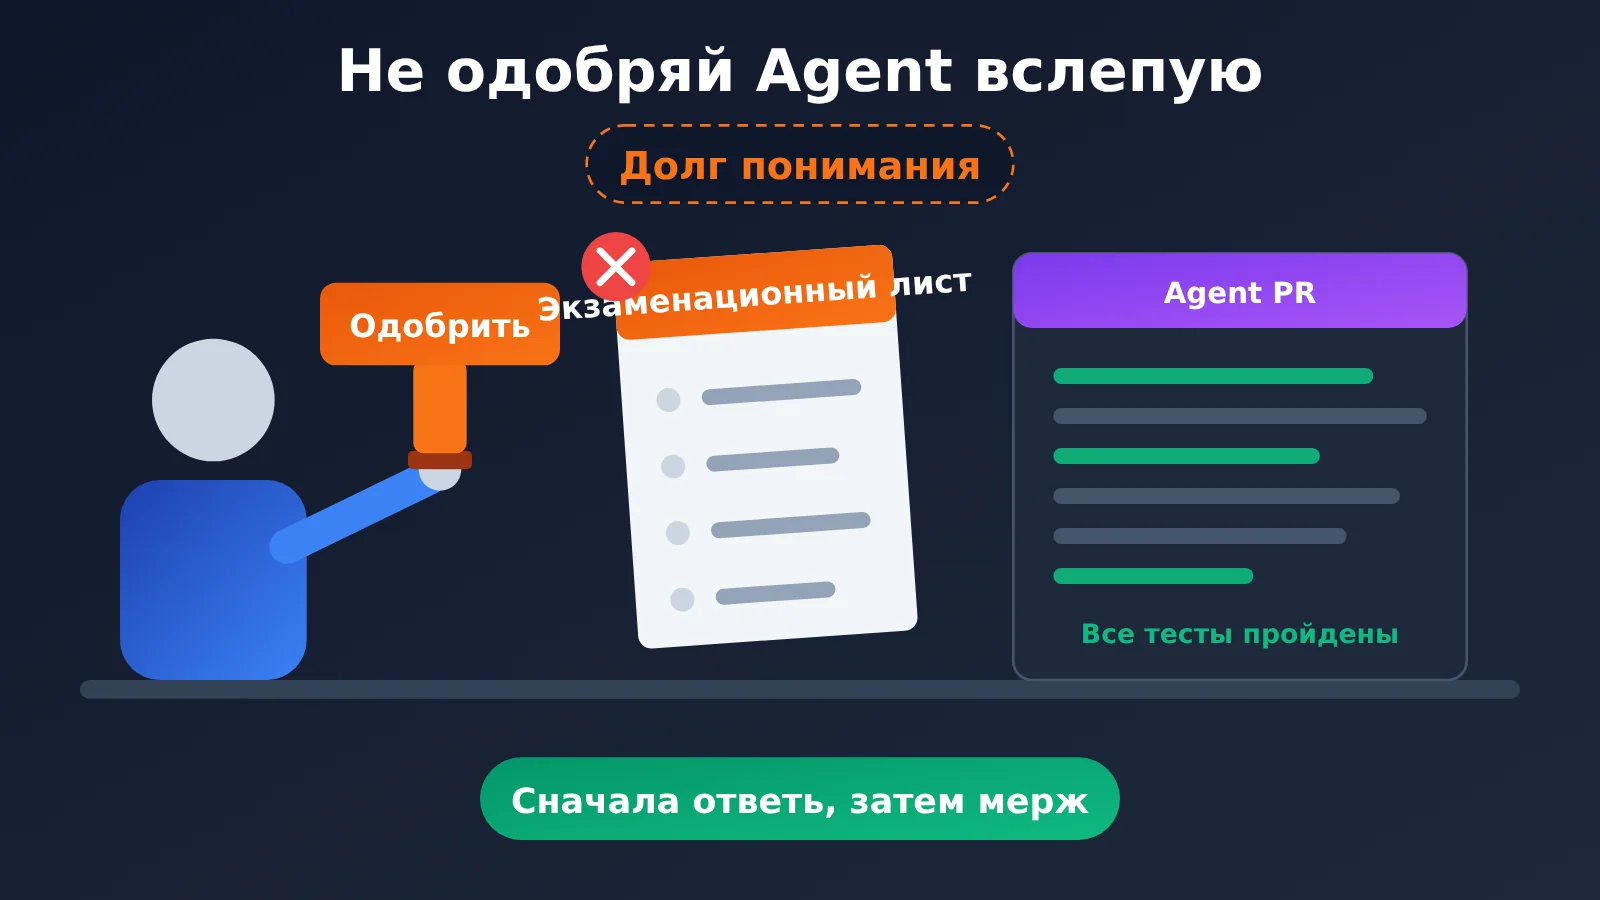
Если вы каждый день используете Claude Code, Cursor или Cline для написания кода, вам наверняка знакома такая ситуация: агент за несколько минут выдаёт PR на несколько сотен строк. Имена соответствуют соглашениям, структура понятна, все тесты проходят — и вы нажимаете «Одобрить». А через несколько недель кто-то спрашивает, почему логика устроена именно так, и вам нечего ответить. В этой статье мы разберём конкретные способы проверки, например попросить ИИ устроить вам экзамен. Они помогут отвечать за каждое одобренное изменение, даже если вы не просматриваете код построчно.
Это не статья с призывом вернуться к написанию кода вручную. Инженер Claude Code Addy Osmani сам прямо говорит: никто не требует от разработчика держать в голове всю кодовую базу. Вопрос не в том, читаете ли вы каждую строку, а в том, понимаете ли вы, что знаете, а чего не знаете.
Что вы получите: узнаете, как когнитивная разгрузка переходит в передачу права на принятие решений, а затем — в когнитивную капитуляцию. Вы также получите готовый список вопросов и шаблоны промптов для проверки перед слиянием и научитесь выбирать глубину ревью с учётом рисков.
Не одобряйте работу Agent не глядя: главное о долге понимания
Как сообщает QbitAI со ссылкой на публикацию, перепечатанную 36Kr, бывший инженер Google Addy Osmani, который сейчас работает над Claude Code, поднял болезненную тему: чем надёжнее результаты AI, тем менее внимательно люди их проверяют. Он выделил несколько последовательных этапов этого процесса и предложил два новых понятия «долга». Уточним: приведённые ниже концепции основаны на пересказе СМИ; точные формулировки стоит сверить с оригинальным текстом Addy.
| Понятие | Значение | Типичная ситуация |
|---|---|---|
| Когнитивная разгрузка | Вы поручаете конкретную работу AI, но по-прежнему понимаете задачу и можете оценить результат | Agent пишет шаблонный код, а вы понимаете, что он делает |
| Передача суждения | Ответы AI постепенно становятся основой для следующих шагов по умолчанию | Во второй раз вы лишь пробегаете результат глазами и дальше действуете так, как предлагает Agent |
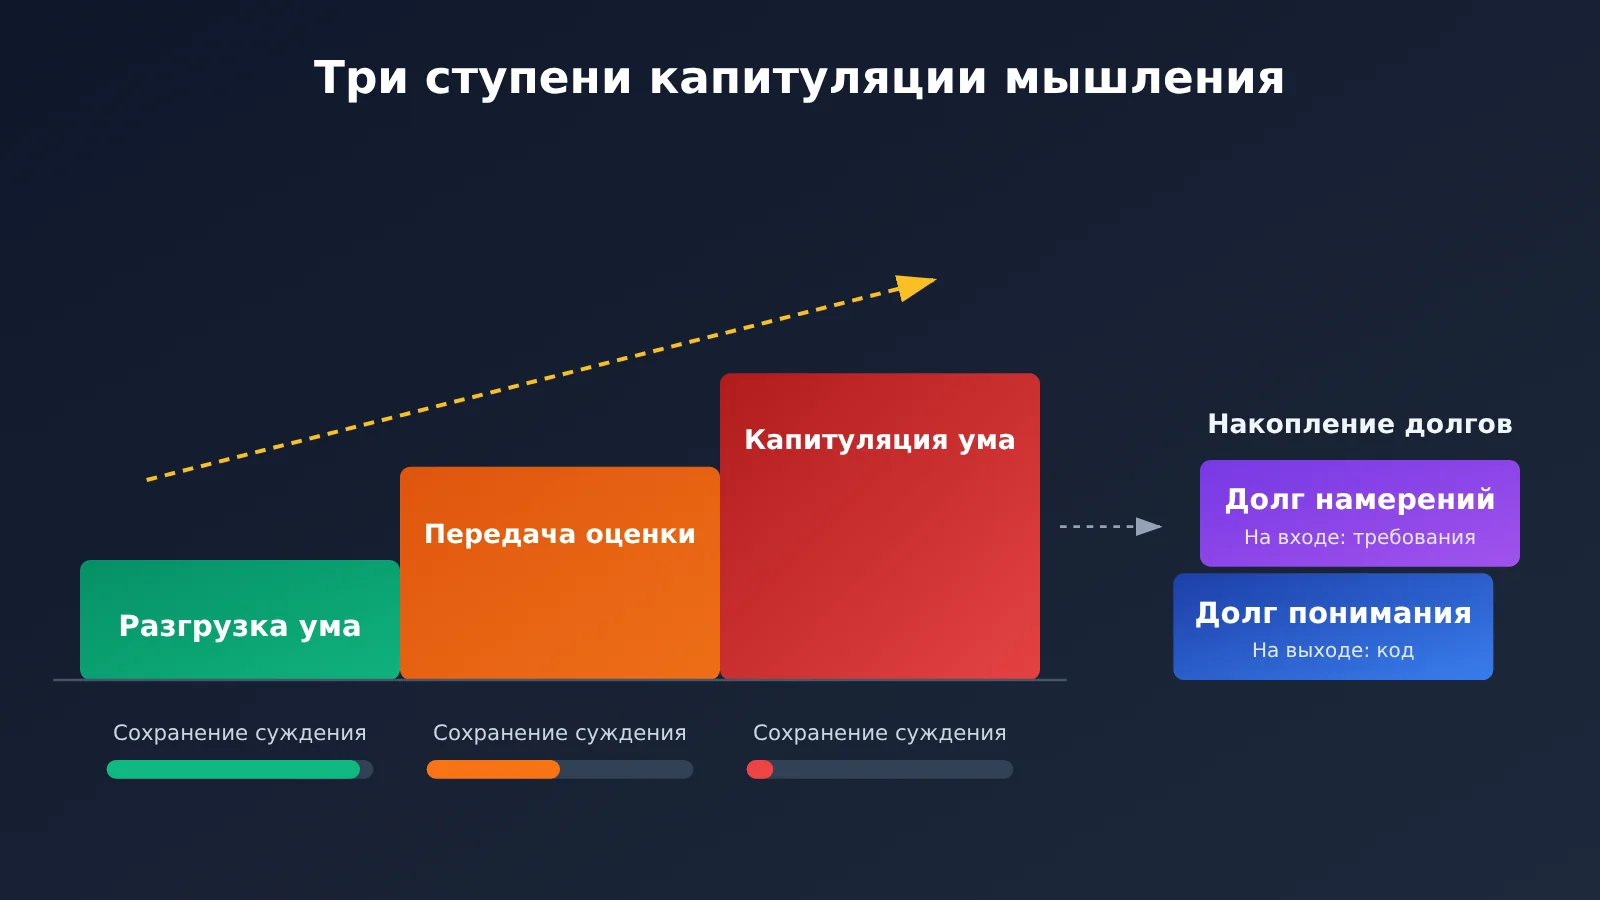
| Когнитивная капитуляция | Вы передаёте AI даже решения, которые должны принимать сами | «AI наверняка прав»: все тесты прошли — сразу сливаем код |
| Долг понимания | Код и система становятся сложнее, а понимание разработчиков за ними не поспевает | Когда нужно изменить функциональность, никто не может разобраться во внутреннем устройстве |
| Долг намерений | AI за вас определяет цели, ограничения и компромиссы, которые не были чётко сформулированы в требованиях | Вы сами не до конца поняли, что вам нужно, а Agent уже выдал вполне презентабельный результат |
Как постепенно возникают когнитивная капитуляция и долг понимания
Когнитивная капитуляция не происходит за одну ночь. Сначала вы просто «разгружаете» себя от конкретной работы — и в этом нет ничего плохого, как нет ничего плохого в использовании компилятора вместо написания кода на ассемблере вручную. Опасность появляется на втором этапе: когда результаты работы агента несколько раз подряд оказываются надёжными, его выводы незаметно становятся для вас исходной истиной, и вы начинаете пропускать проверку. На третьем этапе кнопка «Одобрить» превращается в формальность, а вы из инженера — в человека, который просто ставит печать.
Addy привёл характерный пример: агент за один раз предлагает 600 строк кода с понятной структурой и успешно пройденными тестами. Разработчик спокойно принимает изменения. Но агент мог в неприметном месте изменить порядок обработки транзакций или скорректировать какое-то граничное условие. В тот момент эти изменения не вызовут ошибок. А когда в системе действительно возникнет проблема, разработчик обнаружит, что не может объяснить, почему код работает именно так. Это и есть «проценты» по долгу понимания — их всегда приходится выплачивать в самый неподходящий момент.
Долг намерения возникает ещё раньше, на этапе формулирования задачи. Современные агенты настолько хорошо дополняют требования, что способны выдать вполне убедительный результат, даже если вы сами не до конца разобрались, чего хотите. Проблема в том, что неясные цели, рамки и компромиссы ИИ уже незаметно определил за вас. Долг намерения и долг понимания часто накладываются друг на друга: вы не понимаете ни того, чего хотели изначально, ни того, что агент в итоге сделал.
6 способов погасить долг понимания
В своей большой статье Addy поделился множеством практических советов. Мы собрали их в 6 методов и указали, с каким видом долга и на каком этапе работы помогает каждый из них.
| Метод | Когда использовать | Что помогает погасить | Что делать |
|---|---|---|---|
| 1. Попросить агента проверить ваши знания | После крупных изменений, перед слиянием | Долг понимания | Попросить агента описать изменения и их причины, затем задать вопросы; сливать только после правильных ответов на все вопросы |
| 2. Составить список требований до начала работы | До написания промпта | Долг намерений | Указать, для кого задача, какую проблему решает, что в неё не входит и каковы критерии готовности |
| 3. Расспросить о несогласованных решениях | После завершения длительной задачи | Долг понимания, долг намерений | Спросить, какие решения агент принял без вашего согласия и на какие предположения опирался |
| 4. Спросить, что осталось без тестов | При просмотре результатов тестирования | Долг понимания | Сначала изучить фактически выполненные тесты и их результаты, затем прочитать сводку ИИ |
| 5. Сохранять исходные материалы | При параллельной работе нескольких агентов | Долг понимания | Для важных задач сохранять исходные материалы и результаты проверок; если не успеваете всё проверить, сократить число параллельных задач |
| 6. Регулярно практиковаться без агента | Каждую неделю и каждый месяц | Утрата навыков | Раз в неделю писать код без агента, раз в месяц оценивать, какие навыки вы передали на аутсорсинг |
Попросите ИИ проверить ваши знания: главный способ выявить долг понимания
Это самый интересный приём во всей подборке. После того как агент завершит крупное изменение, не спешите его одобрять. Вместо этого попросите агента выступить в роли экзаменатора: описать, что и почему было изменено, а затем задать несколько вопросов по этим изменениям. Установите правило: слияние возможно, только если вы ответили правильно на все вопросы.
Этот приём превращает расплывчатое ощущение «кажется, я всё понял» в проверяемый результат. Вопросы, на которые вы не смогли ответить, покажут, где именно у вас накопился долг понимания.
Расспросите о несогласованных решениях и пропущенных тестах
При выполнении длительных задач агент сам выбирает параметры по умолчанию, меняет объём реализации и даже принимает решения при противоречиях в требованиях. Эти решения могут не попасть в итоговую сводку, потому что кажутся «слишком естественными». Поэтому вместо вопроса «Всё готово?» полезнее спросить: какие решения ты принял без моего явного согласия? Где ты опирался на собственные предположения? Что осталось непроверенным? Какие изменения могут повлиять на другие функции?
С тестами ситуация похожая. Addy напоминает: зелёные тесты доказывают лишь то, что проверенные условия выполнены. Если граничные случаи в тесты не включили, отчёт всё равно может выглядеть отлично. Поэтому сначала посмотрите, какие тесты действительно запускались и какие результаты они вернули, а уже потом читайте сводку, созданную ИИ. Для изменений с высоким риском можно также попросить другого агента независимо поискать проблемы под другим углом.
Самопроверка перед слиянием: 5 шагов, чтобы не одобрять работу агента вслепую
Все описанные выше приёмы складываются в процесс, который можно применять перед слиянием каждого PR. Он не требует построчной проверки, но на каждом этапе вы должны сами разобраться в происходящем.
- Запишите ожидания до начала работы: своими словами опишите требования и то, что должно получиться. Если после двух корректировок промпта результат всё ещё не устраивает, вернитесь к требованиям и разберитесь с ними, вместо того чтобы усложнять промпт.
- Попросите объяснить решения: по завершении задачи пусть агент перечислит решения, принятые без вашего согласования, свои предположения и то, что осталось непроверенным.
- Проверьте, какие тесты действительно запускались: изучите выполненные команды и их вывод, уточните, какие граничные случаи остались без проверки.
- Попросите агента составить вопросы: пусть он подготовит вопросы для самопроверки по текущему diff. Если ответили неправильно, вернитесь к коду и разберитесь в нём.
- Найдите то, что могли упустить: после того как агент представит результат, найдите хотя бы одну вещь, которую он мог не проверить.
Минимальный промпт для проверки долга понимания
Этот промпт попросит агента проверить, насколько хорошо вы поняли изменения. Его можно сразу вставить в диалог с Claude Code, Cursor или Cline:
在我合并这次改动之前,请先做两件事:
1. 用不超过 10 条要点总结本次改了哪些文件、每处改动的原因。
2. 根据本次 diff 给我出 5 道题,重点覆盖:事务/调用顺序、
   边界条件、错误处理、对其他模块的影响。
   先只给题目,等我作答后再批改,并指出我答错的地方对应哪段代码。
规则:我没有全部答对之前,不要建议合并。
Посмотреть полный шаблон промпта для проверки перед слиянием
# 阶段 A:开工前(偿还意图债,由我先填写)
需求说明:
- 面向谁:
- 要解决的问题:
- 明确不做的事:
- 完成标准(做到什么程度算完成):
- 我预期的改动范围和结果:

# 阶段 B:任务结束后(请 Agent 逐条回答)
1. 你做了哪些我没有明确授权的决定?请列出决定内容和理由。
2. 哪些地方依赖了你自己的假设?假设不成立时会发生什么?
3. 还有哪些内容没有验证?
4. 哪些改动可能影响其他功能或模块?
5. 你实际运行了哪些测试命令?请贴出原始输出,而不是总结。
6. 哪些边界情况没有写进测试?

# 阶段 C:出题考核(偿还理解债)
请根据本次 diff 出 5 道题,先只给题目。
我作答后请批改,答错的题请定位到具体代码行。
我未全部答对前,不要建议合并。

# 阶段 D:高风险改动追加(可交给另一个独立会话)
请你作为独立审查者,不参考上一个会话的总结,
只基于原始需求和 diff,找出最可能出问题的 3 个地方。
🎯 Совет: этап A обязательно заполните сами до начала работы, а не поручайте это агенту. Для этапа D лучше открыть новый сеанс, чтобы независимый проверяющий не попал под влияние выводов предыдущего агента. Это перекликается с предупреждением Addy о потере информации при передаче данных между агентами.
Шпаргалка: вопросы перед слиянием
| Этап | Обязательный вопрос | Тревожный признак |
|---|---|---|
| Перед началом работы | Могу ли я своими словами объяснить требования и критерии готовности? | Не получается описать, что делать не нужно |
| После выполнения | Какие решения агент принял без разрешения? | Ответ — «никаких», хотя diff явно выходит за рамки задачи |
| Тестирование | Какие тесты действительно запускали? Что не проверили? | Есть только итоговое описание, но нет исходного вывода |
| Проверка знаний | Смогу ли я правильно ответить на все вопросы? | Ошибки в вопросах о порядке транзакций и граничных условиях |
| Завершение | Могу ли я найти хотя бы одну вещь, которую агент не проверил? | Не удаётся вспомнить ничего |
AI задаёт вам вопросы или проверка по отчёту о приёмке
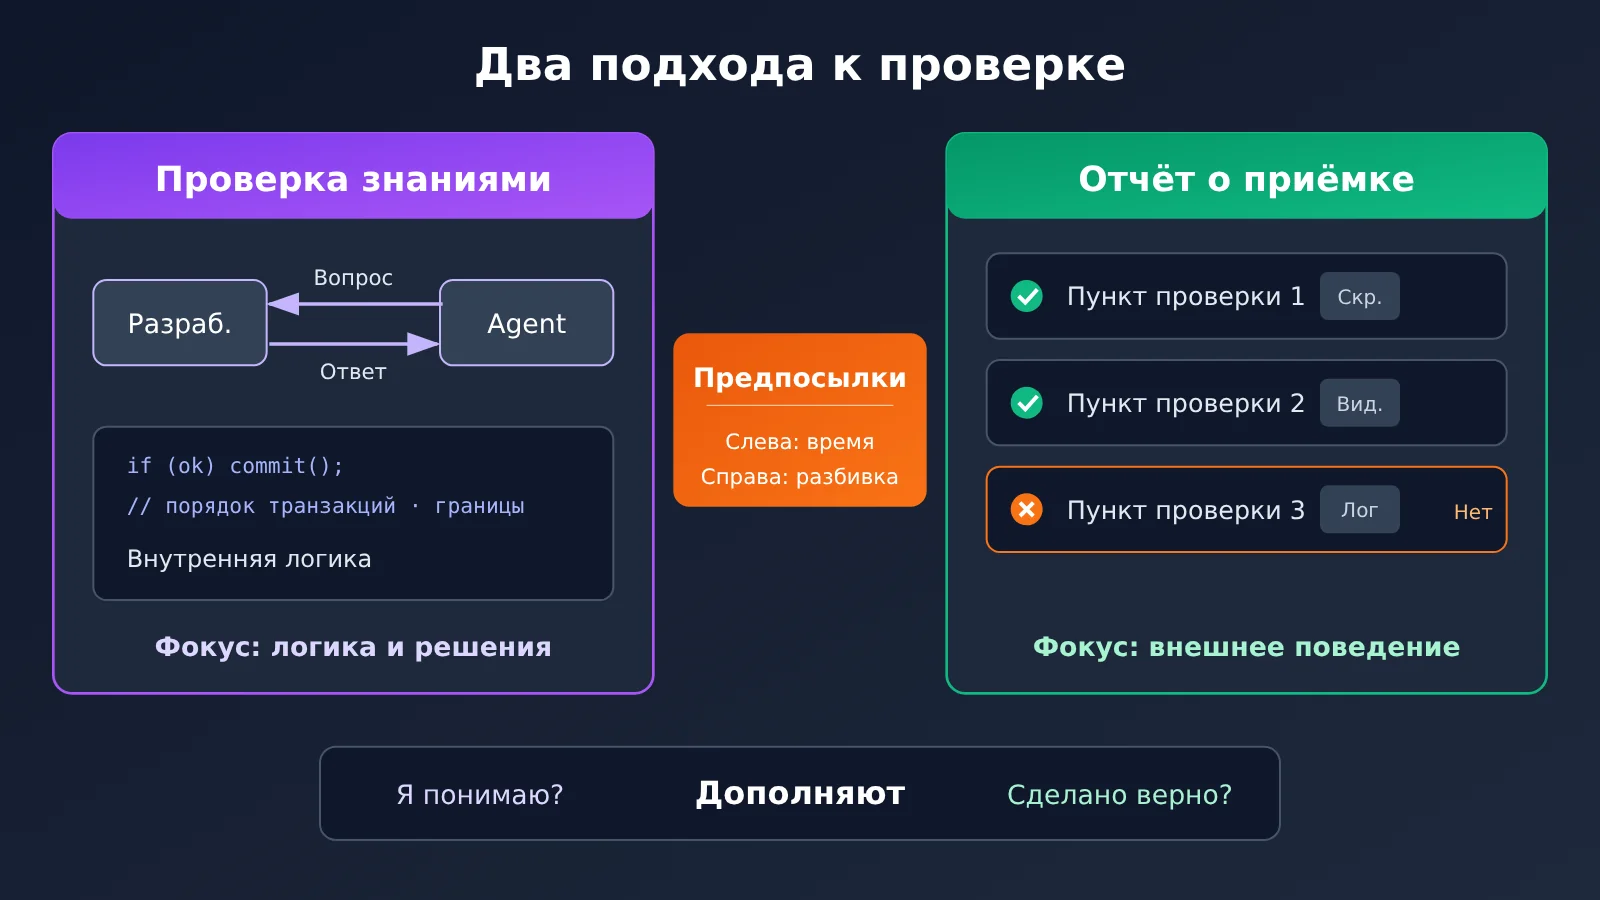
Совсем другой подход предлагает LobeHub — платформа для совместной работы AI-агентов с открытым исходным кодом и примерно 84 тысячами звёзд на GitHub. По сообщению 白鲸实验室, команда утверждает, что «почти перестала смотреть код» и сосредоточилась на мультимодальных отчётах агентов о приёмке. Для этого она использует собственный инструмент Acceptance, открытый в сентябре этого года: перед сдачей работы агент разбивает требования на проверяемые пункты, выполняет проверки в реальном продукте и собирает онлайн-отчёт со скриншотами, записями экрана и логами. Человек может принять работу целиком или отклонить отдельный пункт.
| Критерий | AI задаёт вам вопросы | Проверка по отчёту о приёмке |
|---|---|---|
| Что проверяется | Внутренняя логика кода, несогласованные решения, допущения | Наблюдаемое внешнее поведение продукта |
| Форма доказательств | Вопросы и ответы, результаты проверки | Скриншоты, записи экрана, логи, записи выполненных команд |
| Какие проблемы помогает обнаружить | Порядок транзакций, граничные случаи, неявные компромиссы | Соответствие интерфейса, взаимодействий и функций требованиям |
| Что легко пропустить | То, о чём вы не догадались попросить составить вопрос | Скрытую внутреннюю логику и риски в архитектуре |
| Предпосылки | Готовность разработчика потратить время на изучение изменений | Возможность разбить требования на наблюдаемые проверки и наличие среды для их автоматического выполнения |
| Роль человека | Разобраться в конкретных изменениях и взять за них ответственность | Определить критерии приёмки и принять окончательное решение |
Сравнение двух подходов к проверке
Проверка по отчёту о приёмке эффективна для проверки наблюдаемого поведения, а замечания можно привязать к конкретному пункту. В описанном в материале тесте проверяющий отклонил только пункт о тёмном фоне, и агент изменил лишь одну строку CSS, не тронув остальные файлы. Но этот подход зависит от того, можно ли разбить требования на наблюдаемые проверки. Кроме того, как отмечается в материале, в более сложных задачах оценка безопасности, архитектуры и итогового качества по-прежнему требует участия человека, а передача обратной связи всё ещё включает ручные этапы. Заявление о том, что команда «почти не смотрит код», сделано ей самой и независимо не подтверждено.
Проверка с вопросами от AI лучше помогает выявить проблемы, которые «не видны в интерфейсе», например порядок транзакций или граничные случаи. Она как раз покрывает слепые зоны отчёта о приёмке. Однако её эффективность зависит от качества вопросов, а разработчику нужно действительно потратить время на понимание изменений. Эти подходы не исключают друг друга: разумно использовать отчёт о приёмке, чтобы проверить, «всё ли сделано правильно», а вопросы — чтобы понять, «разбираюсь ли я, почему всё сделано именно так».
Выбирайте глубину проверки долга понимания по риску изменений
Не каждый PR стоит проводить через полный процесс проверки. Addy тоже предупреждает: когда сгенерированного кода становится слишком много, чтобы отвечать за него, вы уже не проверяете его, а просто надеетесь, что всё в порядке. Таблица ниже поможет выбрать подход по уровню риска. Конкретные пороги стоит подстроить под вашу команду.
| Уровень риска | Типичные изменения | Рекомендуемая глубина проверки |
|---|---|---|
| Низкий | Тексты, стили, отдельные скрипты, прототипы | Достаточно отчёта о приёмке или ручной проверки; зафиксируйте ожидаемый результат |
| Средний | Обычные бизнес-функции, добавление интерфейсов | Расспросите о решениях, принятых без согласования, и проверьте реальные результаты тестов |
| Высокий | Транзакции, права доступа, платежи, миграция данных | Полный процесс из 5 шагов + проверочные вопросы + проверка независимым агентом |
| Превышена нагрузка | Параллельная работа нескольких агентов, результаты которых не успевают проверять | Добавьте автоматические проверки или сократите число параллельно работающих агентов |
💡 Как выбрать подход: если в вашей команде уже налажена автоматическая приёмка, можно сосредоточить проверочные вопросы на изменениях с высоким риском. Если нет, хотя бы для PR, затрагивающих согласованность данных и права доступа, придерживайтесь правила: «сливаем только после правильных ответов».
Частые вопросы FAQ
Q1: Что такое долг понимания и чем он отличается от технического долга?
Долг понимания возникает, когда сложность кода и системы растёт, а понимание кода разработчиками за ней не поспевает. Технический долг обычно связан с недостатками самого кода. Долг понимания может возникнуть и при хорошем качестве кода: проблема в том, что люди его не понимают. Заметной она становится, когда код нужно изменить.
Q2: Чем проверка с помощью вопросов от AI отличается от объяснения кода самим AI?
Когда AI объясняет код, вы пассивно получаете информацию — и легко возникает иллюзия, что вы всё поняли. Проверка с вопросами требует самостоятельно отвечать, а ошибки привязываются к конкретным участкам кода. Так можно превратить смутное понимание в проверяемый результат.
Q3: Если не одобрять работу Agent бездумно, значит ли это, что нужно проверять код AI построчно?
Нет. По сообщениям, команда Claude Code не требует от инженеров помнить всю кодовую базу: когда нужно изменить какую-то часть, они с помощью Claude заново разбираются в соответствующей логике. Главное — понимать, что вы знаете, а чего не знаете, и выбирать глубину проверки с учётом рисков.
Q4: Для каких сценариев разработки подходит этот подход?
Прежде всего для следующих:
— **Длительные задачи Agent**: в них могут появляться несанкционированные решения, поэтому полезно использовать список уточняющих вопросов
— **Изменения в бэкенде, затрагивающие транзакции и граничные условия**: подойдёт проверка с помощью вопросов
— **Параллельная разработка с несколькими Agent**: полезно сохранять исходные материалы и ограничивать количество параллельных задач
— **Командный Code Review**: список вопросов можно включить в шаблон PR
Q5: Как применять эту самопроверку долга понимания в Claude Code, Cursor и Cline?
Подход не зависит от конкретного инструмента — главное здесь промпт и процесс:
1. Сохраните полный шаблон промпта из статьи как фрагмент, который команда сможет использовать повторно
2. Перед началом работы напишите этап A вручную, а после завершения задачи вставьте этапы B и C
3. Для изменений с высоким риском выполните этап D в отдельной новой сессии
Можно также включить правило «слияние только после правильных ответов» в командный чек-лист проверки PR.
Q6: Какие ограничения известны у этих методов?
Важно смотреть на них объективно:
— **Данные об эффективности**: сейчас нет открытых данных о том, насколько эти методы снижают долю дефектов или повышают эффективность
— **Затраты времени**: полный процесс увеличивает время до слияния и подходит не для всех PR
— **Слепые зоны в вопросах**: Agent может не задать вопросы о проблемах, которых сам не заметил, поэтому пропускать шаг «найти что-то упущенное при проверке» нельзя
— **Источники**: точка зрения Addy приведена в пересказе СМИ, поэтому формулировки первоисточника нужно проверять самостоятельно
Q7: Действительно ли нужно каждую неделю практиковаться в написании кода без AI?
По мнению Адди, навыки, которыми долго не пользуешься, постепенно утрачиваются. Если время от времени выполнять задачи самостоятельно, без Agent, можно проверить свой реальный уровень. Раз в месяц стоит пересматривать, какие навыки вы доверили ИИ, а какие нужно поддерживать самостоятельно. Это не требует много времени, но помогает не допустить незаметной когнитивной капитуляции.
Не доверяйте Agent без проверки: главное о долге понимания
- Когнитивная капитуляция происходит постепенно: сначала вы разгружаете мышление, затем уступаете право принимать решения, а потом полностью передаёте его ИИ.
- Долг понимания со временем накапливает проценты: код пишется всё быстрее, но непонятные участки дадут о себе знать, когда их придётся менять.
- Долг намерения возникает ещё до начала работы: сами составьте список требований, а если результат не устраивает после двух промптов, пересмотрите требования.
- Проверка знаний — ключевой шаг: попросите Agent подвести итог изменений и задать вам вопросы. Объединяйте изменения только после того, как ответите на все вопросы правильно.
- Зелёные тесты не гарантируют отсутствие проблем: сначала посмотрите результаты фактически выполненных тестов, а затем выясните, что осталось непроверенным.
- Отчёт о приёмке и проверка знаний дополняют друг друга: первый помогает проверить внешнее поведение, вторая — ваше понимание внутренней логики.
- Проверяйте изменения с учётом риска: если не успеваете с проверкой, добавьте автоматизацию или сократите число параллельных задач. Не полагайтесь на удачу.
Итоги
Главное правило — не одобряйте работу агента автоматически:
- Распознайте проблему: следите за тем, чтобы «поручить работу ИИ» не превратилось в «доверить ИИ принятие решений». Долг понимания и долг намерений возникают как раз на этом пути.
- Действуйте: перед началом работы запишите свои ожидания, при сдаче уточните, какие решения агент принял без разрешения и что не проверил, а перед слиянием попросите ИИ проверить ваши знания.
- Учитывайте уровень риска: для изменений с низким риском достаточно отчёта о приёмке или выборочной проверки; для изменений с высоким риском пройдите весь процесс и добавьте независимое ревью.
ИИ будет писать код всё быстрее, но за изменения по-прежнему отвечает тот, кто их одобрил. В следующий раз перед нажатием кнопки «Одобрить» попросите агента задать вам 5 вопросов и проверьте, на сколько из них сможете ответить.
📚 Источники
- QbitAI: большой гайд по агентам от инженера Claude (перепубликация на 36Kr): взгляды Addy Osmani на когнитивную капитуляцию, долг понимания и долг намерений, а также практические методы работы
- Ссылка:
36kr.com/p/4056027738116995 -
Примечание: основной источник методологии этой статьи; материал представляет собой пересказ в СМИ
-
Оригинальный пост Addy Osmani: первоисточник, на который ссылается публикация
- Ссылка:
x.com/addyosmani/status/2117512471930167377 -
Примечание: за точными формулировками обращайтесь к оригиналу; ссылку необходимо проверить самостоятельно
-
BaiJing Lab: AI-компания с 80 тысячами звёзд решила передать управление собой ИИ (перепубликация на 36Kr): описание архитектуры управляющих агентов LobeHub и практики отчётов о приёмке Acceptance
- Ссылка:
36kr.com/p/4056040123945860 - Примечание: источник для сравнения подхода к ревью через отчёты о приёмке; слова «почти не смотрим код» принадлежат самой команде
Автор: техническая команда APIYI