Anmerkung des Autors: Ausgehend von Addy Osmanis Konzepten der „kognitiven Kapitulation“ und der „Verständnisschulden“ stellt dieser Artikel eine Checkliste und Eingabeaufforderungs-Vorlagen für den Selbstcheck vor dem Zusammenführen eines PR zusammen. Außerdem vergleicht er den Ansatz von LobeHub, der sich bei der Prüfung auf Abnahmeberichte stützt. So können Sie die Prüftiefe passend zum Risiko wählen.
Wenn Sie täglich mit Claude Code, Cursor oder Cline Code ausliefern, kennen Sie vielleicht diese Situation: Ein Agent liefert in wenigen Minuten einen PR mit mehreren Hundert Zeilen ab. Die Benennung ist einheitlich, die Struktur klar und alle Tests sind grün – also klicken Sie auf „Genehmigen“. Ein paar Wochen später fragt jemand, warum die Logik so umgesetzt wurde, und Sie können es nicht beantworten. Dieser Artikel zeigt Ihnen konkrete Prüfschritte wie „Lassen Sie sich von der KI abfragen“. So können Sie für jede genehmigte Änderung Verantwortung übernehmen, ohne jede Zeile prüfen zu müssen.
Dieser Artikel will Sie nicht dazu überreden, wieder Code von Hand zu schreiben. Der Claude-Code-Entwickler Addy Osmani stellt selbst klar: Niemand verlangt von Entwicklern, die gesamte Codebasis auswendig zu kennen. Entscheidend ist nicht, ob Sie jede Zeile lesen, sondern ob Sie wissen, was Sie verstehen – und was nicht.
Das nehmen Sie mit: Sie verstehen den schrittweisen Übergang von „kognitiver Entlastung“ über das „Abgeben von Urteilsvermögen“ bis zur „kognitiven Kapitulation“. Außerdem erhalten Sie eine direkt kopierbare Fragenliste und Eingabeaufforderungs-Vorlagen für die Prüfung vor dem Zusammenführen und lernen, die Prüftiefe am Risiko der Änderung auszurichten.
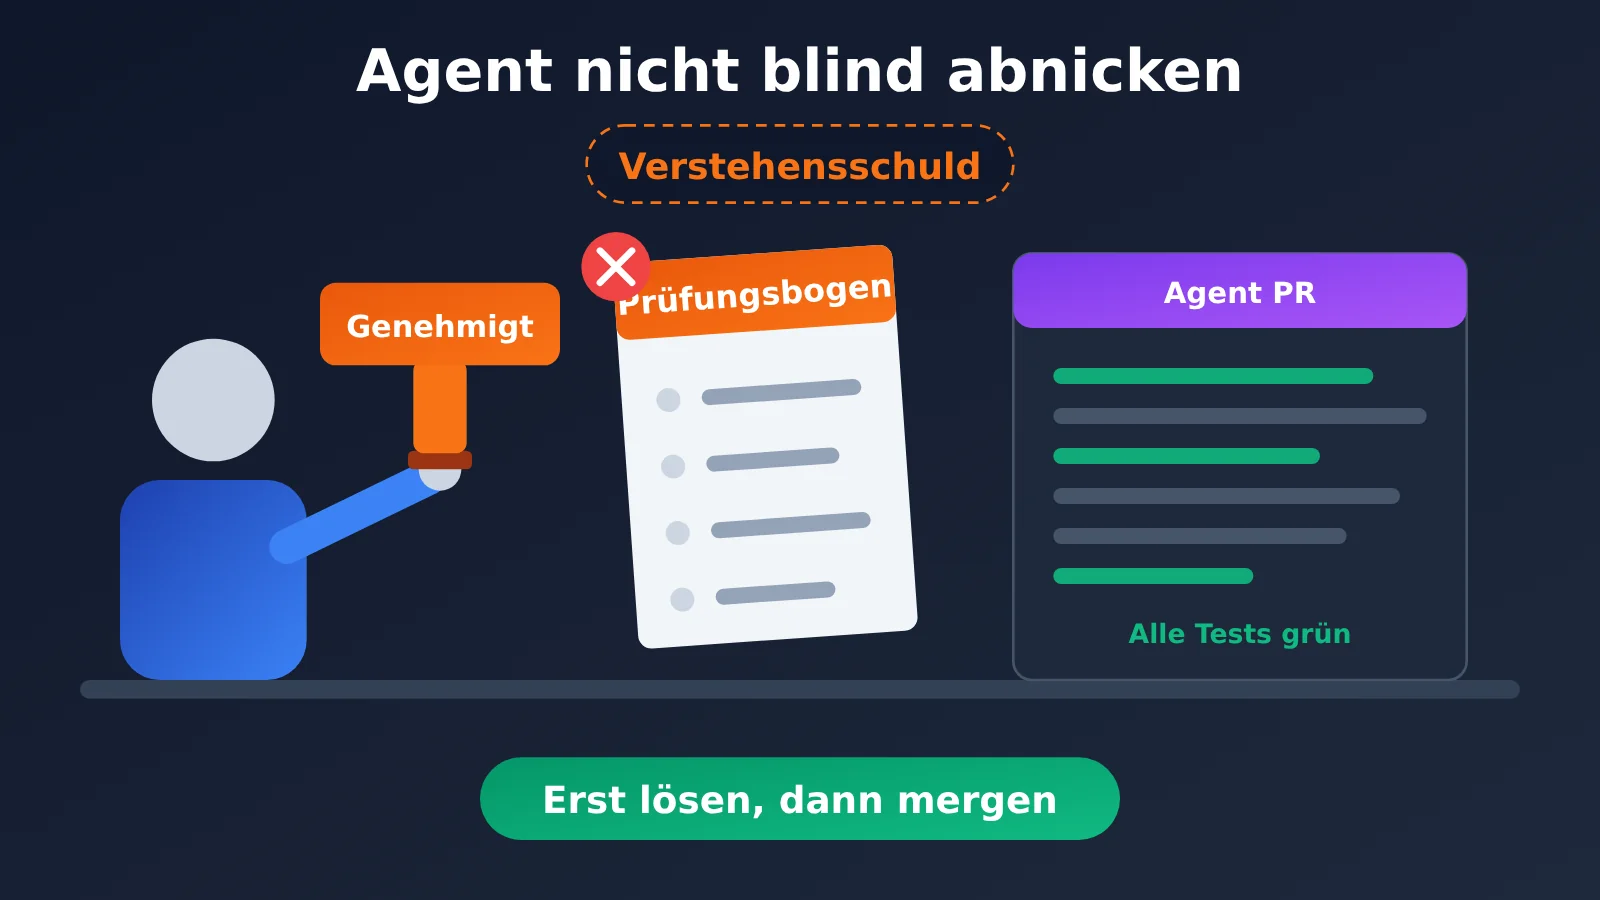
Nicht einfach abnicken: Das Wichtigste zu Verständnisschulden
Wie QbitAI berichtet (und 36Kr aufgegriffen hat), beschreibt der ehemalige Google-Ingenieur Addy Osmani, der inzwischen an Claude Code arbeitet, ein unangenehmes Problem: Je zuverlässiger KI-generierte Ergebnisse sind, desto weniger sorgfältig prüfen Menschen sie. Er unterteilt diesen Prozess in mehrere aufeinanderfolgende Phasen und beschreibt zwei neue Arten von „Schulden“. Die folgenden Konzepte stammen aus der Medienberichterstattung; für den genauen Wortlaut ist Addys Originaltext maßgeblich.
| Konzept | Bedeutung | Typisches Beispiel |
|---|---|---|
| Kognitive Auslagerung | Man überlässt der KI konkrete Arbeit, versteht die Aufgabe aber weiterhin und kann das Ergebnis beurteilen | Ein Agent schreibt Boilerplate-Code, und man weiß genau, was er tut |
| Abgabe der Urteilsfähigkeit | Die Antworten der KI werden zunehmend zur ungeprüften Grundlage für die nächsten Arbeitsschritte | Beim zweiten Mal schaut man nur noch flüchtig hin und macht weiter, wie der Agent es vorgibt |
| Kognitive Kapitulation | Man überlässt der KI auch Entscheidungen, die man selbst treffen sollte | „Die KI wird schon recht haben“ – alle Tests sind grün, also wird direkt gemergt |
| Verständnisschulden | Code und System werden komplexer, doch das Verständnis der Entwickler hält nicht Schritt | Wenn eine Funktion geändert werden muss, blickt niemand mehr durch die interne Struktur |
| Intentionsschulden | Die KI entscheidet über Ziele, Einschränkungen und Abwägungen, die in den Anforderungen nicht klar formuliert wurden | Man weiß selbst noch nicht genau, was man will, aber der Agent liefert bereits ein ansehnliches Ergebnis |
Von kognitiver Kapitulation zu Verständnisschulden
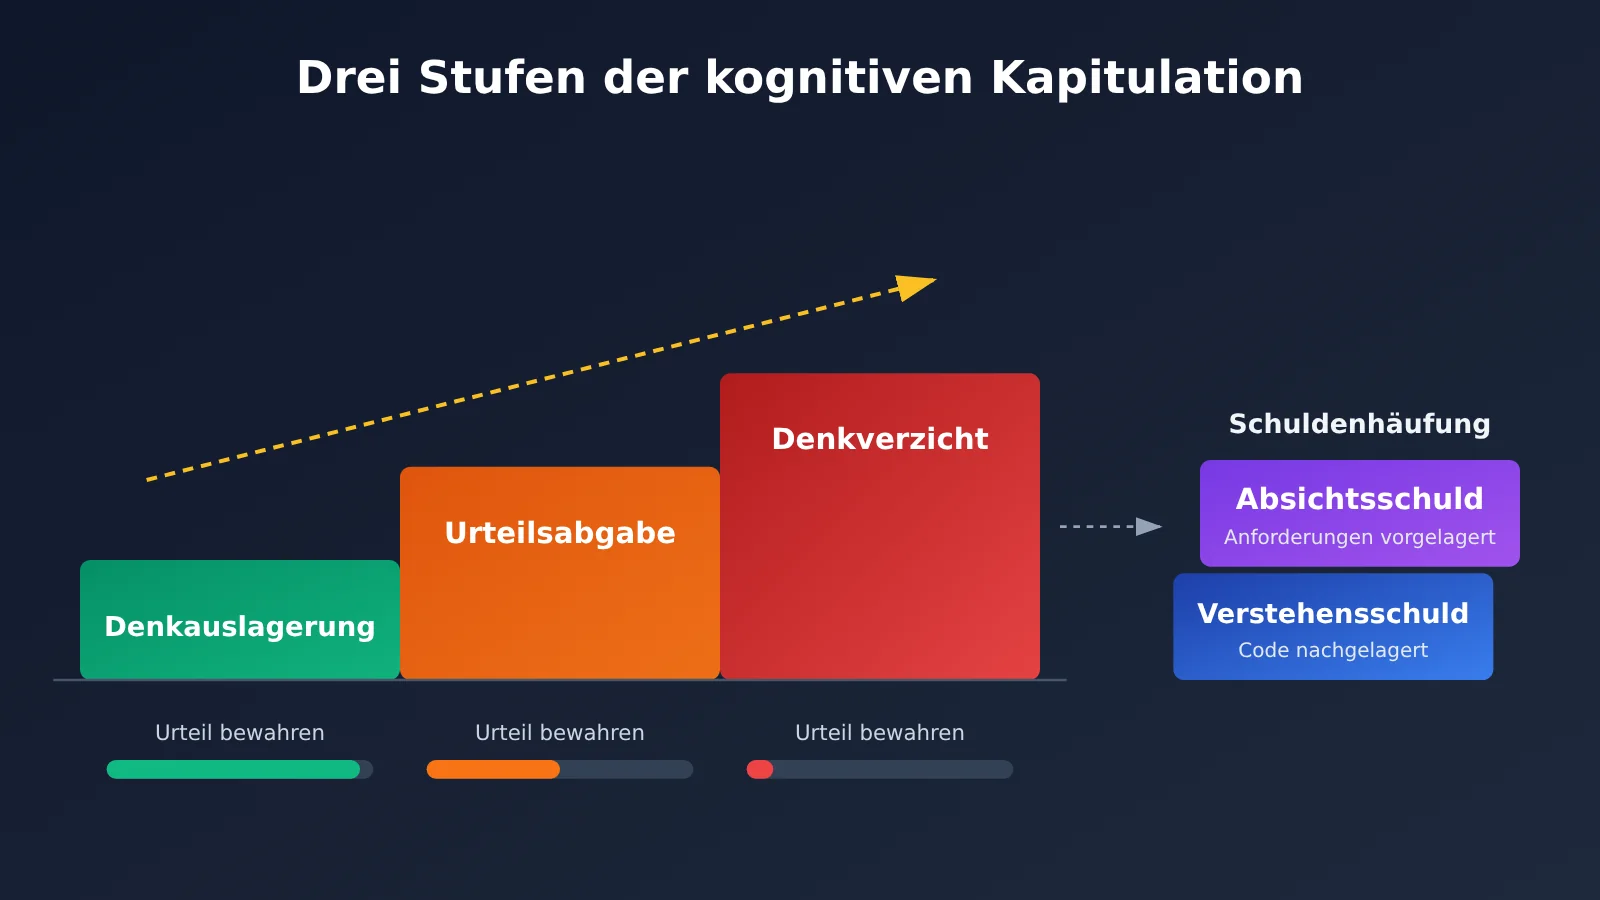
Kognitive Kapitulation passiert nicht über Nacht. Anfangs lagert man nur konkrete Arbeit aus – daran ist nichts auszusetzen, genauso wenig wie daran, einen Compiler zu nutzen, statt Assembler von Hand zu schreiben. Gefährlich wird es in der zweiten Phase: Wenn die Ergebnisse eines Agenten mehrfach zuverlässig waren, werden seine Schlussfolgerungen schleichend zur eigenen Grundannahme, und man beginnt, auf die Prüfung zu verzichten. In der dritten Phase wird der „Genehmigen“-Button zum bloßen Stempel: Aus dem Entwickler wird jemand, der nur noch abnickt.
Addy nennt ein typisches Beispiel: Ein Agent liefert auf einmal 600 Zeilen Code, sauber strukturiert und mit bestandenen Tests. Der Entwickler mergt sie ohne Bedenken. Doch vielleicht hat der Agent an einer unauffälligen Stelle die Reihenfolge der Transaktionsverarbeitung geändert oder eine Randbedingung angepasst. Diese Änderungen lösen zunächst keinen Fehler aus. Erst wenn im System tatsächlich etwas schiefläuft, merkt der Entwickler, dass er nicht erklären kann, warum sich der Code so verhält. Das sind die „Zinsen“ auf Verständnisschulden – und sie werden immer zum ungünstigsten Zeitpunkt fällig.
Intentionsschulden entstehen noch früher im Prozess. Heutige Agenten sind so gut darin, Anforderungen zu ergänzen, dass sie selbst dann ein plausibel aussehendes Ergebnis liefern, wenn man sich noch nicht über alles im Klaren ist. Das Problem: Über Ziele, Umfang und Abwägungen, die man nicht eindeutig formuliert hat, hat die KI inzwischen stillschweigend selbst entschieden. Intentions- und Verständnisschulden treten oft gemeinsam auf: Man weiß weder genau, was man ursprünglich wollte, noch, was der Agent letztlich umgesetzt hat.
6 Methoden, um Verständnisschulden abzubauen
Addy stellt in seinem ausführlichen Artikel viele praktische Ansätze vor. Hier sind sie zu sechs Methoden zusammengefasst – mit Angaben dazu, welche Art von Schulden sie abbauen und wann sie im Workflow zum Einsatz kommen.
| Methode | Zeitpunkt | Baut vor allem ab | Die Maßnahme in einem Satz |
|---|---|---|---|
| 1. Lass dich vom Agent prüfen | Nach einer größeren Änderung, vor dem Merge | Verständnisschulden | Erst Änderungen und Gründe zusammenfassen lassen, dann Fragen beantworten und nur bei lauter richtigen Antworten mergen |
| 2. Schreib vorab eine Anforderungsliste | Vor dem Schreiben der Eingabeaufforderung | Intentionsschulden | Festhalten, für wen die Lösung gedacht ist, welches Problem sie löst, was sie nicht leisten soll und wann sie fertig ist |
| 3. Frag nach nicht autorisierten Entscheidungen | Am Ende einer längeren Aufgabe | Verständnisschulden, Intentionsschulden | Fragen, welche Entscheidungen der Agent ohne deine Zustimmung getroffen und welche Annahmen er dabei verwendet hat |
| 4. Frag nach nicht durchgeführten Tests | Bei der Auswertung von Testergebnissen | Verständnisschulden | Erst die tatsächlich ausgeführten Tests und ihre Ergebnisse ansehen, dann die KI-Zusammenfassung lesen |
| 5. Bewahr die Originalmaterialien auf | Wenn mehrere Agents parallel arbeiten | Verständnisschulden | Bei wichtigen Aufgaben Originalmaterialien und Prüfnachweise aufbewahren; wenn die Prüfung nicht mehr zu schaffen ist, weniger parallel arbeiten |
| 6. Üb regelmäßig ohne Agent | Wöchentlich und monatlich | Kompetenzverlust | Einmal pro Woche ohne Agent programmieren und monatlich prüfen, welche Fähigkeiten du ausgelagert hast |
Lass dich von der KI prüfen: der wichtigste Check für Verständnisschulden
Das ist einer der interessantesten Ansätze der ganzen Methode. Nachdem ein Agent eine größere Änderung abgeschlossen hat, gib sie nicht sofort frei. Lass ihn stattdessen die Rolle des Prüfers übernehmen: Er soll zusammenfassen, was er warum geändert hat, und anschließend ein paar Fragen zu den Änderungen stellen. Dabei gilt die Regel: Nur wenn du alle Fragen richtig beantwortest, wird gemergt.
So wird aus dem vagen Gefühl „Ich habe es ungefähr verstanden“ ein überprüfbares Ergebnis. Fragen, die du nicht beantworten kannst, zeigen dir ganz konkret, wo deine Verständnisschulden liegen.
Frag nach nicht autorisierten Entscheidungen und fehlenden Tests
Bei länger laufenden Aufgaben wählen Agents selbstständig Standardparameter, passen den Umfang der Implementierung an oder treffen sogar Abwägungen bei widersprüchlichen Anforderungen. Solche Entscheidungen tauchen in der abschließenden Zusammenfassung nicht unbedingt auf, weil sie „zu selbstverständlich“ erscheinen. Statt einfach zu fragen „Bist du fertig?“, lohnt sich daher das Nachhaken: Welche Entscheidungen hast du getroffen, die ich nicht ausdrücklich autorisiert habe? Wo hast du dich auf eigene Annahmen gestützt? Was wurde noch nicht überprüft? Welche Änderungen könnten andere Funktionen beeinflussen?
Für Tests gilt dasselbe. Addy weist ausdrücklich darauf hin, dass grüne Tests nur beweisen, dass die von ihnen abgedeckten Bedingungen erfüllt sind. Fehlen Grenzfälle in den Tests, kann der Bericht trotzdem gut aussehen. Die richtige Reihenfolge ist deshalb: erst ansehen, welche Tests tatsächlich ausgeführt wurden und welche Ergebnisse sie geliefert haben, dann die KI-generierte Zusammenfassung lesen. Bei Änderungen mit hohem Risiko kannst du außerdem einen zweiten Agent unabhängig und aus einer anderen Perspektive nach Problemen suchen lassen.
Selbstcheck vor dem Merge: 5 Schritte, statt Agent-Ergebnisse blind abzunicken
Die bisherigen Methoden ergeben zusammen einen Ablauf, den du vor dem Merge jedes PRs durchgehen kannst. Du musst dafür nicht jede Zeile prüfen – aber bei jedem Schritt selbst mitdenken.
- Vor dem Start Erwartungen festhalten: Beschreibe die Anforderungen und das erwartete Ergebnis in eigenen Worten. Bist du nach zwei Anpassungsrunden an der Eingabeaufforderung noch immer nicht zufrieden, überarbeite die Anforderungen, statt immer weitere Anweisungen anzuhängen.
- Entscheidungen offenlegen lassen: Lass den Agent nach Abschluss der Aufgabe nicht autorisierte Entscheidungen, Annahmen und ungeprüfte Punkte auflisten.
- Tatsächlich ausgeführte Tests prüfen: Sieh dir die ausgeführten Testbefehle und ihre Ausgabe an und frage nach, welche Grenzfälle nicht abgedeckt sind.
- Den Agent Fragen stellen lassen: Lass den Agent auf Grundlage des aktuellen Diffs Fragen für einen Selbsttest erstellen. Lies bei falschen Antworten den betreffenden Code noch einmal genau durch.
- Nach einer übersehenen Sache suchen: Suche nach der Abgabe des Agents selbst nach mindestens einer Sache, die er möglicherweise nicht geprüft hat.
Kompaktes Beispiel für eine Eingabeaufforderung zum Verständnis-Check
Diese Eingabeaufforderung lässt sich direkt in den Chat von Claude Code, Cursor oder Cline einfügen:
在我合并这次改动之前,请先做两件事:
1. 用不超过 10 条要点总结本次改了哪些文件、每处改动的原因。
2. 根据本次 diff 给我出 5 道题,重点覆盖:事务/调用顺序、
   边界条件、错误处理、对其他模块的影响。
   先只给题目,等我作答后再批改,并指出我答错的地方对应哪段代码。
规则:我没有全部答对之前,不要建议合并。
Vollständige Vorlage für Fragen vor dem Merge anzeigen
# 阶段 A:开工前(偿还意图债,由我先填写)
需求说明:
- 面向谁:
- 要解决的问题:
- 明确不做的事:
- 完成标准(做到什么程度算完成):
- 我预期的改动范围和结果:

# 阶段 B:任务结束后(请 Agent 逐条回答)
1. 你做了哪些我没有明确授权的决定?请列出决定内容和理由。
2. 哪些地方依赖了你自己的假设?假设不成立时会发生什么?
3. 还有哪些内容没有验证?
4. 哪些改动可能影响其他功能或模块?
5. 你实际运行了哪些测试命令?请贴出原始输出,而不是总结。
6. 哪些边界情况没有写进测试?

# 阶段 C:出题考核(偿还理解债)
请根据本次 diff 出 5 道题,先只给题目。
我作答后请批改,答错的题请定位到具体代码行。
我未全部答对前,不要建议合并。

# 阶段 D:高风险改动追加(可交给另一个独立会话)
请你作为独立审查者,不参考上一个会话的总结,
只基于原始需求和 diff,找出最可能出问题的 3 个地方。
🎯 Tipp: Füllen Sie Phase A unbedingt selbst aus, bevor die Arbeit beginnt – und lassen Sie das nicht den Agenten übernehmen. Für Phase D empfiehlt sich eine neue Sitzung. So wird der unabhängige Prüfer nicht von der Zusammenfassung des vorherigen Agenten beeinflusst. Das greift auch Addys Hinweis auf Informationsverluste bei der Weitergabe zwischen mehreren Agenten auf.
Checkliste: Fragen vor dem Merge
| Phase | Unbedingt fragen | Warnsignal |
|---|---|---|
| Vor dem Start | Kann ich die Anforderungen und Abnahmekriterien in eigenen Worten erklären? | Ich kann nicht aufschreiben, was ausdrücklich nicht umgesetzt werden soll. |
| Nach der Lieferung | Welche Entscheidungen hat der Agent ohne Freigabe getroffen? | Die Antwort lautet „keine“, aber der Diff geht offensichtlich über den Umfang hinaus. |
| Tests | Welche Tests wurden tatsächlich ausgeführt? Was wurde nicht getestet? | Es gibt nur eine Zusammenfassung, aber keine Originalausgabe. |
| Wissensprüfung | Könnte ich alle Prüfungsfragen richtig beantworten? | Fragen zu Transaktionsreihenfolge oder Randbedingungen werden falsch beantwortet. |
| Abschluss | Kann ich eine Sache finden, die der Agent nicht geprüft hat? | Mir fällt überhaupt nichts ein. |
KI-Prüfungsfragen im Vergleich zur Prüfung per Abnahmebericht
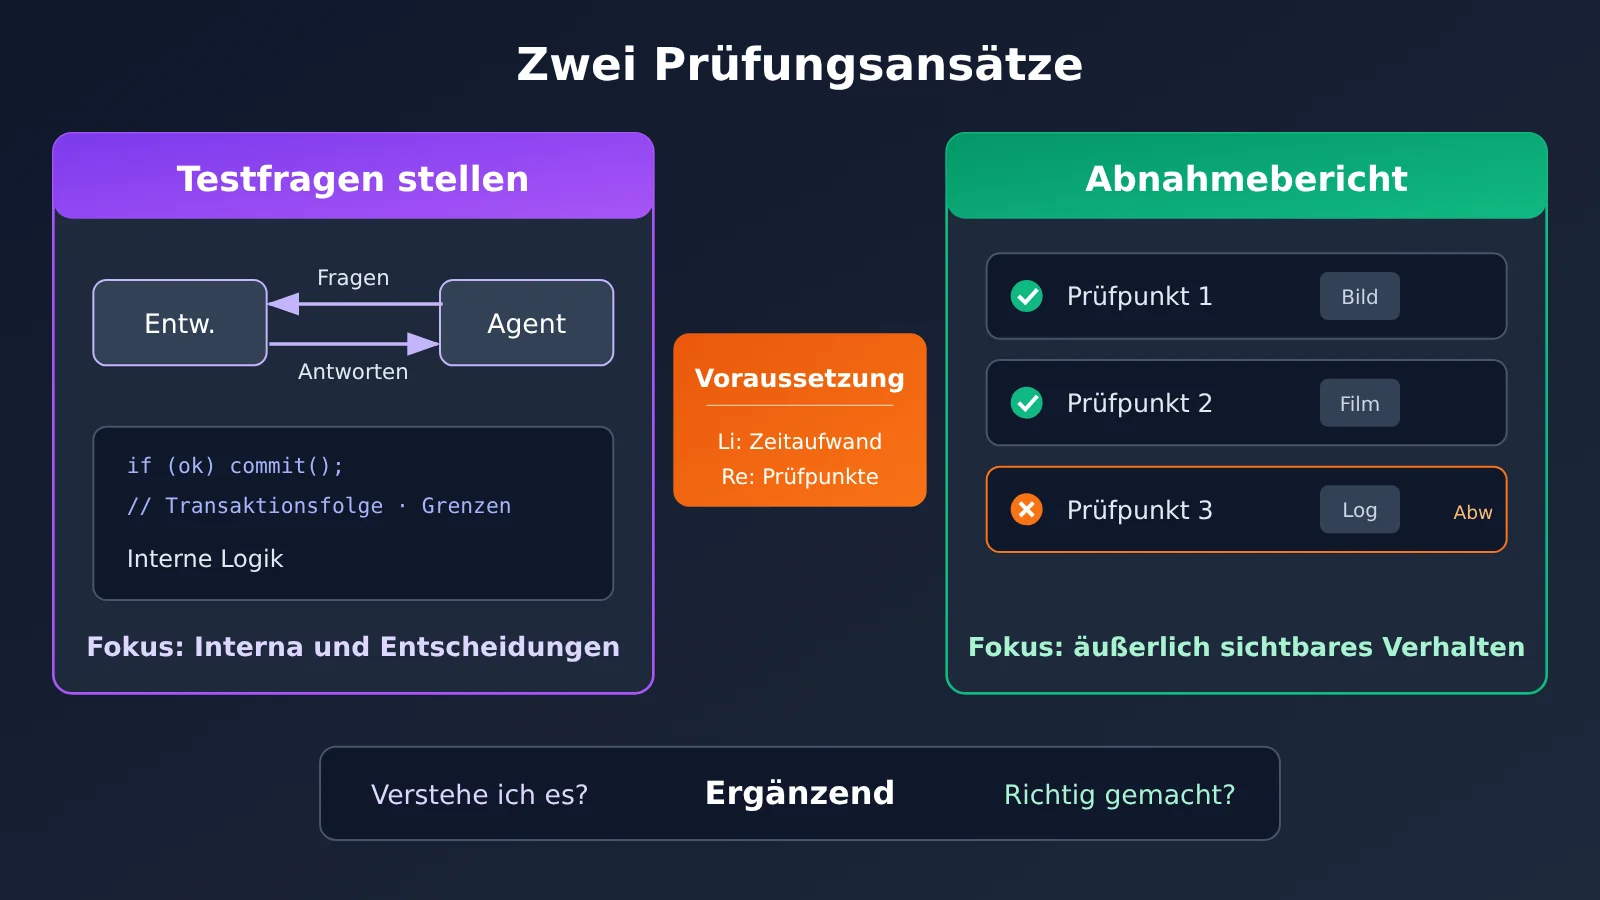
Ein ganz anderer Ansatz kommt von LobeHub, einer Open-Source-Plattform für die Zusammenarbeit mit Agents mit rund 84.000 GitHub-Sternen. Laut einem Bericht von Baijing Lab sieht sich das Team nach eigener Aussage „den Code fast gar nicht mehr an“. Stattdessen konzentriert es sich auf multimodale Abnahmeberichte der Agents. Dafür nutzt es das selbst entwickelte Tool Acceptance, das im September dieses Jahres als Open Source veröffentlicht wurde: Vor der Übergabe zerlegt der Agent die Anforderungen in direkt überprüfbare Prüfpunkte, führt diese einzeln im echten Produkt aus und fasst die Ergebnisse mit Screenshots, Bildschirmaufnahmen und Logs in einem Online-Bericht zusammen. Menschen können das Gesamtergebnis abnehmen oder einzelne Punkte zurückweisen.
| Dimension | KI-Prüfungsfragen | Prüfung per Abnahmebericht |
|---|---|---|
| Fokus | Interne Codelogik, nicht autorisierte Entscheidungen, Annahmen | Von außen beobachtbares Produktverhalten |
| Nachweise | Fragen und Antworten, Korrekturergebnisse | Screenshots, Bildschirmaufnahmen, Logs, Befehlsprotokolle |
| Erkennbare Probleme | Transaktionsreihenfolge, Randfälle, implizite Abwägungen | Ob Oberfläche, Interaktion und Funktionen den Anforderungen entsprechen |
| Leicht zu übersehende Probleme | Fragen, an die niemand gedacht hat | Nicht sichtbare interne Logik und Architekturrisiken |
| Voraussetzungen | Entwickler sind bereit, Zeit in das Verständnis zu investieren | Anforderungen lassen sich in beobachtbare Prüfpunkte zerlegen, und eine automatisierte Ausführungsumgebung ist vorhanden |
| Rolle des Menschen | Konkrete Änderungen verstehen und verantworten | Abnahmekriterien definieren und abschließend entscheiden |
Die beiden Prüfungsansätze im Vergleich
Prüfung per Abnahmebericht: Abnahmeberichte sind sehr effizient, wenn es darum geht, beobachtbares Verhalten zu überprüfen. Rückmeldungen können sich gezielt auf einzelne Prüfpunkte beziehen. Im Praxistest aus dem Bericht beanstandete der Prüfer nur den dunklen Hintergrund. Der Agent änderte daraufhin lediglich eine CSS-Zeile, alle anderen Dateien blieben unverändert. Der Ansatz setzt jedoch voraus, dass sich Anforderungen in beobachtbare Prüfpunkte zerlegen lassen. Der Bericht weist außerdem darauf hin, dass bei komplexeren Aufgaben Menschen weiterhin über Sicherheit, Architektur und endgültige Qualität urteilen müssen. Auch bei der Rückübermittlung von Feedback gibt es noch Schritte, die manuell bearbeitet werden müssen. Die Aussage, man sehe sich „den Code fast gar nicht mehr an“, stammt vom Team selbst und wurde nicht unabhängig überprüft.
KI-Prüfungsfragen: Fragen eignen sich besser, um Probleme aufzudecken, die „an der Oberfläche nicht sichtbar“ sind, etwa bei der Transaktionsreihenfolge oder bei Randfällen. Damit decken sie genau den blinden Fleck des Abnahmeberichts ab. Ihr Nutzen hängt allerdings von der Qualität der Fragen ab. Außerdem müssen Entwickler tatsächlich Zeit investieren, um die Änderungen zu verstehen. Die beiden Ansätze schließen sich nicht aus. Sinnvoll ist es, mit dem Abnahmebericht zu prüfen: „Wurde es richtig gemacht?“ Die Prüfungsfragen klären dagegen: „Verstehe ich, warum es so gemacht wurde?“
Prüftiefe für Verständnis-Schulden nach Änderungsrisiko wählen
Nicht jeder PR braucht den vollständigen Prozess. Addy weist auch darauf hin: Wenn so viel generierter Inhalt anfällt, dass du nicht mehr dafür geradestehen kannst, prüfst du ihn nicht mehr – du wettest darauf, dass alles in Ordnung ist. Die folgende Tabelle bietet eine Orientierung nach Risikostufen. Die konkreten Grenzen solltet ihr an euer Team anpassen.
| Risikostufe | Typische Änderungen | Empfohlene Prüftiefe |
|---|---|---|
| Niedrig | Texte, Styles, eigenständige Skripte, Prototypen | Abnahmebericht oder manuelle Stichprobe; Erwartungen dokumentieren |
| Mittel | Übliche Geschäftsfunktionen, neue Schnittstellen | Nicht autorisierte Entscheidungen hinterfragen + tatsächliche Testausgaben prüfen |
| Hoch | Transaktionen, Berechtigungen, Zahlungen, Datenmigrationen | Vollständiger 5-Schritte-Prozess + Wissensprüfung + unabhängige Agent-Prüfung |
| Überlastung | Parallele Ergebnisse mehrerer Agents, die sich nicht mehr prüfen lassen | Automatisierte Prüfungen ergänzen oder die Zahl paralleler Agents reduzieren |
💡 Empfehlung: Wenn euer Team bereits eine ausgereifte automatisierte Abnahme hat, könnt ihr die Wissensprüfung auf Änderungen mit hohem Risiko konzentrieren. Falls nicht, solltet ihr zumindest bei PRs zu Datenkonsistenz und Berechtigungen darauf bestehen: „Erst richtig antworten, dann mergen.“
Häufig gestellte Fragen (FAQ)
Q1: Was sind Verständnisschulden und wie unterscheiden sie sich von technischen Schulden?
Verständnisschulden entstehen, wenn die Komplexität von Code und Systemen wächst, das Verständnis der Entwickler aber nicht im gleichen Mass zunimmt. Technische Schulden betreffen meist die Qualität des Codes selbst. Verständnisschulden können dagegen auch bei gutem Code entstehen: Das Problem ist, dass Menschen ihn nicht ausreichend verstehen. Sichtbar wird das oft erst, wenn Änderungen nötig sind.
Q2: Was ist der Unterschied zwischen einem KI-Quiz und einer Erklärung des Codes durch die KI?
Bei einer Erklärung empfängst du Informationen passiv. Dabei entsteht leicht der Eindruck, du hättest alles verstanden. Bei einem Quiz musst du selbst antworten. Falsche Antworten lassen sich konkreten Codestellen zuordnen – so wird aus einem vagen Verständnis ein überprüfbares Ergebnis.
Q3: Bedeutet „Agenten nicht einfach abnicken“, dass ich KI-Code Zeile für Zeile prüfen muss?
Nein. Berichten zufolge verlangt das Claude-Code-Team von seinen Entwicklern nicht, die gesamte Codebasis auswendig zu kennen. Wenn sie einen Teil ändern müssen, nutzen sie Claude, um die relevante Logik erneut zu verstehen. Entscheidend ist, dass du weisst, was du verstehst und was nicht, und die Prüftiefe nach dem Risiko bestimmst.
Q4: Für welche Entwicklungsszenarien eignet sich diese Methode?
Sie eignet sich vor allem für folgende Szenarien:
– **Lange laufende Agent-Aufgaben**: Hier kann es leicht zu nicht autorisierten Entscheidungen kommen. Eine Liste mit Rückfragen hilft bei der Prüfung.
– **Backend-Änderungen mit Transaktionen oder Grenzfällen**: Hier eignet sich ein Quiz zur Verständnisprüfung.
– **Parallele Entwicklung mit mehreren Agenten**: Hier ist es sinnvoll, das Ausgangsmaterial aufzubewahren und die Anzahl paralleler Aufgaben zu begrenzen.
– **Code Reviews im Team**: Die Fragenliste kann in die PR-Vorlage aufgenommen werden.
Q5: Wie setze ich diesen Selbstcheck für Verständnisschulden in Claude Code, Cursor und Cline um?
Die Methode ist unabhängig vom konkreten Tool. Entscheidend sind die Eingabeaufforderungen und der Ablauf:
1. Speichere die vollständigen Vorlagen für Eingabeaufforderungen aus diesem Artikel als wiederverwendbare Team-Bausteine.
2. Schreibe Phase A vor Arbeitsbeginn von Hand und füge nach Abschluss der Aufgabe die Phasen B und C ein.
3. Führe bei Änderungen mit hohem Risiko Phase D in einer neuen, separaten Sitzung aus.
Du kannst auch „Merge nur bei richtigen Antworten“ in die PR-Prüfregeln des Teams aufnehmen.
Q6: Welche Einschränkungen sind bei diesen Methoden bekannt?
Die Methoden sollte man realistisch betrachten:
– **Daten zur Wirksamkeit**: Derzeit gibt es keine öffentlich verfügbaren Daten, die zeigen, um wie viel diese Methoden die Fehlerrate senken oder die Effizienz steigern.
– **Zeitaufwand**: Der vollständige Ablauf verlängert die Zeit bis zum Merge und eignet sich nicht für jeden PR.
– **Blinde Flecken bei den Fragen**: Der Agent stellt möglicherweise keine Fragen zu Problemen, die ihm selbst nicht bewusst sind. Deshalb darf der Schritt „eine übersehene Sache finden“ nicht entfallen.
– **Quellenhinweis**: Addys Ansichten stammen aus einer Medienberichterstattung. Den genauen Wortlaut der Originalquelle solltest du selbst überprüfen.
Q7: Ist eine wöchentliche Offline-Programmierübung wirklich nötig?
Addys Argument: Fähigkeiten, die lange nicht genutzt werden, können nach und nach verkümmern. Gelegentlich eine Aufgabe ohne Agenten selbstständig zu lösen, hilft dir dabei, dein tatsächliches Können einzuschätzen. Wenn du ausserdem einmal im Monat überprüfst, welche Fähigkeiten du bereits an die KI abgegeben hast und welche du selbst weiter beherrschen musst, kostet das wenig Zeit und kann verhindern, dass du das eigene Denken schleichend aufgibst.
Agent-Änderungen nicht einfach abnicken: Das Wichtigste zu Verständnis- und Absichtsschulden
- Kognitive Kapitulation geschieht schleichend: Erst lagern wir Denkarbeit aus, dann überlassen wir anderen einzelne Urteile und schließlich die gesamte Entscheidung.
- Verständnisschulden kosten später Zinsen: Je schneller Code entsteht, desto mehr können sich unverstandene Teile anhäufen – und bei späteren Änderungen geballt Probleme verursachen.
- Absichtsschulden entstehen schon vor der Umsetzung: Schreiben Sie vor dem Start selbst eine Anforderungsliste. Sind Sie nach zwei Eingabeaufforderungen nicht zufrieden, sortieren Sie die Anforderungen neu.
- Sich abfragen lassen ist der zentrale Schritt: Lassen Sie den Agenten die Änderungen zusammenfassen und Fragen dazu stellen. Führen Sie die Änderungen erst zusammen, wenn Sie alle beantworten können.
- Grüne Tests bedeuten nicht, dass alles in Ordnung ist: Prüfen Sie zuerst die Ausgabe der tatsächlich ausgeführten Tests und fragen Sie dann, was nicht getestet wurde.
- Abnahmebericht und Fragen ergänzen sich: Der Bericht prüft das äußere Verhalten, die Fragen testen Ihr Verständnis der internen Logik.
- Prüfen Sie nach Risiko: Wenn die Prüfungskapazität nicht reicht, ergänzen Sie Automatisierung oder reduzieren Sie die parallele Arbeit – verlassen Sie sich nicht auf Glück.
Zusammenfassung
Die wichtigsten Punkte, um Agent-Änderungen nicht einfach abzunicken:
- Phase erkennen: Achten Sie darauf, wann aus „Die KI erledigt die Arbeit“ ein „Die KI trifft die Entscheidungen“ wird. Verständnis- und Absichtsschulden entstehen als Nebenprodukte dieses Übergangs.
- Konkrete Schritte: Halten Sie vor Beginn Ihre Erwartungen fest, fragen Sie bei der Übergabe nach nicht autorisierten Entscheidungen und ungetesteten Inhalten und lassen Sie sich vor dem Zusammenführen von der KI abfragen.
- Nach Risiko abwägen: Bei Änderungen mit geringem Risiko reichen ein Abnahmebericht oder Stichproben. Änderungen mit hohem Risiko durchlaufen den vollständigen Prozess und erhalten zusätzlich eine unabhängige Prüfung.
KI wird Code künftig noch schneller schreiben. Für eine Änderung verantwortlich bleibt aber immer die Person, die sie freigibt. Lassen Sie den Agenten vor dem nächsten Klick auf „Freigeben“ doch fünf Fragen stellen – und sehen Sie, wie viele Sie beantworten können.
📚 Quellen
- 量子位: Großes Tutorial zu Claude als Engineering-Agent (von 36 氪 übernommen): Stellt Addy Osmanis Ansichten und praktische Methoden zu kognitiver Kapitulation, Verständnis- und Intentionsschulden vor
- Link:
36kr.com/p/4056027738116995 -
Hinweis: Quelle für den methodischen Ansatz dieses Artikels; es handelt sich um eine mediale Zusammenfassung
-
Originalbeitrag von Addy Osmani: Die im Bericht zitierte Originalquelle
- Link:
x.com/addyosmani/status/2117512471930167377 -
Hinweis: Für den genauen Wortlaut gilt das Original; der Link muss selbst überprüft werden
-
白鲸实验室: Ein KI-Unternehmen mit 80.000 Stars beschließt, sich von KI übernehmen zu lassen (von 36 氪 übernommen): Stellt LobeHubs Supervisor-Agent-Architektur und die Praxis der Acceptance-Abnahmeberichte vor
- Link:
36kr.com/p/4056040123945860 - Hinweis: Vergleichsquelle für die Prüfung anhand von Abnahmeberichten; die Aussage, man „schaue sich den Code fast nicht an“, stammt vom Team selbst
Autor: Technikteam von APIYI