作者注:今日はAPIを呼び出すので、引き続き grok-4.7 を使います。Grok 4.8 は 2026-11-13 時点でまだモデルIDが存在しないため、本記事では出典と照らし合わせながら Grok 4.7 の3つの弱点を確認し、4.8 にそれを補う証拠がすでにあるのかを見ていきます。
本番環境で grok-4.7 を呼び出しているなら、最近は「いったん止めて Grok 4.8 を待つべきか」と迷うところでしょう。先に結論を言うと、今日APIを呼び出すなら grok-4.7 を使ってください。 2026-11-13 時点で、Grok 4.8 にはモデルIDもモデルカードもベンチマークスコアも価格もありません。マスク氏が言う「今週中」は Grok Bot ユーザー向けの小規模なソフトロールアウト(試験提供)であって、APIの公開ではありません。
これは「新バージョンは必ず強くなる」という予告記事ではありません。 本記事では、Grok 4.7 の公開データで裏付けが取れる3つの弱点だけを突き合わせます。それぞれに出典を明記します。公式の自己申告なのか、サードパーティのベンチマークなのか、それともマスク氏の発言そのものなのか。そのうえで、Grok 4.8 に現時点でそれを補う証拠があるかを見ていきます。
本記事の価値:読み終えると、Grok 4.7 の弱点が具体的にどこにあるのか、それが誰のデータに基づくのか、そして Grok 4.8 が登場する前に 20万トークンの区分でコストをどう管理するかが分かります。
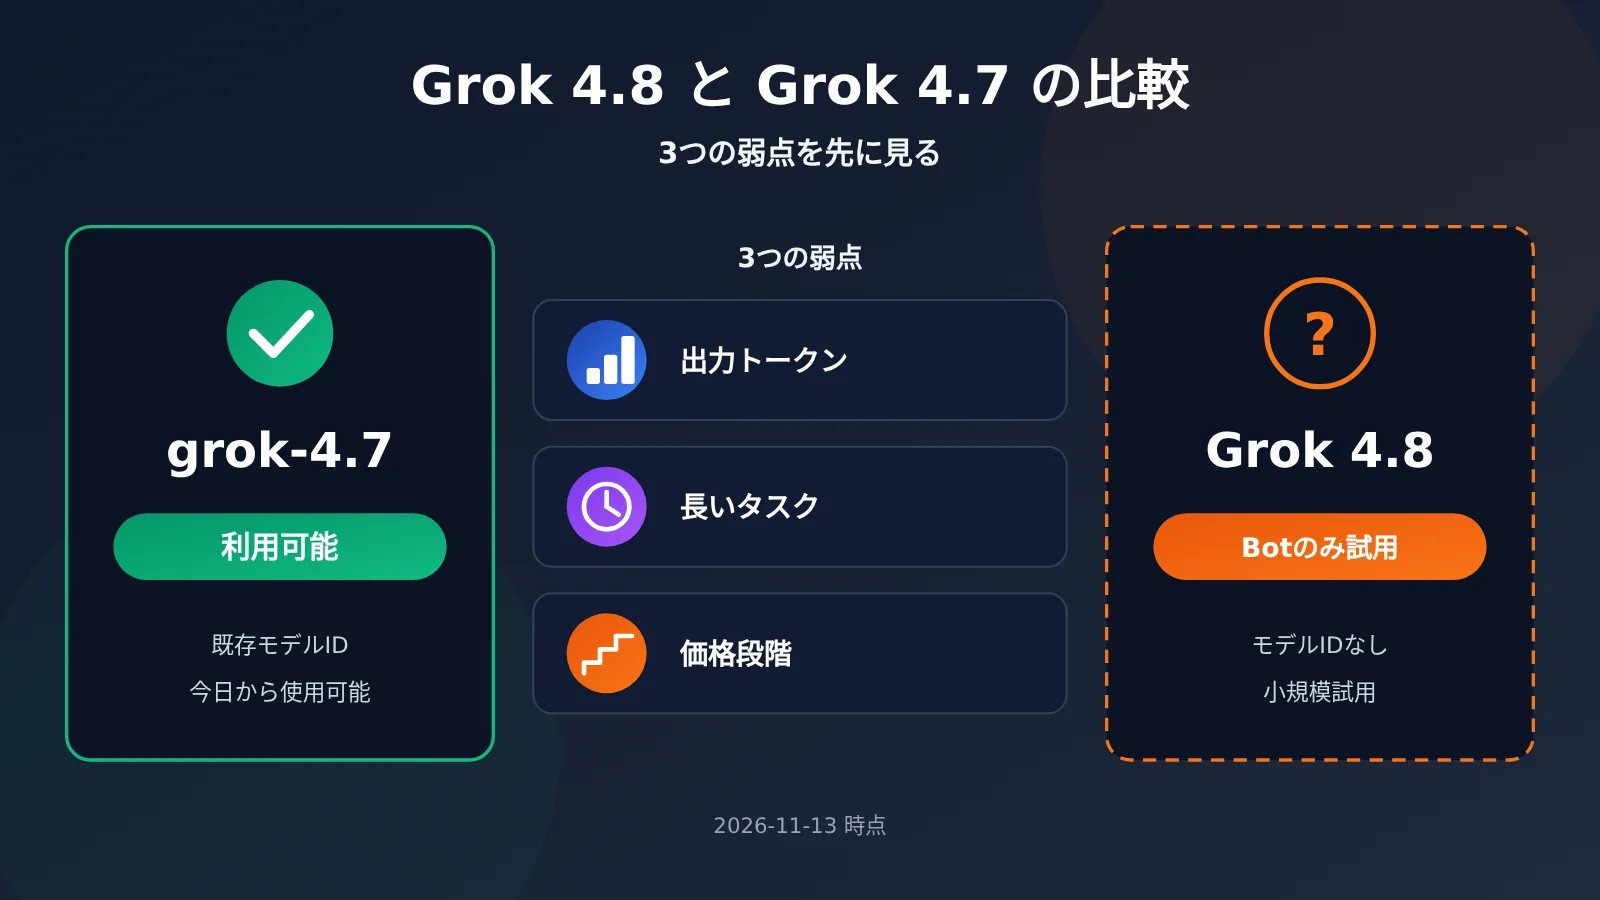
Grok 4.8 と Grok 4.7 の比較:今どちらを選ぶべきか
今回の比較は、よくある新旧バージョンの比較とは少し事情が異なります。Grok 4.8 については現時点でマスクが X に投稿した数行のコメントしかなく、検証可能なスコアは一切ありません。したがってここでの「比較」とは、実際には次のことを意味します。すなわち、Grok 4.7 のどの弱点が公開データとして記録されているのか、そして Grok 4.8 で判明している変更点がその弱点に対応できているのか、を照らし合わせることです。
| あなたの状況 | 推奨 | 理由 |
|---|---|---|
| 今週中にリリースまたは API を変更する予定 | grok-4.7 を使う | プラットフォームのモデル一覧には grok-4.7 しかない |
| 長期的な選定を検討中 | まず grok-4.7 でベースラインを計測 | 4.8 にはベンチマークがなく、横比較ができない |
| 4.8 をいち早く試したい | プラットフォームのモデル一覧をチェック | Bot のソフトローンチは API が使えることを意味しない |
| 長時間タスクへの要求が非常に高い | 4.8 に期待を寄せない | 長時間タスクの差が縮まったことを示す証拠がない |
ここで補足しておきたいのは、「Bot users」とは Grok Bot のユーザーを指し、ハードウェアロボットのことではないという点です。また「soft rollout」とは小規模に段階的に展開することを意味し、開発者向けに公開された API のことではありません。これを「すでに切り替え可能なモデル ID」と誤解すると、呼び出し時にそのままエラーになります。
Grok 4.8 と Grok 4.7 の核心的差異:3つの弱点の出所
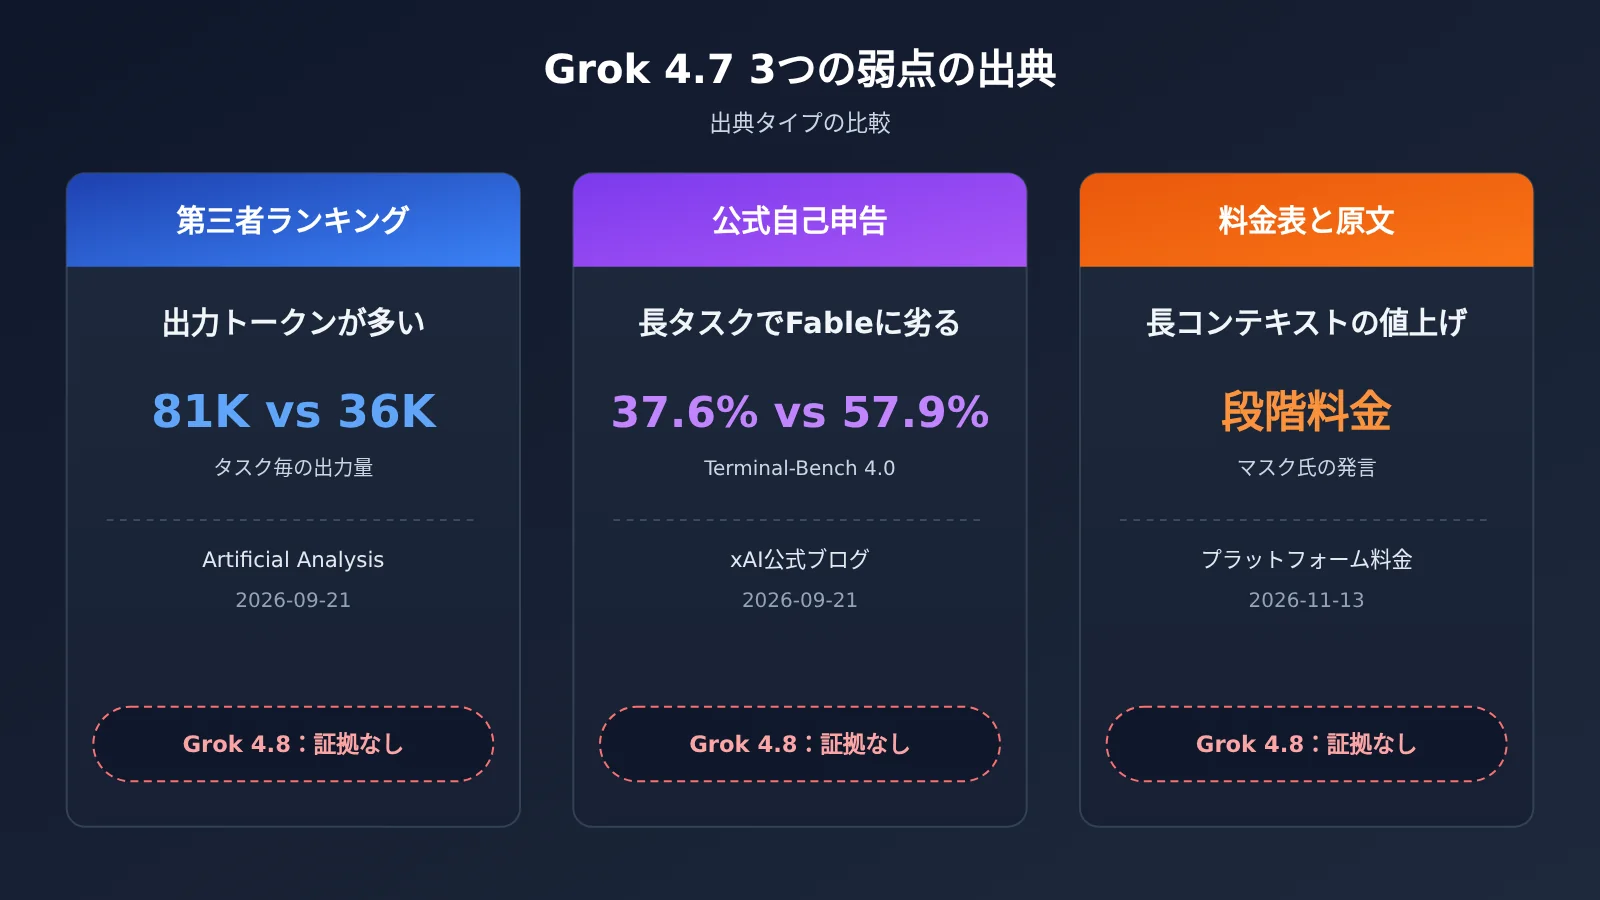
まず、3つの弱点それぞれの出所タイプを表にまとめます。以下の展開は、この順序に厳密に従います。
| 弱点 | 出所タイプ | 出所日 | Grok 4.8 に補う証拠があるか |
|---|---|---|---|
| 出力トークンが多め | 第三者ベンチマーク(Artificial Analysis) | 2026-09-21 | なし |
| 数時間級の長時間タスクで Fable に後れ | 公式自己申告(xAI ブログの表) | 2026-09-21 | なし |
| 長コンテキストの段階別値上げ+マスク氏が素性を認めず | プラットフォーム価格表+マスク氏の原発言 | 2026-11-13 / 2026-11-10 | なし |
弱点1:Grok 4.7 は出力トークンが多め(第三者ベンチマーク)
ここの出所は、Artificial Analysis が 2026-09-21 に公開した Grok 4.7 の評価で、第三者ベンチマークに属します。公式データでも、本記事の筆者によるテストでもありません。彼らは xhigh 档位でテストし、Grok 4.7 のインテリジェンス指数は 46 で、Grok 4.6 より 2 ポイント高い結果でした。スコアは上がりましたが、その代償として出力トークンが明らかに増えています。
同じ評価記事にある出力量の対照は次のとおりです。なお、2つの Grok 4.6 の数値は異なる档位に対応しており、1つにまとめることはできません。
- Grok 4.7(xhigh):インテリジェンス指数タスクあたり約
81,000出力トークン - Grok 4.6(high):約
36,000出力トークン - Grok 4.6(xhigh):約
38,000出力トークン。評価では 4.7 はその2倍超とされている - GPT-6 Astra(max):約
27,000出力トークン
規模感をつかむために、公式の出力価格 $6 / 1M tokens でざっと計算してみましょう。8.1万出力で約 $0.49、3.6万で約 $0.22 です。これはあくまでベンチマークタスクでの換算方法であり、「同じ問題で、お金がどこに消えるか」を説明するためのもので、どのプラットフォームの実際の請求額でもありません。
Artificial Analysis は同時に、Grok 4.7 のコンテキストは 500K、表示価格は $2 / $6、キャッシュヒットは $0.50 で、いずれも 4.6 と同じだと明記しています。つまり、単価は上がっていないものの、タスクごとに吐き出すトークンが増えたため、1タスクあたりのコストは実質的に上昇しているのです。
弱点その2:Grok 4.7 は数時間に及ぶ長尺タスクで依然 Fable に後れを取る(公式の自己申告)
この点の出典は xAI 公式ブログ(2026-09-21)にある比較表で、いわゆる公式の自己申告です。表の4列の見出しは順に Grok 4.7 xHigh、Grok 4.6 High、GPT-5.6 Sol Max、Fable 5.1 Max です。長尺タスクの差を最もよく示しているのは、次の2項目です。
- Terminal-Bench 4.0:Grok 4.7 は
37.6%、Fable 5.1 Max は57.9%(Grok 4.6 は20.3%、GPT-5.6 Sol は37.3%) - CursorBench 4.0:Grok 4.7 は
46.3%、Fable 5.1 Max は51.8%(Grok 4.6 は40.4%、GPT-5.6 Sol は41.7%)
ただし公式表は「全面的に劣っている」わけではありません。Grok 4.7 の 4.6 に対する向上は確かなもので、しかも2つの専門ベンチマークでは首位に立っています。
- EEBench:Grok 4.7 は
64.0%で、4.6 の53.0%、GPT-5.6 Sol の39.4%、Fable 5.1 の56.4%を上回ります - Harvey Legal Agent Benchmark:Grok 4.7 は
19.6%で、15.8%/2.5%/6.7%を上回ります - DeepSWE v1.1:Grok 4.7 は
71.0%。公式には xhigh ではなく high effort と注記されており、GPT-5.6 Sol の72.7%をやや下回ります - AA Briefcase v1.1:Grok 4.7 は
1657で、Fable の1678をわずかに下回ります - HealthBench Professional:Grok 4.7 は
56.7%で、GPT-5.6 Sol の60.5%と Fable の62.1%を下回ります
| 公式表のベンチマーク | Grok 4.6 との比較 | GPT-5.6 Sol との比較 | Fable 5.1 との比較 |
|---|---|---|---|
| Terminal-Bench 4.0 | 明らかに高い | ほぼ同等でわずかに高い | 差が大きい |
| CursorBench 4.0 | より高い | より高い | より低い |
| DeepSWE v1.1 | より高い | やや低い | やや高い |
| EEBench | より高い | より高い | より高い |
| Harvey Legal Agent | より高い | より高い | より高い |
| HealthBench Professional | より高い | より低い | より低い |
サードパーティのランキングには別のデータ群があり、これは切り分けて注記する必要があります。Artificial Analysis の評価では、Grok 4.6 と比べて Grok 4.7 は Terminal-Bench 4.0 で 4.5 ポイント高く、GDP.pdf では 3.0 ポイント高くなっています。一方で AA-LCR は 3.7 ポイント低く、AutomationBench-AA は 1.1 ポイント低くなっています。ここでの「+4.5 ポイント」は公式表の 37.6% 対 20.3% と同じ絶対スコアの体系ではなく、混同して使うことはできません。
弱点3:Grok 4.7 の価格区分とマスク本人の発言(価格表+原文)
3つ目の弱点には2つの部分があります。1つは長いコンテキストの価格、もう1つはマスク本人の 4.7 に対する姿勢です。まず価格から見ていきましょう。プラットフォームの総合表と価格APIでは、20万トークン以上の記載が完全には一致していません。
| 価格項目 | プラットフォームのモデル総合表 | 価格API の billing_expr |
|---|---|---|
| ≤ 20万トークン 入力 / 出力 / キャッシュ読み込み | 記載あり | 記載あり、総合表と一致 |
| 20万超 入力 | 記載あり | 記載あり、総合表と一致 |
| 20万超 出力 | 単独記載なし | 記載あり |
| 20万超 キャッシュ読み込み | 単独記載なし | 記載あり |
具体的な数字は以下のとおりです。価格データの日付は 2026-11-13、単位はすべて 1M tokens あたりです。
- 低档(0–200,000 tokens):入力
$2、出力$6、キャッシュ読み込み$0.5。総合表と価格式が一致 - 高档(200,001–500,000 tokens)入力:
$4。総合表と価格式が一致 - 高档 出力:価格式は
$12、総合表の段階表には記載なし - 高档 キャッシュ読み込み:価格式は
$1、総合表の段階表には記載なし
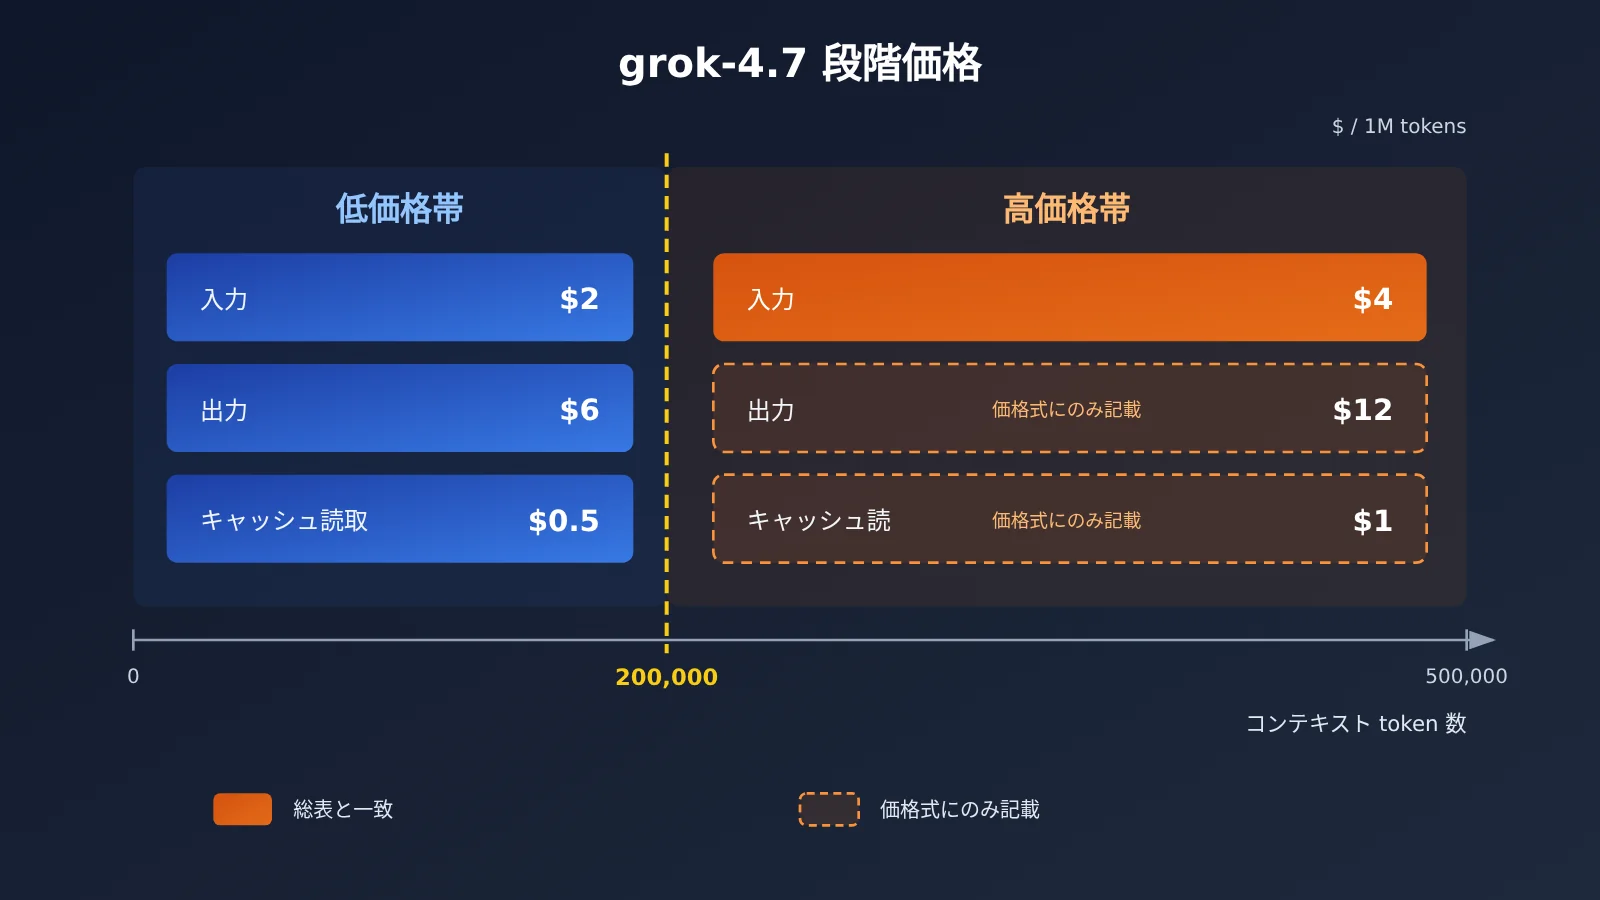
上図の価格情報は APIYI(apiyi.com)の価格APIとモデル総合表に基づくもので、照合日は 2026-11-13 です。プラットフォームのモデル一覧を基準としています。
次に原文を見てみましょう。2026-11-10 17:35、マスクは X で Grok 4.8 について「will bear no resemblance to 4.7 (thankfully). It is not yet incredible」と述べました。同じ日の 18:22、彼は返信でさらに「Not as good. Opus 5.5 is a masterpiece.」と述べ、つまり 4.8 は Opus 5.5 には及ばないという意味です。同時に、Grok 5 は2〜3か月以内に Opus 5.5 を超える見込みだと予想しています。
これらは姿勢であって、Grok 4.8 のスコアではありません。ある創業者が新版について「4.7 とは似ていない、よかった」と言うのは、彼が 4.7 の土台を認めていないことを示すだけで、4.8 が上記3つの弱点で改善されたと結論づけることはできません。
Grok 4.8 はこの3つの弱点を補えるのか
語れるのは、マスク氏の元投稿に書かれている内容だけです。同氏は JAX/SGLang を捨て、C/C++ で強化学習(RL)と推論スタックをゼロから書き直したと述べています。事前学習は完了済みで、SFT データは大幅にクレンジングしたとのこと。4.8 は現在 RL 段階にあり、「evals are starting to climb」という状況です。投稿にはベンチマーク名やスコア、パラメータ数は一切示されていません。
この情報を3つの弱点と照らし合わせると、結論はかなり慎重なものになります:
- 出力トークンがやや多い:RL 段階は確かに出力長に影響し得ますが、同氏はトークン効率について触れていません。
- 長タスクで Fable に劣る:Terminal-Bench や CursorBench には触れておらず、長タスクのデータも一切ありません。
- 20万トークン超の価格:価格情報は一切なく、4.8 はどの料金表にも掲載されていません。
したがって、推測は「RL と推論スタックを書き直し、SFT データをクレンジングした」という範囲に留まります。現時点で、上記の3点がすでに補われたことを示す証拠はありません。4.8 のモデルカードとサードパーティのベンチマークが出てから、項目ごとに照らし合わせることに意味があります。
今 grok-4.7 を使う場合、20万トークンの価格帯はどう分けるか
4.8 の提供開始前は、grok-4.7 のコストをしっかり抑えるのが現実的です。カギは 20万トークンのラインです。入力がこの線を超えると単価がそのまま2倍になり、料金表の計算式に従って出力とキャッシュ読み取りも2倍になります。以下、実装に使える接続情報と価格帯の提案です:
- モデル ID:
grok-4.7。エンドポイントは chat で、グループにはCodexResponses、Default、SVIPが含まれます。 - インターフェースアドレス:OpenAI 互換形式。base_url に
https://api.apiyi.com/v1を指定し、model をgrok-4.7に設定するだけでOKです。 - 低価格帯の制御:1回のリクエストのコンテキストはできるだけ
200,000トークン以内に収めます。文書全体を詰め込む代わりに、要約や検索チャンクで代替できます。 - 高価格帯の予算:長いコンテキストが本当に必要な場合は、入力
$4、出力$12、キャッシュ読み取り$1で見積もります。ただし、総合表に高価格帯の出力が記載されていないという不整合に注意してください。 - 出力長:弱点1を踏まえ、必要なタスクには max_tokens を設定し、推論の高い設定で出力が暴走しないようにします。
モデルと価格はプラットフォームのモデル一覧を基準にしてください。最新情報は docs.apiyi.com/models で確認できます。公式ブログでは、Grok 4.7 に fast バリアントがあり、出力速度が約2倍、価格も約2倍になると述べていますが、プラットフォームの総合表には fast 用の独立したモデル ID はありません。呼び出し時に独自に綴らないでください。
🚀 クイックスタート:grok-4.8 の提供開始後、APIYI apiyi.com ができるだけ早くこのモデルを公開します。それまでは同じ API キーで grok-4.7 のベースラインをまず動作させ、4.8 が使えるようになったら model パラメータを1つ変えるだけで比較できます。
Grok 4.8 と Grok 4.7 の比較:シーン別の推奨
Grok 4.7 を引き続き使うのが適したシーン
- 法律・エンジニアリング系の専門タスク:公式の表では EEBench と Harvey Legal Agent の2項目で Grok 4.7 が1位となっており、こうしたタスクで待つ理由はありません。
- コンテキストを20万以内に抑えられる業務:低価格帯の課金に安定して留まることができ、単価は 4.6 と同じです。
- すぐにリリースする必要があるプロジェクト:grok-4.7 は現在唯一呼び出し可能なバージョンです。
Grok 4.8 を継続して注視する価値があるシーン
- 数時間に及ぶ Agent / ターミナルの長タスク:Terminal-Bench 4.0 と Fable 5.1 の差は明らかで、他のモデルを代替候補として同時に評価できます。
- 出力トークンのコストに敏感なバッチタスク:サードパーティのランキングでは 4.7 の出力がやや長めで、4.8 で改善されればコスト削減に直結しますが、現時点では証拠がありません。
- 20万以上のコンテキストに大きく依存するアプリケーション:上位価格帯は2倍になるため、4.8 リリース後の課金方式に注目する価値があります。
Grok 4.8 と Grok 4.7 の比較:判断のヒント
| 注目ポイント | 現在のアクション | 再評価するタイミング |
|---|---|---|
| リリースの安定性 | grok-4.7 を使用 | 4.8 がプラットフォームのモデル一覧に現れたとき |
| タスク単価のコスト | コンテキストと出力長を制御 | 4.8 のサードパーティによるトークン使用量データが出たとき |
| 長タスク能力 | 代替モデルを並行して評価 | 4.8 が Terminal-Bench などのスコアを公開したとき |
| 価格の透明性 | 価格表 API を基準に予算を組む | プラットフォームの総合表に上位価格帯の出力価格が追加されたとき |
💡 選択のアドバイス:どちらのバージョンを選ぶかは、あなたのタスクが長タスクに該当するか、20万トークンを頻繁に超えるかによって決まります。APIYI apiyi.com 経由で同じインターフェースのセットを使い、あなた自身のサンプルで実行してから、長タスクを他のモデルに切り替えるかどうかを決めることをおすすめします。
よくある質問(FAQ)
Q1:Grok 4.8 は現在 API で呼び出せますか?
いいえ。2026年11月13日時点で、Grok 4.8 にはモデル ID がありません。プラットフォームのモデル一覧表や価格 API のどこにも grok-4.7 しか載っていません。マスク氏が言及した「今週のソフトローンチ」は Grok Bot ユーザー向けのみです。
Q2:Grok 4.8 と Grok 4.7 は結局どちらが強いのですか?
現時点では判断できません。Grok 4.8 には公開されたランキングもスコアも一切ありません。マスク氏は「評価は上昇中」「まだ驚くほどではない」「Opus 5.5 には及ばない」と述べただけです。これは評価の姿勢であって、比較可能なデータではありません。
Q3:「Grok 4.7 は出力トークンが多い」という説の出典はどこですか?
Artificial Analysis が 2026年9月21日に公表した第三者評価(テスト設定は xhigh)によるものです。1タスクあたり約8.1万出力トークンで、比較対象の 4.6 high が3.6万、4.6 xhigh が3.8万でした。これは公式データではありません。
Q4:Grok 4.7 は Grok 4.6 より全面的に劣化しているのですか?
いいえ。公式表では、Grok 4.7 は Terminal-Bench、CursorBench、EEBench など複数の項目で 4.6 を上回っています。第三者ランキングでは AA-LCR が3.7ポイント低く、AutomationBench-AA が1.1ポイント低いという結果で、一部項目の後退にとどまります。
Q5:今すぐ grok-4.7 を呼び出すにはどうすればいいですか?
APIYI(apiyi.com)に登録して APIキーを取得してください。新規ユーザーには無料のテスト枠があります。OpenAI 互換 SDK を使い、base_url にプラットフォームの API アドレスを、model に grok-4.7 を設定するだけで利用できます。
Q6:20万トークンを超える出力は結局いくらで課金されるのですか?
価格表の計算式には出力 $12、キャッシュ読み込み $1 と記載されています。一方、総合表の段階設定には高価格帯の入力 $4 しか書かれておらず、高価格帯の出力は別途記載されていません。二か所の記載は完全には一致していないため、予算を組む際は価格表の計算式に沿って保守的に見積もり、最終的にはプラットフォームのモデル一覧を確認することをおすすめします。
Q7:Grok 4.8 が公開されたら、どう移行すればいいですか?
プラットフォームのリアルタイム情報には、まだ Grok 4.8 の公開記録がありません。公開後は通常 model パラメータを置き換えるだけで済みますが、まず同じサンプル群で出力トークン、長時間タスクの成功率、段階別コストを比較したうえで、トラフィックを切り替えることをおすすめします。
Grok 4.8 と Grok 4.7 の比較:主なポイント
- 現時点の選択:API を呼び出すなら grok-4.7。Grok 4.8 にはまだモデル ID がありません。
- 弱点 1(外部リーダーボード):xhigh ではタスクあたり約 8.1 万出力トークンと長めです。
- 弱点 2(公式の自己申告):Terminal-Bench と CursorBench では依然として Fable 5.1 に後れています。
- 全面劣後ではありません:EEBench と Harvey の 2 項目では Grok 4.7 が 1 位です。
- 弱点 3(価格表+本人発言):20 万トークンを超える入力は倍額。マスク氏は 4.7 の土台を認めていません。
- 4.8 で判明している変更:RL と推論スタックの書き直し、SFT の整理。3 つの弱点を補った証拠はありません。
- 始め方:APIYI apiyi.com 経由でまず grok-4.7 のベースラインを実行し、4.8 が公開されたら直接比較します。
まとめ
Grok 4.8 と Grok 4.7 の比較における主なポイント:
- 可用性:2026-11-13 時点では grok-4.7 のみ呼び出し可能。Bot のソフトローンチは API 公開を意味しません。
- 3 つの弱点:出力トークンが多め(外部リーダーボード)、長タスクで Fable に後れ(公式の自己申告)、長いコンテキストの値上げと創業者の発言(価格表と本人発言)。それぞれ情報源が異なります。
- 4.8 の根拠:現時点では RL と推論スタックの書き直し、SFT 整理という説明のみで、スコア、価格、モデルカードはありません。
立ち止まって待つより、まず grok-4.7 のコンテキストの段階設定と出力長を適切に管理し、4.8 に検証可能なデータが出てから項目ごとに照合するのがよいでしょう。APIYI apiyi.com の統一インターフェースを使って、まず grok-4.7 があなたの業務でどう機能するかを検証し、今後の切り替えに備えてベースラインを残すことをおすすめします。
📚 参考资料
- xAI 公式ブログ – Grok 4.7 リリース:公式が公表したベンチマーク比較表と価格設定
- リンク:
x.ai/news/grok-4-7 -
説明:Terminal-Bench 4.0、CursorBench 4.0、EEBench などのデータソース
-
Artificial Analysis – Grok 4.7 評価:サードパーティのランキング、出力トークン使用量を含む
- リンク:
artificialanalysis.ai/articles/benchmarking-grok-4-7 -
説明:インテリジェンス指数、出力トークンの比較、AA-LCR などの項目の変化
-
マスク氏の X 投稿(2026-11-10):Grok 4.8 の進捗に関する発言
- リンク:
x.com/elonmusk/status/2120088070443655190 -
説明:RL と推論スタックの書き換え、SFT の整理、Bot のソフトローンチ
-
マスク氏の X 返信(2026-11-10):4.8 と Opus 5.5 の比較に関する見解
- リンク:
x.com/elonmusk/status/2120099798078656909 -
説明:「Not as good」の発言元
-
APIYI モデル一覧:grok-4.7 のモデル、グループ、段階別価格
- リンク:
docs.apiyi.com/models - 説明:モデルと価格はこちらを基準とし、確認日 2026-11-13
作者:APIYI 技術チーム
技術的なやり取り:APIYI サイトのトップページからお気軽にお問い合わせください。詳細資料は docs.apiyi.com のドキュメントセンターをご覧ください