結論
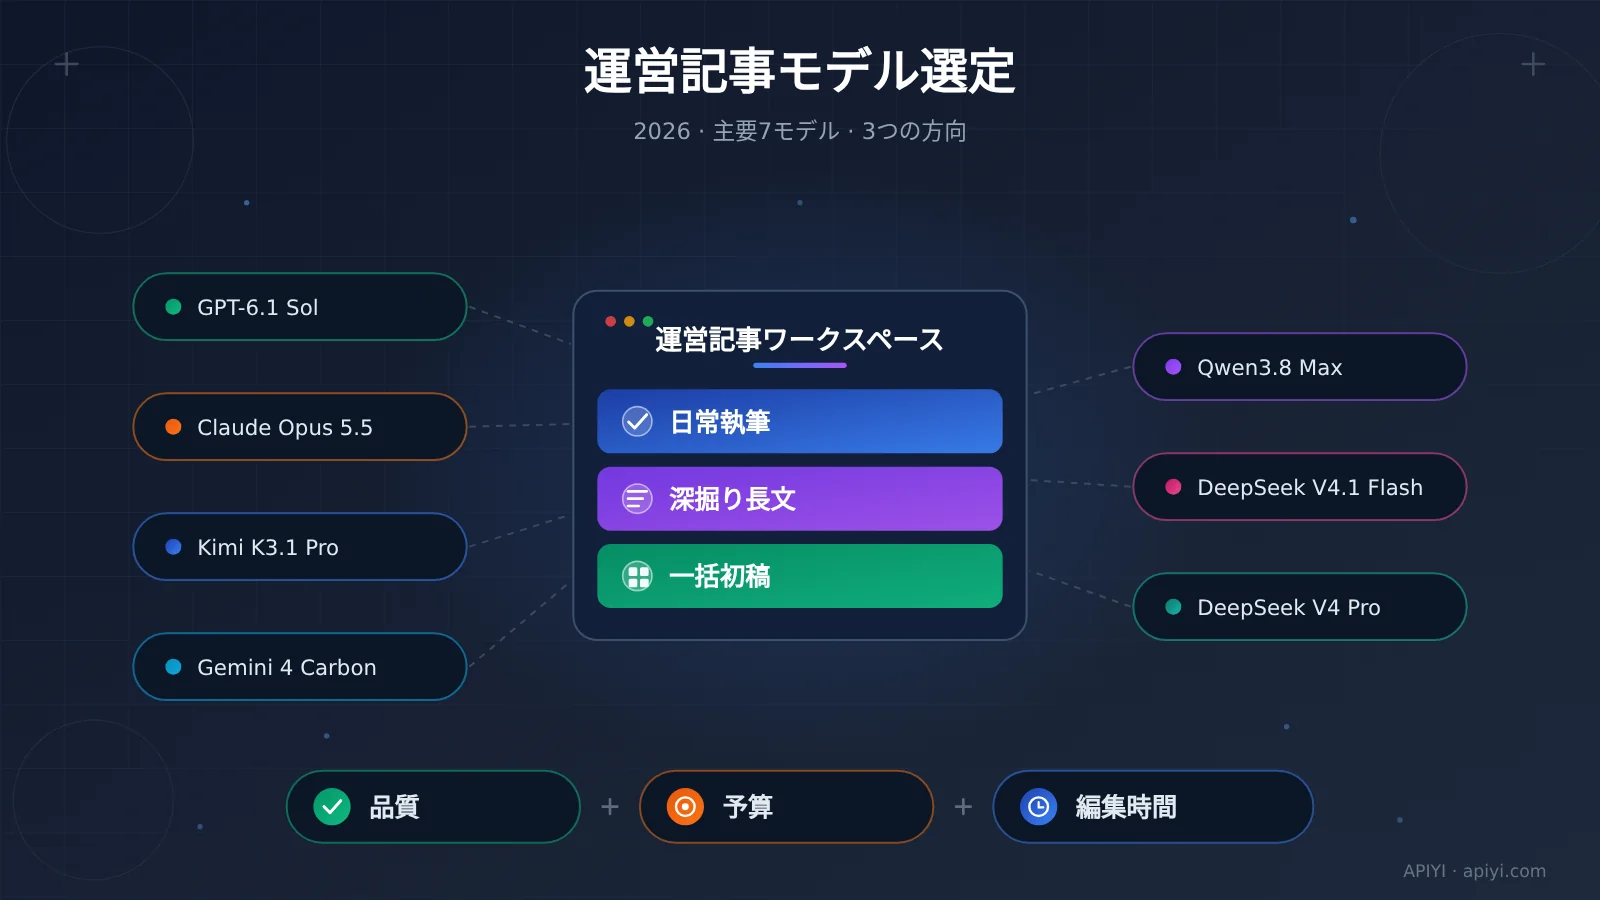
日常的な記事はまず GPT-6.1 Sol、重要な長文はまず Claude Opus 5.5、大量の初稿はまず DeepSeek V4.1 Flash を試してください。 資料が密集するタスクには Kimi と Gemini を加え、構造化された制作には Qwen を加え、DeepSeek Pro については具体的なタスクごとに検証します。
これらはあくまでテスト候補であり、中国語ライティングの優勝者リストではありません。本当にコスト効率のよい組み合わせを選ぶには、資料理解・記事の品質・呼び出しコスト・そして編集や修正にかかる時間を同時に評価する必要があります。
この記事で扱う内容
- 3種類のライティングテストが、それぞれ何を明らかにするのか。
- 7つのモデルには、どんな実際の違いがあるのか。
- 運用タスクごとに、メインモデルと代替モデルをどう配置するか。
- コストをどう計算し、統一インターフェースでブラインドテストを実施するか。
運用記事を書くならどの大規模言語モデルを選ぶ?まずテストの基準を理解する
モデルベンチマークとは、統一されたタスクでモデルの性能を測る一連のテストのことです。運用におけるモデル選定では、実際の制作フローに近いテストを優先して確認すべきです。同じ資料、同じ企画、同じ文字数で、完成した原稿を比較します。
コンテンツ運用記事を書くならどの大規模言語モデル?:英語スコアは候補の絞り込みに使う
AI Writing Benchmark は 2026年11月11日 に更新され、共通の英語ライティングタスクとモデル名を伏せた比較を採用しています。115モデル、131,507回のブラインド評価を対象としています。
GPT-6.1 Sol の英語総合スコアは 95.3、記事・ブログ・編集系のスコアは 98.5 です。Claude Opus 5.5 と Kimi K3.1 Pro の総合スコアはそれぞれ92.9、91.9で、いずれも基準スコアです。
率直に言えば、GPT はブログ執筆の候補プールに入れる価値があります。中国語の WeChat 公式アカウント記事の修正回数を減らせるかどうかは、ローカルでのテストが必要です。このプロジェクトは個人によって維持・運営されており、言語や評価方法も判断材料に含めるべきです。
特にバージョンはよく確認すべきです。解説・科学普及カテゴリーで先行するのは Kimi K3。ToneBench の「テンプレート臭の少なさ」単一項目89.0は GPT-6 Sol に対応します。これらの2つのスコアは、それぞれ旧バージョン名での結果です。
コンテンツ運用記事を書くならどの大規模言語モデル?:台本テストのほうが資料パッケージ執筆に近い
ToneBench の 2026年11月10日 時点のスナップショットは、英語の長尺動画台本を評価しています。モデルは制作要件とリサーチ資料パッケージを読み込み、クローズドブック形式で生成します。87モデル、151構成、7,550本の原稿をカバーしています。
以下の表は、選択した構成の Writing Score を抜粋したものです。Claude は xhigh 構成です。各行は各テストの推論構成をそのまま採用しており、計算予算は統一していません。そのため、ここではスコアのみを記載し、モデルランキングと構成ランキングの順位を混在させません。
| モデル | Writing Score | テストで推定した台本1本あたりの費用 |
|---|---|---|
| GPT-6.1 Sol | 82.4 | $0.239 |
| Claude Opus 5.5、xhigh | 85.8 | $1.003 |
| Kimi K3.1 Pro | 82.5 | $0.251 |
| Gemini 4 Carbon | 80.1 | $0.586 |
| Qwen3.8 Max | 76.8 | $0.207 |
| DeepSeek V4.1 Flash、1017バージョン | 81.6 | $0.014 |
| DeepSeek V4 Pro | 80.1 | $0.077 |
中心となる示唆は、Opus は高品質な長尺原稿を優先的にテストするのに適しており、Flash は低コスト競争力を示したことです。表中の費用は、このテストにおける台本作業量に対するものです。中国語のコンテンツ運用記事の見積もりにそのまま転用することはできません。
このテストはモデルによるレビューを採用しており、ベンダーへの選好が存在します。上位構成の信頼区間は重なっており、参照台本の変化も首位に影響します。候補を絞り込んだうえで、編集者による検証に回すのに適しています。
図の説明:以下では品質と費用で候補の分布を示します。データは上記の ToneBench スナップショットに基づきます。APIYI apiyi.com で再テストする際は、自身の Token、構成、編集時間を別途記録する必要があります。
運営記事を書くならどの大規模言語モデル?:中国語のエビデンスから適用範囲を探る
OmniToolsは2026年10月26日から11月3日にかけて、中国語の金融経済ディープ記事を対象にテストを実施し、10種類のモデルで合計26本の記事を生成しました。AIブラインド評価のスコアはOpus 5.5が8.25、GPT-6.1 Solが6.33でした。
これは、Opusが中国語の長文記事の候補となり得る根拠になります。ただしサンプル数が少なく、モデルごとに生成本数も異なるうえ、テスト実施者には商業ルーティングサービスの背景があります。結論はこの金融経済長文の事例に限定して解釈するのが適切です。
運営記事を書くならどの大規模言語モデル?:7モデルを個別に比較
運営記事を書くならどの大規模言語モデル?:GPTとClaudeの役割分担
GPT-6.1 Sol:日常的な記事作成の優先候補。英語記事のカテゴリで際立った成績を収めており、まずテックブログ、製品分析、ニュース解説でテストするのに適しています。中国語の自然さと引用の正確性については、別途スコアリングする必要があります。
Claude Opus 5.5:重要度の高い長文の優先候補。スクリプトテストと中国語の金融経済事例の両方がこれを裏付けています。特集記事やブランド長文はまずこれを試すとよいでしょう。一方、高頻度の短稿では、追加分の品質がより高いコストに値するかを比較すべきです。
運営記事を書くならどの大規模言語モデル?:Kimi、Gemini、Qwenの使い方
Kimi K3.1 Pro:長文資料タスクの候補。約1Mトークンのコンテキストと英語の総合ライティングの結果から、知識集約型の記事テストに組み込むことを支持できます。K3の科学普及カテゴリの成績は個別に評価する必要があります。
Gemini 4 Carbon:複雑な資料分析の候補。まず多段階の問題、証拠の関係、記事のアウトラインを整理させ、その後で直接記事化する効果と比較するのがよいでしょう。現時点のエビデンスは、候補としての判断を支持するのに適しています。
Qwen3.8 Max:構造化された量産の候補。製品説明、固定コーナー、テンプレート化されたコンテンツをテストできます。バッチ推論では単一リクエストあたりのコンテキスト上限が256Kなので、導入前にリージョン対応状況を確認する必要があります。
運営記事を書くならどの大規模言語モデル?:DeepSeek FlashとProの選び方
DeepSeek V4.1 Flash:低コストの初稿の優先候補。前述のスクリプトテストではスコアと費用のバランスに優れ、バッチでの初稿作成、リライト、知識の解説に適しています。公開前には人間によるファクトチェックを残しておきましょう。
DeepSeek V4 Pro:タスク特化の候補。APIは現在もサービスを提供していますが、このスクリプトテストではFlashのスコアのほうが高くなりました。特定タスクのブラインドテストで効果が証明された場合にのみ、予算を上げる価値があります。
記事制作にどの大規模言語モデルを選ぶか:タスク別の階層化プラン
以下は現時点で得られているエビデンスに基づくテスト順序です。中国語の成果物を採用するかどうかは、チームによるブラインド評価で決めます。
| コンテンツ制作タスク | 優先候補 | 代替または併用案 |
|---|---|---|
| テックニュース、日常的なブログ | GPT-6.1 Sol | Flash で初稿を作成し、GPT で改稿 |
| 深掘りした業界分析、ブランドの長文 | Claude Opus 5.5 | GPT で同一テーマをブラインドテスト |
| 技術チュートリアル、知識解説 | GPT、Kimi K3.1 Pro | Flash で低コストの対照を実施 |
| 長い資料の統合、複雑な議題 | Kimi、Gemini | 先にエビデンスを整理し、その後で成稿モデルに渡す |
| マーケティング記事、SNS向け短コンテンツ | GPT で短コンテンツを先にテスト | ブランドの長文には Opus を追加 |
| バッチ処理の構造化コンテンツ | Qwen、Flash | 採用率に応じて主力を決定 |
| 利用可能なプラットフォーム | 各社公式の対応インターフェース | APIYI apiyi.com で統一的に呼び出して比較 |
マーケティングとセールス分野で英語圏に強いモデルは Claude Sonnet 5.5 で、これは上記の7モデルの外にあります。マーケティングコピーが中核事業であれば、長文モデルの中だけで最優秀モデルを選ぶのではなく、候補プールを広げるとよいでしょう。
すぐに始めるためのヒント:APIYI apiyi.com は、1つの API キーで複数のモデルを呼び出せる OpenAI 互換インターフェースを提供しており、新規ユーザーには無料テスト枠があります。まず同じテーマで3モデルを比較し、その後テスト範囲を広げてください。
コンテンツ運営の記事を書くならどの大規模言語モデル?合格稿までのコストを算出
Token はモデルがテキストを処理する際の計量単位です。入力Tokenにはプロンプト、資料、コンテキストが含まれ、出力Tokenには生成内容が含まれます。コンテキストウィンドウは、1回の呼び出しで処理できる範囲を表します。
以下では APIYI 2026年11月12日10:45(UTC+8)時点の価格スナップショット を用います。単位は米ドル/100万Tokenです。試算はすべて入力10,000、出力3,000 Tokenで計算します。
| モデル | 入力単価 | 出力単価 | 1回あたりの試算費用 |
|---|---|---|---|
| GPT-6.1 Sol | $2 | $10 | $0.05000 |
| Claude Opus 5.5 | $4 | $20 | $0.10000 |
| Kimi K3.1 Pro | $2 | $10 | $0.05000 |
| Gemini 4 Carbon | $2 | $10 | $0.05000 |
| Qwen3.8 Max | $1.65 | $4.95 | $0.03135 |
| DeepSeek V4.1 Flash | $0.30 | $1.20 | $0.00660 |
| DeepSeek V4 Pro | $1.32 | $3.96 | $0.02508 |
計算方法は「入力量÷100万×入力単価+出力量÷100万×出力単価」です。この表は1回の生成にかかる基本費用を比較したものです。リトライ、レビュー、編集にかかる時間は別途計算する必要があります。
ルーティングの違いによっても、請求額と機能は変わります:
- Qwen公式のリージョン別価格:シンガポールは$2/$6、北京と米国バージニアは$1.65/$4.951。
- Gemini公式直結:紹介期間は11月30日まで。12月1日以降は$4/$20で、推論Tokenは出力費用に計上されます。サードパーティは各社の告知に従って確認してください。
- DeepSeek公式直結:オフピーク時は価格が半額になります。適用時間帯は公式ルールで確認してください。
- Kimiのバッチ機能:Moonshotチャネルのバッチルールは個別に確認が必要です。Alibaba CloudのK3.1 Proドキュメントにはバッチ推論非対応と記載されています。
プロンプトキャッシュは、サービス提供者のルールに従って重複入力を再利用し、課金する仕組みです。統一インターフェースは切り替えに便利ですが、キャッシュ、検索、推論モード、バッチ機能についてはルートごとに確認する必要があります。
運営記事を書くならどの大規模言語モデル?実際のブラインドテストを実施する方法
最小構成の呼び出しは、APIの疎通確認に適しています。以下ではテキスト生成のみをデモし、検索やその他のツールは有効にしません。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
result = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "根据给定资料写运营文章大纲。"}],
)
print(result.choices[0].message.content)
完全な比較では、同じ資料と同じタスクを使用し、各モデルにつき少なくとも3回、個別に生成する必要があります。以下では生成原稿と使用量を保存します。レビュー時にはモデルのラベルを隠し、その後、編集者が修正に要した時間と採用状況を記録します。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
models = ["gpt-6.1-sol", "claude-opus-5-5", "kimi-k3.1-pro"]
packet = "在此粘贴同一份已核验资料包。"
results = []

for model in models:
    for trial in range(3):
        response = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system",
                 "content": "仅依据资料写作,缺少依据的观点请省略。"},
                {"role": "user",
                 "content": f"写一篇运营文章,先回答问题,再展开论证。\n资料:{packet}"},
            ],
        )
        results.append({
            "model": model,
            "trial": trial,
            "text": response.choices[0].message.content,
            "usage": response.usage.model_dump() if response.usage else None,
        })
事実の正確性、企画の実行力、中国語の自然さ、読みやすさ、内容の付加価値を評価することをおすすめします。同時に、編集者の採用率と1記事あたりの合格コストを記録します。安価な初稿が全編書き直しになるなら、浮くのは小銭、消えるのは午後です。
運営記事を書くならどの大規模言語モデル?よくある質問
予算が限られている場合、まずどれをテストすべきですか?
まず Flash、GPT、Opus を比較し、低コスト、日常的な原稿作成、重要な長文という用途をカバーします。APIYI apiyi.com でモデルを切り替えれば、個別に接続するための設定作業を減らせます。
1つのインターフェースで比較を完全に公平にできますか?
APIYI apiyi.com では呼び出し形式を統一できますが、公平性を保つには資料、ツール権限、分量、推論設定も統一する必要があります。モデルのバージョンとエンドポイントを記録し、異なる作業条件を混同しないようにしましょう。
運営記事を書くならどの大規模言語モデルを選ぶか:結びに代えての提案
階層的なモデル選定を採用します。通常の初稿には低コストの候補を、重要な記事には高品質な候補を使い、事実確認は独立したチェックプロセスに任せ、人による検証も残します。モデルの推奨は、最終的にはチームの実際の採用率に従うべきです。
上記の組み合わせは APIYI apiyi.com で検証し、従量制でテストしながら最新の価格を確認することをおすすめします。選定のゴールは、ランキング首位のモデルにすべての仕事を割り当てることではなく、合格水準の記事を安定して産出することにあります。
参考資料
- AI Writing Benchmark:aiwritingbenchmark.com、2026年11月11日更新。
- ToneBench:benchmark.towardsai.com/models/、2026年11月10日時点のスナップショット。
- OmniTools中国語長文実測:omnitools.ai/evals/longform-writing。
- アリババクラウド公式価格:alibabacloud.com/help/en/model-studio/model-pricing、2026年11月12日時点の照会結果。
- Gemini公式価格改定:blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/。
著者:APIYI技術コンテンツチーム。apiyi.com でのモデル呼び出しや運営記事の評価について、ぜひ意見交換しましょう。比較の際はバージョン、設定、タスクの基準を添えてください。