
GPT、Claude、Kimiのライティングテスト概要:まず結論から
英語記事ならまず GPT-6.1 Sol を試す。文体を重視する長文なら Claude Opus 5.5 を優先。解説・科学普及系の記事なら Kimi K3 も候補に加える価値があります。 Kimi K3.1 Pro の英語での総合性能も非常に高く、ToneBench では GPT に近い結果を示しています。
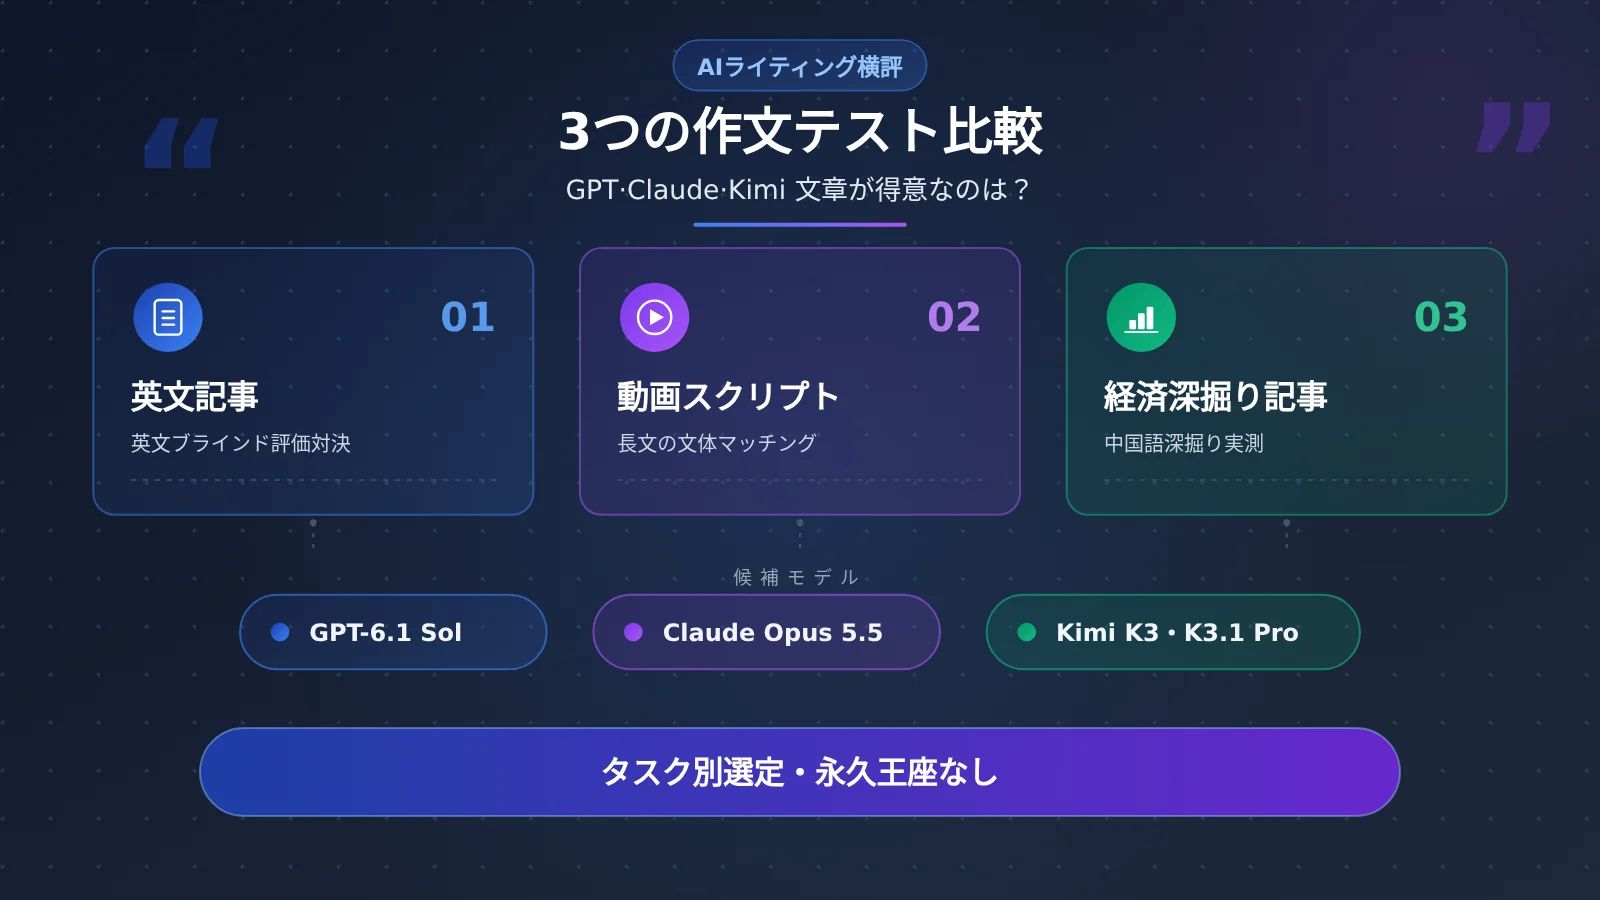
3つのテストはタスク・言語・評価方法がそれぞれ異なります。最も実用的な結論は、候補リストを作って自分の原稿で検証することであり、3つのモデルファミリーに永久のトロフィーを授けることではありません。
導入のヒント:APIYI apiyi.com の統一インターフェース経由で候補モデルを呼び出し、同じ資料セットで初稿を比較できます。新規ユーザー向けの無料テスト枠は、プラットフォームの現行ルールに準じます。
GPT、Claude、Kimi ライティングテスト:この記事の後半でわかること
本記事では、英語ライティングのランキング、スタイル化された動画向け長文原稿のテスト、そして中国語の金融・経済に関する深掘り記事の実測を順に掘り下げていきます。最後に、ユースケースの選び方、ブラインドテストの手順、呼び出しのサンプルを紹介し、記事の品質と人による編集コストに焦点を当てます。
まず2つの用語を定義しておきます。ライティングベンチマークとは、あらかじめ定めたタスクに沿って出力を評価するテストのことです。ブラインド評価とは、モデルの身元を隠したうえでテキストを比較する方法です。ブラインド評価は人間でもモデルでも実施できるため、結果を読むときは誰が評価したのかを明確に区別する必要があります。
GPT、Claude、Kimi ライティングテスト①:英語記事は GPT で
AI Writing Benchmark は Johannes Eva が運営する英語ライティングのプロジェクトで、モデルベンダーから金銭的支援を受けていないと明言しています。本記事では、2026年11月11日に更新され、11月12日に照会した結果を採用しています。
このプロジェクトは115のモデルを対象とし、131,507回の公開ブラインド評価による対決を記録しています。匿名のテキストを比較してライティングを評価し、AI評価によるランキングと人間の投票によるランキングをそれぞれ提示しています。
| モデル | 英語総合スコア | 結果の基準 |
|---|---|---|
| GPT-6.1 Sol | 95.3 | 総合ランキング1位 |
| Claude Opus 5.5 | 92.9 | 総合ランキング2位 |
| Kimi K3.1 Pro | 91.9 | 総合ランキング3位 |
総合スコアは複数種類のタスクをまとめたものです。タスクカテゴリ別スコアは、ある特定の種類の課題だけを反映します。GPT-6.1 Sol は記事・ブログ・編集系コンテンツのカテゴリ別スコアが 98.5 であり、総合スコアの 95.3 とは分けて記録する必要があります。
これらはベンチマーク内部での相対的なスコアです。このプロジェクトでは 50 を、その言語とカテゴリの平均的なモデルに勝つ推定確率が2分の1であることを示す値と定義しています。読者はスコアを公開可能なコンテンツの割合と捉えるのではなく、競争上の位置に注目すべきです。
率直に言えば、タスクが英語のブログや編集系の記事であれば、GPT-6.1 Sol を最初のテスト対象に含める十分な理由があります。 中国語の記事については、別途中国語での根拠を探す必要があります。
もう一つ注目すべき結果は、Kimi K3 が解説・サイエンス系のカテゴリで 94.9 を記録し首位に立っている点です。ここで勝利しているのは K3 であり、総合ランキング3位は K3.1 Pro です。バージョン名はスコアと一緒に保存しておく必要があります。
GPT、Claude、Kimiのライティングテスト その2:長尺原稿の文体ではClaudeが優位
ToneBenchはモデルにクリエイティブ・ブリーフ、リサーチ資料パッケージ、スタイルガイドを読み込ませ、その後、完全なYouTube台本を生成させます。モデルは原作者の完成稿を見ることはできず、ネットワーク接続や外部ツールの呼び出しもできません。
本記事は2026年11月10日に更新された資料を用いています。タスクは特定クリエイター向けの動画長尺原稿であり、提供された資料には全タスクの言語が明記されていないため、ここでは台本のシナリオとして解釈します。
テストには87モデル、151構成が参加し、各構成が10タスクを完了、各タスクを独立に5回生成しました。合計7,550本の原稿が生成され、4名のAIレビュアーによって30,200回の採点が行われています。
特に注目しているのはスタイルマッチング、つまりトーン、リズム、表現方法が対象クリエイターにどれだけ近いかです。文体マッチングの重みは19%、内容の深さ・正確性・価値が15%で、さらに一貫性と分量コントロールも評価します。
下表は各モデルの最良構成におけるWriting Scoreを採用し、資料に記載されたモデルランキングも示しています。Claudeはxhighに対応します。資料には他の2モデルの具体的な推論構成名が示されていないため、再測定時には補完する必要があります。
| モデル | モデルランキング | Writing Score | テスト推定1本あたりコスト |
|---|---|---|---|
| Claude Opus 5.5 | 1 | 85.8 | $1.003 |
| GPT-6.1 Sol | 8 | 82.4 | $0.239 |
| Kimi K3.1 Pro | 9 | 82.5 | $0.251 |
Writing Scoreはこのテストにおけるライティングパフォーマンスを集約した指標で、ランキングはElo基準に関わります。したがって、Kimiのスコアが0.1高くランキングが1つ低いのは、両者のパフォーマンスが近いと理解すべきです。
Claudeはこの結果群でリードし、テスト推定コストはGPTの約4.2倍です。これはToneBenchのコスト推定であり、他のプラットフォームの記事料金にそのまま当てはめることはできません。
ランキングを理解するには、タスクとレビューも同じ図に収めるのがよいでしょう。APIYI apiyi.comで再測定する際は、構成記録を保持し、元のランキングに戻って比較基準を確認することをお勧めします。
ToneBenchの1位と2位は信頼区間が重なり、参照台本を1本でも除くと首位が変わります。研究ではレビュアーに一定のベンダー選好があることも判明しましたが、単一レビュアーによる評価を除いてもClaudeは依然として首位です。
核心的な判断は、資料を吸収しクリエイターの声を保つ長尺原稿では、Claudeを優先的に試す価値があるということです。この結果は候補選択の指針として適切ですが、優位の幅は自身の原稿で検証する必要があります。
また、GPT-6 SolのLeast Slop個別項目の成績は別バージョン・別指標に属し、GPT-6.1 SolのWriting Scoreを置き換えることはできない点に留意してください。
GPT、Claude、Kimi ライティングテスト3:中国語の深掘り記事では何を見るべきか?
OmniTools のテストは 2026年10月26日から11月3日 に実施され、対象は PANews の中国語金融経済ディープ記事でした。10種類のモデル、26記事を比較しています。
| モデル | AIブラインド評価点 | テスト記事数 | 自然度スコア |
|---|---|---|---|
| Claude Opus 5.5 | 8.25 | 7 | 8.3 |
| GPT-6.1 Sol | 6.33 | 3 | 5.5 |
このテストでは、Claude の総合スコアと自然度がより高くなっています。中国語の金融経済ディープ記事では、Claude Opus 5.5 がまず試す価値のある候補です。
ただし、サンプル数が少なく、モデルごとの記事数も偏っており、さらに Kimi は参加していません。したがって、この資料は GPT と Claude の中国語シーンにおける証拠を補足するにとどまり、3モデルの完全な中国語ランキングを示すことはできません。
レビューには Claude Opus 5.5 と DeepSeek V4 Pro を使用し、自身のモデルは評価対象外とするルールを設けています。公開元は API ルーティングサービスを手がける商業的背景を持っているため、読む際はこの出所情報を念頭に置いてください。
編集者による評価はまた別の記録です。Claude の編集採用率100%は1/1ラウンドのみに対応しており、事例として観察するのに適しています。長期的な採用状況については、さらに多くの記事による裏付けが必要です。
ひとことでまとめると、ここで得られたのは Claude が中国語の金融経済長文記事を書くことに関するポジティブなシグナルであり、その証拠の範囲はこのシーンに限定されます。
GPT、Claude、Kimi 文章作成テスト:シナリオ別に候補を選ぶ
3つの結果を並べるときは、スコアを合計するのではなく「選型表」として整理するべきです。記事の言語、タスク、目指す文体によって、どの証拠が自分に関係するかが変わります。
| 執筆シーン | 優先候補 | 選定の根拠 |
|---|---|---|
| 英語ブログ、編集系記事 | GPT-6.1 Sol | 英語記事の分類でリード |
| クリエイター風の動画長尺台本 | Claude Opus 5.5 | ToneBench で現在トップ |
| 中国語の金融・経済ディープ記事 | Claude Opus 5.5 | 中国語の小サンプル実測でリード |
| 英語の解説、科学コミュニケーション | Kimi K3 | 解説・科学コミュニケーション分類でリード |
| 資料パッケージ駆動の長文コンテンツ | 3モデル共同のブラインドテスト | GPT と Kimi は ToneBench でほぼ互角 |
| 呼び出し検証プラットフォーム | APIYI apiyi.com | 統一インターフェースでモデル切り替えが容易 |
中国語の技術チュートリアルや製品紹介といったシーンは、現状の3つの証拠ではカバーしきれていません。より確実な方法は、候補を同時にテストして、技術をきちんと説明できるか、事実を正確に書けるかを見ることです。
GPT、Claude、Kimi 文章作成テスト:自分で比較するには?
実際のテーマを選び、各モデルにまったく同じ資料、構成案、文字数、ツール権限を与えるのがおすすめです。各モデルで少なくとも3回ずつ独立に生成し、モデル名を伏せたうえで編集者に評価してもらいます。
評価はまず5項目から始めるとよいでしょう。事実の正確さ、構成案の実行度、表現の自然さ、構造のわかりやすさ、コンテンツの価値です。重み付けはチームのタスクによって決め、あくまで自前のルールであることを明記します。
さらに人件費としての編集コスト、つまり公開可能な状態まで修正するのに必要な作業量も記録します。修正時間、書き直した段落、事実誤認、最終的な採用状況を併せて残すのが理想的です。
設定のヒント:APIYI apiyi.com では1つの APIキーでモデルを切り替えられるため、重複した接続作業を減らせます。テスト時はモデルのバージョン、パラメータ、実際の Token 使用量を残しておくと、再現が容易になります。
以下は最小限の呼び出し例です。同じ実際の資料パッケージを brief に入れ、モデル名を切り替えるだけで比較用の初稿が生成できます。APIキーは実行環境から安全に提供してください。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

brief = """请依据以下资料和策划生成文章。
只使用资料支持的事实,遵守目标篇幅与文风。
这里替换为各模型共同使用的实际资料包和策划。
"""

for model in [
    "gpt-6.1-sol",
    "claude-opus-5-5",
    "kimi-k3.1-pro",
]:
    result = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": brief}],
    )
    print(model, result.choices[0].message.content)
このコードはあくまで出発点です。正式なブラインドテストでは、生成を繰り返し、匿名で提示し、設定を記録する必要があります。解説分類でリードするモデルを検証したい場合は、Kimi K3 を追加で組み込む必要があります。
GPT、Claude、Kimi ライティングテスト FAQ
GPT、Claude、Kimi のライティングテストで、Kimi はどのバージョンを試すべきですか?
解説・科学普及系の記事には、まず Kimi K3 を候補に加えましょう。本記事の総合ランキングと ToneBench の結果を比較する場合は K3.1 Pro を使います。APIYI(apiyi.com)で呼び出す前に、モデルリストと具体的なモデル名を確認して、バージョンの取り違えを避けましょう。
GPT、Claude、Kimi のライティングテストで、実際のコストはどう比較すればよいですか?
「1本あたりの合格コスト」で比較します。これは累計の呼び出し費用に編集作業量を加えたものです。APIYI(apiyi.com)でテストする際は、実際の使用量とリトライ回数を記録し、その時点の価格で計算しましょう。初稿の費用だけを見るより、実際の制作現場に近い指標になります。
GPT、Claude、Kimi ライティングテストのまとめ:編集の手間が少ないモデルを選ぶ
英語の記事はまず GPT、スタイルを重視した長文や中国語の金融・経済の深掘り記事はまず Claude、解説・科学普及系には Kimi を加える。 これらはあくまで特定タスクにおける優先順位であり、モデルファミリー全体の恒久的なランキングではありません。
APIYI(apiyi.com)を通じて、同じ資料パッケージで効果を検証することをおすすめします。最終的にどれを選ぶかは、誰がより正確に企画を完成させ、使える段落をより多く残し、編集者の追加作業を1ラウンド減らせるかで決まります。
GPT、Claude、Kimi ライティングテストの参考資料
-
AI Writing Benchmark:aiwritingbenchmark.com
英語の総合ランキングとカテゴリ別ランキング。2026年11月11日更新時点の基準を採用しています。 -
Towards AI ToneBench:benchmark.towardsai.com/models/
動画スクリプトのテスト、モデルランキング、構成とコスト見積もり。2026年11月10日時点の資料を採用しています。 -
OmniTools 長文ライティング徹底検証:omnitools.ai/evals/longform-writing
PANews の中国語ファイナンス深掘り記事テスト。テスト期間は2026年10月26日から11月3日までです。
著者:APIYI技術コンテンツチーム。APIYI apiyi.com を通じて、モデル設定、ブラインドテスト手法、編集経験についてぜひ情報交換しましょう。


