著者注:GPT Image 2.6 で新たに追加された Complexity パラメータは、モデルが描画前にどれだけシーンを計画するかを制御します。この記事では、OpenAI 公式の切り絵風サッカーチームの比較例をもとに、Complexity の3段階の違い、Quality との役割分担、API での選び方とテスト方法を解説します。
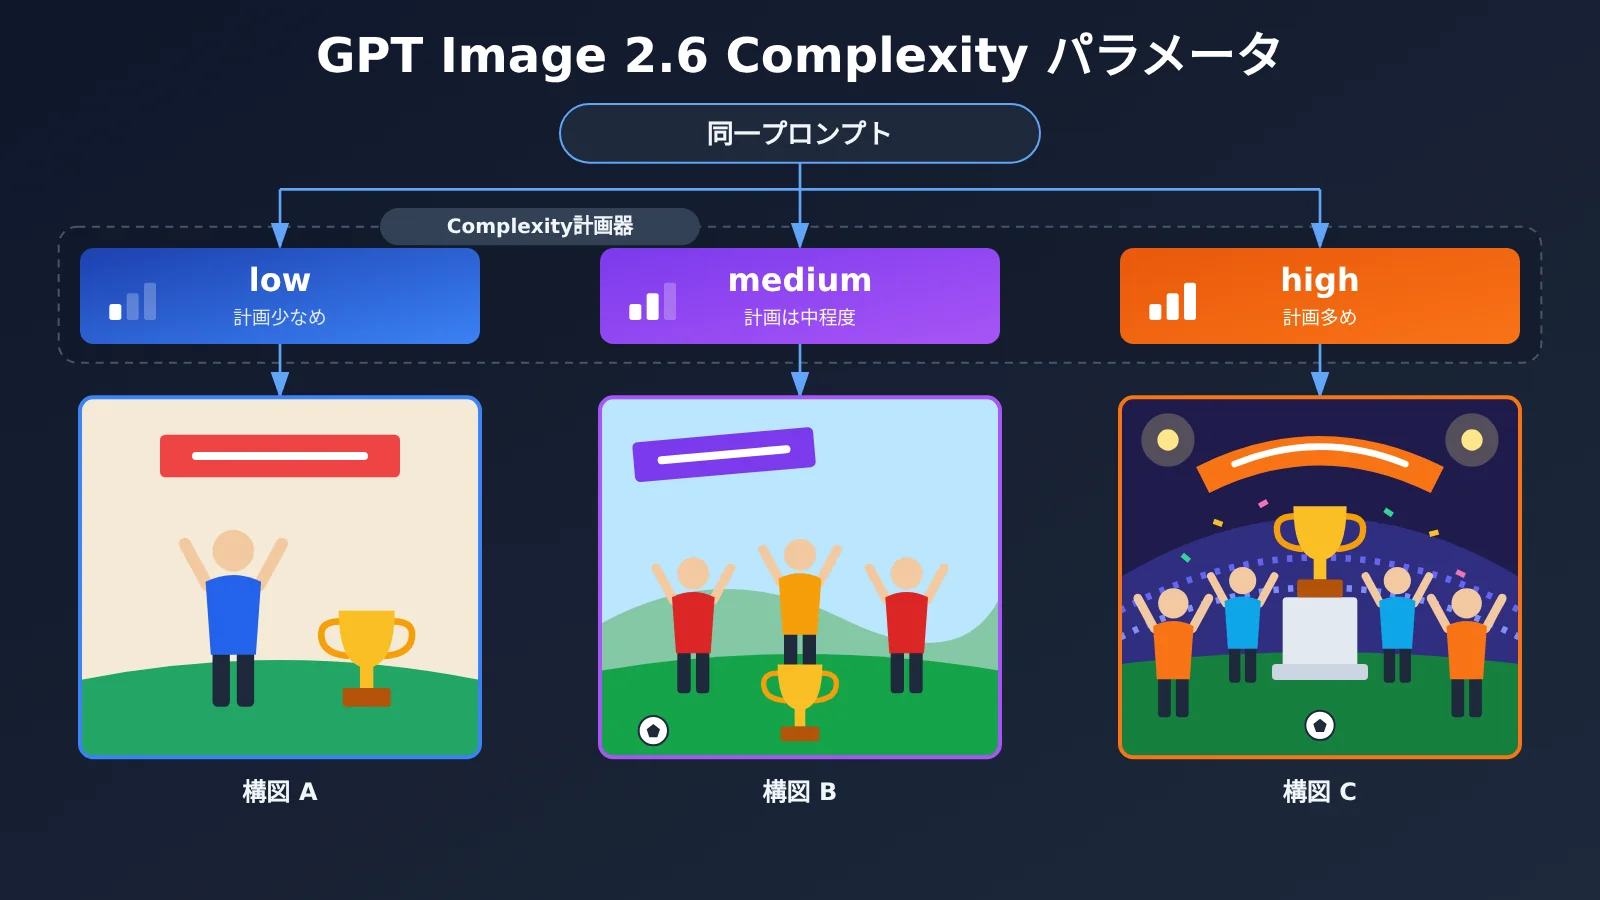
同じプロンプト、同じサイズと画質のまま、Complexity を low から high に変更するだけで、選手のユニフォームの色やトロフィーの装飾、「CHAMPIONS」の看板の位置まで変わることがあります。これは、OpenAI が GPT Image 2.6 のプロンプトガイドで公開した比較結果です。
2026年11月4日、OpenAI は Images 2.6 を発表し、開発者向けに gpt-image-2.6-flare と gpt-image-2.6-sunburst の2つのモデルを提供するとともに、complexity パラメータを追加しました。このパラメータはモデルの思考の連鎖を確認するためのものではなく、「高ければ高いほどよい」という画質の切り替えスイッチでもありません。モデルが描き始める前に、どれだけシーンを計画するかを制御するものです。
この記事でわかること:GPT Image 2.6 の Complexity パラメータの公式な定義、実際の例で3つの設定によって何が変わるか、そして API ではどの設定からテストを始めればよいかを解説します。
GPT Image 2.6 Complexityの基本情報
まず、公式に確認されている情報を表にまとめます。以降の分析や考察は、これらの情報をもとにしています。
| 項目 | 詳細 |
|---|---|
| リリース日 | 2026年11月4日、Images 2.6と同時にリリース |
| 対応モデル | gpt-image-2.6-flare、gpt-image-2.6-sunburst |
| 選択できるレベル | low / medium / high |
| デフォルト値 | 両モデルとも high |
| 公式の定義 | 制作上の要件を理解し、満たすために、レンダリング前にどの程度の計画を行うかを制御する |
| 料金 | パラメータによる追加料金はないが、実際のトークン消費量と所要時間は各自でテストする必要がある |
| 関連する制限 | GPT Image 2.6は reasoning.summary に対応しておらず、計画の過程を読み取れない |
ここで、誤解しやすい点が2つあります。1つ目は、公式が言及しているのは「計画にどれだけの処理を投入するか」であり、各レベルの内部的な計算資源の割り当て方や、固定数の推論トークンに対応するかどうかは公開されていないという点です。2つ目は、「追加料金がない」ことは「3つのレベルの料金が同じ」ことを意味しません。最終的な料金は、実際に課金対象となるトークン数に基づいて計算されるためです。
GPT Image 2.6のComplexityとQualityの違い
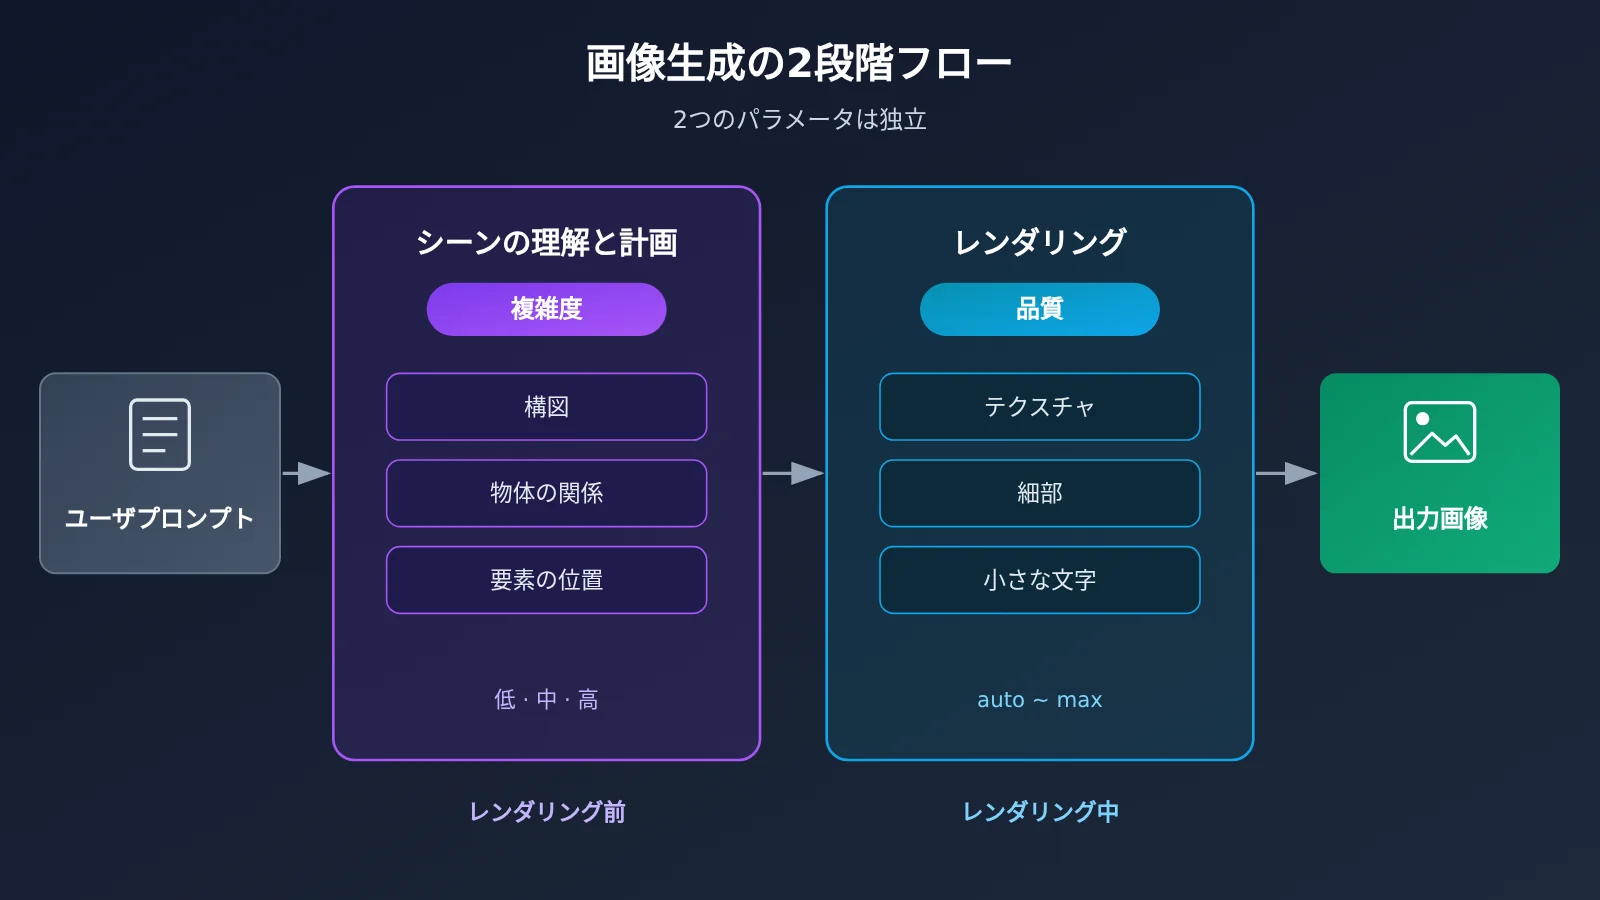
Complexityを初めて見たとき、Qualityの別の呼び方だと思う人もいるかもしれません。しかし、両者は画像生成の異なる段階を担当します。Complexityは画像をどう構成するかを決め、Qualityは画像をどれだけ精細に描くかを決めます。
| 比較項目 | Complexity | Quality |
|---|---|---|
| 作用する段階 | レンダリング前の計画とシーンの理解 | レンダリング時の視覚的な表現 |
| 主な影響 | 全体の構図、物体同士の関係、要素の位置、複数の制約の調整 | テクスチャ、ディテール、小さな文字、全体の精細さ |
| 選択できる値 | low / medium / high | auto / low / medium / high / xhigh / max |
| デフォルト値 | high | インターフェースの設定による |
| 典型的な問題 | 要素の配置が違う、関係性の理解が誤っている | 構造は正しいが、小さな文字がぼやける、テクスチャが粗い |
2つのパラメータは互いに独立しているため、問題を解決するときは、まずどちらの種類の問題かを見極めましょう。インフォグラフィックの構造や矢印の関係が正しく、ラベルの小さな文字だけが読みづらい場合は、先にQualityを上げるべきです。Complexityをさらに上げても、あまり効果はありません。一方、画像内の複数の被写体の相対的な位置がいつも間違っているなら、Complexityを見直しましょう。
たとえるなら、Complexityはレイアウトデザイナーが描き始める前に下書きにかける時間、Qualityは最後の色塗りや線描の精細さです。下書きに時間をかけても線が細かくなるとは限りませんし、線を細かく描いても下書きの構造上の間違いは補えません。
GPT Image 2.6 Complexity の公式比較事例:切り絵のサッカーチーム
抽象的な定義だけでは捉え方にずれが生じやすいため、公式プロンプトガイドには直接比較できる事例が紹介されています。
実験条件(公式発表):
- モデル:
gpt-image-2.6-sunburst - サイズ:
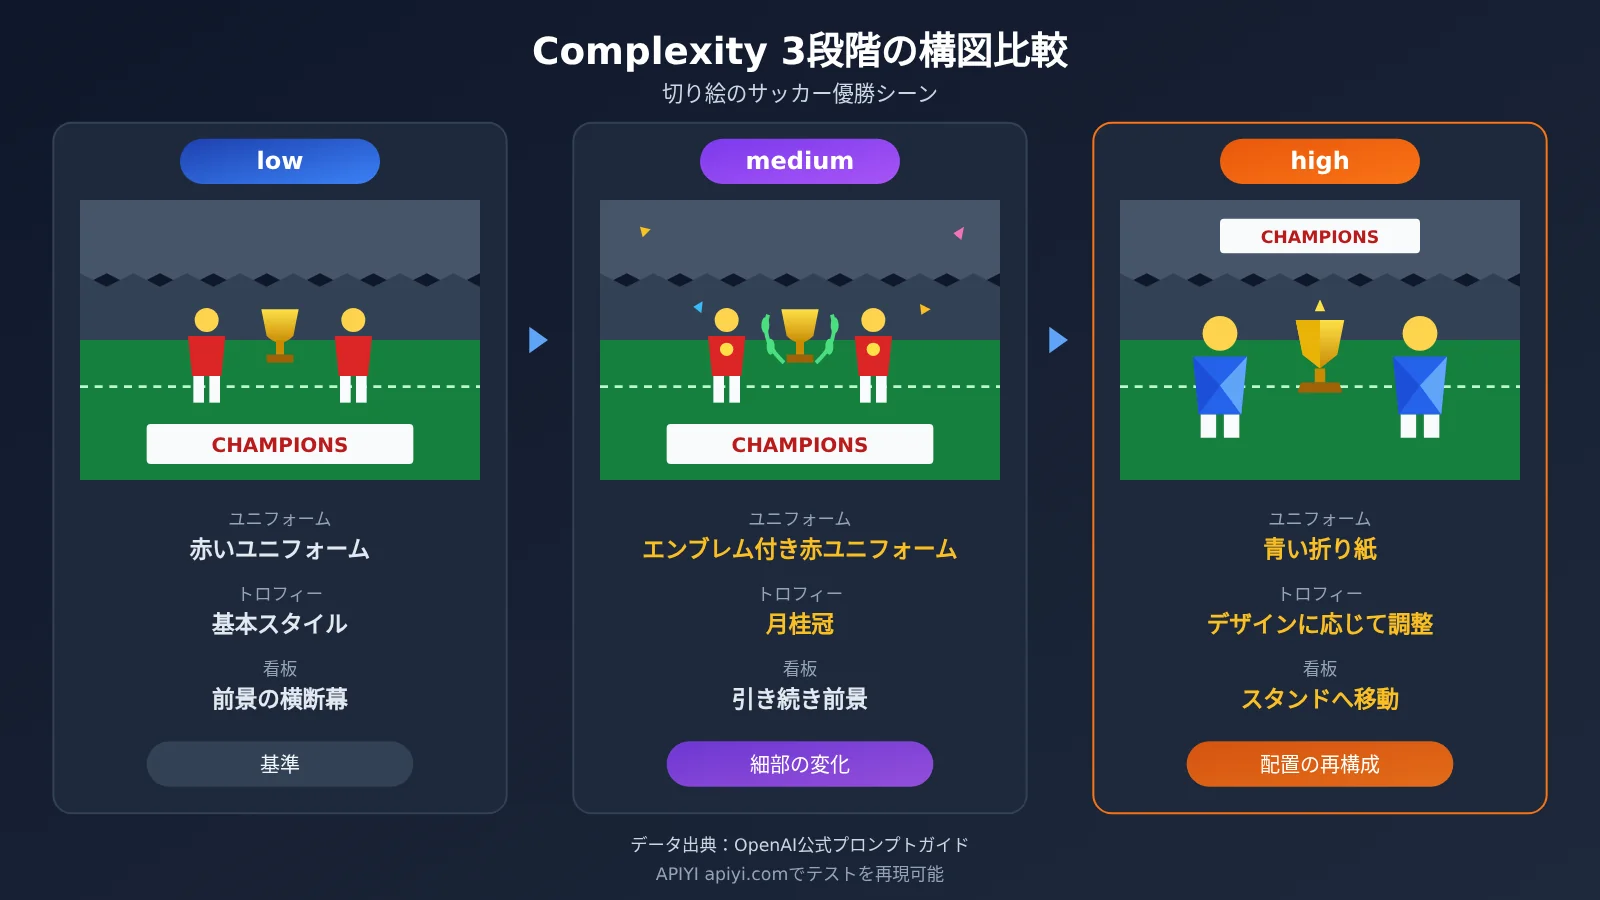
1024x1536、Quality:medium、形式:png - プロンプト:「A premium handcrafted layered paper-cut illustration of a football team celebrating a championship victory inside a packed stadium.」(満員のスタジアムで優勝を祝うサッカーチームを描いた、上質な手作りの多層切り絵イラスト)
- 唯一の変数:Complexity をそれぞれ low、medium、high に設定
| 設定 | ユニフォーム | トロフィー | CHAMPIONS の看板 | 構図の変化 |
|---|---|---|---|---|
| low | 赤い服 | 上部に王冠の装飾 | 手前の横断幕に配置 | 基本的なレイアウト |
| medium | チームエンブレム付きの赤いユニフォーム | 月桂冠の装飾付き | 引き続き手前の横断幕に配置 | 細部の要素がより豊かに |
| high | 青い折り紙風のユニフォーム | 全体のデザインに合わせて変更 | 観客席に移動 | 手前の空間をより多く選手に割き、全体のレイアウトを再構成 |
切り絵の事例から見る Complexity の変化
公式の説明によると、low から medium への変化は、主に各要素の細部のデザインに表れています。ユニフォームにエンブレムが加わり、トロフィーの装飾も変わりましたが、看板の位置は変わっていません。high になると、変化は全体のレイアウトにまで広がります。スローガンは手前から観客席に移り、手前の空間は選手のために確保されました。ユニフォームの素材も、「切り絵」のテーマにより近い折り紙のような質感に変わっています。
このことから、Complexity を高くすると、単にテクスチャが増えるだけでなく、モデルが構図の階層や要素の配置についても異なる判断をすることがわかります。high の結果は、モデルが「切り絵」「優勝」「スタジアム」という3つの条件を踏まえ、より全体的に再構成したものと捉えられます。
ただし、この比較から得られる根拠には限りがあるため、次の点に注意が必要です。
- 公式が各設定で示したのは1つのサンプルのみであり、これだけで high の平均的な品質が高いとは判断できません。
- 公式は、3つの設定それぞれの実際の所要時間やトークン使用量を公表していません。
- 「high のほうが切り絵のテーマに合っている」というのは、1枚の結果に対する解釈であり、統計的な結論ではありません。
GPT Image 2.6のComplexityはどの段階を選ぶ?
公式は明確な出発点を示すとともに、Highが常に最適とは限らないと強調しています。
公式の推奨:編集タスクはまずlowから
OpenAIはリリース告知で、多くの画像編集タスクでは、まずlow complexityを試して編集速度を上げ、ワークフローに必要なQualityと組み合わせることを推奨しています。lowから始めるのに適したタスクには、背景の変更、看板の内容の変更、部分的な色の変更、オブジェクトの削除など、画像のほかの部分を維持する必要がある精密な編集が含まれます。
なぜ部分編集にはそれほど多くの計画が必要ないのでしょうか。以下は妥当と考えられる技術的な推論ですが、公式には確認されていません。ユーザーが「花瓶の色だけを変えて、ほかはそのままにして」と指示した場合、意図に最も沿うのは画像への変更を最小限に抑えることです。モデルがシーン全体を大幅に再計画すると、かえって変更すべきでない部分まで変わってしまう可能性があります。公式も「複雑度が高いと、望ましくない追加の変更が生じる可能性がある」と述べており、この推論と方向性は一致しています。ただし、highが必ず変更箇所のより大きなずれを引き起こすと証明するデータは、現時点ではありません。
公式の推奨:制約の多いタスクはmediumとhighを比較
画面要素が多く、レイアウトが複雑で、制約条件も多いタスクについては、公式はmediumまたはhighを試すことを推奨しています。
| タスクの種類 | 推奨される開始段階 | 根拠 | 追加の確認項目 |
|---|---|---|---|
| 背景の変更、部分的な色の変更、看板の文字の変更 | low | 公式の推奨 | 編集対象外の領域が変更されていないか |
| 単一オブジェクトの削除 | low | 公式の推奨 | 補完された領域が自然か |
| 複数の主体が登場するシーン、人物同士の関係 | medium / highを比較 | 公式の推奨 | 主体の位置や関係が正しいか |
| 複雑なインフォグラフィック、ラベルが密集した画像 | medium / highを比較 | 公式の推奨 | 構造が正しいことを確認してから文字の明瞭さをチェック |
| レイアウトが完全に指定されたデザイン案 | 最高段階を標準にする必要はない | 公式は改善が目立たない可能性を指摘 | 余計な変更が生じていないか |
最後の行は特に注目すべきポイントです。プロンプトで各要素の位置をすでに具体的に指定している場合、モデルが自由に計画できる余地はもともと小さくなります。公式によると、この種のタスクではComplexityを上げても目立った改善が得られず、遅延だけが増える可能性があります。
デフォルトのhighが意味すること
2つのモデルはいずれもデフォルトがhighです。従来のワークフローから移行する際、このパラメータを指定しなければ、最高の計画段階で実行されます。大量の部分編集リクエストを処理する場合、このデフォルト値が必ずしも最適な設定とは限りません。
🎯 技術的なアドバイス:Complexityは全体に適用するスイッチではなく、タスクの種類に応じて調整するパラメータとして扱うことをおすすめします。APIYI apiyi.comのOpenAI互換インターフェースを使って、比較テストを行うこともできます。2.6モデルが提供されているか、
complexityパラメータがそのまま転送されるかは、プラットフォームのモデル一覧とドキュメントを確認してください。
APIでGPT Image 2.6のComplexityを設定する方法
最小限のサンプル
complexity は /v1/images/generations のリクエストボディで、quality や size と同じ階層に指定します。使用しているSDKのバージョンにこのフィールドがまだない場合は、extra_body を使って渡せます。
import base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.images.generate(
    model="gpt-image-2.6-sunburst",
    prompt="A detailed educational infographic explaining how a coffee machine works, with clearly labeled components and arrows.",
    size="1024x1536",
    quality="medium",
    extra_body={"complexity": "high", "output_format": "png"},
)
open("coffee_high.png", "wb").write(base64.b64decode(resp.data[0].b64_json))
これは公式のパラメータ仕様に基づいたサンプルコードであり、実際にテスト済みのリクエストではありません。
3段階の比較テスト用スクリプト全体を見る
import base64
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # APIYIのOpenAI互換インターフェース
)

PROMPT = (
    "A premium handcrafted layered paper-cut illustration of a football team "
    "celebrating a championship victory inside a packed stadium."
)
LEVELS = ["low", "medium", "high"]
REPEATS = 3  # 各レベルで複数回実行し、1枚だけで判断しないようにする

def run_once(level: str, idx: int) -> dict:
    start = time.time()
    resp = client.images.generate(
        model="gpt-image-2.6-sunburst",  # モデルを固定
        prompt=PROMPT,                   # プロンプトを固定
        size="1024x1536",                # サイズを固定
        quality="medium",                # 画質を固定
        extra_body={"complexity": level, "output_format": "png"},
    )
    elapsed = time.time() - start
    path = f"paper_cut_{level}_{idx}.png"
    with open(path, "wb") as f:
        f.write(base64.b64decode(resp.data[0].b64_json))
    usage = getattr(resp, "usage", None)  # トークン使用量を記録(返された場合)
    return {"level": level, "idx": idx, "seconds": round(elapsed, 2),
            "usage": usage, "file": path}

results = []
for level in LEVELS:
    for i in range(REPEATS):
        try:
            results.append(run_once(level, i))
        except Exception as e:
            results.append({"level": level, "idx": i, "error": str(e)})

for r in results:
    print(r)
このスクリプトでは complexity だけを変更し、それ以外のパラメータはすべて固定しています。これは公式の移行ガイドでも推奨されている方法です。まずはデフォルト値で試し、その後は一度に1つのパラメータだけを調整します。
🚀 クイックスタート:新規ユーザーは APIYI apiyi.com で無料テスト枠を取得できます。上のスクリプトで小規模な比較を行い、本番環境で使用するレベルを決めましょう。
GPT Image 2.6 Complexity を公平にテストする方法
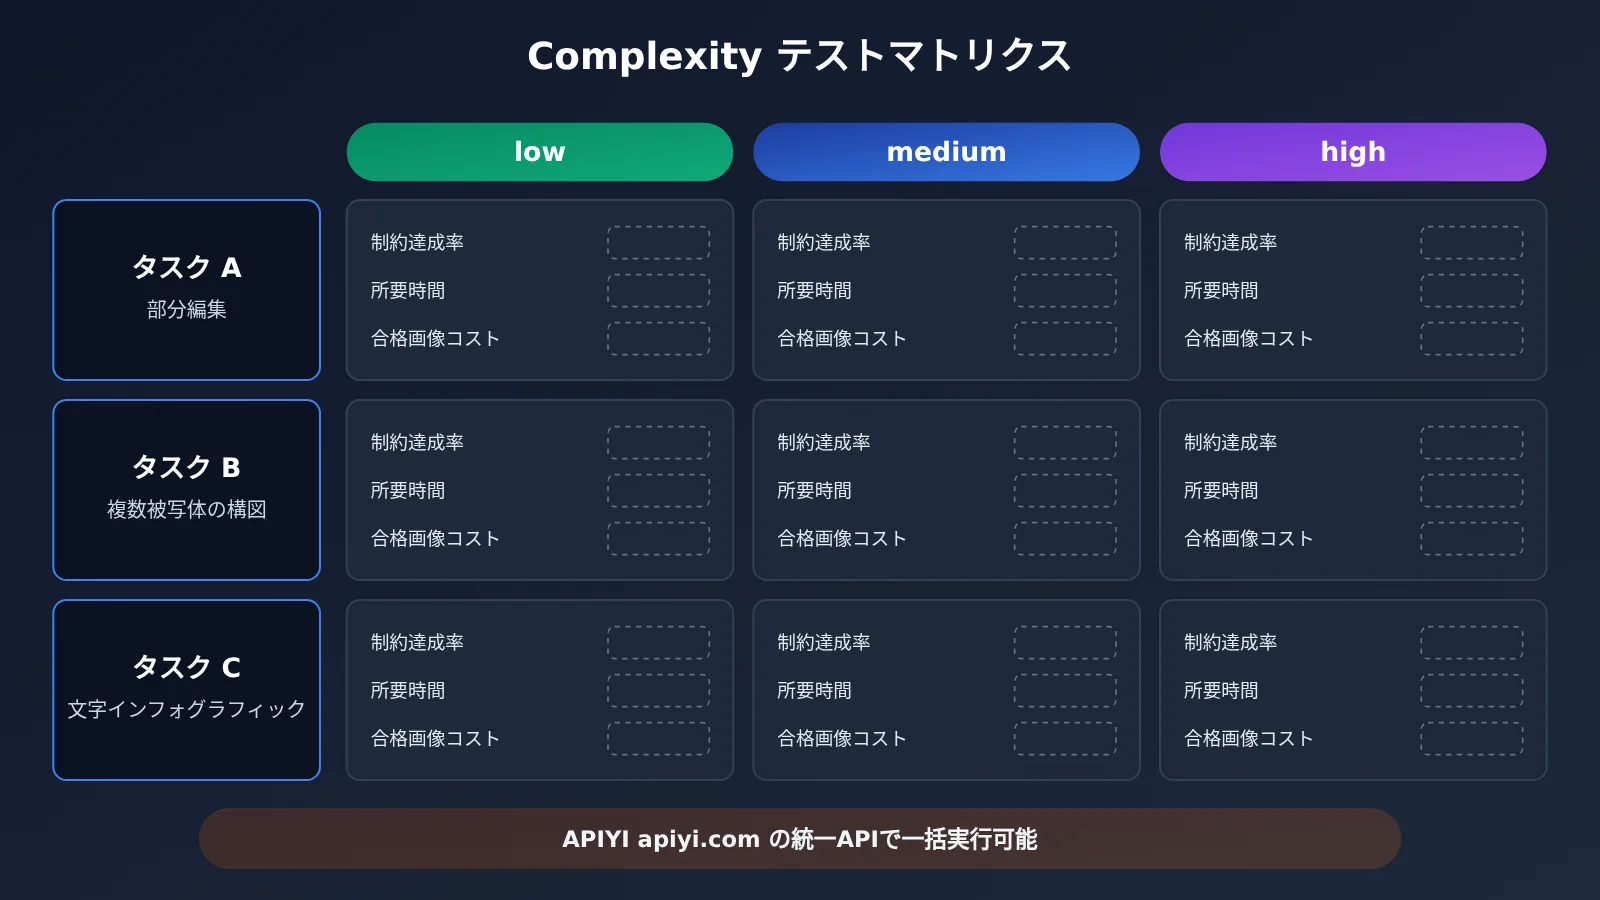
1枚だけの比較では、偶然の影響を受けやすくなります。以下は公式の移行ガイドを参考にしたテスト設計で、チーム内で評価する際の枠組みとして使えます。これは方法の提案であり、実施済みのテストデータは含まれていません。
代表的な3種類のタスク:
- タスク A:シンプルな部分編集。1つのオブジェクトだけを変更し、それ以外は維持する;
- タスク B:複数の被写体を含む複雑な構図。複数のオブジェクトが指定された位置関係を保つ;
- タスク C:文字量の多いインフォグラフィック。指定された構成に従ってラベル、フロー、階層を表現する。
変数の管理:モデル、プロンプト、参照画像、サイズ、出力形式、Quality を固定し、Complexity だけを変更して、各設定で複数回生成します。
| 評価指標 | 測定する内容 | 記録方法 |
|---|---|---|
| 制約の達成率 | プロンプト内の必須要件をいくつ満たしたか | 項目ごとにチェック |
| レイアウトの正確性 | オブジェクトの位置や関係が記述どおりか | 人手で判定 |
| 意図しない変更 | 編集タスクで、変更すべきでない領域が変わっていないか | 元画像と比較 |
| 文字の正確性 | ラベルやタイトルの表記が正しく、はっきり読めるか | 一文字ずつ確認 |
| 生成時間 | リクエスト1回のエンドツーエンドの所要時間 | スクリプトで計測 |
| 合格画像の平均コスト | 総費用 ÷ 合格画像の枚数 | usage を集計 |
特に重視したいのは最後の指標です。ある設定で1回あたりの費用が安くても、合格画像を1枚得るまでに何度も再試行が必要なら、結果的に安くなるとは限りません。単発の費用だけを見るよりも、「合格画像1枚あたりの平均コスト」で比較するほうが、実際のビジネスに近い評価ができます。
GPT Image 2.6のComplexityがもたらす影響
開発者への影響
- 調整するパラメータが1つ増える:これまで画像生成の調整では主にサイズと画質が重視されていましたが、今後は「計画にかける労力」も考慮する必要があります。デフォルトのhighは部分編集のリクエストに必ずしも適していないため、既存のワークフローを移行する際は再評価が必要です。
- 問題を切り分けて調整する:生成結果が思わしくない場合は、まず「構図の問題」か「レンダリングの問題」かを見極めてから、ComplexityとQualityのどちらを調整するか決めましょう。両方のパラメータをやみくもに最大にするのは避けるべきです。
- コストは実際に測定する:Complexityに追加料金はありませんが、各レベルでのトークン使用量の違いは公式には公表されていません。サードパーティのKingy AIによる1回のテストでは、デフォルトのhighを使用した2.6は、2.5よりも処理時間と費用が高くなりました。ただし、両者の計算条件は一致していないため、一般的な結論にはできません。自分の環境で測定する価値があることを示す結果にとどまります。
画像生成製品への影響
- 計画とレンダリングを別々に制御できるようになる:テキストモデルには以前から「推論の強度」のような概念がありましたが、画像モデルでも計画段階を個別に調整できるようになりました。製品設計では、「素早い下書き」と「複雑なレイアウト」に異なるレベルを割り当てることができ、同じ設定を共用する必要がなくなります。
- Highを売りにはできない:公式は、高いレベルを選ぶと遅延や余計な変更が増える可能性があると明言しています。ユーザー向けの製品では、一律に最高レベルを使うのではなく、タスクの種類に応じて自動的にレベルを選ぶほうが適しています。
よくある質問 FAQ
Q1:GPT Image 2.6 の Complexity パラメータとは何ですか?
画像を描画する前に、モデルが制作要件を理解して満たすためにどの程度計画を行うかを制御するパラメータです。low、medium、high から選択でき、2つの 2.6 モデルではどちらもデフォルトが high です。主に構図、オブジェクト間の関係、要素の配置に影響しますが、モデルの内部推論プロセスを読み取ることはできません。
Q2:Complexity と Quality の違いは何ですか?
Complexity は「画面をどう構成するか」、Quality は「どれだけ精細に描くか」を制御する、それぞれ独立したパラメータです。構成は正しいのに小さな文字がぼやける場合は、まず Quality を調整しましょう。要素の配置が繰り返し間違う場合は、Complexity の調整を検討してください。
Q3:Complexity を high に設定すれば、必ず効果が高くなりますか?
必ずしもそうではありません。公式によると、高い設定では処理時間が長くなったり、意図しない追加の変更が生じたりする可能性があります。レイアウトを完全に指定したタスクでは、改善が目立たない場合もあります。正確な部分編集には、まず low を試すことが公式で推奨されています。
Q4:Complexity に追加料金はかかりますか?各設定の料金差はいくらですか?
公式によると、Complexity の調整に個別の追加料金はかかりません。ただし、実際の費用は課金対象のトークン数に基づいて計算されます。3段階それぞれの平均トークン消費量や処理時間の差は公式には公開されていないため、自分のタスクのサンプルを使って「合格画像1枚あたりの平均コスト」を測ることをおすすめします。
Q5:API を使って Complexity の効果を手早く試すにはどうすればよいですか?
1. APIYI apiyi.com に登録し、APIキーと無料テスト枠を取得します;
2. モデル一覧で 2.6 シリーズのモデルが利用可能か、また `complexity` パラメータに対応しているかを確認します;
3. 本記事のスクリプトを使い(base_url は `https://api.apiyi.com/v1` に設定)、ほかのパラメータを固定して Complexity だけを変更し、結果を比較します。
Q6:Complexity にはどのような既知の制限がありますか?
公式が公開している視覚的な比較は1サンプルのみで、現時点では3段階それぞれの大規模サンプルでの成功率、平均遅延、独立した第三者による体系的な比較はありません。また、計画が正しくても文字が必ず鮮明になるとは限らず、複雑なリクエストには長い処理時間がかかることがあります。生成画像を商用利用する前には、引き続き人による確認が必要です。
GPT Image 2.6 Complexity の要点 Key Takeaways
- 定義:Complexity はレンダリング前のシーンの計画にどれだけ処理を割くかを制御するもので、思考の連鎖のオン・オフを切り替えるものではありません。
- 役割分担:Complexity は構図の組み立てを、Quality はレンダリングの精細さを制御します。両者は独立して調整できます。
- 公式事例:切り絵のサッカーチームでは、high に設定すると、看板が観客席に移り、ユニフォームの素材が折り紙に変わりました。
- 最初の設定:部分編集ではまず low を試し、制約の多い複雑な画像では medium と high を比較しましょう。
- デフォルト設定の落とし穴:2つのモデルのデフォルトは high です。既存のワークフローを移行する際は、設定を見直す必要があります。
- コストの考え方:追加料金がないことは、同じ価格を意味しません。「合格画像1枚あたりの平均コスト」で比較する方が確実です。
- 試し方:APIYI apiyi.com の OpenAI 互換インターフェースで、3段階の比較テストを実行できます。
まとめ
GPT Image 2.6 の Complexity パラメータの要点は次のとおりです。
- 変わるのは画面の組み立て方:公式の切り絵の事例では、設定を変えると、ユニフォーム、トロフィー、看板のデザイン上の選択が変わりました。
- Quality とは役割が明確に分かれている:一方は計画を、もう一方はレンダリングを制御します。問題が生じたら、まずどちらに関係するかを判断しましょう。
- 「高いほどよい」わけではない:high は処理が遅くなることも、変更すべきでない箇所を変えてしまうこともあります。タスクの種類に合わせて設定を選びましょう。
画像生成では、最終画像の精細さと、モデルが画面をどう組み立てるかの両方を制御する必要があります。自社の業務サンプルで小規模な比較テストを行い、制約の充足率、意図しない変更、合格画像のコストを基準に設定を選ぶのが合理的です。
まずは APIYI apiyi.com の無料枠で3段階の比較テストを行い、プラットフォームが 2.6 モデルと関連パラメータに対応していることを確認してから、本番ワークフローに組み込むことをおすすめします。
📚 参考資料
- OpenAI公式発表 – Introducing Images 2.6:Images 2.6のリリース告知とComplexityの使用に関する推奨事項
- リンク:
openai.com/index/introducing-images-2-6 -
補足:編集タスクではlow complexityを優先するという公式の推奨が含まれています
-
OpenAI APIドキュメント – GPT Image 2.6 prompting guide:Complexityパラメータの説明と、切り絵のサッカーチームを使った比較例
- リンク:
developers.openai.com/api/docs/guides/image-prompting -
補足:Set image complexity、Compare complexity、Migrate an existing workflowの各セクションを重点的にご覧ください
-
OpenAI APIドキュメント – Image generation:画像生成インターフェースのパラメータ概要
- リンク:
developers.openai.com/api/docs/guides/image-generation -
補足:quality、size、output_formatなどのパラメータの詳細な仕様を確認できます
-
OpenAIモデルページ:FlareとSunburstのモデル詳細
- リンク:
developers.openai.com/api/docs/models/gpt-image-2.6-sunburst - 補足:モデルIDと対応機能を確認できます
著者:APIYI技術チーム
技術に関するお問い合わせ:APIYIのホームページからお気軽にお問い合わせください。その他の接続に関する資料は、docs.apiyi.comのドキュメントセンターをご覧ください