著者注:大規模言語モデル API の請求を、入力・出力・キャッシュ・推論 Token とマルチモーダルの課金項目に分けて解説します。呼び出しログを使った使用量の照合、急な費用増加の原因特定、価格変更への対応方法も紹介します。
月末に請求書を開くと、あるモデルの費用が先月より大幅に増えている。でも、呼び出し回数はほとんど変わっていない。大規模言語モデル API を本番環境で利用しているチームなら、一度は経験したことがあるのではないでしょうか。この記事では、課金項目ごとに分解し、呼び出しログと照合する方法を紹介します。大規模言語モデル API の請求内容を理解し、正しく確認するために役立ててください。
この記事は価格一覧ではありません。各社の価格は頻繁に変わるため、具体的な単価は掲載せず、長く使える課金の考え方と照合のポイントを解説します。
業界の動きを示す一例として、2026 年 11 月に、ある AI インフラ企業が大規模言語モデルのプラットフォーム運営担当者を募集していました。その職務には「コストと請求の検証」が明記され、入力/出力 Token、キャッシュ Token、推論 Token、画像や音声・動画などの課金基準を確認し、異常な請求、価格変更、請求額のずれを速やかに発見することが求められていました。プラットフォーム側が専任者を必要とするほど、課金の仕組みは複雑なのです。利用する側にも、自分たちなりの照合習慣が必要です。
この記事で得られること:大規模言語モデル API の請求に含まれる各課金項目の内訳を理解し、呼び出しログで使用量を照合できるようになります。また、「同じリクエストなのに費用が急に変わった」原因も素早く特定できるようになります。
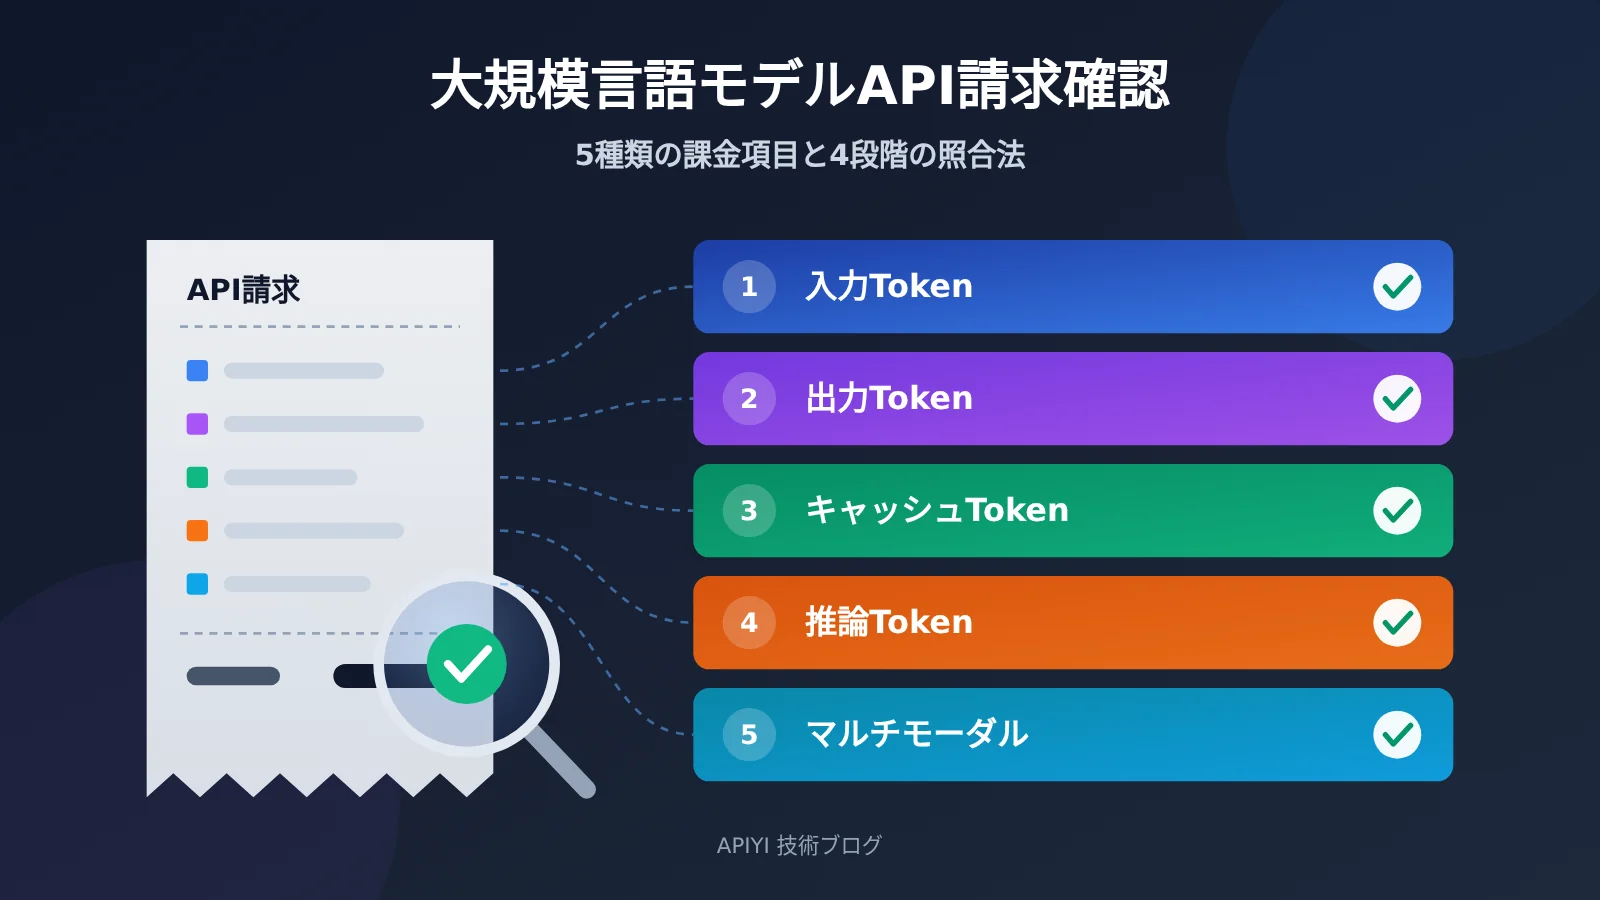
大規模言語モデル API の請求を理解する:5つの課金項目
1回のモデル呼び出しの費用は、通常「呼び出し回数 × 単価」ほど単純ではありません。課金項目ごとに単価も発生源も異なります。まとめて見てしまうと、コストの内訳を見誤りかねません。
| 課金項目 | 発生源 | 一般的な料金体系 | 請求確認のポイント |
|---|---|---|---|
| 入力 Token | システムプロンプト、会話履歴、ツール定義、検索で取得した文書、ユーザー入力 | Token 単位で課金。通常は出力より安い | コンテキストが知らないうちに長くなっていないか |
| 出力 Token | モデルが生成した、ユーザーに見える返信 | Token 単位で課金。通常は入力より単価が高い | 返信の長さ、max_tokens の設定 |
| キャッシュ Token | キャッシュにヒットした入力プレフィックス | ヒットした部分は割引されることが多い。一部のベンダーは書き込みに別途課金 | ヒット率が下がっていないか |
| 推論 Token | 推論モデルの内部的な思考プロセス | 通常は出力として課金されるが、返信に表示されるとは限らない | 推論が長くなっていないか |
| マルチモーダル課金 | 画像、音声、動画の入力または生成 | 枚数、秒数、解像度に応じた課金、または Token に換算 | 仕様のパラメータが変わっていないか |
大規模言語モデル API の請求が「合わない」と感じやすい理由
1つ目の理由は、目に見えない Token です。コードにはユーザーの質問を一文書いただけでも、実際に送信されるリクエストには、数千 Token 分のシステムプロンプトや複数ターンの会話履歴、ツールの Schema が含まれていることがあります。推論モデルでは、ユーザーには見えない思考用の Token も大量に生成されます。これらは画面には表示されませんが、すべて請求の対象になります。
2つ目の理由は、計算方法が統一されていないことです。同じ「画像入力」でも、枚数で課金するベンダーもあれば、解像度を Token に換算するベンダーもあります。同じ「キャッシュ」でも、自動でキャッシュするベンダー、明示的な指定が必要なベンダー、読み取りのみを割引するベンダー、書き込みにも追加料金を請求するベンダーがあります。モデルやベンダーをまたいで比較する際は、まず計算方法をそろえる必要があります。
3つ目の理由は、条件が変動することです。モデルのエイリアスが新しいバージョンを指すようになったり、プロンプトのプレフィックスを少し変更しただけでキャッシュがすべて無効になったりすることがあります。また、推論モデルは難しい問題に直面すると、より長く思考します。単価が変わらなくても、請求額は変わり得ます。
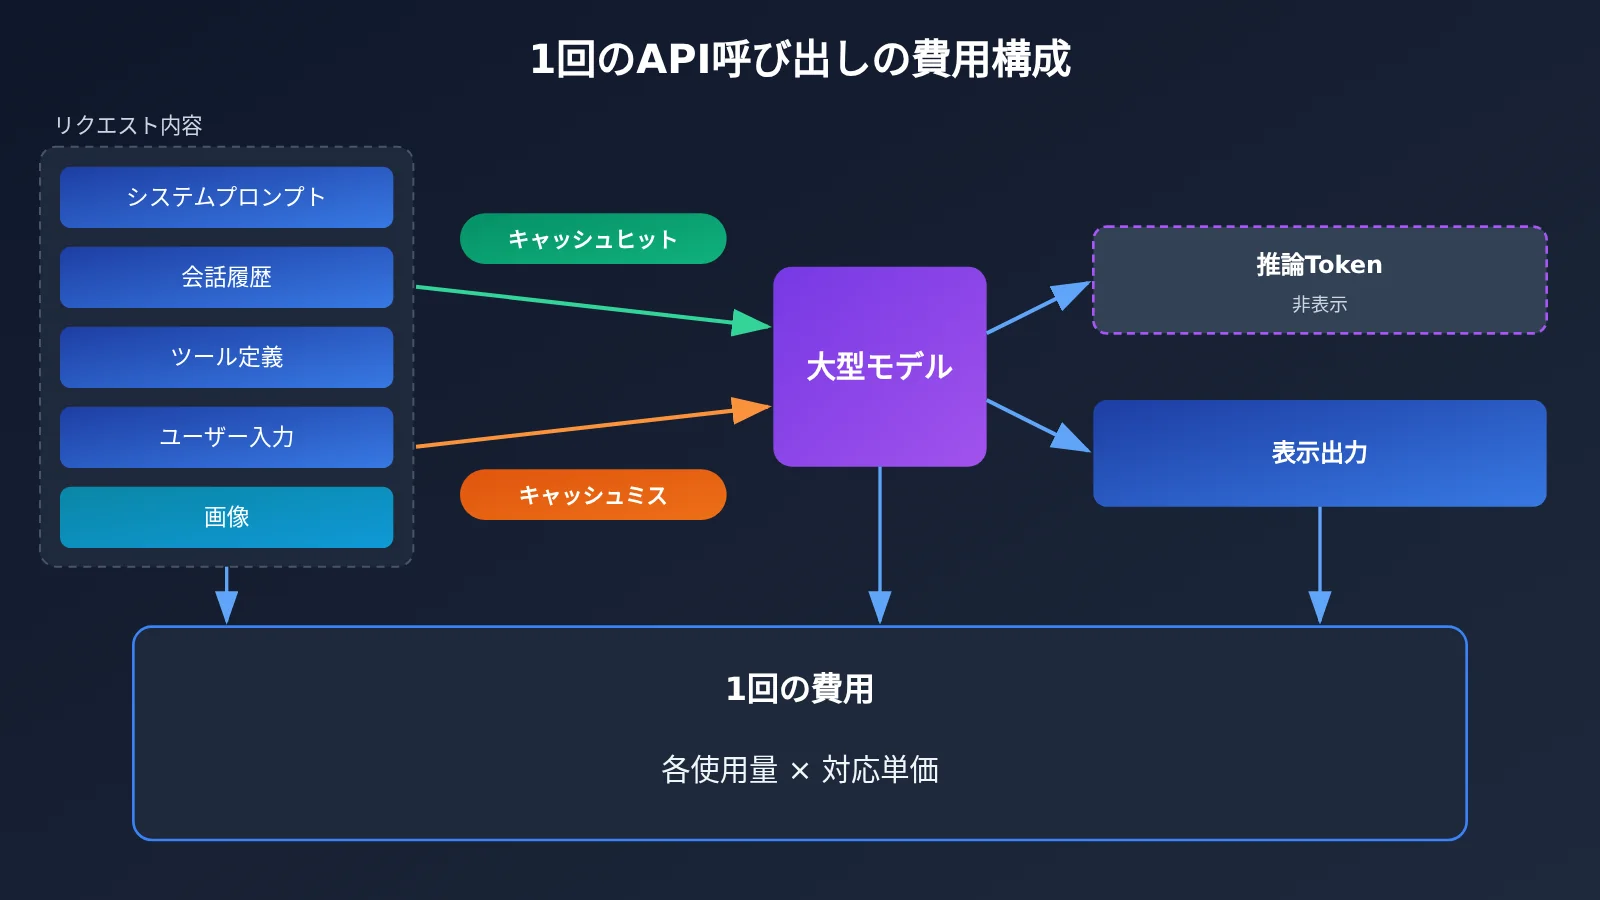
大規模言語モデルのAPI請求における各課金項目の詳細
入力トークン:最も過小評価されやすい項目
入力トークンとは、モデルが今回のリクエストで「読み取る」すべての内容を指します。ユーザーが入力した一言だけではありません。複数ターンの会話では、各ターンでそれまでの会話履歴が再送されます。会話が長くなるほど1ターンあたりの入力コストは高くなり、総コストはターン数の2乗に近いペースで増加します。
RAGアプリケーションも、入力トークンを多く消費します。検索で取得する文書の断片の数や、それぞれの長さが入力コストに直結します。Function Callingでは、ツール定義のJSON Schemaがリクエストごとに入力として計上されるため、ツールが多いほど固定的なコストも大きくなります。
また、モデルによってトークナイザーが異なる点にも注意が必要です。同じ中国語の文章でも、モデルによってトークン数が大きく異なる場合があります。あるモデルのトークン数を使って、別のモデルの料金を見積もることはできません。
出力Token:単価が高く、パラメータで直接制御できる
出力Tokenは、モデルが生成する回答の内容です。多くのプロバイダーでは出力単価が入力単価よりも明らかに高いため、「モデルに余計なことを言わせない」ほうが、入力を圧縮するよりも節約につながる場合が多くあります。
max_tokens は出力コストの上限を設定するものですが、その範囲に収まることを保証するものではありません。回答が途中で切れた場合も、生成済みの部分には料金が発生します。ストリーミング出力が途中で切断された場合、生成済みTokenの扱いはプラットフォームによって異なることもあるため、公式の説明を確認してください。
キャッシュToken:ヒットして初めて節約できる
プロンプトキャッシュの仕組みは次のとおりです。複数のリクエストで同じプレフィックス(たとえば、同じシステムプロンプトや長い文書)を共有している場合、プロバイダーは処理済みの部分を再利用し、その部分の入力料金を割引できます。
キャッシュには、確認しておきたい一般的なルールがいくつかあります。
- 自動で有効になるか:デフォルトで有効にするプロバイダーもあれば、リクエスト内でキャッシュ位置を明示する必要があるプロバイダーもあります;
- プレフィックスの一致条件:通常、先頭から一字一句一致している必要があり、プレフィックスのどこか一箇所でも変わると、それ以降はすべて無効になります;
- 最小長と有効期限:短すぎるプレフィックスはキャッシュされない場合があり、有効期限が切れると再度書き込む必要があります;
- 書き込みに料金がかかるか:初回のキャッシュ書き込みに通常の入力より高い料金を設定し、以降の読み取りだけを安くするプロバイダーもあります。
料金を照合する際は、「キャッシュ読み取りToken」と「通常の入力Token」を分けて集計しましょう。そうしないと、キャッシュヒット率の低下を呼び出し量の増加と誤認してしまいます。
推論トークン:見えなくても料金がかかる
推論モデルは回答を出す前に内部で思考を行い、この部分のトークンには通常、出力単価が適用されます。多くの場合、推論内容はすべて返されるわけではなく、使用量フィールドでトークン数だけを確認できます。
推論トークンの数は、質問の難易度や推論の強度を指定するパラメータによって変わります。同じAPIでも、ユーザーの質問が難しくなれば請求額が増える可能性があります。シンプルな分類や形式変換だけが必要な場合、推論モデルを使うと、不要な思考に料金を払うことになりがちです。
マルチモーダルの課金:「何を基準に課金されるか」を確認
マルチモーダルの課金基準は違いが大きいため、モデルごとに公式の料金ページを確認することが特に重要です。以下は一般的な課金方式です。具体的なルールは各社が現在公開している情報を確認してください。
| 種類 | 一般的な課金方式 | 料金に影響する主なパラメータ | 確認のポイント |
|---|---|---|---|
| 画像入力(理解) | 解像度をトークンに換算、または枚数単位 | 画像サイズ、詳細度のパラメータ | アップロード前後の実際の解像度を記録する |
| 画像生成 | 枚数単位、または出力トークン単位 | サイズ、品質グレード、生成枚数 | リクエストごとの仕様パラメータを記録する |
| 音声入力/出力 | 時間単位、または音声トークンに換算 | 音声の長さ、サンプリングの処理方法 | 音声の実際の長さを記録する |
| 音声合成 | 文字数またはトークン単位 | テキストの長さ、音声のグレード | 合成するテキストの長さを記録する |
| 動画生成/理解 | 秒数、フレーム数、または解像度のグレード単位 | 長さ、解像度、フレームレート | 長さと解像度の組み合わせを記録する |
| Embedding | 入力トークン単位 | テキストの長さ、バッチサイズ | 通常の入力単価とは分けて集計する |
🎯 技術的なアドバイス:マルチモーダルを利用する際は、さまざまな課金基準をまとめて管理できるよう、入口を一本化するのがおすすめです。APIYI apiyi.com の公式紹介によると、プラットフォーム上のモデルは共通の残高で利用でき、使用量の統計や呼び出しログも提供されています。まずコンソールでログに表示される項目を確認し、そのうえで照合表に追加で記録するパラメータを決めるとよいでしょう。
大規模言語モデル APIの請求確認:4ステップで照合
請求を照合する基本的な考え方は、自分で記録した使用量 × 記録時点の単価から想定費用を算出し、プラットフォームの請求額と比較することです。差額が許容範囲を超えたら、項目ごとに原因を調べます。
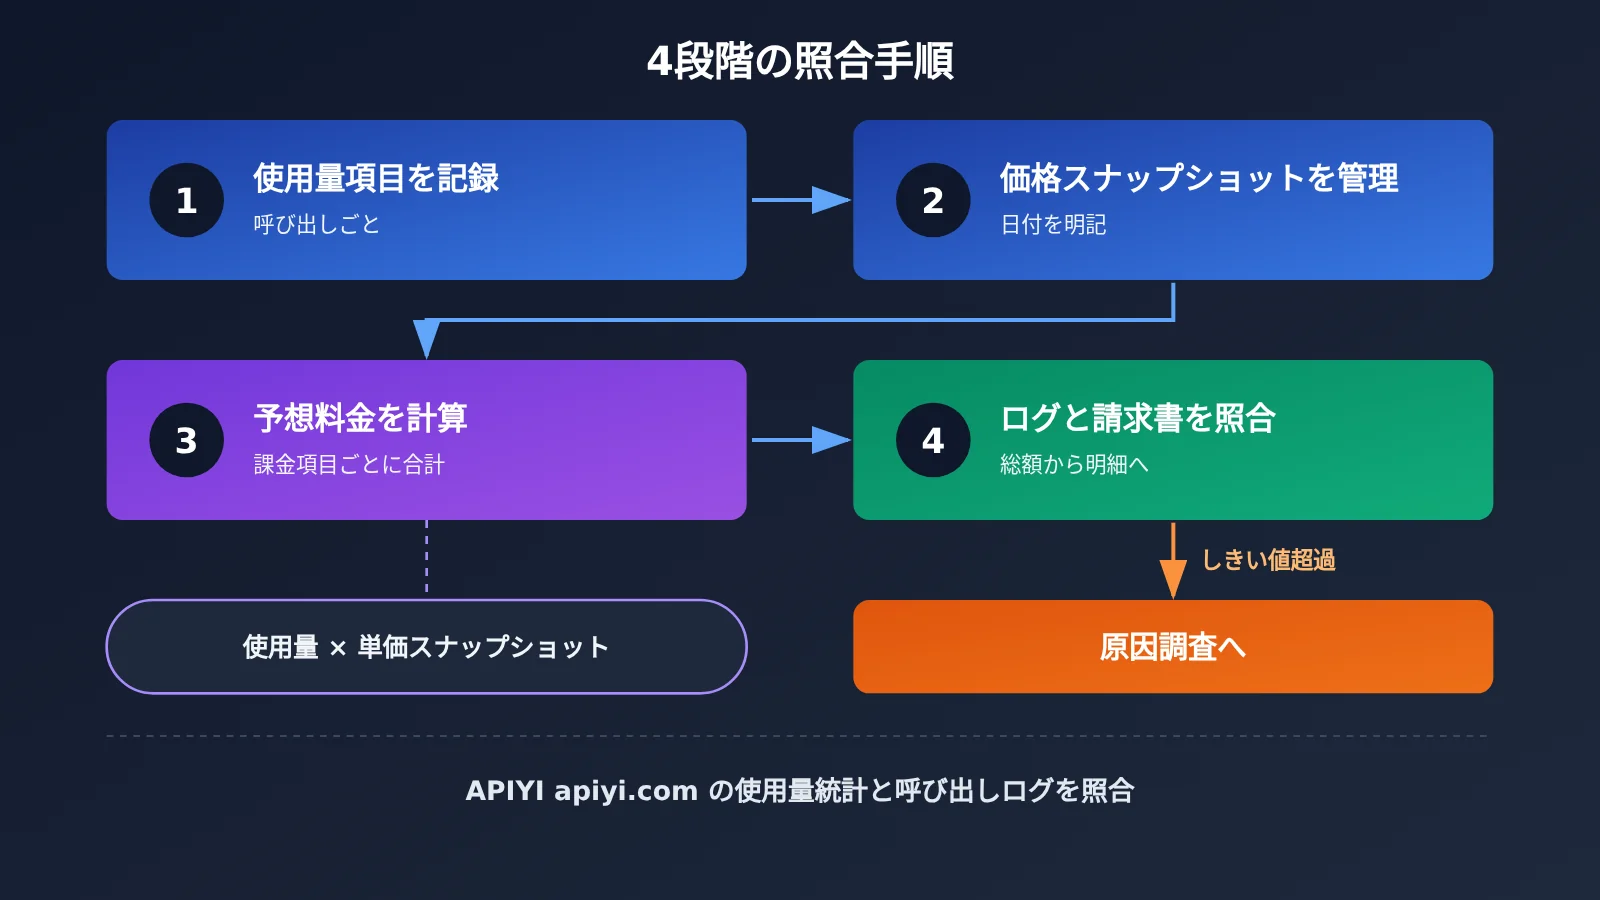
ステップ1:呼び出しごとに使用量フィールドを記録する
OpenAI互換形式のインターフェースでは、通常、レスポンスに usage オブジェクトが返されます。主なフィールドとその意味は以下のとおりです。モデルやプラットフォームによって返される内容が異なる場合があるため、導入前に一度リクエストを送って確認しましょう。
| フィールド(OpenAI互換形式での一般的な表記) | 意味 | 対応する課金項目 |
|---|---|---|
prompt_tokens |
今回のリクエストにおける入力Tokenの総数 | 入力(キャッシュ部分を含む) |
prompt_tokens_details.cached_tokens |
入力のうちキャッシュにヒットした部分 | キャッシュ読み取り |
completion_tokens |
出力Tokenの総数 | 出力(推論部分を含む場合あり) |
completion_tokens_details.reasoning_tokens |
出力のうち推論に使われた部分 | 推論 |
model |
実際にレスポンスを返したモデル名 | バージョン変更の識別に使用 |
各呼び出しについて、少なくとも以下の情報をデータベースに保存することをおすすめします。
- リクエスト時刻、リクエストID、業務シナリオの識別子
- リクエストで指定したモデル名と、レスポンスで返された
model - 上表のすべての使用量フィールド。欠けているフィールドは0ではなく空として記録
- 画像サイズ、音声の長さ、生成数など、マルチモーダルリクエストの仕様パラメータ
- ストリーミングの有無、リトライの有無、出力が途中で切れたかどうか(
finish_reason)
prompt_tokens と completion_tokens は多くの場合「総数」であり、キャッシュと推論はその内訳です。費用を計算する際は、まず総数から内訳を差し引き、それぞれに対応する単価を掛けましょう。そうしないと、二重計算や割引の計算漏れが生じます。
ステップ 2:日付付きの価格スナップショットを管理する
コードに単価をハードコードするのは避けましょう。価格スナップショットの表を用意し、各行にモデル名、課金項目、単価、通貨、適用開始日、出典(公式料金ページやプラットフォームのお知らせ)を記録することをおすすめします。
価格が改定されたら、古い値を上書きせず、新しい行を追加します。こうすることで、過去の任意の日の請求を確認する際に、当時の価格で再計算できます。APIYI のような集約プラットフォーム経由でモデルを呼び出す場合は、そのプラットフォームが現在公表している単価を使い、確認日も記録しましょう。
ステップ 3:想定費用を計算する
1回あたりの想定費用は、次の項目に分けて合算できます。
- キャッシュにヒットしなかった入力 Token × 入力単価
- キャッシュ読み取り Token × キャッシュ読み取り単価(キャッシュ書き込みにも課金される場合は、その費用を別途加算)
- 可視出力 Token × 出力単価
- 推論 Token × 推論に対応する単価(多くの場合は出力単価と同じですが、公式の説明を確認してください)
- マルチモーダル部分は、それぞれの課金基準に従って個別に計算
これらを日別、モデル別、業務シナリオ別に集計すれば、「本来いくらかかるはずか」を示す台帳ができます。
ステップ 4:プラットフォームのログと請求額を照合する
自分の記録をプラットフォームの利用統計や呼び出しログと照らし合わせます。まず合計額、次にモデル別の金額を比較し、最後に個々のリクエストまで確認しましょう。
許容範囲となるしきい値を設けるのがおすすめです。為替レート、課金精度、集計タイムゾーンなどの違いによって小さな差が生じることはよくあるため、しきい値を超えた分を一つずつ調査します。
🚀 クイックスタート:すでに APIYI apiyi.com でモデルを呼び出している場合は、まず一定期間の呼び出しログをエクスポートし、自分で記録した
usageフィールドと1件ずつ照合しましょう。ログでキャッシュ Token と推論 Token が個別に区別されているかどうかは、プラットフォームが現在提供しているフィールドを確認してください。個別に記載されていない場合は、ローカルに記録したレスポンスのフィールドを明細の根拠にします。
大規模言語モデル API の請求額に異常があるとき:費用の急変をどう調べるか
同じ種類のリクエストで費用が急に変わった場合は、特に注意が必要です。以下の表に、よくある原因と調査の方向性をまとめました。
| 異常の内容 | 考えられる原因 | 調査方法 |
|---|---|---|
| 呼び出し回数は変わらないのに、1回あたりの費用が増えた | モデルのエイリアスが新しいバージョンを指すようになり、単価や Token 消費量が変わった | レスポンスの model フィールドが変わっていないか比較する |
| 入力 Token の総数は変わらないのに、入力費用が増えた | キャッシュヒット率が低下した | cached_tokens の割合を確認し、プロンプトのプレフィックスが変更されていないか調べる |
| 表示される回答の長さは変わらないのに、出力費用が増えた | 推論 Token が増加した | reasoning_tokens の推移を確認し、推論の強度に関するパラメータを調べる |
| 入力 Token が継続的に少しずつ増えている | 対話履歴が切り詰められていない、検索で取得する断片が増えた、ツール定義が増えた | 完全なリクエスト本文をサンプルで確認する |
| 呼び出し回数が業務上の処理件数より多い | クライアントによるリトライ、タイムアウト後の再送 | リクエスト ID と業務 ID で重複を除いて集計する |
| 画像や動画の費用が急増した | 解像度、品質レベル、生成数が引き上げられた | リクエスト内の仕様パラメータを比較する |
| 請求単価がスナップショットと一致しない | 公式またはプラットフォームが価格を改定した | 料金ページとお知らせを確認し、料金のスナップショットを更新する |
キャッシュの無効化:最も気づきにくいコスト増
キャッシュの無効化は、一見問題なさそうな変更が原因で起こることがよくあります。例えば、システムプロンプトの冒頭に現在の日付を追加したり、プレフィックスにユーザー ID を挿入したりするケースです。これではリクエストごとにプレフィックスが異なるため、キャッシュがすべて無効になり、入力コストは通常料金に戻ってしまいます。
固定の内容を先頭に置き、変動する内容を最後に置くのが正しい方法です。プロンプトテンプレートを変更した翌日には、キャッシュヒット率に変化がないか確認しましょう。
推論の長さの変動:問題の難易度も請求額に影響する
推論モデルの費用は、問題の難易度に左右されます。ある日にユーザーから複雑な質問が集中すれば、推論 Token は大きく増えますが、これは正常な変動です。一方、リクエストの種類が変わっていないのに推論 Token が継続的に増えている場合は、モデルのバージョンや推論パラメータが変更されていないか確認しましょう。
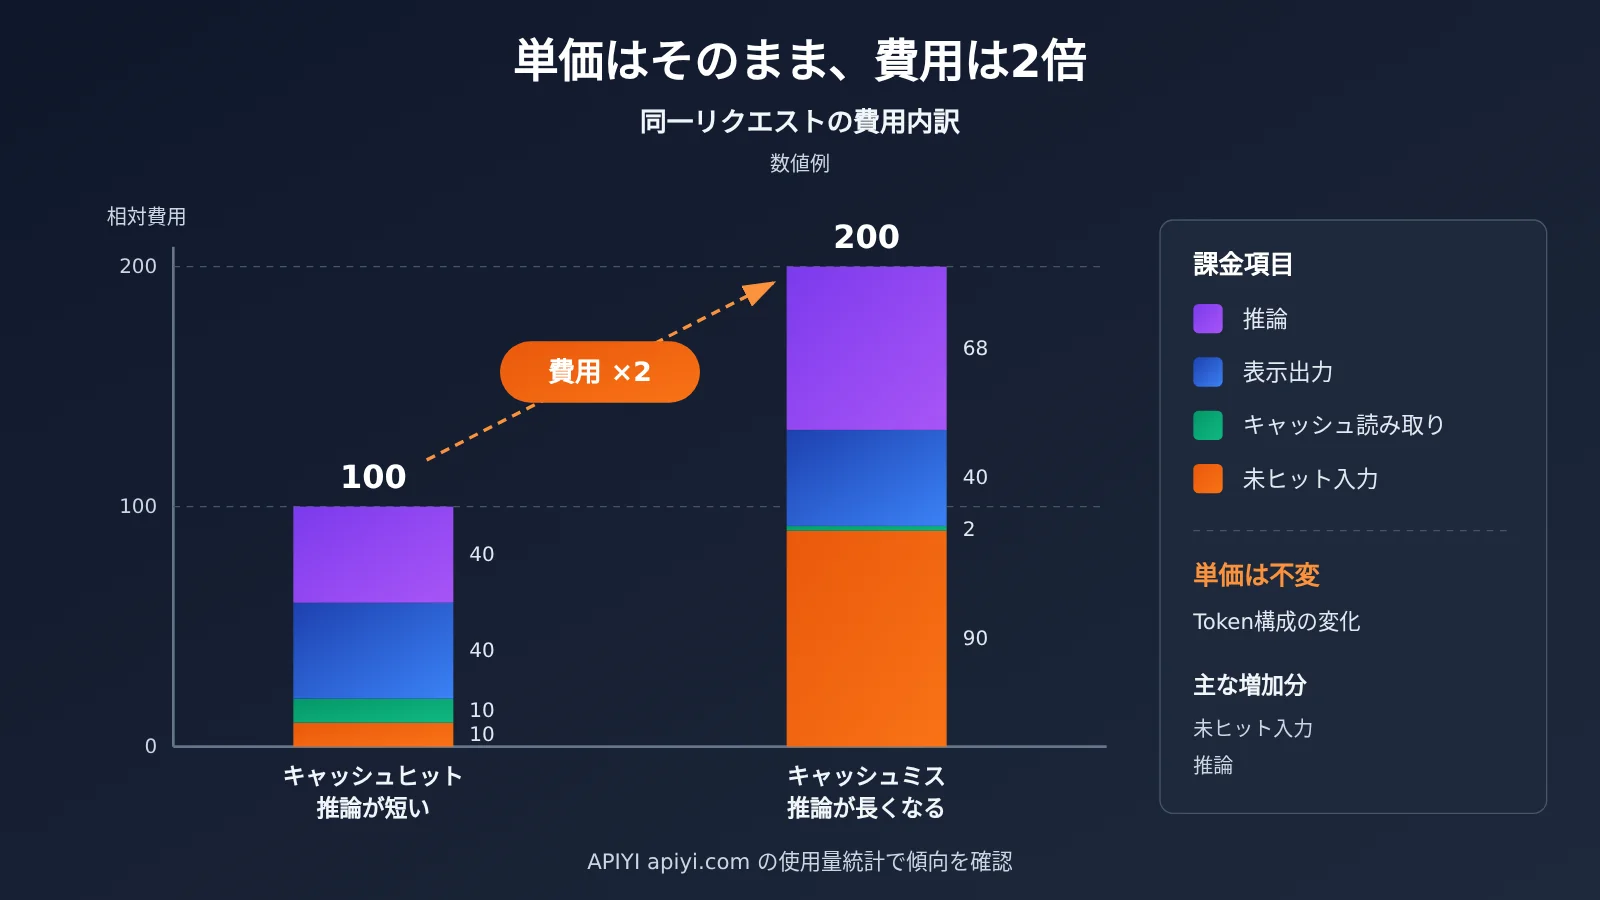
大規模言語モデル APIの料金変動に備えるチェック習慣
料金の変動そのものはコントロールできませんが、早めに気づくことはできます。以下は、長く続けやすいチェック習慣です。
- 毎週:モデル別の費用推移と1回あたりの平均コストを確認し、急な変化がないかチェックする;
- 毎月:請求額を一通り照合し、差額がしきい値を超えた項目は、一つずつ原因を調べる;
- プロンプトテンプレートを変更するたびに:1〜2日間、キャッシュヒット率を確認する;
- モデルの切り替えやアップグレードの前に:少量のリクエストで新旧モデルのToken消費量と費用を比較する;
- お知らせを確認する:利用しているベンダーやプラットフォームの料金・モデル更新に関するお知らせを購読し、受け取ったらすぐに価格スナップショットを更新する;
- バージョンを固定する:本番環境では、できるだけ具体的なバージョン番号を含むモデル名を使用し、エイリアスの自動更新による予期せぬ変更を避ける。
💡 選び方のヒント:複数のベンダーのモデルを業務で使っている場合、アカウントごとに請求額を照合するには多くの時間がかかります。APIYI apiyi.com を通じて一元的に接続すれば、残高やログを共通化し、異なるモデルの使用量を確認できるため、1回あたりのコストを横並びで比較しやすくなります。確認できる明細の項目については、事前にコンソールで確かめることをおすすめします。
よくある質問 FAQ
Q1:大規模言語モデルのAPI請求におけるTokenとは何ですか?
Token(トークン)は、モデルがテキストを処理する際の基本単位で、テキストを分割した断片と考えることができます。中国語の漢字1文字が1つ以上のTokenに対応する場合があり、具体的な数はモデルのトークナイザーによって異なります。請求は通常、入力、出力、キャッシュ、推論など、Tokenの種類ごとに数量に応じて計算されます。
Q2:キャッシュTokenと通常の入力Tokenにはどのような違いがありますか?
どちらも入力に含まれますが、キャッシュTokenはキャッシュ済みのプレフィックスに一致した部分で、通常は割引価格が適用されます。通常の入力Tokenは標準価格で課金されます。初回のキャッシュ書き込みに別途料金がかかるプロバイダーもあるため、請求額を照合する際は、この3つを分けて集計しましょう。
Q3:推論Tokenが返信に表示されないのはなぜですか?
推論Tokenはモデル内部の思考によって生成されます。多くのモデルは推論過程の全体を呼び出し元に返さず、使用量フィールドに数量だけを示します。通常は出力単価で課金されるため、返信が短くても費用が高くなる場合があります。
Q4:同じリクエストの費用が突然変わるのはなぜですか?
主な原因は、モデルのエイリアスが新しいバージョンを指すようになった、プロンプトのプレフィックスが変わってキャッシュが使われなくなった、推論が長くなった、の3つです。そのほか、リトライによる重複課金や、マルチモーダルの仕様パラメータが大きく設定されたことも考えられます。本文の異常シグナル表に沿って一つずつ確認すれば、原因を特定できます。
Q5:プラットフォームのログを使って、大規模言語モデルのAPI請求を照合するにはどうすればよいですか?
まず、自分のシステムで各レスポンスの `usage` フィールドとリクエストIDを記録します。次に、プラットフォームの呼び出しログをエクスポートし、リクエストごとに照らし合わせます。たとえばAPIYI(apiyi.com)では、コンソールで使用量の統計と呼び出しログを確認できます。まずログにどのフィールドが含まれているかを確認し、ローカルの記録と突き合わせましょう。
Q6:マルチモーダルモデルの費用はどのように見積もればよいですか?
まず公式の料金ページで、枚数単位、秒数単位、解像度に応じたTokenへの換算など、課金方式を確認します。次に、画像サイズ、音声の長さ、動画の解像度と長さなど、対応する仕様パラメータをリクエストログに記録し、それぞれに単価を掛けて見積もります。
Q7:請求額の照合で差異が見つかった場合、まずどこを確認すればよいですか?
まず料金のスナップショットが最新かどうかを確認し、価格改定の影響を除外します。次に呼び出し回数を比較し、リトライや重複リクエストがないかを確認します。最後に差異をモデル別・課金項目別に分け、入力、キャッシュ、推論、マルチモーダルのどの部分で差が生じているかを特定します。
Q8:この照合方法にはどのような限界がありますか?
この方法はレスポンスに返される使用量フィールドに依存します。モデルやインターフェースによってはキャッシュや推論の内訳が返されないため、その場合はプラットフォームの請求明細に頼るしかありません。また、為替レート、課金の精度、集計タイムゾーンによって小さな差が生じることもあります。完全な一致を目指すのではなく、合理的なしきい値を設定しましょう。
大規模言語モデル API の請求を理解するためのポイント Key Takeaways
- 料金は複数の課金項目で構成される:入力、出力、キャッシュ、推論、マルチモーダルの単価はそれぞれ異なるため、分けて集計しましょう。
- 入力トークンはユーザーの質問だけではない:システムプロンプト、会話履歴、検索された文書、ツールの定義も入力に含まれます。
- キャッシュヒットにはプレフィックスの一致が重要:固定内容を前に、変動する内容を後ろに配置し、テンプレートの変更後はヒット率を確認しましょう。
- 推論トークンは見えなくても課金される:単純なタスクでは推論モデルの使用を避け、推論長の推移に注目しましょう。
- マルチモーダルはまず「何を基準に課金されるか」を確認:枚数、秒数、解像度など、課金基準は公式の料金ページで確認しましょう。
- 照合は4ステップで:使用量を記録し、料金のスナップショットを管理し、想定費用を計算して、ログや請求書と照合します。
- 統一された窓口があると照合しやすい:APIYI apiyi.com の共通残高と呼び出しログを利用すれば、複数モデルの使用量をまとめて確認できます。
まとめ
大規模言語モデル API の請求内容を理解し、照合するためのポイントは次の3つです。
- 分けて確認する:1回の呼び出しにかかる費用を入力、キャッシュ、出力、推論、マルチモーダルに分け、それぞれの発生源を確認します。
- 自分で記録する:呼び出しごとに使用量の各項目と仕様パラメータをデータベースに保存し、日付付きの料金スナップショットを管理します。
- 定期的に照合する:毎週推移を確認し、毎月総額を照合します。費用が急変した場合は、モデルのバージョン、キャッシュヒット率、推論長、リトライ、仕様パラメータを一つずつ調べましょう。
プラットフォームの運営側はこうした課金基準を専門的に検証していますが、利用する側も自分で照合する習慣を身につけることが大切です。複数の提供元のモデルを同時に利用する場合は、APIYI apiyi.com を通じて統一的に接続する方法がおすすめです。一つのコンソールで使用量と呼び出しログを確認し、この記事の方法と組み合わせて照合できます。
📚 参考資料
- V2EX の求人投稿:AI Agent インフラ企業の大規模言語モデルプラットフォーム運用職:職務内容に「コストと請求の検証」が記載されています
- リンク:
v2ex.com/t/1254263 -
説明:2026-11-03 公開。プラットフォーム側で入力/出力トークン、キャッシュトークン、推論トークン、画像・音声・動画などの課金基準を検証し、請求の異常、価格の変動、課金のずれを発見する業務が記載されています
-
各モデル提供元の公式料金ページ:具体的な単価と課金ルールについての唯一の信頼できる情報源です
- リンク:利用する提供元の公式サイトにある料金ページまたはドキュメントをご確認ください
- 説明:料金は頻繁に変更されるため、引用する際は必ず確認日を記録してください
著者:APIYI 技術チーム
技術に関するお問い合わせ:大規模言語モデルのAPI請求の照合についてご不明な点があれば、APIYIのホームページ apiyi.com からお気軽にお問い合わせください。連携に関する詳しい資料は、docs.apiyi.com のドキュメントセンターをご覧ください