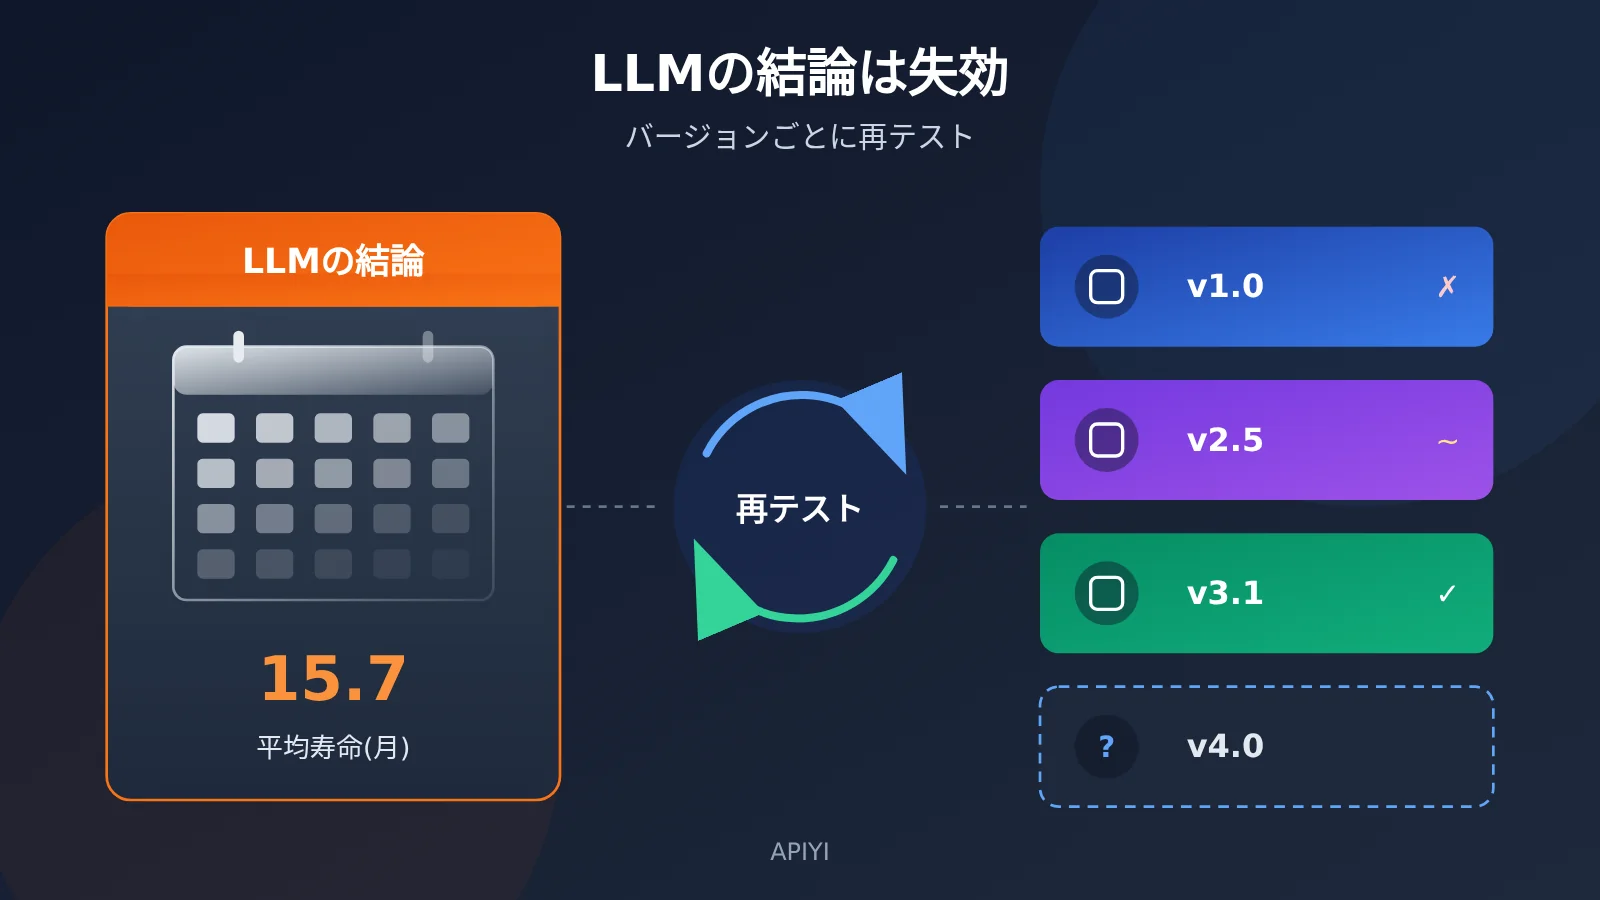
著者注:スタンフォード大学の研究によると、LLMに関する広く知られた結論の44%はすでに有効ではなく、その平均寿命はわずか15.7か月でした。この記事では、この研究をもとに、開発チームがすぐに使えるモデル選定時の再テストチェックリストを紹介します。
「あるモデルは strawberry に r がいくつあるか数えられない」「長いコンテキストでは途中の情報が失われる」「モデルは参考文献を捏造しがちだ」。こうした話を、論文や技術系のコミュニティ、モデルの選定会議で何度も耳にしたことがあるかもしれません。スタンフォード大学の研究者 Owen Queen と James Zou は、広く引用されているLLMに関する50の結論を20のモデルで再検証し、44%がすでに有効ではなく、有効でなくなった時期を推定できた結論の平均寿命は15.7か月にすぎないことを明らかにしました。
これは、単に「モデルはますます強くなっている」と語る記事ではありません。 この研究は、どの種類の結論が最も早く有効でなくなるのか、どの種類の結論が長く有効であり続けるのか、そして同世代のモデル間にどれほどの差があるのかを、具体的なデータで示しています。この記事では、研究者が学術界に向けて示した提案を、開発チームがモデル選定時に実践できる手順に置き換えて紹介します。
この記事のポイント:読み終える頃には、「モデルはXが苦手」という主張のうち、どのようなものが特に頼りにならないのかがわかります。そして、「モデル名、バージョン、日付を記録し、プロンプトを保存して、選定対象のモデルで再テストする」という選定習慣を身につけられます。
LLMに関する結論の陳腐化:研究の要点
まずは、この研究で特に重要な数字を表で確認しましょう。研究に使用されたモデルは、8つの開発元が2024年7月から2026年9月にかけてリリースしたものです。関連報道は2026年11月3日に公開されました。
| 要点 | 研究データ | モデル選定への意味 |
|---|---|---|
| 結論が陳腐化した割合 | 50件の結論のうち、44%が陳腐化し、34%は効果が大幅に弱まった | ネット上で語られるモデルの欠点の多くは、そのまま引用できなくなっている |
| 引き続き成り立つ割合 | 16%のみが維持され、6%はむしろ効果が強まった | 一部の「根強い」傾向には長期的な注意が必要 |
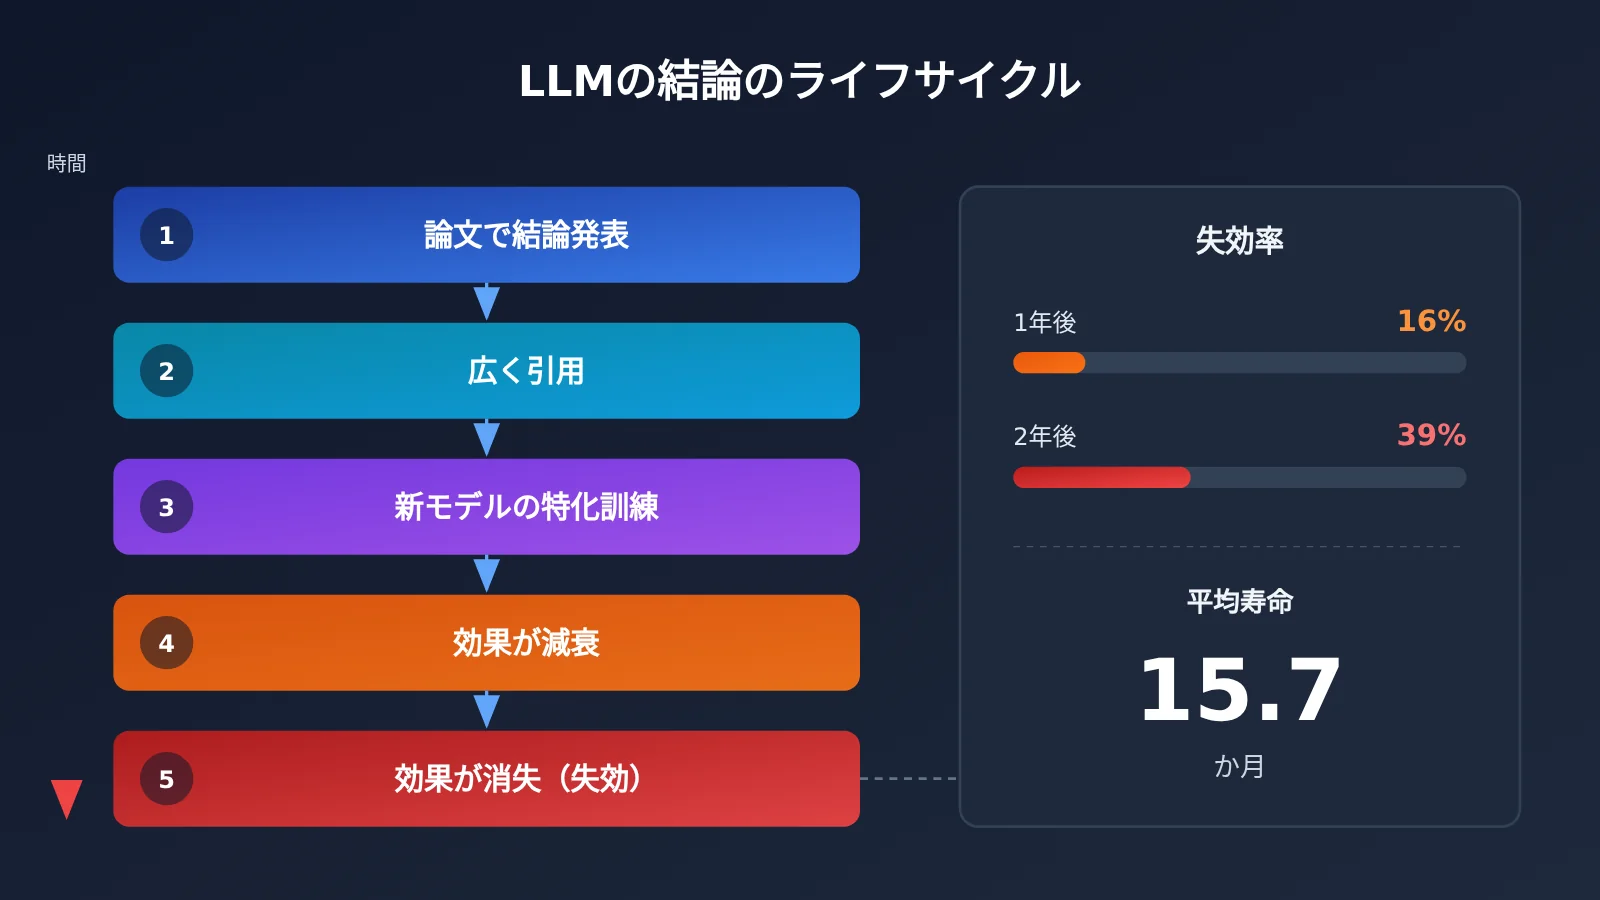
| 平均寿命 | 陳腐化までの期間を推定できた22件の結論では、平均15.7か月 | 1年以上前の評価結果は、割り引いて見る必要がある |
| 時間の経過による累積 | 1年後に16%が陳腐化し、2年後には39%に上昇 | 結論が古いほど、再検証の必要性が高まる |
| 同世代モデルの違い | 2026年7〜9月にリリースされたモデルでは、陳腐化した結論の数が11〜30件と幅がある | リリース時期だけで能力を推測することはできない |
LLMに関する結論の陳腐化についての2つの重要な発見
1つ目は、「陳腐化」の意味です。この研究では、元の結論の根拠となった効果が、新しいモデルではほぼ消失している状態を「陳腐化」と呼んでいます。単に程度が改善しただけではありません。さらに34%の結論では、効果が「大幅に弱まった」とされています。つまり、問題は残っているものの、その程度は元の論文で述べられたほど深刻ではなくなっています。両者を合わせると、広く知られている結論の約8割は、現在のモデルにそのまま当てはめることができません。
2つ目は、結論の「寿命」がその種類と強く関係していることです。モデルに「何ができないか」を示す能力の欠陥に関する結論は、最も早く陳腐化します。一方、モデルが「どのように振る舞う傾向があるか」を示す選好に関する結論は、より長く残ります。研究者はその理由を、次のように説明しています。能力に関する誤りには通常「正解」があり、開発元は明確な学習目標に向けて改善できます。一方、選好や傾向には標準的な正解がないため、修正するのが難しいのです。
特に古くなりやすい LLM に関する結論
再検証の優先順位を決めるには、結論の種類を理解することが前提です。以下の表は、研究に関する報道をもとに、代表的な結論を「古くなりやすいもの」と「比較的長く有効なもの」に分けたものです。
| 結論の種類 | 代表例 | 研究での状況 | 再検証の優先度 |
|---|---|---|---|
| 推論・能力上の欠陥 | strawberry の文字数を数える、なじみのない進数での計算、長いコンテキストの中間にある情報の見落とし、ユーザーに反論されると正解を撤回する | 推論に関する結論9件のうち5件が古くなり、維持または強化されたものはなかった | 最高:引用前に必ず再検証 |
| 事実性とハルシネーション | 科学論文の参考文献を捏造する | 一部のモデルでは発生率がほぼ0に低下した一方、依然として高いモデルもある | 高:差が非常に大きいため、モデルごとに検証が必要 |
| 組み合わせ推論 | 2ホップ問題、「反転の呪い」、対になった時間に関する問題で回答が矛盾する | 弱まったものの、依然として確認される | 中〜高:問題は残っているが、程度の変化が大きい |
| 評価者としての好み | 自分の回答を好む、採択論文と不採択論文に近いスコアを付ける、医学論文の要旨の表現に評価が左右される | 維持または強化 | 中:長期的なリスクがあるため、定期的な確認が必要 |
| ユーザーへのおべっか・迎合 | ユーザーの意見に合わせて答える | 維持または強化された結論の中で比較的多い | 中:カスタマーサポートやアドバイザー用途では優先 |
| 出力分布の傾向 | 政治的な左派寄りの偏向、自由回答形式の質問への回答が酷似する、生成する乱数の分布に偏りがある | 維持または強化 | 中:コンテンツ生成やサンプリングの際に注意が必要 |
なお、推論に関する結論について、報道本文には「9件中5件が古くなり、維持または強化されたものはなかった」とある一方、図のキャプションには「9件すべてが弱まった」と記されています。両者を合わせると、5件は古くなり、残りの数件も弱まっており、元のまま維持されたものはなかったと理解できます。ただし、原論文に記載された50件すべての結論リストと再検証方法は確認できていないため、具体的な分類については原論文を参照してください。
LLM の好みに関する結論はなぜ長く有効なのか
維持または強化された11件の結論のうち、3件は「評価者としての LLM」に関するもので、3件はおべっかや迎合に関するものでした。残りは政治的傾向、自由回答形式の質問への回答の類似、乱数の分布の偏りに関するものです。これらの問題には、何が「正しい」出力なのかを定義しにくく、そのため的を絞った学習で解消することも難しいという共通点があります。
開発チームにとって、これは直感に反するリスクの優先順位を意味します。よく話題になる「モデルは文字を正しく数えられない」という問題は、すでに解消されていることが多い一方、本当に警戒すべきなのは、むしろ目立ちにくい体系的な傾向です。LLM を自動評価、スコア付け、レコメンドに使っているなら、好みに関する問題を定期的な回帰テストに組み込みましょう。
社会的バイアスに関する LLM の結論は一様ではない
研究者は、社会的バイアスに関する結論の変化は一様ではないと指摘しています。政治的な左派寄りの偏向は依然として存在し、性別に関するステレオタイプや潜在的な連想バイアスは弱まりました。一方、アフリカ系アメリカ人英語の使用者に対するバイアスは、傾向データ上では方向が逆転するという結果も見られました。このことは、「モデルには一般的にある種のバイアスがある」という大まかな主張は、具体的なモデルと時点を明らかにして初めて意味を持つことを、改めて示しています。
なぜメーカーやリリース時期から LLM の性能を推測できないのか
モデルを選ぶ際、「新しいモデルは古いモデルより必ず優れている」「同じメーカーのモデルなら性能も似ている」「大きなモデルほど安定している」と直感的に考えるチームは少なくありません。しかし、研究データはこうした推測を明確に否定しています。
最も典型的なのが、参考文献の捏造を調べたテストです。2023 年の Walters と Wilder による原研究では、GPT-3.5 が生成した参考文献の 55% が捏造でした。スタンフォード大学の研究者が同じプロンプトで現在のモデルをテストしたところ、GPT-6.1 Sol は 0%、Claude Sonnet 5.5 は 1% でした。一方、同じく 2026 年にリリースされた Qwen3.7-Flash では、参考文献の 69% が捏造で、3 年前の GPT-3.5 をも上回りました。
同じ時期にリリースされたモデルの間でも、差は驚くほど大きくなっています。2026 年 7 月から 9 月にリリースされたモデルでは、「覆された」結論の数は DeepSeek V4 Pro の 11 件から GPT-6.1 Sol の 30 件まで幅がありました。研究では、リリース日、メーカー、モデルの規模のいずれも、こうした傾向を確実に予測する手がかりにはならないと明言しています。
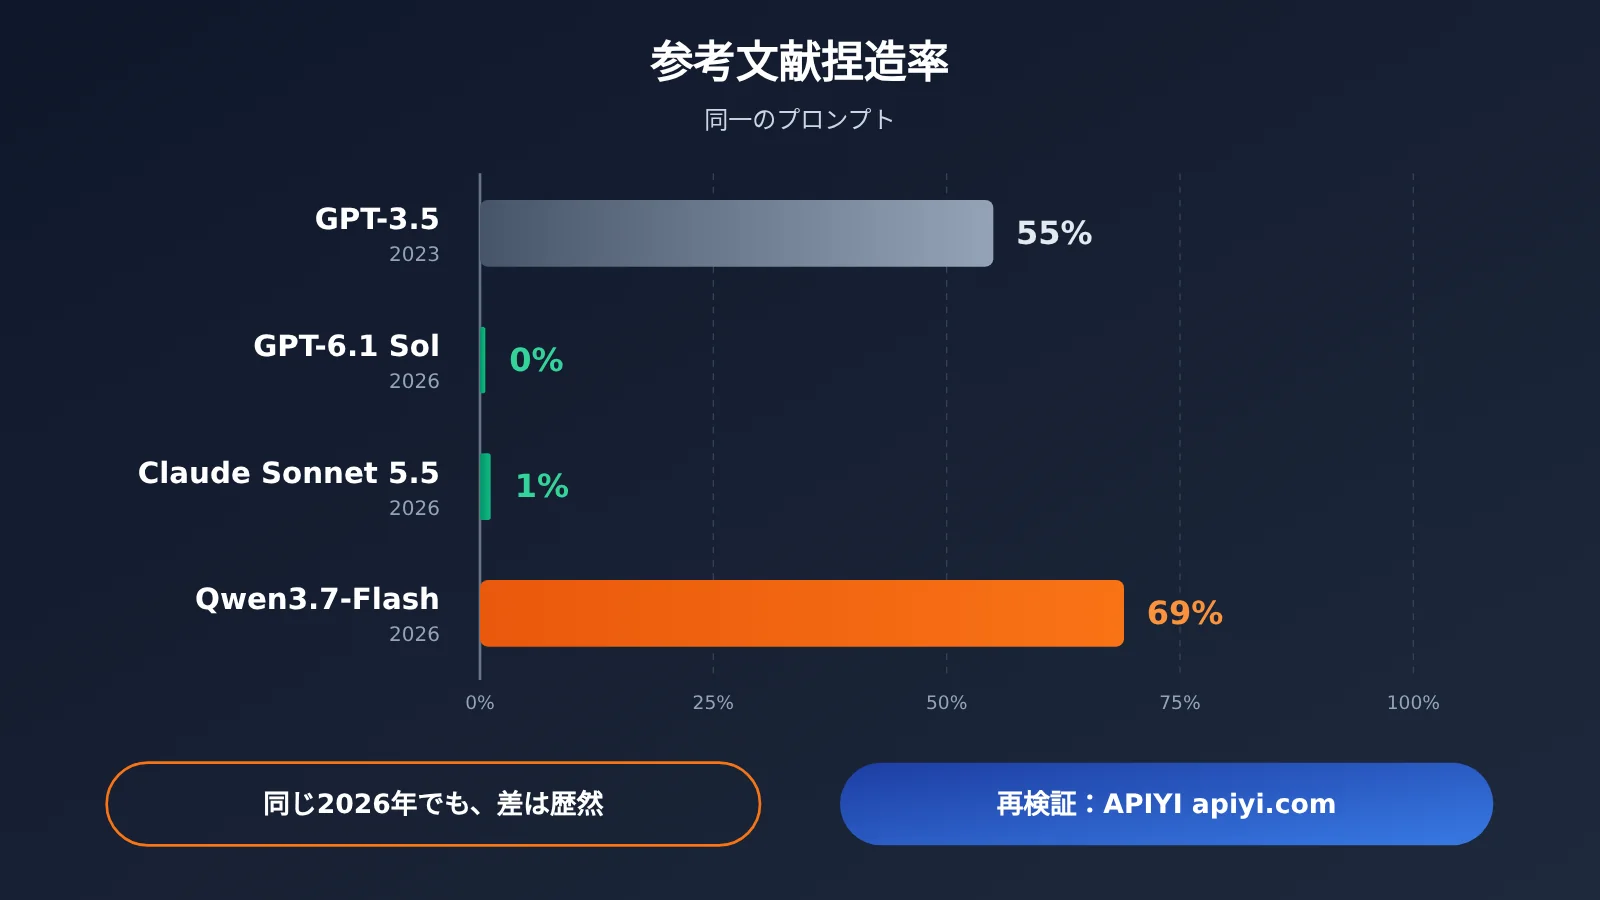
この比較図が伝えたいのは、同じ時代のモデルでも、同じテストで正反対の結果を示す可能性があるということです。チーム内でこうした比較を再現するなら、APIYI apiyi.com のような統一インターフェースを提供するプラットフォームを使い、同じプロンプトのセットで複数の候補モデルをテストできます。利用可能なモデルについては、プラットフォームの公式モデル一覧をご確認ください。
また、研究者は、改善を「問題が完全に解決した」と受け取らないよう注意を促しています。2 ホップ問題(2 つの既知の事実を組み合わせる必要がある問題)では、Claude Sonnet 5.5 は 2 つのサブ問題にそれぞれ正答できる場合でも、それらを組み合わせた問題の約 10% を間違えました。原論文で報告された ChatGPT の数値は 43% です。確かに数値は大きく下がっていますが、業務が複数段階の事実の組み合わせに依存しているなら、この 10% でも本番環境での事故につながりかねません。
LLM 選定の再テストを始めよう:5 ステップのチェックリスト
研究者は学術界に対し、LLM に関する経験的な結論を普遍的な真実ではなく、「特定のモデルについて、特定の時点で得られた観察結果」として扱うよう提言しています。また、将来のモデルで再テストできるよう、論文にはモデル名、バージョン、日付を記録し、プロンプトと分析コードを公開すべきだとしています。この提言は、開発チームのモデル選定プロセスにもほぼそのまま応用できます。
ステップ 1:LLM に関する結論にメタデータを付ける
結論の出典が論文、ブログ、同僚の経験、自分自身のテストのいずれであっても、まずは以下の項目を記録しましょう。重要な項目が欠けている結論は、「要検証の手がかり」として扱い、意思決定の根拠にはできません。
| メタデータ項目 | 記録する内容 | 記録が必要な理由 |
|---|---|---|
| モデル名 | 「ある会社のモデル」ではなく、正式なモデル名 | 同じ提供元でもモデルによって大きな違いがある |
| 具体的なバージョン | バージョン番号またはスナップショットの識別子 | 同名のモデルでも、更新後に性能が変わる可能性がある |
| テスト日 | 日付まで正確に記録 | 結論が出てからの経過時間を判断するため。平均寿命の 15.7 か月が参考になる |
| 完全なプロンプト | システムプロンプト、ユーザー入力、例 | プロンプトが変わると再現できない |
| 呼び出しパラメータ | 温度、最大出力長など | サンプリングパラメータは安定性に関する結論に影響する |
| 評価基準 | 何を合格とし、何を失敗とするか | 基準がなければ、異なる人のテスト結果を比較できない |
| サンプル数 | テストしたケースの数 | 1 回の会話のスクリーンショットでは、結果の割合を示せない |
ステップ2:結論の種類に応じてLLMの再テストの優先順位を決める
結論を見つけたら、まずどの種類に当たるかを判断します。能力の欠陥に関する結論(数を正しく数えられない、計算を間違える、覚えられない、反論されると回答を変える)は、原則として「すでに古くなっている可能性が高い」と考え、引用前に必ず再テストします。一方、選好や傾向に関する結論(自己優遇、迎合、出力の類似)は、原則として「今も存在する可能性が高い」と考え、長期的な回帰テストに組み込みます。
あわせて、結論が出てからの経過年数も確認します。研究データによると、1年を超えた結論が古くなっている確率は約16%、2年を超えると39%に上がります。結論の対象となったモデルが、あなたの候補モデルに置き換わっている場合は、その結論がどれほど有名であっても、改めてテストしましょう。
ステップ3:結論を実行可能なLLMテストケースに書き換える
「モデルは長文の理解が苦手」という主張は、そのままではテストできません。具体的なケースに書き換える必要があります。例えば、長い文書の冒頭・中間・末尾にそれぞれ重要な事実を配置し、個別に質問して正答率を集計します。あるいは、まずモデルに正解を答えさせ、次にユーザーによる反論を再現して、回答を変える割合を集計します。
書き換える際は、論文に登場する単純な例をそのまま使うのではなく、実際の業務データにできるだけ近づけましょう。研究で「すでに古くなった」とされた定番問題は、各社が対策として学習させている可能性があります。定番問題をクリアできても、業務データでも同様にクリアできるとは限りません。
ステップ4:すべての候補LLMで同じプロンプトを使って再検証する
再検証のポイントは、比較条件をそろえることです。同じプロンプト、同じパラメータ、同じ評価基準を使い、モデルだけを切り替えます。モデルごとに別のSDKを接続し、認証も個別に処理しなければならないと、再検証のコストが高くなり、チームが実施をためらうことにもなります。
🚀 実践のヒント:APIYI apiyi.com は統一されたOpenAI API標準に基づき、1つのトークンで200以上のモデルを呼び出せます。候補モデルを切り替える際はmodelパラメータだけを変更し、プロンプトやその他のパラメータはそのまま使えるため、このような横断的な再検証に適しています。対応するモデルやバージョンの詳細は、プラットフォームの公式モデル一覧を確認してください。
ステップ5:LLMに関する結論の記録を作成し、定期的に見直す
再検証の結果は、その都度「結論の記録」として保存しましょう。少なくとも、結論の原文、メタデータ、再検証結果、次回の見直し日を含めます。平均寿命が15.7か月であることを踏まえ、コア業務が依存する結論は四半期または半年ごとに見直すことをおすすめします。モデルのバージョンアップを計画する際は、例外なく全件の再検証を実施しましょう。
| シーン | 推奨される再検証の範囲 | 再検証のタイミング |
|---|---|---|
| 初めてのモデル選定 | 意思決定に影響するすべての結論 + 業務の主要ユースケース | 選定レビュー前 |
| モデルのバージョンアップ | すべての回帰テストケース | 切り替え・本番リリース前 |
| 外部の結論を引用 | 関連する結論のみ | 企画書に記載する前 |
| 日常運用 | 選好傾向に関するケース + 高リスクのユースケース | 四半期または半年ごと |
| 本番環境で異常が発生 | 異常に関連する能力 | 直ちに |
💡 選定のヒント:モデルを選ぶ際は、まず「どのモデルが最強か」を問うのではなく、業務にとってどのような誤りが最も問題になるかを明確にし、候補モデルを対象に絞って再検証しましょう。APIYI apiyi.com の統一インターフェースを使えば、複数の候補モデルを同じテストフローで比較でき、接続部分の余計な変数を減らせます。
よくある質問 FAQ
Q1:LLM に関する結論が「期限切れ」になるとはどういう意味ですか?
スタンフォード大学のこの研究では、LLM に関する経験的な結論の根拠となる現象が、新しいモデルではほぼ見られなくなることを「期限切れ」としています。問題は残っているものの程度が大幅に下がった「弱まり」とは区別されています。50 件の結論のうち、44% が期限切れ、34% が弱まっていました。
Q2:LLM の能力不足に関する結論と、好みや傾向に関する結論はどう違いますか?
能力不足に関する結論は、文字数を数える、計算する、長いコンテキストの情報を保持するといった、モデルに「できないこと」を扱います。明確な正解があり、対象を絞った学習で改善しやすいため、最も早く期限切れになります。一方、好みや傾向に関する結論は、自分の回答を好む、ユーザーにおもねるといった「どのように振る舞いがちか」を扱います。標準的な正解がないため、より長く残ります。
Q3:LLM に関する結論の期限切れを調べたこの研究は、いつ発表されましたか?
関連する報道は 2026 年 11 月 3 日に公開されました。研究では、2024 年 7 月から 2026 年 9 月までにリリースされた、8 社の開発元による計 20 のモデルをテストしています。モデルの進化は速いため、この記事で引用した具体的なデータにも有効期限があります。利用する前に元の論文を確認することをおすすめします。
Q4:どのようなチームが LLM をバージョンごとに再テストする必要がありますか?
主に次のようなケースが挙げられます。
– **モデルの選定や切り替えを進めているチーム**:2 年前の欠点に関する印象だけで候補モデルを除外しないようにする
– **LLM を使って評価や採点を行うチーム**:自分の回答を好む、表現に影響されるといった傾向が残っている
– **事実の正確性が重要なアプリケーション**:参考文献の捏造率は、同世代のモデル間でも 0% から 69% まで幅がある
– **カスタマーサポートや相談対応の対話型製品**:ユーザーにおもねる傾向を長期的に監視する必要がある
Q5:複数の LLM を低コストで再テストするにはどうすればよいですか?
ポイントは接続方法を統一し、「モデルだけを変え、ほかの変数は変えない」ことを簡単にすることです。
1. APIYI の apiyi.com にアクセスし、アカウントを登録して APIキーを取得する
2. 公式モデル一覧で、候補となるモデルとバージョンが利用可能か確認する
3. 同じプロンプトとパラメータを使い、model パラメータだけを変更して順に呼び出し、結果とメタデータを記録する
こうすることで、各社の API への接続を繰り返すのではなく、テストケースの設計に力を注げます。
Q6:再テストの代わりに、新しいモデルのランキングスコアを見るだけでもよいですか?
完全に頼ることはおすすめしません。研究によると、リリース日、開発元、規模から、個々の結論に対するモデルの挙動を確実に予測することはできず、同じ時期にリリースされたモデル間でも大きな差があります。ランキングは候補の絞り込みに活用し、最終判断は自社の業務データを使った再テストの結果に基づいて行いましょう。
Q7:この LLM 研究自体にはどのような限界がありますか?
まず、50 件の結論の完全な一覧と再テストの方法は元の論文を確認する必要があり、二次報道ではすべての詳細を網羅できません。また、報道では推論に関する結論について本文と図の説明文に違いがあり、元の論文を確認する必要があります。最後に、研究結果も「特定のモデルを特定の時点で観察した」ものです。研究者自身の論理に従えば、この結果も時間とともに期限切れになります。
LLM に関する結論の陳腐化:重要ポイント Key Takeaways
- 陳腐化の割合は高い:広く知られた LLM に関する結論 50 件のうち、44% がすでに陳腐化し、34% は明らかに当てはまりにくくなっています
- 有効期間は短い:推定可能な結論の有効期間は平均 15.7 か月で、2 年後には約 4 割が陳腐化しています
- 能力上の欠点に関する結論は陳腐化しやすい:文字数のカウント、算術、長いコンテキストでの情報の取りこぼしなどに関する結論は、優先的に再テストしましょう
- 好みや傾向は持続しやすい:自分自身を好む傾向、迎合、出力の類似性は長期的な回帰テストに組み込みましょう
- メーカーや時期だけでは推測できない:同じ 2026 年のモデルでも、参考文献の捏造率は 0% から 69% まで差があります
- メタデータが前提:モデル名、バージョン、日付、プロンプトのいずれかが欠けると、結論の再現は困難です
- 統一インターフェースで再テストのコストを削減:APIYI apiyi.com を活用すれば、model パラメータを変更するだけで横断的に比較できます
まとめ
LLM に関する結論は平均 15.7 か月で陳腐化します。このデータは、次のことを示唆しています。
- 結論には有効期限がある:LLM に関するあらゆる主張は、「ある時点における特定のモデルの観察結果」と捉えるべきです
- 種類によって優先順位が決まる:能力上の欠点に関する結論は優先的に再テストし、好みや傾向は長期的に監視しましょう
- バージョンが重要:メーカー、リリース時期、モデルの規模は、特定のバージョンを実測する代わりにはなりません
次にモデル選定の会議で「あるモデルは X が苦手」と聞いたら、まず 3 つの質問をしてみましょう。どのバージョンか? いつテストしたのか? プロンプトは残っているか? 答えが分からなければ、再テストのリストに加えましょう。
APIYI apiyi.com を通じて候補モデルを同じテストフローに接続し、同じプロンプトで複数のモデルをすばやく再テストすることをおすすめします。利用可能なモデルは公式リストをご確認ください。
📚 参考資料
- THE DECODER – Rapid LLM development is outrunning the research meant to explain it, study finds:スタンフォード大学によるLLMの研究結論の陳腐化に関する報道
- リンク:
the-decoder.com/rapid-llm-development-is-outrunning-the-research-meant-to-explain-it-study-finds -
内容: 44%の結論が陳腐化したこと、平均有効期間が15.7か月であること、参考文献の捏造事例、同世代モデル間の違いなど、主要なデータを掲載
-
Owen Queen、James Zou の原著論文:スタンフォード大学の研究者による、LLMに関する50の結論を再検証した研究
- リンク: 論文著者名とタイトルを使って、学術検索プラットフォームで検索してください
- 内容: 本記事では原著論文の全文を入手できなかったため、50の結論の一覧と再検証方法については原文をご確認ください
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI のウェブサイト apiyi.com のトップページからお気軽にお問い合わせください。モデルの利用に関する詳しい資料は、ドキュメントセンター docs.apiyi.com でもご覧いただけます